Vantaggi e ottimizzazione dell’infrastruttura Solana multi-regione
Abbiamo sottolineato a lungo quanto sia importante restare fisicamente vicini al validator leader corrente. Eppure Solana è distribuita a livello globale e i leader ruotano costantemente. Concentrare tutto in una sola città non rispecchia questa realtà, ed è per questo che un approccio multi-regione ha senso. In questo articolo partiamo dalle epoche e dallo schedule dei leader, poi mostriamo come decidere se sei «vicino» in termini pratici e come rendere operativa questa decisione.
Comprendere le epoche e lo schedule dei leader
Solana fa avanzare il tempo in slot. Circa 400 ms compongono uno slot, e gli slot sono raggruppati in un’epoca. Un’epoca è un insieme di slot (432.000 in totale) e corrisponde a circa due giorni. Puoi seguirne l’avanzamento con il metodo RPC getEpochInfo. Per comprendere l’attuale ritmo di elaborazione della rete e la velocità con cui avanzano gli slot, getRecentPerformanceSamples è utile. All’inizio di ogni epoca lo schedule dei leader viene fissato, e in ogni momento esattamente un leader sta producendo il blocco. Questo rapido avvicendamento è il motivo per cui serve un approccio che segua la distanza man mano che i leader cambiano.
Perché la distanza influenza i risultati
Nella storia delle infrastrutture di trading, essere fisicamente vicini ai server principali della borsa è sempre stato un vantaggio. C’è persino chi dice che il prezzo di un server cambi con la lunghezza del cavo. La luce è veloce, ma non infinita. Una distanza più breve significa ricezione più veloce e invio più veloce. Lo stesso principio si applica su una blockchain, con una differenza: il punto di produzione dei blocchi di Solana si sposta per il mondo. Se il leader è a New York in questo momento, essere vicini a New York aiuta. Se il leader successivo è a Francoforte, essere vicini a Francoforte aiuta. Ecco perché si preparano più sedi invece di un unico hub.
La strategia multi-regione essenziale
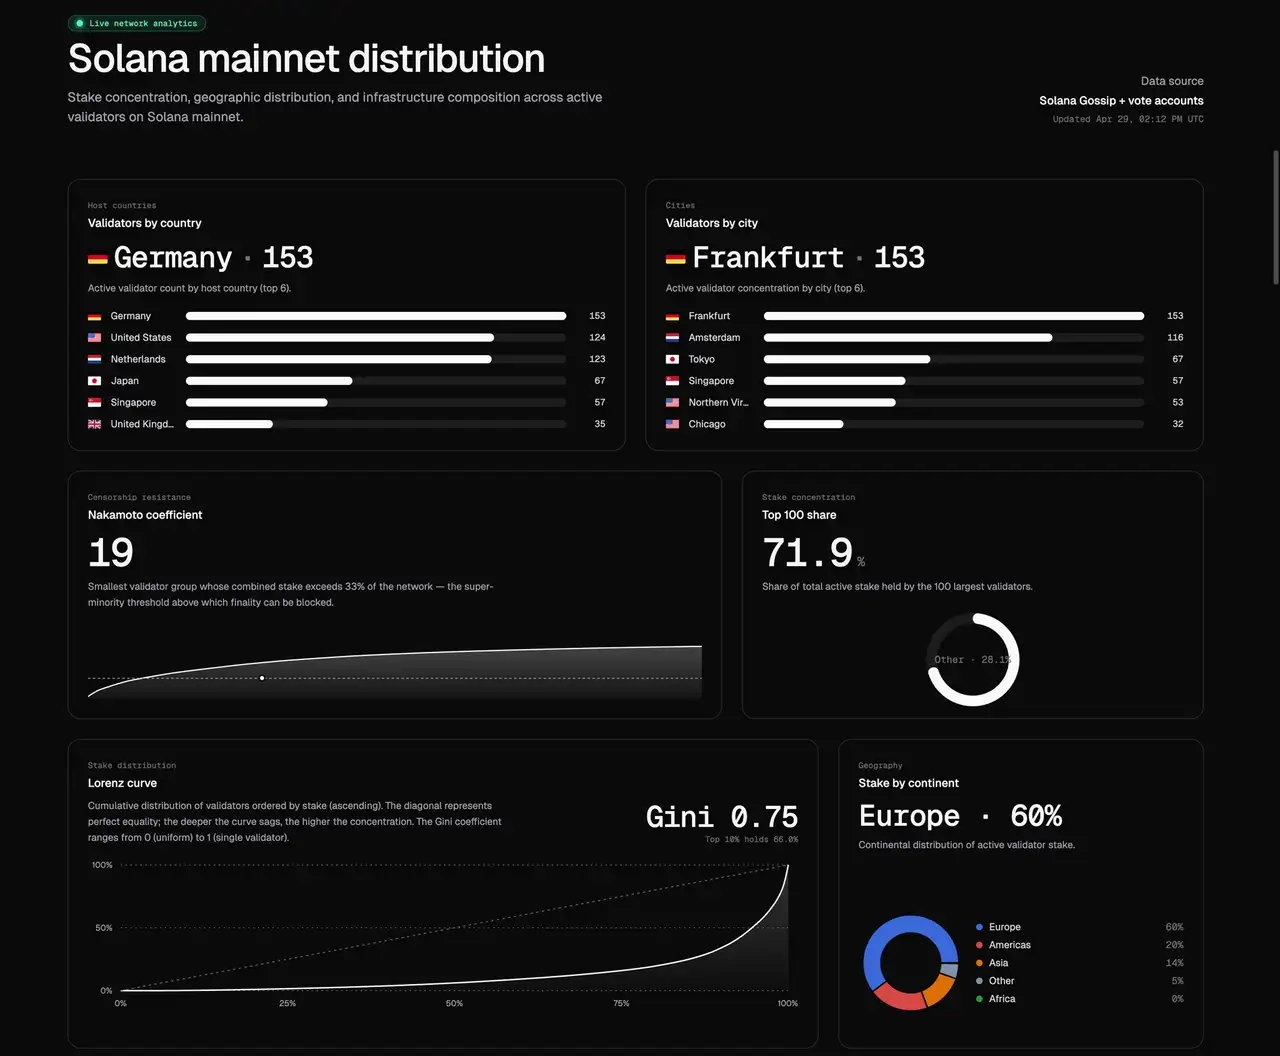
Dati della rete Solana: Validators Solutions
Mantieni diverse piccole basi nelle principali città dei validator e nei punti di interscambio, e usa automaticamente la base più vicina al leader corrente in ogni dato momento. Quando il leader dello slot è a New York, ricevi e invii da New York. Quando il leader successivo ruota a Francoforte, passa immediatamente a Francoforte e trasmetti da lì sul percorso più breve. L’obiettivo non è migliorare una media, ma evitare di perdere le opportunità che continuano ad arrivare.
Scegli il dedicato, non il condiviso
Le reti condivise e i server condivisi sono sensibili agli altri utenti e tendono a oscillare nelle ore di punta. Endpoint dedicati e server dedicati distribuiti tra le regioni ti permettono di aggirare la congestione e far passare i dati come su un’autostrada privata. La ricezione dello stream è particolarmente sensibile alla distanza, quindi collocarla il più vicino possibile su risorse dedicate influenza ciò che percepisci ogni giorno. Anche la trasmissione si comporta come previsto solo quando parte da una base vicina lungo un percorso dedicato (sei l’unico utente, quindi sei meno esposto al throttling e alle code condivise).
Come misurare la «vicinanza»
La vicinanza è una decisione basata sui dati, non una sensazione. Per prima cosa, individua dove ti trovi nell’epoca corrente. Usa getEpochInfo per recuperare i dati dell’epoca e leggere gli slot trascorsi e quelli rimanenti. Poi usa getRecentPerformanceSamples per stimare il tempo medio recente per slot. Gli slot rimanenti moltiplicati per il tempo medio per slot ti danno un numero approssimativo di secondi fino al cambio. Questo rende più facile pianificare la preparazione e i passaggi di sede.
Con l’avvicinarsi del cambio, recupera i leader per il tuo intervallo target con getSlotLeaders e restringi i candidati a breve termine. Puoi elencare i nodi del cluster con getClusterNodes. Incrocia l’identità del leader con i dati dei nodi, quindi usa l’IP pubblico o l’indirizzo gossip per individuare le possibili aree geografiche.
Attenzione qui. La geolocalizzazione IP può essere errata o obsoleta, quindi una volta ottenuta una mappa approssimativa, esegui effettivamente il ping da ciascuna delle tue basi e misura direttamente il round-trip di riferimento. La rete si comporta come un viaggio su strada: la distanza conta, ma la scelta del percorso cambia il tempo di arrivo. Il ping è un indicatore compatto di quanto siano «trafficate» oggi le strade. Non affidarti a una singola misurazione. Esegui diversi ping leggeri in una breve finestra e decidi in base alla mediana per ridurre il rumore.
Non buttare via i risultati. Conserva le misurazioni e le mappature per base nel tuo database e fai aggiornare i delta a un worker leggero a ogni cambio di epoca. Le operazioni quotidiane diventano più stabili e le tue decisioni più rapide.
Trasformarlo in un sistema con database e worker
Se ricalcoli tutto da zero, la tua velocità viene consumata dalla misurazione stessa. In pratica, conserva nel database la mappatura tra leader e regioni, oltre alla latenza per base. Aggiornala con un worker a ogni confine di epoca. Lascia che l’applicazione a runtime legga quel database e decida istantaneamente quale base usare. Colloca la ricezione vicino alla sorgente dello stream e prepara la trasmissione nella regione del leader successivo con un leggero anticipo. La suddivisione dei ruoli abbassa la latenza complessiva combinata.
Ottimizzazione a livello micro e progettazione a livello macro
Per ciascuna base, usa CPU ad alta frequenza di clock, memoria DDR5 e i più recenti NVMe, mantenendo basso l’utilizzo tipico. L’ottimizzazione a livello micro è la base che rende proficua la progettazione multi-regione. A livello macro, colloca endpoint dedicati e server all’interno della stessa rete per massimizzare la «comunicazione a distanza zero» che non attraversa l’Internet pubblico. Per i collegamenti tra basi, i tuoi percorsi dedicati spesso riducono i tempi di attesa del passaggio rispetto ai percorsi generici tramite RPC pubblici.
Implementazione e supporto
Ricevi e invia vicino al leader. Poiché il «vicino» continua a cambiare, distribuisci la tua presenza su più regioni. Ciò che serve è un piccolo meccanismo per seguire lo schedule più recente e un modo sensato di posizionare le basi. Possiamo aiutarti come builder con passi concreti per accorciare i round trip dei dati. Questo include la progettazione del tuo database e dei worker, il posizionamento delle basi, la preparazione di endpoint dedicati e il passaggio di consegne tra città.
Per aggiornamenti e domande, entra nella ERPC Web Dashboard. Sono disponibili prove gratuite e ambienti di test.
ERPC Web Dashboard: https://dashboard.erpc.global/it
Grazie come sempre. Continuiamo a testare sul campo e a migliorare con onestà, affinché il tuo progetto abbia successo.