Principio fondamentale di Internet: se è più vicino, è più veloce. Sempre — anche su Solana.
Molti trader e progetti alla ricerca dell’«ambiente più veloce» guardano prima alla latenza media.
Può essere utile come riferimento per un confronto, ma se il tuo obiettivo è il trading zero-slot — in altre parole, l’intervallo dei 200–400 ms — non lo otterrai mai dalla latenza media.
Solana è distribuita a livello globale e la comunicazione intercontinentale comporta inevitabilmente ritardi di centinaia di millisecondi.
Finché ti concentri su una media che include tali ritardi, la velocità di cui hai veramente bisogno rimarrà fuori portata.
In realtà, il risultato è deciso dalla riduzione di pochi millisecondi all’interno della tua regione, dove avviene la comunicazione a breve distanza.
Recuperare l’intuizione della velocità
Quando pensi alle reti, immagina di guidare un’auto. Il punto di partenza è casa tua, la destinazione è il tuo ufficio. Un tragitto breve è semplice e veloce, con scarso rischio di incidenti o traffico.
Un lungo viaggio, al contrario, comporta incroci, autostrade, gallerie — e da qualche parte lungo l’andata e il ritorno è probabile che si verifichi congestione.
Internet funziona allo stesso modo. Più il server è lontano, più hop sono necessari e più il tempo di round trip diventa variabile. Avvicinare la destinazione è la via più breve per ottenere sia la massima velocità sia la stabilità.
Perché le medie non vincono
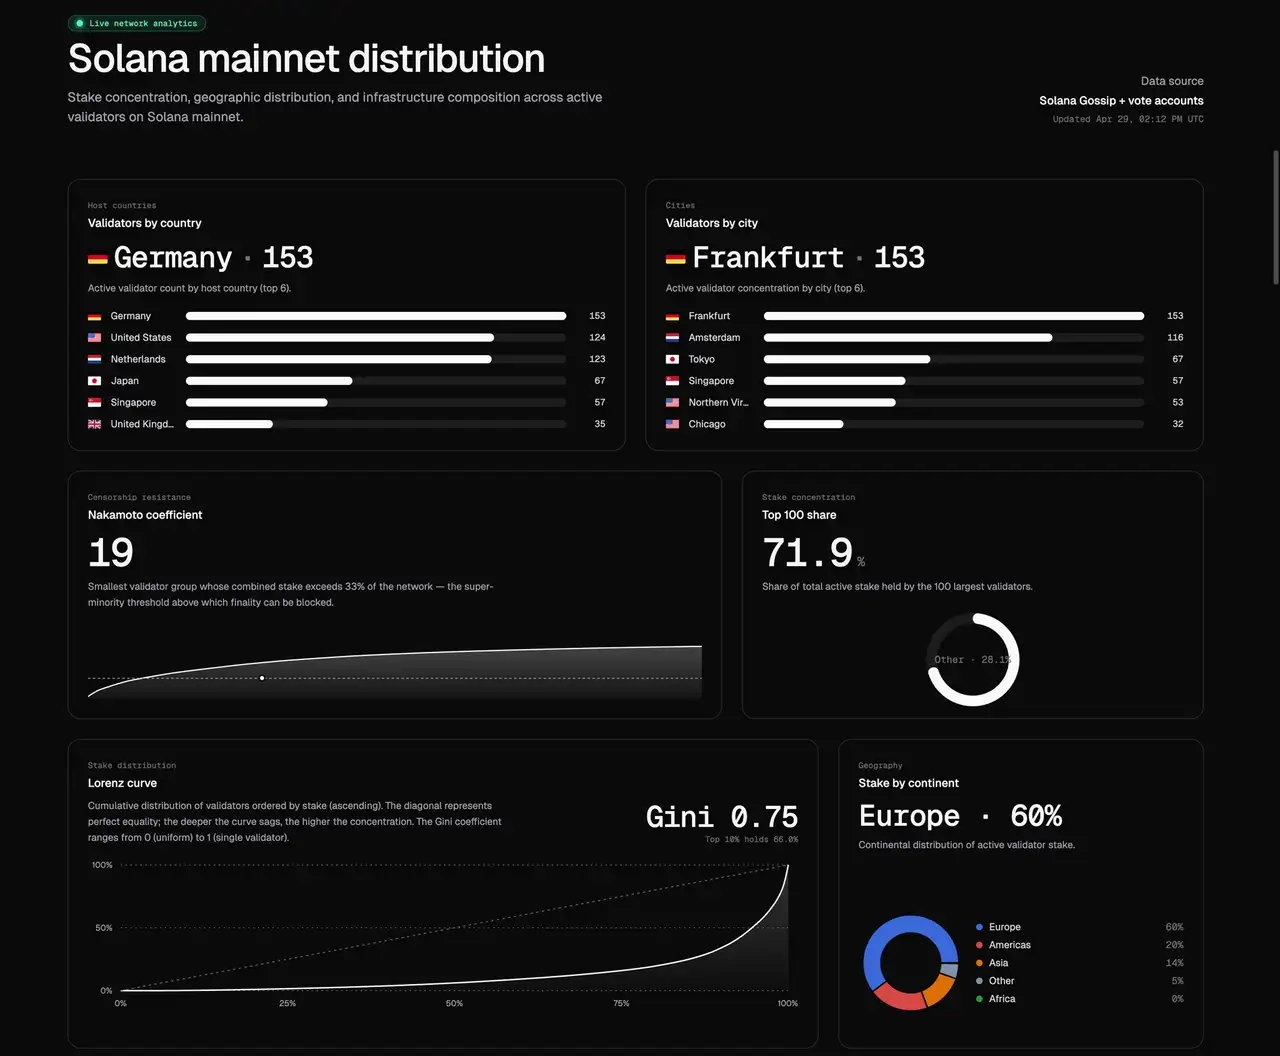
Dati della rete Solana: Validators Solutions
Su Solana, i leader ruotano per produrre i blocchi, quindi la vicinanza fisica al leader corrente determina il risultato. I leader sono distribuiti a livello globale e non è raro che si trovino su continenti diversi.
La comunicazione intercontinentale supera i 100 ms di ping e sale a diverse centinaia di millisecondi per gli stream.
Per quanto tu possa raffinare una media che include tali ritardi, non si tradurrà in prestazioni reali. Semplicemente non puoi stare al passo negli slot intercontinentali.
Il punto non è inseguire le medie, ma concentrarsi sulla propria regione e minimizzare i round trip in quell’ambito. Combattere per pochi millisecondi a breve distanza è l’unico approccio pratico con un reale vantaggio competitivo.
Come riferimento, ecco i valori di round trip di base in base alla distanza:
| Distanza | Ping di round trip (circa) |
|---|---|
| Stessa rete | ~0,1 ms |
| Connessione privata | ~0,2 ms |
| Stesso data center | ~0,3 ms |
| Stessa città | ~1 ms |
| Paese vicino | ~5–10 ms |
| Intercontinentale | ~100–300 ms |
La latenza effettiva reale cresce ulteriormente a seconda del metodo di comunicazione, a causa dell’overhead del protocollo e dei costi di mantenimento:
| Metodo | Moltiplicatore di latenza | Note |
|---|---|---|
| Ping (ideale) | 1× | Solo limite inferiore di riferimento |
| POST (invio singolo) | ~2–3× | Controllo di round trip, retry, TLS |
| Stream | ~5× | Connessione persistente, controllo di congestione, buffer |
Come misurare la «vicinanza»
La vicinanza va misurata con i dati, non con l’intuizione. Inizia controllando la posizione dell’epoca corrente. Con l’RPC getEpochInfo, ottieni i dati dell’epoca più recente, gli slot trascorsi e il numero di slot rimanenti.
Successivamente, usa getRecentPerformanceSamples per stimare i tempi medi recenti degli slot. Moltiplicando il tempo medio degli slot per gli slot rimanenti si ottiene una stima approssimativa di quanti secondi mancano alla transizione — utile per la preparazione e i piani di switch.
Con l’avvicinarsi della transizione, preparati a recuperare i leader di destinazione con getSlotLeaders.
L’elenco dei nodi del cluster è disponibile con getClusterNodes, quindi puoi incrociare i dati dei leader con le informazioni sui nodi, usando gli IP pubblici o gli indirizzi gossip per stimare la distribuzione geografica dei leader nello schedule.
Un’avvertenza: la geolocalizzazione IP presenta errori e ritardi, quindi le stime possono essere sbagliate. Dopo aver mappato le posizioni, esegui sempre il ping da ciascuna sede per misurare direttamente i ritardi di round trip di base.
Il networking è come un viaggio in auto — non solo la distanza, ma anche il percorso scelto influisce sul tempo di arrivo. Il ping mostra, semplicemente, quanto sono congestionate oggi le strade.
Non affidarti a una singola misurazione; prendi più campioni a brevi intervalli e usa la mediana per ridurre il rumore.
Non scartare i risultati dopo l’uso. Accumula i dati di round trip e le mappature per sede nel tuo database e aggiornali incrementalmente con worker leggeri a ogni transizione di epoca. Questo stabilizza le operazioni e accelera il processo decisionale.
Il posizionamento dell’applicazione definisce la latenza
La velocità non è determinata solo dalle specifiche del server. La posizione dell’applicazione conta altrettanto.
Come esempio estremo, monitorare da Tokyo ciò che accade a Francoforte è svantaggioso. La sola latenza di round trip crea un ritardo accumulato, lasciandoti sempre indietro.
Distribuisci le risorse in ogni sede, completando ricezione ed elaborazione in locale, oppure inoltrando i dati alla sede successiva tramite il percorso più breve. Questa struttura migliora sia la copertura sia la reattività.
VPS distribuiti nella stessa rete
Le nostre istanze VPS sono distribuite per regione nella stessa rete degli endpoint dedicati Solana, eliminando la comunicazione esterna e ottenendo i round trip più brevi.
Possono essere distribuite rapidamente e su piccola scala per regione. Anche distribuire solo worker da 1–2 core riduce la latenza effettiva e il rischio di perdere opportunità.

Prossimo rilascio a settembre 2025: «SUPER EPYC VPS»
Questo mese, partendo dalla regione più popolare, Francoforte, prevediamo di rilasciare «SUPER EPYC VPS», che utilizza CPU da data center con velocità di clock di 5,7 GHz ai vertici del mercato.
L’adozione di CPU di ultima generazione per i prodotti VPS non è una pratica comune, il che rende la disponibilità limitata. Per chi cerca il VPS più veloce, sarà un’opzione forte.

Per la massima qualità e velocità: il bare metal
Mentre il VPS divide un server fisico in parti virtualizzate, i server bare metal mettono a tua esclusiva disposizione CPU, memoria, disco e banda di rete.
Questo rende più facile sostenere prestazioni elevate e stabili anche nei momenti di picco, ideale per le applicazioni Solana che richiedono una latenza costantemente bassa.
Per i casi d’uso Solana, le CPU Ryzen sono particolarmente popolari, raggiungendo velocità di clock massime di 5,7 GHz di fascia consumer. EPYC è progettato per minimizzare l’overhead di virtualizzazione, mentre Ryzen è progettato per massimizzare le prestazioni single-thread senza virtualizzazione. Scegli in base al tuo caso d’uso.

Le sfide che ERPC risolve
- Fallimenti delle transazioni e fluttuazioni di latenza comuni nei tipici ambienti RPC
- Limitazioni di prestazioni imposte da molti provider di infrastruttura
- L’impatto significativo della distanza di rete sulla qualità della comunicazione
- Accesso limitato per i piccoli progetti a infrastrutture di alta qualità
Dettagli su prodotti, prove gratuite, processo di onboarding, configurazioni dedicate, richieste di inventario e partecipazione alla waitlist sono disponibili tramite la ERPC Web Dashboard:
- Sito ufficiale ERPC: https://erpc.global/it
- ERPC Web Dashboard: https://dashboard.erpc.global/it
Continueremo i nostri sforzi di ricerca e sviluppo, lavorando per stabilizzare l’offerta ed espandere la nostra gamma, offrendo valore a più progetti in tutto il mondo.
Grazie per il tuo continuo supporto.