Dieci miti che rallentano le applicazioni Solana: perché un sistema veloce può ancora essere lento
La connessione è veloce. La CPU è recente. Il server si trova nella stessa città del fornitore dei dati. Eppure l'applicazione continua a reagire lentamente alle informazioni di cui ha bisogno. La connessione rimane aperta, ma i dati in elaborazione accumulano sempre più ritardo.
Nello sviluppo di applicazioni a bassa latenza su Solana, questa situazione non ha sempre un'unica causa. Instradamento della rete, impostazioni di ricezione, dati sottoscritti e attese interne all'applicazione possono combinarsi e impedire di sfruttare appieno l'infrastruttura veloce scelta.
In ERPC, gestita da ELSOUL LABO B.V., il nostro team di assistenza incontra regolarmente domande su cicli di ricezione bloccati, configurazioni dei client, sottoscrizioni inutilmente ampie e tentativi di riconnessione che lasciano irrisolto l'errore iniziale. Scelte che creavano pochi problemi in una normale applicazione web possono diventare vincoli nel trading ad alta frequenza e nell'elaborazione in tempo reale.
Questo articolo esamina dieci miti alla base di questi problemi. L'obiettivo è aiutare a valutare sia la scelta dell'infrastruttura sia il progetto che ne traduce le prestazioni in decisioni e invio di transazioni.
Questa guida si rivolge a sviluppatori con esperienza nelle applicazioni web che iniziano a realizzare applicazioni di trading ad alta frequenza (HFT) o altre applicazioni in tempo reale su Solana. Affronta la scelta dell'ambiente e i primi controlli da eseguire. Qui, una sottoscrizione consiste nello scegliere quali aggiornamenti dei dati l'applicazione riceverà in modo continuativo.
Prima di tutto, decidere cosa deve terminare prima
Il tempo di andata e ritorno della rete, l'istante di arrivo dei dati, il tempo necessario alla decisione e quello richiesto per confermare una transazione sono metriche diverse. Un ping rapido non impedisce decisioni lente se l'elaborazione si blocca dopo la ricezione. Una risposta RPC veloce non significa necessariamente che la transazione sia stata eseguita.
Consideriamo, per esempio, un'applicazione che riceve un aggiornamento dello stato di un mercato, ricalcola le proprie condizioni e invia una transazione quando tali condizioni sono soddisfatte. Separare il tempo fino all'arrivo dell'aggiornamento, quello necessario per terminare il calcolo e quello richiesto per verificare il risultato della transazione inviata. Definire quale intervallo deve accorciarsi chiarisce dove indagare.
Misurare questi intervalli separatamente. Per migliorare, occorre smettere di ridurre la velocità al nome di un prodotto o a un solo numero.
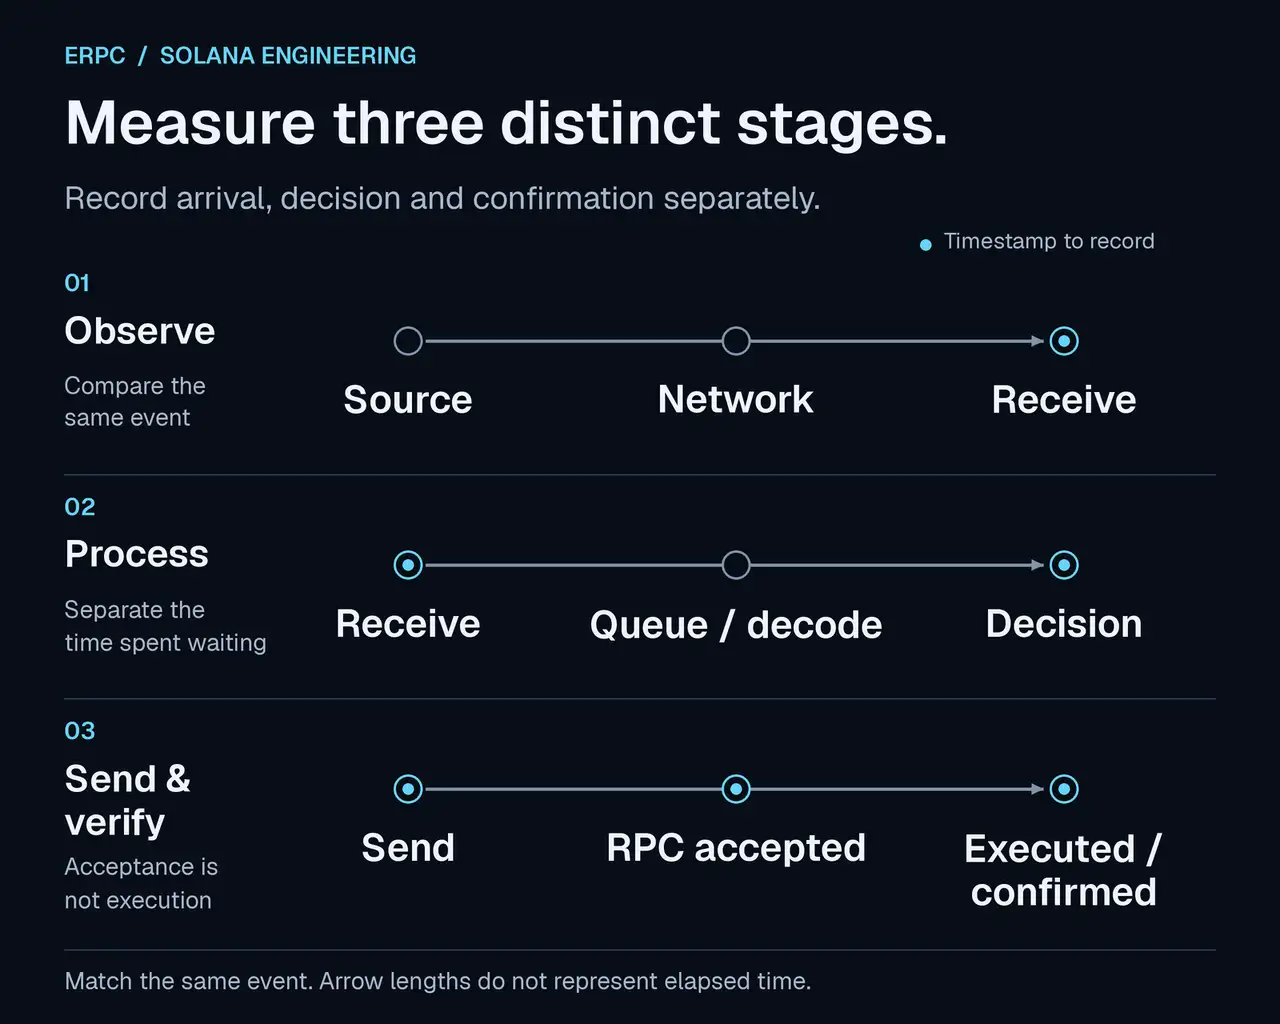
Misurare separatamente l'osservazione, l'elaborazione dentro l'applicazione e l'invio con la conferma. Il diagramma illustra le fasi da misurare, non durate misurate o differenze di prestazioni tra le fasi.
Mito 1: se una piccola VM funziona, la sua capacità deve essere sufficiente
Una piccola VM cloud funzionava bene per una precedente applicazione web o per un carico di lavoro su Ethereum. Questa esperienza può indurre a pensare che la stessa configurazione gestisca anche un flusso Solana. Ma un'applicazione che effettua richieste RPC occasionali e una che riceve ed elabora continuamente un'ampia gamma di aggiornamenti richiedono risorse diverse.
Dimensionare l'ambiente in base al volume dei dati, alla frequenza di arrivo, al lavoro per evento e alla latenza accettabile. Quanti eventi arrivano ogni secondo? Quanti byte vengono trasferiti? Quanto tempo CPU e quanta memoria consumano la decodifica e le decisioni? Prevedere un margine per reggere sia i picchi sia il traffico ordinario. Anche sulla stessa blockchain, l'ampiezza delle sottoscrizioni e l'implementazione cambiano i requisiti.
La difficoltà è che un'applicazione con risorse insufficienti può sembrare funzionante. I dati possono continuare ad apparire sullo schermo diventando però sempre più vecchi, oppure alcune lacune durante la riconnessione possono passare inosservate. Il solo conteggio degli eventi ricevuti non lo rivela. Controllare anche gli eventi la cui elaborazione è completata, l'età dei dati non ancora elaborati e la continuità degli eventi che la sottoscrizione dovrebbe coprire.
Se l'unico riferimento è l'esperienza precedente, gli sviluppatori potrebbero non mettere mai in discussione la capacità del lato ricevente e continuare ad attribuire il problema all'endpoint dei dati. Provare un ambiente con più margine può rendere visibili arretrati o dati mancanti prima non evidenti.
Per indagare, confrontare lo stesso endpoint, sottoscrizione, livello di commitment (la fase di conferma richiesta, spiegata nel mito 9), SDK, impostazioni e carico di elaborazione su un ambiente di ricezione ed elaborazione con più capacità disponibile. Mantenere la stessa regione, registrare le differenze di CPU, memoria e rete e confrontare il throughput di ricezione, il lavoro completato, l'arretrato, gli eventi mancanti e il tempo necessario per decidere. Poiché il carico cambia nel tempo, confrontare possibilmente lo stesso periodo, rispettando i limiti di connessione e il carico imposto al servizio.
Un miglioramento dopo il cambio di ambiente mostra che le condizioni di ricezione o elaborazione hanno contribuito al risultato. Se CPU, memoria e rete sono cambiate insieme, servono ulteriori verifiche per identificare la risorsa determinante. Scegliere risorse adeguate alla quantità e alla frequenza dei dati effettivamente gestiti è un requisito per l'elaborazione a bassa latenza.
Mito 2: essere nella stessa città significa essere vicini sulla rete
«Entrambi i server sono a Francoforte, quindi saranno vicini». «Distribuire a Tokyo deve essere la soluzione più veloce per il Giappone». I nomi delle città aiutano a valutare le posizioni di distribuzione, ma non garantiscono il percorso effettivo del traffico.
Il percorso dipende dalle connessioni tra data center, dai collegamenti tra operatori di rete e dalle decisioni di instradamento. Persino server nella stessa città possono comunicare attraverso un percorso indiretto su reti esterne. RIPE IPmap, per esempio, indica fra i propri utilizzi la visualizzazione delle inefficienze di instradamento, come il traffico che esce da un paese e poi vi rientra. [1]
Misurare l'RTT tra la fonte dati effettiva e l'host che esegue l'applicazione, le variazioni nel tempo, le ritrasmissioni o le perdite e l'istante di arrivo dello stesso evento. Traceroute e MTR possono aiutare a esaminare il percorso, ma il solo numero di hop non ne determina la qualità. È anche importante non scambiare la limitazione delle risposte diagnostiche di un router intermedio per una perdita di pacchetti che colpisce l'applicazione.
Dopo aver scelto una regione, porsi un'altra domanda: come sono realmente collegati questa specifica fonte dati e questo specifico server? Questo controllo aggiuntivo rivela differenze che il nome della città, da solo, non può mostrare.
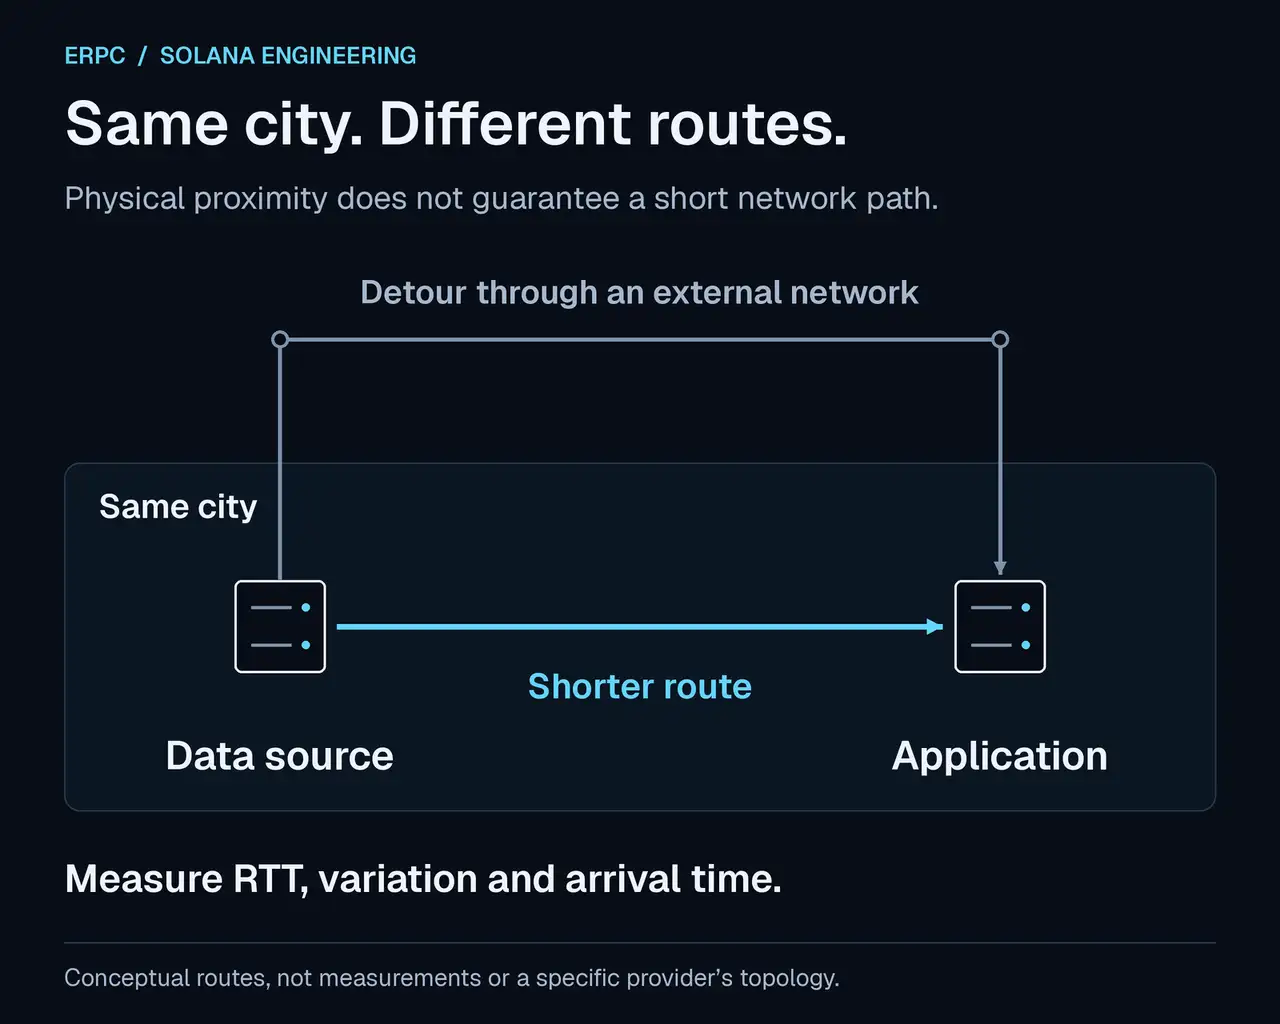
Due server nella stessa città possono avere percorsi e tempi di andata e ritorno diversi. Il diagramma è concettuale e non rappresenta il percorso reale di un particolare fornitore.
Mito 3: specifiche di rete elevate garantiscono banda utilizzabile sufficiente
La banda indicata nelle specifiche di un server può riferirsi a concetti diversi: velocità della porta fisica, banda assegnata a una macchina virtuale, banda sostenibile o limite temporaneo di burst. Una scheda di rete veloce non significa che l'applicazione possa sfruttarne continuamente tutta la capacità.
La documentazione AWS, per esempio, distingue la banda di base dalla banda di burst e descrive vincoli relativi a destinazioni del traffico, flussi e frequenza dei pacchetti. È un esempio di come leggere le specifiche; non significa che ogni VPS abbia gli stessi limiti di AWS. [2]
Nella scelta di un piano, verificare se la banda è dedicata o condivisa, le condizioni d'uso continuativo, le quote di trasferimento e l'eventuale trattamento diverso delle destinazioni del traffico. Nei test, mantenere il traffico verso lo stesso endpoint e con le stesse condizioni di sottoscrizione previste in produzione, osservando insieme throughput di ricezione, pacchetti scartati, ritrasmissioni e carico CPU.
Un risultato elevato in un breve test di velocità non dimostra che il server sappia elaborare continuamente un flusso di produzione. Allo stesso tempo, un throughput di ricezione basso non indica necessariamente banda insufficiente. Distinguere i problemi di configurazione della ricezione dai limiti di elaborazione prima di potenziare la connessione.
Mito 4: una CPU migliore, più core o più GHz massimi rendono veloce l'applicazione
La frequenza massima di boost di una CPU non è una frequenza mantenuta con qualsiasi carico. Il funzionamento effettivo dipende da alimentazione, temperatura, firmware, controlli di frequenza e altri carichi. La documentazione Linux spiega che abilitare il boost ne consente l'uso, ma non dimostra che la CPU stia effettivamente operando in boost. [3]
Se il lavoro importante è concentrato in un solo thread, aggiungere core non lo farà terminare prima. L'utilizzo complessivo della CPU può apparire basso mentre un singolo core o l'event loop è saturo. Anche la guida ufficiale di Node.js spiega come una callback pesante costringa altro lavoro ad attendere. [4]
Verificare frequenza di clock, temperatura, utilizzo per core e tempi di elaborazione con il carico reale. In un ambiente virtuale, può essere utile anche il tempo trascorso in attesa dell'assegnazione della CPU. Profilare l'applicazione per capire quanto tempo richiedano decodifica, calcolo, allocazione della memoria e logging.
Scegliere una combinazione di prestazioni di clock della CPU, assegnazione delle risorse, impostazioni che sostengano le prestazioni e implementazione dell'applicazione. Il confronto dei soli modelli non stabilisce la velocità dell'intera applicazione.
Mito 5: con gRPC bastano le impostazioni predefinite del client
Stabilire una connessione gRPC non dimostra che possa ricevere il volume di dati necessario alla velocità richiesta. HTTP/2 dispone di un controllo di flusso attraverso cui il ricevente comunica al mittente quanti dati può accettare. Il controllo si applica sia al singolo stream sia alla connessione: le finestre di ricezione e i loro aggiornamenti possono quindi limitare il throughput anche quando il collegamento di rete ha capacità libera. [5][6]
Una finestra di ricezione indica al mittente quanti dati può inviare prima di un nuovo aggiornamento dal ricevente. Valori iniziali, regolazione automatica e precedenza delle impostazioni differiscono tra SDK e librerie. Scrivere un numero grande in un file di configurazione non prova che il client si comporti come previsto. Verificare le impostazioni dello stream e della connessione, la loro interazione con i parametri adattivi e la versione in uso.
Applicare modifiche misurando il throughput di ricezione effettivo e l'arretrato di elaborazione nelle stesse condizioni di sottoscrizione. Dimensione massima dei messaggi ricevuti, buffer di ricezione TCP e finestra di ricezione HTTP/2 sono impostazioni distinte. Il keepalive verifica che la connessione sia attiva; non aggiunge capacità di elaborazione né banda.
Le FAQ gRPC di ERPC includono procedure diagnostiche ed esempi di configurazione per flussi il cui throughput rimane costante mentre aumenta il ritardo. Prima di usare un esempio, annotare l'SDK e la sua versione. Individuare dove quell'SDK configura le finestre di ricezione dello stream e della connessione e la regolazione automatica, quindi confrontare queste impostazioni con l'esempio delle FAQ. Se si usa un SDK diverso, consultare la sua documentazione per trovare le impostazioni corrispondenti, senza copiare invariati nomi e valori dei parametri. Verificare poi il risultato rispetto al proprio volume di sottoscrizioni e alla capacità di elaborazione. [7]
Mito 6: ricevere tutti i blocchi completi permette di decidere prima
«Prima riceviamo tutto, poi cerchiamo ciò che conta». È un modo comprensibile di iniziare lo sviluppo, ma aggiunge lavoro che potrebbe non essere necessario prima di una decisione. Trasferire, decodificare, allocare memoria e cercare dati inutili consuma risorse finite di banda e CPU.
Per reagire ai cambiamenti di un mercato, programma o account specifico, definire prima gli eventi e i campi necessari alla decisione. Yellowstone gRPC offre filtri per sottoscrizioni a transazioni e account, oltre alla possibilità di recuperare solo una parte dei dati di un account. Le notifiche di blocchi completi e quelle di aggiornamenti individuali sono inoltre cose diverse. [8]
Per un requisito come «ricalcolare le condizioni ogni volta che cambia il mercato A», elencare le informazioni che identificano il mercato A, lo stato utilizzato nel calcolo e gli eventi che aggiornano quello stato. I dati necessari dipendono dalle specifiche del programma: confrontarle quindi con gli aggiornamenti ricevuti. Usare l'elenco per restringere le sottoscrizioni, poi verificare che lo stato necessario alla decisione rimanga completo.
A parità di risorse e condizioni, se un'applicazione deve decodificare tutti i record e cercare quelli utili mentre un'altra può elaborare subito l'aggiornamento necessario, la seconda evita quell'attesa. Un concorrente più focalizzato può reagire ripetutamente prima per ragioni che vanno oltre la connessione di rete. Decidere cosa si può ignorare fa parte della progettazione a bassa latenza.
Indicizzazione, audit, ricerca e archiviazione storica possono legittimamente richiedere tutti i dati. Prevedere un percorso separato per quel carico. Separarlo dalle decisioni immediate consente di progettare la capacità e la completezza richieste da ciascun percorso. Verificare però che i filtri non eliminino aggiornamenti necessari a decisioni corrette. Anche l'elaborazione in batch può aumentare il throughput complessivo in alcuni casi: sceglierla in base all'attesa tollerabile dall'applicazione.
Nell'attuale servizio Shared gRPC di ERPC, una sottoscrizione
blocks non vuota richiede il servizio Dedicated. Sottoscrizioni transactions o blocksMeta possono soddisfare esigenze specifiche, ma nessuna delle due fornisce gli stessi dati dei blocchi completi. Anche scegliendo Dedicated occorrono capacità di elaborazione adeguata sul lato ricevente e sottoscrizioni ben progettate. [9]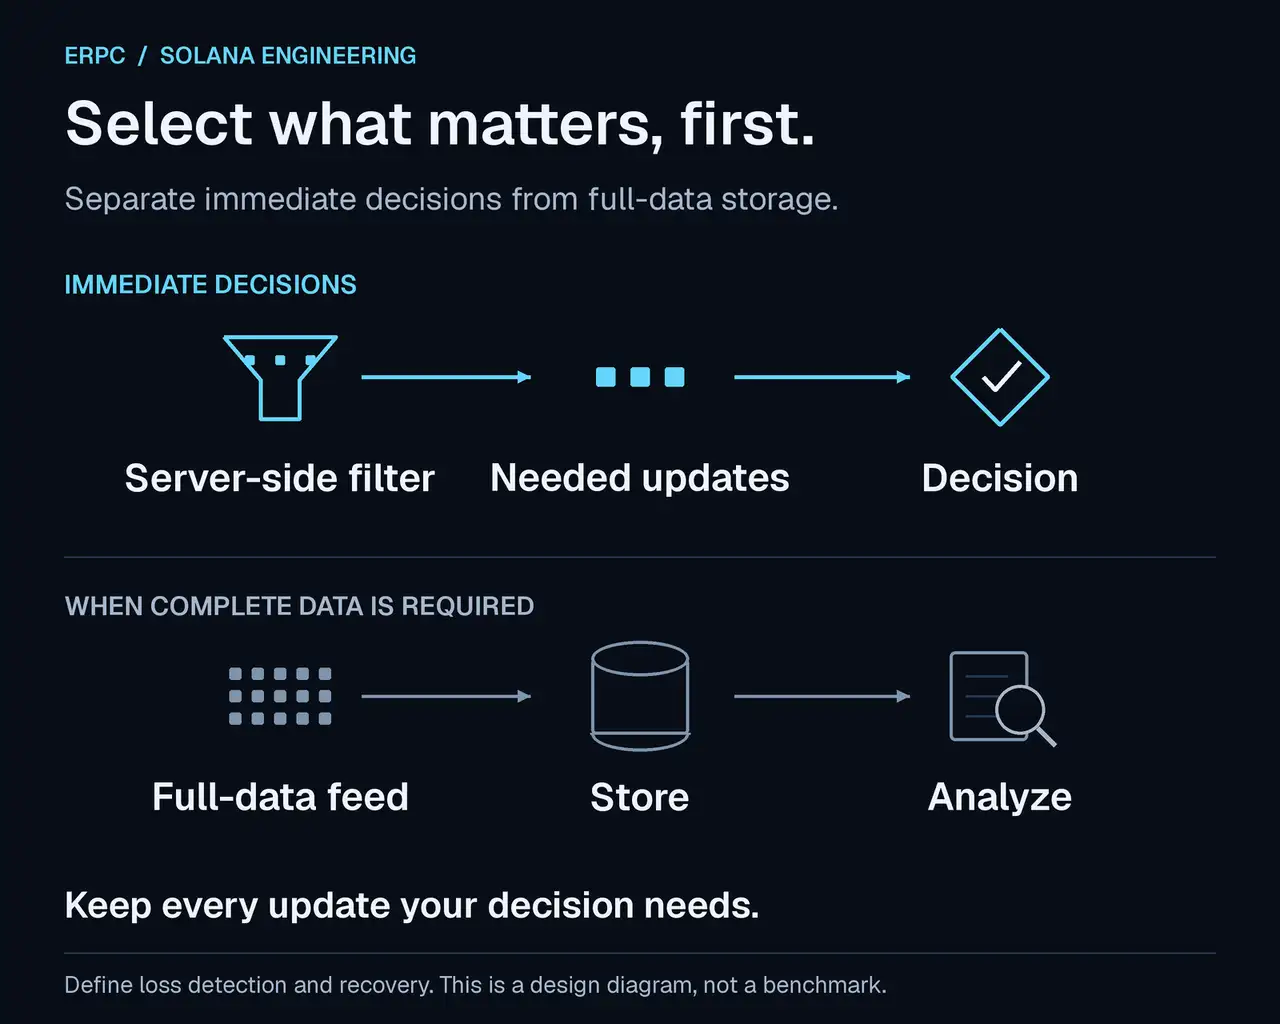
Usare un percorso per gli aggiornamenti necessari alle decisioni immediate e un altro per l'archiviazione e l'analisi complete. Il diagramma illustra un approccio architetturale. Verificare che i filtri mantengano lo stato necessario a decisioni corrette e definire come recuperare dati mancanti.
Mito 7: se i dati arrivano, l'elaborazione sta tenendo il passo
Tra la ricezione dei dati e la loro elaborazione in uno stato utilizzabile per decidere può formarsi una coda. Se il lavoro in ingresso supera continuamente la capacità di elaborazione, il ritardo si accumula anche con la connessione aperta. Un buffer più grande può assorbire picchi temporanei, ma in presenza di un deficit persistente di elaborazione contiene semplicemente più dati vecchi.
Consideriamo un esempio ipotetico che parte senza lavoro in attesa. L'applicazione riceve 12.000 eventi dello stesso tipo al secondo e completa l'elaborazione di 10.000 eventi al secondo. Se può conservare tutti gli eventi nella coda senza scartarli né accorparli, il lavoro in attesa cresce di 2.000 eventi al secondo e raggiunge 20.000 dopo 10 secondi. La connessione resta attiva e i dati continuano ad apparire, mentre il lavoro necessario alle decisioni rimane indietro. Questi numeri illustrano il meccanismo; non sono misurazioni delle prestazioni di ERPC.
Non misurare soltanto il numero di eventi ricevuti. Misurare anche il lavoro completato, la lunghezza della coda, l'età dell'elemento non elaborato più vecchio e il tempo dalla ricezione al completamento della decisione. Monitorare separatamente lo stato della connessione e la freschezza dei dati.
Nel ciclo di ricezione, mantenere solo il lavoro necessario a continuare a ricevere. Valutare lo spostamento di scritture su database, logging dell'intero payload, chiamate API esterne e calcoli pesanti su percorsi distinti. Imporre un limite alla capacità delle code e definire cosa accade quando sono piene. Anche una coda limitata può far attendere il lavoro a monte una volta piena; da sola non risolve una capacità di elaborazione insufficiente. [10]
Per gli aggiornamenti in cui conta solo lo stato più recente, può essere possibile accorpare gli stati precedenti. Gli eventi di transazione che richiedono elaborazione ordinata o completa non vanno scartati indiscriminatamente. Progettare rilevamento delle lacune, replay e recupero dello stato dopo la riconnessione in base ai requisiti dell'applicazione.
STREAM_GUARD_SLOW_READER di ERPC è una risposta protettiva a progressi insufficienti nella scrittura o a un ritardo osservato nella consegna. Questa osservazione, da sola, non identifica la causa. Esaminare connessione, host, volume delle sottoscrizioni e velocità di consumo dell'applicazione. Prima di riconnettersi, conservare il primo stato, messaggio, metadati e trailer quando disponibili, quindi leggere il motivo e le condizioni di retry forniti dal server. Reinviare la stessa richiesta rifiutata senza correggerla lascia intatta la causa. [7]Mito 8: un ping o una media rapidi significano che l'applicazione è veloce quando serve
Il ping dà un'indicazione del tempo di andata e ritorno della rete. Misura un intervallo diverso dalla latenza dell'applicazione, che comprende elaborazione alla fonte, contenuto delle sottoscrizioni, attese di ricezione, decodifica e decisione. Una media può anche nascondere un piccolo numero di ritardi considerevoli.
p50 è la mediana. p95 e p99 indicano i valori al di sotto dei quali, o pari ai quali, si trova rispettivamente il 95% e il 99% delle misurazioni. p99 non è il massimo. Includere numero di campioni e periodo di misurazione e controllare valori durante i picchi di eventi, massimi, timeout, disconnessioni e dati mancanti. [11]
Nel confrontare fornitori, usare lo stesso evento, tipo di dati, commitment e condizioni di sottoscrizione. Se possibile, ricevere sullo stesso host di misurazione e utilizzare un clock monotono per i tempi trascorsi nell'applicazione. Quando si sottraggono timestamp di host diversi, considerare le differenze tra gli orologi che possono alterare la misura.
Conservare solo gli eventi riusciti può far apparire veloce una configurazione con frequenti dati mancanti. Scegliere il singolo risultato più rapido e scegliere una configurazione che rischia meno di rimanere indietro quando serve in produzione sono decisioni diverse.
Mito 9: i dati più precoci hanno la stessa definitività e lo stesso significato
Shreds, notifiche di transazione, aggiornamenti di account e notifiche di blocco non rappresentano le stesse informazioni nella stessa fase. L'utilizzo di dati di una fase precedente può lasciare all'applicazione più lavoro di ricostruzione o interpretazione. Un confronto deve allineare non solo l'istante di ricezione, ma anche ciò che è possibile sapere in quel momento. [8][12]
Distinguere anche i livelli di commitment di Solana:
processed, confirmed e finalized. Se le osservazioni iniziali guidano le decisioni, l'applicazione deve verificarne successivamente lo stato di conferma e correggere il proprio stato quando necessario. Separare la ricezione di un aggiornamento precoce dalle condizioni per compiere un'azione definitiva in un sistema esterno. [13]Per esempio, confrontare semplicemente notifiche ricevute a commitment diversi e dichiarare che una arriva un certo numero di millisecondi prima non confronta lo stesso lavoro. Stabilire le informazioni e il grado di conferma richiesti dall'applicazione, quindi misurare il tempo necessario per essere pronti a decidere in quelle condizioni.
Mito 10: un invio riuscito significa che la transazione verrà eseguita per prima
Una risposta positiva di
sendTransaction significa che l'RPC ha accettato la transazione. Non ne garantisce l'elaborazione né la conferma da parte del cluster. La specifica Solana richiede esplicitamente di verificare separatamente lo stato della firma. [14]Anche quando le informazioni ricevute consentono una decisione anticipata, contano ancora percorso di invio, validità del blockhash, contesa sugli account scrivibili, risorse di calcolo, commissioni di priorità e condizioni di successo della transazione stessa. SWQoS riguarda l'ammissione e la priorità delle connessioni verso il leader, mentre le commissioni di priorità influiscono sulla priorità di pianificazione. Sono ruoli diversi e nessuno dei due garantisce incondizionatamente ordine di esecuzione o successo. [15][16]
Registrare separatamente completamento della decisione, inizio dell'invio, accettazione RPC, risultati dell'esecuzione e stato di conferma richiesto. Nei retry, distinguere anche tra reinviare una transazione con la stessa firma e costruirne una nuova, evitando così azioni duplicate involontarie.
Solo osservando l'intero percorso dalla ricezione alla conferma è possibile identificare il miglioramento che avvicina all'obiettivo.
Le prime misurazioni da impostare
Iniziare con questi tre controlli.
- Scegliere una decisione e annotare quali aggiornamenti richiede e quale stato deve essere disponibile prima che l'applicazione possa decidere.
- Nello stesso periodo di misurazione, registrare il numero di eventi ricevuti, di eventi la cui elaborazione è completata e di eventi ancora in attesa, tutti dello stesso tipo. Se il lavoro è in coda, misurare anche il tempo trascorso da quando l'applicazione ha ricevuto l'evento in attesa più vecchio.
- Se il lavoro in attesa o il tempo di attesa continua ad aumentare, individuare dove si accumula. Scegliere una modifica pertinente a sottoscrizioni, elaborazione, impostazioni o ambiente di esecuzione e confrontare i risultati prima e dopo.
Il tempo misurato dalla ricezione nell'applicazione rivela l'attesa al suo interno. Misurare separatamente il ritardo dall'evento originario alla ricezione nell'applicazione. Dopo aver raccolto queste prime misurazioni, usare la tabella seguente per ampliare i controlli.
| Fase | Cosa registrare | Cosa aiuta a identificare |
|---|---|---|
| Rete e ricezione | Throughput effettivo di ricezione, ritrasmissioni e perdite, differenze di arrivo dello stesso evento | Vincoli di instradamento, banda e impostazioni di ricezione |
| Applicazione | Conteggi di eventi ricevuti ed elaborati, lunghezza della coda, età dell'elemento più vecchio | Deficit persistenti di elaborazione e accumulo di dati obsoleti |
| Tempo alla decisione | p50, p95, p99 e massimo dalla ricezione al completamento della decisione | Lavoro costoso e ritardi durante i picchi |
| Invio e conferma | Inizio dell'invio, accettazione RPC, stato della firma, errori di esecuzione | Ritardi e fallimenti dopo la ricezione |
| Condizioni di confronto | Regione, host, SDK e versione, sottoscrizione, commitment, periodo e numero di campioni | Differenze apparenti dovute a condizioni diverse |
Conservare una misura di riferimento, poi verificare una modifica alla volta in base ai sintomi: ampiezza delle sottoscrizioni, separazione dell'elaborazione, impostazioni del client, posizione o risorse. Se si allarga una finestra, controllare anche l'aumento di memoria e arretrato. Se si restringe una sottoscrizione, verificare che non siano andate perse informazioni necessarie.
Il p99 del tempo totale non si calcola sommando semplicemente i p99 delle singole fasi. Calcolarlo sul tempo totale di ogni evento corrispondente e usare le misurazioni delle fasi per individuare le cause. Eseguire test sia durante picchi reali di eventi sia con carico medio.
ERPC prepara l'infrastruttura, così gli sviluppatori possono affinare la logica
Quando reti, server, distribuzione dei dati e client vengono scelti separatamente, possono rimanere attese nei passaggi tra di essi, anche se ciascuno ha buone specifiche. ERPC riunisce su una piattaforma distribuzione dei dati Solana e ambienti di elaborazione, riducendo il lavoro ripetuto per scegliere da zero posizione e risorse.
Le offerte SUPER VPS e Premium VPS prevedono configurazioni ad alto clock e assegnazione delle risorse senza overcommitment, mentre Bare Metal offre una macchina fisicamente dedicata. ERPC avvicina reti e server al proprio ambiente di distribuzione e prepara CPU, memoria, storage e connettività per un'elaborazione continuativa. Le specifiche dettagliate sono disponibili per ogni piano e regione. [17][18]
| Ostacolo comune nello sviluppo | Infrastruttura e informazioni disponibili tramite ERPC | Cosa affinare nell'applicazione |
|---|---|---|
| Distanza che i nomi delle città non rivelano | Configurazioni regionali e di rete che consentono di scegliere insieme distribuzione ed elaborazione | Misurare istanti di arrivo e variazioni con le proprie sottoscrizioni |
| Contesa delle risorse e prestazioni continuative | SUPER VPS e Premium VPS ad alto clock senza overcommitment e Bare Metal dedicato | Identificare il lavoro costoso e l'elaborazione sequenziale |
| Volume dei dati e metodo di connessione | gRPC, Shreds, RPC e opzioni condivise o dedicate adatte al carico | Definire gli eventi e i campi necessari |
| Impostazioni di ricezione e diagnosi | Solana Stream SDK, esempi di configurazione, documentazione dei filtri e FAQ per errore | Verificare impostazioni effettive, code, riconnessione e recupero |
ERPC aiuta gli sviluppatori a procedere con selezione e configurazione dell'infrastruttura, lasciando più tempo per stabilire cosa osservare, quali informazioni usare per decidere e quando inviare. Con servizio e posizione adeguati, allineare volume delle sottoscrizioni e capacità di elaborazione trasforma le prestazioni dell'infrastruttura in velocità dell'applicazione.
Iniziare dalle informazioni realmente necessarie alle decisioni. Riceverle presto, elaborarle senza attese inutili e verificare il risultato. ERPC continuerà a fornire l'ambiente e le informazioni a supporto di questo miglioramento.
Risorse per l'implementazione
- FAQ gRPC di ERPC: https://erpc.global/it/faq/grpc/general/
- Filtri di sottoscrizione e limiti Shared attuali: https://erpc.global/it/doc/geyser-grpc/filter/
- Best practice per l'implementazione gRPC: https://erpc.global/it/doc/geyser-grpc/best-practices/
- Solana Stream SDK: https://github.com/ValidatorsDAO/solana-stream
- ERPC VPS: https://erpc.global/it/vps/
- ERPC Bare Metal: https://erpc.global/it/baremetal/
- ERPC Dashboard: https://dashboard.erpc.global/
- Discord ufficiale di Validators DAO: https://discord.gg/C7ZQSrCkYR
Riferimenti tecnici
- RIPE IPmap, visualizzazione delle inefficienze di instradamento: https://ipmap.ripe.net/
- AWS, banda di rete delle istanze: https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/ec2-instance-network-bandwidth.html
- Linux Kernel, CPU Performance Scaling: https://docs.kernel.org/admin-guide/pm/cpufreq.html
- Node.js, evitare il blocco dell'event loop: https://nodejs.org/en/learn/asynchronous-work/dont-block-the-event-loop
- IETF RFC 9113, controllo di flusso HTTP/2: https://httpwg.org/specs/rfc9113.html#FlowControl
- gRPC, Flow Control: https://grpc.io/docs/guides/flow-control/
- ERPC, impostazioni di ricezione, lettori lenti e retry nelle FAQ gRPC: https://erpc.global/it/faq/grpc/general/
- Yellowstone gRPC, specifiche di sottoscrizioni e filtri: https://github.com/rpcpool/yellowstone-grpc
- ERPC, regole attuali dei filtri Shared: https://erpc.global/it/doc/geyser-grpc/filter/
- Tokio, code e backpressure: https://tokio.rs/tokio/tutorial/channels
- AWS CloudWatch, definizioni dei percentili: https://docs.aws.amazon.com/AmazonCloudWatch/latest/monitoring/Statistics-definitions.html
- ERPC, Shreds UDP Forwarding: https://erpc.global/it/doc/shredstream/udp-forwarding/
- Solana, Transaction Confirmation & Expiration: https://solana.com/developers/cookbook/transactions/confirmation
- Solana, sendTransaction: https://solana.com/docs/rpc/http/sendtransaction
- Solana, Stake-weighted Quality of Service: https://solana.com/docs/defi/stake-weighted-qos
- Solana, commissioni delle transazioni: https://solana.com/docs/core/fees
- ERPC, configurazioni e specifiche VPS: https://erpc.global/it/vps/
- ERPC, configurazioni e specifiche Bare Metal: https://erpc.global/it/baremetal/