«¿Los datos de Solana llegan tarde o incompletos?» Qué revisar en tu infraestructura de recepción
Te suscribes a un flujo rápido de Shreds de Solana, pero apenas llegan unos pocos paquetes. Los Shreds que recibes se analizan correctamente, pero faltan demasiados fragmentos para extraer transacciones. gRPC funciona en el mismo servidor y no sabes dónde seguir buscando.
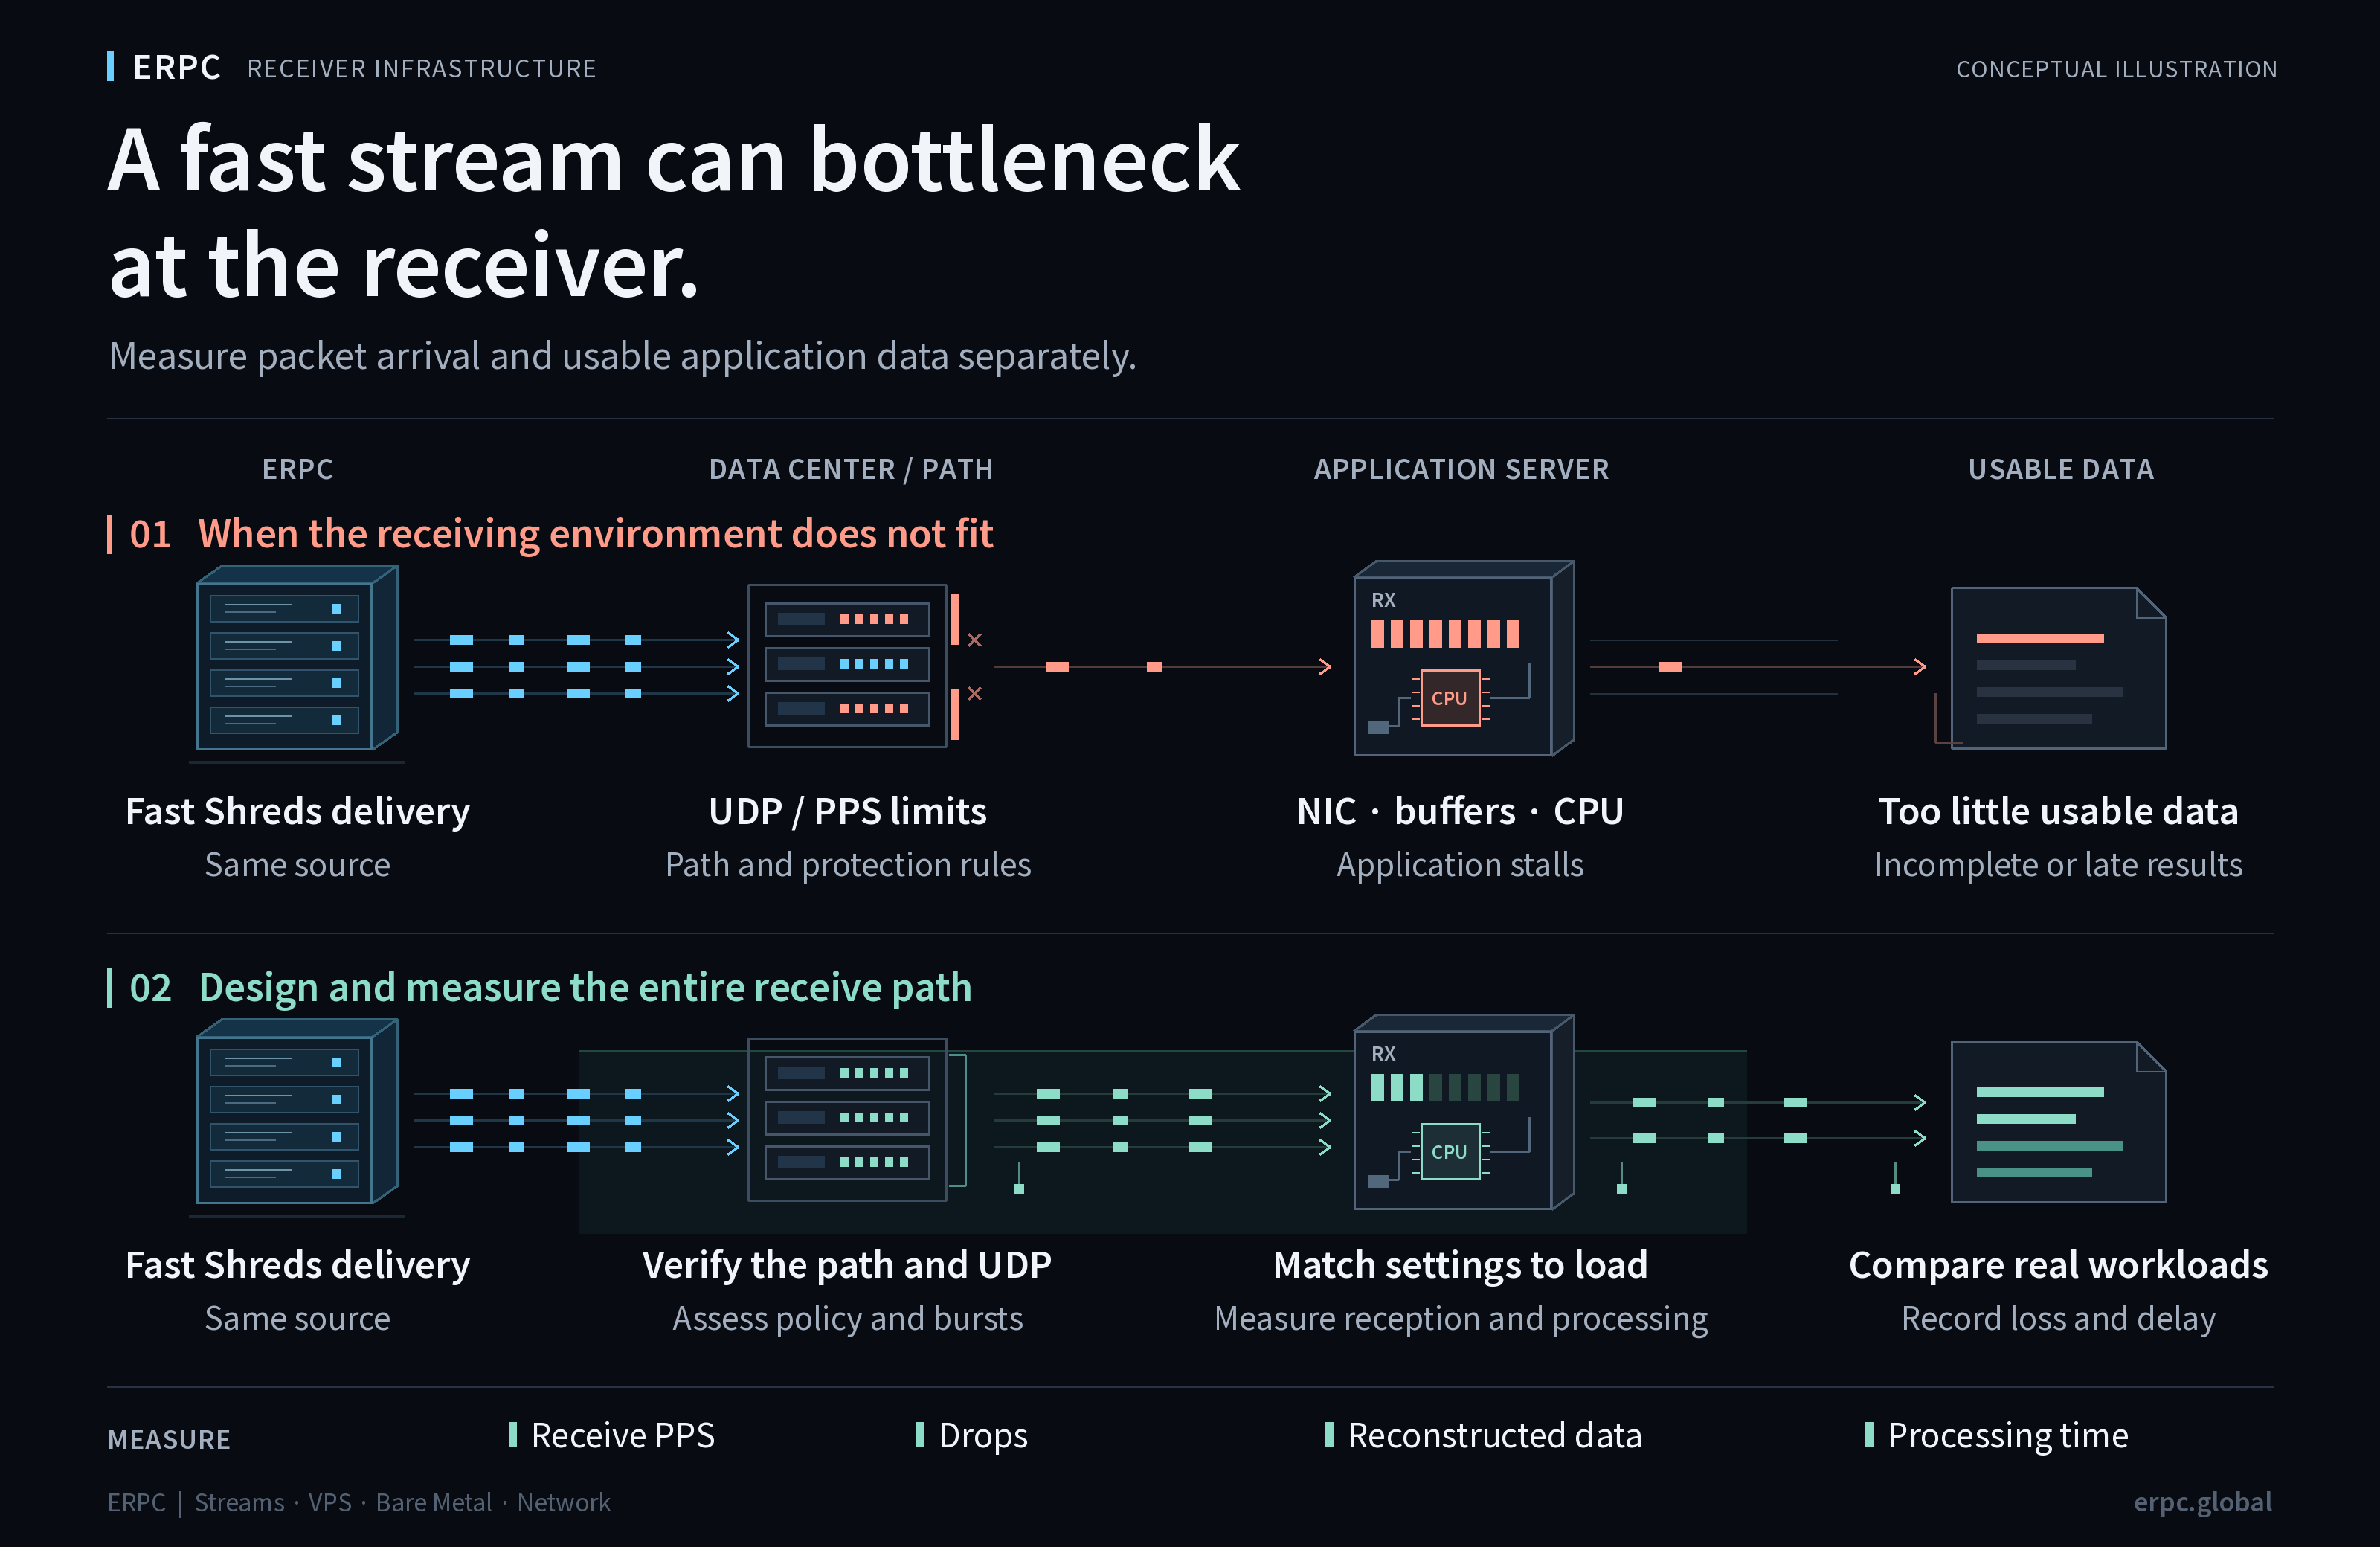
Además de comprobar el emisor, revisa tu servidor de aplicaciones y el centro de datos que lo aloja. Aunque ERPC reenvíe rápidamente los Shreds, las restricciones de UDP a lo largo de la ruta o los cuellos de botella de procesamiento en el servidor receptor pueden impedir que tu aplicación aproveche esa velocidad.
Elegir un flujo de Shreds implica tener en cuenta todo el recorrido: cómo llegan los paquetes y cómo se convierten en datos utilizables. La calidad de la red, la distancia y las políticas operativas de los centros de datos también son condiciones de rendimiento comunes a Geyser Yellowstone gRPC, al tráfico habitual de RPC y API y al envío de transacciones.
Los registros de envío y los datos recibidos utilizables reflejan hechos distintos
En una consulta reciente al soporte de ERPC, unas mediciones breves en el lado emisor registraron aproximadamente entre 3.400 y 3.900 paquetes/s. El receptor informó de unos 13 paquetes/s y de que no se había completado la reconstrucción de ningún slot.
Estas cifras proceden de periodos de medición distintos y no se ha confirmado que los métodos de medición sean comparables. Por tanto, no permiten determinar una tasa de entrega satisfactoria ni una tasa de pérdida. Los registros de envío por sí solos no demuestran la llegada de los paquetes, y la causa exacta sigue sin determinarse en el momento de redactar este artículo.
Unos pocos miles de PPS tampoco bastan, por sí solos, para determinar que un servidor de propósito general esté sometido a una carga inusualmente alta. Las cuestiones son qué ocurre en la ruta real, qué límites se aplican, cómo se concentra el tráfico en intervalos cortos, cómo se gestiona la recepción y qué mide cada contador.
Ambos en Fráncfort, pero con rutas de red diferentes
La fuente del flujo y tu servidor de aplicaciones pueden estar ambos en Fráncfort y, aun así, ocupar centros de datos distintos. En esa configuración, el tráfico puede salir de unas instalaciones, cruzar una red externa y entrar en las otras. Compartir la etiqueta de región no implica compartir instalaciones, operador de red ni el mismo conjunto de dispositivos intermedios.
Cuando los flujos o los servicios RPC de ERPC y un servidor VPS o Bare Metal de ERPC están ubicados en el mismo emplazamiento, los servidores que prestan los servicios y el servidor de aplicaciones se encuentran en racks cercanos, y la comunicación entre ellos permanece en la red interna. Esta es la idea de Zero-Distance Communication de ERPC: diseñar conjuntamente la ubicación física y la ruta hasta la aplicación receptora, más allá de elegir la misma ciudad.
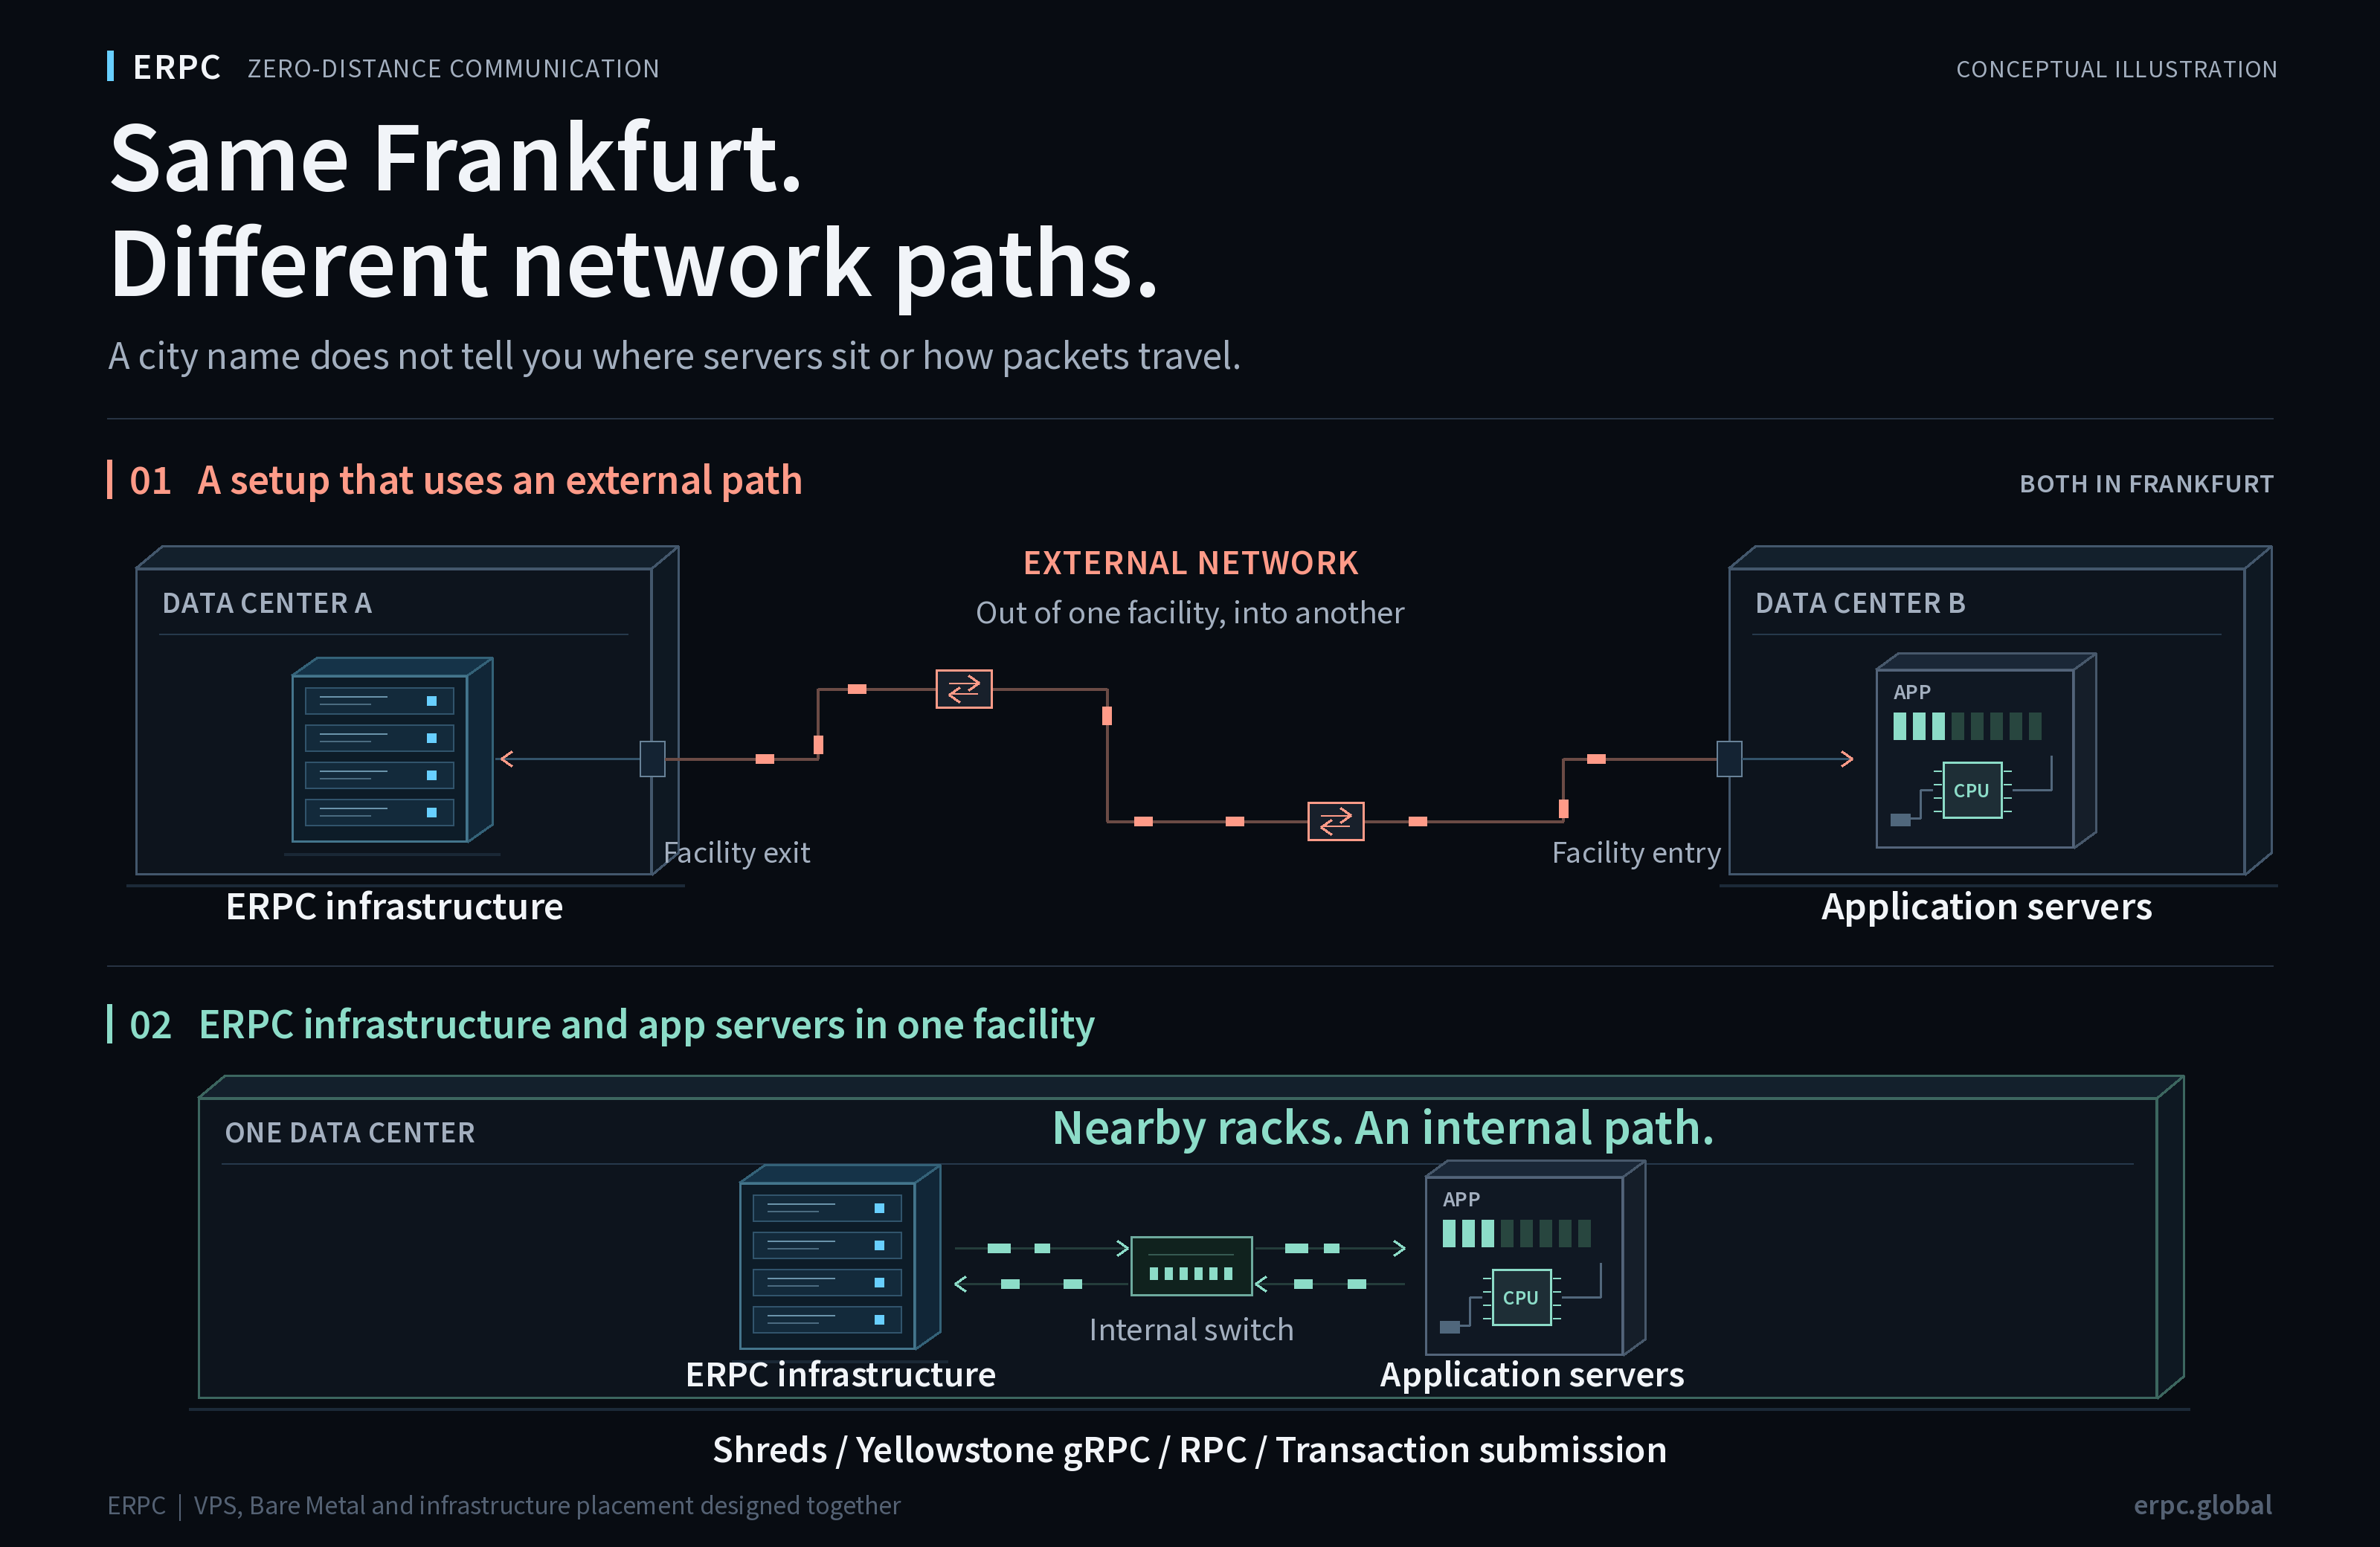
Evitar un desvío por una red externa entre los servicios de ERPC y el servidor de aplicaciones acorta la ruta y reduce, en ese tramo, la exposición a la congestión y a los cambios de ruta de las redes externas. Una ruta corta, junto con los recursos necesarios para la recepción y el procesamiento, sienta las bases para aprovechar un flujo rápido. Comprueba el resultado tanto en la llegada de los paquetes como en el procesamiento de la aplicación.
Las condiciones de la red afectan a todos los tipos de comunicación
Los fragmentos que faltan hacen visible el problema con los Shreds, pero la calidad de esa misma infraestructura afecta de forma más amplia a la recepción de datos, las solicitudes API y el envío de transacciones. El protocolo cambia los síntomas que observa la aplicación y los puntos que conviene medir.
| Comunicación | Dónde se manifiestan los efectos de la red | Qué comprobar en la aplicación |
|---|---|---|
| Shreds / UDP | Pérdida y retraso de paquetes, y llegada de los fragmentos necesarios para la reconstrucción | Shreds válidos y tiempo hasta poder reconstruir los datos |
| Geyser Yellowstone gRPC | Esperas por retransmisiones TCP, acumulación de datos en el flujo y retrasos | Tiempo hasta recibir y procesar la misma actualización |
| RPC, API y tráfico entre servicios | Recorridos de ida y vuelta de las solicitudes y las respuestas, y esperas durante la congestión | Tiempo de respuesta y su variación |
| Envío de transacciones | Ruta de la solicitud hasta el nodo receptor | Tiempo entre la solicitud de envío y la respuesta del nodo |
Una ubicación cercana y unas políticas operativas adecuadas favorecen todo este tráfico. Mide por separado el tiempo de respuesta del nodo receptor y el tiempo hasta que una transacción se incluye y se finaliza en la cadena.
Los Gbps no lo dicen todo sobre los PPS y las ráfagas
El ancho de banda describe cuántos datos pueden transportarse a lo largo del tiempo. Los PPS indican el número de paquetes procesados cada segundo. Una conexión puede tener ancho de banda disponible y, a la vez, alcanzar un límite de paquetes por segundo o una restricción aplicada a UDP. La propia documentación de los proveedores de nube trata los límites de ancho de banda y de PPS como restricciones distintas.[1]
Los Shreds no llegan necesariamente a un ritmo uniforme. Una ráfaga puede ejercer una presión sobre las colas que el promedio oculta. Si los paquetes se acumulan más rápido de lo que un dispositivo de red o el receptor puede procesarlos, los que superen la capacidad de la cola pueden descartarse.[2]
Consulta a tu proveedor de alojamiento sobre la recepción sostenida de UDP, las ráfagas breves, los límites de PPS y las reglas aplicadas por la protección DDoS. El objetivo es establecer condiciones que admitan de forma segura el tráfico necesario, en lugar de desactivar la protección indiscriminadamente.
Que gRPC funcione no demuestra que la recepción UDP funcione
gRPC basado en TCP y los Shreds en bruto transmitidos por UDP utilizan mecanismos de transporte distintos. TCP ofrece retransmisión y entrega ordenada, mientras que gRPC en streaming dispone de control de flujo que tiene en cuenta la capacidad del receptor. UDP, por sí mismo, no retransmite los paquetes que faltan ni hace esperar al emisor hasta que la aplicación receptora se ponga al día.[3]
Por tanto, que gRPC funcione en un servidor no demuestra que la ruta UDP o el receptor funcionen correctamente. Hay que comprobar por separado los filtros específicos del protocolo, los puertos, las rutas de entrega y las implementaciones del receptor. Los retrasos en el procesamiento de gRPC también pueden manifestarse como tiempos de espera o desconexiones.
Las transacciones/s de gRPC y los paquetes/s de UDP miden unidades distintas en etapas de procesamiento diferentes. No se pueden comparar directamente para calcular el volumen entregado o una tasa de pérdida.
De la llegada de paquetes a los datos utilizables
Con un receptor que utiliza un socket UDP estándar, los paquetes que llegan pasan por la tarjeta de red (NIC), el kernel y el búfer de recepción del socket antes de llegar a la aplicación. Si el procesamiento se retrasa, pueden descartarse después de haber llegado al host. Los contadores de recepción de las interfaces de Linux incluyen paquetes descartados en etapas posteriores, por lo que un contador de recepción creciente, por sí solo, no demuestra que los paquetes se entreguen a la aplicación.[4]
Una cola de recepción individual o un núcleo de CPU pueden estar muy ocupados aunque la utilización global de la CPU sea baja. Revisa las colas de la NIC, la asignación de interrupciones y el rendimiento de un solo núcleo. En la aplicación, separa la recepción del trabajo posterior cuando corresponda y mantén fuera del bucle de recepción los análisis que consumen muchos recursos y la generación excesiva de registros. Un búfer de recepción mayor puede absorber ráfagas temporales; no puede resolver un déficit sostenido de capacidad de procesamiento.[5]
Los Shreds son fragmentos de datos de bloques. La corrección de errores hacia adelante (FEC) puede recuperar los datos que faltan mediante Shreds de datos y de codificación del mismo grupo, pero la reconstrucción sigue requiriendo suficientes fragmentos. Más paquetes duplicados no sustituyen a los fragmentos que faltan.[6]
Según la implementación, un receptor puede reconstruir entradas a partir de los fragmentos disponibles antes de que se complete todo el slot.[9] Además del número total de paquetes, mide el número de Shreds únicos y válidos, los datos reconstruidos y el tiempo hasta que la aplicación reconoce el evento que necesita.
Mide cada etapa durante la misma ventana de tiempo
Alinea el destino, el puerto y la ventana de medición en ambos extremos. Registrar por separado las siguientes etapas ayuda a acotar la siguiente investigación.
| Punto de medición | Qué registrar | Qué permite determinar |
|---|---|---|
| Emisor | Registros correspondientes al destino objetivo y definición del contador | Qué etapa del envío se observó |
| Entrada del host receptor | Captura del tráfico UDP objetivo, estadísticas de la NIC y pérdidas de captura | Cuánto tráfico era visible en ese punto de observación |
| SO y socket | Errores UDP, pérdidas en el búfer de recepción y cambios en las colas | Si la recepción está acumulando retraso dentro del host |
| Reconstrucción de Shreds | Shreds únicos y válidos, reconstrucciones correctas, datos ausentes y errores | Si los paquetes permiten obtener los datos necesarios |
| Aplicación | Trabajo de procesamiento pendiente y marcas de tiempo de detección del mismo evento | Si la velocidad de llegada se traslada a la aplicación |
Si una captura muestra pocos paquetes, comprueba primero el filtro, la interfaz observada, las pérdidas de captura y los descartes de la NIC. Algunos contadores del SO abarcan todo el host o el espacio de nombres de red; comprueba su alcance y relaciónalos con las mediciones de la aplicación objetivo.[4][5]
Cambia la configuración después de identificar la etapa que presenta la limitación. Aumentar solo el tamaño de un búfer o de un anillo puede desplazar el cuello de botella o añadir tiempo de espera. La configuración actual del receptor de ERPC y las comprobaciones están documentadas aquí:
Elige la política operativa además del servidor
Solana Foundation explica la importancia del control sobre las NIC, los núcleos físicos, los controladores y la red para los validadores de alto rendimiento. Esos requisitos de un validador completo no deben aplicarse íntegramente a todos los receptores de Shreds. Una aplicación receptora necesita una configuración adecuada para su propio flujo y su carga de procesamiento.[7]
Reducir costes o consumo eléctrico es un objetivo operativo razonable. Las aplicaciones HFT y en tiempo real también necesitan una respuesta rápida de la CPU, capacidad de procesamiento sostenida y esperas de red cortas. Salir de un estado de ahorro de energía puede suponer una contrapartida en términos de latencia.[8]
Además de los modelos de CPU y el número de núcleos, comprueba cómo se comparten los recursos, cómo se gestiona la carga sostenida, las condiciones del tráfico UDP y la ruta real de la red.
ERPC considera conjuntamente el flujo y el entorno de recepción
ERPC trabaja en la selección de centros de datos cercanos a la infraestructura de Solana, las rutas de red, el hardware y la configuración operativa, y ofrece VPS y Bare Metal junto con Shreds y gRPC. Puedes elegir un VPS en función de tu carga de procesamiento y comparar Bare Metal cuando quieras recursos físicos exclusivos.
Conocer la configuración y el funcionamiento de los entornos que proporcionamos también facilita la resolución de problemas técnicos. Podemos comparar los registros de envío con las mediciones del receptor e identificar comprobaciones concretas para la red, el SO o la aplicación. En la consulta aquí descrita, comprobamos las mediciones de envío y solicitamos mediciones adicionales del receptor.
Evaluar conjuntamente el flujo, la ubicación del receptor y la implementación de la aplicación facilita identificar qué falta entre el servicio que elegiste y los datos que necesitas.
Compara tu entorno actual con facturación por hora
Si tienes dudas sobre tu entorno de recepción, prueba un VPS o un servidor Bare Metal de ERPC con facturación por hora y compara utilizando el mismo flujo y la misma aplicación. Consulta el panel de control para conocer los precios actuales, la disponibilidad y las condiciones de contratación en tu región preferida.
Empieza con una configuración disponible y registra los recuentos de recepción, los datos reconstruidos, el trabajo de procesamiento pendiente y las marcas de tiempo de detección de los mismos eventos. Al comparar marcas de tiempo entre hosts, comprueba también la precisión de la sincronización de los relojes. Repite la prueba en distintos momentos y compara en qué puntos de la ruta difieren los resultados. Utiliza esas mediciones para elegir un servidor y un centro de datos adecuados para tu aplicación.
- VPS: https://erpc.global/es/vps/
- Bare Metal: https://erpc.global/es/baremetal/
- Panel de control: https://dashboard.erpc.global/es/
Artículos relacionados
- Solana Stream SDK v4.0.0: https://erpc.global/es/news/2026/11/07/erpc-solana-stream-sdk-v4-20261107/
- [9] Shreds UDP Forwarding Premium: https://erpc.global/es/news/2026/11/03/erpc-shreds-udp-forwarding-premium-20261103/
- Discord oficial de Validators DAO: https://discord.gg/C7ZQSrCkYR
Referencias técnicas
- [1] Límites de ancho de banda y PPS de AWS EC2: https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/monitoring-network-performance-ena.html
- [2] Directrices de uso de UDP de la IETF, ráfagas: https://www.rfc-editor.org/rfc/rfc8085.html#section-3.1.6
- [3] UDP en Linux: https://man7.org/linux/man-pages/man7/udp.7.html
- [3] TCP en Linux: https://man7.org/linux/man-pages/man7/tcp.7.html
- [3] Control de flujo de gRPC: https://grpc.io/docs/guides/flow-control/
- [4] Estadísticas de interfaces de Linux: https://docs.kernel.org/networking/statistics.html
- [4] Comportamiento y pérdidas de captura de libpcap: https://github.com/the-tcpdump-group/libpcap/blob/master/doc/README.linux
- [5] Escalado en la pila de red de Linux: https://docs.kernel.org/networking/scaling.html
- [5] Búferes de recepción de sockets de Linux: https://man7.org/linux/man-pages/man7/socket.7.html
- [5] Red Hat, investigación de descartes UDP: https://docs.redhat.com/en/documentation/red_hat_enterprise_linux/10/html/network_troubleshooting_and_performance_tuning/tuning-udp-connections
- [6] Anza, propagación de bloques con Turbine: https://docs.anza.xyz/consensus/turbine-block-propagation/
- [7] Solana Foundation, hardware para validadores de alto rendimiento: https://solana.com/news/high-performance-solana-validators-run-on-bare-metal-hardware
- [8] Gestión del tiempo de inactividad de la CPU en Linux: https://docs.kernel.org/admin-guide/pm/cpuidle.html