« Les données Solana sont lentes ou incomplètes ? » Que vérifier dans votre infrastructure de réception
Vous vous abonnez à un flux rapide de Shreds Solana, mais les paquets n’arrivent qu’au compte-gouttes. Les Shreds reçus sont analysés correctement, mais il manque trop de fragments pour en extraire les transactions. gRPC fonctionne sur le même serveur, et vous ne savez pas où chercher ensuite.
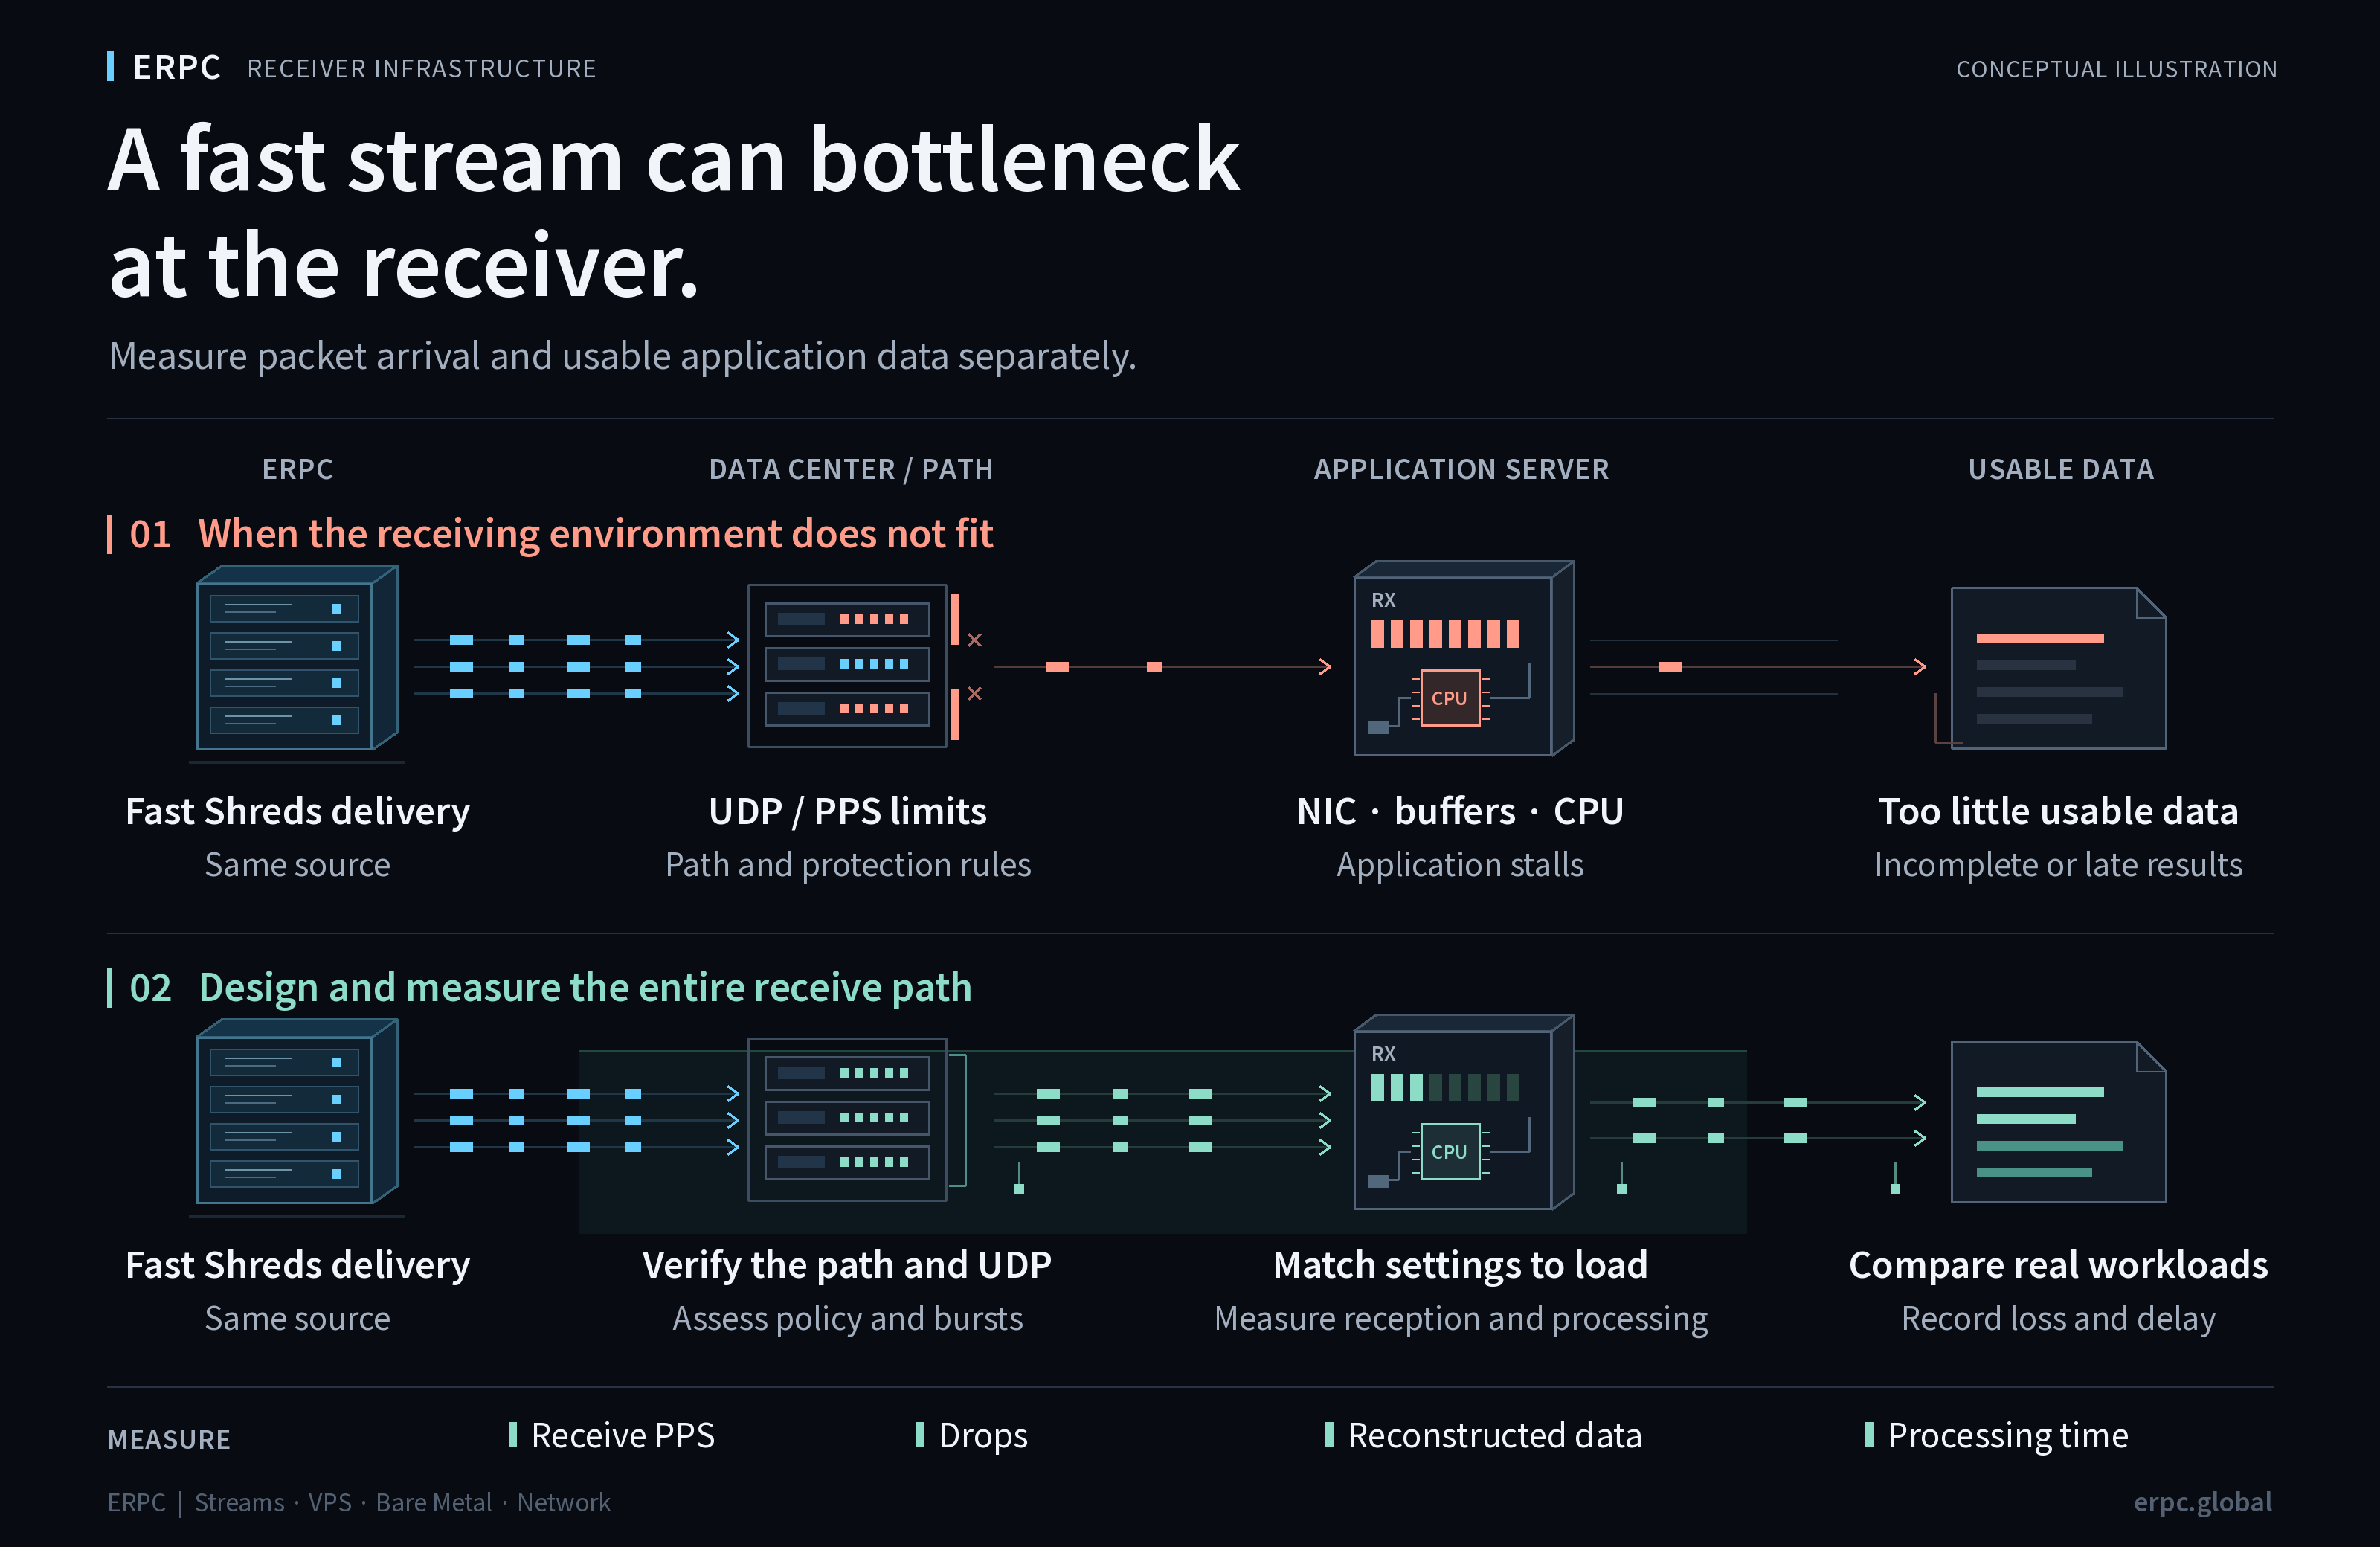
En plus de vérifier l’émetteur, examinez votre serveur applicatif et le centre de données qui l’héberge. Même lorsqu’ERPC transmet rapidement les Shreds, des restrictions UDP sur le chemin ou des goulots d’étranglement dans le traitement sur le serveur de réception peuvent empêcher votre application de tirer parti de cette rapidité.
Choisir un flux de Shreds nécessite de considérer l’ensemble du chemin : la manière dont les paquets arrivent et celle dont ils deviennent des données exploitables. La qualité du réseau, la distance et les politiques d’exploitation des centres de données sont également des facteurs de performance communs à Geyser Yellowstone gRPC, au trafic RPC et API courant et à l’envoi de transactions.
Les relevés d’émission et les données reçues exploitables sont deux constats distincts
Lors d’une récente demande d’assistance auprès d’ERPC, des mesures réalisées sur de courtes périodes côté émission ont relevé environ 3 400 à 3 900 paquets/s. Le récepteur a signalé environ 13 paquets/s et aucune reconstruction complète de slot.
Ces chiffres proviennent de périodes de mesure différentes, et il n’a pas été confirmé que les méthodes de mesure étaient comparables. Ils ne permettent donc d’établir ni un taux de livraison réussie ni un taux de perte. Les relevés côté émission ne prouvent pas, à eux seuls, l’arrivée des paquets, et la cause exacte reste indéterminée au moment de la rédaction.
Quelques milliers de PPS ne suffisent pas non plus, à eux seuls, à établir qu’un serveur généraliste subit une charge inhabituellement élevée. Il faut déterminer ce qui se passe sur le chemin réellement emprunté, quelles limites s’appliquent, comment le trafic se concentre sur de courts intervalles, comment la réception est gérée et ce que mesure chaque compteur.
À Francfort dans les deux cas, mais avec des chemins réseau différents
La source de votre flux et votre serveur applicatif peuvent tous deux se trouver à Francfort tout en étant hébergés dans des centres de données distincts. Dans cette configuration, le trafic peut quitter un site, traverser un réseau externe et entrer dans l’autre. Une même désignation régionale ne garantit ni un même site, ni un même opérateur réseau, ni les mêmes équipements intermédiaires.
Lorsque les flux ou services RPC d’ERPC et un serveur VPS ou Bare Metal d’ERPC sont hébergés sur un même site, les serveurs qui fournissent les services et le serveur applicatif occupent des racks voisins, et les communications entre eux restent sur le réseau interne. C’est le principe de Zero-Distance Communication d’ERPC : concevoir conjointement l’implantation physique et le chemin jusqu’à l’application réceptrice, au-delà du simple choix d’une même ville.
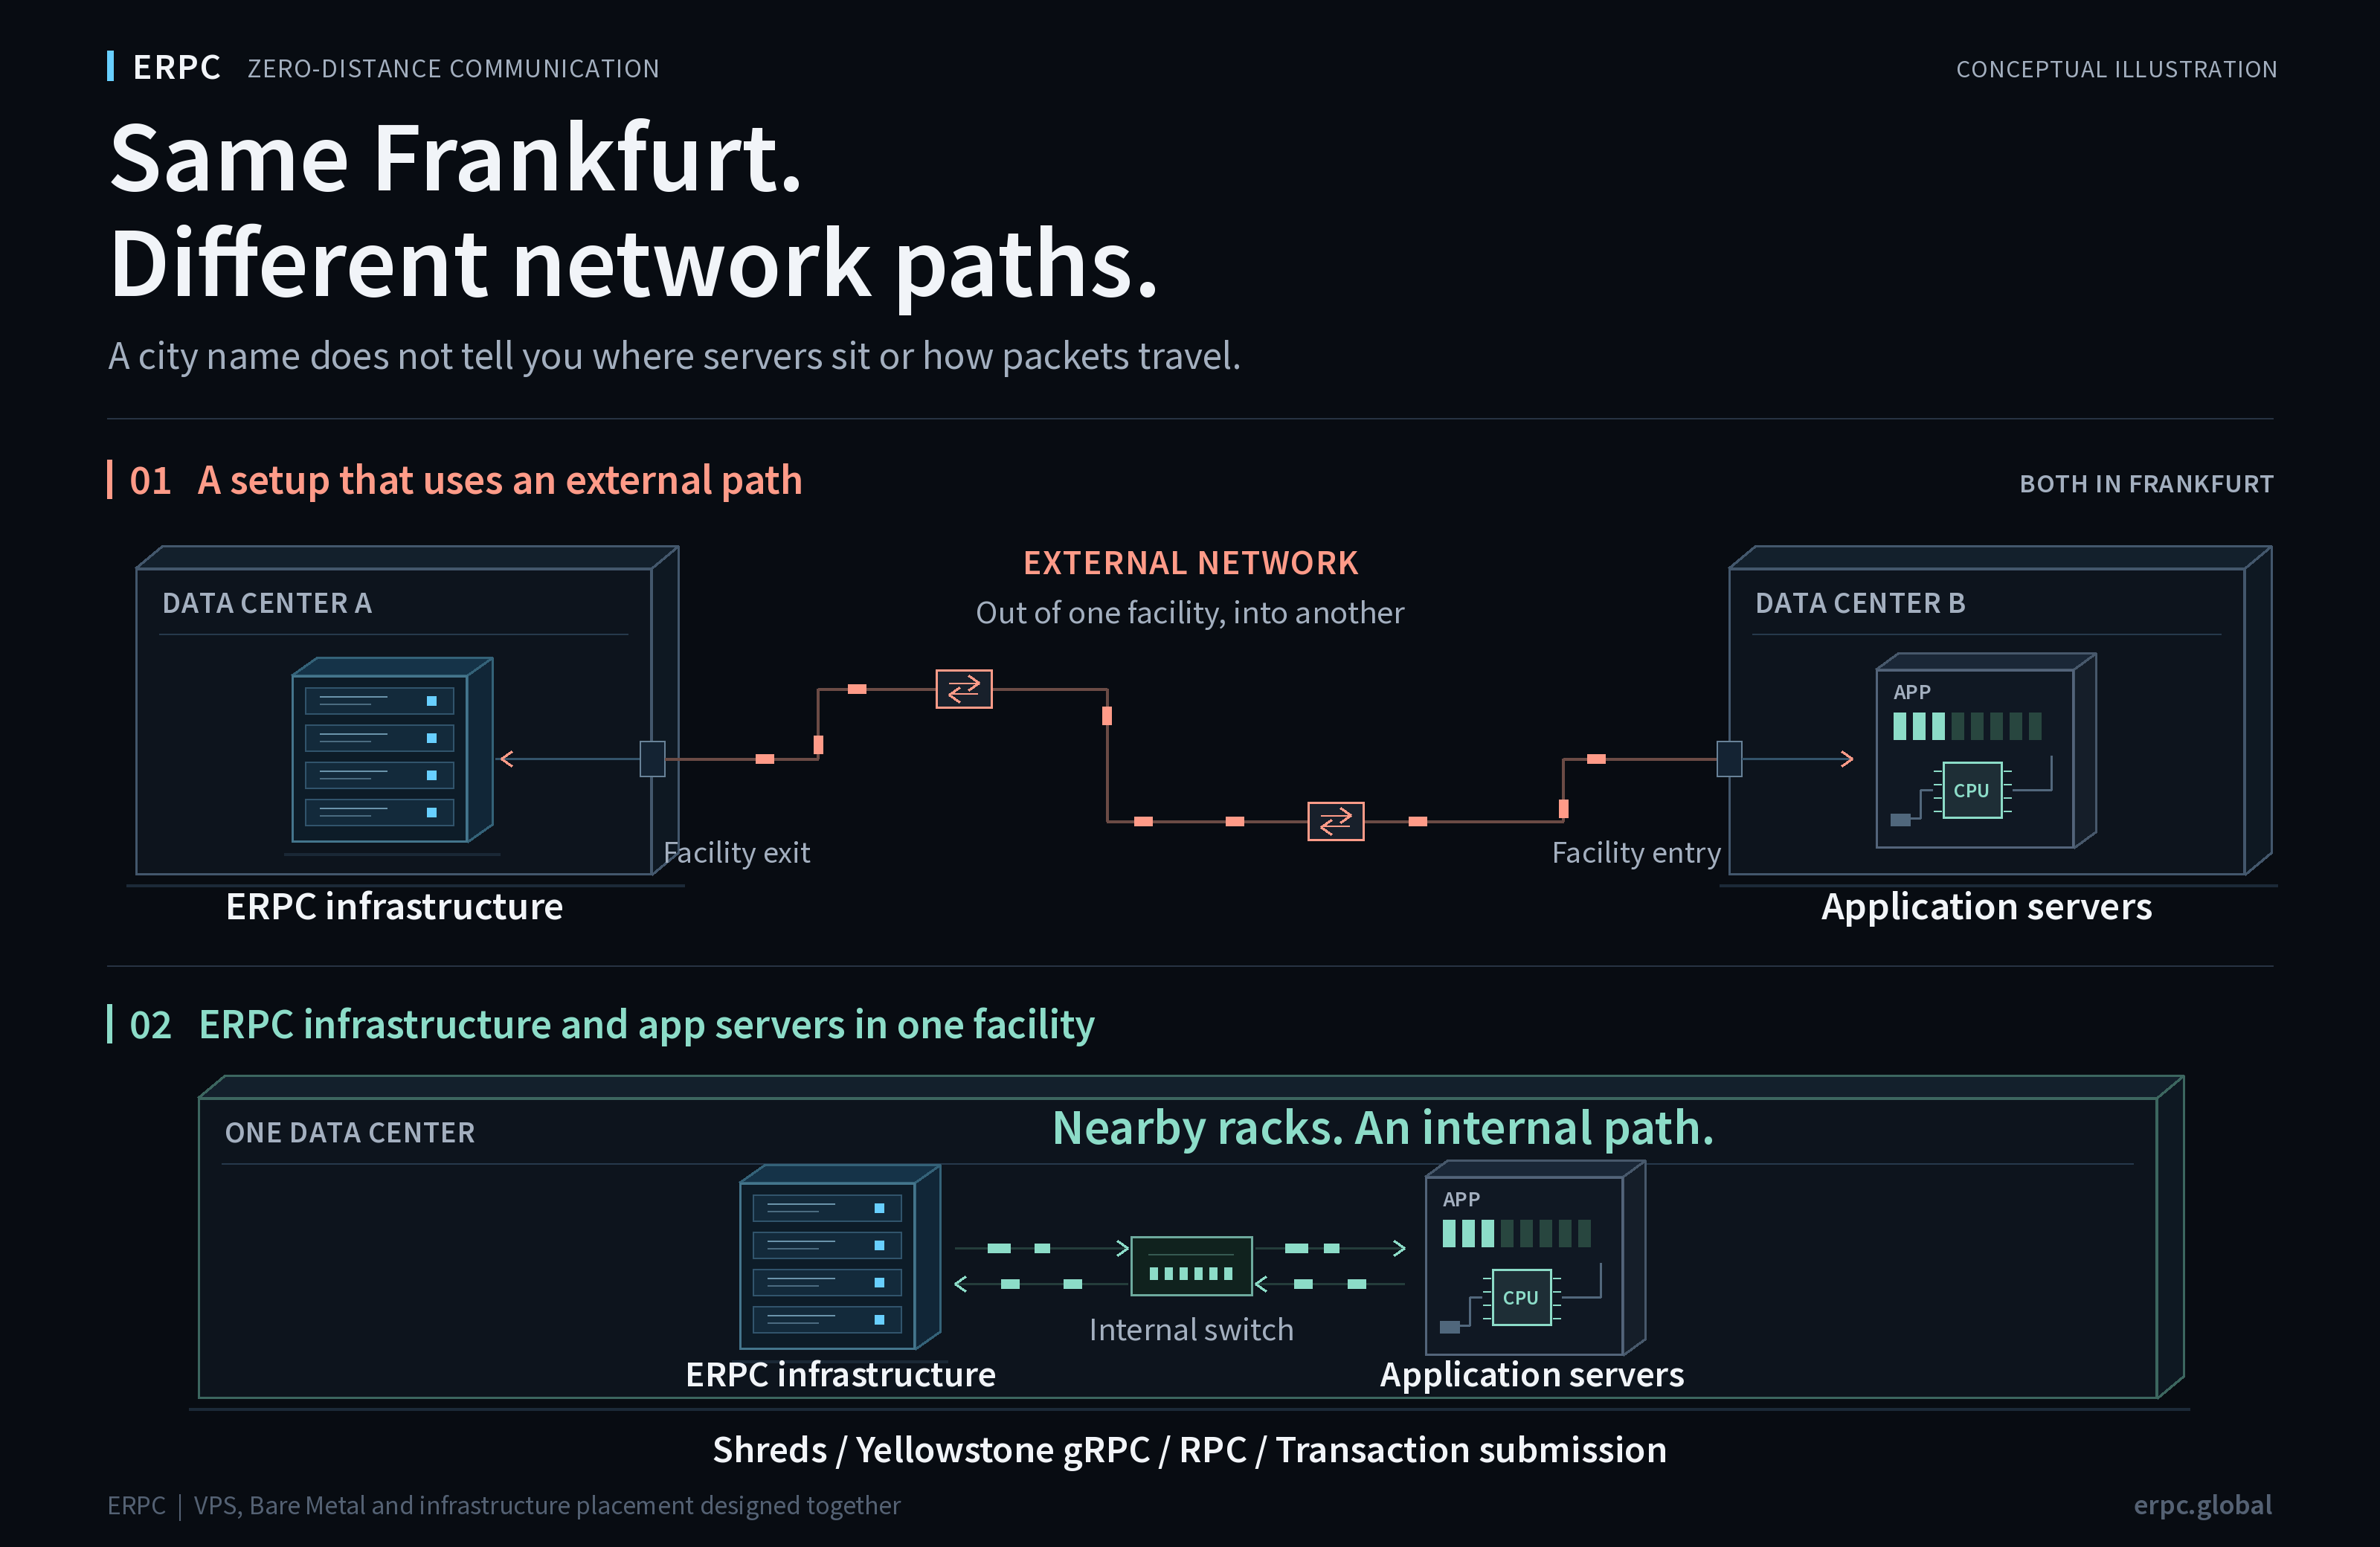
Éviter un détour par un réseau externe entre les services ERPC et le serveur applicatif raccourcit le chemin et réduit, sur ce segment, l’exposition à la congestion et aux changements de routage des réseaux externes. Un chemin court, associé aux ressources nécessaires à la réception et au traitement, constitue une base pour tirer parti d’un flux rapide. Vérifiez le résultat à la fois à l’arrivée des paquets et lors du traitement applicatif.
Les conditions réseau influencent tous les types de communication
Avec les Shreds, les fragments manquants rendent le problème visible, mais la qualité de cette même infrastructure influence plus largement la réception des données, les requêtes API et l’envoi de transactions. Le protocole fait varier les symptômes observés par l’application et les points qu’il est utile de mesurer.
| Communication | Où se manifestent les effets du réseau | Points à vérifier dans l’application |
|---|---|---|
| Shreds / UDP | Perte et retard de paquets, et arrivée des fragments nécessaires à la reconstruction | Shreds valides et délai avant de pouvoir reconstruire les données |
| Geyser Yellowstone gRPC | Attente liée aux retransmissions TCP, accumulation de données dans le flux et retard | Temps nécessaire pour recevoir et traiter la même mise à jour |
| RPC, API et trafic entre services | Allers-retours des requêtes et des réponses, et temps d’attente en cas de congestion | Temps de réponse et ses variations |
| Envoi de transactions | Chemin de la requête jusqu’au nœud récepteur | Temps écoulé entre la requête d’envoi et la réponse du nœud |
Une implantation proche et des politiques d’exploitation adaptées favorisent l’ensemble de ces communications. Mesurez séparément le temps de réponse du nœud récepteur et le délai jusqu’à l’inclusion puis la finalisation d’une transaction sur la chaîne.
Le débit en Gbps ne dit pas tout sur les PPS et les rafales
La bande passante décrit la quantité de données pouvant être transportée dans un intervalle de temps. Les PPS décrivent le nombre de paquets traités chaque seconde. Une connexion peut disposer de bande passante inutilisée tout en atteignant une limite de débit en paquets ou une restriction appliquée à UDP. La documentation des fournisseurs cloud eux-mêmes traite les plafonds de bande passante et de PPS comme des contraintes distinctes.[1]
Les Shreds n’arrivent pas nécessairement à un rythme régulier. Une rafale peut exercer sur les files d’attente une pression que la moyenne masque. Si les paquets s’accumulent plus vite qu’un équipement réseau ou le récepteur ne peut les traiter, ceux qui dépassent la capacité de la file peuvent être abandonnés.[2]
Renseignez-vous auprès de votre hébergeur sur la réception UDP soutenue, les rafales courtes, les limites de PPS et les règles appliquées par la protection DDoS. L’objectif est de définir des conditions qui autorisent le trafic nécessaire en toute sécurité, plutôt que de désactiver la protection sans discernement.
Le bon fonctionnement de gRPC ne prouve pas celui de la réception UDP
gRPC, qui repose sur TCP, et les Shreds bruts transmis via UDP utilisent des mécanismes de transport différents. TCP assure la retransmission et la livraison dans l’ordre, tandis que gRPC en streaming dispose d’un contrôle de flux qui tient compte de la capacité du récepteur. UDP, à lui seul, ne retransmet pas les paquets manquants et ne force pas l’émetteur à attendre que l’application réceptrice rattrape son retard.[3]
Par conséquent, le bon fonctionnement de gRPC sur un serveur ne prouve pas que le chemin UDP ou le récepteur fonctionnent correctement. Les filtres propres au protocole, les ports, les chemins de livraison et les implémentations des récepteurs doivent faire l’objet de vérifications distinctes. Des retards de traitement gRPC peuvent aussi se manifester par des temps d’attente ou des déconnexions.
Le nombre de transactions/s en gRPC et le nombre de paquets/s en UDP correspondent à des unités différentes, mesurées à des étapes de traitement différentes. On ne peut pas les comparer directement pour calculer une quantité de données livrées ou un taux de perte.
Des paquets reçus aux données exploitables
Dans le cas d’un récepteur utilisant un socket UDP standard, les paquets entrants traversent la carte réseau (NIC), le noyau et le tampon de réception du socket avant d’atteindre l’application. Si le traitement prend du retard, des paquets peuvent être abandonnés après avoir atteint l’hôte. Les compteurs de réception des interfaces Linux incluent des paquets abandonnés à des étapes ultérieures ; la seule augmentation d’un compteur de réception ne prouve donc pas la remise à l’application.[4]
Une file de réception ou un cœur CPU peut être fortement sollicité, même lorsque l’utilisation globale du CPU reste faible. Vérifiez les files de la carte réseau, l’affectation des interruptions et les performances en monocœur. Dans l’application, séparez si nécessaire la réception des traitements en aval, en maintenant les opérations d’analyse coûteuses et une journalisation excessive hors de la boucle de réception. Un tampon de réception plus grand peut absorber des rafales temporaires ; il ne peut pas compenser un déficit durable de capacité de traitement.[5]
Les Shreds sont des fragments de données de bloc. La correction d’erreurs directe (FEC) peut récupérer les données manquantes à partir de Shreds de données et de codage appartenant au même groupe, mais la reconstruction nécessite toujours un nombre suffisant de fragments. Recevoir davantage de paquets en double ne remplace pas les fragments manquants.[6]
Selon son implémentation, un récepteur peut reconstruire des entrées à partir des fragments disponibles avant que le slot entier soit complet.[9] En complément du nombre total de paquets, mesurez le nombre de Shreds uniques et valides, les données reconstruites et le délai avant que l’application reconnaisse l’événement dont elle a besoin.
Mesurez chaque étape sur la même fenêtre temporelle
Alignez la destination, le port et la fenêtre de mesure des deux côtés. Enregistrer séparément les mesures des étapes suivantes permet de mieux cibler la suite de l’investigation.
| Point de mesure | Éléments à consigner | Ce qu’ils permettent d’établir |
|---|---|---|
| Émetteur | Relevés pour la destination visée et définition du compteur | Quelle étape d’émission a été observée |
| Point d’entrée de l’hôte récepteur | Capture du trafic UDP visé, statistiques de la carte réseau et pertes lors de la capture | Quantité de trafic visible à ce point d’observation |
| OS et socket | Erreurs UDP, pertes dans le tampon de réception et évolution des files d’attente | Si la réception est engorgée à l’intérieur de l’hôte |
| Reconstruction des Shreds | Shreds uniques et valides, reconstructions réussies, données manquantes et erreurs | Si les paquets permettent d’obtenir les données requises |
| Application | Retard de traitement accumulé et horodatages de détection du même événement | Si l’application bénéficie de la rapidité d’arrivée |
Si une capture contient peu de paquets, vérifiez d’abord son filtre, l’interface observée, les pertes de capture et les pertes au niveau de la carte réseau. Certains compteurs de l’OS portent sur l’hôte entier ou sur l’espace de noms réseau ; vérifiez leur périmètre et rapprochez-les des mesures de l’application visée.[4][5]
Modifiez les paramètres après avoir identifié l’étape soumise à une contrainte. Augmenter uniquement la taille d’un tampon ou d’un anneau peut déplacer le goulot d’étranglement ou ajouter du temps d’attente. La configuration actuelle du récepteur ERPC et les vérifications à effectuer sont documentées ici :
Choisissez la politique d’exploitation autant que le serveur
La Solana Foundation explique l’importance du contrôle sur les cartes réseau, les cœurs physiques, les pilotes et le réseau pour les validateurs à hautes performances. Ces exigences propres à un validateur complet ne doivent pas être appliquées en bloc à tous les récepteurs de Shreds. Une application réceptrice a besoin d’une configuration adaptée à son propre flux et à sa charge de traitement.[7]
Réduire les coûts ou la consommation électrique est un objectif d’exploitation raisonnable. Les applications HFT et en temps réel ont également besoin d’une réponse rapide du CPU, d’une capacité de traitement soutenue et de courts temps d’attente réseau. La sortie d’un état d’économie d’énergie peut impliquer un compromis en matière de latence.[8]
Outre les modèles de CPU et le nombre de cœurs, vérifiez les modalités de partage des ressources, la gestion d’une charge soutenue, les conditions applicables au trafic UDP et le chemin réseau réellement emprunté.
ERPC prend en compte à la fois le flux et l’environnement de réception
ERPC travaille sur le choix de centres de données proches de l’infrastructure Solana, les chemins réseau, le matériel et les paramètres d’exploitation, et propose des VPS et du Bare Metal en complément des Shreds et de gRPC. Vous pouvez choisir un VPS adapté à votre charge de traitement et comparer le Bare Metal lorsque vous souhaitez disposer de ressources physiques exclusives.
La connaissance de la configuration et de l’exploitation des environnements que nous fournissons facilite aussi le diagnostic technique. Nous pouvons comparer les relevés côté émission aux mesures du récepteur et identifier des vérifications concrètes à effectuer sur le réseau, l’OS ou l’application. Dans la demande d’assistance décrite ici, nous avons vérifié les mesures côté émission et demandé des mesures supplémentaires côté réception.
Évaluer ensemble le flux, l’emplacement du récepteur et l’implémentation de l’application facilite l’identification de ce qui manque entre le service choisi et les données dont vous avez besoin.
Comparez votre environnement actuel grâce à la facturation à l’heure
Si vous avez des doutes sur votre environnement de réception, essayez un VPS ou un serveur Bare Metal ERPC avec une facturation à l’heure et effectuez la comparaison avec le même flux et la même application. Consultez le tableau de bord pour connaître les tarifs actuels, les disponibilités et les conditions de commande dans la région de votre choix.
Commencez par une configuration disponible et consignez le nombre de paquets reçus, les données reconstruites, le retard de traitement accumulé et les horodatages de détection des mêmes événements. Lorsque vous comparez des horodatages entre plusieurs hôtes, vérifiez aussi la précision de la synchronisation des horloges. Répétez le test à différents moments et repérez les endroits du chemin où les résultats diffèrent. Appuyez-vous sur ces mesures pour choisir un serveur et un centre de données adaptés à votre application.
- VPS : https://erpc.global/fr/vps/
- Bare Metal : https://erpc.global/fr/baremetal/
- Tableau de bord : https://dashboard.erpc.global/fr/
Articles associés
- Solana Stream SDK v4.0.0 : https://erpc.global/fr/news/2026/11/07/erpc-solana-stream-sdk-v4-20261107/
- [9] Shreds UDP Forwarding Premium : https://erpc.global/fr/news/2026/11/03/erpc-shreds-udp-forwarding-premium-20261103/
- Discord officiel de Validators DAO : https://discord.gg/C7ZQSrCkYR
Références techniques
- [1] Limites de bande passante et de PPS d’AWS EC2 : https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/monitoring-network-performance-ena.html
- [2] Recommandations de l’IETF sur l’utilisation d’UDP, rafales : https://www.rfc-editor.org/rfc/rfc8085.html#section-3.1.6
- [3] UDP sous Linux : https://man7.org/linux/man-pages/man7/udp.7.html
- [3] TCP sous Linux : https://man7.org/linux/man-pages/man7/tcp.7.html
- [3] Contrôle de flux gRPC : https://grpc.io/docs/guides/flow-control/
- [4] Statistiques des interfaces Linux : https://docs.kernel.org/networking/statistics.html
- [4] Comportement et pertes de capture de libpcap : https://github.com/the-tcpdump-group/libpcap/blob/master/doc/README.linux
- [5] Mise à l’échelle de la pile réseau Linux : https://docs.kernel.org/networking/scaling.html
- [5] Tampons de réception des sockets Linux : https://man7.org/linux/man-pages/man7/socket.7.html
- [5] Red Hat, analyse des pertes UDP : https://docs.redhat.com/en/documentation/red_hat_enterprise_linux/10/html/network_troubleshooting_and_performance_tuning/tuning-udp-connections
- [6] Anza, propagation des blocs avec Turbine : https://docs.anza.xyz/consensus/turbine-block-propagation/
- [7] Solana Foundation, matériel pour validateurs à hautes performances : https://solana.com/news/high-performance-solana-validators-run-on-bare-metal-hardware
- [8] Gestion du temps d’inactivité du CPU sous Linux : https://docs.kernel.org/admin-guide/pm/cpuidle.html