Dix mythes qui ralentissent les applications Solana : pourquoi une infrastructure rapide peut rester lente
Votre connexion est rapide. Votre CPU est récent. Votre serveur se trouve dans la même ville que le fournisseur de données. Pourtant, votre application réagit encore lentement aux informations dont elle a besoin. La connexion reste ouverte, mais les données traitées prennent progressivement du retard.
Lors du développement d’applications à faible latence sur Solana, cette situation n’a pas toujours une cause unique. Le routage réseau, les paramètres de réception, les données auxquelles vous vous abonnez et les attentes internes à l’application peuvent se cumuler et empêcher de profiter pleinement de l’infrastructure rapide que vous avez choisie.
Chez ERPC, exploité par ELSOUL LABO B.V., notre équipe de support rencontre régulièrement des questions sur des boucles de réception bloquées, les paramètres des clients, des abonnements inutilement larges et des tentatives de reconnexion qui laissent l’erreur initiale intacte. Des choix peu problématiques dans une application web classique peuvent devenir des contraintes pour le trading à haute fréquence et le traitement en temps réel.
Cet article examine dix mythes à l’origine de ces problèmes. Il vise à vous aider à évaluer le choix de votre infrastructure ainsi que la conception qui permet de conserver ses performances jusqu’à la décision et à l’envoi d’une transaction.
Ce guide s’adresse aux développeurs ayant une expérience des applications web qui commencent à construire des applications de trading à haute fréquence (HFT) ou d’autres applications en temps réel sur Solana. Il traite du choix de l’environnement et des premières vérifications à effectuer. Ici, un abonnement consiste à choisir les mises à jour de données que l’application recevra en continu.
Définir d’abord ce qui doit se terminer plus tôt
Le temps aller-retour réseau, l’arrivée des données, le temps de décision et le délai de confirmation d’une transaction sont des mesures différentes. Un ping rapide n’empêche pas les décisions lentes si le traitement se bloque après réception. Une réponse RPC rapide ne signifie pas nécessairement que la transaction a été exécutée.
Prenons une application qui reçoit une mise à jour de l’état d’un marché, recalcule ses conditions et envoie une transaction lorsque ces conditions sont remplies. Distinguez le délai d’arrivée de la mise à jour, le temps nécessaire pour terminer le calcul et le temps nécessaire pour vérifier le résultat de la transaction envoyée. Définir l’intervalle à raccourcir permet de savoir où chercher.
Mesurez ces étapes séparément. Améliorer les performances commence par définir la vitesse au-delà d’un seul nom de produit ou d’un seul chiffre.
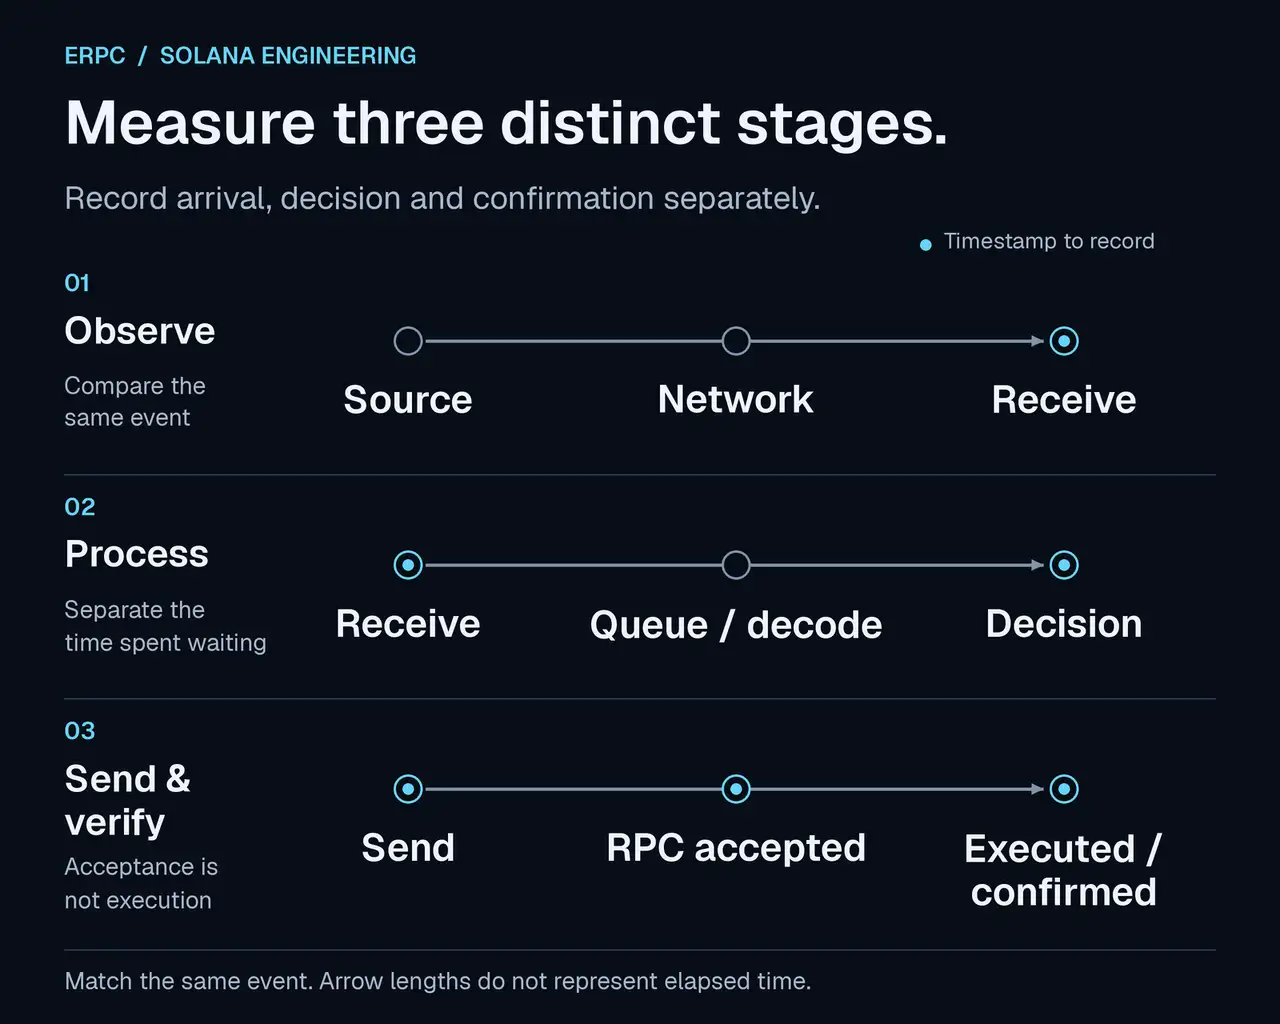
Mesurez séparément l’observation, le traitement dans l’application, puis l’envoi et la confirmation. Ce diagramme illustre des étapes de mesure, pas des durées mesurées ni des différences de performance.
Mythe 1 : Une petite VM fonctionne, donc sa capacité doit être suffisante
Une petite VM cloud convenait à une ancienne application web ou à une charge de travail Ethereum. Cette expérience peut inciter à penser que la même configuration traitera un flux Solana. Pourtant, une application qui effectue occasionnellement des requêtes RPC n’a pas les mêmes besoins qu’une application qui reçoit et traite en continu un large ensemble de mises à jour.
Dimensionnez l’environnement selon le volume de données, leur fréquence d’arrivée, le travail par événement et la latence acceptable. Combien d’événements arrivent chaque seconde ? Combien d’octets sont transférés ? Combien de temps CPU et de mémoire consomment le décodage et les décisions ? Prévoyez une marge pour suivre les pics aussi bien que le trafic habituel. Même sur une seule chaîne, le périmètre des abonnements et l’implémentation modifient les besoins.
La difficulté est qu’une application sous-dimensionnée peut sembler fonctionner. Des données continuent à s’afficher alors qu’elles deviennent de plus en plus anciennes, ou des lacunes pendant les reconnexions passent inaperçues. Le seul nombre d’événements reçus ne permet pas de le voir. Vérifiez le nombre d’événements traités, l’âge des données non traitées et la continuité des événements que votre abonnement doit couvrir.
Si l’expérience antérieure est le seul repère, les développeurs risquent de ne jamais remettre en question la capacité de réception et de continuer à incriminer le point d’accès aux données. Essayer un environnement disposant de davantage de marge peut révéler un retard ou des données manquantes jusque-là invisibles.
Pour enquêter, comparez le même point d’accès, le même abonnement, le même niveau de commitment (le stade de confirmation demandé, expliqué dans le mythe 9), le même SDK avec ses paramètres et le même traitement dans un environnement de réception et de traitement disposant de plus de marge. Conservez la même région, relevez les différences de CPU, de mémoire et de réseau, puis comparez le débit reçu, le travail terminé, l’accumulation, les événements manquants et le temps de décision. La charge varie dans le temps. Comparez si possible sur la même période, tout en respectant les limites de connexion et la charge imposée au service.
Une amélioration après changement d’environnement montre que les conditions de réception ou de traitement ont contribué au résultat. Si le CPU, la mémoire et le réseau ont changé ensemble, des vérifications supplémentaires sont nécessaires pour déterminer quelle ressource a compté. Choisir les ressources en fonction du volume et du débit réellement traités est un préalable au traitement à faible latence.
Mythe 2 : Être dans la même ville signifie être proche sur le réseau
« Les deux serveurs sont à Frankfurt, ils sont donc forcément proches. » « Un déploiement à Tokyo doit être le plus rapide pour le Japon. » Le nom d’une ville aide à choisir un emplacement, mais ne garantit pas le chemin réellement emprunté par le trafic.
Ce chemin dépend des connexions entre centres de données, des interconnexions entre opérateurs et des décisions de routage. Même deux serveurs dans la même ville peuvent faire un détour par des réseaux externes. RIPE IPmap cite notamment la visualisation de routes inefficaces, telles qu’un trafic qui quitte un pays avant d’y revenir, parmi ses usages. [1]
Mesurez le RTT entre la source réelle des données et la machine qui héberge votre application, les variations dans le temps, les retransmissions ou pertes, ainsi que l’heure d’arrivée du même événement. Traceroute et MTR peuvent aider à examiner le chemin, mais le nombre de sauts ne suffit pas à déterminer sa qualité. Il faut aussi éviter de confondre un routeur intermédiaire qui limite ses réponses de diagnostic avec une perte de paquets affectant l’application.
Après avoir choisi une région, posez une question supplémentaire : comment cette source précise et ce serveur précis sont-ils réellement reliés ? Cette vérification révèle des différences que le seul nom d’une ville ne montre pas.
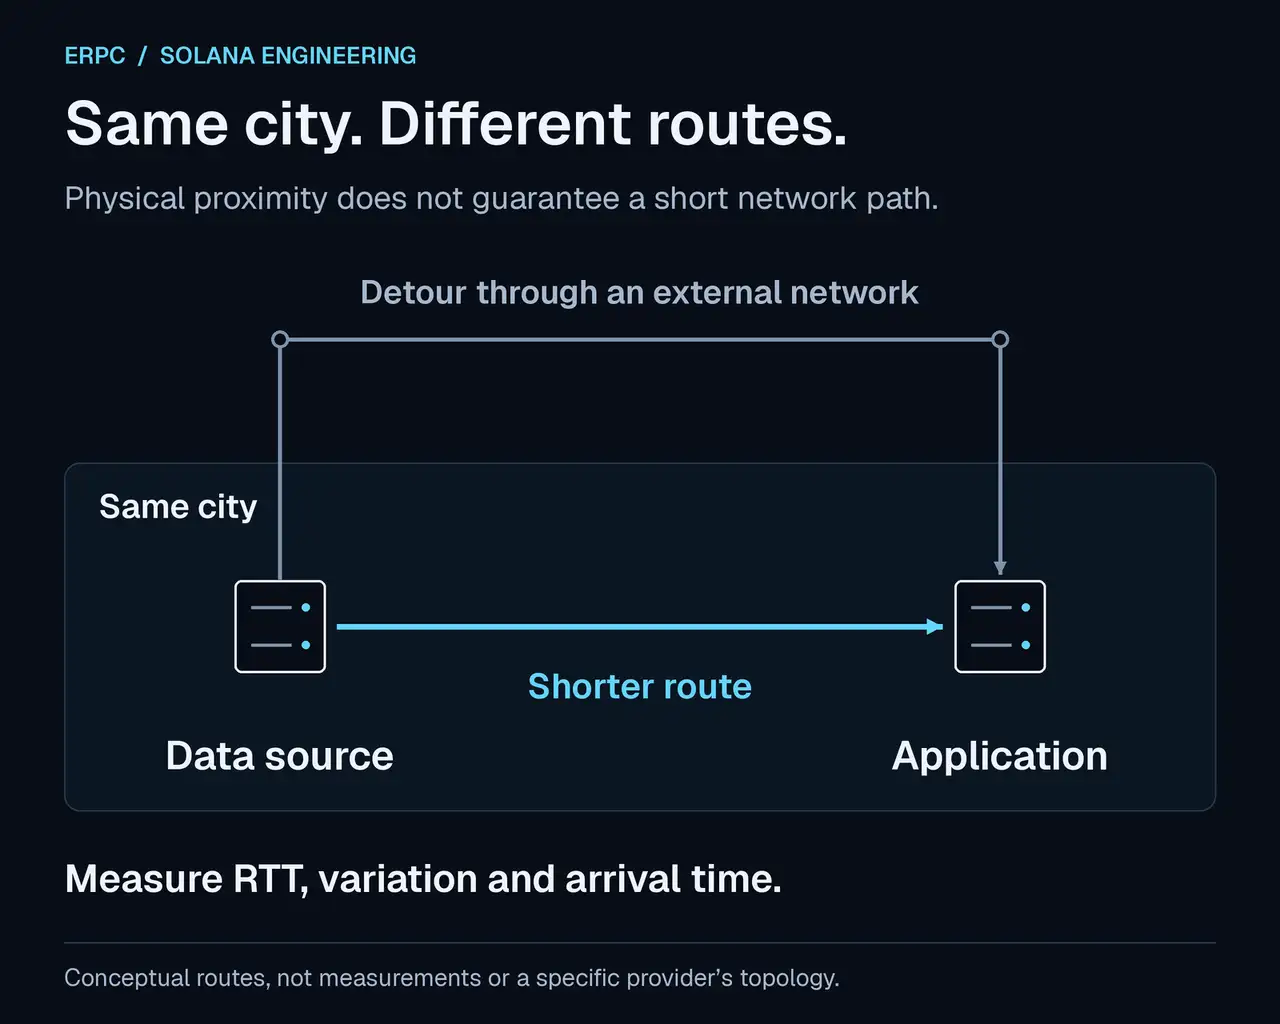
Deux serveurs dans une même ville peuvent suivre des routes différentes et présenter des temps aller-retour différents. Ce diagramme est conceptuel et ne représente pas la route réelle d’un fournisseur particulier.
Mythe 3 : Une spécification réseau élevée garantit assez de bande passante utilisable
La bande passante annoncée pour un serveur peut désigner plusieurs choses : la vitesse du port physique, la bande passante attribuée à une machine virtuelle, le débit durablement disponible ou une limite temporaire en mode burst. Une carte réseau rapide ne signifie pas que l’application peut exploiter en continu toute sa capacité.
La documentation AWS distingue, par exemple, la bande passante de base de celle disponible en burst, et décrit des contraintes liées aux destinations, aux flux et au débit en paquets. Cet exemple montre comment lire une spécification ; il ne signifie pas que tous les VPS ont les mêmes limites qu’AWS. [2]
Lors du choix d’une offre, vérifiez si la bande passante est dédiée ou partagée, les conditions d’utilisation continue, les volumes de transfert autorisés et les éventuelles différences selon les destinations. Pendant les tests, maintenez le trafic vers le même point d’accès avec les mêmes conditions d’abonnement qu’en production. Observez ensemble le débit reçu, les paquets abandonnés, les retransmissions et la charge CPU.
Un résultat élevé dans un bref test de vitesse ne prouve pas que le serveur peut traiter durablement un flux de production. À l’inverse, un débit reçu faible ne signifie pas nécessairement un manque de bande passante. Distinguez les problèmes de réception des limites de traitement avant d’augmenter la capacité de la connexion.
Mythe 4 : Un meilleur modèle de CPU, plus de cœurs ou davantage de GHz maximaux rendent l’application rapide
La fréquence maximale de boost d’un CPU n’est pas une fréquence maintenue sous toutes les charges. Son fonctionnement réel dépend de la puissance, de la température, du firmware, des réglages de fréquence et des autres tâches. La documentation Linux explique qu’activer le boost autorise son utilisation ; cela ne démontre pas que le CPU fonctionne effectivement en boost. [3]
Si le travail important est concentré dans un seul thread, ajouter des cœurs ne raccourcit pas à lui seul ce travail. L’utilisation globale du CPU peut sembler faible alors qu’un cœur ou une boucle événementielle est saturé. Le guide officiel Node.js explique également comment un callback coûteux fait attendre les autres tâches. [4]
Vérifiez la fréquence, la température, l’utilisation de chaque cœur et les temps de traitement sous la charge réelle. Dans un environnement virtuel, le temps passé à attendre une allocation CPU peut aussi être instructif. Profilez l’application pour identifier le temps consacré au décodage, aux calculs, aux allocations mémoire et aux journaux.
Choisissez une combinaison de performances de fréquence CPU, d’allocation de ressources, de réglages permettant des performances durables et d’implémentation applicative. Comparer uniquement les références des processeurs ne détermine pas la vitesse de l’ensemble de l’application.
Mythe 5 : Avec gRPC, les paramètres par défaut du client suffisent
Établir une connexion gRPC ne prouve pas qu’elle peut recevoir le volume nécessaire à la vitesse requise. HTTP/2 dispose d’un contrôle de flux par lequel le récepteur indique à l’émetteur la quantité de données qu’il peut accepter. Ce contrôle s’applique à chaque flux et à la connexion. Les fenêtres de réception et leurs mises à jour peuvent donc limiter le débit même si le lien réseau dispose encore de capacité. [5][6]
Une fenêtre de réception indique à l’émetteur combien de données il peut envoyer sans nouvelle mise à jour du récepteur. Les valeurs initiales, l’ajustement automatique et la priorité des paramètres diffèrent selon les SDK et les bibliothèques. Inscrire un grand nombre dans un fichier de configuration ne prouve pas que le client fonctionne comme prévu. Vérifiez les paramètres du flux et de la connexion, leur interaction avec les réglages adaptatifs et la version utilisée.
Effectuez les changements en mesurant le débit réellement reçu et le retard de traitement dans les mêmes conditions d’abonnement. La taille maximale d’un message reçu, le tampon de réception TCP et la fenêtre HTTP/2 sont des paramètres distincts. Keepalive vérifie que la connexion est toujours active ; il n’ajoute ni capacité de traitement ni bande passante.
La FAQ gRPC d’ERPC propose des étapes de diagnostic et des exemples de configuration pour un flux dont le débit reste constant alors que le retard s’accumule. Avant d’utiliser un exemple, notez le SDK et sa version. Repérez où ce SDK configure les fenêtres de réception du flux et de la connexion ainsi que leur ajustement automatique, puis comparez ces réglages à l’exemple de la FAQ. Si vous utilisez un autre SDK, consultez sa documentation pour identifier les paramètres correspondants au lieu de recopier tels quels leurs noms et leurs valeurs. Vérifiez ensuite le résultat avec votre volume d’abonnement et votre capacité de traitement. [7]
Mythe 6 : Recevoir tous les blocs complets permet de décider le plus tôt
« Tout recevoir d’abord, puis chercher ce qui compte. » C’est une façon compréhensible de démarrer le développement, mais elle ajoute du travail qui n’est peut-être pas nécessaire avant une décision. Le transfert, le décodage, l’allocation mémoire et la recherche dans des données inutiles consomment des ressources CPU et une bande passante limitées.
Si vous voulez réagir aux changements d’un marché, d’un programme ou d’un compte précis, définissez d’abord les événements et les champs nécessaires à la décision. Yellowstone gRPC fournit des filtres d’abonnement pour les transactions et les comptes, ainsi qu’un moyen de récupérer seulement une partie des données d’un compte. Les notifications de blocs complets et celles de mises à jour individuelles sont également différentes. [8]
Pour une exigence telle que « recalculer les conditions chaque fois que le marché A change », listez les informations qui identifient le marché A, l’état utilisé dans le calcul et les événements qui mettent cet état à jour. Les données nécessaires dépendent de la spécification du programme : confrontez donc cette spécification aux mises à jour reçues. Utilisez la liste pour restreindre les abonnements, puis vérifiez que l’état nécessaire à la décision reste complet.
À ressources et conditions identiques, si une application attend de décoder et parcourir tous les enregistrements tandis qu’une autre traite immédiatement la mise à jour utile, la seconde évite ce délai. Un concurrent plus ciblé peut réagir régulièrement avant vous pour des raisons qui dépassent la connexion réseau. Décider de ce qui peut être ignoré fait partie de la conception à faible latence.
L’indexation, l’audit, la recherche et le stockage historique peuvent légitimement nécessiter toutes les données. Prévoyez un chemin séparé pour cette charge. Le dissocier des décisions immédiates permet de définir la capacité et l’exhaustivité requises pour chaque chemin. Vérifiez toutefois que le filtrage n’élimine pas des mises à jour nécessaires à des décisions correctes. Le traitement par lots peut aussi augmenter le débit total dans certains cas ; choisissez-le en fonction du temps d’attente acceptable pour l’application.
Dans le service Shared gRPC actuel d’ERPC, un abonnement
blocks non vide nécessite le service Dedicated. Les abonnements transactions ou blocksMeta peuvent répondre à certains besoins, mais aucun ne fournit les mêmes données que les blocs complets. Le choix de Dedicated exige toujours une capacité de traitement adaptée côté réception et une conception appropriée des abonnements. [9]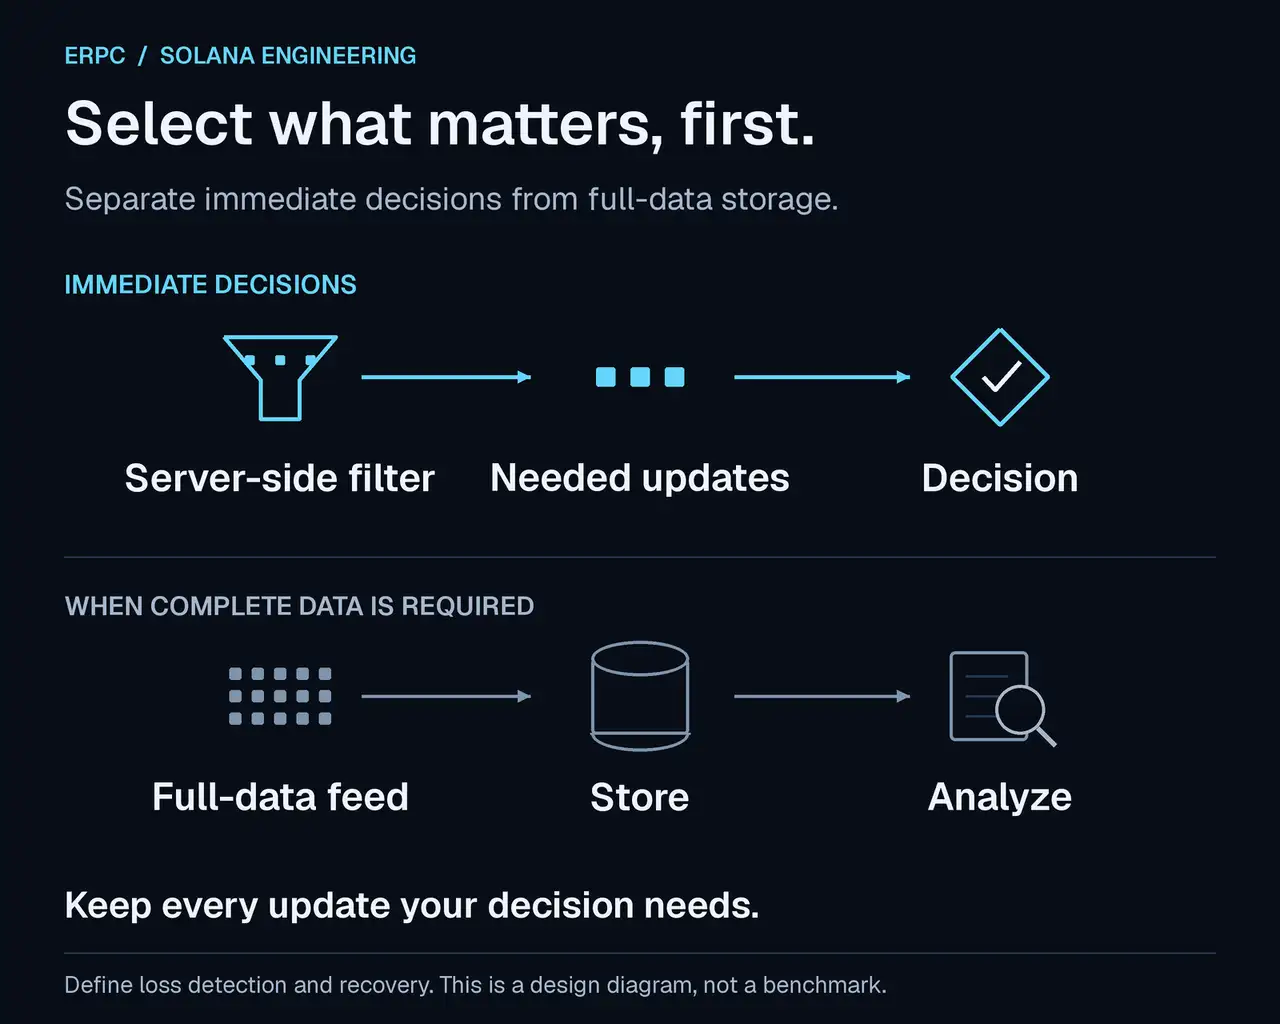
Utilisez un chemin pour les mises à jour nécessaires aux décisions immédiates et un autre pour le stockage complet et l’analyse. Ce diagramme illustre une approche architecturale. Vérifiez que le filtrage conserve l’état nécessaire à des décisions correctes et définissez la récupération des données manquantes.
Mythe 7 : Si les données arrivent, le traitement suit forcément
Une file d’attente peut se former entre les données reçues et celles déjà traitées pour être utilisables dans une décision. Si le travail entrant dépasse durablement la capacité de traitement, le retard augmente même avec une connexion ouverte. Un tampon plus grand peut absorber des pointes temporaires, mais en cas de déficit durable de traitement, il conserve simplement davantage de données anciennes.
Prenons un exemple hypothétique sans travail en attente au départ. L’application reçoit 12 000 événements du même type par seconde et en traite complètement 10 000 par seconde. Si elle peut garder chaque événement dans sa file d’attente sans en supprimer ni en regrouper, le travail en attente augmente de 2 000 événements par seconde et atteint 20 000 après 10 secondes. La connexion reste active et les données continuent de s’afficher, tandis que le travail nécessaire aux décisions prend du retard. Ces chiffres illustrent le mécanisme ; ce ne sont pas des mesures de performance d’ERPC.
Ne mesurez pas uniquement les événements reçus. Mesurez aussi les traitements terminés, la longueur de la file, l’âge de l’élément non traité le plus ancien et le temps entre réception et fin de décision. Surveillez séparément l’état de la connexion et la fraîcheur des données.
Ne conservez dans la boucle de réception que le travail nécessaire pour continuer à recevoir. Envisagez de séparer les écritures en base de données, la journalisation intégrale des charges utiles, les appels API externes et les calculs lourds dans d’autres chemins de traitement. Fixez une capacité maximale aux files et une politique lorsqu’elles sont pleines. Une file d’attente de capacité limitée peut toujours faire attendre le travail en amont une fois remplie ; elle ne résout pas à elle seule un manque de capacité de traitement. [10]
Pour des mises à jour où seul le dernier état compte, il peut être possible de regrouper les états anciens. Les événements de transaction qui nécessitent un traitement ordonné ou exhaustif ne doivent pas être supprimés sans discernement. Concevez la détection des lacunes, la récupération des données et la restauration de l’état après reconnexion selon les besoins de l’application.
Le
STREAM_GUARD_SLOW_READER d’ERPC est une protection déclenchée en cas de progression insuffisante des écritures ou de retard de livraison observé. Cette seule observation ne suffit pas à attribuer une cause. Examinez la connexion, la machine, le volume d’abonnement et la vitesse de consommation de l’application. Avant une reconnexion, conservez le premier status, message, les metadata et trailers disponibles, puis lisez la raison et les conditions de nouvelle tentative fournies par le serveur. Renvoyer la même requête refusée sans la corriger laisse la cause intacte. [7]Mythe 8 : Un ping ou une moyenne rapide signifie être rapide au moment important
Le ping donne une indication du temps aller-retour réseau. Il mesure un intervalle différent de la latence applicative, qui comprend le traitement à la source, le contenu de l’abonnement, l’attente de réception, le décodage et la décision. Une moyenne peut aussi masquer un petit nombre de retards importants.
p50 est la médiane. p95 et p99 sont les valeurs en dessous desquelles, ou auxquelles, se situent respectivement 95% et 99% des mesures. p99 n’est pas le maximum. Indiquez le nombre d’échantillons et la période de mesure, et vérifiez les valeurs pendant les pics d’événements, les maxima, les délais d’expiration, les déconnexions et les données manquantes. [11]
Pour comparer des fournisseurs, faites correspondre le même événement, le même type de données, le même commitment et les mêmes conditions d’abonnement. Recevez si possible sur la même machine de mesure et utilisez une horloge monotone pour les durées internes à l’application. Si vous soustrayez des horodatages provenant de machines différentes, tenez compte des écarts d’horloge qui peuvent fausser la mesure.
Ne conserver que les événements réussis peut faire paraître rapide une configuration qui perd souvent des données. Choisir le résultat isolé le plus rapide et choisir une configuration moins susceptible de prendre du retard au moment où la production en a besoin sont deux décisions différentes.
Mythe 9 : Les premières données reçues sont aussi définitives et ont le même sens
Les Shreds, notifications de transaction, mises à jour de comptes et notifications de blocs ne représentent pas la même information au même stade. Utiliser des données plus précoces peut laisser davantage de reconstruction ou d’interprétation à votre application. Une comparaison doit aligner non seulement l’heure de réception, mais aussi ce qui peut être connu à cet instant. [8][12]
Distinguez également les niveaux de commitment
processed, confirmed et finalized de Solana. Si des observations précoces alimentent les décisions, l’application doit vérifier ultérieurement leur état de confirmation et corriger son état si nécessaire. Séparez la réception d’une mise à jour précoce des conditions permettant une action définitive dans un système externe. [13]Par exemple, juxtaposer des notifications reçues avec des commitments différents et dire que l’une est plus rapide de quelques millisecondes ne compare pas le même travail. Déterminez les informations et le degré de confirmation nécessaires à votre application, puis mesurez le temps requis pour pouvoir décider dans ces conditions.
Mythe 10 : Un envoi réussi signifie que la transaction sera exécutée en premier
Une réponse réussie à
sendTransaction signifie que le RPC a accepté la transaction. Elle ne garantit ni son traitement ni sa confirmation par le cluster. La spécification Solana demande explicitement de vérifier séparément le statut de la signature. [14]Même lorsque les informations entrantes permettent de décider tôt, le chemin d’envoi, la validité du blockhash, la contention sur les comptes accessibles en écriture, les ressources de calcul, les frais de priorité et les conditions de réussite propres à la transaction restent déterminants. SWQoS concerne l’admission et la priorité des connexions vers le leader, tandis que les frais de priorité influencent l’ordonnancement. Leurs rôles diffèrent et aucun des deux ne garantit sans condition l’ordre d’exécution ou le succès. [15][16]
Enregistrez séparément la fin de décision, le début d’envoi, l’acceptation RPC, les résultats d’exécution et l’état de confirmation requis. Lors d’une nouvelle tentative, distinguez aussi le renvoi d’une transaction portant la même signature de la création d’une nouvelle transaction, afin d’éviter des actions doubles involontaires.
Seule l’observation de tout le chemin, de la réception à la confirmation, permet d’identifier l’amélioration qui vous rapprochera de l’objectif.
Les premières mesures à mettre en place
Commencez par ces trois vérifications.
- Choisissez une décision et notez les mises à jour qu’elle nécessite ainsi que l’état qui doit être disponible avant que l’application puisse décider.
- Sur une même période de mesure, relevez le nombre d’événements reçus, entièrement traités et encore en attente, pour un même type d’événement. Si le travail est mis en file d’attente, mesurez également le temps écoulé depuis la réception par l’application de l’événement en attente le plus ancien.
- Si le travail en attente ou le temps d’attente continue d’augmenter, identifiez l’endroit où il s’accumule. Choisissez une modification pertinente des abonnements, du traitement, des paramètres ou de l’environnement d’exécution, puis comparez les résultats avant et après.
Le temps mesuré depuis la réception par l’application révèle l’attente à l’intérieur de celle-ci. Mesurez séparément le délai entre l’événement d’origine et sa réception par l’application. Une fois ces premiers relevés disponibles, utilisez le tableau suivant pour élargir les vérifications.
| Étape | Éléments à enregistrer | Problèmes recherchés |
|---|---|---|
| Réseau et réception | Débit reçu réel, retransmissions et pertes, écarts d’arrivée du même événement | Contraintes de routage, de bande passante et de réception |
| Application | Nombre d’événements reçus et traités, longueur de file, âge du plus ancien élément | Déficit durable de traitement et accumulation de données anciennes |
| Temps de décision | p50, p95, p99 et maximum entre réception et fin de décision | Traitements coûteux et retards pendant les pics |
| Envoi et confirmation | Début d’envoi, acceptation RPC, statut de signature, erreurs d’exécution | Retards et échecs après réception |
| Conditions de comparaison | Région, machine, SDK et version, abonnement, commitment, période et nombre d’échantillons | Écarts apparents dus à des conditions différentes |
Conservez une mesure de référence, puis vérifiez un changement à la fois selon les symptômes : périmètre des abonnements, séparation du traitement, paramètres clients, emplacement ou ressources. Si vous élargissez une fenêtre, vérifiez aussi l’augmentation éventuelle de mémoire et du retard accumulé. Si vous réduisez un abonnement, assurez-vous de ne pas perdre une information nécessaire.
Le p99 du temps total ne se calcule pas en additionnant simplement les p99 de chaque étape. Calculez-le à partir du temps total de chaque événement apparié et utilisez les mesures par étape pour localiser les causes. Testez pendant de véritables pics d’événements aussi bien qu’à charge moyenne.
ERPC prépare l’infrastructure pour que les développeurs affinent leur logique
Lorsque réseaux, serveurs, livraison de données et clients sont choisis séparément, des attentes peuvent subsister entre eux même si chacun possède de bonnes spécifications. ERPC réunit la livraison des données Solana et les environnements de traitement sur une même plateforme, ce qui réduit le travail que les développeurs doivent autrement reprendre pour choisir emplacements et ressources depuis zéro.
Les offres SUPER VPS et Premium VPS annoncent des configurations à haute fréquence et une allocation de ressources sans surallocation. Bare Metal propose une machine physique dédiée. ERPC rapproche réseaux et serveurs de son environnement de livraison et prépare CPU, mémoire, stockage et connectivité pour un traitement continu. Les spécifications précises sont disponibles pour chaque offre et chaque région. [17][18]
| Difficulté fréquente de développement | Infrastructure et informations proposées par ERPC | Points à affiner dans l’application |
|---|---|---|
| Distance que les noms de villes ne révèlent pas | Configurations régionales et réseau permettant de choisir ensemble livraison et traitement | Mesurer les arrivées et leurs variations avec ses conditions d’abonnement |
| Contention sur les ressources et performances durables | SUPER VPS et Premium VPS à haute fréquence sans surallocation, et Bare Metal dédié | Identifier les traitements coûteux et séquentiels |
| Volume des données et mode de connexion | gRPC, Shreds, RPC et options partagées ou dédiées adaptées à la charge | Définir les événements et champs nécessaires |
| Paramètres de réception et diagnostic | Solana Stream SDK, exemples de configuration, documentation des filtres et FAQ par erreur | Vérifier les réglages effectifs, files, reconnexions et récupérations |
ERPC aide les développeurs à avancer dans la sélection et le réglage de l’infrastructure, pour consacrer davantage de temps à ce qu’ils observent, aux informations qui fondent leurs décisions et au moment d’envoyer. Avec un service et un emplacement adaptés, aligner le volume d’abonnement sur la capacité de traitement transforme les performances de l’infrastructure en vitesse applicative.
Commencez par déterminer les informations réellement nécessaires à vos décisions. Recevez-les tôt, traitez-les sans attente inutile et vérifiez le résultat. ERPC continuera à fournir l’environnement et les informations qui permettent cette amélioration.
Ressources pour l’implémentation
- FAQ gRPC ERPC : https://erpc.global/fr/faq/grpc/general/
- Filtres d’abonnement et limites Shared actuelles : https://erpc.global/fr/doc/geyser-grpc/filter/
- Bonnes pratiques d’implémentation gRPC : https://erpc.global/fr/doc/geyser-grpc/best-practices/
- Solana Stream SDK : https://github.com/ValidatorsDAO/solana-stream
- ERPC VPS : https://erpc.global/fr/vps/
- ERPC Bare Metal : https://erpc.global/fr/baremetal/
- ERPC Dashboard : https://dashboard.erpc.global/
- Discord officiel de Validators DAO : https://discord.gg/C7ZQSrCkYR
Références techniques
- RIPE IPmap, visualisation des inefficacités de routage : https://ipmap.ripe.net/
- AWS, bande passante réseau des instances : https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/ec2-instance-network-bandwidth.html
- Linux Kernel, CPU Performance Scaling : https://docs.kernel.org/admin-guide/pm/cpufreq.html
- Node.js, éviter de bloquer la boucle événementielle : https://nodejs.org/en/learn/asynchronous-work/dont-block-the-event-loop
- IETF RFC 9113, contrôle de flux HTTP/2 : https://httpwg.org/specs/rfc9113.html#FlowControl
- gRPC, Flow Control : https://grpc.io/docs/guides/flow-control/
- ERPC, réception, slow readers et nouvelles tentatives dans la FAQ gRPC : https://erpc.global/fr/faq/grpc/general/
- Yellowstone gRPC, spécifications des abonnements et filtres : https://github.com/rpcpool/yellowstone-grpc
- ERPC, règles actuelles des filtres Shared : https://erpc.global/fr/doc/geyser-grpc/filter/
- Tokio, files et backpressure : https://tokio.rs/tokio/tutorial/channels
- AWS CloudWatch, définition des percentiles : https://docs.aws.amazon.com/AmazonCloudWatch/latest/monitoring/Statistics-definitions.html
- ERPC, Shreds UDP Forwarding : https://erpc.global/fr/doc/shredstream/udp-forwarding/
- Solana, Transaction Confirmation & Expiration : https://solana.com/developers/cookbook/transactions/confirmation
- Solana, sendTransaction : https://solana.com/docs/rpc/http/sendtransaction
- Solana, Stake-weighted Quality of Service : https://solana.com/docs/defi/stake-weighted-qos
- Solana, frais de transaction : https://solana.com/docs/core/fees
- ERPC, configurations et spécifications VPS : https://erpc.global/fr/vps/
- ERPC, configurations et spécifications Bare Metal : https://erpc.global/fr/baremetal/