“Solana का डेटा धीमा या अधूरा है?” रिसीविंग इंफ्रास्ट्रक्चर में क्या जाँचें
आप तेज़ Solana Shreds स्ट्रीम की सदस्यता लेते हैं, लेकिन पैकेट बहुत कम संख्या में पहुँचते हैं। जो Shreds मिलते हैं, वे सही तरह से पार्स हो जाते हैं, फिर भी इतने फ़्रैगमेंट गायब हैं कि ट्रांज़ैक्शन निकालना संभव नहीं होता। उसी सर्वर पर gRPC काम कर रहा है, इसलिए यह स्पष्ट नहीं होता कि आगे कहाँ जाँच करें।
भेजने वाले पक्ष की जाँच के साथ-साथ अपने एप्लिकेशन सर्वर और उसे होस्ट करने वाले डेटा सेंटर को भी देखें। ERPC के तेज़ी से Shreds फ़ॉरवर्ड करने के बावजूद, पथ में UDP पर लगे प्रतिबंध या प्राप्त करने वाले सर्वर में प्रोसेसिंग की बाधाएँ आपके एप्लिकेशन को उस गति का लाभ लेने से रोक सकती हैं।
Shreds स्ट्रीम चुनते समय पूरे पथ को ध्यान में रखना ज़रूरी है: पैकेट कैसे पहुँचते हैं और उपयोग योग्य डेटा में कैसे बदलते हैं। नेटवर्क की गुणवत्ता, दूरी और डेटा सेंटर की संचालन नीतियाँ, Geyser Yellowstone gRPC, सामान्य RPC और API ट्रैफ़िक तथा ट्रांज़ैक्शन भेजने के प्रदर्शन को प्रभावित करने वाली साझा परिस्थितियाँ भी हैं।
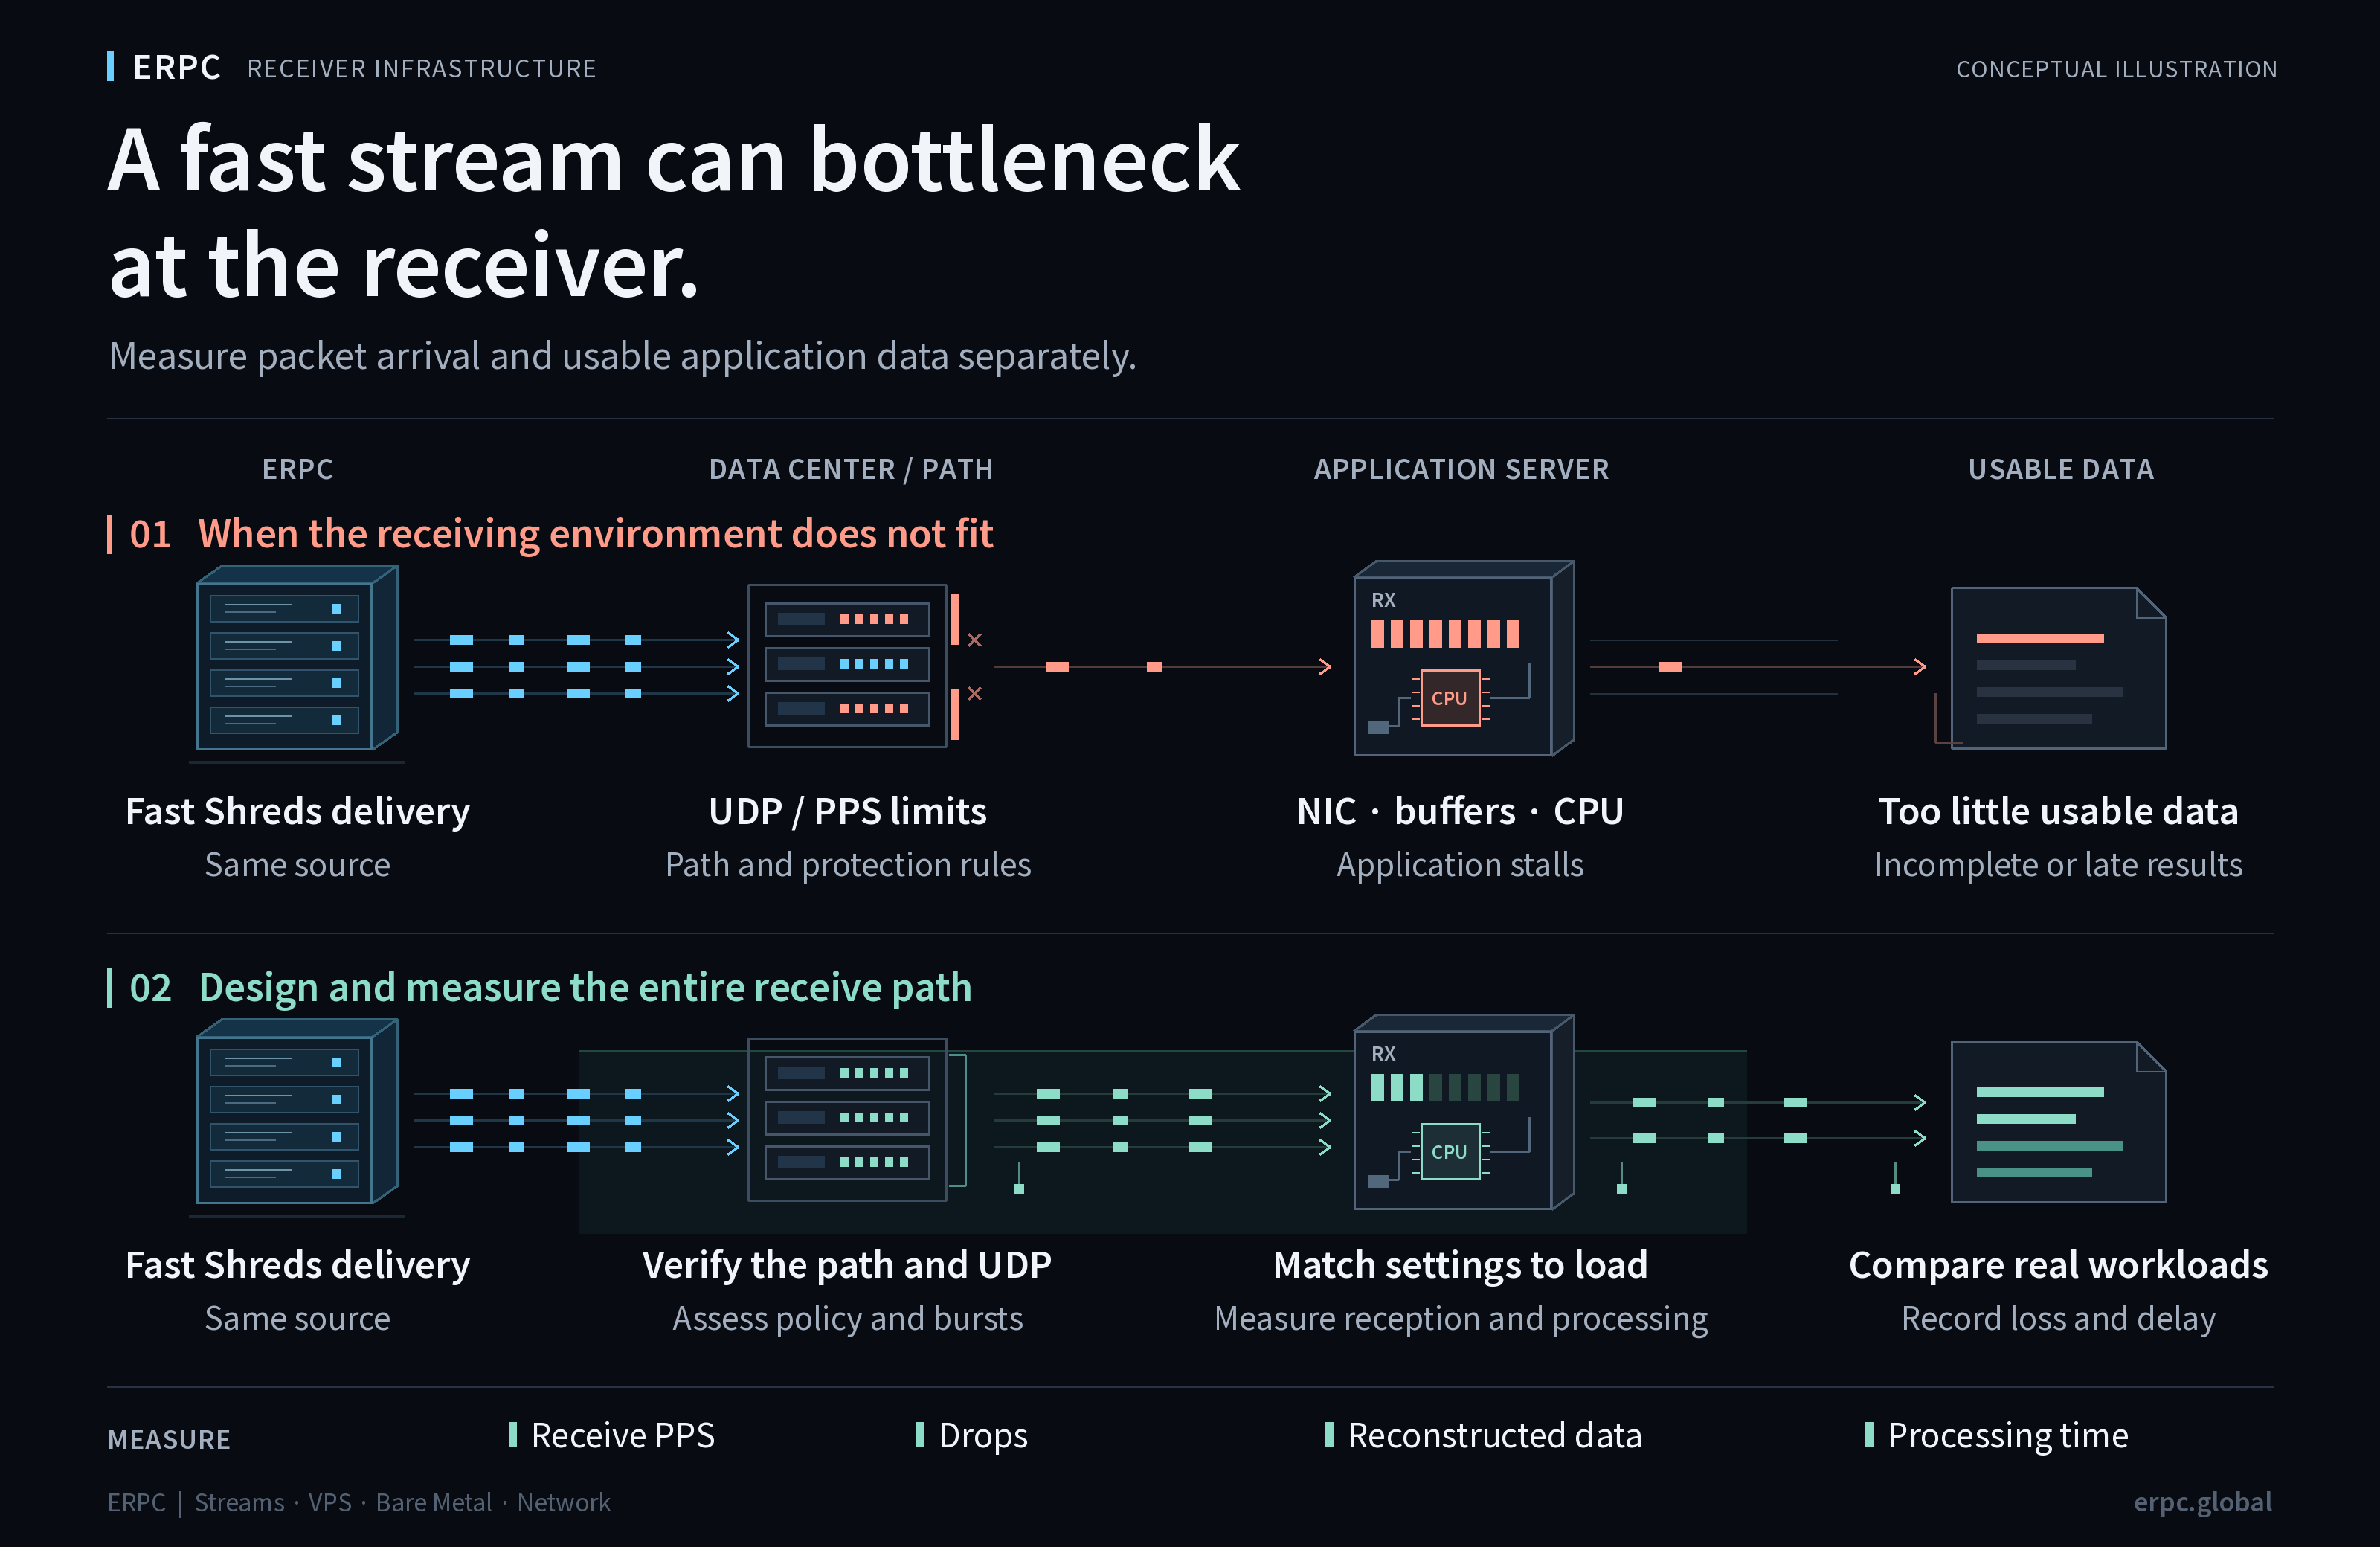
भेजने के रिकॉर्ड और प्राप्त उपयोगी डेटा अलग बातें हैं
हाल ही में ERPC को मिले एक सहायता अनुरोध में, भेजने वाले पक्ष पर थोड़े समय के मापन में लगभग 3,400–3,900 पैकेट/सेकंड दर्ज किए गए। रिसीवर ने लगभग 13 पैकेट/सेकंड मिलने की सूचना दी और बताया कि किसी भी स्लॉट का पुनर्निर्माण पूरा नहीं हुआ।
ये आँकड़े अलग-अलग मापन अवधियों से हैं, और यह पुष्टि नहीं हुई है कि मापने के तरीके आपस में तुलनीय हैं। इसलिए इनसे सफल डिलीवरी की दर या हानि दर निर्धारित नहीं की जा सकती। केवल भेजने वाले पक्ष के रिकॉर्ड यह साबित नहीं करते कि डेटा पहुँचा, और यह लेख लिखे जाने तक अंतिम कारण निर्धारित नहीं हुआ है।
कुछ हज़ार PPS भी अपने आप में यह सिद्ध नहीं करते कि किसी सामान्य उद्देश्य वाले सर्वर पर असामान्य रूप से अधिक लोड है। असल सवाल हैं: वास्तविक पथ पर क्या हो रहा है, कौन-सी सीमाएँ लागू हैं, छोटे समय अंतराल में ट्रैफ़िक कैसे केंद्रित होता है, डेटा प्राप्त करने की प्रक्रिया कैसे सँभाली जाती है और प्रत्येक काउंटर क्या मापता है।
एक ही फ़्रैंकफ़र्ट। अलग नेटवर्क पथ।
आपका स्ट्रीम स्रोत और एप्लिकेशन सर्वर दोनों फ़्रैंकफ़र्ट में होते हुए भी अलग-अलग डेटा सेंटरों में हो सकते हैं। ऐसी व्यवस्था में ट्रैफ़िक एक परिसर से बाहर निकलकर बाहरी नेटवर्क से गुजर सकता है और फिर दूसरे परिसर में प्रवेश कर सकता है। केवल क्षेत्र का नाम एक होने से यह साबित नहीं होता कि परिसर, नेटवर्क ऑपरेटर या बीच में आने वाले उपकरण भी एक ही हैं।
जब ERPC की स्ट्रीम या RPC सेवाएँ और ERPC VPS या Bare Metal होस्ट एक ही परिसर में रखे जाते हैं, तो सेवा के सर्वर और एप्लिकेशन सर्वर पास-पास के रैकों में होते हैं और उनके बीच का संचार आंतरिक नेटवर्क पर ही रहता है। ERPC के Zero-Distance Communication के पीछे यही विचार है: केवल एक ही शहर चुनने से आगे बढ़कर, भौतिक व्यवस्था और डेटा प्राप्त करने वाले एप्लिकेशन तक के पथ को साथ में डिज़ाइन करना।
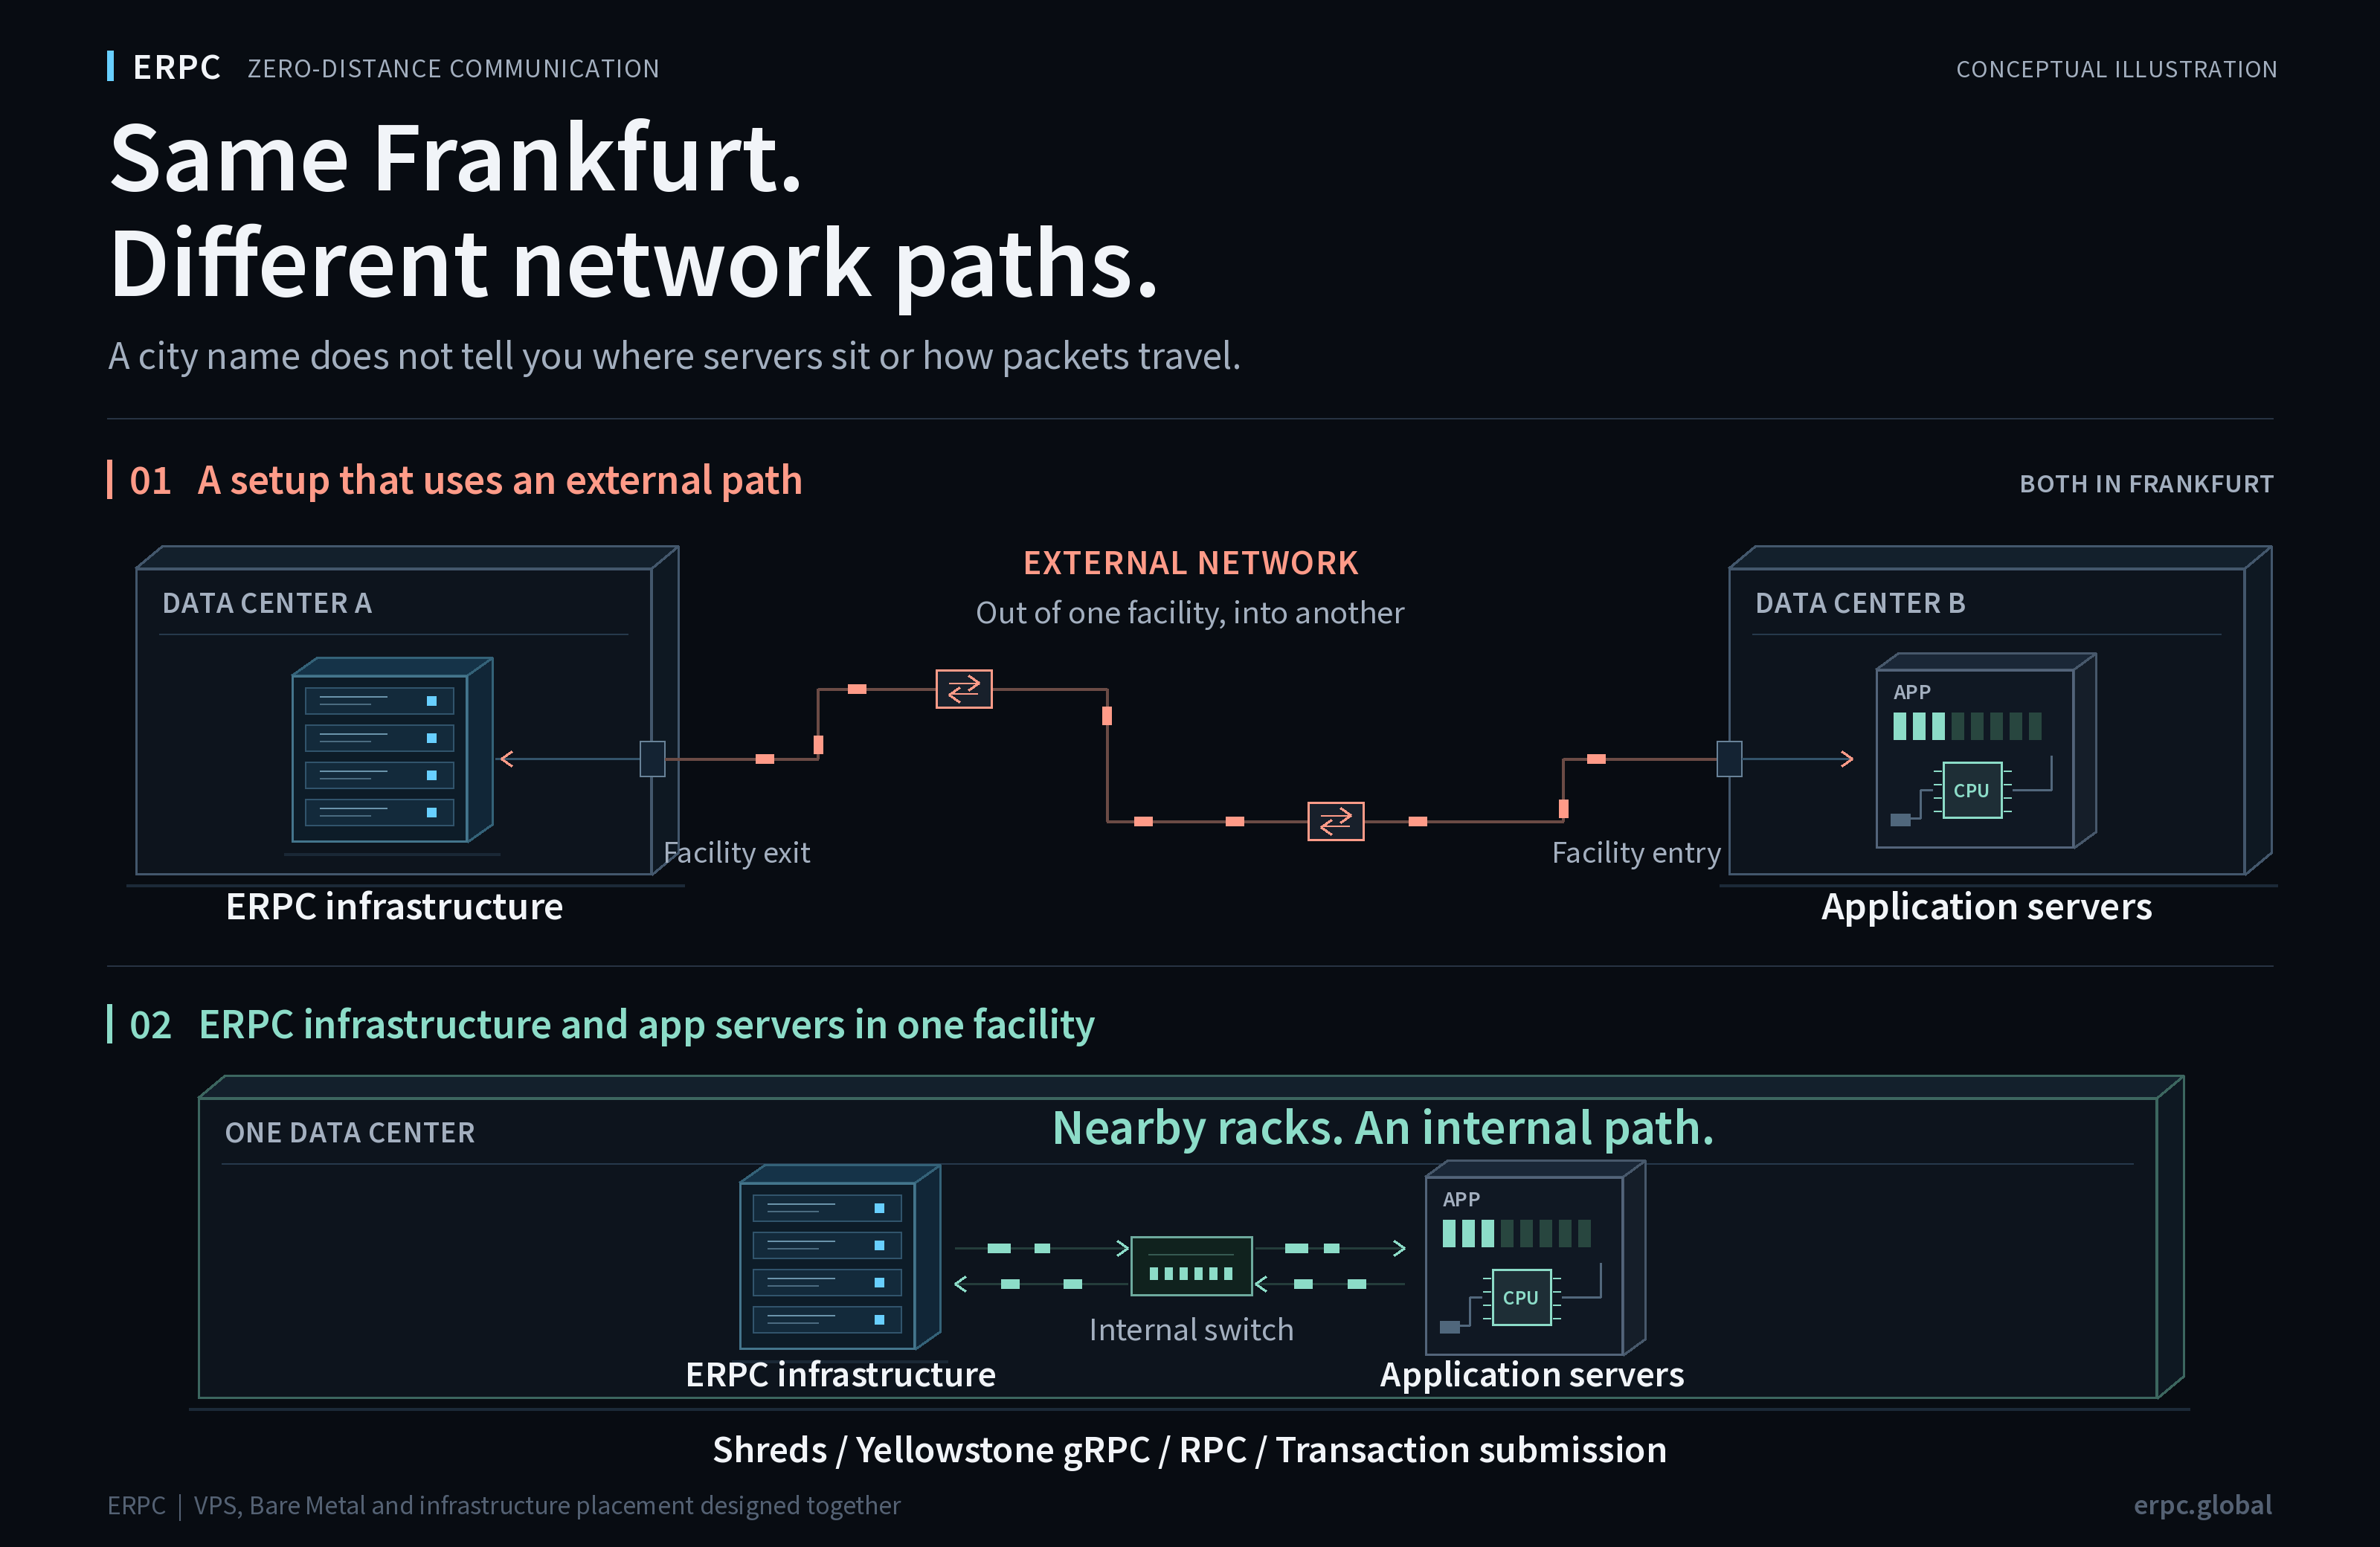
ERPC सेवाओं और एप्लिकेशन सर्वर के बीच बाहरी नेटवर्क का चक्कर बचाने से पथ छोटा होता है और उस हिस्से का बाहरी नेटवर्क की भीड़ तथा रूट बदलावों से प्रभावित होने का जोखिम घटता है। छोटा पथ, डेटा प्राप्त करने और प्रोसेस करने के लिए आवश्यक संसाधनों के साथ मिलकर, तेज़ स्ट्रीम का लाभ उठाने की बुनियाद बनाता है। पैकेट पहुँचने और एप्लिकेशन में प्रोसेसिंग, दोनों स्तरों पर परिणाम की पुष्टि करें।
नेटवर्क की स्थितियाँ हर प्रकार के संचार को प्रभावित करती हैं
Shreds में गायब फ़्रैगमेंट समस्या को स्पष्ट कर देते हैं, लेकिन उसी इंफ्रास्ट्रक्चर की गुणवत्ता व्यापक रूप से डेटा प्राप्त करने, API अनुरोधों और ट्रांज़ैक्शन भेजने को भी प्रभावित करती है। प्रोटोकॉल बदलने से एप्लिकेशन में दिखने वाले लक्षण और वे बिंदु बदल जाते हैं जिन्हें मापना उपयोगी है।
| संचार | नेटवर्क का प्रभाव कहाँ दिखता है | एप्लिकेशन में क्या जाँचें |
|---|---|---|
| Shreds / UDP | पैकेट हानि और देरी, तथा पुनर्निर्माण के लिए आवश्यक फ़्रैगमेंट का पहुँचना | वैध Shreds और डेटा का पुनर्निर्माण हो पाने तक का समय |
| Geyser Yellowstone gRPC | TCP रीट्रांसमिशन की प्रतीक्षा, स्ट्रीम में बैकलॉग और देरी | उसी अपडेट के प्राप्त होने और प्रोसेस होने तक का समय |
| RPC, API और सेवाओं के बीच ट्रैफ़िक | अनुरोध और उत्तर का आने-जाने का समय, तथा कंजेशन के दौरान प्रतीक्षा | उत्तर का समय और उसमें होने वाला बदलाव |
| ट्रांज़ैक्शन भेजना | अनुरोध का प्राप्त करने वाले नोड तक का पथ | भेजने के अनुरोध से नोड के उत्तर तक का समय |
पास-पास की भौतिक व्यवस्था और उपयुक्त संचालन नीतियाँ इन सभी प्रकार के ट्रैफ़िक का समर्थन करती हैं। प्राप्त करने वाले नोड के उत्तर का समय, ट्रांज़ैक्शन के चेन में शामिल होकर फ़ाइनलाइज़ होने तक के समय से अलग मापें।
Gbps, PPS और बर्स्ट के बारे में सब कुछ नहीं बताता
बैंडविड्थ बताती है कि समय के साथ कितना डेटा ले जाया जा सकता है। PPS बताता है कि प्रति सेकंड कितने पैकेट प्रोसेस होते हैं। किसी कनेक्शन में बैंडविड्थ की अतिरिक्त क्षमता होने पर भी वह पैकेट दर की सीमा या UDP पर लागू प्रतिबंध से बाधित हो सकता है। क्लाउड प्रदाताओं के अपने दस्तावेज़ भी बैंडविड्थ और PPS की अनुमत सीमाओं को अलग-अलग बाधाओं के रूप में देखते हैं।[1]
Shreds हमेशा एकसमान दर से नहीं आते। किसी बर्स्ट से कतारों पर ऐसा दबाव बन सकता है जो औसत में दिखाई नहीं देता। यदि पैकेट किसी नेटवर्क उपकरण या रिसीवर की प्रोसेसिंग गति से तेज़ी से जमा हों, तो कतार की क्षमता से बाहर के पैकेट ड्रॉप हो सकते हैं।[2]
लगातार UDP प्राप्त करने, थोड़े समय के बर्स्ट, PPS सीमाओं और DDoS सुरक्षा द्वारा लागू नियमों के बारे में अपने होस्टिंग प्रदाता से पूछें। उद्देश्य आवश्यक ट्रैफ़िक को सुरक्षित रूप से प्रवेश देने वाली स्थितियाँ तय करना है, न कि सुरक्षा को बिना सोचे-समझे बंद करना।
gRPC का काम करना, UDP रिसेप्शन के काम करने का प्रमाण नहीं है
TCP आधारित gRPC और UDP पर आने वाले रॉ Shreds अलग परिवहन तंत्र का उपयोग करते हैं। TCP पुनः प्रेषण और क्रमबद्धता प्रदान करता है, जबकि स्ट्रीमिंग gRPC में ऐसा फ़्लो कंट्रोल होता है जो रिसीवर की क्षमता को ध्यान में रखता है। UDP स्वयं गायब पैकेट दोबारा नहीं भेजता और डेटा प्राप्त करने वाले एप्लिकेशन को पिछड़ा काम पूरा करने देने के लिए भेजने वाले को प्रतीक्षा भी नहीं कराता।[3]
इसलिए किसी सर्वर पर gRPC का काम करना यह साबित नहीं करता कि UDP पथ या रिसीवर सही काम कर रहा है। प्रोटोकॉल-विशिष्ट फ़िल्टर, पोर्ट, डिलीवरी पथ और रिसीवर के कार्यान्वयन की अलग-अलग जाँच ज़रूरी है। gRPC में प्रोसेसिंग की देरी प्रतीक्षा समय या कनेक्शन टूटने के रूप में भी सामने आ सकती है।
gRPC पर ट्रांज़ैक्शन/सेकंड और UDP पर पैकेट/सेकंड अलग प्रोसेसिंग चरणों में अलग इकाइयाँ मापते हैं। डिलीवरी की मात्रा या हानि दर निकालने के लिए इनकी सीधे तुलना नहीं की जा सकती।
आने वाले पैकेट से उपयोग योग्य डेटा तक
सामान्य UDP सॉकेट रिसीवर में आने वाले पैकेट एप्लिकेशन तक पहुँचने से पहले NIC, कर्नेल और सॉकेट रिसीव बफ़र से गुजरते हैं। प्रोसेसिंग पीछे रह जाए तो वे होस्ट तक पहुँचने के बाद भी ड्रॉप हो सकते हैं। Linux के इंटरफ़ेस रिसीव काउंटरों में वे पैकेट भी शामिल होते हैं जो बाद के चरणों में ड्रॉप हो जाते हैं, इसलिए केवल रिसीव काउंट बढ़ना एप्लिकेशन तक डिलीवरी का प्रमाण नहीं है।[4]
कुल CPU उपयोग कम होने पर भी कोई एक रिसीव कतार या CPU कोर व्यस्त हो सकता है। NIC कतारों, इंटरप्ट किस कोर को सौंपे गए हैं और सिंगल-कोर प्रदर्शन की जाँच करें। एप्लिकेशन में जहाँ उपयुक्त हो, डेटा प्राप्त करने को आगे के काम से अलग रखें और भारी पार्सिंग तथा अत्यधिक लॉगिंग को रिसीव लूप से बाहर रखें। बड़ा रिसीव बफ़र अस्थायी बर्स्ट सँभाल सकता है; लगातार बनी रहने वाली प्रोसेसिंग क्षमता की कमी को दूर नहीं कर सकता।[5]
Shreds ब्लॉक डेटा के फ़्रैगमेंट होते हैं। फ़ॉरवर्ड एरर करेक्शन (FEC), एक ही समूह के डेटा और कोडिंग Shreds का उपयोग करके गायब डेटा पुनः प्राप्त कर सकता है, लेकिन पुनर्निर्माण के लिए फिर भी पर्याप्त फ़्रैगमेंट आवश्यक हैं। अधिक डुप्लिकेट पैकेट गायब फ़्रैगमेंट की जगह नहीं ले सकते।[6]
कार्यान्वयन के आधार पर, कोई रिसीवर पूरा स्लॉट तैयार होने से पहले ही उपलब्ध फ़्रैगमेंट से एंट्री का पुनर्निर्माण कर सकता है।[9] कुल पैकेट संख्या के साथ-साथ वैध और यूनिक Shreds, पुनर्निर्मित डेटा तथा एप्लिकेशन के लिए आवश्यक घटना को पहचानने तक का समय भी मापें।
हर चरण को एक ही समय अंतराल में मापें
दोनों ओर गंतव्य, पोर्ट और मापन का समय अंतराल एक जैसा रखें। नीचे दिए गए चरणों को अलग-अलग दर्ज करने से अगली जाँच का दायरा सीमित करने में मदद मिलती है।
| मापन बिंदु | क्या दर्ज करें | इससे क्या पता चलता है |
|---|---|---|
| भेजने वाला पक्ष | लक्षित गंतव्य के रिकॉर्ड और काउंटर की परिभाषा | भेजने के किस चरण को देखा गया |
| प्राप्त करने वाले होस्ट का प्रवेश बिंदु | लक्षित UDP ट्रैफ़िक का कैप्चर, NIC आँकड़े और कैप्चर के दौरान ड्रॉप हुए पैकेट | उस अवलोकन बिंदु पर कितना ट्रैफ़िक दिखाई दिया |
| OS और सॉकेट | UDP त्रुटियाँ, रिसीव बफ़र में ड्रॉप और कतार में बदलाव | क्या होस्ट के भीतर डेटा प्राप्त करने की प्रक्रिया में बैकलॉग बन रहा है |
| Shreds का पुनर्निर्माण | वैध और यूनिक Shreds, सफल पुनर्निर्माण, गायब डेटा और त्रुटियाँ | क्या पैकेट से आवश्यक डेटा मिल रहा है |
| एप्लिकेशन | प्रोसेसिंग बैकलॉग और उसी घटना की पहचान के टाइमस्टैम्प | क्या पहुँचने की गति का लाभ एप्लिकेशन तक पहुँचता है |
यदि किसी कैप्चर में बहुत कम पैकेट दिखें, तो पहले उसके फ़िल्टर, देखे जा रहे इंटरफ़ेस, कैप्चर में हुई हानि और NIC पर ड्रॉप की जाँच करें। कुछ OS काउंटर पूरे होस्ट या नेटवर्क नेमस्पेस को कवर करते हैं; उनका दायरा जाँचें और उन्हें लक्षित एप्लिकेशन से मिले मापन के साथ जोड़कर देखें।[4][5]
सीमित करने वाले चरण की पहचान करने के बाद सेटिंग बदलें। केवल बफ़र या रिंग बढ़ाने से बाधा किसी और स्थान पर जा सकती है या प्रतीक्षा समय बढ़ सकता है। ERPC के वर्तमान रिसीवर कॉन्फ़िगरेशन और जाँचों का विवरण यहाँ है:
सर्वर के साथ संचालन नीति भी चुनें
Solana Foundation उच्च प्रदर्शन वाले वैलिडेटरों के लिए NIC, भौतिक कोर, ड्राइवर और नेटवर्किंग पर नियंत्रण के महत्त्व को समझाता है। पूर्ण वैलिडेटर की उन आवश्यकताओं को हर Shreds रिसीवर पर ज्यों का त्यों लागू नहीं करना चाहिए। डेटा प्राप्त करने वाले एप्लिकेशन को अपनी स्ट्रीम और प्रोसेसिंग वर्कलोड के अनुकूल कॉन्फ़िगरेशन चाहिए।[7]
लागत या बिजली की खपत घटाना एक उचित संचालन लक्ष्य है। HFT और रीयल-टाइम एप्लिकेशन को CPU की तुरंत प्रतिक्रिया, लगातार बनी रहने वाली प्रोसेसिंग क्षमता और नेटवर्क पर कम प्रतीक्षा समय भी चाहिए। पावर-सेविंग अवस्था से सक्रिय होने पर लेटेंसी के मामले में समझौता करना पड़ सकता है।[8]
CPU मॉडल और कोर की संख्या के साथ-साथ यह भी जाँचें कि संसाधन कैसे साझा किए जाते हैं, लगातार लोड कैसे सँभाला जाता है, UDP ट्रैफ़िक के लिए क्या शर्तें हैं और वास्तविक नेटवर्क पथ क्या है।
ERPC स्ट्रीम और रिसीविंग वातावरण को साथ में देखता है
ERPC, Solana इंफ्रास्ट्रक्चर के पास डेटा सेंटर चुनने, नेटवर्क पथ, हार्डवेयर और संचालन सेटिंग पर काम करता है तथा Shreds और gRPC के साथ VPS और Bare Metal भी प्रदान करता है। आप अपने प्रोसेसिंग वर्कलोड के लिए VPS चुन सकते हैं और जब आपको केवल आपके उपयोग के लिए समर्पित भौतिक संसाधन चाहिए हों, तब Bare Metal से तुलना कर सकते हैं।
हमारे द्वारा उपलब्ध कराए गए वातावरण के कॉन्फ़िगरेशन और संचालन की समझ तकनीकी समस्याओं को सुलझाने में भी मदद करती है। हम भेजने वाले पक्ष के रिकॉर्ड की तुलना रिसीवर के मापन से कर सकते हैं और नेटवर्क, OS या एप्लिकेशन के लिए ठोस जाँचें तय कर सकते हैं। यहाँ वर्णित सहायता अनुरोध में, हमने भेजने वाले पक्ष के मापन की जाँच की और रिसीवर से अतिरिक्त मापन माँगे।
स्ट्रीम, रिसीवर की भौतिक स्थिति और एप्लिकेशन के कार्यान्वयन का एक साथ मूल्यांकन करने से यह पहचानना आसान होता है कि चुनी गई सेवा और आवश्यक डेटा के बीच क्या कमी है।
प्रति घंटे की बिलिंग से अपने मौजूदा वातावरण की तुलना करें
अपने रिसीविंग वातावरण को लेकर आप अनिश्चित हों, तो प्रति घंटे की बिलिंग पर ERPC VPS या Bare Metal सर्वर आज़माएँ और उसी स्ट्रीम तथा एप्लिकेशन से तुलना करें। अपने पसंदीदा क्षेत्र में मौजूदा कीमतों, उपलब्धता और ऑर्डर की शर्तों के लिए डैशबोर्ड देखें।
उपलब्ध कॉन्फ़िगरेशन से शुरू करें और प्राप्त पैकेटों की संख्या, पुनर्निर्मित डेटा, प्रोसेसिंग बैकलॉग तथा उन्हीं घटनाओं के पहचाने जाने के टाइमस्टैम्प दर्ज करें। अलग-अलग होस्ट के टाइमस्टैम्प की तुलना करते समय क्लॉक सिंक्रोनाइज़ेशन की सटीकता भी जाँचें। टेस्ट को अलग-अलग समय पर दोहराएँ और तुलना करें कि पथ के किस हिस्से में परिणाम बदलते हैं। इन मापों के आधार पर अपने एप्लिकेशन के अनुकूल सर्वर और डेटा सेंटर चुनें।
- VPS: https://erpc.global/hi/vps/
- Bare Metal: https://erpc.global/hi/baremetal/
- डैशबोर्ड: https://dashboard.erpc.global/hi/
संबंधित लेख
- Solana Stream SDK v4.0.0: https://erpc.global/hi/news/2026/11/07/erpc-solana-stream-sdk-v4-20261107/
- [9] Shreds UDP Forwarding Premium: https://erpc.global/hi/news/2026/11/03/erpc-shreds-udp-forwarding-premium-20261103/
- Validators DAO का आधिकारिक Discord: https://discord.gg/C7ZQSrCkYR
तकनीकी संदर्भ
- [1] AWS EC2 की बैंडविड्थ और PPS की अनुमत सीमाएँ: https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/monitoring-network-performance-ena.html
- [2] IETF UDP उपयोग दिशानिर्देश, बर्स्ट: https://www.rfc-editor.org/rfc/rfc8085.html#section-3.1.6
- [3] Linux UDP: https://man7.org/linux/man-pages/man7/udp.7.html
- [3] Linux TCP: https://man7.org/linux/man-pages/man7/tcp.7.html
- [3] gRPC फ़्लो कंट्रोल: https://grpc.io/docs/guides/flow-control/
- [4] Linux इंटरफ़ेस आँकड़े: https://docs.kernel.org/networking/statistics.html
- [4] libpcap में कैप्चर का व्यवहार और ड्रॉप: https://github.com/the-tcpdump-group/libpcap/blob/master/doc/README.linux
- [5] Linux नेटवर्किंग स्टैक में स्केलिंग: https://docs.kernel.org/networking/scaling.html
- [5] Linux सॉकेट रिसीव बफ़र: https://man7.org/linux/man-pages/man7/socket.7.html
- [5] Red Hat में UDP ड्रॉप की जाँच: https://docs.redhat.com/en/documentation/red_hat_enterprise_linux/10/html/network_troubleshooting_and_performance_tuning/tuning-udp-connections
- [6] Anza Turbine ब्लॉक प्रसार: https://docs.anza.xyz/consensus/turbine-block-propagation/
- [7] Solana Foundation, उच्च प्रदर्शन वाले वैलिडेटर का हार्डवेयर: https://solana.com/news/high-performance-solana-validators-run-on-bare-metal-hardware
- [8] Linux CPU निष्क्रिय समय प्रबंधन: https://docs.kernel.org/admin-guide/pm/cpuidle.html