








Rendi più veloce la tua app Solana: rivedi il volume dei dati gRPC, l’elaborazione in ricezione e le risorse di esecuzione
L’applicazione Solana che stai sviluppando potrebbe funzionare più velocemente. La quantità di dati ricevuti, l’elaborazione successiva e risorse come CPU e rete agiscono insieme. Rivedere questa combinazione può aiutarti a ottenere più prestazioni dal software che hai già.
Hai iniziato a sviluppare HFT su Solana, ti sei connesso a Geyser gRPC e vedi i dati nei log. Eppure, le decisioni non arrivano alla velocità che ti aspettavi. Le attese tra la ricezione e una decisione possono indicare dove migliorare. Inizia individuando ciò che puoi osservare nel codice attuale.
In ERPC, i dialoghi e i riscontri dei clienti ci offrono occasioni per esaminare la distribuzione dei dati, le impostazioni di ricezione e l’elaborazione delle applicazioni. Queste osservazioni contribuiscono a migliorare la distribuzione e la documentazione. Questo articolo illustra i meccanismi e i passaggi di indagine affinché gli sviluppatori che affrontano per la prima volta flussi rapidi e ad alto volume possano esplorare i miglioramenti nel proprio ambiente.
Inizia con una piccola verifica nel codice attuale
Puoi cercare i termini tecnici e i comandi di diagnosi man mano che diventano utili. Se hai un agente IA capace di leggere il codice del progetto, prova prima la breve richiesta qui sotto. Aggiungi dove viene eseguita l’applicazione e quando ti sembra lenta. I requisiti ancora da definire e le misurazioni non disponibili possono restare tali mentre inizi.
text
Voglio capire se la mia applicazione Solana ha margine per rispondere più velocemente.
Leggi prima il codice attuale e individua dove vengono ricevuti i dati e dove si conclude la decisione che li utilizza. Mantieni la sottoscrizione invariata e proponi la modifica più piccola che consenta di misurare il numero di eventi e il tempo trascorso in quell’intervallo.
Per questo primo compito, mostra i punti di misura, la modifica proposta, ciò che permetterebbe di scoprire e ciò che resterebbe non misurato. Se l’accesso all’host non è disponibile, inizia da ciò che si può osservare nell’applicazione. Non mostrare informazioni riservate, non modificare la produzione e non creare risorse a pagamento.
Voglio capire se la mia applicazione Solana ha margine per rispondere più velocemente.
Leggi prima il codice attuale e individua dove vengono ricevuti i dati e dove si conclude la decisione che li utilizza. Mantieni la sottoscrizione invariata e proponi la modifica più piccola che consenta di misurare il numero di eventi e il tempo trascorso in quell’intervallo.
Per questo primo compito, mostra i punti di misura, la modifica proposta, ciò che permetterebbe di scoprire e ciò che resterebbe non misurato. Se l’accesso all’host non è disponibile, inizia da ciò che si può osservare nell’applicazione. Non mostrare informazioni riservate, non modificare la produzione e non creare risorse a pagamento.Il primo risultato utile è sapere dove e cosa misurare nel proprio codice. Distinguere gli intervalli osservabili da quelli non misurati aiuta a scegliere cosa approfondire dopo. Più avanti nell’articolo trovi un prompt più dettagliato per proseguire la diagnosi.
Per esempio, un agente potrebbe rispondere: «La ricezione avviene in
stream.ts, in onData; la decisione viene completata in strategy.ts, in onDecisionComplete. Propongo una modifica che aggreghi i conteggi degli eventi ricevuti e delle decisioni completate, insieme al tempo trascorso in questo intervallo. L’intervallo precedente al callback non rientra nell’ambito di questa proposta di misurazione». Questo esempio usa nomi fittizi di file e funzioni in TypeScript. Qualunque sia il linguaggio di programmazione, verifica la coerenza tra questi tre elementi: i punti nel codice effettivo, le registrazioni da aggiungere e i limiti di questa misurazione. Se ricezioni e decisioni non hanno un rapporto uno a uno, chiedi all’agente di proporre anche la loro corrispondenza e l’unità di conteggio.Aggiungi una prospettiva sui flussi alla tua esperienza di sviluppo web
I servizi gestiti permettono agli sviluppatori di realizzare molte funzionalità web senza pensare ai singoli componenti del server. Questa esperienza resta una base per lavorare con i flussi Solana. Aggiungi una visione della quantità di dati che arriva continuamente e della velocità con cui l’applicazione li elabora.
Connettere un SDK a Solana può sembrare altrettanto semplice. Ma sottoscrivere un’ampia gamma di transazioni o aggiornamenti degli account cambia il carico di lavoro. I requisiti di banda, CPU e memoria dipendono dalla sottoscrizione, dalle dimensioni dei messaggi, dalla compressione, dall’elaborazione applicativa e dal traffico del momento. Non esiste un unico numero fisso di megabyte al secondo per «Solana».
Il punto di partenza è considerare il rapporto tra lavoro in arrivo e capacità di elaborazione sia nella progettazione sia nelle misurazioni.
Anche un flusso attivo può accumulare una coda
Per prima cosa, confronta i dati che arrivano nello stesso intervallo di un secondo usando riquadri delle stesse dimensioni. Ogni riquadro rappresenta 1.000 messaggi; ipotizzando 1 kB per messaggio, il totale è 1 MB. L’esempio con meno dati riceve 2 MB al secondo, quello con più dati ne riceve 12 MB al secondo. L’app ricevente ha la stessa capacità di elaborazione in entrambi i casi. È un modello illustrativo del volume del contenuto utile dei messaggi in unità decimali, senza compressione né intestazioni di protocollo.
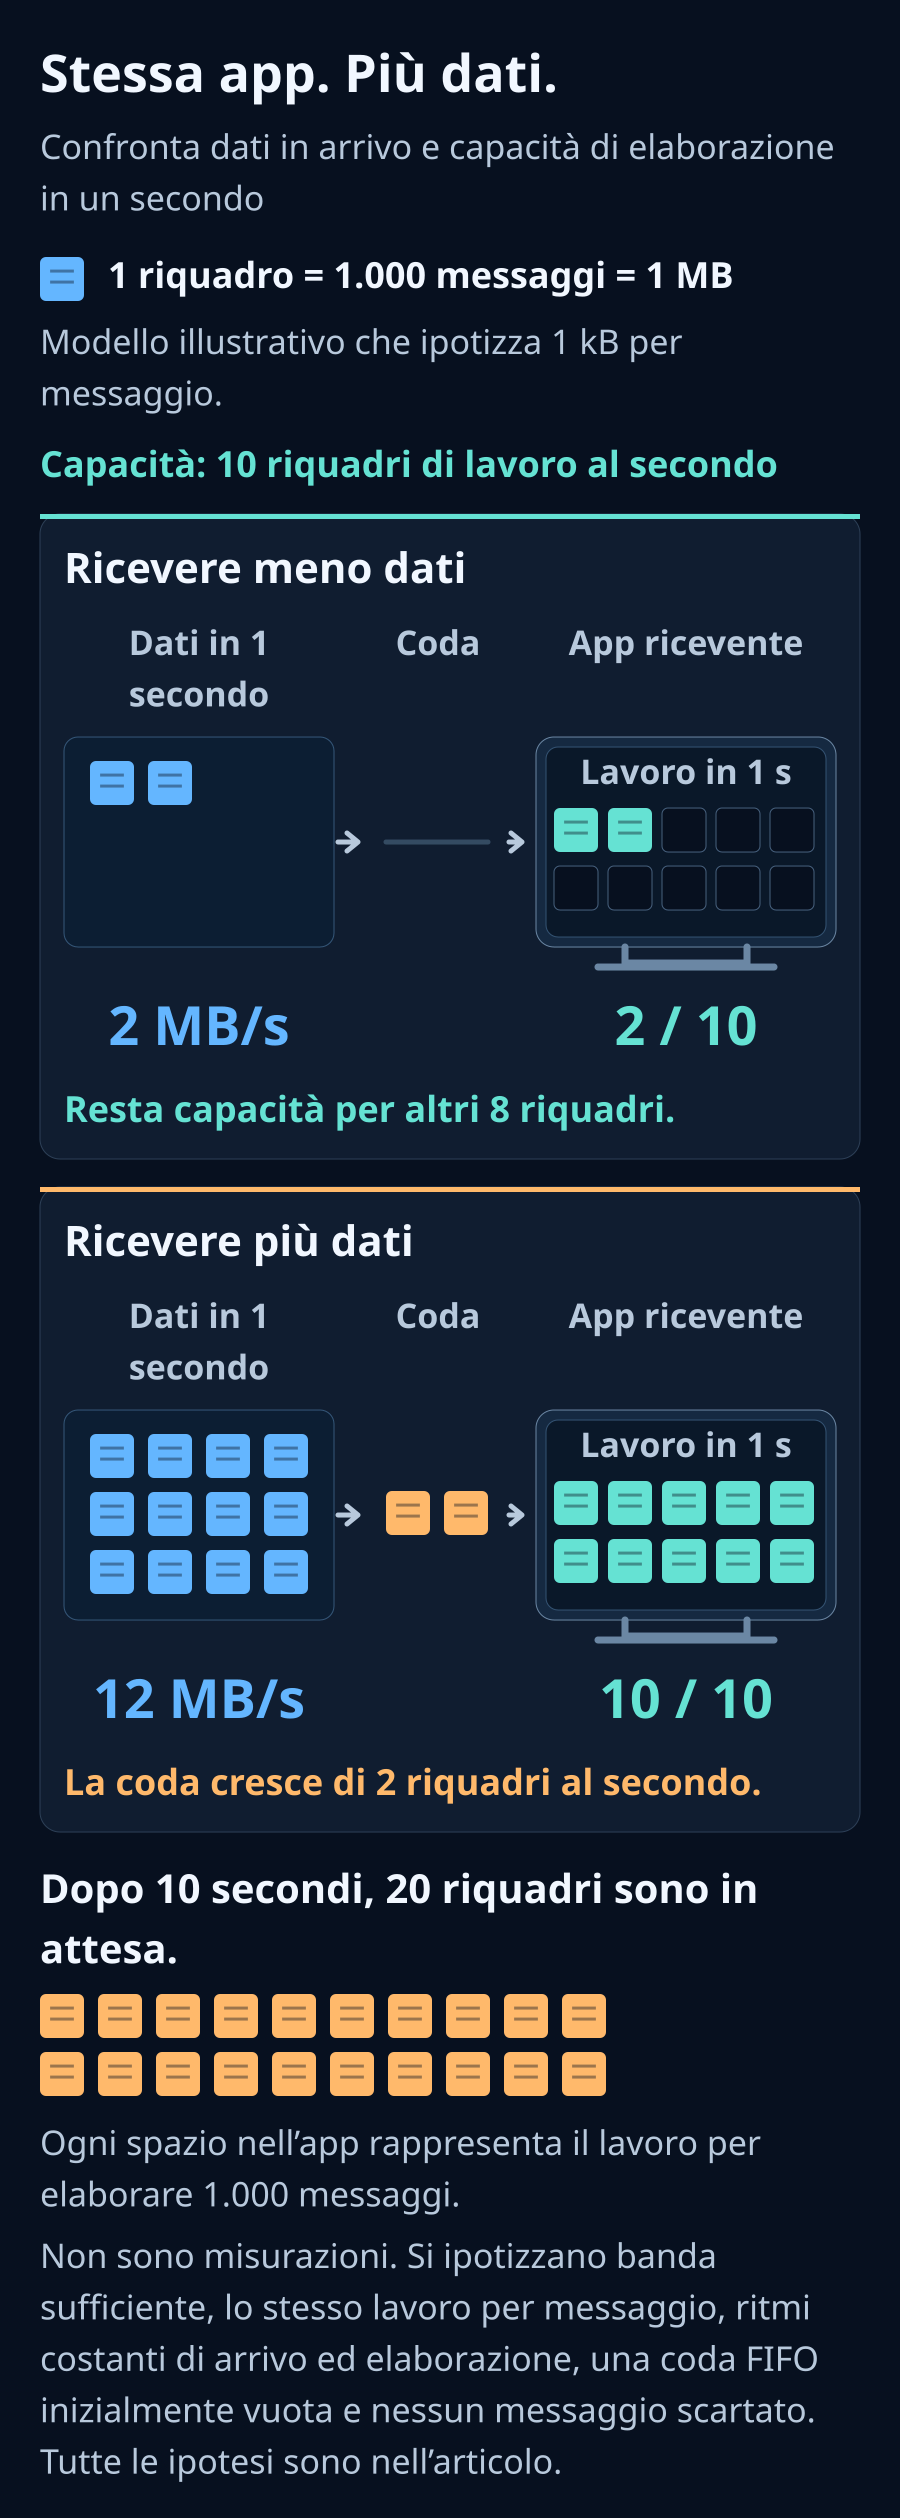
Consideriamo un modello illustrativo: arrivano 12.000 eventi al secondo e un computer può elaborarne 10.000 al secondo. Ogni evento richiede lo stesso lavoro, la coda è inizialmente vuota, gli eventi vengono elaborati in ordine di arrivo e nessuno viene scartato.
Ogni secondo rimangono altri 2.000 eventi da elaborare. Dopo dieci secondi, 20.000 eventi sono in attesa. Un evento che si aggiunge alla coda in quel momento aspetta circa due secondi prima che inizi la sua elaborazione. I log continuano a scorrere mentre la coda continua a crescere.
Si tratta di ipotesi esplicative, non di misurazioni di Solana o ERPC. Il modello presuppone un ingresso e una capacità costanti. Il traffico reale arriva a raffiche e i costi di elaborazione variano, quindi possono verificarsi attese anche quando la capacità media è sufficiente.
Il controllo di flusso di gRPC regola la trasmissione in base a ciò che il destinatario può accettare. Quando l’elaborazione resta indietro, l’attesa può estendersi oltre la coda dell’applicazione, alle librerie di comunicazione o al mittente. Una connessione attiva, o una scrittura riuscita in un’API di invio, non dimostra quanto siano aggiornati i dati al loro arrivo.[1]
Scegli i dati necessari prima che attraversino la rete
Se le tue decisioni richiedono informazioni solo su determinati programmi o account, definisci prima quei dati e applica filtri di sottoscrizione lato server. Yellowstone gRPC supporta filtri per transazioni e account. Verifica le combinazioni esatte e le possibilità disponibili nelle specifiche dell’API, dell’SDK e del servizio che utilizzi.[2]
Se non sai ancora cosa filtrare, esamina il codice per identificare i valori che l’applicazione usa nelle decisioni e i campi delle notifiche che li forniscono. Da questa corrispondenza ricava possibili condizioni di sottoscrizione, poi verifica che includano gli eventi necessari già noti. Controllare sia la riduzione degli eventi sia la conservazione dei dati richiesti offre una base solida per il confronto successivo.
Ricevere tutto e scartare i dati inutili nel client comporta comunque il lavoro di trasferimento, decrittazione e decodifica fino a quel punto. Filtrare alla fonte può ridurre questo lavoro. Nell’esempio precedente, limitare l’ingresso ai 2.000 eventi al secondo necessari lascia margine alla stessa capacità di elaborazione di 10.000 eventi al secondo.
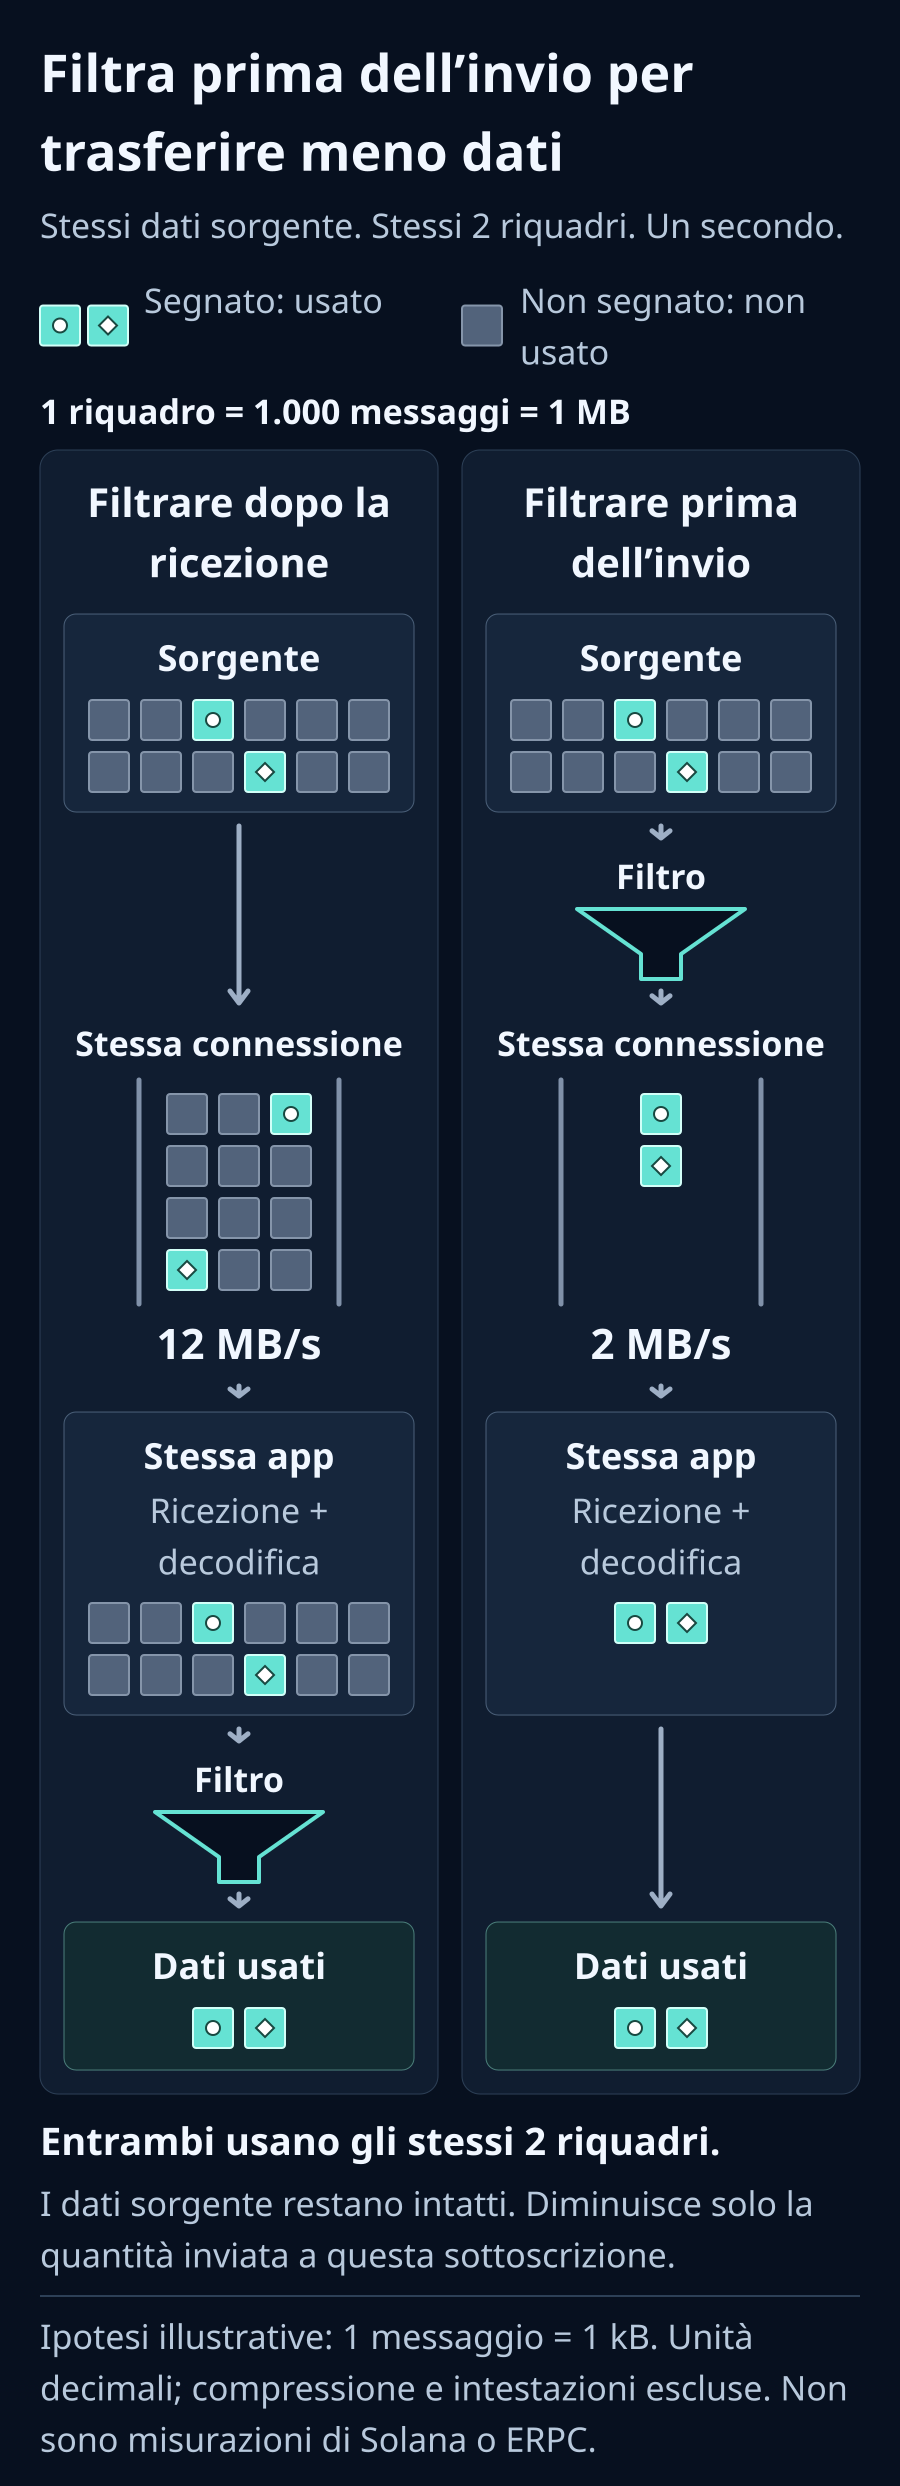
Pensa al traffico stradale: la lunghezza della strada rappresenta la distanza di propagazione, le corsie rappresentano la banda, il casello rappresenta la capacità di elaborazione in ricezione e la fila di auto rappresenta il lavoro in attesa. Mandare solo le auto necessarie allo stesso casello produce una coda diversa dal convogliare tutte le auto della zona. Accorciare la strada e ridurre il numero di auto sono due miglioramenti distinti.
La comunicazione ha anche limiti fisici. Trasferire 100 MB a 1 Gbps richiede in teoria almeno 0,8 secondi; a 10 Gbps, richiede 0,08 secondi. Questi limiti inferiori usano unità decimali ed escludono distanza, overhead del protocollo, ritrasmissioni e lavoro in coda. Non significano che ogni singolo evento di un flusso subisca un ritardo di 0,8 secondi.
Anche quando un calcolo è più rapido di uno scambio di rete, inviare dati inutili ha comunque un costo. Considera separatamente il tempo di propagazione, la quantità di dati che può attraversare il collegamento per unità di tempo e il lavoro che può essere completato dopo l’arrivo.
Alcune applicazioni richiedono tutti i dati, come indici completi, audit e ricerca. Hanno bisogno di capacità di ricezione, elaborazione e archiviazione adeguate a quel carico. Ricevere tutte le singole notifiche è inoltre diverso dall’attendere un blocco completo: dati aggregati e ricostruiti sotto forma di blocco. Verifica se la tua decisione dipende inutilmente da dati non pertinenti o dal completamento dell’aggregazione.[2]
Rivedi l’elaborazione in ricezione e le risorse di esecuzione
Rust può aiutare a ridurre i costi di elaborazione. Per sfruttarne la velocità, esamina anche il volume in ingresso, la capacità effettiva del collegamento, i tempi di attesa delle scritture sul database, i lock e le parti seriali. In un runtime asincrono, assegnare il lavoro intensivo sulla CPU e quello che blocca un thread a parti appropriate del sistema può migliorare a sua volta l’applicazione.[3]
Mantieni breve il ciclo di ricezione e separa il lavoro costoso. Definisci un limite per la coda e cosa accade quando è piena. Una coda illimitata può nascondere ritardi crescenti sotto forma di maggiore consumo di memoria. Neppure una coda limitata risolve una carenza persistente di capacità di elaborazione. Rispetta l’ordine e la completezza richiesti scegliendo tra sottoscrizioni più mirate, elaborazione più efficiente, partizionamento, parallelismo e risorse aggiuntive.
Inizia misurando dalla ricezione fino alla conclusione della decisione, poi approfondisci i punti in cui emerge un’attesa. La tabella seguente propone un primo modo di esaminare ogni area. I nomi dettagliati delle metriche e i comandi sono riportati anche nel prompt diagnostico più avanti, così puoi usare gli elementi che diventano rilevanti.
| Risorsa | Cosa verificare per prima cosa |
|---|---|
| CPU | Il lavoro si concentra su un solo core? Controlla l’utilizzo complessivo e per core, insieme ai limiti CPU dell’ambiente di esecuzione |
| Memoria | Gli eventi in attesa o l’uso di memoria continuano a crescere? Osserva la quantità di dati in coda insieme al tempo di attesa dell’evento più vecchio |
| Disco e database | La ricezione aspetta che il salvataggio finisca? Controlla le scritture sul database e le attese di archiviazione. Se l’applicazione non conserva dati, puoi partire da altre aree |
| Rete | Il collegamento e le sue impostazioni sono adatti al volume in ingresso? Controlla la velocità effettiva di trasferimento, il tempo di andata e ritorno e le ritrasmissioni |
Quando approfondisci la comunicazione, le impostazioni delle librerie possono fornire altri indizi. HTTP/2 ha finestre di controllo del flusso sia a livello di stream sia di connessione, che regolano la quantità di dati aggiuntivi che l’altro endpoint può inviare. Se questa disponibilità è ridotta rispetto al prodotto banda-ritardo, cioè la banda moltiplicata per il tempo di andata e ritorno, il throughput può raggiungere un limite anche quando il collegamento ha ancora margine. In questo caso, esamina la libreria e gli intermediari, verificando l’ambito di applicazione dell’impostazione e il suo costo in memoria mentre la modifichi.[4]
Misura l’attualità e l’attesa, oltre alla ricezione
Per iniziare a verificare gli accumuli all’interno dell’applicazione, mantieni la sottoscrizione attuale e registra, nello stesso periodo di osservazione, gli eventi ricevuti, gli eventi completati, il numero di elementi in coda e l’attesa dell’evento più vecchio. Se non sai dove misurare, usa il prompt più avanti per chiedere a un agente di esaminare il codice. Se non c’è una coda esplicita, inizia dal tempo tra la ricezione e il completamento della decisione e confrontalo con una versione diagnostica priva delle elaborazioni costose.
Il seguente pseudocodice, indipendente dal linguaggio e dall’SDK, mostra dove collocare le misurazioni. Mantieni l’ordine di elaborazione e la concorrenza attuali mentre aggiungi la strumentazione al codice reale.
text
Quando vengono ricevuti i dati:
  Aumentare di 1 il conteggio degli eventi ricevuti
  Registrare un timestamp monotono di ricezione associato all’evento
  Passare l’evento all’elaborazione esistente

Quando si conclude la decisione che usa lo stesso evento:
  Aumentare di 1 il conteggio degli eventi completati
  Calcolare e aggregare il tempo trascorso dalla ricezione
Quando vengono ricevuti i dati:
Aumentare di 1 il conteggio degli eventi ricevuti
Registrare un timestamp monotono di ricezione associato all’evento
Passare l’evento all’elaborazione esistente
Quando si conclude la decisione che usa lo stesso evento:
Aumentare di 1 il conteggio degli eventi completati
Calcolare e aggregare il tempo trascorso dalla ricezioneSe ricezione e decisioni non hanno una relazione uno a uno, definisci prima quella corrispondenza e l’unità da contare. Riassumere le osservazioni su un intervallo fisso permette di confrontare i risultati senza aggiungere un messaggio di log per ogni evento.
Per approfondire la diagnosi, registra anche i byte ricevuti, i byte in coda, i p50/p95/p99 del tempo di elaborazione, gli errori e le riconnessioni. Il p99 è la soglia entro cui rientra il 99% dei tempi di elaborazione misurati. Specifica dove viene effettuata ogni misura. Il traffico della scheda di rete, la dimensione Protobuf e la dimensione degli oggetti decodificati sono quantità diverse.
Usa un orologio monotono per i tempi trascorsi su uno stesso host, distinguendo ricezione, inserimento in coda, estrazione e completamento. Se la decodifica è già avvenuta quando viene eseguito il callback dell’SDK, l’intervallo precedente non è misurato. Per confrontare un timestamp del mittente, verifica la sincronizzazione degli orologi e il punto in cui quel timestamp viene generato. Non definire automaticamente la differenza come pura latenza di rete.
Se l’attesa diminuisce rimuovendo l’elaborazione applicativa senza cambiare la sottoscrizione, è un indizio per indagare l’effetto dell’aggiunta di tale elaborazione. Un lavoro rapido dopo il callback non dimostra, da solo, che i dati siano arrivati aggiornati.
Puoi anche confrontare gli identificatori degli eventi con un flusso di riferimento che abbia la stessa sottoscrizione e lo stesso commitment, cioè lo stadio di conferma dei dati che utilizzi. Verifica che il flusso di riferimento non stia a sua volta accumulando ritardo. Un salto tra numeri di slot non dimostra da solo una perdita di dati e non corrisponde a un numero fisso di secondi: alcuni slot non contengono eventi corrispondenti ai filtri e gli slot possono essere saltati.[5]
mtr aiuta a esaminare latenza e modalità di risposta lungo un percorso di rete. Una perdita limitata a un hop intermedio può dipendere da un router che limita le proprie risposte. Confronta il comportamento fino alla destinazione con le ritrasmissioni TCP, le velocità effettive di trasferimento e un altro percorso. mtr da solo non può dimostrare l’esaurimento della banda o un guasto del data center.[6]
Un prompt diagnostico per il tuo agente IA
Fornisci il testo seguente a un agente che possa leggere il codice del tuo progetto. Inizia indicando dove viene eseguito e quando e in che modo ti sembra lento. L’agente può prima esaminare dal codice la connessione, la sottoscrizione e l’elaborazione dopo la ricezione. Non devi incollare chiavi API o credenziali nella conversazione.
Se gli eventi necessari o il ritardo accettabile non sono ancora definiti, indica che sono da decidere. Spiega con parole tue quali informazioni vuoi osservare e quali decisioni vuoi prendere. Tratta le misure non disponibili come non misurate e inizia da ciò che puoi esaminare ora.
text
Esamina se il mio client Solana Geyser gRPC ha margine per rispondere più velocemente. Se sono presenti ritardi, accumuli o disconnessioni, isolane le cause e aiutami a migliorarli. Non dedurre che vengano elaborati dati aggiornati soltanto perché la connessione riesce o i log mostrano eventi. Non decidere in anticipo se la causa sia nel client o nel fornitore.

1. Definisci l’obiettivo: eventi necessari, attualità accettabile, requisiti di ordinamento e perdita di dati, filtri di sottoscrizione, commitment, regione dell’endpoint, versioni effettive di linguaggio, SDK e libreria gRPC, ambiente di esecuzione. Esamina prima codice, configurazione e lockfile disponibili; chiedi soltanto le informazioni mancanti. Lascia esplicitamente aperti i requisiti non ancora decisi ed esamina prima lo stato attuale. Non mostrare segreti e oscura i dati sensibili nei log condivisi.

2. Misura dalla ricezione al completamento. Dai priorità alla ricezione, al completamento e ai tempi di attesa, iniziando da ciò che si può misurare. Registra eventi/secondo, byte/secondo, eventi completati/secondo, numero di elementi e byte in coda, attesa dell’evento più vecchio, p50/p95/p99, errori, disconnessioni, riconnessioni e dati scartati. Se non c’è una coda esplicita, dichiaralo e identifica gli intervalli di elaborazione che puoi osservare. Indica i punti di osservazione e gli intervalli non misurati. Distingui il traffico della scheda di rete, i byte trasmessi, la dimensione Protobuf e gli oggetti decodificati. Usa un orologio monotono per i tempi locali trascorsi; verifica sincronizzazione e origine dei timestamp esterni. Non convertire direttamente un salto tra slot in perdita di dati o in una durata fissa.

3. Separa i vincoli di CPU, memoria, disco e rete. Esamina CPU per core e thread, steal e limiti CPU, RSS/GC/swap/PSI, attese I/O, byte, pacchetti scartati ed errori della scheda di rete, ritrasmissioni TCP e RTT. Tra i possibili strumenti Linux ci sono mpstat, pidstat, vmstat, iostat, sar, ss -ti e /proc/pressure/. Se mancano strumenti o permessi, dichiaralo e fornisci i comandi minimi necessari. Se l’accesso all’host non è disponibile, cerca informazioni nella console di gestione o nella strumentazione dell’applicazione e indica come non misurate le grandezze non disponibili. Non inventare mai risultati.

4. Esamina entrambe le finestre HTTP/2, di stream e di connessione, i buffer di ricezione TCP, proxy, VPN e sidecar. Consulta la documentazione ufficiale della versione installata dell’SDK e considera il prodotto banda-ritardo. Controlla conversione JSON, logging per evento, chiamate sincrone al database o ad API esterne, lavoro bloccante, lock, creazione illimitata di task e code senza limite nel ciclo di ricezione o attorno ad esso. Non considerare Rust o il solo codice asincrono una soluzione.

5. Se mtr o uno strumento equivalente è disponibile, esegui una misurazione limitata verso l’host effettivo dell’endpoint. Sui sistemi supportati valuta: mtr --tcp --port <PORT> --report --report-cycles 30 <HOST>. Usa la porta effettiva invece di presumere una porta TLS standard. Non classificare come guasto una perdita limitata a un hop intermedio; confronta il comportamento a destinazione, le ritrasmissioni e altri percorsi. Non usare mtr al posto di una misura della banda.

6. Registra una misura iniziale con la sottoscrizione attuale e cambia una sola variabile alla volta. Mantieni la stessa sottoscrizione quando confronti un percorso di ricezione minimo con la pipeline che include l’elaborazione applicativa. Tratta le modifiche ai filtri come un confronto separato. Prima di restringere la sottoscrizione, associa i dati usati per decidere alle notifiche da cui provengono e verifica che i filtri proposti includano gli eventi necessari già identificati. Progetta code limitate e parallelismo che preservino l’ordine e la completezza richiesti e specifica il comportamento quando la coda è piena. Non scartare silenziosamente dati necessari. Conserva i dettagli completi degli errori e le scadenze per i nuovi tentativi; non riconnetterti durante una pausa imposta.

7. Riporta separatamente fatti osservati, possibili cause, ipotesi non verificate, modifiche verificabili e misure prima e dopo. Stima CPU, RAM, banda, prestazioni di archiviazione e collocazione a partire dalla sottoscrizione e dalle misure, includendo margine per i picchi. Non inventare un requisito hardware fisso e universale per Solana. Se necessario, proponi un confronto tra macchine o data center usando la stessa sottoscrizione, SDK e commitment.

Se uso ERPC, leggi la sua FAQ gRPC aggiornata e segui le istruzioni per il codice di errore esatto:
https://erpc.global/en/faq/grpc/general/
Se ERPC User MCP o una CLI è collegato, verifica le operazioni e i permessi effettivamente disponibili. L’accesso all’account non implica l’accesso alla diagnostica dell’host. Prima di creare un VPS a pagamento, modificare un contratto, aggiornare la produzione o riavviarla, presenta costo, scopo e durata del test e ottieni la mia approvazione. Completa prima la diagnosi e le migliorie verificabili.
Esamina se il mio client Solana Geyser gRPC ha margine per rispondere più velocemente. Se sono presenti ritardi, accumuli o disconnessioni, isolane le cause e aiutami a migliorarli. Non dedurre che vengano elaborati dati aggiornati soltanto perché la connessione riesce o i log mostrano eventi. Non decidere in anticipo se la causa sia nel client o nel fornitore.
1. Definisci l’obiettivo: eventi necessari, attualità accettabile, requisiti di ordinamento e perdita di dati, filtri di sottoscrizione, commitment, regione dell’endpoint, versioni effettive di linguaggio, SDK e libreria gRPC, ambiente di esecuzione. Esamina prima codice, configurazione e lockfile disponibili; chiedi soltanto le informazioni mancanti. Lascia esplicitamente aperti i requisiti non ancora decisi ed esamina prima lo stato attuale. Non mostrare segreti e oscura i dati sensibili nei log condivisi.
2. Misura dalla ricezione al completamento. Dai priorità alla ricezione, al completamento e ai tempi di attesa, iniziando da ciò che si può misurare. Registra eventi/secondo, byte/secondo, eventi completati/secondo, numero di elementi e byte in coda, attesa dell’evento più vecchio, p50/p95/p99, errori, disconnessioni, riconnessioni e dati scartati. Se non c’è una coda esplicita, dichiaralo e identifica gli intervalli di elaborazione che puoi osservare. Indica i punti di osservazione e gli intervalli non misurati. Distingui il traffico della scheda di rete, i byte trasmessi, la dimensione Protobuf e gli oggetti decodificati. Usa un orologio monotono per i tempi locali trascorsi; verifica sincronizzazione e origine dei timestamp esterni. Non convertire direttamente un salto tra slot in perdita di dati o in una durata fissa.
3. Separa i vincoli di CPU, memoria, disco e rete. Esamina CPU per core e thread, steal e limiti CPU, RSS/GC/swap/PSI, attese I/O, byte, pacchetti scartati ed errori della scheda di rete, ritrasmissioni TCP e RTT. Tra i possibili strumenti Linux ci sono mpstat, pidstat, vmstat, iostat, sar, ss -ti e /proc/pressure/. Se mancano strumenti o permessi, dichiaralo e fornisci i comandi minimi necessari. Se l’accesso all’host non è disponibile, cerca informazioni nella console di gestione o nella strumentazione dell’applicazione e indica come non misurate le grandezze non disponibili. Non inventare mai risultati.
4. Esamina entrambe le finestre HTTP/2, di stream e di connessione, i buffer di ricezione TCP, proxy, VPN e sidecar. Consulta la documentazione ufficiale della versione installata dell’SDK e considera il prodotto banda-ritardo. Controlla conversione JSON, logging per evento, chiamate sincrone al database o ad API esterne, lavoro bloccante, lock, creazione illimitata di task e code senza limite nel ciclo di ricezione o attorno ad esso. Non considerare Rust o il solo codice asincrono una soluzione.
5. Se mtr o uno strumento equivalente è disponibile, esegui una misurazione limitata verso l’host effettivo dell’endpoint. Sui sistemi supportati valuta: mtr --tcp --port <PORT> --report --report-cycles 30 <HOST>. Usa la porta effettiva invece di presumere una porta TLS standard. Non classificare come guasto una perdita limitata a un hop intermedio; confronta il comportamento a destinazione, le ritrasmissioni e altri percorsi. Non usare mtr al posto di una misura della banda.
6. Registra una misura iniziale con la sottoscrizione attuale e cambia una sola variabile alla volta. Mantieni la stessa sottoscrizione quando confronti un percorso di ricezione minimo con la pipeline che include l’elaborazione applicativa. Tratta le modifiche ai filtri come un confronto separato. Prima di restringere la sottoscrizione, associa i dati usati per decidere alle notifiche da cui provengono e verifica che i filtri proposti includano gli eventi necessari già identificati. Progetta code limitate e parallelismo che preservino l’ordine e la completezza richiesti e specifica il comportamento quando la coda è piena. Non scartare silenziosamente dati necessari. Conserva i dettagli completi degli errori e le scadenze per i nuovi tentativi; non riconnetterti durante una pausa imposta.
7. Riporta separatamente fatti osservati, possibili cause, ipotesi non verificate, modifiche verificabili e misure prima e dopo. Stima CPU, RAM, banda, prestazioni di archiviazione e collocazione a partire dalla sottoscrizione e dalle misure, includendo margine per i picchi. Non inventare un requisito hardware fisso e universale per Solana. Se necessario, proponi un confronto tra macchine o data center usando la stessa sottoscrizione, SDK e commitment.
Se uso ERPC, leggi la sua FAQ gRPC aggiornata e segui le istruzioni per il codice di errore esatto:
https://erpc.global/en/faq/grpc/general/
Se ERPC User MCP o una CLI è collegato, verifica le operazioni e i permessi effettivamente disponibili. L’accesso all’account non implica l’accesso alla diagnostica dell’host. Prima di creare un VPS a pagamento, modificare un contratto, aggiornare la produzione o riavviarla, presenta costo, scopo e durata del test e ottieni la mia approvazione. Completa prima la diagnosi e le migliorie verificabili.Prova lo stesso codice in un ambiente confrontabile
Le misurazioni possono rivelare possibilità di migliorare le risorse CPU o di memoria, oppure il percorso di rete. Una CPU più potente, più memoria, il lavoro suddiviso o una posizione più vicina alla fonte sono opzioni possibili. Collegare queste scelte al volume di dati dell’applicazione e alle osservazioni rende più chiari sia il motivo per provarle sia l’effetto da verificare.
ERPC VPS è una possibilità per eseguire client di streaming vicino all’infrastruttura Solana. La fatturazione oraria consente di confrontare lo stesso codice e la stessa sottoscrizione con l’ambiente attuale. Controlla prezzi, regioni e disponibilità correnti nel Dashboard. Anche su ERPC, le risorse necessarie dipendono dalla sottoscrizione e dall’elaborazione dell’applicazione.[7]
Confronta la crescita della coda, l’attualità al completamento dell’elaborazione, p99 ed errori, oltre al throughput di ricezione. Registra il periodo di misurazione e il carico della blockchain. Confronti simultanei o misure ripetute aiutano a non scambiare variazioni del traffico nel tempo per differenze tra ambienti.
Per ricevere assistenza, condividi le impostazioni di sottoscrizione con i dati sensibili oscurati, la versione dell’SDK, la regione, i timestamp, i messaggi di errore completi e le misure di cui disponi. Puoi indicare come non misurati i valori che non hai ancora ottenuto.
Ogni osservazione in più rende più facile scegliere la prossima modifica da provare. Conserva i dati necessari e verifica i miglioramenti un passo alla volta. Continueremo a migliorare le informazioni e l’infrastruttura che sostengono il tuo sviluppo.
Riferimenti e collegamenti utili
- [1] gRPC Flow Control: https://grpc.io/docs/guides/flow-control/
- [2] Specifica delle sottoscrizioni Yellowstone gRPC: https://github.com/rpcpool/yellowstone-grpc/blob/master/README.md
- [3] Tokio: CPU-bound tasks and blocking code: https://docs.rs/tokio/latest/tokio/index.html#cpu-bound-tasks-and-blocking-code
- [4] Controllo di flusso HTTP/2: https://www.rfc-editor.org/rfc/rfc9113.html#section-5.2
- [5] Terminologia Solana: https://solana.com/docs/references/terminology
- [6] Documentazione ufficiale di mtr: https://github.com/traviscross/mtr
- [7] ERPC VPS: https://erpc.global/it/vps/
- Linux PSI: https://docs.kernel.org/accounting/psi.html
- API di misurazione Node.js: https://nodejs.org/api/perf_hooks.html
- ERPC gRPC FAQ: https://erpc.global/it/faq/grpc/general/
- ERPC Web Dashboard: https://dashboard.erpc.global/it/
- Discord ufficiale di Validators DAO: https://discord.gg/C7ZQSrCkYR


