เลือก Solana VPS หรือ Bare Metal: CPU, UDP และเครือข่าย
เซิร์ฟเวอร์สำคัญพอ ๆ กับสตรีม Solana
สตรีม Solana ที่รวดเร็วไม่ได้แปลว่าแอปจะได้รับข้อมูลทันเวลาเสมอไป CPU ใช้งานน้อยและพอร์ตที่ระบุ 1 Gbps ไม่เพียงพอสำหรับอธิบาย Shreds ที่ไม่ครบหรือ gRPC lag ที่เพิ่มขึ้น ต้องวัดตั้งแต่ต้นทางถึงแอป บทความนี้ใช้ข้อมูลตรวจสอบที่ไม่ระบุตัวตน ผลทดสอบอิสระ และ benchmark สาธารณะโดยไม่กล่าวโทษผู้ให้บริการเมื่อยังไม่ทราบสาเหตุ
ความเร็วสูงหมายถึงแพ็กเก็ตจำนวนมากและการพุ่งขึ้นชั่วคราว
Shreds และ Yellowstone Geyser gRPC ส่งข้อมูลต่อเนื่องและอาจมี burst สั้น ๆ Bandwidth, packets per second (PPS), RTT, jitter, packet loss และเวลาประมวลผลเป็นคนละตัวชี้วัด สมมติรับ 4 MB/s เป็นเวลา 30 วัน จะรวมประมาณ 10.4 TB แต่เฉลี่ยเพียง 32 Mbps จึงยังสรุปไม่ได้ว่า 1 Gbps ไม่พอ ต้องวัดข้อจำกัด UDP, uplink ที่แชร์กัน และความสามารถของตัวรับ
สตรีมทำงาน แต่ข้อมูลยังไม่ครบ
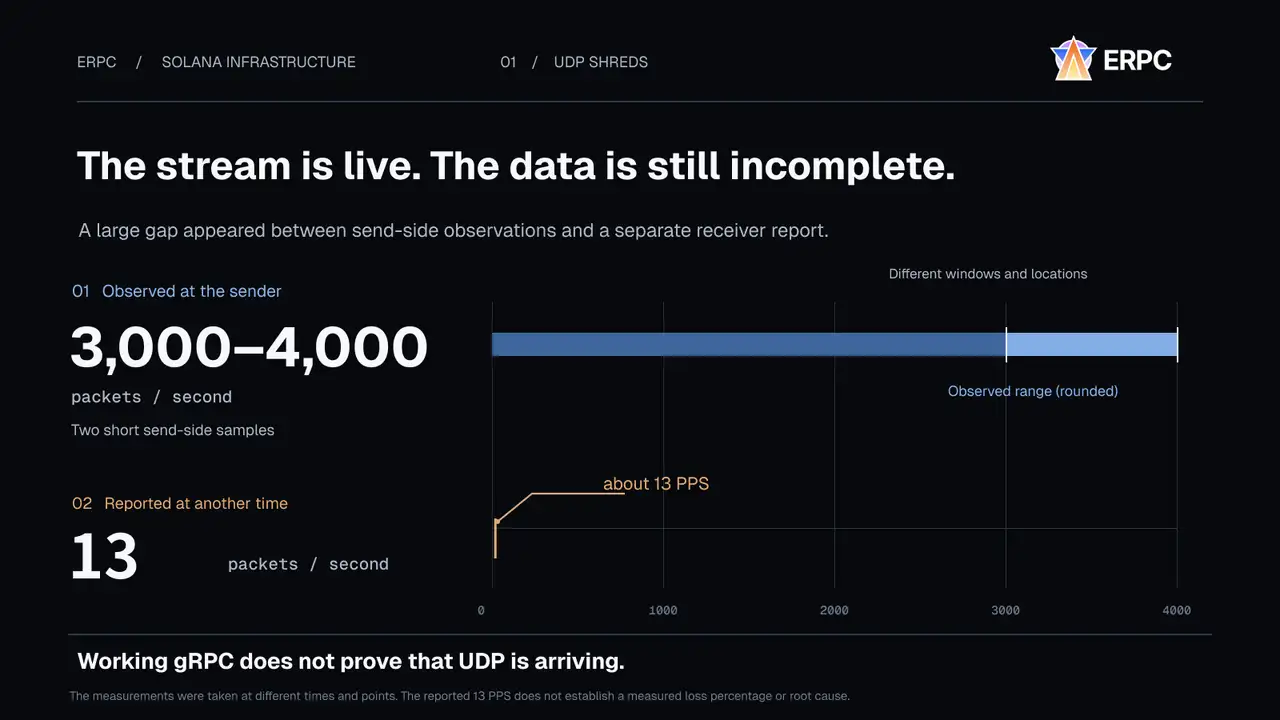
การตรวจสอบแบบไม่ระบุตัวตนครั้งหนึ่งพบฝั่งส่งประมาณ 3,400–3,900 UDP packets/s ขณะที่ฝั่งรับรายงานประมาณ 13 packets/s ในอีกช่วงเวลา Shreds ที่ได้รับถูกต้องแต่ไม่พอสำหรับการประกอบข้อมูล และ gRPC บนเครื่องเดียวกันยังทำงาน เวลาหรือจุดวัดไม่ตรงกัน จึงไม่สามารถคำนวณเปอร์เซ็นต์สูญหายหรือระบุสาเหตุได้ PPS หลักพันก็ไม่ได้หนักเกินสำหรับเซิร์ฟเวอร์ทั่วไปโดยอัตโนมัติ
หาจุดสังเกตก่อนเปลี่ยนเครื่อง
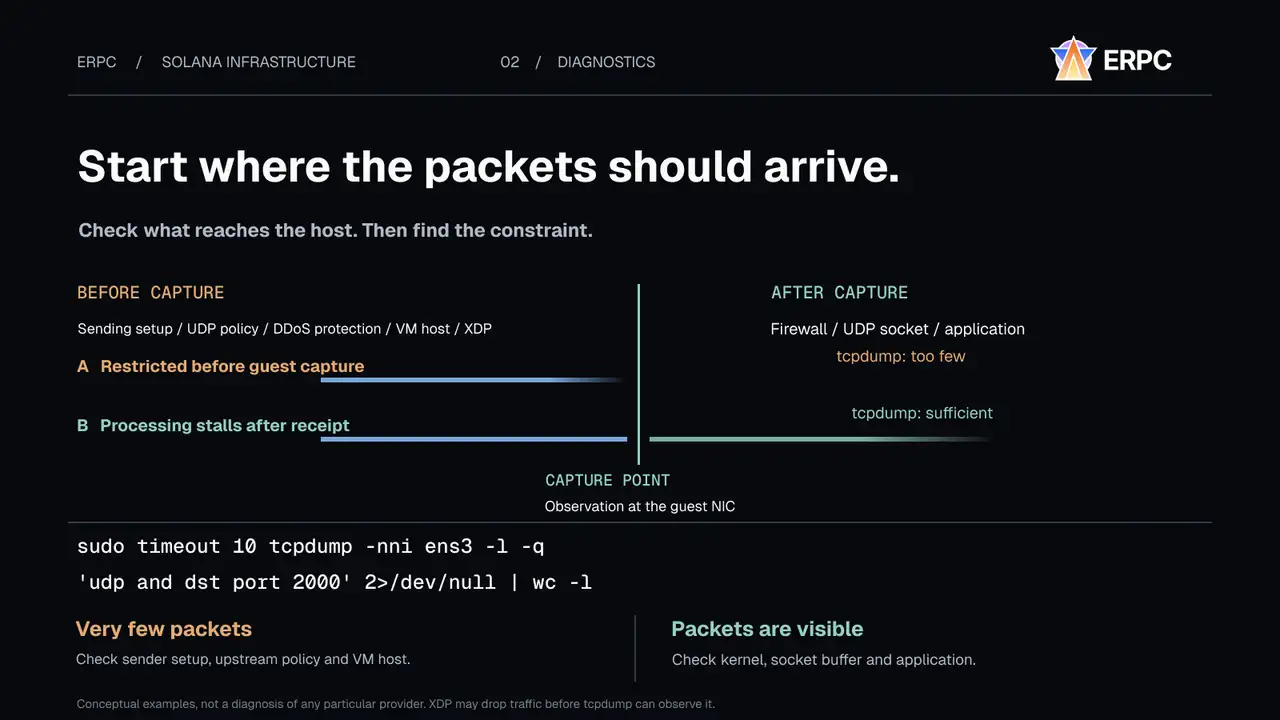
นโยบายเครือข่าย DDoS protection หรือโฮสต์ virtualization อาจจำกัด UDP ก่อนถึง VM หลัง NIC ก็อาจสูญหายใน kernel, socket buffer หรือแอป เริ่มจับแพ็กเก็ตด้วย tcpdump ที่อินเทอร์เฟซรับแล้วตรวจ NIC counters, UDP errors และคิว XDP อาจทิ้งแพ็กเก็ตก่อน tcpdump เห็น ต้องเทียบปลายทาง พอร์ต และช่วงเวลาเดียวกันทั้งสองฝั่ง
เมืองเดียวกันไม่รับประกันเส้นทางสั้น
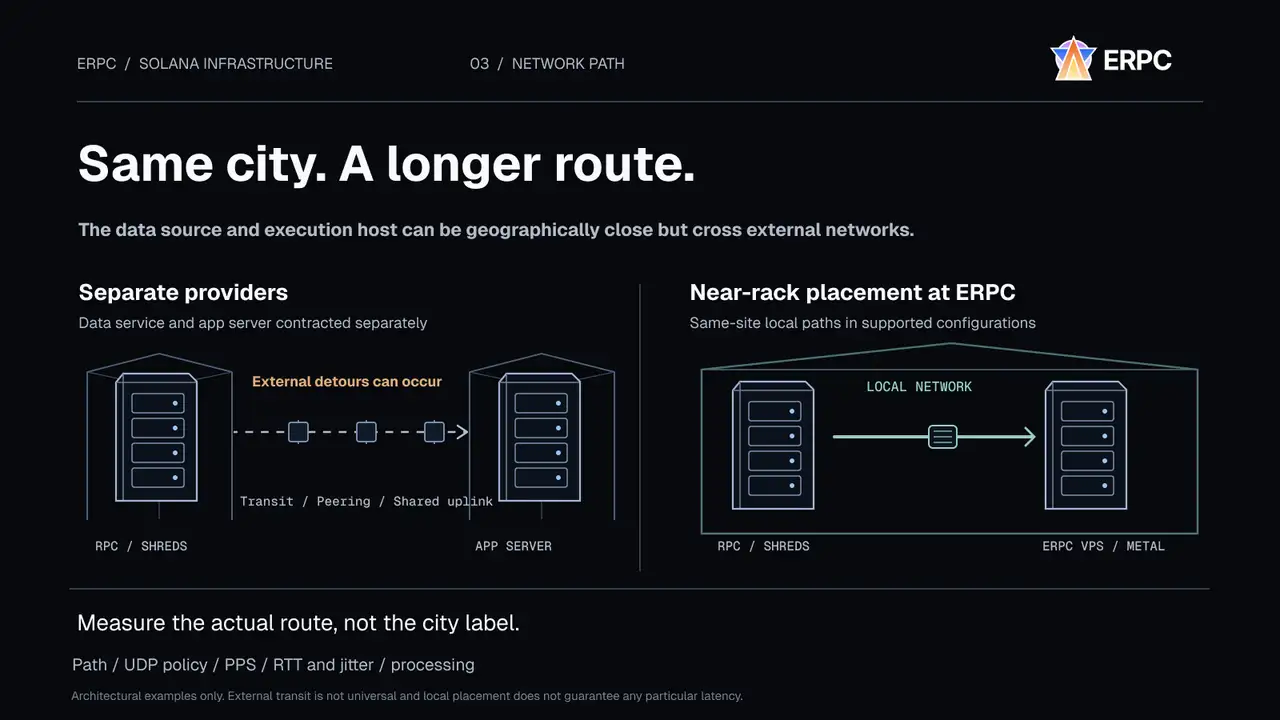
เซิร์ฟเวอร์สองเครื่องใน Frankfurt อาจอยู่คนละศูนย์ข้อมูลและผ่าน transit ภายนอก จากเครื่องภายนอกเดียวกัน วัด RTT ไปยังสอง endpoint ที่อยู่ใกล้กันใน Amsterdam ได้ประมาณ 11 ms และ 23 ms ทั้งที่สอง endpoint ห่างกันเพียงประมาณ 0.1 ms ช่วงอื่น upstream มีการสูญเสีย 5–8% และหน่วงเพิ่มประมาณ 5 ms ตัวเลขนี้เฉพาะเส้นทางที่วัด ไม่ได้หมายถึงผู้ให้บริการทุกราย
รันแอปใกล้แหล่งข้อมูล
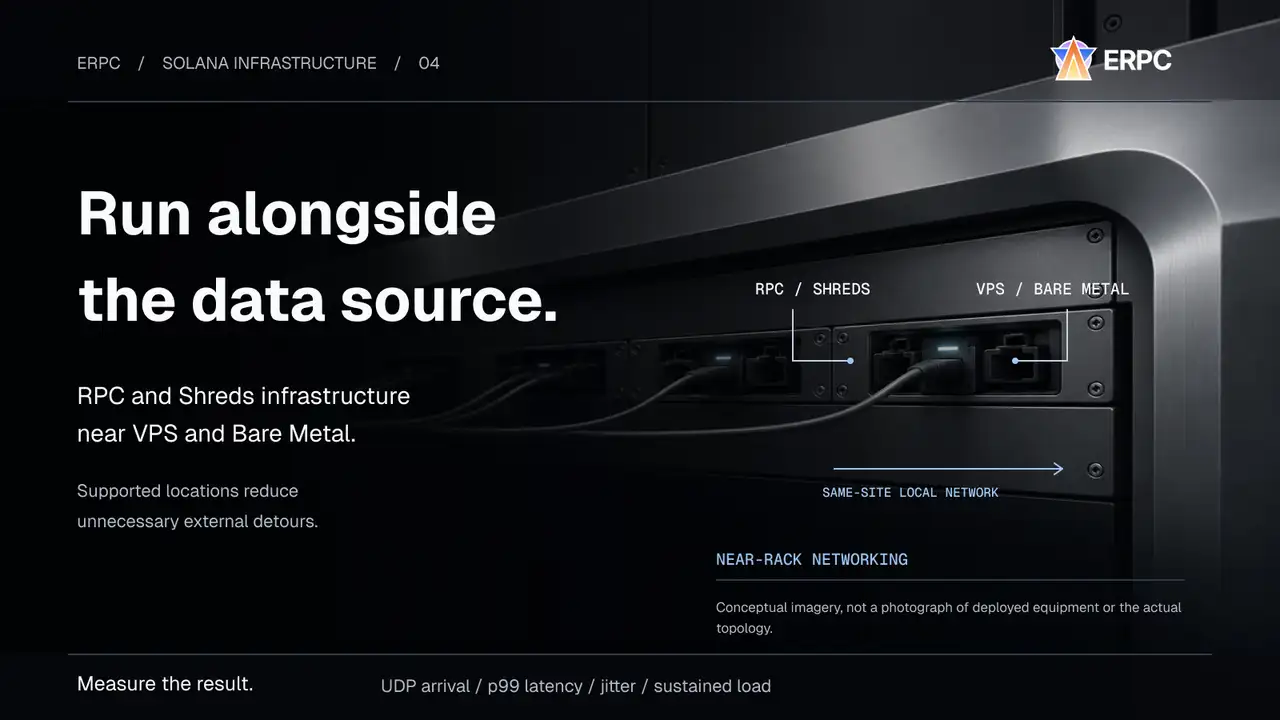
โดยทั่วไปผู้ให้บริการ RPC และผู้ให้เช่าเซิร์ฟเวอร์ขายบริการแยกกัน ERPC ออกแบบ Shreds, Geyser gRPC, RPC, VPS และ Bare Metal ร่วมกัน ในจุดบริการที่รองรับ แหล่งข้อมูลกับแอปอาจสื่อสารผ่านเครือข่ายภายในและแร็กที่อยู่ใกล้กัน เพื่อลดทางอ้อมภายนอก Zero-Distance Communication ไม่ได้หมายถึงระยะทางหรือ latency เป็นศูนย์จริง ต้องวัดเส้นทางด้วย
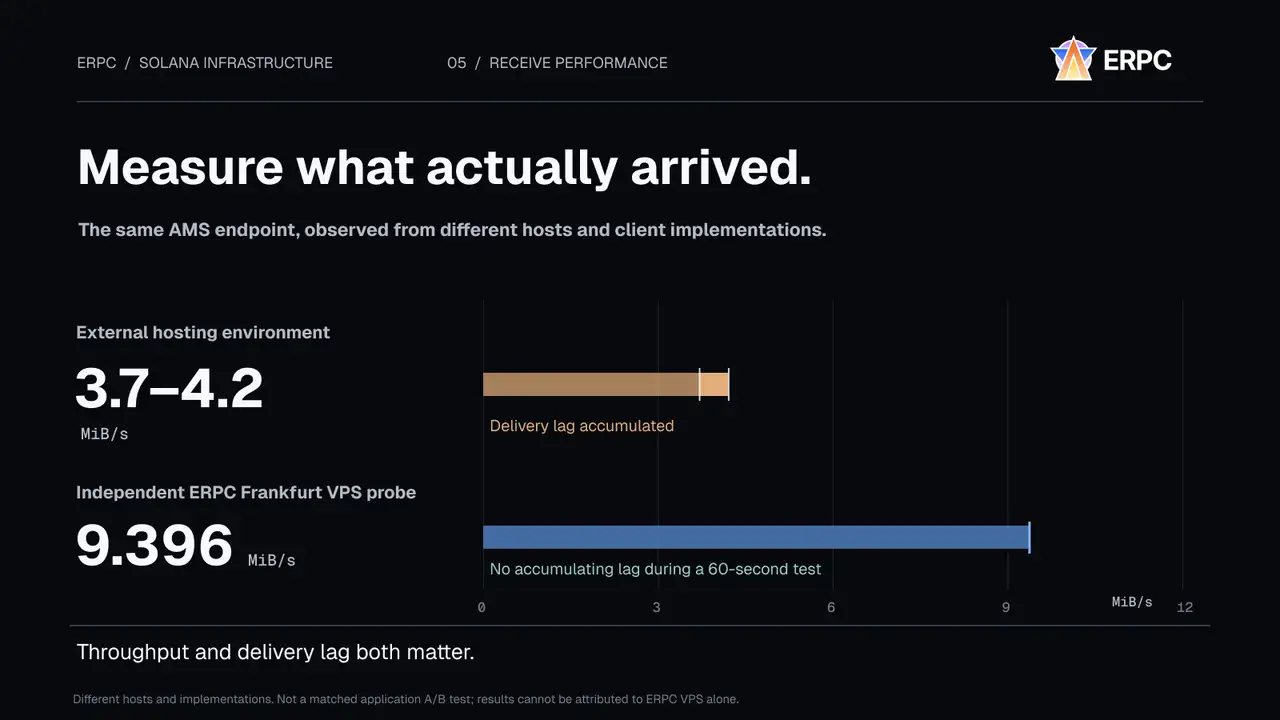
เปรียบเทียบข้อมูลที่แอปได้รับจริง
สำหรับ Geyser gRPC subscription ที่ใกล้เคียงกันไปยัง endpoint Amsterdam เดียวกัน โฮสต์ภายนอกได้ 3.7–4.2 MiB/s พร้อม lag เพิ่มขึ้น ส่วนการทดสอบอิสระบน ERPC VPS Frankfurt ที่จำกัด CPU หนึ่งคอร์ได้เฉลี่ย 9.396 MiB/s และราว 1,910 transactions/s เป็นเวลา 60 วินาทีโดย lag ไม่สะสม พบ TCP retransmissions บนเส้นทางปัญหา แต่โฮสต์และโปรแกรมรับต่างกัน จึง ไม่ใช่ A/B test ที่ควบคุมครบ การทดสอบ HTTP/2 อีกชุดได้ 2.7 MB/s เมื่อ window 16 KiB และสูงสุด 7.1 MB/s เมื่อเพิ่ม window
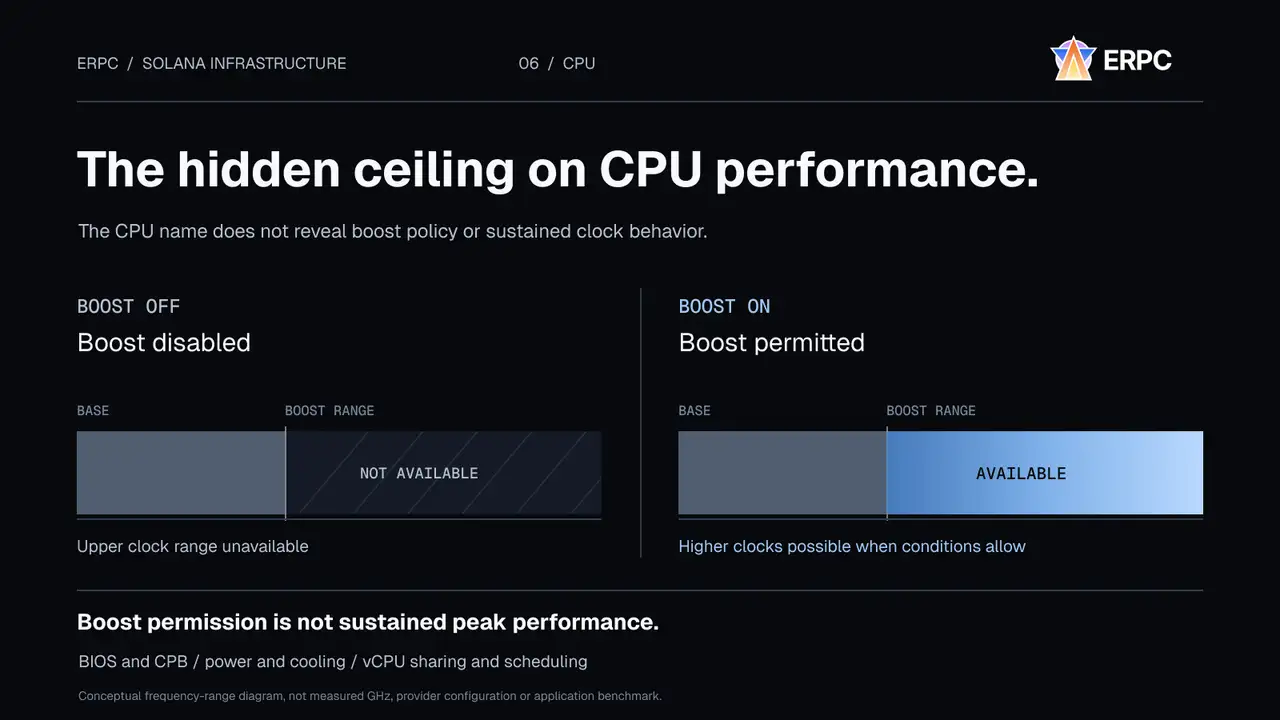
ชื่อ CPU ไม่บอกข้อจำกัดทั้งหมด
VM ที่มี CPU รุ่นเดียวกันและจำนวน vCPU เท่ากันอาจมีนโยบาย boost, กำลังไฟ, การระบายความร้อน และ scheduling ต่างกัน AMD Core Performance Boost หรือ Intel Turbo Boost อาจถูกปิดใน BIOS หรือโฮสต์ แม้เปิดอยู่ก็ไม่ได้รับประกัน clock สูงสุดตลอดเวลา VM อาจไม่เห็นการตั้งค่าโฮสต์ ต้องวัดประสิทธิภาพต่อเนื่องภายใต้โหลดจริง
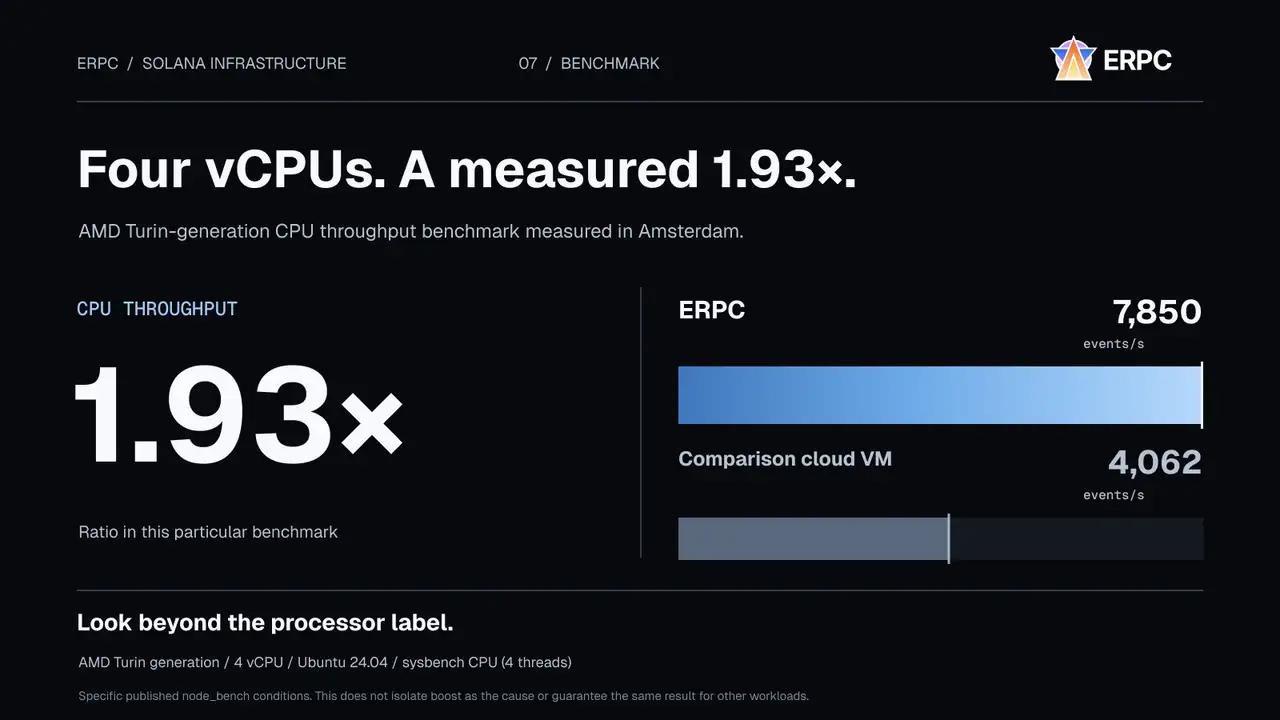
สี่ vCPU มีผล benchmark ต่างกัน 1.93 เท่า
benchmark สาธารณะ ERPC ของ AMD Turin 4 vCPU พร้อม Ubuntu 24.04 ที่ Amsterdam วัด sysbench CPU ได้ ERPC 7,850 events/s เทียบกับคลาวด์ VM 4,062 events/s หรือประมาณ 1.93× ในเงื่อนไขนั้น และรายงาน bandwidth หน่วยความจำราว 3.2× กับ IOPS อ่านสุ่ม 4K ราว 16.6× นี่ไม่ใช่ผลลัพธ์ที่รับประกันสำหรับทุกแอปหรือหลักฐานว่าเกิดจาก boost เพียงอย่างเดียว
เศรษฐศาสตร์ศูนย์ข้อมูลส่งผลต่อการออกแบบ
ไฟฟ้า ระบบเย็น แร็ก สวิตช์ ลิงก์ และการดูแลมีต้นทุน การแชร์ทรัพยากรและประหยัดไฟเหมาะกับแอปทั่วไป แต่ Solana stream หนักอาจใช้ CPU, PPS และ uplink ต่อเนื่อง นโยบาย bandwidth ร่วม จำกัดต่อ flow ป้องกัน DDoS และลดพลังงานอาจเหมาะกับงานอื่น สิ่งสำคัญคือตรวจว่านโยบายเข้ากับ workload ไม่ใช่กล่าวโทษผู้ให้บริการ
อย่าลืมค่าถ่ายโอนข้อมูลบนคลาวด์
สตรีมต่อเนื่องสร้างข้อมูลระดับ TB ตามเวลา บางคลาวด์ไม่คิดค่า Internet ingress แต่อาจคิด egress และการถ่ายโอนระหว่าง zone หรือ service ผลิตภัณฑ์ ERPC ที่เข้าเงื่อนไขแยกปริมาณภายในแพลตฟอร์มจากโควต้าภายนอกตามแผนปัจจุบัน เปรียบเทียบค่าใช้จ่ายทั้งเส้นทางแทนดูแค่ค่า VM
เลือก VPS หรือ Bare Metal ตามงาน
RPC เบาอาจใช้ EPYC VPS ได้ งาน gRPC ต่อเนื่องต้องมี CPU และ RAM เพียงพอ Shreds UDP และ trading ที่ไวต่อ latency ต้องทดสอบนโยบาย UDP, PPS, burst, ระยะทาง และเวลาตรวจพบ Bare Metal ให้ทรัพยากรจริงแบบเฉพาะ แต่ไม่ได้เร็วกว่า VPS ทุกกรณี การแยกงานหลาย VPS ก็อาจดี เปรียบเทียบแอป ฟิลเตอร์ ช่วงเวลาเดียวกัน Shreds ที่ถูกต้อง การสร้างข้อมูลใหม่ lag retransmissions และ p95/p99
ทดสอบก่อนทำสัญญาระยะยาว
บน Linux ใช้ tcpdump, nstat, ip -s link, ethtool -S, ss -tin และ lscpu เพื่อตรวจเบื้องต้นแบบอ่านอย่างเดียว เปลี่ยน IP และอินเทอร์เฟซตัวอย่าง และดูความเปลี่ยนแปลงของตัวนับ lscpu อย่างเดียวพิสูจน์นโยบาย boost ของ hypervisor ไม่ได้ ERPC มีการคิดรายชั่วโมงสำหรับ VPS และ Bare Metal ที่เข้าเงื่อนไขตามสต็อก เลือกเครื่องที่ทำให้ใช้ข้อมูลที่จำเป็นได้ทันเวลา
bash
IFACE=ens3
SRC_IP=203.0.113.10  # documentation address; replace with real sender IP
PORT=2000
sudo timeout -s INT 10 tcpdump -nni "$IFACE" -l -q \
  "udp and src host $SRC_IP and dst port $PORT" 2>/dev/null | wc -l
nstat -az UdpInErrors UdpRcvbufErrors
ip -s link show dev "$IFACE"
sudo ethtool -S "$IFACE" | grep -Ei 'drop|miss|err|fifo'
ss -tin
lscpuIFACE=ens3
SRC_IP=203.0.113.10 # documentation address; replace with real sender IP
PORT=2000
sudo timeout -s INT 10 tcpdump -nni "$IFACE" -l -q \
"udp and src host $SRC_IP and dst port $PORT" 2>/dev/null | wc -l
nstat -az UdpInErrors UdpRcvbufErrors
ip -s link show dev "$IFACE"
sudo ethtool -S "$IFACE" | grep -Ei 'drop|miss|err|fifo'
ss -tin
lscpuเอกสารอ้างอิงทางเทคนิค
- https://solana.com/news/high-performance-solana-validators-run-on-bare-metal-hardware
- https://docs.kernel.org/networking/statistics.html
- https://man7.org/linux/man-pages/man7/udp.7.html
- https://docs.kernel.org/admin-guide/pm/amd-pstate.html
- https://grpc.io/docs/guides/flow-control/
- https://www.rfc-editor.org/rfc/rfc8085.html
- https://erpc.global/en/vps/
- Validators DAO testing tools