Diez mitos que ralentizan las aplicaciones de Solana: por qué un entorno rápido puede seguir siendo lento
La conexión es rápida. La CPU es moderna. El servidor está en la misma ciudad que el proveedor de datos. Aun así, la aplicación tarda en reaccionar a la información que necesita. La conexión permanece abierta, pero los datos procesados acumulan cada vez más retraso.
Al desarrollar aplicaciones de baja latencia en Solana, esta situación no siempre tiene una sola causa. Las rutas de red, la configuración de recepción, los datos a los que se suscribe la aplicación y las esperas internas pueden combinarse e impedir que se aproveche toda la infraestructura rápida que se ha elegido.
En ERPC, operado por ELSOUL LABO B.V., nuestro equipo de soporte recibe con frecuencia consultas sobre bucles de recepción bloqueados, ajustes del cliente, suscripciones innecesariamente amplias e intentos de reconexión que no resuelven el error original. Decisiones que apenas causaban problemas en una aplicación web convencional pueden convertirse en limitaciones para el trading de alta frecuencia y el procesamiento en tiempo real.
Este artículo examina diez mitos que hay detrás de estos problemas. Su objetivo es ayudar a evaluar tanto la elección de infraestructura como el diseño que permite trasladar su rendimiento hasta la decisión y el envío de una transacción.
Esta guía está dirigida a desarrolladores con experiencia en aplicaciones web que empiezan a crear aplicaciones de trading de alta frecuencia (HFT) u otras aplicaciones en tiempo real sobre Solana. Aborda la elección del entorno y las primeras comprobaciones. Aquí, una suscripción consiste en elegir qué actualizaciones de datos recibirá la aplicación de forma continua.
Primero, decidir qué debe terminar antes
El tiempo de ida y vuelta de la red, la llegada de datos, el tiempo de decisión y el plazo hasta la confirmación de una transacción son métricas diferentes. Un ping rápido no evita decisiones lentas si el procesamiento se atasca después de recibir los datos. Una respuesta RPC rápida no significa necesariamente que la transacción se haya ejecutado.
Por ejemplo, considere una aplicación que recibe una actualización del estado de un mercado, vuelve a calcular sus condiciones y envía una transacción cuando estas se cumplen. Separe el tiempo hasta que llega la actualización, el tiempo necesario para terminar el cálculo y el tiempo hasta verificar el resultado de la transacción enviada. Definir qué intervalo debe acortarse permite saber dónde investigar.
Mida estos intervalos por separado. La mejora empieza por definir la velocidad con más precisión que un nombre de producto o una sola cifra.
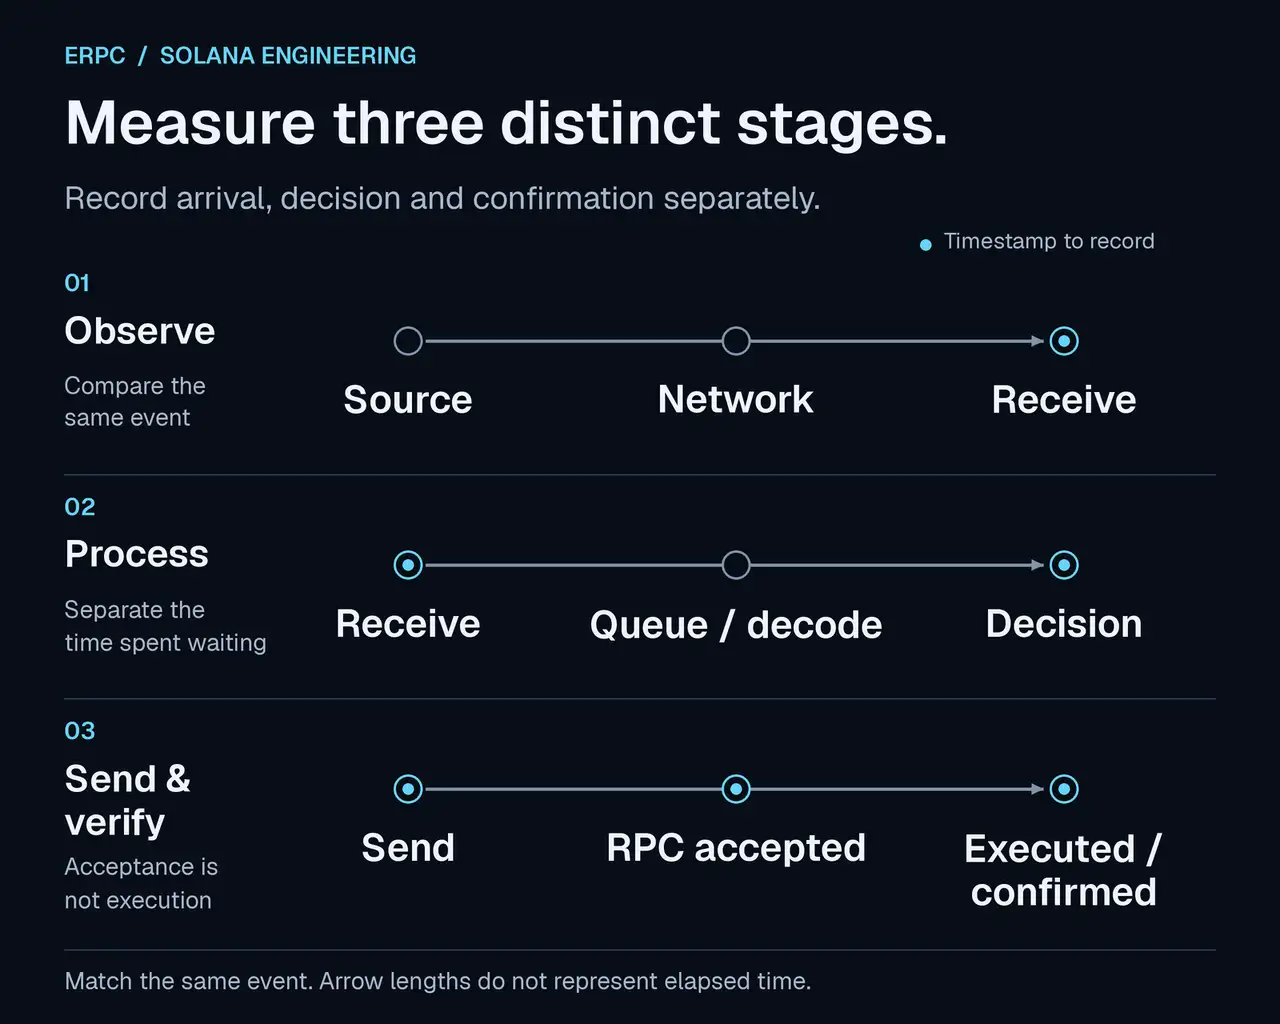
Mida por separado la observación, el procesamiento dentro de la aplicación y el envío y la confirmación. Este diagrama ilustra etapas de medición, no duraciones medidas ni diferencias de rendimiento.
Mito 1: Una VM pequeña funciona, así que su capacidad debe ser suficiente
Una VM pequeña en la nube funcionaba bien para una aplicación web anterior o una carga de trabajo de Ethereum. Esa experiencia puede llevar a suponer que la misma configuración también podrá procesar un flujo de Solana. Sin embargo, una aplicación que hace consultas RPC ocasionales necesita recursos distintos de otra que recibe y procesa continuamente un conjunto amplio de actualizaciones.
Dimensione el entorno según el volumen de datos, la tasa de llegada, el trabajo por evento y la latencia aceptable. ¿Cuántos eventos llegan cada segundo? ¿Cuántos bytes se transfieren? ¿Cuánto tiempo de CPU y memoria consumen la decodificación y las decisiones? Reserve margen para mantener el ritmo durante los picos y el tráfico habitual. Incluso en la misma cadena, el alcance de la suscripción y la implementación cambian los requisitos.
La dificultad es que una aplicación con recursos insuficientes puede aparentar que funciona. Los datos siguen apareciendo en pantalla mientras se vuelven cada vez más antiguos, o pasan inadvertidos los eventos perdidos durante una reconexión. El número de eventos recibidos no basta para detectarlo. Compruebe también los eventos procesados, la antigüedad de los datos pendientes y la continuidad de los eventos que debería cubrir la suscripción.
Si la experiencia anterior es el único punto de referencia, los desarrolladores pueden no cuestionar nunca la capacidad de recepción y seguir atribuyendo el problema al endpoint de datos. Probar un entorno con más margen puede revelar retrasos o datos ausentes que antes no se percibían.
Para investigarlo, compare el mismo endpoint, suscripción, nivel de commitment (la etapa de confirmación solicitada, explicada en el mito 9), SDK con su configuración y trabajo de procesamiento en un entorno de recepción y procesamiento con más margen. Mantenga la misma región, registre las diferencias de CPU, memoria y red, y compare el caudal recibido (la cantidad de datos recibida por unidad de tiempo, por ejemplo, bytes por segundo), el trabajo completado, la acumulación, los eventos ausentes y el tiempo hasta decidir. La carga cambia con el tiempo, así que compare durante el mismo período cuando sea posible, respetando los límites de conexión y la carga sobre el servicio.
Una mejora al cambiar el entorno demuestra que las condiciones de recepción o procesamiento influyeron en el resultado. Si CPU, memoria y red cambiaron a la vez, hacen falta más comprobaciones para identificar qué recurso fue determinante. Elegir recursos según la cantidad y la velocidad de los datos realmente procesados es un requisito previo para lograr baja latencia.
Mito 2: Estar en la misma ciudad significa estar cerca en la red
«Los dos servidores están en Frankfurt, así que deben estar cerca». «Desplegar en Tokyo tiene que ser lo más rápido para Japón». El nombre de una ciudad ayuda a elegir ubicaciones, pero no garantiza la ruta real que seguirá el tráfico.
La ruta depende de las conexiones entre centros de datos, las interconexiones entre operadores y las decisiones de encaminamiento. Incluso servidores de la misma ciudad pueden dar un rodeo por redes externas. RIPE IPmap menciona, por ejemplo, la visualización de rutas ineficientes, como tráfico que sale de un país y luego regresa, entre sus usos. [1]
Mida el RTT entre la fuente real de datos y el equipo donde se ejecuta la aplicación, su variación temporal, las retransmisiones o pérdidas y el momento de llegada del mismo evento. Traceroute y MTR ayudan a investigar la ruta, pero el número de saltos por sí solo no determina cuál es mejor. También es importante no confundir un router intermedio que limita sus respuestas de diagnóstico con pérdidas de paquetes que afectan a la aplicación.
Después de elegir una región, plantee una pregunta más: ¿cómo se conectan realmente esta fuente concreta y este servidor concreto? Esa comprobación descubre diferencias que el nombre de la ciudad no permite ver.
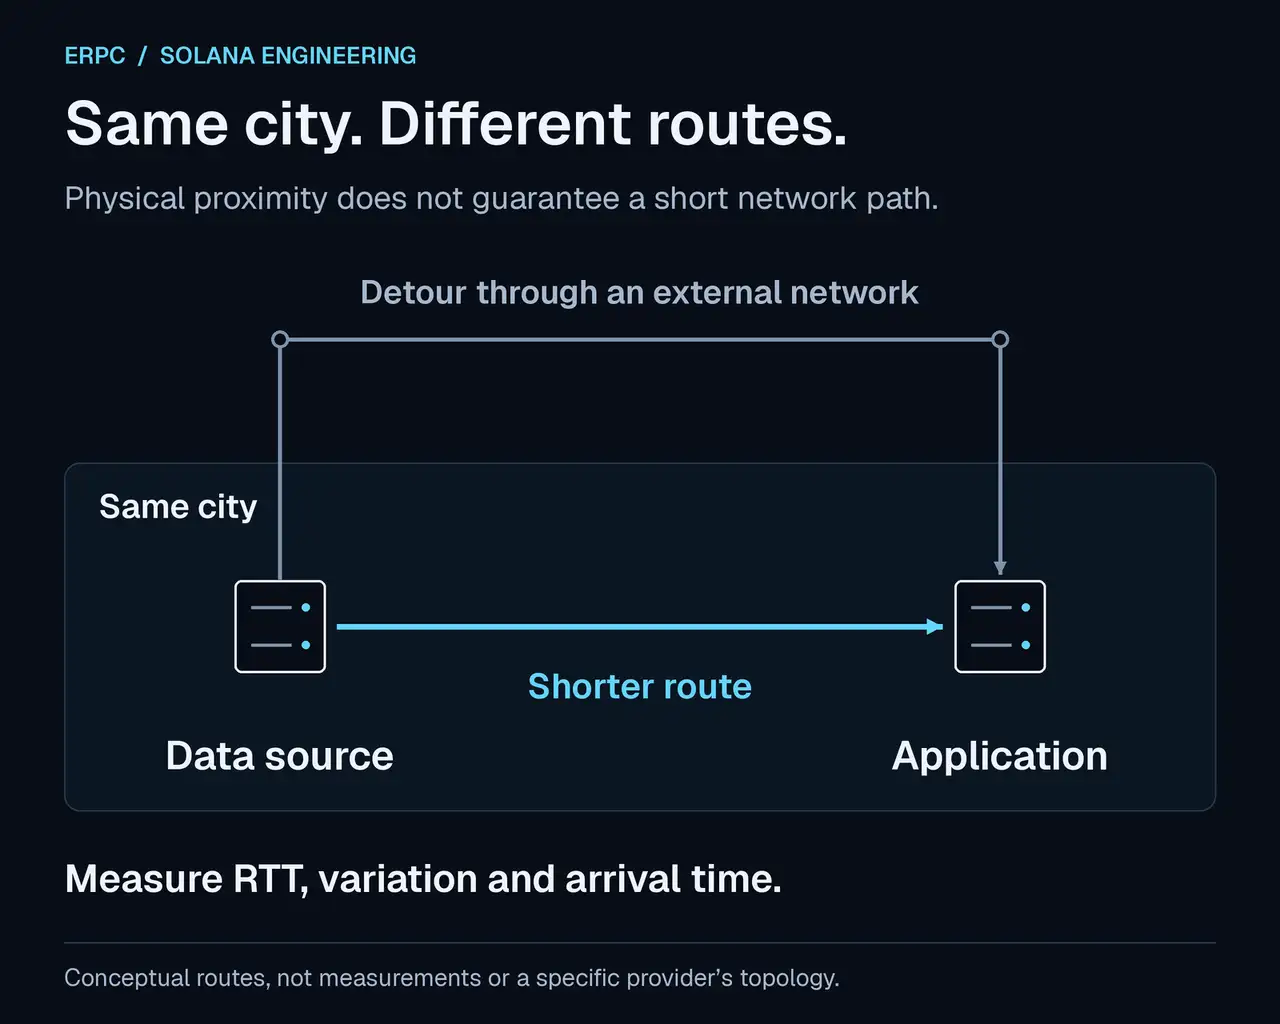
Dos servidores de la misma ciudad pueden tener rutas y tiempos de ida y vuelta diferentes. Este diagrama es conceptual y no representa la ruta real de ningún proveedor en particular.
Mito 3: Una especificación de red alta implica suficiente ancho de banda utilizable
El ancho de banda en la ficha de un servidor puede significar varias cosas: velocidad del puerto físico, ancho de banda asignado a una máquina virtual, capacidad sostenida o un límite temporal de ráfaga. Una NIC rápida no significa que la aplicación pueda utilizar toda su capacidad de forma continua.
La documentación de AWS, por ejemplo, distingue el ancho de banda de base del disponible en ráfaga y describe restricciones relacionadas con destinos, flujos y tasas de paquetes. Es un ejemplo de cómo interpretar una especificación; no significa que todos los VPS tengan los mismos límites que AWS. [2]
Al elegir un plan, compruebe si el ancho de banda es dedicado o compartido, las condiciones de uso sostenido, los límites de transferencia y las diferencias según el destino. Durante la prueba, mantenga tráfico hacia el mismo endpoint con las condiciones de suscripción previstas para producción, observando a la vez el caudal recibido, los descartes, las retransmisiones y la carga de CPU.
Una cifra alta en una prueba breve de velocidad no demuestra que el servidor pueda procesar continuamente un flujo de producción. Al mismo tiempo, un caudal recibido bajo no implica necesariamente falta de ancho de banda. Separe los problemas de configuración de recepción de los límites de procesamiento antes de ampliar la conexión.
Mito 4: Un mejor modelo de CPU, más núcleos o más GHz máximos hacen rápida la aplicación
La frecuencia máxima de boost de una CPU no es una frecuencia que mantenga con cualquier carga. Su funcionamiento real depende de la potencia, la temperatura, el firmware, el control de frecuencia y otras cargas. La documentación de Linux explica que habilitar el boost permite utilizarlo; no demuestra que la CPU esté funcionando efectivamente con boost. [3]
Si el trabajo importante se concentra en un hilo, añadir núcleos no lo termina antes por sí solo. El uso global de CPU puede parecer bajo mientras un núcleo o el bucle de eventos está saturado. La guía oficial de Node.js también explica cómo un callback costoso hace esperar a otras tareas. [4]
Compruebe la frecuencia, la temperatura, el uso por núcleo y los tiempos de procesamiento bajo la carga real. En un entorno virtual, el tiempo de espera hasta que se asigna CPU también puede ser revelador. Perfile la aplicación para averiguar cuánto tiempo consumen la decodificación, los cálculos, la asignación de memoria y los registros.
Elija una combinación de rendimiento de frecuencia de CPU, asignación de recursos, ajustes que sostengan el rendimiento e implementación de la aplicación. Comparar solo los modelos no establece la velocidad de la aplicación completa.
Mito 5: Con gRPC basta la configuración predeterminada del cliente
Establecer una conexión gRPC no demuestra que pueda recibir el volumen necesario a la velocidad requerida. HTTP/2 utiliza un control de flujo mediante el cual el receptor indica al emisor cuántos datos puede aceptar. Se aplica tanto por flujo como por conexión, de modo que las ventanas de recepción y sus actualizaciones pueden limitar el caudal aunque la red tenga capacidad disponible. [5][6]
Una ventana de recepción indica al emisor cuántos datos puede enviar sin una nueva actualización del receptor. Los valores iniciales, el ajuste automático y la prioridad de los parámetros difieren entre SDK y bibliotecas. Escribir un número grande en un archivo de configuración no demuestra que el cliente se comporte como se espera. Compruebe los ajustes de flujo y de conexión, su interacción con las opciones adaptativas y la versión utilizada.
Introduzca cambios mientras mide el caudal real recibido y la acumulación de trabajo bajo las mismas condiciones de suscripción. El tamaño máximo de mensaje recibido, el búfer de recepción TCP y la ventana HTTP/2 son parámetros distintos. Keepalive comprueba que la conexión sigue activa; no añade capacidad de procesamiento ni ancho de banda.
La FAQ de gRPC de ERPC incluye pasos de diagnóstico y ejemplos de configuración para un flujo cuyo caudal permanece constante mientras aumenta el retraso. Antes de utilizar un ejemplo, anote el SDK y su versión. Localice dónde configura ese SDK las ventanas de recepción del flujo y de la conexión, así como el ajuste automático, y compare esos parámetros con el ejemplo de la FAQ. Si utiliza otro SDK, consulte su documentación para identificar los ajustes correspondientes en vez de copiar sin cambios los nombres y valores de los parámetros. Verifique después el resultado con su volumen de suscripción y capacidad de procesamiento. [7]
Mito 6: Recibir todos los bloques completos permite decidir antes que nadie
«Recibir todo primero y buscar después lo importante». Es una forma comprensible de empezar a desarrollar, pero añade trabajo que quizá no sea necesario antes de decidir. Transferir, decodificar, asignar memoria y buscar datos innecesarios consume recursos limitados de CPU y ancho de banda.
Si quiere reaccionar a cambios en un mercado, programa o cuenta concretos, defina primero los eventos y campos necesarios para decidir. Yellowstone gRPC ofrece filtros de suscripción para transacciones y cuentas, además de una forma de obtener solo parte de los datos de una cuenta. Las notificaciones de bloques completos y las de actualizaciones individuales también son diferentes. [8]
Si el requisito es «volver a calcular las condiciones cada vez que cambie el mercado A», enumere la información que identifica ese mercado, el estado utilizado en el cálculo y los eventos que actualizan dicho estado. Los datos necesarios dependen de la especificación del programa, por lo que debe contrastarla con las actualizaciones recibidas. Use esa lista para limitar las suscripciones y compruebe después que el estado necesario para decidir sigue estando completo.
Con los mismos recursos y condiciones, si una aplicación espera a decodificar y buscar en todos los registros mientras otra procesa de inmediato la actualización necesaria, la segunda evita esa espera. Un competidor más centrado puede reaccionar antes repetidamente por motivos ajenos a la conexión de red. Decidir qué se puede ignorar forma parte del diseño de baja latencia.
La indexación, la auditoría, la investigación y el almacenamiento histórico pueden necesitar legítimamente todos los datos. Reserve un camino separado para esa carga. Separarlo de las decisiones inmediatas permite diseñar la capacidad y la integridad que requiere cada camino. Verifique, no obstante, que el filtrado no elimine actualizaciones necesarias para decisiones correctas. El procesamiento por lotes también puede aumentar el caudal total en algunos casos, por lo que debe elegirse según la espera tolerable para la aplicación.
En el servicio Shared gRPC actual de ERPC, una suscripción
blocks no vacía requiere el servicio Dedicated. Las suscripciones transactions o blocksMeta pueden cubrir ciertas necesidades, pero ninguna ofrece los mismos datos que los bloques completos. Elegir Dedicated sigue exigiendo capacidad de procesamiento adecuada en el receptor y un diseño apropiado de las suscripciones. [9]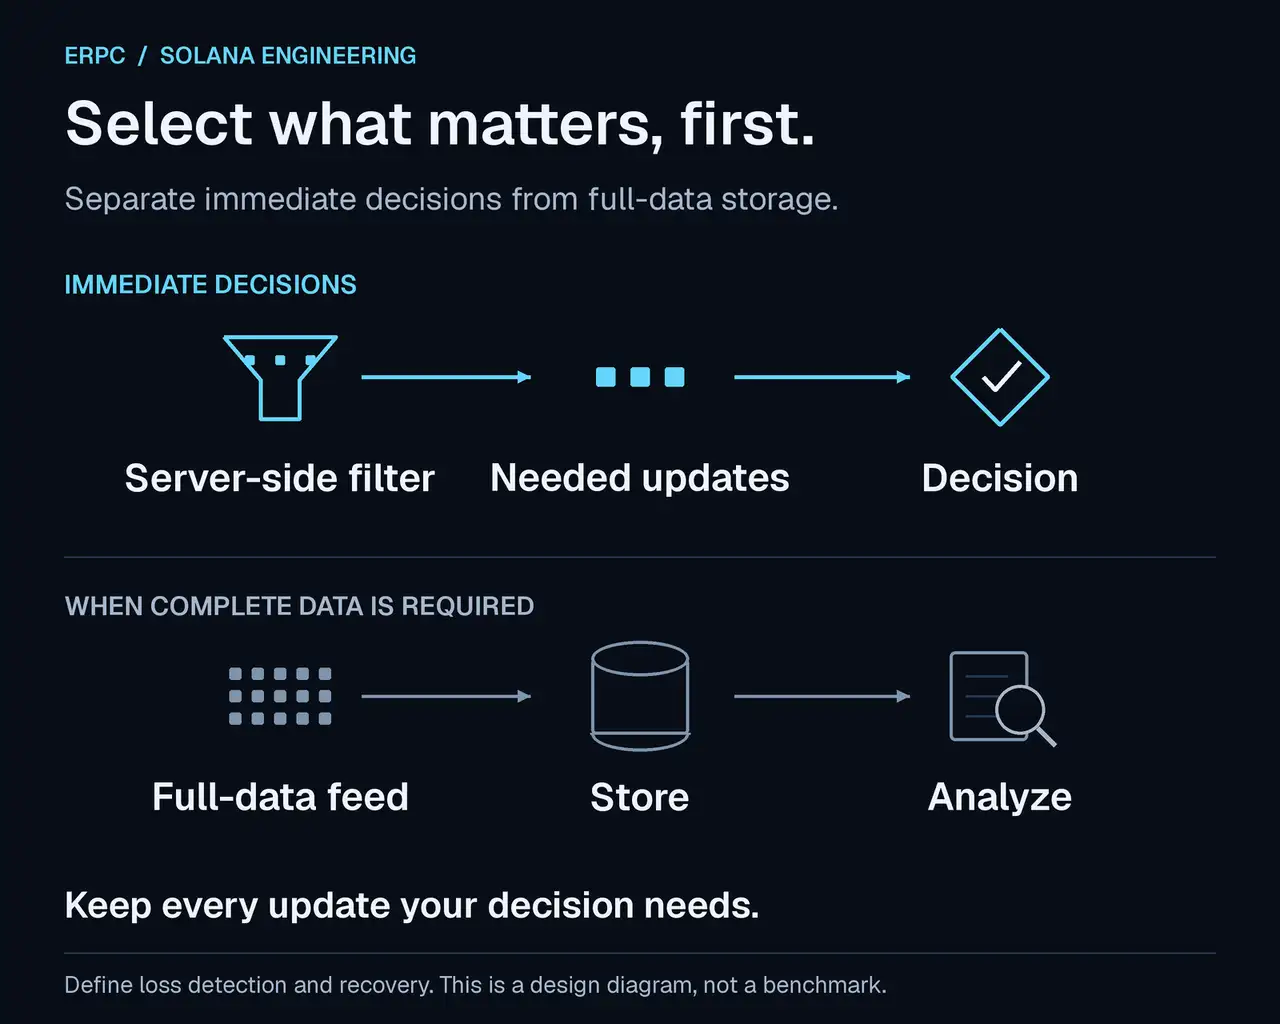
Use un camino para las actualizaciones necesarias para decisiones inmediatas y otro para el almacenamiento completo y el análisis. Este diagrama ilustra una arquitectura. Compruebe que el filtrado conserva el estado necesario para decidir correctamente y defina cómo recuperar los datos ausentes.
Mito 7: Si llegan datos, el procesamiento está siguiendo el ritmo
Puede formarse una cola entre los datos recibidos y los ya procesados hasta un estado que permita decidir. Si el trabajo entrante supera continuamente la capacidad de procesamiento, el retraso se acumula aunque la conexión siga abierta. Un búfer mayor puede absorber picos temporales, pero ante un déficit sostenido de procesamiento solo conserva más datos antiguos.
Considere un ejemplo hipotético que comienza sin trabajo pendiente. La aplicación recibe 12.000 eventos del mismo tipo por segundo y completa el procesamiento de 10.000 por segundo. Si puede conservar todos los eventos en la cola sin descartarlos ni combinarlos, el trabajo pendiente aumenta en 2.000 eventos por segundo y alcanza 20.000 al cabo de 10 segundos. La conexión sigue activa y continúan apareciendo datos, mientras el trabajo necesario para decidir se retrasa. Estas cifras ilustran el mecanismo; no son mediciones del rendimiento de ERPC.
No mida únicamente el número de eventos recibidos. Mida también el procesamiento completado, la longitud de la cola, la antigüedad del elemento pendiente más antiguo y el tiempo entre recepción y fin de la decisión. Supervise por separado el estado de la conexión y la actualidad de los datos.
Deje en el bucle de recepción solo el trabajo necesario para seguir recibiendo. Considere trasladar las escrituras en base de datos, el registro de cargas útiles completas, las llamadas a API externas y los cálculos pesados a otros caminos de procesamiento. Establezca una capacidad máxima para las colas y una política para cuando se llenen. Una cola limitada, cuando se llena, puede hacer que las etapas anteriores de procesamiento tengan que esperar; no resuelve por sí sola una capacidad de procesamiento insuficiente. [10]
En actualizaciones donde solo importa el estado más reciente, puede ser posible agrupar estados anteriores. Los eventos de transacción que requieren procesamiento completo o en orden no deben descartarse indiscriminadamente. Diseñe la detección de huecos, la recuperación de datos y la restauración del estado tras reconectar según los requisitos de la aplicación.
El
STREAM_GUARD_SLOW_READER de ERPC es una protección ante un avance insuficiente de escritura o un retraso de entrega observado. Esa observación no basta para atribuir una causa. Investigue la conexión, el equipo, el volumen de suscripción y la velocidad de consumo de la aplicación. Antes de reconectar, conserve el primer status, message, metadata y trailers disponibles, y lea la razón y las condiciones de reintento indicadas por el servidor. Reenviar la misma solicitud rechazada sin corregirla mantiene la causa. [7]Mito 8: Un ping o promedio rápido significa rapidez cuando importa
Ping ofrece una indicación del tiempo de ida y vuelta de la red. Mide un intervalo diferente de la latencia de la aplicación, que incluye el procesamiento en origen, el contenido de la suscripción, la espera de recepción, la decodificación y la decisión. Una media también puede ocultar un pequeño número de retrasos considerables.
p50 es la mediana. p95 y p99 marcan los valores en los que, o por debajo de los que, se encuentra el 95% y el 99% de las mediciones. p99 no es el máximo. Incluya el número de muestras y el período de medición, y revise los valores durante picos de eventos, los máximos, los tiempos de espera agotados, las desconexiones y los datos ausentes. [11]
Al comparar proveedores, empareje el mismo evento, tipo de datos, commitment y condiciones de suscripción. Cuando sea posible, reciba en el mismo equipo de medición y use un reloj monotónico para los tiempos transcurridos dentro de la aplicación. Al restar marcas de tiempo de equipos diferentes, tenga en cuenta los desfases entre relojes que pueden contaminar la medición.
Conservar solo eventos exitosos puede hacer parecer rápida una configuración que pierde datos con frecuencia. Elegir el resultado aislado más rápido y elegir una configuración que tenga menos probabilidades de retrasarse cuando producción la necesita son decisiones distintas.
Mito 9: Los primeros datos recibidos son igual de definitivos y significan lo mismo
Los Shreds, las notificaciones de transacciones, las actualizaciones de cuentas y las notificaciones de bloques no representan la misma información en la misma fase. Utilizar datos de una etapa anterior puede dejar más reconstrucción o interpretación a cargo de la aplicación. La comparación debe igualar no solo el momento de recepción, sino también lo que se puede saber en ese instante. [8][12]
Distinga también los niveles de commitment
processed, confirmed y finalized de Solana. Si las observaciones tempranas alimentan decisiones, la aplicación debe comprobar después su estado de confirmación y corregir su propio estado cuando sea necesario. Separe la recepción de una actualización temprana de las condiciones para realizar una acción definitiva en un sistema externo. [13]Por ejemplo, comparar sin más notificaciones recibidas con distintos commitments y afirmar que una es ciertos milisegundos más rápida no compara el mismo trabajo. Determine la información y el grado de confirmación que requiere la aplicación y mida cuánto tarda en poder decidir bajo esas condiciones.
Mito 10: Un envío exitoso significa que la transacción se ejecutará primero
Una respuesta exitosa de
sendTransaction significa que el RPC aceptó la transacción. No garantiza el procesamiento ni la confirmación por parte del clúster. La especificación de Solana exige comprobar por separado el estado de la firma. [14]Aunque la información recibida permita decidir pronto, siguen importando la ruta de envío, la validez del blockhash, la contención en cuentas con permiso de escritura, los recursos de cómputo, las tarifas de prioridad y las condiciones de éxito de la propia transacción. SWQoS se ocupa de la admisión y la prioridad de conexión hacia el líder, mientras que las tarifas de prioridad afectan a la prioridad de planificación. Sus funciones son distintas y ninguna garantiza incondicionalmente el orden de ejecución o el éxito. [15][16]
Registre por separado el fin de la decisión, el inicio del envío, la aceptación RPC, los resultados de ejecución y el estado de confirmación requerido. Al reintentar, distinga también entre reenviar una transacción con la misma firma y construir una nueva, para evitar acciones duplicadas involuntarias.
Solo al observar todo el recorrido, desde la recepción hasta la confirmación, puede identificar qué mejora le acercará al objetivo.
Mediciones que conviene establecer primero
Empiece con estas tres comprobaciones.
- Elija una decisión y anote qué actualizaciones necesita y qué estado debe estar disponible antes de que la aplicación pueda decidir.
- Durante el mismo período de medición, registre el número de eventos recibidos, de eventos cuyo procesamiento ha terminado y de eventos pendientes, todos del mismo tipo. Si el trabajo se almacena en una cola, mida también cuánto tiempo ha pasado desde que la aplicación recibió el evento pendiente más antiguo.
- Si el trabajo pendiente o la espera siguen aumentando, localice dónde se acumula el trabajo. Elija un cambio pertinente en las suscripciones, el procesamiento, la configuración o el entorno de ejecución, y compare los resultados anteriores y posteriores.
El tiempo medido desde la recepción en la aplicación revela la espera dentro de ella. Mida por separado el retraso entre el evento original y su recepción en la aplicación. Una vez disponibles estos primeros registros, use la tabla siguiente para ampliar las comprobaciones.
| Etapa | Qué registrar | Qué ayuda a identificar |
|---|---|---|
| Red y recepción | Caudal real recibido, retransmisiones y pérdidas, diferencias de llegada del mismo evento | Restricciones de ruta, ancho de banda y ajustes de recepción |
| Aplicación | Recuentos recibidos y completados, longitud de cola, antigüedad del elemento más viejo | Déficits sostenidos de procesamiento y datos obsoletos acumulados |
| Tiempo hasta decidir | p50, p95, p99 y máximo desde la recepción hasta el fin de la decisión | Trabajo costoso y retrasos durante picos |
| Envío y confirmación | Inicio de envío, aceptación RPC, estado de firma, errores de ejecución | Retrasos y fallos posteriores a la recepción |
| Condiciones de comparación | Región, equipo, SDK y versión, suscripción, commitment, período y número de muestras | Diferencias aparentes por condiciones distintas |
Conserve una medición de referencia y verifique un cambio cada vez según los síntomas: alcance de suscripción, separación del procesamiento, ajustes del cliente y ubicación o recursos. Si amplía una ventana, compruebe también si aumentan la memoria utilizada y la acumulación. Si limita una suscripción, asegúrese de no perder información necesaria.
El p99 del tiempo total no se calcula sumando los p99 de cada etapa. Calcúlelo a partir del tiempo total de cada evento emparejado y use las mediciones por etapa para localizar las causas. Pruebe tanto durante picos reales de eventos como con carga media.
ERPC prepara la infraestructura para que los desarrolladores perfeccionen su lógica
Cuando las redes, los servidores, la entrega de datos y los clientes se eligen por separado, pueden quedar esperas entre ellos aunque cada componente tenga buenas especificaciones. ERPC reúne la entrega de datos de Solana y los entornos de procesamiento en una plataforma, reduciendo el trabajo que los desarrolladores tendrían que repetir para elegir ubicaciones y recursos desde cero.
Las ofertas SUPER VPS y Premium VPS especifican configuraciones de alta frecuencia y asignación de recursos sin sobreasignación, mientras Bare Metal ofrece una máquina física dedicada. ERPC aproxima las redes y los servidores a su entorno de entrega y prepara CPU, memoria, almacenamiento y conectividad para un procesamiento sostenido. Las especificaciones concretas están disponibles para cada plan y región. [17][18]
| Obstáculo habitual de desarrollo | Infraestructura e información disponibles en ERPC | Qué perfeccionar en la aplicación |
|---|---|---|
| Distancia que no revelan los nombres de las ciudades | Configuraciones regionales y de red para elegir juntos entrega y procesamiento | Medir llegadas y variación bajo sus condiciones de suscripción |
| Contención de recursos y rendimiento sostenido | SUPER VPS y Premium VPS de alta frecuencia sin sobreasignación y Bare Metal dedicado | Identificar trabajo costoso y procesamiento secuencial |
| Volumen de datos y método de conexión | gRPC, Shreds, RPC y opciones compartidas o dedicadas adecuadas para la carga | Definir los eventos y campos necesarios |
| Ajustes de recepción y diagnóstico | Solana Stream SDK, ejemplos de configuración, documentación de filtros y FAQ por error | Verificar ajustes efectivos, colas, reconexión y recuperación |
ERPC ayuda a avanzar en la selección y el ajuste de infraestructura, dejando más tiempo para desarrollar qué observar, con qué información decidir y cuándo enviar. Con un servicio y una ubicación adecuados, ajustar el volumen de suscripción a la capacidad de procesamiento convierte el rendimiento de infraestructura en velocidad de aplicación.
Empiece por decidir qué información requieren realmente sus decisiones. Recíbala pronto, procésela sin esperas innecesarias y compruebe el resultado. ERPC seguirá ofreciendo el entorno y la información que facilitan esa mejora.
Recursos de implementación
- FAQ de gRPC de ERPC: https://erpc.global/es/faq/grpc/general/
- Filtros de suscripción y límites actuales de Shared: https://erpc.global/es/doc/geyser-grpc/filter/
- Buenas prácticas de implementación de gRPC: https://erpc.global/es/doc/geyser-grpc/best-practices/
- Solana Stream SDK: https://github.com/ValidatorsDAO/solana-stream
- ERPC VPS: https://erpc.global/es/vps/
- ERPC Bare Metal: https://erpc.global/es/baremetal/
- ERPC Dashboard: https://dashboard.erpc.global/
- Discord oficial de Validators DAO: https://discord.gg/C7ZQSrCkYR
Referencias técnicas
- RIPE IPmap, visualización de rutas ineficientes: https://ipmap.ripe.net/
- AWS, ancho de banda de red de instancias: https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/ec2-instance-network-bandwidth.html
- Linux Kernel, CPU Performance Scaling: https://docs.kernel.org/admin-guide/pm/cpufreq.html
- Node.js, evitar el bloqueo del bucle de eventos: https://nodejs.org/en/learn/asynchronous-work/dont-block-the-event-loop
- IETF RFC 9113, control de flujo HTTP/2: https://httpwg.org/specs/rfc9113.html#FlowControl
- gRPC, Flow Control: https://grpc.io/docs/guides/flow-control/
- ERPC, recepción, slow readers y reintentos en la FAQ de gRPC: https://erpc.global/es/faq/grpc/general/
- Yellowstone gRPC, especificaciones de suscripciones y filtros: https://github.com/rpcpool/yellowstone-grpc
- ERPC, reglas actuales de filtros Shared: https://erpc.global/es/doc/geyser-grpc/filter/
- Tokio, colas y backpressure: https://tokio.rs/tokio/tutorial/channels
- AWS CloudWatch, definiciones de percentiles: https://docs.aws.amazon.com/AmazonCloudWatch/latest/monitoring/Statistics-definitions.html
- ERPC, Shreds UDP Forwarding: https://erpc.global/es/doc/shredstream/udp-forwarding/
- Solana, Transaction Confirmation & Expiration: https://solana.com/developers/cookbook/transactions/confirmation
- Solana, sendTransaction: https://solana.com/docs/rpc/http/sendtransaction
- Solana, Stake-weighted Quality of Service: https://solana.com/docs/defi/stake-weighted-qos
- Solana, tarifas de transacción: https://solana.com/docs/core/fees
- ERPC, configuraciones y especificaciones de VPS: https://erpc.global/es/vps/
- ERPC, configuraciones y especificaciones de Bare Metal: https://erpc.global/es/baremetal/