








FAQ - Geyser gRPC Stream
P: ¿En qué regiones se encuentran sus nodos?
Actualmente operamos nodos en las siguientes regiones:
- Frankfurt (FRA)
- Amsterdam (AMS)
- Londres (LON)
- Nueva York (NY)
- Tokio (TY)
- Singapur (SGP)
- Sídney (SYD)
ERPC mide la latencia real de la red a partir de las rutas reales, seleccionando automáticamente la región con la latencia más baja en lugar de depender de la distancia en línea recta. Este enfoque no solo mejora la latencia de usuarios individuales, sino que también aumenta la eficiencia general de la red y refuerza la resiliencia global de ERPC ante posibles ataques.
Si tu entorno no selecciona automáticamente la región óptima, contáctanos desde el ERPC Web Dashboard.
ERPC Web Dashboard: https://dashboard.erpc.global/es
P: La latencia muestra 9999ms y se selecciona una región no óptima. ¿Qué debo hacer?
Para seleccionar la región de gRPC, ERPC envía sondeos de latencia ICMP a tu IP registrada desde los hosts proxy que se indican a continuación. Permite solicitudes de eco ICMP entrantes desde todas las IP de origen indicadas. Si un firewall (ufw, firewall en la nube, grupo de seguridad, etc.) las bloquea, la medición puede mostrar
9999ms y podría seleccionarse una región no óptima. Varias IP en una misma región corresponden a hosts de sondeo distintos; todas son necesarias.P: He añadido mi IP a la lista blanca, pero sigo sin poder conectarme. ¿Qué debo comprobar?
Usa el endpoint HTTPS cifrado seleccionado en el Dashboard. HTTPS usa el puerto 443; HTTP en el puerto 80 sigue siendo la opción de baja latencia sin cifrar.
Ambos transportes usan la misma lista blanca de IP registradas. Usa el endpoint seleccionado en el Dashboard; HTTPS usa el puerto 443 y HTTP, el 80.
- Endpoint HTTPS: usa el endpoint seleccionado en el Dashboard en el puerto 443.
- Endpoint HTTP: usa el endpoint seleccionado en el Dashboard en el puerto 80.
- Usa la URL que se muestra en el Dashboard con
https://ohttp://.
La autenticación se basa en tu dirección IP registrada. No añadas las cabeceras
x-token, token ni Authorization salvo que la página de un producto concreto lo indique explícitamente.P: Solo he usado WebSocket antes. ¿Puedo usar gRPC? ¿Tienen ejemplos?
Sí. Puedes probar rápidamente y empezar a desarrollar con gRPC usando SLV.
Para un endpoint compartido que puedes probar sin token, ejecuta:
bash
Consulta nuestra Guía de inicio rápido de gRPC para más detalles.
P: ¿Puedo registrar dos direcciones IP?
Puedes utilizar un endpoint por suscripción. Si deseas utilizar dos direcciones IP, debes contratar dos suscripciones independientes.
P: ¿Hay algún límite de filtro?
Geyser gRPC compartido tiene protecciones de uso razonable para que un stream no consuma los recursos que necesitan otros clientes de ERPC. Con la regla actual de Shared, se rechaza cualquier mapa
blocks no vacío, incluso una solicitud de bloques limitada. Cada filtro de cuenta debe incluir account, owner o un filtro cuckoo compatible; memcmp o dataSize por sí solos no bastan.Elimina una forma rechazada y suscríbete solo a los datos que necesita tu aplicación. Una suscripción de transacciones o los metadatos de bloques pueden servir sin transportar un bloque completo. Geyser gRPC Dedicated es apropiado cuando una carga legítima supera el límite de forma o recursos de Shared; no vuelve válidos los parámetros inválidos ni corrige un cliente lento.
P: ¿Cómo recopilo un error de gRPC antes de reconectar?
Conserva el primer error antes de que un bucle de reconexión lo sustituya. Registra el estado y el mensaje de gRPC de los metadatos iniciales y los trailers, junto con
x-erpc-error-code, x-erpc-error-reason y x-erpc-doc-url. Si ERPC indica una pausa, registra también x-erpc-retry-after-seconds y x-erpc-retry-at (segundos Unix).Un error puede mostrarse como
ERPC [STREAM_GUARD_SLOW_READER]: .... Pega el error mostrado o su código en la búsqueda de FAQ. La explicación canónica está en las FAQ de gRPC de ERPC. No supongas que llegará un trailer cuando una conexión termina antes de tiempo.También puedes buscar por un síntoma: receptor lento, desconectado, ancho de banda, retraso de entrega, acumulación, pausa, reintento, argumento inválido, recurso agotado, permiso denegado, registro de IP, demasiados streams, bloques completos o todas las cuentas.
P: ¿Qué errores de gRPC ponen en pausa mi conexión y cuándo debe dejar de reconectar mi cliente?
Una pausa es un período temporizado que ERPC aplica después de ciertos errores. El cliente no debe reconectar mientras la pausa esté en curso.
Qué se cuenta. Estos errores se cuentan y comparten una misma serie de escalones:
- Cada solicitud Subscribe que ERPC rechaza con
ERPC_GRPC_INVALID_ARGUMENT,STREAM_GUARD_SHAPE_BLOCKSoSTREAM_GUARD_SHAPE_ACCOUNTS_ALL, incluida la primera. El primer error contado es la advertencia, que no inicia ninguna pausa. STREAM_GUARD_SLOW_READER. Sin embargo, si el retraso de entrega se origina del lado de ERPC, ERPC cierra el stream sin que se cuente, y el error no incluye ningún plazo de reintento.
No se cuentan: la reconexión en sí, los cuatro códigos
STREAM_ADMISSION_* (STREAM_ADMISSION_LIMIT_REACHED, STREAM_ADMISSION_IP_NOT_ADMITTED, STREAM_ADMISSION_SOURCE_UNAVAILABLE y STREAM_ADMISSION_SNAPSHOT_UNAVAILABLE) ni ningún error contado que ocurra mientras una pausa está en curso. Un error contado durante una pausa no prolonga la pausa ni pasa al siguiente escalón.Los escalones. Cada error contado avanza un escalón en este orden, empezando por la advertencia:
- Advertencia: sin pausa.
- Pausa de 60 segundos.
- Pausa de 300 segundos.
- Pausa de 1800 segundos.
- Pausa de 86400 segundos (24 horas). Este es el último escalón: en él, cada error contado inicia otra pausa de 86400 segundos.
En el escalón de advertencia, el siguiente error contado pasa a la pausa de 60 segundos solo cuando llega como máximo 1 hora después de la advertencia. Un error contado que llega más de 1 hora después de la advertencia es otra advertencia sin pausa, y entonces la ventana de 1 hora empieza en esa nueva advertencia.
Un error contado que llega menos de 60 segundos después del último error que se contó se cuenta como parte de ese error y no avanza ningún escalón.
Cuándo vuelven los escalones a la advertencia. Una vez que los escalones han iniciado una pausa, solo vuelven a la advertencia después de 24 horas sin ningún error contado y sin ninguna pausa, medidas desde el final de la última pausa; el siguiente error contado a partir de ese momento es una advertencia sin pausa. Hasta entonces, el siguiente error contado inicia inmediatamente el siguiente escalón, sin advertencia.
La pausa de egreso.
STREAM_GUARD_EGRESS_BUDGET inicia su propia pausa fija de 600 segundos. No hace avanzar los escalones.Dónde se indica la hora de fin.
- El error que inicia una pausa incluye
Retry after N seconds.y los headersx-erpc-retry-after-secondsyx-erpc-retry-at(segundos Unix). La advertencia no incluye ningún plazo de reintento. - Cuando una solicitud rechazada contada es la que inicia una pausa, se devuelve como
STREAM_GUARD_SHAPE_REJECT_PENALTYconResourceExhausted (8)en lugar de su propio código. - Durante una pausa por lector lento o egreso, una reconexión recibe
STREAM_GUARD_PENALTY_ACTIVEcon el tiempo restante. - Durante una pausa iniciada por una solicitud rechazada, una conexión nueva se cierra inmediatamente sin estado gRPC ni código de ERPC. Una solicitud en una conexión que sigue abierta puede recibir de nuevo como respuesta
STREAM_GUARD_SHAPE_REJECT_PENALTYcon el tiempo restante antes de que esa conexión se cierre. Es posible que el cliente nunca vuelva a ver la hora de fin, así que debe guardarx-erpc-retry-atdel primer error que lo incluya.
Qué debe hacer el cliente. Ante un error contado, detén el bucle, no reenvíes la misma solicitud y corrígela. Durante una pausa, no reconectes antes de la hora indicada en
x-erpc-retry-at. Las solicitudes Subscribe rechazadas se cuentan según las reglas anteriores; reconectar, no.P: ¿Qué significa STREAM_GUARD_SLOW_READER con ResourceExhausted (8) cuando un receptor lento queda desconectado?
ERPC observó poco progreso de escritura o retraso de entrega en este stream. El retraso de entrega por sí solo no identifica la causa. Comprueba pérdida de red, ancho de banda efectivo, capacidad del host y si el consumidor de la aplicación puede seguir el ritmo. Reduce los datos suscritos y mueve el procesamiento fuera del bucle de recepción hacia una cola acotada. Una cola acotada controla el uso de memoria, pero no soluciona un consumidor sostenidamente lento. Si ERPC proporciona un plazo de reintento, espéralo antes de reconectar. La pregunta «¿Por qué mi stream de gRPC se mantiene a una velocidad constante y se queda atrás?», más abajo, explica la ventana de recepción y cómo ampliarla en la biblioteca de tu cliente.
P: ¿Por qué mi stream de gRPC se mantiene a una velocidad constante y se queda atrás?
Una ventana de recepción pequeña en tu cliente, o en algo situado entre él y ERPC, puede causar cortes con
STREAM_GUARD_SLOW_READER y las pausas que les siguen. Esta respuesta explica qué es una ventana de recepción, cómo saber si limita tu stream y cómo ampliarla según la biblioteca. La pregunta «¿Qué errores de gRPC ponen en pausa mi conexión y cuándo debe dejar de reconectar mi cliente?», más arriba, indica los escalones y su duración.Qué es una ventana de recepción. En HTTP/2, el receptor le indica al emisor cuántos datos se pueden enviar antes de que el receptor confirme; esa cantidad es la ventana de recepción (la ventana de control de flujo de HTTP/2). Un viaje de ida y vuelta transporta como máximo una ventana, así que la velocidad se estanca cerca de la ventana dividida entre el tiempo de ida y vuelta (el trayecto hasta el endpoint y de regreso).
Los otros límites. Hay dos ventanas, una por stream y otra por conexión (todos los streams de una conexión la comparten), y la menor de las dos fija el límite. En la especificación de HTTP/2, ambas ventanas empiezan en 65,535 bytes. El búfer de recepción TCP (la memoria para los datos entrantes) limita la velocidad de la misma forma. Un proxy, balanceador de carga, gateway, VPN o sidecar intermedio tiene sus propias ventanas y búferes. Una ventana o un búfer pequeño ahí limita el stream aunque las ventanas de tu propio cliente sean grandes.
Cómo se ve. Un stream se estabiliza en casi la misma velocidad por muy activa que esté la cadena, y su retraso de entrega crece de forma constante. ERPC midió desde un lugar con un tiempo de ida y vuelta de unos 6 ms hasta el endpoint Shared de Frankfurt, cambiando solo la ventana entre pruebas:
- Ventana de stream de 16 KiB: plana cerca de 2.7 MB/s (16 KiB divididos entre 6 ms); el retraso de entrega creció unos 0.6 segundos por segundo y llegó a 26 segundos en 45 segundos.
- Ambas de 16 MiB: el retraso de entrega máximo fue de 14 ms.
Si el retraso de entrega se origina del lado de ERPC, ERPC cierra el stream sin que se cuente, y el error no incluye ningún plazo de reintento.
Cómo comprobarlo.
- Compara la velocidad y el retraso de entrega del stream con el patrón anterior.
- Mide el tiempo de ida y vuelta. Multiplica la velocidad del stream por el tiempo de ida y vuelta para estimar la ventana (2.7 MB/s por 6 ms son unos 16 KB).
- Comprueba si alguna de las dos ventanas de tu cliente tiene un valor pequeño o si el crecimiento automático (la biblioteca amplía la ventana por sí sola) está desactivado.
- Comprueba el búfer de recepción TCP. En Linux, ejecuta
sysctl net.ipv4.tcp_rmem net.core.rmem_maxy mira si tu aplicación estableceSO_RCVBUF, lo que desactiva el ajuste automático de tamaño. - Comprueba las ventanas y los búferes de todo lo que haya en medio.
- Si la velocidad no tiene techo y solo crece el retraso, lo lento es el procesamiento después de recibir. La pregunta «¿Qué significa
STREAM_GUARD_SLOW_READERconResourceExhausted (8)cuando un receptor lento queda desconectado?», más arriba, explica cómo dejar el bucle de recepción solo para leer y pasar el trabajo pesado a una cola acotada.
Ajustes por biblioteca. Los ejemplos fijan ambas ventanas en 16 MiB, como en la medición de ERPC. Para una biblioteca que no aparece aquí, busca los ajustes de ventana inicial de HTTP/2.
Rust,
yellowstone-grpc-client. Sin ajustes de ventana, GeyserGrpcClient::build_from_shared usa 2 MiB por stream y 5 MiB por conexión. Con un viaje de ida y vuelta de 6 ms, estos valores predeterminados permiten más de 300 MB/s, así que no limitan el stream. Para fijar tú mismo las ventanas, usa los dos métodos del builder y mantén http2_adaptive_window desactivado. Si está activado, la ventana empieza en 65,535 bytes y crece por sí sola hasta 16 MiB, sin tener en cuenta tus valores.rust
TypeScript,
@triton-one/yellowstone-grpc 5.0.1 o posterior. Valores predeterminados: 4 MiB por stream, 8 MiB por conexión y crecimiento automático activado. La ventana empieza en 64 KiB y crece hasta 16 MiB, así que los valores predeterminados rara vez limitan el stream. Para fijar los tamaños, pasa el tercer argumento con grpcHttp2AdaptiveWindow: false.typescript
TypeScript,
@triton-one/yellowstone-grpc 5.0.0 o anterior. Estas versiones usan @grpc/grpc-js, cuya ventana predeterminada es de 65,535 bytes: unos 11 MB/s a 6 ms y unos 0.66 MB/s a 100 ms. Desde la versión 1.14, @grpc/grpc-js aplica 'grpc-node.flow_control_window' a ambas ventanas; la versión 1.13 solo lo aplica a la ventana de stream, así que la ventana de conexión se queda en 65,535 bytes (unos 11 MB/s a 6 ms). Con una versión de @grpc/grpc-js anterior a la 1.14, es más rápido actualizar a @triton-one/yellowstone-grpc 5.0.1 o posterior.typescript
Go,
google.golang.org/grpc. De forma predeterminada, la biblioteca amplía las ventanas por sí sola, hasta 16 MiB. grpc.WithInitialWindowSize y grpc.WithInitialConnWindowSize las fijan y desactivan el crecimiento automático; los valores inferiores a 64 KiB se ignoran. Configura las dos: si solo configuras una, la otra se queda en 64 KiB.go
Python,
grpcio. grpc.http2.bdp_probe está activado de forma predeterminada, así que las ventanas crecen por sí solas; si tu código pasa ("grpc.http2.bdp_probe", 0), elimínalo. grpc.http2.lookahead_bytes fija la lectura anticipada por stream (64 KB de forma predeterminada); valores mayores pueden ayudar con un viaje de ida y vuelta largo.python
Recibe más cerca. Un viaje de ida y vuelta más corto permite que la misma ventana entregue más, y el servicio VPS y los servidores bare metal de ERPC sitúan el cliente cerca del endpoint.
Divide con cuidado. Standard permite 10 streams y Premium 50, por cada IP de origen registrada. Cada stream tiene su propia ventana de stream, pero los streams de una misma conexión comparten una sola ventana de conexión, así que una ventana de conexión pequeña sigue limitando la velocidad. Al reemplazar un stream, cierra primero el anterior: los streams abiertos entran en el límite, y superarlo devuelve
STREAM_ADMISSION_LIMIT_REACHED (tiene su propia pregunta más abajo). Dividir no acelera un procesamiento lento.P: ¿Qué significa STREAM_GUARD_EGRESS_BUDGET con ResourceExhausted (8)?
El tráfico agregado de la IP superó el límite de Shared, de modo que los streams relacionados pueden cerrarse juntos. Reduce el volumen de datos y los streams paralelos innecesarios, y espera hasta el plazo devuelto. Esta pausa de egreso dura 600 segundos y no avanza la escala de penalizaciones, aunque puede seguir vigente una pausa más larga ya existente.
P: ¿Qué significa STREAM_GUARD_PENALTY_ACTIVE con ResourceExhausted (8)?
Sigue activa una pausa anterior por lector lento o egreso, y esta respuesta incluye el tiempo restante. Conserva el primer error de ERPC, corrige su causa y no reconectes antes de
x-erpc-retry-at; no reconectes antes para probarlo. Los intentos de reconexión no se cuentan. La pregunta «¿Qué errores de gRPC ponen en pausa mi conexión y cuándo debe dejar de reconectar mi cliente?», más arriba, indica los escalones y su duración.P: ¿Qué significa STREAM_GUARD_SHAPE_BLOCKS con PermissionDenied (7)?
La regla actual de Shared rechaza cualquier mapa
blocks no vacío, incluso cuando la solicitud es limitada. Elimina el mapa blocks. Usa transacciones y/o metadatos de bloques cuando cubran la necesidad; ninguno equivale a un bloque completo. Para bloques completos se necesita Geyser gRPC Dedicated; esto no implica que exista un plan de bloques selectivos en Shared.P: ¿Qué significa STREAM_GUARD_SHAPE_ACCOUNTS_ALL con PermissionDenied (7)?
Una entrada de filtro de cuenta debe seleccionar datos con
account, owner o un filtro cuckoo compatible. memcmp y dataSize solos no son suficientes. Limita la solicitud de cuentas a una de esas formas compatibles o usa Geyser gRPC Dedicated cuando necesites el stream completo de cuentas.P: ¿Qué significa STREAM_GUARD_SHAPE_REJECT_PENALTY con ResourceExhausted (8)?
Este código se devuelve en lugar de
ERPC_GRPC_INVALID_ARGUMENT, STREAM_GUARD_SHAPE_BLOCKS o STREAM_GUARD_SHAPE_ACCOUNTS_ALL cuando esa solicitud rechazada contada es la que inicia una pausa; la pregunta «¿Qué errores de gRPC ponen en pausa mi conexión y cuándo debe dejar de reconectar mi cliente?», más arriba, indica cuándo ocurre. Incluye Retry after N seconds., x-erpc-retry-after-seconds y x-erpc-retry-at. Durante esta pausa, las conexiones nuevas se cierran inmediatamente sin estado gRPC ni código de ERPC, así que es posible que el cliente nunca vuelva a ver la hora de fin. Guarda x-erpc-retry-at del primer error que lo incluya. Las solicitudes Subscribe rechazadas se cuentan según las reglas anteriores; reconectar, no. Corrige la solicitud y no la reenvíes sin cambios. Un cierre temprano puede parecer un error de transporte, así que conserva el primer error de ERPC antes de que el bucle de reconexión lo oculte.P: ¿Qué significa STREAM_ADMISSION_LIMIT_REACHED con ResourceExhausted (8)?
La capacidad de admisión está llena en este momento. Cierra streams sin usar o duplicados, revisa la capacidad de la conexión y vuelve a intentarlo cuando haya capacidad disponible. Esta respuesta no significa por sí sola que haya una penalización temporizada activa.
P: ¿Qué significa STREAM_ADMISSION_IP_NOT_ADMITTED con PermissionDenied (7)?
ERPC no pudo admitir la conexión, incluso después de que expire un período de gracia de registro de IP. Compara la IP de salida real con la IP registrada y confirma el estado de acceso actual. Da tiempo a que se propague un cambio de registro sin asumir un plazo fijo, y contacta con soporte si persiste.
P: ¿Qué significa STREAM_ADMISSION_SOURCE_UNAVAILABLE con Unavailable (14)?
ERPC no pudo determinar el origen de esta conexión en ese momento. Aplica backoff y vuelve a intentarlo después. Si persiste, contacta con soporte e incluye el primer error y sus metadatos; la respuesta no demuestra un fallo en la red o el servidor del cliente.
P: ¿Qué significa STREAM_ADMISSION_SNAPSHOT_UNAVAILABLE con Unavailable (14)?
ERPC no pudo verificar el acceso en ese momento. Aplica backoff y vuelve a intentarlo después; contacta con soporte si continúa. Volver a registrar repetidamente, ampliar filtros o comprar Geyser gRPC Dedicated no corrige esta respuesta de disponibilidad.
P: ¿Qué significa ERPC_GRPC_INVALID_ARGUMENT con InvalidArgument (3)?
La solicitud contiene parámetros, opciones, tipos de campo, claves o combinaciones de filtros inválidos. Corrige la solicitud antes de reintentarla y no reenvíes la misma solicitud. Cada solicitud Subscribe rechazada con este código es un error contado según las reglas de pausa de la pregunta «¿Qué errores de gRPC ponen en pausa mi conexión y cuándo debe dejar de reconectar mi cliente?», más arriba, reglas que comparte con
STREAM_GUARD_SHAPE_BLOCKS, STREAM_GUARD_SHAPE_ACCOUNTS_ALL y STREAM_GUARD_SLOW_READER. Cuando una de estas solicitudes inicia una pausa, se devuelve como STREAM_GUARD_SHAPE_REJECT_PENALTY con ResourceExhausted (8). Geyser gRPC Dedicated no hace válidos los parámetros inválidos.El mensaje de error termina el código con
(reason: <token>), y el mismo token se devuelve en el header de respuesta x-erpc-error-reason. Busca el token abajo para ver qué cambiar. Cuando se aplica un límite, el mensaje de error lo indica.P: ¿Qué significa ERPC_GRPC_REQUEST_FAILED cuando gRPC devuelve otro estado distinto de cero?
La solicitud falló con un estado gRPC válido que determina el siguiente paso. Corrige una solicitud con
OutOfRange (11) cuando un rango histórico sea inválido; aplica backoff ante un estado de disponibilidad como Unavailable (14). No clasifiques todos los estados distintos de cero como transitorios ni reintentes sin cambios cada respuesta.P: ¿Qué región recomiendan?
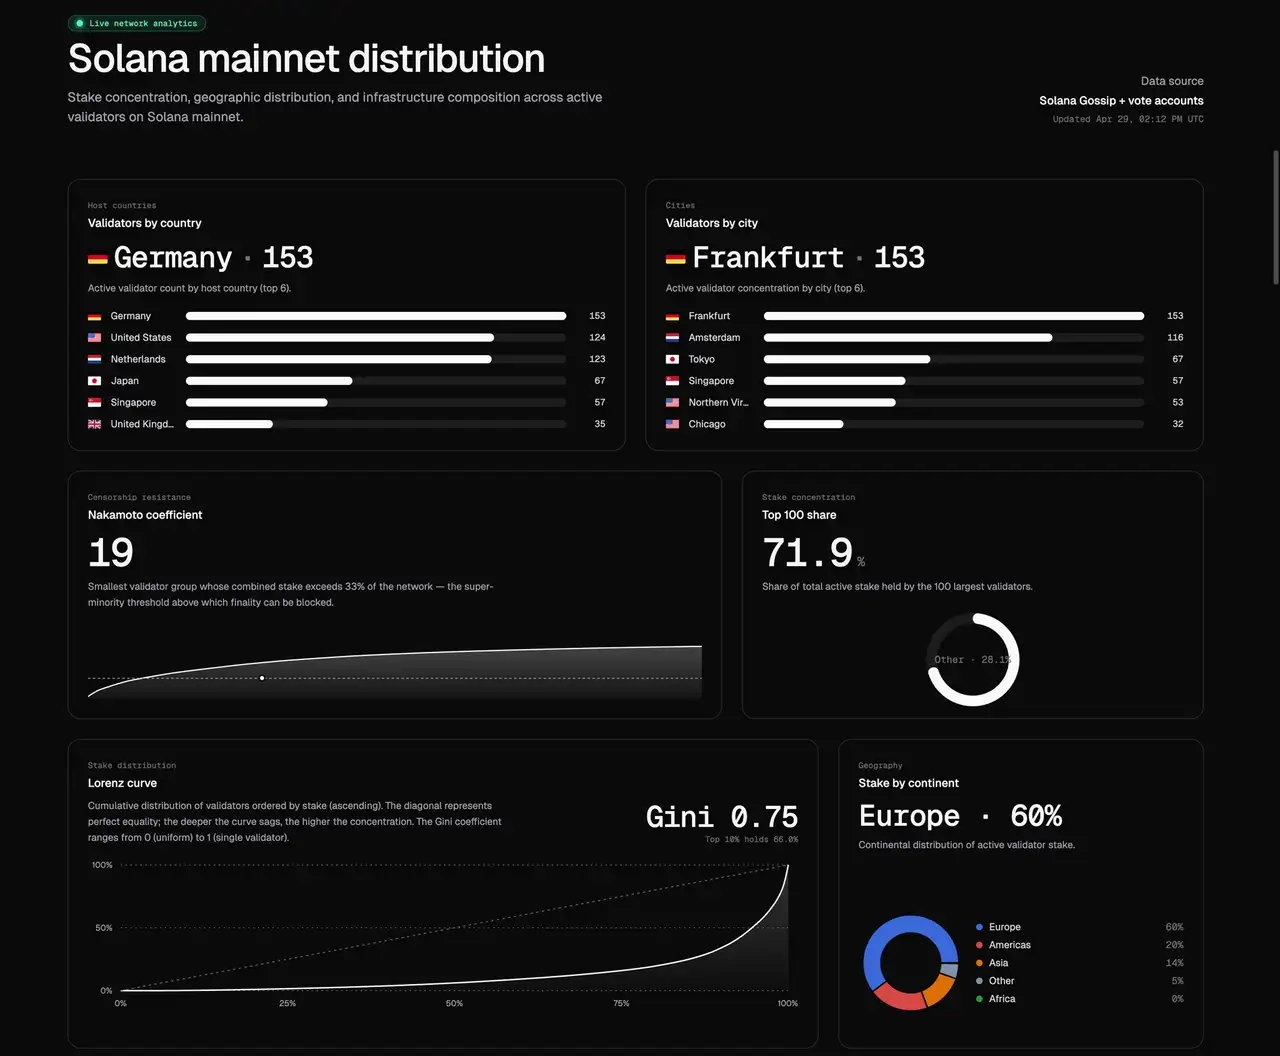
No existe una única región que sea siempre la mejor. Solana es global y el rol de líder pasa de un validador a otro según el calendario de líderes. Las regiones con más validadores y más stake reciben slots de líder con más frecuencia, lo que puede ayudar a que las transacciones se incluyan antes en un bloque. La contrapartida es que el tráfico de la competencia también se concentra allí, por lo que, según tu estrategia, una región menos concurrida a veces puede ofrecer mejores resultados.
Como punto de partida práctico, elige una región con alta densidad de validadores como Frankfurt o la costa este de los Estados Unidos cuando más importe recibir un flujo constante de slots de líder, o sitúate cerca de un validador objetivo específico cuando la ruta de ejecución más corta sea la prioridad. Usa Validators Solutions para entender la distribución pública de la red Solana y luego usa la ERPC Leader Slot API y las mediciones reales para decidir si es apropiado un despliegue en una sola región, en dos regiones o global.
P: Necesito una latencia de ~400ms o menos.
Para lograr una latencia de aproximadamente 400ms o menos, ten en cuenta estos puntos esenciales:
-
Comprensión realista de los valores de ping: Los valores de ping reflejan condiciones ideales y no la latencia real de las comunicaciones en streaming, que suele rondar 5 veces la latencia del ping. Por ejemplo, un ping de 100ms entre continentes se traduce en la práctica en unos 500ms de latencia. Por lo tanto, para alcanzar ~400ms de latencia, la infraestructura debe estar en la misma región.
- Referencia típica del valor del ping:
- Misma red: ~0.1ms
- Interconexión de red privada (PNI): ~0.2ms
- Mismo centro de datos: ~0.3ms
- Misma ciudad: ~1ms
- País vecino: ~5–10ms
- Intercontinental: ~100–300ms
- Referencia típica del valor del ping:
-
Evitar la trampa de la latencia media: Los validadores de Solana están geográficamente dispersos a nivel mundial, y el calendario de líderes cambia aleatoriamente con cada época. Confiar en la latencia media para alcanzar ~400ms es poco práctico. En su lugar, debes realizar un seguimiento preciso de los calendarios de validadores en tu región específica para identificar los slots con la latencia más baja. Para lograr una latencia mínima de forma constante, se necesita infraestructura en todas las regiones pertinentes. Dentro de la misma región, la adquisición de datos puede ocurrir en decenas de milisegundos, y la transmisión, en solo unos pocos milisegundos.
-
Seguimiento del calendario de líderes: Monitorea el calendario de validadores líderes de tu región con la ERPC Leader Slot API (
getLeaderSlots). Devuelve el calendario de próximos líderes, el peso de stake de la época actual, la geolocalización estimada de los validadores y valores de ping de referencia, para que puedas identificar los slots de menor latencia a los que apuntar antes de que lleguen. Los datos públicos tipo mapa y las API RPC nativas son útiles para tener una visión amplia de la red, pero no son lo bastante precisos para sincronizar la ejecución. La Leader Slot API cubre ese hueco con la granularidad necesaria para las decisiones de enrutamiento y trading.
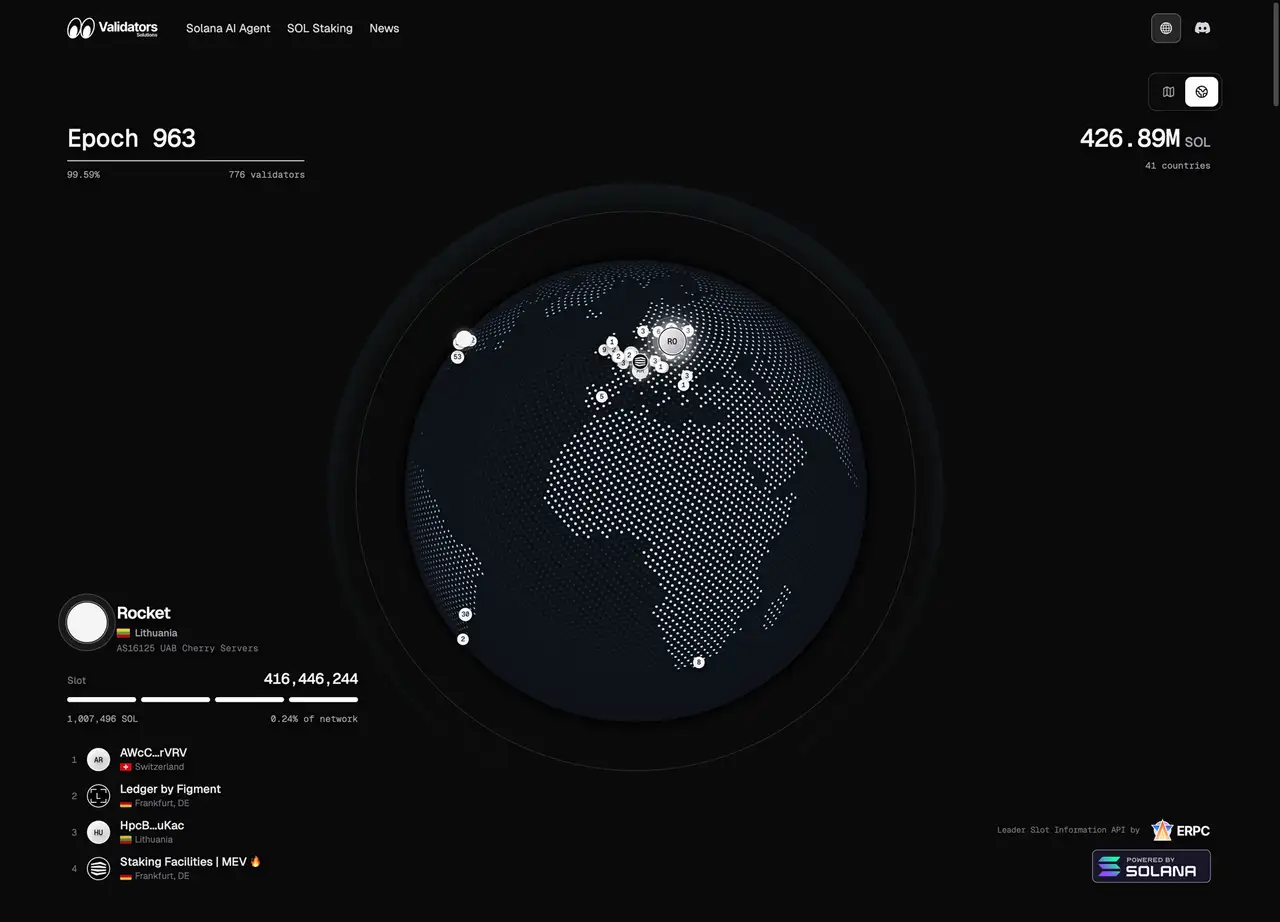
Datos de la red de Solana: Validators Solutions
P: ¿Cómo puedo lograr el trading de cero bloques (cero slots)?
Lograr con éxito el trading de cero bloques (cero slots) requiere estrategias más sofisticadas, como las siguientes:
-
Identificar zonas de oportunidad: Los validadores de Solana se distribuyen globalmente, y es físicamente imposible alcanzar la latencia óptima para cada slot. Por lo tanto, monitorea los calendarios de validadores líderes en la región donde se encuentra tu infraestructura e identifica las zonas de oportunidad más favorables. El despliegue de infraestructura en varias regiones también puede ser ventajoso. Por ejemplo, Frankfurt es una región clave debido a su alta densidad de validadores, lo que resulta en una selección de líderes más frecuente y más oportunidades de trading.Utiliza la ERPC Leader Slot API (
getLeaderSlots) para consultar el calendario de próximos líderes, el peso de stake de la época actual, datos estimados de geolocalización de validadores y valores de ping de referencia, con mucha más precisión que las fuentes públicas de datos tipo mapa o las API RPC nativas. Así puedes identificar las zonas de oportunidad antes de que lleguen los slots y ejecutar operaciones con latencia cercana a cero. -
Usar nodos dedicados: Si te cuesta competir, considera desplegar nodos dedicados. Los nodos compartidos experimentan latencia debido al tráfico de otros usuarios, y por lo tanto no se recomiendan. Además, colocar tu nodo dedicado dentro de la misma red que tu aplicación reduce significativamente la latencia de la red y optimiza el rendimiento.
P: ¿Puedo usar un endpoint específico?
Para mantener un entorno de baja latencia, nuestro sistema selecciona automáticamente el nodo disponible más cercano. Si deseas utilizar un endpoint específico, te recomendamos alquilar un servidor situado lo más cerca posible de ese endpoint.
P: Estoy recibiendo un error 401. ¿Por qué?
Para mantener un entorno de baja latencia, implementamos restricciones de IP. Si no tienes una suscripción o tu IP no está registrada, recibirás un error 401.
Por favor, comprueba si tu IP registrada coincide con tu IP de acceso actual.
P: Estoy recibiendo un error 429. ¿Por qué?
Has alcanzado el límite de conexión de tu plan.
Si encuentras este error, considera actualizar tu plan. Si necesitas más conexiones de las que proporciona nuestro plan premium, un nodo de gRPC dedicado sería más adecuado.
P: ¿Por qué los endpoints dedicados son más rápidos?
Los endpoints compartidos son utilizados por múltiples clientes que comparten los mismos recursos. A medida que aumenta el tráfico, tiende a aparecer latencia. Los recursos del servidor tienen límites físicos, y la cantidad de trabajo que pueden manejar es finita. Cuando llegan demasiadas solicitudes al mismo tiempo, deben ser procesadas secuencialmente, lo que resulta en tiempos de respuesta más lentos.
Aunque tomamos varias medidas para optimizar el rendimiento incluso en endpoints compartidos, con endpoints dedicados eres el único usuario del recurso. Esto significa que no te ves afectado en absoluto por otros usuarios, lo que garantiza respuestas siempre estables y rápidas.
Además, los endpoints dedicados ofrecen opciones de comunicación sin TLS, como HTTP. Al omitir el handshake TLS (unos 20ms), la comunicación se vuelve aún más rápida en comparación con HTTPS.
P: ¿Se aumentará mi precio después de suscribirme?
Mientras tu suscripción siga activa, se mantiene el precio que fijaste al registrarte. Los entornos capaces de soportar la carga de trabajo en tiempo real de Solana escasean en todo el mundo, y tenemos previsto subir los precios a medida que crezca la demanda de hardware y de red. Las configuraciones de mayores prestaciones y las regiones con más demanda son las que antes se agotan, por lo que asegurarte el precio actual es la opción más rentable a largo plazo.
P: Quiero pagar con cripto
Los pagos con cripto están disponibles desde el ERPC Web Dashboard cuando el país de tu dirección de facturación registrada es uno de los países miembros de la UE. Si todas las tarjetas de pago registradas en tu cuenta fueron emitidas fuera de la UE, los pagos con cripto no están disponibles. Puedes usar SOL, USDC o EURC para comprar ERPC Credits.
Usa esos ERPC Credits para activar o continuar planes de ERPC. Abre el dashboard, elige el pago con cripto, envía la transferencia desde tu wallet y el dashboard verificará la transacción y aplicará los créditos a tu cuenta.
Países admitidos: Alemania, Austria, Bélgica, Bulgaria, Chequia, Chipre, Croacia, Dinamarca, Eslovaquia, Eslovenia, España, Estonia, Finlandia, Francia, Grecia, Hungría, Irlanda, Italia, Letonia, Lituania, Luxemburgo, Malta, Países Bajos, Polonia, Portugal, Rumanía, Suecia.
Para los países que no están en la lista, paga con tarjeta de crédito.
P: ¿Cómo puedo lograr la latencia más baja posible?
Te recomendamos encarecidamente combinar un nodo de gRPC dedicado con nuestro servidor bare metal.
Ambos comparten la misma red, permitiendo la comunicación privada de cero distancia sin atravesar internet. Esta configuración alcanza una latencia extremadamente baja, normalmente con un ping de unos 0.1ms.
Contáctanos desde el ERPC Web Dashboard para más detalles.
P: ¿Cómo es la latencia?
La latencia varía según el método de medición y tu entorno de uso específico. En lugar de centrarte en valores numéricos exactos, es crucial asegurarte de que la latencia cumpla con tus requisitos operativos reales.
Proporcionamos herramientas fáciles de usar en TypeScript y Rust para medir la latencia.
P: ¿Es este RPC (gRPC, Shreds) más rápido que otros?
Diseñamos cada nivel de precio para la velocidad, y nos alegra que se mida en comparación directa con cualquier otro proveedor. Los resultados pueden variar según la región, el uso de un endpoint compartido o dedicado, el protocolo (WebSockets, gRPC o Shreds) y el lenguaje de programación de tu cliente.
Si encuentras nuestro servicio más lento, indícanos a través del ERPC Web Dashboard las condiciones específicas y los competidores con los que lo has comparado. Identificaremos la causa y mejoraremos aún más la velocidad.
P: ¿Qué plan ofrece el rendimiento más rápido?
En general, nuestro plan de más alto nivel proporciona el rendimiento más rápido debido a las CPU superiores, capacidades de memoria más altas y configuraciones de hardware robustas.
También ofrecemos soluciones personalizadas si necesitas servidores aún más potentes, pero nuestros planes estándar están diseñados para ofrecer relaciones precio-rendimiento óptimas.
Estamos convencidos de que ofrecemos un rendimiento de clase mundial en cada nivel de precios. Si encuentras un proveedor más rápido dentro del mismo rango de precios, avísanos para que podamos investigar y hacer mejoras.
P: Estoy experimentando alta latencia. ¿Qué puedo hacer?
La latencia depende en gran medida de tu proximidad al endpoint. Recomendamos acceder desde un servidor cerca del endpoint proporcionado. Las conexiones más rápidas se logran con nuestros servidores bare metal y nuestro servicio VPS.
P: ¿Cuál es el más rápido: WebSockets, gRPC o Shreds?
Los comentarios de nuestros clientes clasifican constantemente la velocidad como sigue:
Shreds > gRPC > WebSockets
Por favor, comparte tu experiencia si observas resultados diferentes.
P: La latencia no es lo que esperaba.
El rendimiento varía dependiendo del lenguaje de programación utilizado. En general, los lenguajes se ordenan así por velocidad:
Rust > Go > TypeScript (JavaScript) > Python
Para comparaciones detalladas, consulta:
Para el máximo rendimiento, recomendamos encarecidamente utilizar Rust.