








Accélérez votre application Solana : revoyez le volume de données gRPC, le traitement à la réception et les ressources d’exécution
L’application Solana que vous développez pourrait fonctionner plus vite. Le volume de données reçues, le traitement qui suit et les ressources telles que le CPU et le réseau agissent ensemble. Examiner cette combinaison peut vous aider à tirer davantage de performances de votre logiciel existant.
Vous avez commencé à développer du HFT sur Solana, vous vous êtes connecté à Geyser gRPC et les données apparaissent dans les journaux. Pourtant, les décisions n’arrivent pas aussi vite que prévu. L’attente entre la réception et une décision peut donner des pistes d’amélioration. Commencez par repérer ce que vous pouvez observer dans votre code actuel.
Chez ERPC, les échanges et les retours des clients nous donnent l’occasion d’examiner la distribution des données, les paramètres de réception et le traitement applicatif. Ces observations alimentent les améliorations de notre distribution et de notre documentation. Cet article présente les mécanismes et les étapes d’investigation pour permettre aux développeurs qui abordent pour la première fois des flux rapides et volumineux d’explorer les améliorations possibles dans leur propre environnement.
Commencez par une petite vérification dans votre code actuel
Vous pouvez rechercher les termes techniques et les commandes de diagnostic à mesure qu’ils deviennent utiles. Si vous disposez d’un agent IA capable de lire le code de votre projet, essayez d’abord la courte demande ci-dessous. Ajoutez où l’application s’exécute et dans quelles situations elle vous semble lente. Vous pouvez commencer en laissant les exigences encore indécises et les mesures indisponibles en l’état.
text
Je souhaite savoir si mon application Solana pourrait répondre plus vite.
Lisez d’abord le code actuel et indiquez où les données sont reçues et où se termine la décision qui les utilise. Conservez l’abonnement inchangé et proposez la plus petite modification permettant de mesurer le nombre d’événements et le temps écoulé sur cet intervalle.
Pour cette première tâche, présentez les points de mesure, la modification proposée, ce qu’elle permettrait d’apprendre et ce qui resterait non mesuré. Si l’accès à l’hôte n’est pas disponible, commencez par ce qui est observable dans l’application. N’affichez pas d’informations confidentielles, ne modifiez pas la production et ne créez pas de ressources payantes.
Je souhaite savoir si mon application Solana pourrait répondre plus vite.
Lisez d’abord le code actuel et indiquez où les données sont reçues et où se termine la décision qui les utilise. Conservez l’abonnement inchangé et proposez la plus petite modification permettant de mesurer le nombre d’événements et le temps écoulé sur cet intervalle.
Pour cette première tâche, présentez les points de mesure, la modification proposée, ce qu’elle permettrait d’apprendre et ce qui resterait non mesuré. Si l’accès à l’hôte n’est pas disponible, commencez par ce qui est observable dans l’application. N’affichez pas d’informations confidentielles, ne modifiez pas la production et ne créez pas de ressources payantes.Le premier résultat utile est de savoir où et quoi mesurer dans votre propre code. Distinguer les intervalles observables de ceux qui ne sont pas mesurés aide à choisir la prochaine étape. Un prompt plus détaillé est proposé plus loin dans l’article pour approfondir le diagnostic.
Un agent pourrait par exemple répondre : « La réception se trouve dans
stream.ts, au niveau de onData ; la décision est finalisée dans strategy.ts, au niveau de onDecisionComplete. Je propose une modification qui agrège le nombre d’événements reçus, le nombre de décisions finalisées et le temps écoulé sur cet intervalle. L’intervalle avant le callback ne fait pas partie du périmètre de cette proposition de mesure. » Cet exemple utilise des noms de fichiers et de fonctions fictifs en TypeScript. Quel que soit le langage de programmation, vérifiez que ces trois éléments sont cohérents : les emplacements dans le code réel, les données à enregistrer et les limites de cette mesure. Si la réception et les décisions n’ont pas une relation un à un, demandez aussi à l’agent de proposer leur correspondance et l’unité de comptage.Ajoutez une perspective de flux à votre expérience du développement web
Les services managés permettent de développer de nombreuses fonctionnalités web sans se préoccuper de chaque composant du serveur. Cette expérience reste une base pour travailler avec les flux Solana. Ajoutez-y l’observation du volume de données qui arrive en continu et de la vitesse à laquelle l’application le traite.
Connecter un SDK à Solana peut sembler tout aussi simple. Mais s’abonner à un large ensemble de transactions ou de mises à jour de comptes modifie la charge de travail. Les besoins en bande passante, CPU et mémoire dépendent de l’abonnement, de la taille des messages, de la compression, du traitement applicatif et du trafic au moment considéré. Il n’existe pas un nombre fixe de mégaoctets par seconde pour « Solana ».
Le point de départ consiste à intégrer le rapport entre le travail entrant et la capacité de traitement à la conception comme aux mesures.
Même un flux actif peut accumuler une file d’attente
Comparez d’abord les données qui arrivent pendant la même seconde à l’aide de carrés de taille identique. Chaque carré représente 1 000 messages ; en supposant 1 kB par message, cela fait 1 MB. Le petit exemple reçoit 2 MB par seconde et le grand, 12 MB par seconde, avec la même capacité de traitement pour l’application réceptrice dans les deux cas. Il s’agit d’un modèle illustratif du volume de charge utile des messages en unités décimales, hors compression et en-têtes de protocole.
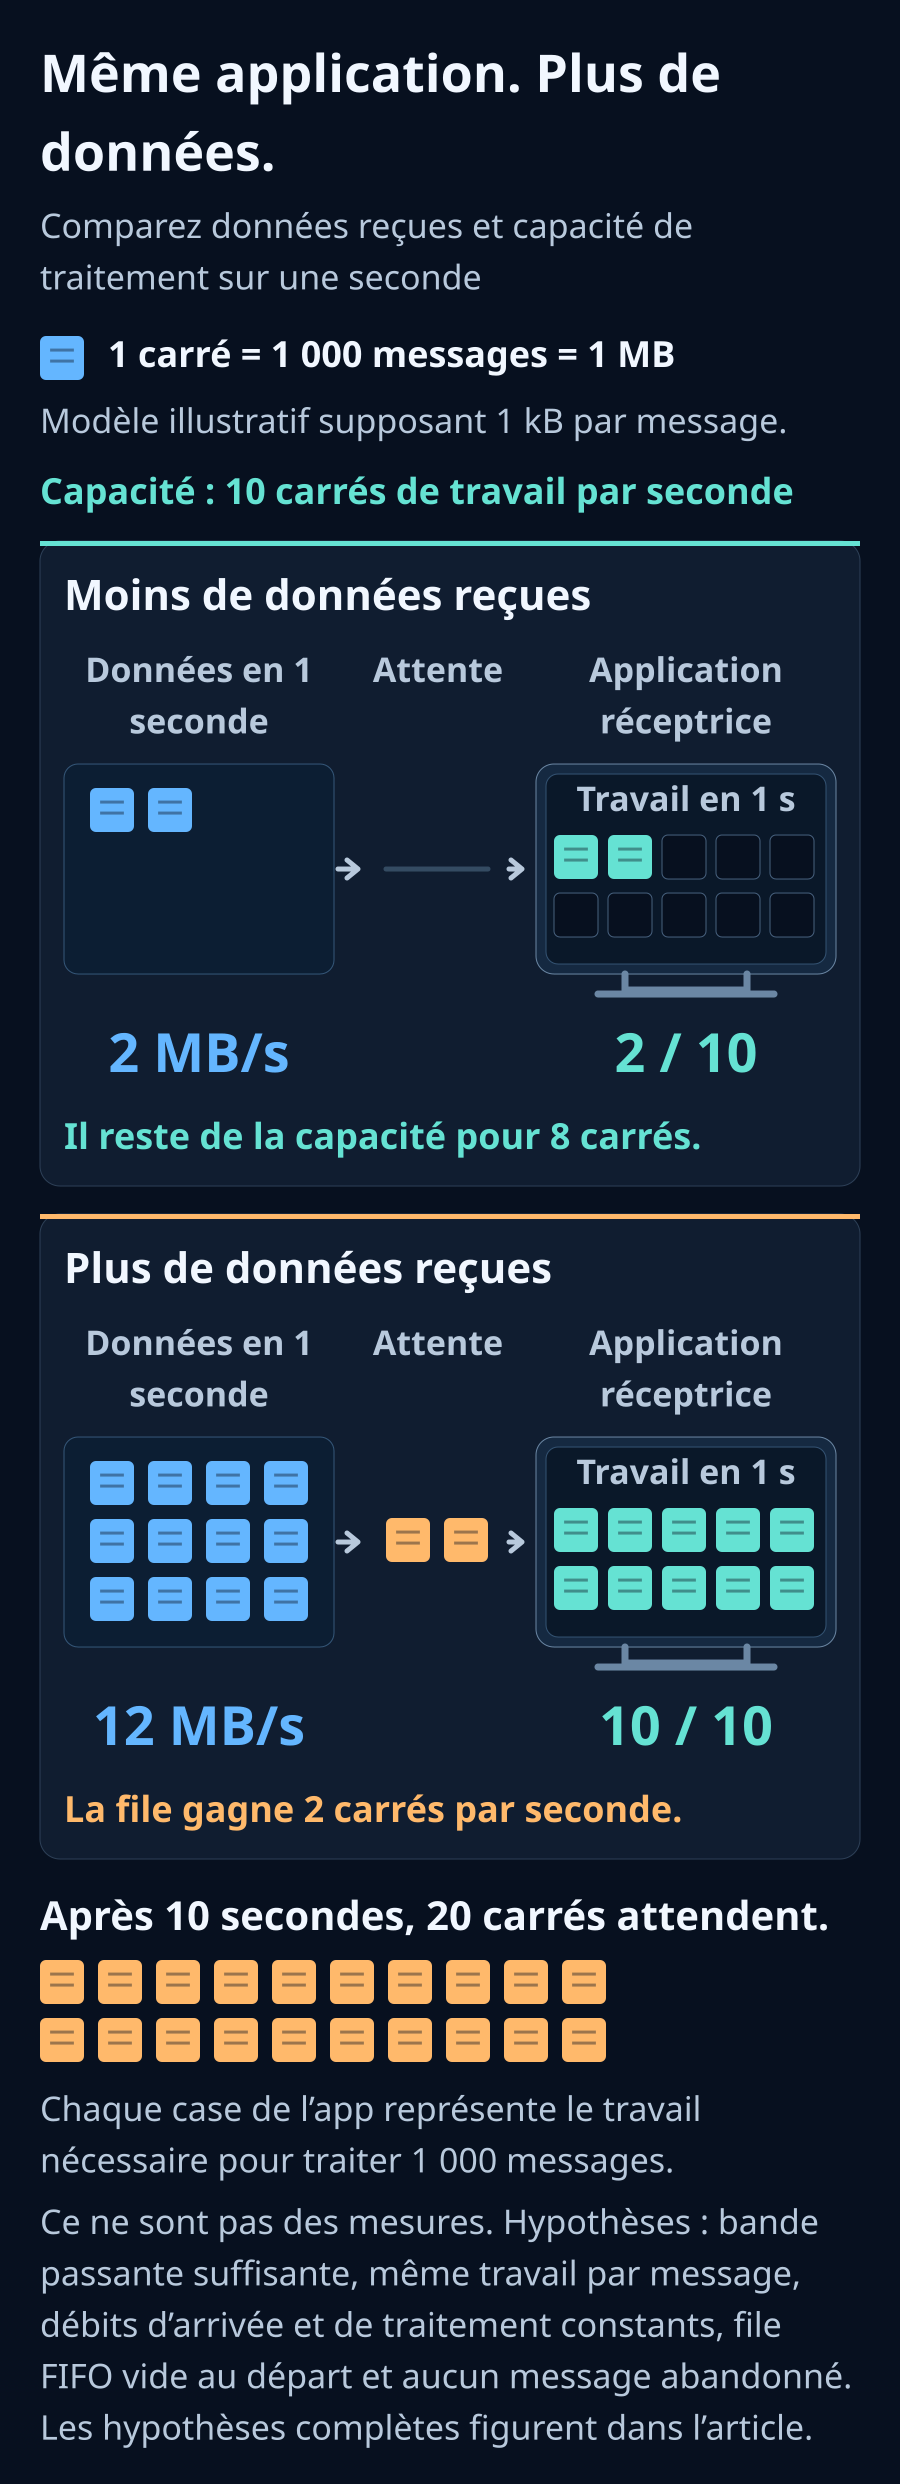
Prenons un modèle illustratif : 12 000 événements arrivent par seconde, et un ordinateur peut en traiter 10 000 par seconde. Chaque événement demande le même travail, la file est initialement vide, les événements sont traités dans leur ordre d’arrivée et aucun n’est supprimé.
Chaque seconde, 2 000 événements supplémentaires restent à traiter. Après dix secondes, 20 000 événements attendent. Un événement qui rejoint alors la file attend environ deux secondes avant le début de son traitement. Les journaux continuent à défiler pendant que la file s’allonge.
Il s’agit d’hypothèses explicatives, et non de mesures de Solana ou d’ERPC. Le modèle suppose un débit entrant et une capacité constants. Le trafic réel arrive par rafales, et le coût du traitement varie. Une attente peut donc apparaître même si la capacité moyenne est suffisante.
Le contrôle de flux de gRPC ajuste la transmission à ce que le destinataire peut accepter. Lorsque le traitement prend du retard, l’attente peut dépasser la file de l’application et s’étendre aux bibliothèques de communication ou à l’émetteur. Une connexion active ou une écriture réussie dans une API d’envoi ne prouve pas que les données sont à jour lorsqu’elles arrivent.[1]
Choisissez les données nécessaires avant qu’elles traversent le réseau
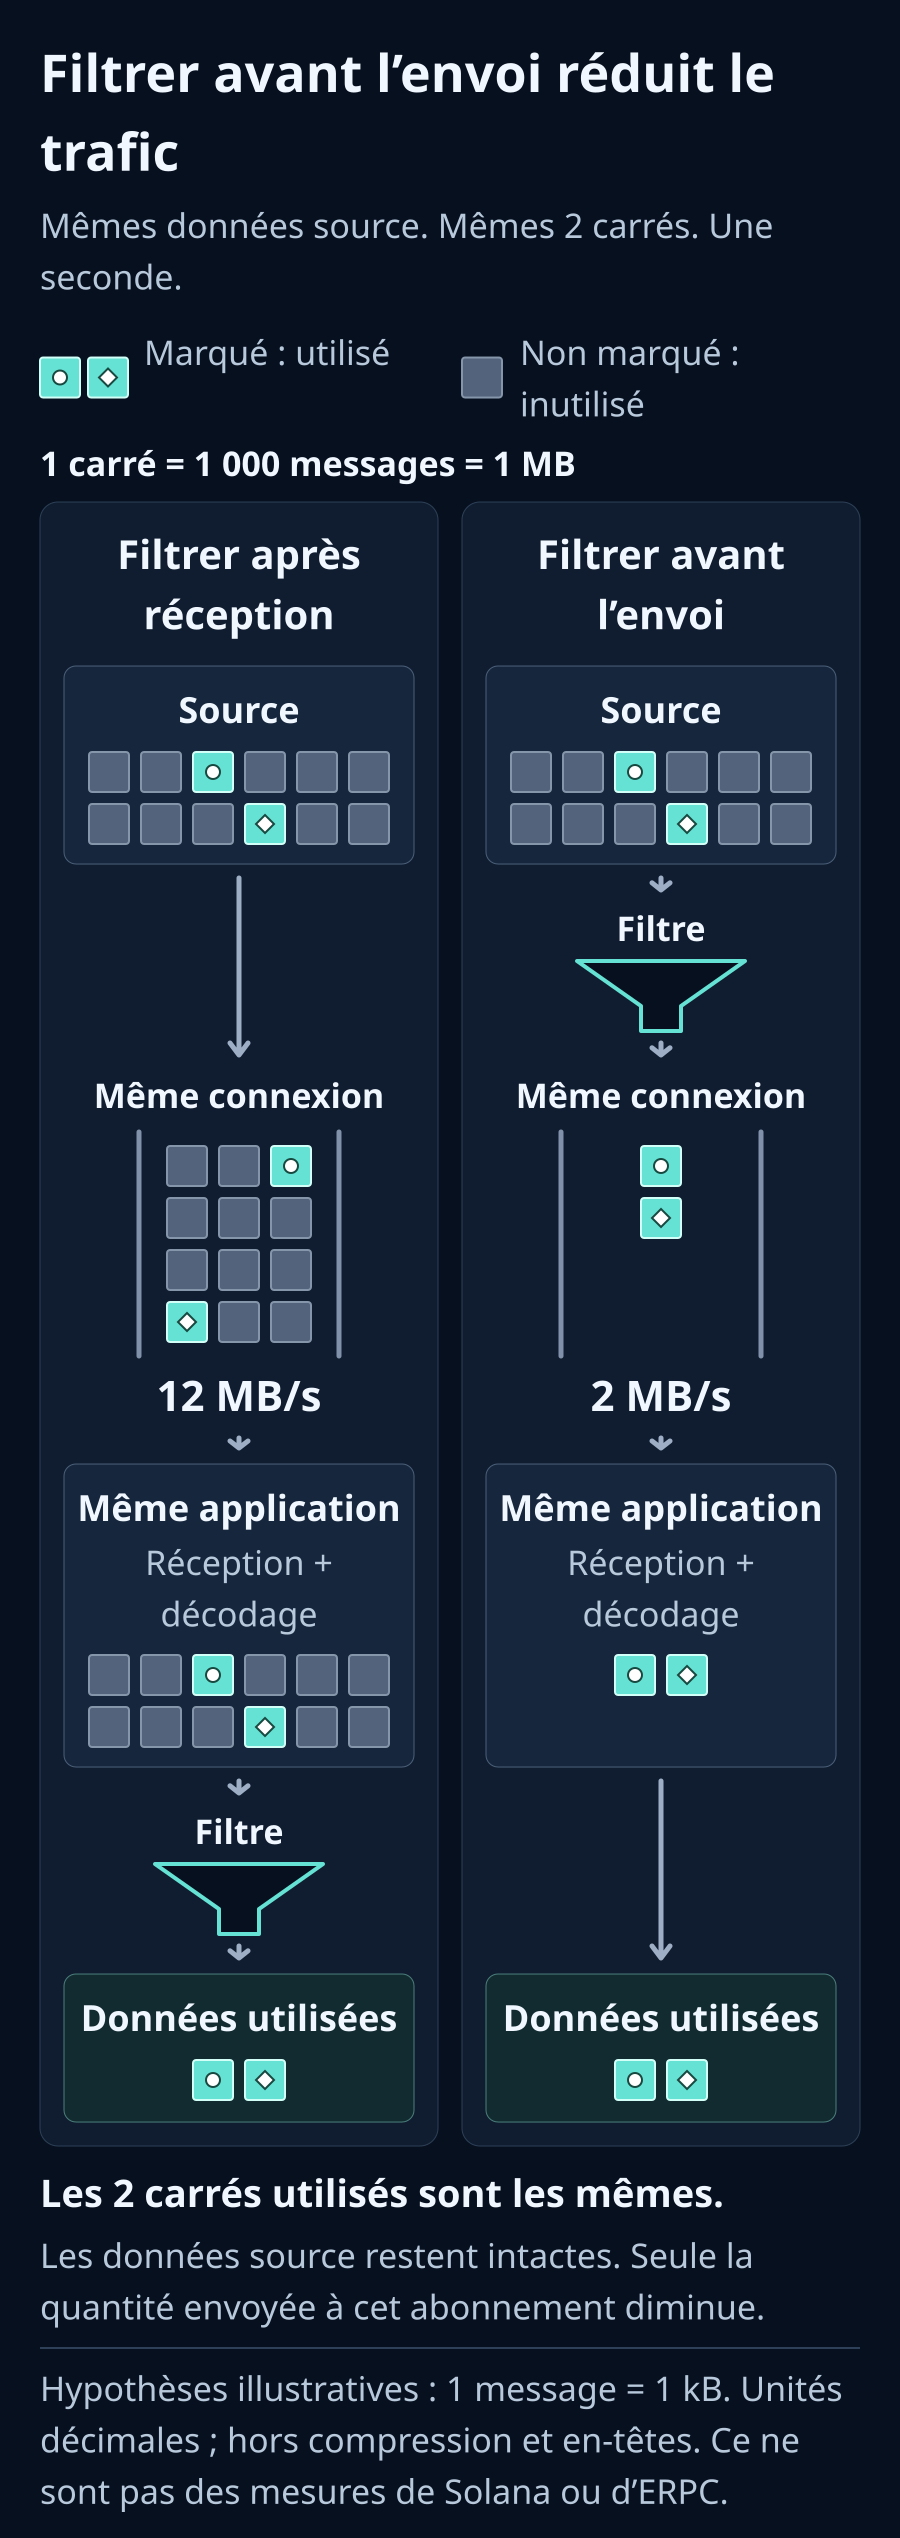
Si vos décisions n’exigent que certains programmes ou comptes, définissez d’abord les données nécessaires, puis appliquez des filtres d’abonnement côté serveur. Yellowstone gRPC propose des filtres pour les transactions et les comptes. Vérifiez les combinaisons précises et les possibilités disponibles dans les spécifications de l’API, du SDK et du service utilisés.[2]
Si vous ne savez pas encore quoi filtrer, examinez le code pour identifier les valeurs utilisées par votre application dans ses décisions et les champs des notifications qui les fournissent. Déduisez de cette correspondance des conditions d’abonnement possibles, puis vérifiez que les événements nécessaires connus sont bien inclus. Contrôler à la fois la réduction du nombre d’événements et la conservation des données nécessaires donne une base solide pour la comparaison suivante.
Tout recevoir puis supprimer les données inutiles côté client implique que le travail de transfert, de déchiffrement et de décodage a déjà eu lieu jusqu’à ce point. Filtrer à l’émission peut réduire ce travail. Dans l’exemple précédent, limiter le flux aux 2 000 événements nécessaires par seconde laisse de la marge à la même capacité de traitement de 10 000 événements par seconde.
Pensez à la circulation routière : la longueur de la route représente la distance de propagation, les voies représentent la bande passante, le péage représente la capacité de traitement à la réception, et la file de voitures représente le travail en attente. Envoyer seulement les voitures nécessaires vers le même péage ne produit pas la même file que d’y diriger toutes les voitures des environs. Raccourcir la route et réduire le nombre de voitures sont deux améliorations distinctes.
La communication a aussi des limites physiques. Transférer 100 MB à 1 Gbps prend théoriquement au moins 0,8 seconde ; à 10 Gbps, il faut 0,08 seconde. Ces limites inférieures utilisent des unités décimales et excluent la distance, le surcoût des protocoles, les retransmissions et les files d’attente. Elles ne signifient pas que chaque événement individuel du flux subit un retard de 0,8 seconde.
Même si un calcul prend moins de temps qu’un échange réseau, envoyer des données inutiles a toujours un coût. Considérez séparément le temps de propagation, la quantité transférable par unité de temps et le travail qui peut être accompli après l’arrivée.
Certaines applications ont besoin de toutes les données, notamment les index complets, l’audit et la recherche. Elles nécessitent des capacités de réception, de traitement et de stockage adaptées à cette charge. Recevoir toutes les notifications individuelles est également différent d’attendre un bloc complet : des données agrégées et reconstruites sous forme de bloc. Vérifiez si votre décision dépend inutilement de données sans rapport avec elle ou de la fin de cette agrégation.[2]
Revoyez le traitement à la réception et les ressources d’exécution
Rust peut aider à réduire le coût du traitement. Pour profiter de cette vitesse, examinez aussi le volume entrant, la capacité effective du lien, le temps d’attente des écritures en base, les verrous et les sections séquentielles. Dans un environnement d’exécution asynchrone, affecter les tâches gourmandes en CPU et celles qui bloquent un thread à des parties adaptées du système peut également améliorer l’application.[3]
Gardez la boucle de réception courte et séparez les tâches coûteuses. Définissez une limite de file et le comportement à adopter lorsqu’elle est pleine. Une file sans limite peut masquer un retard croissant derrière une consommation de mémoire qui augmente. Une file bornée ne résout pas non plus un manque durable de capacité de traitement. Préservez l’ordre et l’exhaustivité nécessaires en choisissant parmi des abonnements plus ciblés, un traitement plus efficace, le partitionnement, le parallélisme et des ressources supplémentaires.
Commencez par mesurer de la réception à la fin de la décision, puis approfondissez les endroits où l’attente apparaît. Le tableau ci-dessous propose une première façon d’examiner chaque domaine. Les noms détaillés des métriques et les commandes figurent aussi dans le prompt de diagnostic plus loin, afin de consulter les éléments qui deviennent pertinents.
| Ressource | Première vérification |
|---|---|
| CPU | Le travail se concentre-t-il sur un seul cœur ? Vérifiez l’utilisation globale et par cœur, ainsi que les limites CPU de l’environnement d’exécution |
| Mémoire | Le nombre d’événements en attente ou l’utilisation de la mémoire continuent-ils à augmenter ? Observez le volume de données en file avec le temps d’attente de l’événement le plus ancien |
| Disque et base de données | La réception attend-elle la fin du stockage ? Vérifiez les écritures en base et les attentes de stockage. Si l’application ne conserve pas les données, d’autres domaines peuvent servir de point de départ |
| Réseau | Le lien et ses paramètres conviennent-ils au volume entrant ? Vérifiez le débit réel, le temps aller-retour et les retransmissions |
Lorsque vous examinez la communication plus en détail, les paramètres des bibliothèques peuvent apporter d’autres indices. HTTP/2 comporte des fenêtres de contrôle de flux au niveau de chaque flux et de la connexion, qui déterminent la quantité de données supplémentaires que le pair peut envoyer. Si cette marge est faible par rapport au produit bande passante-délai, c’est-à-dire la bande passante multipliée par le temps aller-retour, le débit peut plafonner alors que le lien dispose encore de capacité. Dans ce cas, examinez la bibliothèque et les intermédiaires, en vérifiant la portée du réglage et son coût mémoire lors de l’ajustement.[4]
Mesurer la fraîcheur et l’attente en plus de la réception
Pour commencer à rechercher une accumulation dans l’application, conservez l’abonnement actuel et relevez, sur une même période d’observation, les événements reçus, les événements traités, le nombre d’éléments dans la file et l’attente de l’événement le plus ancien. Si vous ne savez pas où mesurer, utilisez le prompt ci-dessous pour demander à un agent d’examiner le code. En l’absence de file explicite, commencez par la durée entre la réception et la fin de la décision, puis comparez-la à celle d’une version de diagnostic sans traitement coûteux.
Le pseudocode ci-dessous, indépendant du langage et du SDK, montre où placer les mesures. Conservez l’ordre de traitement et le niveau de concurrence actuels lorsque vous ajoutez l’instrumentation au code réel.
text
Lors de la réception des données :
  Augmenter le nombre d’événements reçus de 1
  Enregistrer un horodatage monotone de réception associé à cet événement
  Transmettre l’événement au traitement existant

Lorsque la décision utilisant le même événement est terminée :
  Augmenter le nombre d’événements terminés de 1
  Calculer et agréger le temps écoulé depuis la réception
Lors de la réception des données :
Augmenter le nombre d’événements reçus de 1
Enregistrer un horodatage monotone de réception associé à cet événement
Transmettre l’événement au traitement existant
Lorsque la décision utilisant le même événement est terminée :
Augmenter le nombre d’événements terminés de 1
Calculer et agréger le temps écoulé depuis la réceptionSi la réception et les décisions n’ont pas une relation un pour un, définissez d’abord cette correspondance et l’unité à compter. Regrouper les observations sur un intervalle fixe permet de comparer les résultats sans ajouter un message de journal pour chaque événement.
Pour approfondir le diagnostic, relevez également les octets reçus, le volume de la file en octets, les p50/p95/p99 du temps de traitement, les erreurs et les reconnexions. Le p99 est le seuil auquel 99 % des temps de traitement mesurés sont inférieurs ou égaux. Précisez où chaque mesure est prise. Le trafic de la carte réseau, la taille Protobuf et la taille des objets décodés sont des quantités différentes.
Utilisez une horloge monotone pour les durées sur un même hôte, en distinguant réception, mise en file, sortie de file et fin du traitement. Si le décodage est déjà terminé lors de l’exécution du callback du SDK, la période qui le précède n’est pas mesurée. Pour comparer avec un horodatage de l’émetteur, vérifiez la synchronisation des horloges et le point où cet horodatage est créé. Ne qualifiez pas automatiquement la différence de latence réseau pure.
Si l’attente diminue lorsque le traitement applicatif est retiré sans modifier l’abonnement, c’est un indice qui invite à examiner l’effet de ce traitement. Un travail rapide après le callback ne prouve pas, à lui seul, que les données étaient à jour à leur arrivée.
Vous pouvez aussi comparer les identifiants d’événements avec un flux de référence ayant le même abonnement et le même niveau de commitment, c’est-à-dire le stade de confirmation des données utilisées. Vérifiez que le flux de référence n’accumule pas lui-même de retard. Un écart entre numéros de slot ne prouve pas à lui seul une perte de données et ne correspond pas à un nombre fixe de secondes : certains slots ne contiennent aucun événement correspondant, et des slots peuvent être sautés.[5]
mtr aide à examiner la latence et les réponses le long d’un itinéraire réseau. Une perte sur un seul saut intermédiaire peut simplement venir d’un routeur qui limite ses réponses. Recoupez le comportement jusqu’à la destination avec les retransmissions TCP, les débits effectifs et un autre itinéraire. mtr seul ne permet pas d’établir une saturation de bande passante ou une panne de centre de données.[6]
Un prompt de diagnostic pour votre agent IA
Transmettez le texte suivant à un agent capable de lire le code de votre projet. Commencez par préciser où il s’exécute et à quel moment et de quelle manière il vous semble lent. L’agent peut d’abord examiner, à partir du code, la connexion, l’abonnement et le traitement après réception. Il n’est pas nécessaire de copier des clés API ou des identifiants de connexion dans la conversation.
Si les événements nécessaires ou le retard acceptable ne sont pas encore définis, indiquez qu’ils restent à déterminer. Expliquez avec vos propres mots quelles informations vous souhaitez observer et quelles décisions vous voulez prendre. Considérez les mesures indisponibles comme non mesurées et commencez par ce que vous pouvez examiner maintenant.
text
Examinez si mon client Solana Geyser gRPC pourrait répondre plus vite. En cas de retard, d’accumulation ou de déconnexion, isolez les causes et aidez à les améliorer. Ne déduisez pas que des données à jour sont traitées uniquement parce que la connexion réussit ou que des événements apparaissent dans les journaux. Ne décidez pas à l’avance si la cause se trouve côté client ou côté fournisseur.

1. Établis l’objectif : événements nécessaires, fraîcheur acceptable, exigences d’ordre et de perte de données, filtres d’abonnement, commitment, région du point de terminaison, versions réelles du langage, du SDK et de la bibliothèque gRPC, environnement d’exécution. Examine d’abord le code, les configurations et les fichiers de verrouillage disponibles ; ne demande que les informations manquantes. Laisse explicitement ouvertes les exigences qui ne sont pas encore définies et examine d’abord la situation actuelle. N’affiche aucun secret et masque les données sensibles dans les journaux partagés.

2. Mesure de la réception à la fin du traitement. Donne la priorité à la réception, à la fin du traitement et aux temps d’attente, en commençant par ce qui est mesurable. Relève événements/seconde, octets/seconde, événements traités/seconde, nombre d’éléments et octets de la file, attente de l’événement le plus ancien, p50/p95/p99, erreurs, déconnexions, reconnexions et données supprimées. S’il n’y a pas de file explicite, indique-le et repère les intervalles de traitement que tu peux observer. Précise les points d’observation et les périodes non mesurées. Distingue le trafic de la carte réseau, les octets transmis, la taille Protobuf et les objets décodés. Utilise une horloge monotone pour les durées locales ; vérifie la synchronisation et l’origine des horodatages externes. Ne convertis pas directement un écart entre slots en perte de données ou en durée fixe.

3. Sépare les contraintes de CPU, mémoire, disque et réseau. Examine le CPU par cœur et thread, le temps CPU volé (steal) et les limites CPU, RSS/GC/swap/PSI, l’attente d’E/S, les octets, pertes et erreurs de la carte réseau, les retransmissions TCP et le RTT. Parmi les outils Linux possibles : mpstat, pidstat, vmstat, iostat, sar, ss -ti et /proc/pressure/. Si des outils ou autorisations manquent, indique-le et fournis les commandes minimales nécessaires. Si l’accès à l’hôte est impossible, recherche des informations dans la console d’administration ou l’instrumentation de l’application et indique comme non mesurées les grandeurs indisponibles. N’invente jamais de résultats.

4. Examine les fenêtres HTTP/2 de flux et de connexion, les tampons de réception TCP, les proxys, VPN et sidecars. Consulte la documentation officielle de la version installée du SDK et étudie le produit bande passante-délai. Examine les conversions JSON, les journaux pour chaque événement, les appels synchrones à la base de données ou aux API externes, les tâches bloquantes, les verrous, la création illimitée de tâches et les files sans limite dans la boucle de réception ou autour d’elle. Ne considère pas Rust ou le code asynchrone seuls comme une solution.

5. Si mtr ou un équivalent est disponible, réalise une mesure limitée vers l’hôte réel du point de terminaison. Sur les systèmes compatibles, envisage : mtr --tcp --port <PORT> --report --report-cycles 30 <HOST>. Utilise le port réel au lieu de supposer un port TLS standard. Ne qualifie pas une perte sur un seul saut intermédiaire de panne ; compare le comportement à destination, les retransmissions et les autres itinéraires. N’utilise pas mtr à la place d’une mesure de bande passante.

6. Enregistre une mesure de référence avec l’abonnement actuel et ne change qu’une variable à la fois. Garde le même abonnement lorsque tu compares un chemin de réception minimal à la chaîne incluant le traitement applicatif. Traite les changements de filtres comme une comparaison distincte. Avant de restreindre l’abonnement, relie les données utilisées pour décider aux notifications qui les fournissent et vérifie que les filtres envisagés incluent les événements nécessaires déjà identifiés. Conçois des files bornées et du parallélisme qui préservent l’ordre et l’exhaustivité requis, et précise le comportement en cas de débordement. Ne supprime pas silencieusement des données nécessaires. Conserve les détails complets des erreurs et les échéances de nouvelle tentative ; ne te reconnecte pas pendant une pause imposée.

7. Présente séparément les faits observés, les causes possibles, les hypothèses non testées, les modifications vérifiables et les mesures avant/après. Estime CPU, RAM, bande passante, performances de stockage et emplacement à partir de l’abonnement et des mesures, en prévoyant une marge pour les pointes. N’invente pas d’exigence matérielle universelle et fixe pour Solana. Si nécessaire, propose de comparer des machines ou centres de données avec le même abonnement, SDK et commitment.

Si j’utilise ERPC, lis sa FAQ gRPC actuelle et suis les instructions correspondant au code d’erreur précis :
https://erpc.global/en/faq/grpc/general/
Si ERPC User MCP ou une CLI est connecté, vérifie les opérations et autorisations réellement disponibles. L’accès au compte n’implique pas un accès aux diagnostics de l’hôte. Avant de créer un VPS payant, de modifier un contrat, de mettre à jour la production ou de la redémarrer, présente le coût, l’objectif et la durée du test et obtiens mon accord. Termine d’abord le diagnostic et les améliorations vérifiables.
Examinez si mon client Solana Geyser gRPC pourrait répondre plus vite. En cas de retard, d’accumulation ou de déconnexion, isolez les causes et aidez à les améliorer. Ne déduisez pas que des données à jour sont traitées uniquement parce que la connexion réussit ou que des événements apparaissent dans les journaux. Ne décidez pas à l’avance si la cause se trouve côté client ou côté fournisseur.
1. Établis l’objectif : événements nécessaires, fraîcheur acceptable, exigences d’ordre et de perte de données, filtres d’abonnement, commitment, région du point de terminaison, versions réelles du langage, du SDK et de la bibliothèque gRPC, environnement d’exécution. Examine d’abord le code, les configurations et les fichiers de verrouillage disponibles ; ne demande que les informations manquantes. Laisse explicitement ouvertes les exigences qui ne sont pas encore définies et examine d’abord la situation actuelle. N’affiche aucun secret et masque les données sensibles dans les journaux partagés.
2. Mesure de la réception à la fin du traitement. Donne la priorité à la réception, à la fin du traitement et aux temps d’attente, en commençant par ce qui est mesurable. Relève événements/seconde, octets/seconde, événements traités/seconde, nombre d’éléments et octets de la file, attente de l’événement le plus ancien, p50/p95/p99, erreurs, déconnexions, reconnexions et données supprimées. S’il n’y a pas de file explicite, indique-le et repère les intervalles de traitement que tu peux observer. Précise les points d’observation et les périodes non mesurées. Distingue le trafic de la carte réseau, les octets transmis, la taille Protobuf et les objets décodés. Utilise une horloge monotone pour les durées locales ; vérifie la synchronisation et l’origine des horodatages externes. Ne convertis pas directement un écart entre slots en perte de données ou en durée fixe.
3. Sépare les contraintes de CPU, mémoire, disque et réseau. Examine le CPU par cœur et thread, le temps CPU volé (steal) et les limites CPU, RSS/GC/swap/PSI, l’attente d’E/S, les octets, pertes et erreurs de la carte réseau, les retransmissions TCP et le RTT. Parmi les outils Linux possibles : mpstat, pidstat, vmstat, iostat, sar, ss -ti et /proc/pressure/. Si des outils ou autorisations manquent, indique-le et fournis les commandes minimales nécessaires. Si l’accès à l’hôte est impossible, recherche des informations dans la console d’administration ou l’instrumentation de l’application et indique comme non mesurées les grandeurs indisponibles. N’invente jamais de résultats.
4. Examine les fenêtres HTTP/2 de flux et de connexion, les tampons de réception TCP, les proxys, VPN et sidecars. Consulte la documentation officielle de la version installée du SDK et étudie le produit bande passante-délai. Examine les conversions JSON, les journaux pour chaque événement, les appels synchrones à la base de données ou aux API externes, les tâches bloquantes, les verrous, la création illimitée de tâches et les files sans limite dans la boucle de réception ou autour d’elle. Ne considère pas Rust ou le code asynchrone seuls comme une solution.
5. Si mtr ou un équivalent est disponible, réalise une mesure limitée vers l’hôte réel du point de terminaison. Sur les systèmes compatibles, envisage : mtr --tcp --port <PORT> --report --report-cycles 30 <HOST>. Utilise le port réel au lieu de supposer un port TLS standard. Ne qualifie pas une perte sur un seul saut intermédiaire de panne ; compare le comportement à destination, les retransmissions et les autres itinéraires. N’utilise pas mtr à la place d’une mesure de bande passante.
6. Enregistre une mesure de référence avec l’abonnement actuel et ne change qu’une variable à la fois. Garde le même abonnement lorsque tu compares un chemin de réception minimal à la chaîne incluant le traitement applicatif. Traite les changements de filtres comme une comparaison distincte. Avant de restreindre l’abonnement, relie les données utilisées pour décider aux notifications qui les fournissent et vérifie que les filtres envisagés incluent les événements nécessaires déjà identifiés. Conçois des files bornées et du parallélisme qui préservent l’ordre et l’exhaustivité requis, et précise le comportement en cas de débordement. Ne supprime pas silencieusement des données nécessaires. Conserve les détails complets des erreurs et les échéances de nouvelle tentative ; ne te reconnecte pas pendant une pause imposée.
7. Présente séparément les faits observés, les causes possibles, les hypothèses non testées, les modifications vérifiables et les mesures avant/après. Estime CPU, RAM, bande passante, performances de stockage et emplacement à partir de l’abonnement et des mesures, en prévoyant une marge pour les pointes. N’invente pas d’exigence matérielle universelle et fixe pour Solana. Si nécessaire, propose de comparer des machines ou centres de données avec le même abonnement, SDK et commitment.
Si j’utilise ERPC, lis sa FAQ gRPC actuelle et suis les instructions correspondant au code d’erreur précis :
https://erpc.global/en/faq/grpc/general/
Si ERPC User MCP ou une CLI est connecté, vérifie les opérations et autorisations réellement disponibles. L’accès au compte n’implique pas un accès aux diagnostics de l’hôte. Avant de créer un VPS payant, de modifier un contrat, de mettre à jour la production ou de la redémarrer, présente le coût, l’objectif et la durée du test et obtiens mon accord. Termine d’abord le diagnostic et les améliorations vérifiables.Essayer le même code dans un environnement comparable
Les mesures peuvent révéler des possibilités d’améliorer les ressources CPU ou mémoire, ou le chemin réseau. Un CPU plus puissant, davantage de mémoire, un travail réparti ou un emplacement plus proche de la source sont des options possibles. Relier ces choix au volume de données de votre application et aux observations rend plus clairs la raison de les essayer et l’effet à vérifier.
ERPC VPS est une possibilité pour exécuter des clients de streaming près de l’infrastructure Solana. La facturation horaire permet de comparer le même code et le même abonnement avec votre environnement actuel. Consultez les tarifs, régions et disponibilités du moment dans le Dashboard. Chez ERPC aussi, les ressources nécessaires dépendent de votre abonnement et du traitement applicatif.[7]
Comparez l’augmentation de la file, la fraîcheur à la fin du traitement, le p99 et les erreurs, en plus du débit de réception. Notez la période de mesure et la charge de la blockchain. Des comparaisons simultanées ou des mesures répétées aident à ne pas confondre les variations du trafic dans le temps avec les différences entre environnements.
Pour contacter l’assistance, transmettez vos paramètres d’abonnement après masquage des informations sensibles, la version du SDK, la région, les horodatages, les messages d’erreur complets et les mesures dont vous disposez. Vous pouvez indiquer comme non mesurées les valeurs que vous n’avez pas encore obtenues.
Chaque observation supplémentaire facilite le choix de la prochaine modification à essayer. Conservez les données nécessaires et vérifiez les améliorations étape par étape. Nous continuerons à améliorer les informations et l’infrastructure qui soutiennent votre développement.
Références et liens utiles
- [1] gRPC Flow Control : https://grpc.io/docs/guides/flow-control/
- [2] Spécification des abonnements Yellowstone gRPC : https://github.com/rpcpool/yellowstone-grpc/blob/master/README.md
- [3] Tokio: CPU-bound tasks and blocking code: https://docs.rs/tokio/latest/tokio/index.html#cpu-bound-tasks-and-blocking-code
- [4] Contrôle de flux HTTP/2 : https://www.rfc-editor.org/rfc/rfc9113.html#section-5.2
- [5] Terminologie Solana : https://solana.com/docs/references/terminology
- [6] Documentation officielle de mtr : https://github.com/traviscross/mtr
- [7] ERPC VPS : https://erpc.global/fr/vps/
- Linux PSI : https://docs.kernel.org/accounting/psi.html
- API de mesure de Node.js : https://nodejs.org/api/perf_hooks.html
- FAQ gRPC d’ERPC : https://erpc.global/fr/faq/grpc/general/
- ERPC Web Dashboard : https://dashboard.erpc.global/fr/
- Discord officiel de Validators DAO : https://discord.gg/C7ZQSrCkYR


