Solana एप्लिकेशन को धीमा करने वाले दस भ्रम: तेज़ सेटअप भी धीमा क्यों पड़ सकता है
आपका कनेक्शन तेज़ है। CPU आधुनिक है। सर्वर डेटा प्रदाता वाले शहर में ही है। फिर भी एप्लिकेशन ज़रूरी जानकारी पर देर से प्रतिक्रिया देता है। कनेक्शन खुला रहता है, लेकिन प्रोसेस हो रहा डेटा लगातार पीछे छूटता जाता है।
Solana पर कम लेटेंसी वाले एप्लिकेशन बनाते समय इस स्थिति का हमेशा एक ही कारण नहीं होता। नेटवर्क रूटिंग, रिसीव सेटिंग्स, सब्सक्राइब किया गया डेटा और एप्लिकेशन के अंदर का इंतज़ार मिलकर आपके चुने हुए तेज़ इंफ्रास्ट्रक्चर का पूरा लाभ मिलने से रोक सकते हैं।
ELSOUL LABO B.V. द्वारा संचालित ERPC में हमारी सपोर्ट टीम को रुके हुए रिसीव लूप, क्लाइंट सेटिंग्स, अनावश्यक रूप से व्यापक सब्सक्रिप्शन और मूल त्रुटि सुलझाए बिना दोबारा कनेक्ट करने की कोशिशों से जुड़े सवाल बार-बार मिलते हैं। सामान्य वेब एप्लिकेशन में जिन विकल्पों से खास समस्या नहीं हुई, वे हाई-फ़्रीक्वेंसी ट्रेडिंग और रियल-टाइम प्रोसेसिंग में बाधा बन सकते हैं।
यह लेख इन समस्याओं के पीछे के दस भ्रमों को समझाता है। उद्देश्य है कि आप इंफ्रास्ट्रक्चर के चुनाव के साथ उस डिज़ाइन का भी आकलन कर सकें, जो उसकी क्षमता को निर्णय और ट्रांज़ैक्शन सबमिट करने तक पहुँचाता है।
यह मार्गदर्शिका उन डेवलपर के लिए है जिन्हें वेब एप्लिकेशन बनाने का अनुभव है और जो Solana पर हाई-फ़्रीक्वेंसी ट्रेडिंग (HFT) या अन्य रियल-टाइम एप्लिकेशन बनाना शुरू कर रहे हैं। इसमें वातावरण चुनने और शुरुआती जाँच करने के तरीके दिए गए हैं। यहाँ सब्सक्रिप्शन का अर्थ है यह चुनना कि एप्लिकेशन को कौन-से डेटा अपडेट लगातार मिलेंगे।
पहले तय करें कि कौन-सा काम जल्दी पूरा होना चाहिए
नेटवर्क का राउंड-ट्रिप समय, डेटा आने का समय, निर्णय में लगने वाला समय और ट्रांज़ैक्शन कन्फ़र्म होने का समय अलग-अलग माप हैं। डेटा मिलने के बाद प्रोसेसिंग अटक जाए तो तेज़ ping भी निर्णय को जल्दी नहीं करा सकता। RPC का तुरंत जवाब देना भी ज़रूरी नहीं कि ट्रांज़ैक्शन निष्पादित हो चुका हो।
उदाहरण के लिए, ऐसे एप्लिकेशन पर विचार करें जो बाज़ार की स्थिति का अपडेट प्राप्त करता है, अपनी शर्तों की दोबारा गणना करता है और शर्तें पूरी होने पर ट्रांज़ैक्शन भेजता है। अपडेट आने तक का समय, गणना पूरी होने तक का समय और भेजे गए ट्रांज़ैक्शन का परिणाम सत्यापित करने तक का समय अलग-अलग रखें। कौन-सा समय कम करना है, यह तय करने से स्पष्ट हो जाता है कि जाँच कहाँ करनी चाहिए।
फिर अवलोकन, प्राप्ति के बाद की प्रोसेसिंग तथा सबमिशन और कन्फ़र्मेशन को अलग-अलग मापें। सुधार की शुरुआत तब होती है जब गति को केवल एक उत्पाद के नाम या एक संख्या तक सीमित नहीं किया जाता।
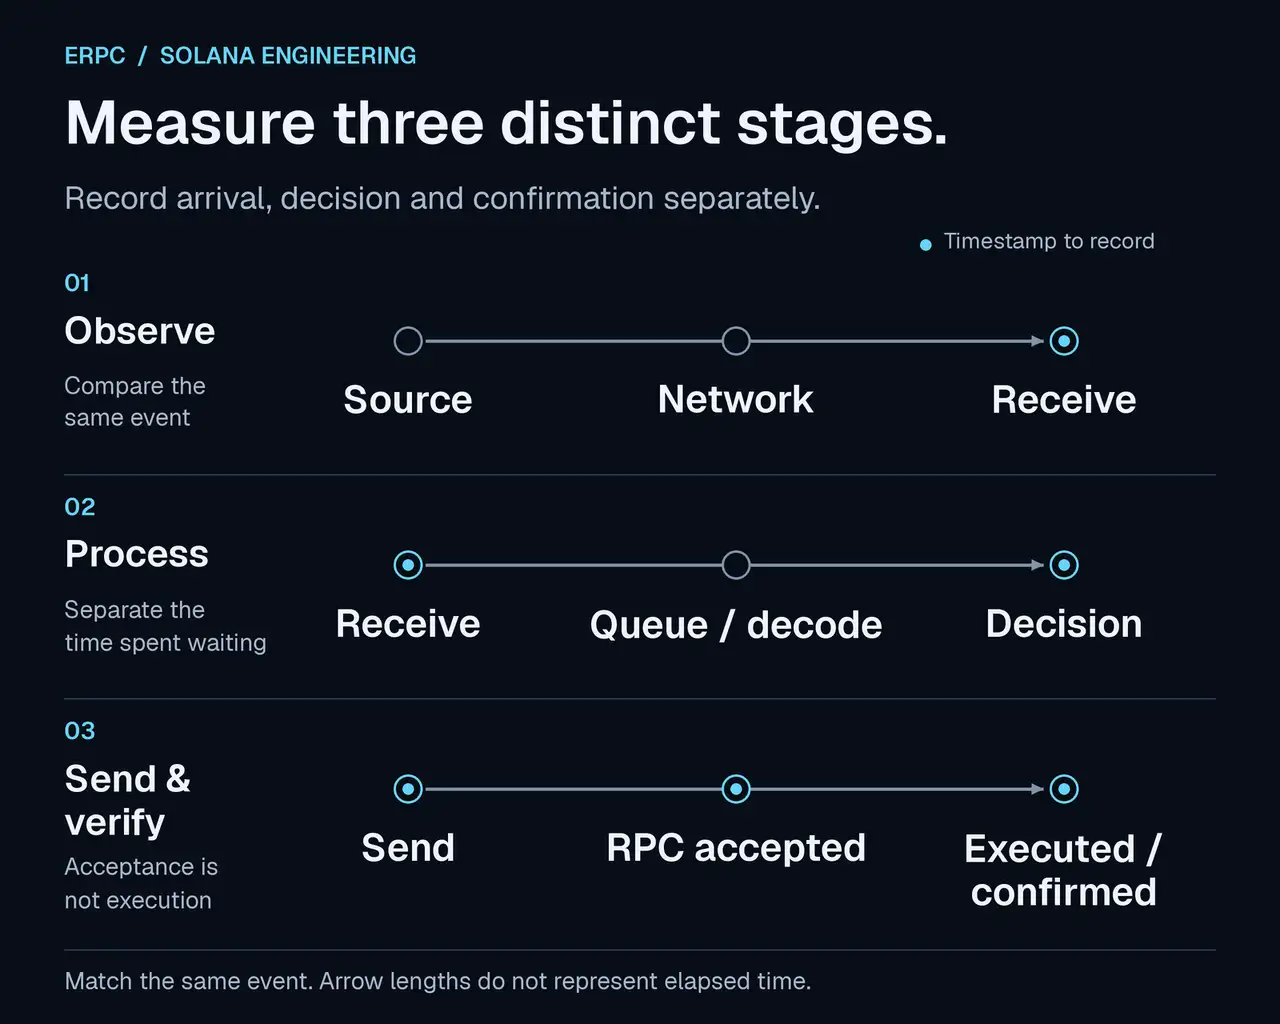
अवलोकन, एप्लिकेशन के अंदर की प्रोसेसिंग तथा सबमिशन और कन्फ़र्मेशन को अलग-अलग मापें। यह आरेख चरणों की वास्तविक मापी गई अवधि या उनके प्रदर्शन में अंतर नहीं दिखाता।
भ्रम 1: छोटी VM पर एप्लिकेशन चल रहा है, इसलिए क्षमता पर्याप्त है
किसी पुराने वेब एप्लिकेशन या Ethereum वर्कलोड के लिए छोटी क्लाउड VM अच्छी चली थी। इस अनुभव से लग सकता है कि वही कॉन्फ़िगरेशन Solana स्ट्रीम भी संभाल लेगा। लेकिन कभी-कभी RPC क्वेरी करने वाले एप्लिकेशन और लगातार व्यापक अपडेट प्राप्त करके प्रोसेस करने वाले एप्लिकेशन की संसाधन ज़रूरतें अलग होती हैं।
डेटा की मात्रा, आने की दर, प्रत्येक इवेंट के काम और स्वीकार्य लेटेंसी के अनुसार क्षमता चुनें। हर सेकंड कितने इवेंट आते हैं? कितने बाइट ट्रांसफ़र होते हैं? डिकोडिंग और निर्णय में कितना CPU समय और मेमोरी लगती है? सामान्य ट्रैफ़िक के साथ अचानक आने वाले उछाल को संभालने के लिए भी गुंजाइश रखें। एक ही चेन पर भी सब्सक्रिप्शन का दायरा और कार्यान्वयन आवश्यकताओं को बदल देते हैं।
मुश्किल यह है कि कम संसाधनों वाला एप्लिकेशन भी काम करता हुआ दिखाई दे सकता है। स्क्रीन पर डेटा लगातार आता रहे, लेकिन वह अधिक पुराना होता जाए; या दोबारा कनेक्ट होने के दौरान आए अंतराल का पता ही न चले। केवल प्राप्त इवेंट की संख्या से यह स्पष्ट नहीं होता। पूरी तरह प्रोसेस किए गए इवेंट की संख्या, लंबित डेटा कितना पुराना है और आपके सब्सक्रिप्शन में आने चाहिए ऐसे इवेंट की निरंतरता भी जाँचें।
यदि पुराने अनुभव को ही आधार माना जाए, तो डेवलपर रिसीव करने वाले पक्ष की क्षमता पर कभी सवाल न उठाकर डेटा एंडपॉइंट को ही दोष देते रह सकते हैं। अधिक गुंजाइश वाला वातावरण आज़माने पर पहले अनदेखा रहा बैकलॉग (मिल चुका लेकिन अभी प्रोसेस न हुआ डेटा) या डेटा का छूटना सामने आ सकता है।
जाँच के लिए उसी एंडपॉइंट, सब्सक्रिप्शन, commitment (डेटा की अनुरोधित पुष्टि अवस्था; भ्रम 9 में समझाया गया है), SDK और सेटिंग्स तथा उसी प्रोसेसिंग वर्कलोड को अधिक क्षमता वाले रिसीव और प्रोसेस वातावरण पर चलाकर तुलना करें। रीजन समान रखें, CPU, मेमोरी और नेटवर्क के अंतर दर्ज करें तथा प्राप्ति की दर, पूरा हुआ काम, बैकलॉग, छूटे इवेंट और निर्णय तक का समय मापें। वर्कलोड समय के साथ बदलता है, इसलिए संभव हो तो समान अवधि में तुलना करें, लेकिन कनेक्शन सीमाओं और सेवा पर पड़ने वाले भार का ध्यान रखें।
वातावरण बदलने के बाद सुधार दिखे तो इसका अर्थ है कि प्राप्ति या प्रोसेसिंग की परिस्थितियों का परिणाम में योगदान था। यदि CPU, मेमोरी और नेटवर्क साथ बदले हैं, तो किस संसाधन से फर्क पड़ा यह जानने के लिए और जाँच चाहिए। वास्तव में संभाले जाने वाले डेटा की मात्रा और दर के अनुसार संसाधन चुनना कम लेटेंसी वाली प्रोसेसिंग की बुनियादी शर्त है।
भ्रम 2: एक ही शहर में होना नेटवर्क पर भी पास होने के बराबर है
“दोनों सर्वर Frankfurt में हैं, इसलिए पास होंगे।” “Tokyo में डिप्लॉय करना जापान के लिए सबसे तेज़ होगा।” शहर के नाम डिप्लॉयमेंट स्थान चुनने में मदद करते हैं, लेकिन ट्रैफ़िक के वास्तविक रास्ते की गारंटी नहीं देते।
रास्ता डेटा सेंटरों के बीच कनेक्शन, नेटवर्क ऑपरेटरों के बीच कनेक्शन और रूटिंग निर्णयों पर निर्भर करता है। एक ही शहर के सर्वर भी बाहरी नेटवर्क के रास्ते घूमकर जुड़ सकते हैं। उदाहरण के लिए, RIPE IPmap अपने उपयोगों में ऐसे अक्षम रास्तों का दृश्यांकन बताता है, जहाँ ट्रैफ़िक किसी देश से बाहर जाकर वापस आता है। [1]
वास्तविक डेटा स्रोत और एप्लिकेशन चलाने वाले होस्ट के बीच RTT, समय के साथ उसका उतार-चढ़ाव, दोबारा भेजे गए या खोए पैकेट तथा समान इवेंट के आने का समय मापें। Traceroute और MTR रास्ते की जाँच में मदद कर सकते हैं, लेकिन केवल हॉप की संख्या से बेहतर मार्ग तय नहीं होता। बीच का राउटर अपने डायग्नोस्टिक जवाब सीमित कर रहा हो तो उसे एप्लिकेशन को प्रभावित करने वाला पैकेट लॉस समझना भी गलत होगा।
रीजन चुनने के बाद एक और सवाल पूछें: यह विशेष डेटा स्रोत और यह विशेष सर्वर वास्तव में कैसे जुड़े हैं? यह अतिरिक्त जाँच वे अंतर दिखाती है जो अकेला शहर का नाम नहीं बता सकता।
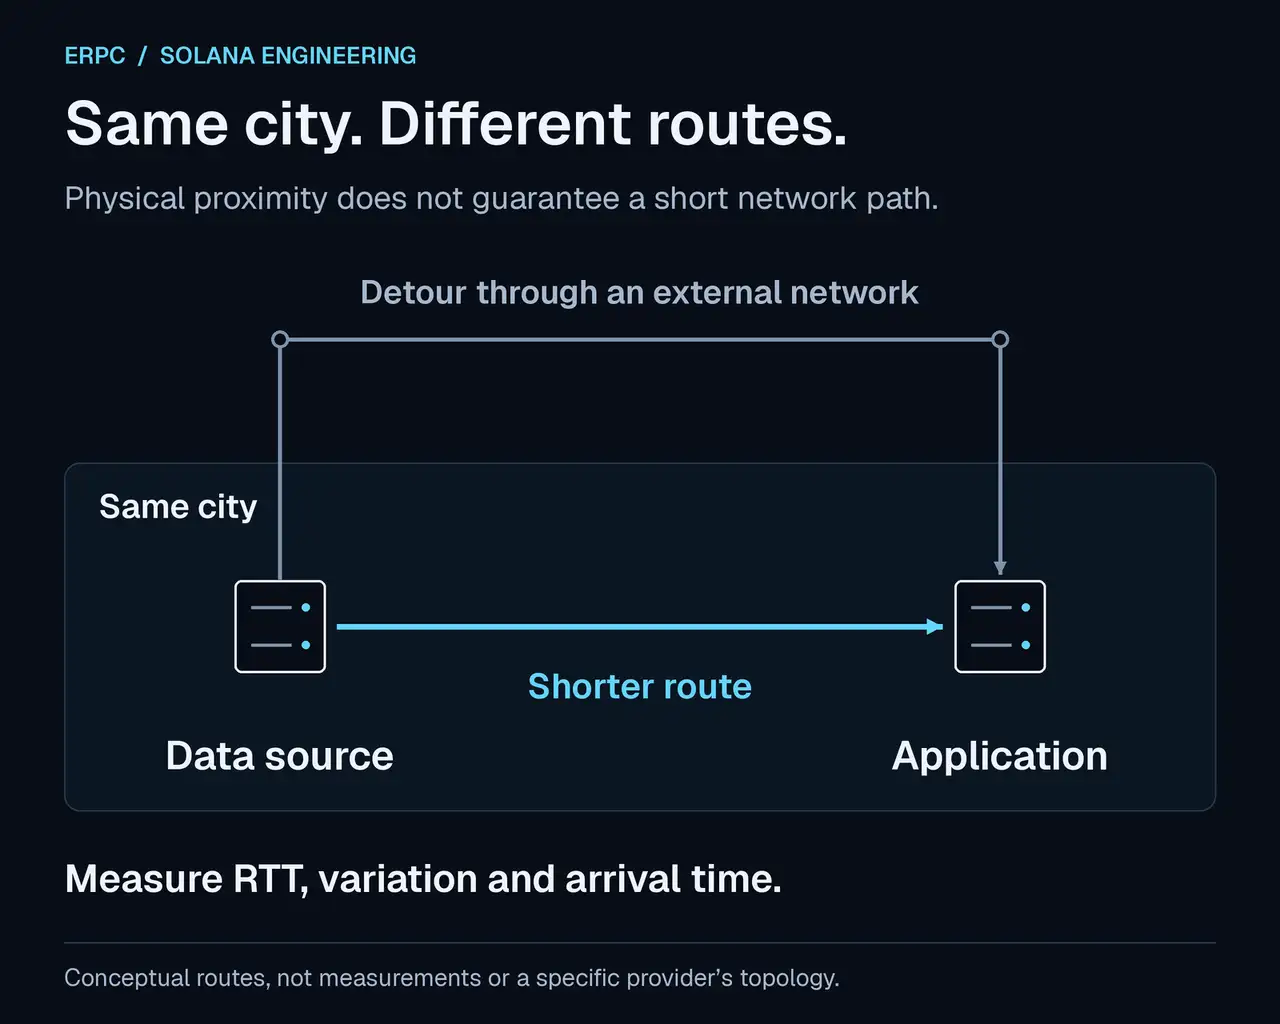
एक ही शहर में स्थित दो सर्वर के रूट और राउंड-ट्रिप समय अलग हो सकते हैं। यह आरेख अवधारणा समझाता है और किसी विशेष प्रदाता का वास्तविक रूट नहीं दिखाता।
भ्रम 3: नेटवर्क के ऊँचे स्पेसिफ़िकेशन का अर्थ पर्याप्त उपयोग योग्य बैंडविड्थ है
सर्वर के स्पेसिफ़िकेशन में बैंडविड्थ के कई अर्थ हो सकते हैं: भौतिक पोर्ट की गति, वर्चुअल मशीन को मिली बैंडविड्थ, लगातार उपलब्ध बैंडविड्थ या कुछ समय के लिए मिलने वाली बर्स्ट सीमा। तेज़ NIC होने से यह सुनिश्चित नहीं होता कि एप्लिकेशन उसकी पूरी क्षमता लगातार इस्तेमाल कर सकेगा।
उदाहरण के लिए, AWS दस्तावेज़ baseline और burst बैंडविड्थ में अंतर बताते हैं तथा ट्रैफ़िक के गंतव्य, फ़्लो और पैकेट दर से जुड़ी सीमाएँ समझाते हैं। यह स्पेसिफ़िकेशन पढ़ने का उदाहरण है; इसका अर्थ नहीं कि हर VPS पर AWS जैसी सीमाएँ हैं। [2]
प्लान चुनते समय देखें कि बैंडविड्थ समर्पित है या साझा, लगातार उपयोग की क्या शर्तें हैं, ट्रांसफ़र सीमा क्या है और क्या अलग गंतव्यों वाले ट्रैफ़िक पर अलग नियम लागू होते हैं। परीक्षण में प्रोडक्शन के लिए तय समान एंडपॉइंट और सब्सक्रिप्शन शर्तों के साथ लगातार ट्रैफ़िक चलाएँ। साथ में रिसीव थ्रूपुट (हर सेकंड वास्तव में मिला डेटा), ड्रॉप, रीट्रांसमिशन और CPU लोड देखें।
छोटे स्पीड टेस्ट में ऊँचा परिणाम यह साबित नहीं करता कि सर्वर प्रोडक्शन स्ट्रीम लगातार प्रोसेस कर पाएगा। वहीं कम रिसीव थ्रूपुट का अर्थ हमेशा बैंडविड्थ की कमी भी नहीं होता। कनेक्शन अपग्रेड करने से पहले रिसीव सेटिंग्स की समस्याओं और प्रोसेसिंग सीमाओं को अलग करके देखें।
भ्रम 4: बेहतर CPU मॉडल, अधिक कोर या ऊँचा अधिकतम GHz एप्लिकेशन को तेज़ बना देता है
CPU की अधिकतम बूस्ट फ़्रीक्वेंसी वह क्लॉक स्पीड नहीं है जिसे वह हर वर्कलोड में बनाए रखता है। वास्तविक व्यवहार बिजली, तापमान, फ़र्मवेयर, फ़्रीक्वेंसी नियंत्रण और अन्य काम पर निर्भर करता है। Linux दस्तावेज़ बताते हैं कि boost सक्षम करना उसके उपयोग की अनुमति देता है; इससे यह सिद्ध नहीं होता कि CPU वास्तव में बूस्ट कर रहा है। [3]
यदि महत्वपूर्ण काम एक ही थ्रेड में केंद्रित है, तो केवल कोर जोड़ने से वह जल्दी पूरा नहीं होगा। कुल CPU उपयोग कम दिख सकता है, जबकि एक कोर या इवेंट लूप पूरी तरह व्यस्त हो। Node.js की आधिकारिक गाइड भी बताती है कि भारी callback दूसरे काम को कैसे इंतज़ार कराता है। [4]
अपने वास्तविक वर्कलोड के दौरान क्लॉक फ़्रीक्वेंसी, तापमान, प्रत्येक कोर का उपयोग और प्रोसेसिंग समय जाँचें। वर्चुअल वातावरण में CPU आवंटन का इंतज़ार करने में लगा समय भी उपयोगी संकेत है। एप्लिकेशन की प्रोफ़ाइल लेकर देखें कि डिकोडिंग, गणना, मेमोरी आवंटन और लॉगिंग में कितना समय लगता है।
CPU क्लॉक प्रदर्शन, संसाधन आवंटन, प्रदर्शन बनाए रखने वाली सेटिंग्स और एप्लिकेशन के कार्यान्वयन को साथ देखकर चुनें। केवल मॉडल नंबरों की तुलना से पूरे एप्लिकेशन की गति तय नहीं हो सकती।
भ्रम 5: gRPC में क्लाइंट की डिफ़ॉल्ट सेटिंग्स पर्याप्त हैं
gRPC कनेक्शन बन जाना यह साबित नहीं करता कि वह आवश्यक मात्रा का डेटा आवश्यक गति से ले सकता है। HTTP/2 में flow control होता है, जिससे रिसीवर सेंडर को बताता है कि वह कितना डेटा स्वीकार कर सकता है। नियंत्रण स्ट्रीम और कनेक्शन दोनों स्तरों पर लागू होता है। इसलिए नेटवर्क लिंक में क्षमता खाली होने पर भी रिसीव विंडो और उसके अपडेट थ्रूपुट सीमित कर सकते हैं। [5][6]
रिसीव विंडो सेंडर को बताती है कि रिसीवर के अगले अपडेट से पहले वह कितना डेटा भेज सकता है। शुरुआती मान, स्वचालित समायोजन और सेटिंग्स की प्राथमिकता SDK और लाइब्रेरी के अनुसार बदलती है। कॉन्फ़िगरेशन फ़ाइल में बड़ी संख्या लिख देना अपेक्षित व्यवहार का प्रमाण नहीं है। स्ट्रीम और कनेक्शन दोनों की सेटिंग्स, adaptive सेटिंग्स के साथ उनका संबंध और उपयोग किए जा रहे संस्करण को जाँचें।
समान सब्सक्रिप्शन शर्तों में वास्तविक रिसीव थ्रूपुट और प्रोसेसिंग बैकलॉग मापते हुए बदलाव करें। प्राप्त संदेश का अधिकतम आकार, TCP रिसीव बफ़र और HTTP/2 रिसीव विंडो अलग सेटिंग्स हैं। Keepalive कनेक्शन के सक्रिय रहने की जाँच करता है; वह प्रोसेसिंग क्षमता या बैंडविड्थ नहीं बढ़ाता।
ERPC gRPC FAQ में उस स्ट्रीम के लिए जाँच के चरण और क्लाइंट कॉन्फ़िगरेशन उदाहरण हैं, जिसका थ्रूपुट स्थिर रहता है लेकिन वह पीछे छूटती जाती है। उदाहरणों से शुरुआत करें, फिर अपने सब्सक्रिप्शन की मात्रा और प्रोसेसिंग क्षमता पर उन्हें सत्यापित करें। किसी कॉन्फ़िगरेशन उदाहरण का उपयोग करने से पहले अपने SDK का नाम और संस्करण दर्ज करें। पता करें कि उस SDK में stream और connection की रिसीव विंडो तथा अपने-आप समायोजन की सेटिंग्स कहाँ हैं, फिर FAQ के उदाहरण से उनका मिलान करें। अलग SDK का उपयोग करने पर पैरामीटर के नाम और मान ज्यों के त्यों कॉपी करने के बजाय, उसकी दस्तावेज़ी जानकारी में संबंधित सेटिंग्स की जाँच करें। [7]
भ्रम 6: हर पूरा ब्लॉक लेने से सबसे जल्दी निर्णय हो सकता है
“पहले सब कुछ ले लो, फिर ज़रूरी चीज़ ढूँढ़ो।” विकास की शुरुआत में यह तरीका समझना आसान है, लेकिन इससे वह काम भी जुड़ जाता है जिसकी निर्णय से पहले आवश्यकता नहीं होती। अनावश्यक डेटा का ट्रांसफ़र, डिकोडिंग, मेमोरी आवंटन और खोज सीमित बैंडविड्थ तथा CPU संसाधन इस्तेमाल करते हैं।
यदि किसी विशेष मार्केट, प्रोग्राम या अकाउंट में बदलाव पर प्रतिक्रिया देनी है, तो पहले निर्णय के लिए आवश्यक इवेंट और फ़ील्ड तय करें। Yellowstone gRPC में ट्रांज़ैक्शन और अकाउंट सब्सक्रिप्शन फ़िल्टर हैं, और अकाउंट डेटा का केवल एक भाग लेने का तरीका भी है। पूरे ब्लॉक की सूचना और अलग-अलग अपडेट की सूचना भी अलग चीज़ें हैं। [8]
मान लें कि आवश्यकता है, “बाज़ार A की स्थिति बदलने पर शर्तों की दोबारा गणना करें।” तब बाज़ार A की पहचान करने वाली जानकारी, गणना में इस्तेमाल होने वाली स्थिति और उस स्थिति को अपडेट करने वाले इवेंट की सूची बनाएँ। आवश्यक डेटा प्रोग्राम के स्पेसिफ़िकेशन पर निर्भर करता है, इसलिए उसे प्राप्त अपडेट से मिलाएँ। सूची के आधार पर सब्सक्रिप्शन का दायरा घटाएँ, फिर जाँचें कि निर्णय के लिए आवश्यक स्थिति पूरी उपलब्ध है।
समान संसाधनों और परिस्थितियों में यदि एक एप्लिकेशन सभी रिकॉर्ड खोलकर खोज पूरी होने की प्रतीक्षा करता है, जबकि दूसरा आवश्यक अपडेट तुरंत प्रोसेस कर सकता है, तो दूसरा वह इंतज़ार बचा लेता है। अधिक केंद्रित प्रतिस्पर्धी का बार-बार पहले प्रतिक्रिया देना केवल नेटवर्क का परिणाम नहीं हो सकता। क्या अनदेखा किया जा सकता है, यह तय करना भी कम लेटेंसी वाले डिज़ाइन का हिस्सा है।
इंडेक्सिंग, ऑडिट, शोध और ऐतिहासिक भंडारण के लिए पूरा डेटा आवश्यक हो सकता है। उस काम के लिए अलग रास्ता बनाएँ। उसे तत्काल निर्णय के रास्ते से अलग रखने पर दोनों की क्षमता और पूर्णता की ज़रूरतों के अनुसार डिज़ाइन किया जा सकता है। लेकिन यह सत्यापित करें कि फ़िल्टरिंग से सही निर्णय के लिए ज़रूरी अपडेट हट नहीं गए हैं। कुछ स्थितियों में बैच प्रोसेसिंग कुल थ्रूपुट बढ़ा सकती है, इसलिए एप्लिकेशन द्वारा सहन किए जा सकने वाले इंतज़ार के अनुसार उसे चुनें।
ERPC की वर्तमान Shared gRPC सेवा में खाली न होने वाले
blocks सब्सक्रिप्शन के लिए Dedicated सेवा चाहिए। किसी खास आवश्यकता के लिए transactions सब्सक्रिप्शन या blocksMeta पर्याप्त हो सकते हैं, लेकिन इनमें से कोई भी पूरे ब्लॉक जैसा डेटा नहीं देता। Dedicated सेवा लेने पर भी उपयुक्त रिसीव-साइड प्रोसेसिंग क्षमता और सब्सक्रिप्शन डिज़ाइन चाहिए। [9]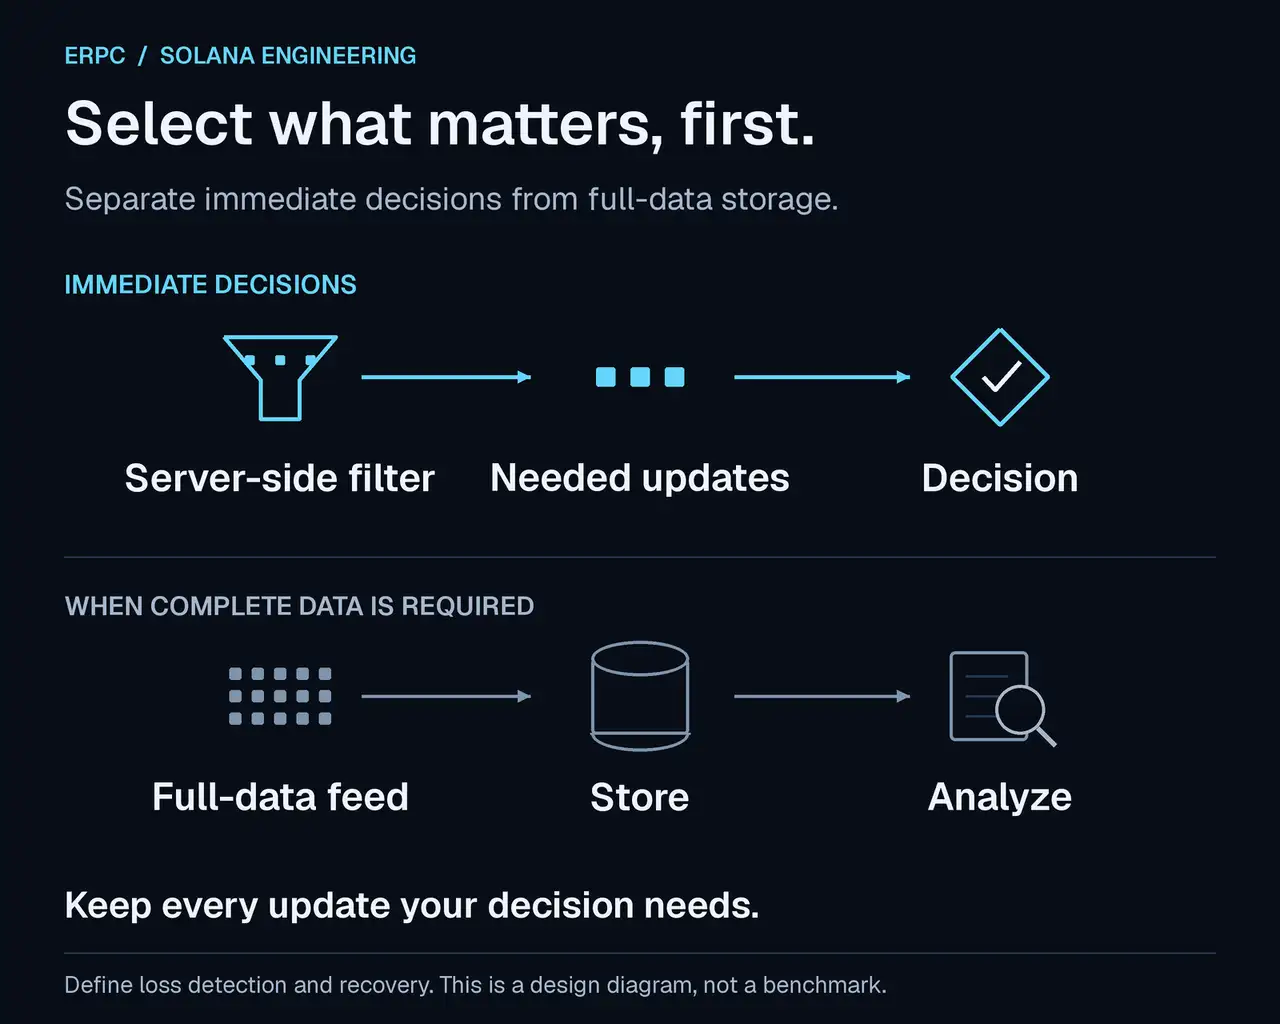
तुरंत निर्णय के लिए आवश्यक अपडेट का एक मार्ग और पूर्ण स्टोरेज तथा विश्लेषण का दूसरा मार्ग रखें। यह आरेख एक आर्किटेक्चर का तरीका समझाता है। जाँचें कि फ़िल्टर लगाने पर सही निर्णय के लिए आवश्यक स्थिति बनी रहे, और डेटा छूटने पर रिकवरी की प्रक्रिया तय करें।
भ्रम 7: डेटा आ रहा है, इसलिए प्रोसेसिंग भी साथ चल रही है
डेटा मिलने और उसे निर्णय के योग्य स्थिति तक प्रोसेस करने के बीच कतार बन सकती है। आने वाला काम लगातार प्रोसेसिंग क्षमता से अधिक हो तो कनेक्शन खुले रहने पर भी देरी बढ़ती रहती है। बड़ा बफ़र अस्थायी उछाल संभाल सकता है, लेकिन लगातार कम पड़ती प्रोसेसिंग क्षमता में वह केवल अधिक पुराना डेटा जमा करता है।
एक काल्पनिक उदाहरण लें जिसमें शुरुआत में कोई काम लंबित नहीं है। एप्लिकेशन हर सेकंड एक ही प्रकार के 12,000 इवेंट प्राप्त करता है और 10,000 इवेंट की प्रोसेसिंग पूरी करता है। यदि वह हर इवेंट को बिना हटाए या मिलाए कतार में रख सकता है, तो लंबित इवेंट की संख्या हर सेकंड 2,000 बढ़ेगी और 10 सेकंड बाद 20,000 हो जाएगी। कनेक्शन सक्रिय रहेगा और डेटा दिखाई देता रहेगा, जबकि निर्णय के लिए आवश्यक काम पीछे छूटता जाएगा। ये संख्याएँ प्रक्रिया समझाने के लिए हैं; ये ERPC के मापे गए प्रदर्शन के आँकड़े नहीं हैं।
सिर्फ़ प्राप्त इवेंट की संख्या न मापें। पूरी हुई प्रोसेसिंग, कतार की लंबाई, सबसे पुराने लंबित आइटम की उम्र और प्राप्ति से निर्णय के अंत तक का समय भी मापें। कनेक्शन की स्थिति और डेटा की ताज़गी अलग-अलग मॉनिटर करें।
रिसीव लूप में केवल वही काम रखें जो प्राप्ति चालू रखने के लिए आवश्यक हो। डेटाबेस में लिखना, पूरा payload लॉग करना, बाहरी API कॉल और भारी गणना को अलग प्रोसेसिंग रास्तों में भेजने पर विचार करें। कतार की क्षमता सीमित रखें और भर जाने पर क्या होगा उसकी नीति तय करें। सीमित कतार भरने पर भी पिछले चरण का काम रुक सकता है; वह अपने आप प्रोसेसिंग क्षमता की कमी दूर नहीं करती। [10]
जिन अपडेट में केवल नवीनतम स्थिति महत्वपूर्ण है, उनमें पुरानी स्थितियों को समेटना संभव हो सकता है। लेकिन जिन ट्रांज़ैक्शन इवेंट को क्रम से या पूरी तरह प्रोसेस करना आवश्यक है, उन्हें मनमाने ढंग से नहीं हटाना चाहिए। एप्लिकेशन की आवश्यकता के अनुसार छूटे हिस्सों का पता लगाने, replay और दोबारा कनेक्ट होने के बाद स्थिति बहाल करने का डिज़ाइन बनाएँ।
ERPC का
STREAM_GUARD_SLOW_READER पर्याप्त लिखने की प्रगति न होने या डेटा डिलीवरी में देरी दिखने पर सुरक्षात्मक प्रतिक्रिया है। केवल इस अवलोकन से कारण तय न करें। कनेक्शन, होस्ट, सब्सक्रिप्शन की मात्रा और एप्लिकेशन की डेटा खपत दर की जाँच करें। दोबारा कनेक्ट होने से पहले उपलब्ध होने पर शुरुआती status, message, metadata और trailers सुरक्षित रखें, फिर सर्वर का दिया कारण और retry की शर्तें पढ़ें। उसी अस्वीकृत अनुरोध को सुधारे बिना दोबारा भेजने पर मूल कारण बना रहता है। [7]भ्रम 8: तेज़ ping या औसत का मतलब महत्वपूर्ण समय पर भी तेज़ एप्लिकेशन है
Ping नेटवर्क के राउंड-ट्रिप समय का संकेत देता है। यह एप्लिकेशन लेटेंसी से अलग अवधि मापता है, जिसमें स्रोत की प्रोसेसिंग, सब्सक्रिप्शन की सामग्री, प्राप्ति का इंतज़ार, डिकोडिंग और निर्णय भी शामिल हैं। औसत कुछ बहुत बड़ी देरी को छिपा भी सकता है।
p50 मध्यिका है। p95 और p99 वे बिंदु हैं जिनसे कम या बराबर क्रमशः 95% और 99% माप होते हैं। p99 अधिकतम मान नहीं है। नमूनों की संख्या और मापन अवधि साथ दें, तथा इवेंट के उछाल के दौरान के परिणाम, अधिकतम मान, टाइमआउट, डिस्कनेक्शन और छूटे डेटा भी देखें। [11]
प्रदाताओं की तुलना करते समय समान इवेंट, डेटा प्रकार, commitment और सब्सक्रिप्शन शर्तों को मिलाएँ। संभव हो तो समान मापन होस्ट पर प्राप्त करें और एप्लिकेशन के अंदर बीता समय मापने के लिए monotonic clock इस्तेमाल करें। अलग होस्ट के timestamps का अंतर निकालते समय घड़ियों का अंतर भी माप को प्रभावित कर सकता है।
केवल सफल इवेंट रखने से बार-बार डेटा खोने वाला कॉन्फ़िगरेशन तेज़ दिखाई दे सकता है। सबसे तेज़ एक परिणाम चुनना और प्रोडक्शन में ज़रूरत के समय कम पीछे छूटने वाला कॉन्फ़िगरेशन चुनना अलग निर्णय हैं।
भ्रम 9: सबसे पहले आया डेटा समान अर्थ और समान पुष्टि स्तर रखता है
Shreds, ट्रांज़ैक्शन सूचनाएँ, अकाउंट अपडेट और ब्लॉक सूचनाएँ एक ही चरण की एक ही जानकारी नहीं हैं। शुरुआती चरण का डेटा उपयोग करने पर एप्लिकेशन को अधिक पुनर्निर्माण या व्याख्या करनी पड़ सकती है। तुलना में केवल प्राप्ति का समय नहीं, बल्कि उस समय क्या ज्ञात हो सकता है, यह भी समान होना चाहिए। [8][12]
Solana के
processed, confirmed और finalized commitment स्तरों में भी अंतर करें। शुरुआती अवलोकन पर निर्णय लेते समय एप्लिकेशन को बाद में कन्फ़र्मेशन स्थिति जाँचनी और आवश्यकता होने पर अपनी स्थिति सुधारनी होगी। जल्दी अपडेट प्राप्त करने और बाहरी सिस्टम में निश्चित कार्रवाई करने की शर्तों को अलग रखें। [13]उदाहरण के लिए, अलग commitment पर आई सूचनाओं की सीधी तुलना करके कहना कि एक कुछ मिलीसेकंड तेज़ है, समान काम की तुलना नहीं है। पहले आवश्यक जानकारी और पुष्टि स्तर तय करें, फिर उन शर्तों में निर्णय लेने योग्य होने तक का समय मापें।
भ्रम 10: सफल सबमिशन का मतलब ट्रांज़ैक्शन सबसे पहले निष्पादित होगा
sendTransaction का सफल जवाब बताता है कि RPC ने ट्रांज़ैक्शन स्वीकार कर लिया है। यह क्लस्टर द्वारा प्रोसेसिंग या कन्फ़र्मेशन की गारंटी नहीं देता। Solana का स्पेसिफ़िकेशन स्पष्ट रूप से signature की स्थिति अलग से जाँचने को कहता है। [14]आने वाली जानकारी से जल्दी निर्णय हो जाए, तब भी सबमिशन का रास्ता, blockhash की वैधता, लिखे जाने वाले अकाउंट पर संसाधन प्रतिस्पर्धा, compute संसाधन, priority fees और ट्रांज़ैक्शन की अपनी सफलता की शर्तें महत्वपूर्ण हैं। SWQoS लीडर की ओर admission और कनेक्शन प्राथमिकता से संबंधित है, जबकि priority fees शेड्यूलिंग की प्राथमिकता प्रभावित करती हैं। दोनों की भूमिकाएँ अलग हैं और कोई भी निष्पादन क्रम या सफलता की बिना शर्त गारंटी नहीं देता। [15][16]
निर्णय पूरा होना, सबमिशन शुरू होना, RPC की स्वीकृति, निष्पादन परिणाम और आवश्यक कन्फ़र्मेशन स्थिति अलग-अलग दर्ज करें। retry करते समय समान signature वाले ट्रांज़ैक्शन को फिर भेजने और नया ट्रांज़ैक्शन बनाने में भी अंतर रखें, ताकि अनचाही दोहरी कार्रवाई न हो।
प्राप्ति से कन्फ़र्मेशन तक पूरे रास्ते को देख सकने पर ही आप पहचान सकते हैं कि कौन-सा सुधार लक्ष्य के करीब ले जाएगा।
सबसे पहले कौन-से माप स्थापित करें
शुरुआत इन तीन जाँचों से करें।
- एक निर्णय चुनें और लिखें कि उसके लिए कौन-से अपडेट आवश्यक हैं तथा निर्णय लेने से पहले कौन-सी स्थिति उपलब्ध होनी चाहिए।
- एक ही मापन अवधि में एक ही प्रकार के प्राप्त इवेंट, जिन इवेंट की प्रोसेसिंग पूरी हो चुकी है, और लंबित इवेंट की संख्या दर्ज करें। यदि काम कतार में है, तो सबसे पुराने लंबित इवेंट को एप्लिकेशन द्वारा प्राप्त किए जाने के बाद बीता समय भी मापें।
- यदि लंबित काम या प्रतीक्षा का समय लगातार बढ़ रहा है, तो पता करें कि काम कहाँ जमा हो रहा है। लक्षणों के अनुसार सब्सक्रिप्शन, प्रोसेसिंग, सेटिंग्स या रनटाइम वातावरण में एक बदलाव चुनें और उससे पहले तथा बाद के परिणामों की तुलना करें।
एप्लिकेशन को डेटा मिलने के बाद से मापा गया समय उसके अंदर के इंतज़ार को दिखाता है। मूल इवेंट होने से लेकर एप्लिकेशन को डेटा मिलने तक की देरी अलग मापें। शुरुआती रिकॉर्ड तैयार होने पर नीचे दी गई तालिका से जाँच का दायरा बढ़ाएँ।
| चरण | क्या दर्ज करें | किस समस्या की पहचान में मदद मिलेगी |
|---|---|---|
| नेटवर्क और प्राप्ति | वास्तविक रिसीव थ्रूपुट, रीट्रांसमिशन व लॉस, समान इवेंट के आगमन का अंतर | रूटिंग, बैंडविड्थ और रिसीव सेटिंग्स की सीमाएँ |
| एप्लिकेशन | प्राप्त और पूरी तरह प्रोसेस हुए इवेंट, कतार की लंबाई, सबसे पुराने आइटम की उम्र | लगातार कम पड़ती प्रोसेसिंग और पुराना डेटा जमा होना |
| निर्णय तक का समय | प्राप्ति से निर्णय पूरा होने तक p50, p95, p99 और अधिकतम समय | अधिक समय या कंप्यूट संसाधन लेने वाला काम और अचानक भार बढ़ने पर देरी |
| सबमिशन और कन्फ़र्मेशन | सबमिशन आरंभ, RPC स्वीकृति, signature स्थिति, निष्पादन त्रुटियाँ | प्राप्ति के बाद की देरी और विफलताएँ |
| तुलना की शर्तें | रीजन, होस्ट, SDK और संस्करण, सब्सक्रिप्शन, commitment, अवधि और नमूनों की संख्या | अलग परिस्थितियों से उत्पन्न दिखावटी अंतर |
आधार माप सुरक्षित रखें, फिर लक्षणों के अनुसार एक समय में एक बदलाव जाँचें: सब्सक्रिप्शन दायरा, प्रोसेसिंग का विभाजन, क्लाइंट सेटिंग्स और स्थान या संसाधन। विंडो बढ़ाने पर मेमोरी उपयोग और बैकलॉग भी जाँचें। सब्सक्रिप्शन सीमित करने पर देखें कि ज़रूरी जानकारी छूटी तो नहीं।
कुल समय का p99 हर चरण के p99 को जोड़कर नहीं निकाला जाता। हर मेल खाते इवेंट के कुल समय से इसे निकालें, और कारण खोजने के लिए चरणवार मापों का उपयोग करें। औसत भार के साथ वास्तविक इवेंट उछाल के दौरान भी परीक्षण करें।
ERPC इंफ्रास्ट्रक्चर तैयार करता है ताकि डेवलपर अपने लॉजिक को बेहतर कर सकें
नेटवर्क, सर्वर, डेटा डिलीवरी और क्लाइंट अलग-अलग चुने जाएँ तो प्रत्येक के अच्छे स्पेसिफ़िकेशन होने पर भी उनके बीच इंतज़ार बच सकता है। ERPC Solana डेटा डिलीवरी और प्रोसेसिंग वातावरण को एक प्लेटफ़ॉर्म पर लाता है, जिससे स्थान और संसाधन हर बार नए सिरे से चुनने का दोहराया जाने वाला काम कम होता है।
SUPER VPS और Premium VPS में हाई-क्लॉक कॉन्फ़िगरेशन और बिना overcommitment के संसाधन आवंटन निर्दिष्ट हैं, जबकि Bare Metal भौतिक रूप से समर्पित मशीन देता है। ERPC नेटवर्क और सर्वर को अपने डिलीवरी वातावरण के करीब रखता है और लगातार प्रोसेसिंग के लिए CPU, मेमोरी, स्टोरेज तथा कनेक्टिविटी तैयार करता है। प्रत्येक प्लान और रीजन के विशिष्ट स्पेसिफ़िकेशन उपलब्ध हैं। [17][18]
| विकास में आम बाधा | ERPC से उपलब्ध इंफ्रास्ट्रक्चर और जानकारी | एप्लिकेशन में क्या बेहतर करें |
|---|---|---|
| शहर के नाम से स्पष्ट न होने वाली दूरी | डेटा डिलीवरी और प्रोसेसिंग वातावरण साथ चुनने वाले रीजन व नेटवर्क कॉन्फ़िगरेशन | अपनी सब्सक्रिप्शन शर्तों में आगमन समय और बदलाव मापें |
| संसाधन प्रतिस्पर्धा और लगातार प्रदर्शन | बिना overcommitment वाले हाई-क्लॉक SUPER VPS व Premium VPS और समर्पित Bare Metal | भारी काम और क्रमिक प्रोसेसिंग पहचानें |
| डेटा मात्रा और कनेक्शन तरीका | gRPC, Shreds, RPC और वर्कलोड के अनुरूप साझा या समर्पित विकल्प | आवश्यक इवेंट और फ़ील्ड तय करें |
| रिसीव सेटिंग्स और समस्या समाधान | Solana Stream SDK, कॉन्फ़िगरेशन उदाहरण, फ़िल्टर दस्तावेज़ और त्रुटि-विशिष्ट FAQ | प्रभावी सेटिंग्स, कतार, री-कनेक्शन और रिकवरी जाँचें |
ERPC इंफ्रास्ट्रक्चर चुनने और ट्यून करने में आगे बढ़ने में मदद करता है, जिससे डेवलपर इस पर अधिक समय लगा सकें कि क्या देखना है, निर्णय के लिए कौन-सी जानकारी लेनी है और कब सबमिट करना है। उपयुक्त सेवा और स्थान के साथ सब्सक्रिप्शन की मात्रा को प्रोसेसिंग क्षमता से मिलाना इंफ्रास्ट्रक्चर के प्रदर्शन को एप्लिकेशन की गति में बदलता है।
पहले तय करें कि निर्णय के लिए वास्तव में कौन-सी जानकारी आवश्यक है। उसे जल्दी प्राप्त करें, अनावश्यक इंतज़ार के बिना प्रोसेस करें और परिणाम सत्यापित करें। इस सुधार को जारी रखने के लिए ERPC वातावरण और जानकारी उपलब्ध कराता रहेगा।
कार्यान्वयन के लिए संसाधन
- ERPC gRPC FAQ: https://erpc.global/hi/faq/grpc/general/
- सब्सक्रिप्शन फ़िल्टर और वर्तमान Shared सीमाएँ: https://erpc.global/hi/doc/geyser-grpc/filter/
- gRPC कार्यान्वयन के सर्वोत्तम तरीके: https://erpc.global/hi/doc/geyser-grpc/best-practices/
- Solana Stream SDK: https://github.com/ValidatorsDAO/solana-stream
- ERPC VPS: https://erpc.global/hi/vps/
- ERPC Bare Metal: https://erpc.global/hi/baremetal/
- ERPC Dashboard: https://dashboard.erpc.global/
- Validators DAO आधिकारिक Discord: https://discord.gg/C7ZQSrCkYR
तकनीकी संदर्भ
- RIPE IPmap, अक्षम रूटिंग का दृश्यांकन: https://ipmap.ripe.net/
- AWS, इंस्टेंस नेटवर्क बैंडविड्थ: https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/ec2-instance-network-bandwidth.html
- Linux Kernel, CPU प्रदर्शन स्केलिंग: https://docs.kernel.org/admin-guide/pm/cpufreq.html
- Node.js, इवेंट लूप को ब्लॉक होने से बचाना: https://nodejs.org/en/learn/asynchronous-work/dont-block-the-event-loop
- IETF RFC 9113, HTTP/2 flow control: https://httpwg.org/specs/rfc9113.html#FlowControl
- gRPC, flow control: https://grpc.io/docs/guides/flow-control/
- ERPC, gRPC FAQ में रिसीव सेटिंग्स, slow reader और retry: https://erpc.global/hi/faq/grpc/general/
- Yellowstone gRPC, सब्सक्रिप्शन और फ़िल्टर स्पेसिफ़िकेशन: https://github.com/rpcpool/yellowstone-grpc
- ERPC, वर्तमान Shared फ़िल्टर नियम: https://erpc.global/hi/doc/geyser-grpc/filter/
- Tokio, कतार और backpressure: https://tokio.rs/tokio/tutorial/channels
- AWS CloudWatch, percentile की परिभाषाएँ: https://docs.aws.amazon.com/AmazonCloudWatch/latest/monitoring/Statistics-definitions.html
- ERPC, Shreds UDP Forwarding: https://erpc.global/hi/doc/shredstream/udp-forwarding/
- Solana, ट्रांज़ैक्शन कन्फ़र्मेशन और समाप्ति: https://solana.com/developers/cookbook/transactions/confirmation
- Solana, sendTransaction: https://solana.com/docs/rpc/http/sendtransaction
- Solana, स्टेक-वेटेड सेवा गुणवत्ता: https://solana.com/docs/defi/stake-weighted-qos
- Solana, ट्रांज़ैक्शन शुल्क: https://solana.com/docs/core/fees
- ERPC, VPS कॉन्फ़िगरेशन और स्पेसिफ़िकेशन: https://erpc.global/hi/vps/
- ERPC, Bare Metal कॉन्फ़िगरेशन और स्पेसिफ़िकेशन: https://erpc.global/hi/baremetal/