








अपने Solana ऐप को और तेज़ बनाएँ: gRPC डेटा की मात्रा, रिसीव प्रोसेसिंग और रनटाइम संसाधनों की समीक्षा करें
आप जो Solana ऐप बना रहे हैं, वह और तेज़ चल सकता है। उसे मिलने वाले डेटा की मात्रा, उसके बाद की प्रोसेसिंग और CPU व नेटवर्क जैसे संसाधन मिलकर काम करते हैं। इस संयोजन की समीक्षा से मौजूदा सॉफ़्टवेयर की क्षमता का बेहतर उपयोग करने में मदद मिल सकती है।
आपने Solana पर HFT का विकास शुरू किया, Geyser gRPC से कनेक्ट हुए और लॉग में डेटा भी दिख रहा है। फिर भी निर्णय उतनी तेज़ी से नहीं हो रहे जितनी उम्मीद थी। डेटा मिलने और निर्णय होने के बीच की प्रतीक्षा, सुधार की जगह खोजने का संकेत दे सकती है। पहले मौजूदा कोड में वे बिंदु ढूँढ़ें जिन्हें देखा और मापा जा सकता है।
ERPC में ग्राहकों से बातचीत और फ़ीडबैक हमें डेटा वितरण, रिसीव सेटिंग और ऐप की प्रोसेसिंग को फिर से देखने के अवसर देते हैं। इनसे मिले विचार हमारी डेटा वितरण सेवा और दस्तावेज़ बेहतर बनाने में काम आते हैं। इस लेख में प्रक्रिया और जाँच के चरण समझाए गए हैं, ताकि पहली बार तेज़ और बड़ी मात्रा वाली डेटा स्ट्रीम सँभालने वाले डेवलपर अपने वातावरण में सुधार के अवसर खोज सकें।
मौजूदा कोड में एक छोटी जाँच से शुरुआत करें
तकनीकी शब्द और निदान command की जानकारी ज़रूरत पड़ने पर ली जा सकती है। यदि आपके पास प्रोजेक्ट का कोड पढ़ सकने वाला AI एजेंट है, तो पहले उसे नीचे दिया छोटा अनुरोध देकर देखें। ऐप कहाँ चलता है और किस समय धीमा लगता है, यह जानकारी जोड़ें। जो आवश्यकताएँ अभी तय नहीं हैं और जो माप उपलब्ध नहीं हैं, उन्हें फिलहाल वैसा ही रखते हुए शुरुआत की जा सकती है।
text
मैं जानना चाहता हूँ कि मेरे Solana ऐप में और तेज़ प्रतिक्रिया देने की गुंजाइश है या नहीं।
पहले मौजूदा कोड पढ़कर डेटा प्राप्त होने का बिंदु और उसी डेटा का उपयोग करने वाला निर्णय पूरा होने का बिंदु पहचानें। सदस्यता की शर्तें बदले बिना, उस अंतराल में इवेंट की संख्या और बीते समय को मापने के लिए सबसे छोटा बदलाव सुझाएँ।
इस पहले काम में माप के बिंदु, प्रस्तावित बदलाव, उससे क्या पता चलेगा और क्या अभी भी नहीं मापा जाएगा, इतना बताना पर्याप्त है। होस्ट का एक्सेस न हो तो ऐप के अंदर जो देखा जा सकता है, उससे शुरू करें। गुप्त जानकारी न दिखाएँ, production में बदलाव न करें और भुगतान वाले संसाधन न बनाएँ।
मैं जानना चाहता हूँ कि मेरे Solana ऐप में और तेज़ प्रतिक्रिया देने की गुंजाइश है या नहीं।
पहले मौजूदा कोड पढ़कर डेटा प्राप्त होने का बिंदु और उसी डेटा का उपयोग करने वाला निर्णय पूरा होने का बिंदु पहचानें। सदस्यता की शर्तें बदले बिना, उस अंतराल में इवेंट की संख्या और बीते समय को मापने के लिए सबसे छोटा बदलाव सुझाएँ।
इस पहले काम में माप के बिंदु, प्रस्तावित बदलाव, उससे क्या पता चलेगा और क्या अभी भी नहीं मापा जाएगा, इतना बताना पर्याप्त है। होस्ट का एक्सेस न हो तो ऐप के अंदर जो देखा जा सकता है, उससे शुरू करें। गुप्त जानकारी न दिखाएँ, production में बदलाव न करें और भुगतान वाले संसाधन न बनाएँ।पहला उपयोगी परिणाम यह जानना है कि अपने कोड में कहाँ और क्या मापना है। जिन अंतरालों को देखा जा सकता है और जो अभी नहीं मापे गए हैं, उन्हें अलग करने से अगली जाँच चुनना आसान होता है। आगे की जाँच के लिए लेख में बाद में एक विस्तृत प्रॉम्प्ट भी दिया गया है।
उदाहरण के लिए, एजेंट ऐसा उत्तर दे सकता है: “डेटा
stream.ts के onData में प्राप्त होता है और निर्णय लेने की प्रक्रिया strategy.ts के onDecisionComplete में पूरी होती है। मैं ऐसा बदलाव सुझाता हूँ जो प्राप्त इवेंट की संख्या, पूरे हुए निर्णयों की संख्या और इस अंतराल में बीते समय को एकत्रित करके सार रूप में दर्ज करे। इस माप के प्रस्ताव में callback से पहले का अंतराल माप के दायरे से बाहर है।” यह एक नमूना उत्तर है, जिसमें TypeScript के काल्पनिक फ़ाइल नाम और फ़ंक्शन नाम इस्तेमाल किए गए हैं। प्रोग्रामिंग भाषा कोई भी हो, जाँचें कि इन तीन बातों में मेल हो: वास्तविक कोड के स्थान, जोड़े जाने वाले रिकॉर्ड और इस माप की सीमाएँ। यदि डेटा प्राप्ति और निर्णय का संबंध एक-से-एक नहीं है, तो एजेंट से उनका संबंध और गिनती की इकाई भी सुझाने को कहें।Web विकास के अनुभव में स्ट्रीम को देखने का नज़रिया जोड़ें
प्रबंधित सेवाओं से डेवलपर हर सर्वर घटक के बारे में सोचे बिना कई Web फ़ीचर बना सकते हैं। Solana स्ट्रीम के साथ काम करते समय भी यह अनुभव आधार बनता है। इसमें यह देखने का नज़रिया जोड़ें कि लगातार कितना डेटा आ रहा है और ऐप उसे कितनी तेज़ी से प्रोसेस कर रहा है।
SDK को Solana से जोड़ना भी उतना ही सरल लग सकता है। लेकिन व्यापक स्तर पर ट्रांज़ैक्शन या अकाउंट अपडेट की सदस्यता लेने पर कार्यभार बदल जाता है। बैंडविड्थ, CPU और मेमोरी की ज़रूरत सदस्यता, संदेश के आकार, कम्प्रेशन, एप्लिकेशन की प्रोसेसिंग और उस समय के ट्रैफ़िक पर निर्भर करती है। “Solana” के लिए मेगाबाइट प्रति सेकंड का कोई एक निश्चित आँकड़ा नहीं है।
शुरुआत इस बात से होती है कि आने वाले काम और उसे प्रोसेस करने की क्षमता के संबंध को डिज़ाइन तथा मापन, दोनों में शामिल किया जाए।
चलती हुई स्ट्रीम में भी कतार बढ़ सकती है
पहले, एक ही सेकंड में आने वाले डेटा की तुलना बराबर आकार के वर्गों से करें। हर वर्ग 1,000 संदेश दिखाता है; हर संदेश को 1 kB मानें, तो कुल 1 MB होता है। कम डेटा वाले उदाहरण में प्रति सेकंड 2 MB और ज़्यादा डेटा वाले उदाहरण में 12 MB मिलते हैं। दोनों में डेटा पाने वाले ऐप की प्रोसेसिंग क्षमता समान है। यह दशमलव इकाइयों में संदेशों के पेलोड की मात्रा समझाने वाला मॉडल है; इसमें संपीड़न और प्रोटोकॉल हेडर शामिल नहीं हैं।
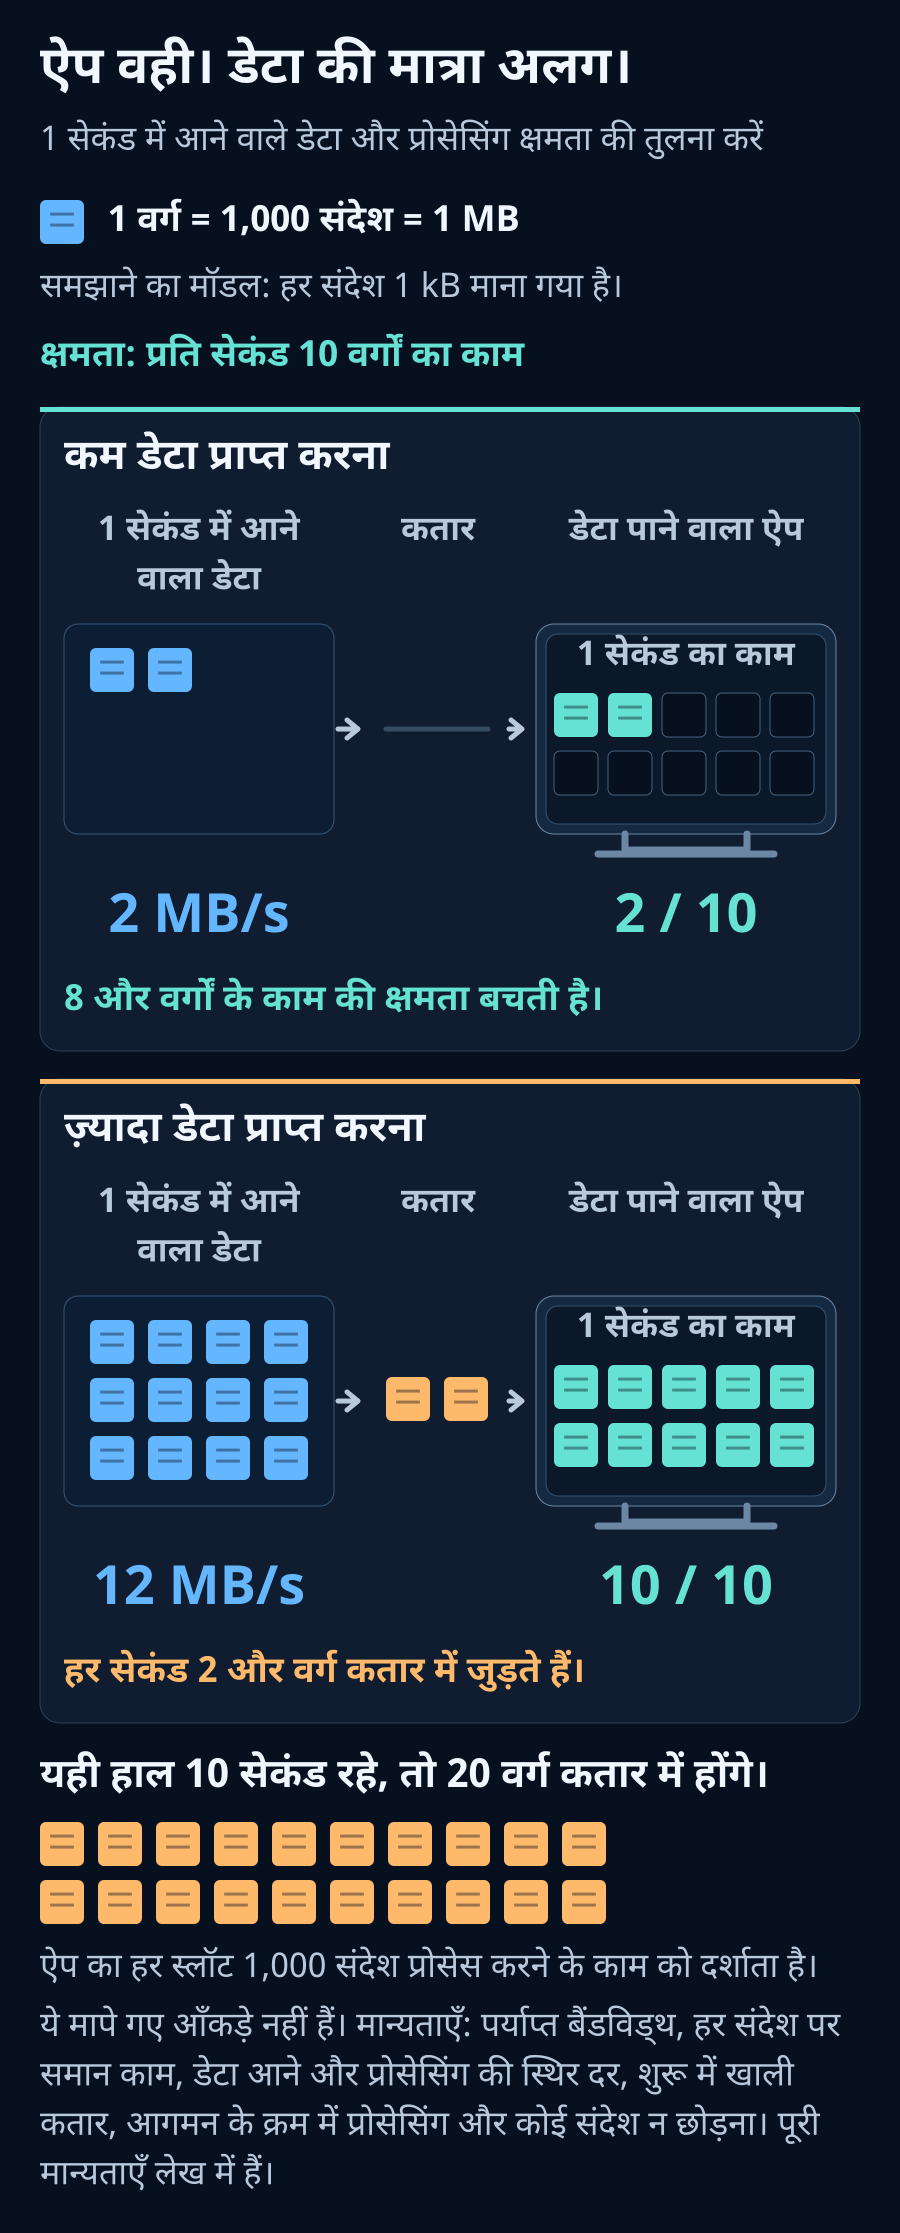
समझने के लिए एक मॉडल लें: हर सेकंड 12,000 इवेंट आते हैं और कंप्यूटर हर सेकंड 10,000 इवेंट प्रोसेस कर सकता है। हर इवेंट में समान काम लगता है, शुरू में कतार खाली है, इवेंट आने के क्रम में प्रोसेस होते हैं और कोई इवेंट छोड़ा नहीं जाता।
हर सेकंड 2,000 और इवेंट बिना प्रोसेस हुए रह जाते हैं। दस सेकंड बाद 20,000 इवेंट इंतज़ार कर रहे होते हैं। उस समय कतार में जुड़ने वाले नए इवेंट को प्रोसेसिंग शुरू होने तक लगभग दो सेकंड इंतज़ार करना पड़ता है। लॉग चलते रहते हैं और कतार भी बढ़ती रहती है।
ये समझाने के लिए मानी गई स्थितियाँ हैं, Solana या ERPC के मापे गए आँकड़े नहीं। मॉडल में आने वाले डेटा की दर और प्रोसेसिंग क्षमता स्थिर मानी गई है। वास्तविक ट्रैफ़िक कभी अचानक बढ़ता है और हर इवेंट की प्रोसेसिंग लागत अलग हो सकती है। इसलिए औसत क्षमता पर्याप्त होने पर भी इंतज़ार हो सकता है।
gRPC का flow control भेजने की दर को इस आधार पर समायोजित करता है कि रिसीवर कितना डेटा स्वीकार कर सकता है। प्रोसेसिंग पीछे रहने पर इंतज़ार एप्लिकेशन की कतार से आगे संचार लाइब्रेरी या भेजने वाले तक फैल सकता है। सक्रिय कनेक्शन या भेजने वाली API में सफल write से यह पता नहीं चलता कि पहुँचने पर डेटा कितना ताज़ा है।[1]
डेटा के नेटवर्क पार करने से पहले ज़रूरी डेटा चुनें
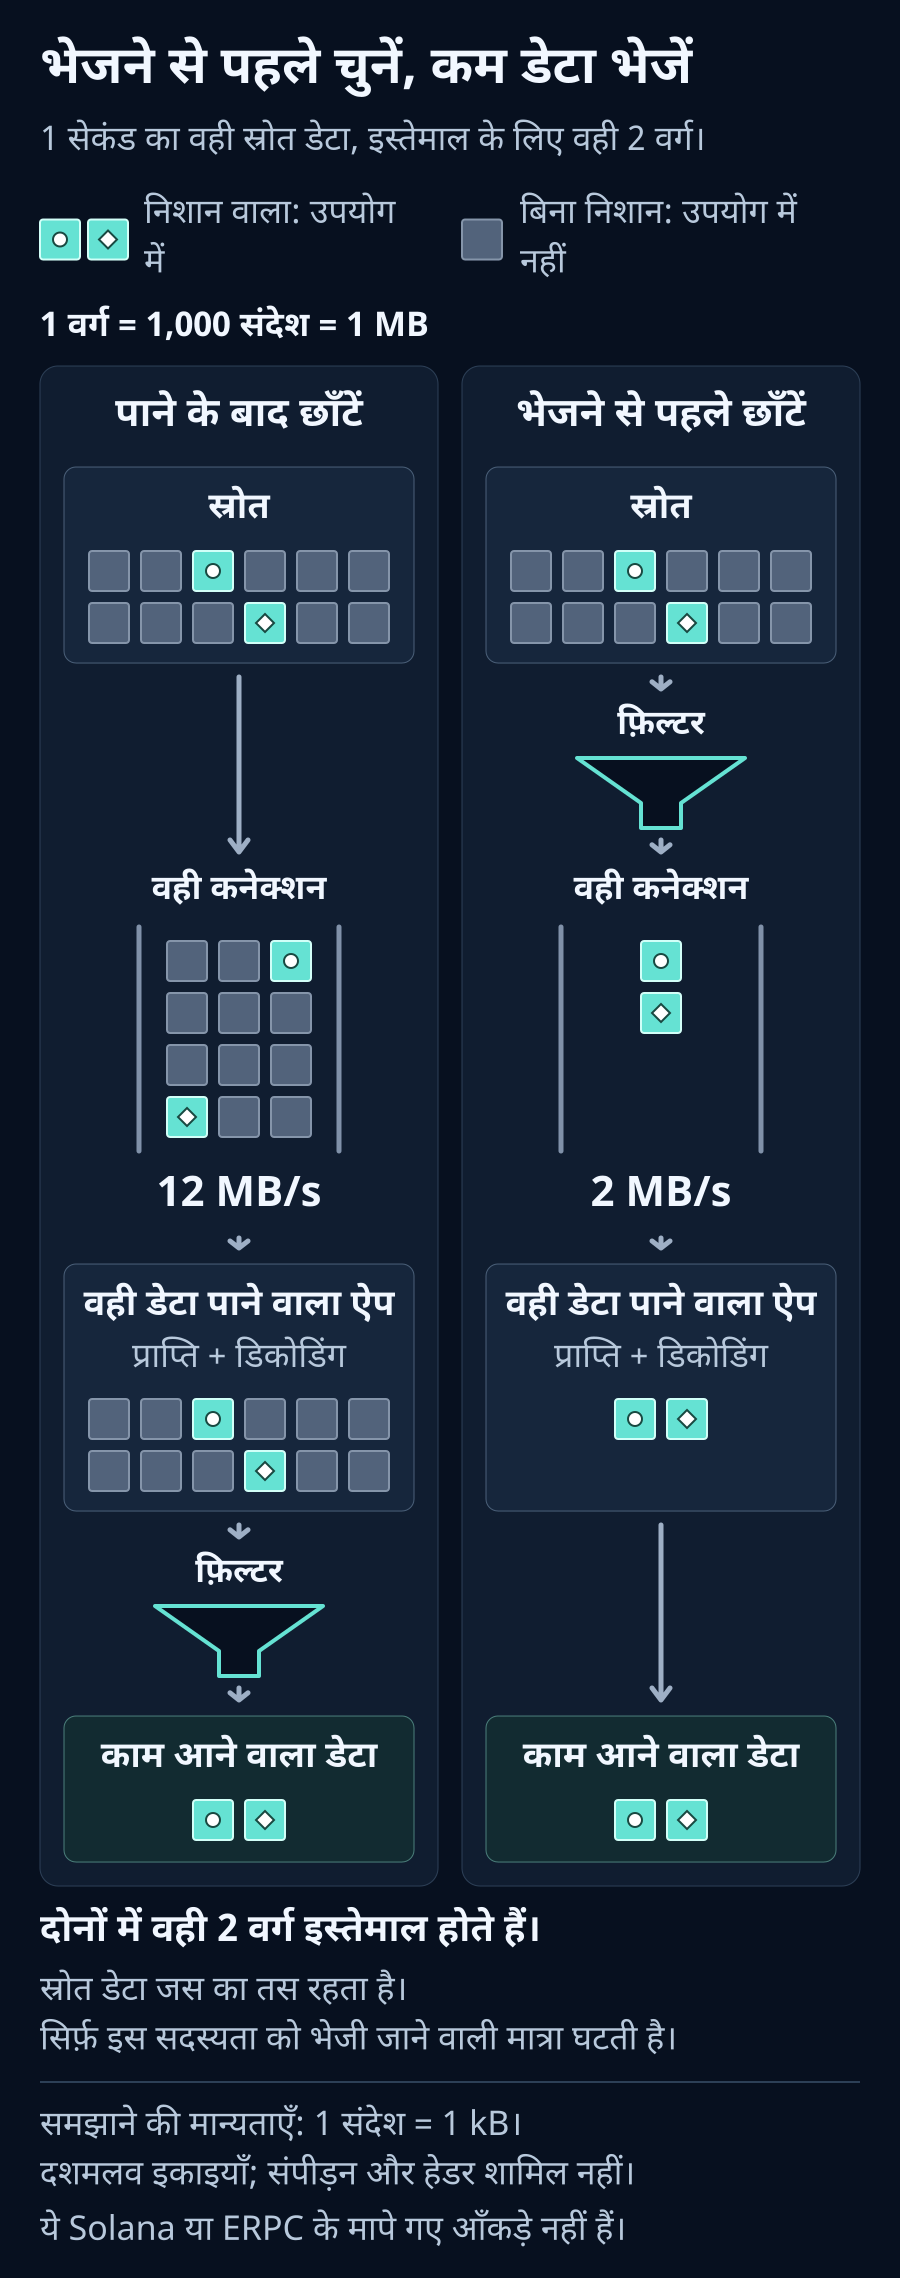
यदि आपके निर्णय के लिए केवल कुछ प्रोग्राम या अकाउंट की जानकारी चाहिए, तो पहले आवश्यक डेटा तय करें और सर्वर पर लागू होने वाले सदस्यता फ़िल्टर इस्तेमाल करें। Yellowstone gRPC ट्रांज़ैक्शन और अकाउंट के लिए फ़िल्टर देता है। शर्तों के सटीक संयोजन और उपलब्ध दायरे को अपनी API, SDK और सेवा की विशिष्टताओं में जाँचें।[2]
यदि तय नहीं कर पा रहे कि क्या फ़िल्टर करें, तो कोड में देखें कि ऐप निर्णय के लिए किन मानों का उपयोग करता है और वे किस नोटिफ़िकेशन के किन फ़ील्ड से मिलते हैं। इस संबंध के आधार पर सदस्यता की संभावित शर्तें बनाएँ, फिर जाँचें कि ज्ञात आवश्यक इवेंट उनमें शामिल हैं। इवेंट की संख्या में कमी और ज़रूरी डेटा का बने रहना, दोनों जाँचने से अगली तुलना के लिए आधार मिलता है।
सब कुछ प्राप्त करने के बाद क्लाइंट में अनावश्यक डेटा छोड़ने पर उस बिंदु तक का ट्रांसफ़र, डिक्रिप्शन और डिकोडिंग का काम पहले ही हो चुका होता है। भेजने वाले पर फ़िल्टर लगाने से यह काम कम किया जा सकता है। ऊपर के उदाहरण में यदि इनपुट केवल ज़रूरी 2,000 इवेंट प्रति सेकंड तक सीमित हो जाए, तो वही 10,000 इवेंट प्रति सेकंड की प्रोसेसिंग क्षमता पर्याप्त गुंजाइश देती है।
सड़क यातायात की कल्पना करें: सड़क की लंबाई सिग्नल के सफ़र की दूरी है, लेन की संख्या बैंडविड्थ है, टोल बूथ रिसीवर की प्रोसेसिंग क्षमता है और गाड़ियों की कतार इंतज़ार करता काम है। उसी टोल बूथ की ओर केवल ज़रूरी गाड़ियाँ भेजने पर बनने वाली कतार, आसपास की सभी गाड़ियाँ वहाँ भेजने से अलग होगी। सड़क को छोटा करना और गाड़ियों की संख्या घटाना दो अलग सुधार हैं।
संचार की भौतिक सीमाएँ भी हैं। 100 MB को 1 Gbps पर भेजने में सैद्धांतिक रूप से कम-से-कम 0.8 सेकंड लगते हैं; 10 Gbps पर 0.08 सेकंड। ये दशमलव इकाइयों से निकाली गई निचली सीमाएँ हैं, जिनमें दूरी, प्रोटोकॉल ओवरहेड, दोबारा भेजना या कतार में प्रतीक्षा शामिल नहीं है। इसका मतलब यह नहीं है कि स्ट्रीम का हर इवेंट 0.8 सेकंड देर से आता है।
एक गणना नेटवर्क पर डेटा के आदान-प्रदान से तेज़ हो, तब भी अनावश्यक डेटा भेजने की लागत समाप्त नहीं होती। सिग्नल की यात्रा का समय, प्रति इकाई समय लिंक से गुजर सकने वाली मात्रा और पहुँचने के बाद पूरा किए जा सकने वाला काम, तीनों पर अलग ध्यान दें।
पूरे इंडेक्स, ऑडिट और शोध जैसे कुछ उपयोगों को सभी डेटा की ज़रूरत होती है। उन्हें उस कार्यभार के अनुरूप रिसीविंग, प्रोसेसिंग और स्टोरेज क्षमता चाहिए। सभी अलग-अलग नोटिफ़िकेशन प्राप्त करना भी पूरे ब्लॉक, यानी ब्लॉक के रूप में एकत्रित और पुनर्निर्मित डेटा, के आने का इंतज़ार करने से अलग है। जाँचें कि आपका निर्णय अनावश्यक रूप से असंबंधित डेटा या एकत्रीकरण पूरा होने पर तो निर्भर नहीं है।[2]
रिसीव प्रोसेसिंग और रनटाइम संसाधनों की समीक्षा करें
Rust प्रोसेसिंग की लागत घटाने में मदद कर सकता है। उस गति का लाभ लेने के लिए आने वाले डेटा की मात्रा, लिंक की वास्तविक बैंडविड्थ, डेटाबेस में लिखे जाने की प्रतीक्षा, लॉक और क्रमिक प्रोसेसिंग वाले हिस्सों को भी देखें। एसिंक्रोनस रनटाइम में CPU पर अधिक काम डालने वाले और थ्रेड को रोकने वाले काम को सिस्टम के उचित हिस्सों में रखना भी ऐप को बेहतर बना सकता है।[3]
रिसीव लूप छोटा रखें और भारी काम अलग करें। कतार की अधिकतम सीमा तथा उसके भरने पर होने वाली कार्रवाई तय करें। बिना सीमा वाली कतार बढ़ती देरी को बढ़ती मेमोरी खपत के रूप में छिपा सकती है। सीमित कतार भी प्रोसेसिंग क्षमता की लगातार कमी को दूर नहीं करती। ज़रूरी क्रम और डेटा की पूर्णता बनाए रखते हुए छोटी सदस्यता, अधिक कुशल प्रोसेसिंग, काम का विभाजन, समानांतर प्रोसेसिंग और अतिरिक्त संसाधनों में से उपयुक्त विकल्प चुनें।
पहले डेटा मिलने से निर्णय पूरा होने तक का समय मापें, फिर जहाँ प्रतीक्षा दिखे उसकी विस्तार से जाँच करें। नीचे की तालिका हर क्षेत्र को देखने का शुरुआती तरीका देती है। विस्तृत metric नाम और command आगे दिए निदान प्रॉम्प्ट में भी हैं, इसलिए ज़रूरत के अनुसार संबंधित चीज़ें इस्तेमाल की जा सकती हैं।
| संसाधन | सबसे पहले क्या जाँचें |
|---|---|
| CPU | क्या काम एक ही कोर पर केंद्रित है? कुल और हर कोर का उपयोग, साथ में execution environment की CPU सीमाएँ देखें |
| मेमोरी | क्या लंबित इवेंट या मेमोरी उपयोग लगातार बढ़ रहे हैं? कतार में डेटा की मात्रा और सबसे पुराने इवेंट की प्रतीक्षा साथ देखें |
| डिस्क और डेटाबेस | क्या डेटा प्राप्ति, स्टोरेज पूरा होने का इंतज़ार कर रही है? डेटाबेस लिखने और स्टोरेज की प्रतीक्षा जाँचें। ऐप डेटा सेव नहीं करता तो दूसरे क्षेत्रों से शुरू किया जा सकता है |
| नेटवर्क | क्या लिंक और उसकी सेटिंग आने वाले डेटा की मात्रा के अनुकूल हैं? वास्तविक ट्रांसफ़र दर, आने-जाने में लगने वाला समय और दोबारा भेजे जाने वाले डेटा की जाँच करें |
संचार की और गहराई से जाँच करते समय library की सेटिंग भी संकेत दे सकती हैं। HTTP/2 में stream और connection, दोनों स्तरों पर flow-control window होती है, जो नियंत्रित करती है कि दूसरा पक्ष कितना और डेटा भेज सकता है। यदि यह अनुमति bandwidth-delay product, यानी बैंडविड्थ और आने-जाने में लगने वाले समय के गुणनफल, के मुकाबले छोटी है, तो लिंक में क्षमता बची होने पर भी throughput एक सीमा पर रुक सकता है। जहाँ यह स्थिति लागू हो, वहाँ library और बीच के घटकों की जाँच करें तथा सेटिंग बदलते समय उसका दायरा और मेमोरी लागत समझें।[4]
प्राप्त डेटा के साथ उसकी ताज़गी और प्रतीक्षा भी मापें
एप्लिकेशन के भीतर जमा होते काम की जाँच शुरू करने के लिए वर्तमान सदस्यता बनाए रखें और एक ही निरीक्षण अवधि में प्राप्त इवेंट, पूरे हुए इवेंट, कतार में इवेंट की संख्या और सबसे पुराने इवेंट का प्रतीक्षा समय दर्ज करें। माप कहाँ लेना है यह न पता हो, तो नीचे के प्रॉम्प्ट से एजेंट को कोड जाँचने दें। स्पष्ट कतार न हो तो प्राप्ति से निर्णय पूरा होने तक के समय से शुरू करें और इसकी तुलना भारी प्रोसेसिंग हटाए गए निदान संस्करण से करें।
नीचे का pseudocode किसी खास भाषा या SDK पर निर्भर नहीं है और दिखाता है कि माप कहाँ जोड़े जाने चाहिए। वास्तविक कोड में माप जोड़ते समय मौजूदा प्रोसेसिंग क्रम और समवर्ती प्रोसेसिंग को बनाए रखें।
text
डेटा प्राप्त होने पर:
  प्राप्त इवेंट की गिनती में 1 जोड़ें
  उस इवेंट से जुड़ा प्राप्ति समय monotonic clock से दर्ज करें
  उसे मौजूदा प्रोसेसिंग में भेजें

उसी इवेंट का उपयोग करने वाला निर्णय पूरा होने पर:
  पूरे हुए इवेंट की गिनती में 1 जोड़ें
  प्राप्ति से बीता समय निकालें और उसका समेकन करें
डेटा प्राप्त होने पर:
प्राप्त इवेंट की गिनती में 1 जोड़ें
उस इवेंट से जुड़ा प्राप्ति समय monotonic clock से दर्ज करें
उसे मौजूदा प्रोसेसिंग में भेजें
उसी इवेंट का उपयोग करने वाला निर्णय पूरा होने पर:
पूरे हुए इवेंट की गिनती में 1 जोड़ें
प्राप्ति से बीता समय निकालें और उसका समेकन करेंयदि डेटा प्राप्ति और निर्णयों का एक-से-एक संबंध नहीं है, तो पहले उनका संबंध और गिनती की इकाई तय करें। निश्चित अंतराल पर प्रेक्षणों को एकत्र करने से हर इवेंट के लिए नया लॉग संदेश जोड़े बिना परिणामों की तुलना की जा सकती है।
आगे की जाँच में प्राप्त bytes, कतार के bytes, प्रोसेसिंग समय के p50/p95/p99, त्रुटियाँ और दोबारा कनेक्शन भी दर्ज करें। p99 वह सीमा है जिसके बराबर या उससे कम 99% मापे गए प्रोसेसिंग समय होते हैं। हर माप कहाँ लिया गया है, यह बताएँ। NIC ट्रैफ़िक, Protobuf का आकार और डिकोड किए गए object का आकार अलग-अलग मात्राएँ हैं।
एक ही host के भीतर बीते समय को मापने के लिए monotonic clock इस्तेमाल करें और प्राप्ति, कतार में डालना, कतार से निकालना तथा काम पूरा होना अलग मापें। यदि SDK का callback चलने से पहले डिकोडिंग पूरी हो चुकी है, तो callback से पहले का समय मापा नहीं गया है। भेजने वाले के timestamp से तुलना करते समय घड़ियों का समन्वय और timestamp बनने का स्थान जाँचें। अंतर को अपने-आप केवल नेटवर्क की देरी न कहें।
यदि सदस्यता बदले बिना एप्लिकेशन की काम-संबंधी प्रोसेसिंग हटाने पर प्रतीक्षा घटती है, तो यह उस प्रोसेसिंग को जोड़ने के प्रभाव की जाँच का संकेत है। केवल callback के बाद काम जल्दी पूरा होने से यह साबित नहीं होता कि डेटा प्राप्त होते समय ताज़ा था।
आप इवेंट की पहचान को समान सदस्यता और commitment (उपयोग किए जा रहे डेटा की पुष्टि का चरण) वाली संदर्भ स्ट्रीम से भी मिला सकते हैं। सुनिश्चित करें कि संदर्भ स्ट्रीम में भी काम जमा नहीं हो रहा। केवल slot संख्या में अंतर डेटा के गायब होने का प्रमाण नहीं है और उसे तय सेकंड में नहीं बदला जा सकता: कुछ slot में फ़िल्टर से मेल खाता इवेंट नहीं होता और slot छोड़े भी जा सकते हैं।[5]
mtr नेटवर्क मार्ग की देरी और जवाब मिलने के तरीके जाँचने में मदद करता है। केवल बीच के किसी hop पर loss दिखना राउटर द्वारा अपने जवाब सीमित करने के कारण भी हो सकता है। गंतव्य तक के व्यवहार को TCP retransmission, वास्तविक ट्रांसफ़र दर और दूसरे मार्ग से तुलना के साथ देखें। अकेला mtr बैंडविड्थ समाप्त होने या डेटा सेंटर में खराबी का प्रमाण नहीं दे सकता।[6]
अपने AI एजेंट के लिए निदान प्रॉम्प्ट
नीचे का पाठ ऐसे एजेंट को दें जो आपके प्रोजेक्ट का कोड पढ़ सके। शुरुआत में बताएँ कि कोड कहाँ चलता है और किस स्थिति में क्या धीमा लगता है। एजेंट पहले कोड से कनेक्शन, सदस्यता और डेटा प्राप्त होने के बाद की प्रोसेसिंग जाँच सकता है। API key या credentials बातचीत में चिपकाने की ज़रूरत नहीं है।
यदि आवश्यक इवेंट या स्वीकार्य देरी अभी तय नहीं है, तो उसे अनिर्धारित बता सकते हैं। अपने शब्दों में समझाएँ कि आप कौन-सी जानकारी देखना चाहते हैं और क्या निर्णय लेना चाहते हैं। जो माप उपलब्ध नहीं हैं, उन्हें न मापा गया मानें और अभी जो जाँचा जा सकता है, उससे शुरुआत करें।
text
जाँचें कि मेरे Solana Geyser gRPC क्लाइंट में और तेज़ प्रतिक्रिया देने की गुंजाइश है या नहीं। यदि देरी, जमा होता काम या कनेक्शन टूटने की समस्या है, तो उनके कारण अलग करें और सुधार में मदद करें। केवल कनेक्शन सफल होने या लॉग में इवेंट दिखने से यह न मानें कि ताज़ा डेटा प्रोसेस हो रहा है। पहले से यह भी तय न करें कि कारण क्लाइंट या प्रदाता में से किस तरफ है।

1. उद्देश्य स्पष्ट करें: आवश्यक इवेंट, स्वीकार्य ताज़गी, क्रम और डेटा हानि की शर्तें, सदस्यता फ़िल्टर, commitment, endpoint का क्षेत्र, भाषा/SDK/gRPC लाइब्रेरी के वास्तविक संस्करण और रनटाइम वातावरण। पहले उपलब्ध कोड, configuration और lockfile पढ़ें; केवल अनुपलब्ध जानकारी पूछें। जो शर्तें अभी तय नहीं हुई हैं, उन्हें स्पष्ट रूप से अनिर्धारित रखें और पहले वर्तमान स्थिति की जाँच करें। रहस्य या गोपनीय जानकारी न दिखाएँ और साझा लॉग में संवेदनशील जानकारी छिपाएँ।

2. प्राप्ति से काम पूरा होने तक मापें। शुरुआत में प्राप्ति, प्रोसेसिंग पूरी होने और प्रतीक्षा समय को प्राथमिकता दें तथा जो मापा जा सकता है, उससे शुरू करें। events/second, bytes/second, पूरे हुए events/second, कतार में इवेंट की संख्या/bytes/सबसे पुराने इवेंट का इंतज़ार, p50/p95/p99, त्रुटियाँ, कनेक्शन टूटना, दोबारा कनेक्शन और drops दर्ज करें। स्पष्ट कतार न हो तो यह बताएँ और प्रोसेसिंग के वे समय-अंतराल पहचानें जिन्हें देखा जा सकता है। निरीक्षण के स्थान तथा न मापे गए समय-अंतराल बताएँ। NIC ट्रैफ़िक, नेटवर्क पर भेजे गए bytes, Protobuf आकार और डिकोड किए गए object में अंतर रखें। स्थानीय बीते समय के लिए monotonic clock इस्तेमाल करें; बाहरी समय के लिए समन्वय और timestamp का मूल स्थान जाँचें। slot के अंतर को सीधे डेटा हानि या किसी निश्चित अवधि में न बदलें।

3. CPU, मेमोरी, डिस्क और नेटवर्क की सीमाएँ अलग करें। हर core/thread का CPU, steal और CPU सीमा, RSS/GC/swap/PSI, I/O प्रतीक्षा, NIC bytes/drops/errors, TCP retransmission और RTT जाँचें। उपयोगी Linux टूल में mpstat, pidstat, vmstat, iostat, sar, ss -ti और /proc/pressure/ शामिल हैं। टूल या अनुमति न हो तो बताएँ और न्यूनतम आवश्यक command दें। यदि host तक पहुँच नहीं है, तो प्रबंधन कंसोल या एप्लिकेशन के भीतर लिए जा सकने वाले मापों से जानकारी खोजें और अनुपलब्ध मात्राओं को न मापा गया चिह्नित करें। परिणाम कभी न गढ़ें।

4. HTTP/2 की stream और connection, दोनों window, TCP receive buffer, proxy, VPN और sidecar जाँचें। इंस्टॉल किए गए SDK संस्करण के आधिकारिक दस्तावेज़ पढ़ें और bandwidth-delay product का संबंध देखें। रिसीव लूप में या उसके आसपास JSON conversion, हर इवेंट की logging, सिंक्रोनस डेटाबेस या बाहरी API call, blocking काम, lock, असीमित task बनाना और बिना सीमा की कतारें जाँचें। केवल Rust या async कोड को समाधान न मानें।

5. mtr या समान टूल उपलब्ध हो तो वास्तविक endpoint host तक सीमित संख्या में माप लें। समर्थित सिस्टम पर यह command विचार में लें: mtr --tcp --port <PORT> --report --report-cycles 30 <HOST>। सामान्य TLS port मान लेने के बजाय वास्तविक port इस्तेमाल करें। केवल बीच के hop पर loss को खराबी न कहें; गंतव्य का व्यवहार, retransmission और दूसरे मार्ग से तुलना करें। mtr को बैंडविड्थ मापन का विकल्प न बनाएँ।

6. वर्तमान सदस्यता में आधार माप दर्ज करें और एक बार में केवल एक चीज़ बदलें। न्यूनतम रिसीविंग पथ और एप्लिकेशन की काम-संबंधी प्रोसेसिंग वाली पाइपलाइन की तुलना करते समय सदस्यता समान रखें। फ़िल्टर में बदलाव को अलग तुलना मानें। सदस्यता का दायरा घटाने से पहले निर्णय में इस्तेमाल होने वाले इनपुट और उनके नोटिफ़िकेशन का संबंध जाँचें तथा पुष्टि करें कि संभावित फ़िल्टर ज्ञात आवश्यक इवेंट शामिल करते हैं। ज़रूरी क्रम और पूर्णता बनाए रखने वाली सीमित कतार तथा समानांतर प्रोसेसिंग डिज़ाइन करें और कतार भरने पर व्यवहार बताएँ। आवश्यक डेटा चुपचाप न छोड़ें। त्रुटि की पूरी जानकारी और दोबारा प्रयास करने की समय-सीमाएँ सहेजें; लागू किए गए विराम के दौरान दोबारा कनेक्ट न करें।

7. देखे गए तथ्य, संभावित कारण, अपरीक्षित धारणाएँ, समीक्षा योग्य बदलाव और बदलाव से पहले तथा बाद के माप अलग-अलग बताएँ। सदस्यता और माप के आधार पर CPU, RAM, बैंडविड्थ, स्टोरेज प्रदर्शन और स्थान का अनुमान लगाएँ, जिसमें अधिकतम लोड के लिए गुंजाइश हो। Solana के लिए सभी पर लागू होने वाली निश्चित हार्डवेयर आवश्यकता न गढ़ें। ज़रूरत हो तो समान सदस्यता, SDK और commitment के साथ अलग मशीनों या डेटा सेंटर की तुलना का प्रस्ताव दें।

यदि मैं ERPC इस्तेमाल करता हूँ, तो वर्तमान gRPC FAQ पढ़ें और सटीक error code के निर्देश अपनाएँ:
https://erpc.global/en/faq/grpc/general/
यदि ERPC User MCP या CLI जुड़ा है, तो वास्तव में उपलब्ध कार्रवाई और अनुमतियाँ जाँचें। अकाउंट की जानकारी तक पहुँच का अर्थ host की जाँच की पहुँच नहीं है। सशुल्क VPS बनाने, अनुबंध बदलने, production अपडेट करने या पुनः शुरू करने से पहले लागत, उद्देश्य और परीक्षण की अवधि बताएँ तथा मेरी मंज़ूरी लें। पहले निदान और समीक्षा योग्य सुधार पूरे करें।
जाँचें कि मेरे Solana Geyser gRPC क्लाइंट में और तेज़ प्रतिक्रिया देने की गुंजाइश है या नहीं। यदि देरी, जमा होता काम या कनेक्शन टूटने की समस्या है, तो उनके कारण अलग करें और सुधार में मदद करें। केवल कनेक्शन सफल होने या लॉग में इवेंट दिखने से यह न मानें कि ताज़ा डेटा प्रोसेस हो रहा है। पहले से यह भी तय न करें कि कारण क्लाइंट या प्रदाता में से किस तरफ है।
1. उद्देश्य स्पष्ट करें: आवश्यक इवेंट, स्वीकार्य ताज़गी, क्रम और डेटा हानि की शर्तें, सदस्यता फ़िल्टर, commitment, endpoint का क्षेत्र, भाषा/SDK/gRPC लाइब्रेरी के वास्तविक संस्करण और रनटाइम वातावरण। पहले उपलब्ध कोड, configuration और lockfile पढ़ें; केवल अनुपलब्ध जानकारी पूछें। जो शर्तें अभी तय नहीं हुई हैं, उन्हें स्पष्ट रूप से अनिर्धारित रखें और पहले वर्तमान स्थिति की जाँच करें। रहस्य या गोपनीय जानकारी न दिखाएँ और साझा लॉग में संवेदनशील जानकारी छिपाएँ।
2. प्राप्ति से काम पूरा होने तक मापें। शुरुआत में प्राप्ति, प्रोसेसिंग पूरी होने और प्रतीक्षा समय को प्राथमिकता दें तथा जो मापा जा सकता है, उससे शुरू करें। events/second, bytes/second, पूरे हुए events/second, कतार में इवेंट की संख्या/bytes/सबसे पुराने इवेंट का इंतज़ार, p50/p95/p99, त्रुटियाँ, कनेक्शन टूटना, दोबारा कनेक्शन और drops दर्ज करें। स्पष्ट कतार न हो तो यह बताएँ और प्रोसेसिंग के वे समय-अंतराल पहचानें जिन्हें देखा जा सकता है। निरीक्षण के स्थान तथा न मापे गए समय-अंतराल बताएँ। NIC ट्रैफ़िक, नेटवर्क पर भेजे गए bytes, Protobuf आकार और डिकोड किए गए object में अंतर रखें। स्थानीय बीते समय के लिए monotonic clock इस्तेमाल करें; बाहरी समय के लिए समन्वय और timestamp का मूल स्थान जाँचें। slot के अंतर को सीधे डेटा हानि या किसी निश्चित अवधि में न बदलें।
3. CPU, मेमोरी, डिस्क और नेटवर्क की सीमाएँ अलग करें। हर core/thread का CPU, steal और CPU सीमा, RSS/GC/swap/PSI, I/O प्रतीक्षा, NIC bytes/drops/errors, TCP retransmission और RTT जाँचें। उपयोगी Linux टूल में mpstat, pidstat, vmstat, iostat, sar, ss -ti और /proc/pressure/ शामिल हैं। टूल या अनुमति न हो तो बताएँ और न्यूनतम आवश्यक command दें। यदि host तक पहुँच नहीं है, तो प्रबंधन कंसोल या एप्लिकेशन के भीतर लिए जा सकने वाले मापों से जानकारी खोजें और अनुपलब्ध मात्राओं को न मापा गया चिह्नित करें। परिणाम कभी न गढ़ें।
4. HTTP/2 की stream और connection, दोनों window, TCP receive buffer, proxy, VPN और sidecar जाँचें। इंस्टॉल किए गए SDK संस्करण के आधिकारिक दस्तावेज़ पढ़ें और bandwidth-delay product का संबंध देखें। रिसीव लूप में या उसके आसपास JSON conversion, हर इवेंट की logging, सिंक्रोनस डेटाबेस या बाहरी API call, blocking काम, lock, असीमित task बनाना और बिना सीमा की कतारें जाँचें। केवल Rust या async कोड को समाधान न मानें।
5. mtr या समान टूल उपलब्ध हो तो वास्तविक endpoint host तक सीमित संख्या में माप लें। समर्थित सिस्टम पर यह command विचार में लें: mtr --tcp --port <PORT> --report --report-cycles 30 <HOST>। सामान्य TLS port मान लेने के बजाय वास्तविक port इस्तेमाल करें। केवल बीच के hop पर loss को खराबी न कहें; गंतव्य का व्यवहार, retransmission और दूसरे मार्ग से तुलना करें। mtr को बैंडविड्थ मापन का विकल्प न बनाएँ।
6. वर्तमान सदस्यता में आधार माप दर्ज करें और एक बार में केवल एक चीज़ बदलें। न्यूनतम रिसीविंग पथ और एप्लिकेशन की काम-संबंधी प्रोसेसिंग वाली पाइपलाइन की तुलना करते समय सदस्यता समान रखें। फ़िल्टर में बदलाव को अलग तुलना मानें। सदस्यता का दायरा घटाने से पहले निर्णय में इस्तेमाल होने वाले इनपुट और उनके नोटिफ़िकेशन का संबंध जाँचें तथा पुष्टि करें कि संभावित फ़िल्टर ज्ञात आवश्यक इवेंट शामिल करते हैं। ज़रूरी क्रम और पूर्णता बनाए रखने वाली सीमित कतार तथा समानांतर प्रोसेसिंग डिज़ाइन करें और कतार भरने पर व्यवहार बताएँ। आवश्यक डेटा चुपचाप न छोड़ें। त्रुटि की पूरी जानकारी और दोबारा प्रयास करने की समय-सीमाएँ सहेजें; लागू किए गए विराम के दौरान दोबारा कनेक्ट न करें।
7. देखे गए तथ्य, संभावित कारण, अपरीक्षित धारणाएँ, समीक्षा योग्य बदलाव और बदलाव से पहले तथा बाद के माप अलग-अलग बताएँ। सदस्यता और माप के आधार पर CPU, RAM, बैंडविड्थ, स्टोरेज प्रदर्शन और स्थान का अनुमान लगाएँ, जिसमें अधिकतम लोड के लिए गुंजाइश हो। Solana के लिए सभी पर लागू होने वाली निश्चित हार्डवेयर आवश्यकता न गढ़ें। ज़रूरत हो तो समान सदस्यता, SDK और commitment के साथ अलग मशीनों या डेटा सेंटर की तुलना का प्रस्ताव दें।
यदि मैं ERPC इस्तेमाल करता हूँ, तो वर्तमान gRPC FAQ पढ़ें और सटीक error code के निर्देश अपनाएँ:
https://erpc.global/en/faq/grpc/general/
यदि ERPC User MCP या CLI जुड़ा है, तो वास्तव में उपलब्ध कार्रवाई और अनुमतियाँ जाँचें। अकाउंट की जानकारी तक पहुँच का अर्थ host की जाँच की पहुँच नहीं है। सशुल्क VPS बनाने, अनुबंध बदलने, production अपडेट करने या पुनः शुरू करने से पहले लागत, उद्देश्य और परीक्षण की अवधि बताएँ तथा मेरी मंज़ूरी लें। पहले निदान और समीक्षा योग्य सुधार पूरे करें।वही कोड तुलना योग्य वातावरण में आज़माएँ
माप से CPU, मेमोरी संसाधनों या नेटवर्क पथ में सुधार के अवसर सामने आ सकते हैं। अधिक शक्तिशाली CPU, अधिक मेमोरी, काम का विभाजन या स्रोत के करीब स्थान, संभावित विकल्प हैं। इन विकल्पों को ऐप के डेटा की मात्रा और प्रेक्षणों से जोड़ने पर उन्हें आज़माने का कारण और जाँचने वाला प्रभाव, दोनों स्पष्ट होते हैं।
ERPC VPS, Solana इंफ़्रास्ट्रक्चर के पास स्ट्रीम क्लाइंट चलाने का एक विकल्प है। घंटे के हिसाब से बिलिंग के साथ आप उसी कोड और सदस्यता की तुलना अपने वर्तमान वातावरण से कर सकते हैं। वर्तमान कीमत, क्षेत्र और उपलब्धता Dashboard में देखें। ERPC पर भी संसाधन की आवश्यकता आपकी सदस्यता और एप्लिकेशन की प्रोसेसिंग पर निर्भर करती है।[7]
रिसीव दर के साथ कतार बढ़ने की गति, प्रोसेसिंग पूरी होने के समय डेटा की ताज़गी, p99 और त्रुटियों की तुलना करें। माप का समय और ब्लॉकचेन का लोड दर्ज करें। साथ-साथ तुलना या बार-बार माप लेने से समय के साथ ट्रैफ़िक में आए बदलाव को वातावरण के प्रदर्शन का अंतर समझने की गलती से बचा जा सकता है।
सहायता के लिए संवेदनशील जानकारी छिपाकर सदस्यता की सेटिंग, SDK संस्करण, क्षेत्र, timestamp, पूरे त्रुटि संदेश और अब तक मिले माप साझा करें। जो मान अभी नहीं मिले हैं, उन्हें स्पष्ट रूप से न मापा गया बता सकते हैं।
हर अतिरिक्त प्रेक्षण से अगला बदलाव चुनना आसान होता है। आवश्यक डेटा बनाए रखते हुए एक-एक कदम पर सुधार जाँचें। हम भी आपके विकास कार्य को सहारा देने वाली जानकारी और इन्फ्रास्ट्रक्चर को बेहतर बनाते रहेंगे।
संदर्भ और संबंधित लिंक
- [1] gRPC Flow Control: https://grpc.io/docs/guides/flow-control/
- [2] Yellowstone gRPC सदस्यता की विशिष्टताएँ: https://github.com/rpcpool/yellowstone-grpc/blob/master/README.md
- [3] Tokio: CPU-bound tasks and blocking code: https://docs.rs/tokio/latest/tokio/index.html#cpu-bound-tasks-and-blocking-code
- [4] HTTP/2 flow control: https://www.rfc-editor.org/rfc/rfc9113.html#section-5.2
- [5] Solana शब्दावली: https://solana.com/docs/references/terminology
- [6] mtr के आधिकारिक दस्तावेज़: https://github.com/traviscross/mtr
- [7] ERPC VPS: https://erpc.global/hi/vps/
- Linux PSI: https://docs.kernel.org/accounting/psi.html
- Node.js मापन API: https://nodejs.org/api/perf_hooks.html
- ERPC gRPC FAQ: https://erpc.global/hi/faq/grpc/general/
- ERPC Web Dashboard: https://dashboard.erpc.global/hi/
- Validators DAO का आधिकारिक Discord: https://discord.gg/C7ZQSrCkYR


