Sepuluh Mitos yang Memperlambat Aplikasi Solana: Mengapa Infrastruktur Cepat Masih Bisa Terasa Lambat
Koneksi Anda cepat. CPU Anda modern. Server Anda berada di kota yang sama dengan penyedia data. Namun, aplikasi masih lambat merespons informasi yang dibutuhkan. Koneksi tetap terbuka, tetapi data yang sedang diproses semakin tertinggal.
Saat membangun aplikasi berlatensi rendah di Solana, keadaan ini tidak selalu disebabkan oleh satu hal. Rute jaringan, pengaturan penerimaan, data yang dilanggan, dan waktu tunggu di dalam aplikasi dapat saling berpadu sehingga infrastruktur cepat yang dipilih tidak dimanfaatkan sepenuhnya.
Di ERPC, yang dioperasikan oleh ELSOUL LABO B.V., tim dukungan kami berulang kali menerima pertanyaan tentang loop penerimaan yang terhenti, pengaturan klien, langganan data yang terlalu luas, dan upaya koneksi ulang yang tidak menyelesaikan kesalahan awal. Pilihan yang hampir tidak menimbulkan masalah pada aplikasi web biasa dapat menjadi kendala dalam perdagangan berfrekuensi tinggi dan pemrosesan waktu nyata.
Artikel ini membahas sepuluh mitos di balik masalah tersebut. Tujuannya adalah membantu Anda menilai pilihan infrastruktur sekaligus desain yang meneruskan kinerjanya hingga menjadi keputusan dan pengiriman transaksi.
Panduan ini ditujukan bagi pengembang yang berpengalaman membangun aplikasi web dan mulai membuat aplikasi perdagangan frekuensi tinggi (HFT) atau aplikasi waktu nyata lainnya di Solana. Panduan ini membahas pemilihan lingkungan dan pemeriksaan awal. Dalam artikel ini, langganan berarti memilih pembaruan data yang akan diterima aplikasi secara terus-menerus.
Pertama, tentukan apa yang harus selesai lebih cepat
Waktu pulang-pergi jaringan, waktu kedatangan data, waktu pengambilan keputusan, dan waktu hingga transaksi dikonfirmasi adalah metrik yang berbeda. Ping yang cepat tidak mencegah keputusan yang lambat jika pemrosesan tersendat setelah data diterima. Respons RPC yang cepat belum tentu berarti transaksi telah dieksekusi.
Sebagai contoh, bayangkan aplikasi yang menerima pembaruan keadaan pasar, menghitung ulang kondisinya, lalu mengirim transaksi ketika kondisi tersebut terpenuhi. Pisahkan waktu hingga pembaruan tiba, waktu untuk menyelesaikan perhitungan, dan waktu untuk memverifikasi hasil transaksi yang dikirim. Menentukan rentang waktu mana yang perlu diperpendek akan memperjelas bagian yang perlu diselidiki.
Lalu ukur pengamatan, pemrosesan setelah penerimaan, serta pengiriman dan konfirmasi secara terpisah. Perbaikan dimulai dengan tidak menyederhanakan kecepatan menjadi satu nama produk atau satu angka.
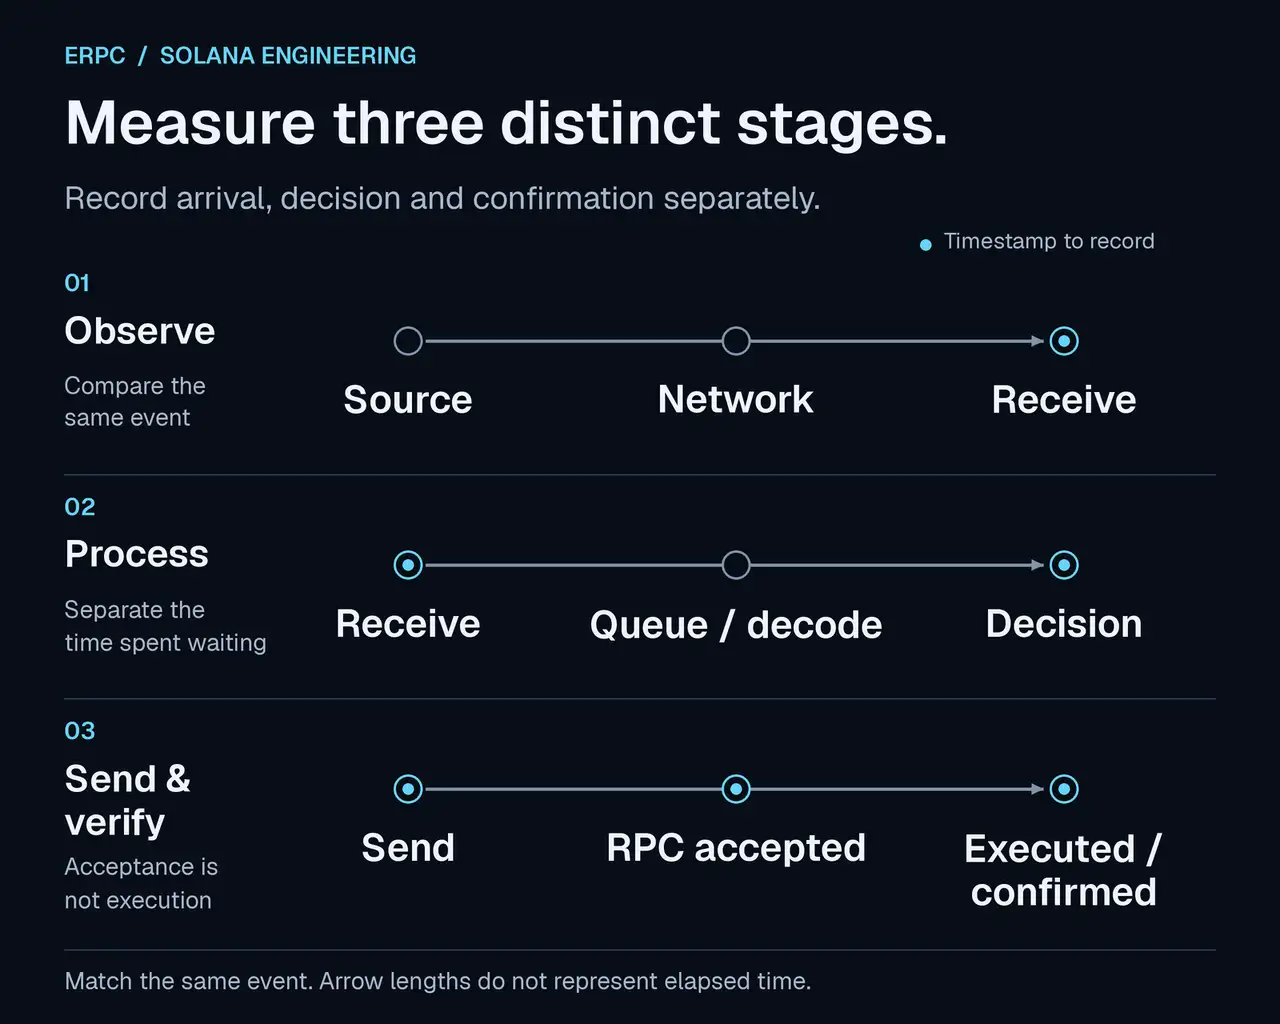
Ukur pengamatan, pemrosesan di dalam aplikasi, serta pengiriman dan konfirmasi secara terpisah. Diagram ini tidak menunjukkan durasi terukur atau perbedaan kinerja antartahap.
Mitos 1: VM kecil masih berjalan, berarti kapasitasnya cukup
VM cloud kecil pernah bekerja dengan baik untuk aplikasi web sebelumnya atau beban kerja Ethereum. Pengalaman itu dapat membuat kita menganggap konfigurasi yang sama akan menangani aliran data Solana. Namun, aplikasi yang sesekali mengirim kueri RPC dan aplikasi yang terus menerima serta memproses beragam pembaruan membutuhkan sumber daya yang berbeda.
Tentukan kapasitas lingkungan berdasarkan volume data, laju kedatangan, pekerjaan per peristiwa, dan latensi yang dapat diterima. Berapa peristiwa yang datang setiap detik? Berapa byte yang ditransfer? Berapa waktu CPU dan memori yang digunakan untuk dekode dan keputusan? Sediakan ruang kapasitas untuk lonjakan maupun lalu lintas normal. Bahkan pada blockchain yang sama, cakupan langganan dan implementasi mengubah kebutuhan sumber daya.
Bagian yang sulit adalah aplikasi dengan sumber daya kurang dapat terlihat tetap bekerja. Data mungkin terus muncul di layar meskipun semakin usang, atau celah saat koneksi ulang tidak terdeteksi. Jumlah peristiwa yang diterima saja tidak dapat menunjukkan hal ini. Periksa juga jumlah peristiwa yang selesai diproses, usia data yang belum diproses, dan kesinambungan peristiwa yang seharusnya tercakup oleh langganan.
Jika pengalaman lama menjadi satu-satunya acuan, pengembang mungkin tidak pernah mempertanyakan kapasitas sisi penerima dan terus menyalahkan endpoint data. Mencoba lingkungan dengan cadangan kapasitas lebih besar dapat mengungkap antrean tertunda atau data hilang yang sebelumnya tidak terlihat.
Untuk menyelidikinya, bandingkan endpoint, langganan, tingkat commitment (tahap konfirmasi yang diminta, dijelaskan dalam Mitos 9), SDK, pengaturan, dan beban pemrosesan yang sama pada lingkungan penerimaan dan pemrosesan dengan kapasitas lebih longgar. Pertahankan wilayah yang sama, catat perbedaan CPU, memori, dan jaringan, lalu bandingkan throughput penerimaan (jumlah data yang benar-benar diterima per detik), pekerjaan selesai, antrean tertunda, peristiwa hilang, dan waktu hingga keputusan. Beban berubah dari waktu ke waktu, jadi lakukan perbandingan pada periode yang sama jika memungkinkan, dengan tetap mematuhi batas koneksi dan memperhatikan beban pada layanan.
Perbaikan setelah perubahan lingkungan menunjukkan bahwa kondisi penerimaan atau pemrosesan turut memengaruhi hasil. Jika CPU, memori, dan jaringan berubah sekaligus, pemeriksaan lanjutan diperlukan untuk menentukan sumber daya mana yang berpengaruh. Memilih sumber daya sesuai jumlah dan laju data yang benar-benar ditangani merupakan prasyarat pemrosesan berlatensi rendah.
Mitos 2: berada di kota yang sama berarti dekat di jaringan
“Kedua server berada di Frankfurt, jadi pasti dekat.” “Menempatkan server di Tokyo pasti paling cepat untuk Jepang.” Nama kota membantu mempertimbangkan lokasi penerapan, tetapi tidak menjamin rute yang benar-benar dilewati lalu lintas.
Jalur bergantung pada koneksi antarpusat data, hubungan antaroperator jaringan, dan keputusan perutean. Bahkan server dalam satu kota dapat melewati jalur memutar melalui jaringan eksternal. RIPE IPmap, misalnya, menyebut visualisasi ketidakefisienan rute, seperti lalu lintas yang keluar dari suatu negara lalu kembali, sebagai salah satu kegunaannya. [1]
Ukur RTT antara sumber data sebenarnya dan host yang menjalankan aplikasi, variasinya sepanjang waktu, transmisi ulang atau kehilangan paket, serta waktu kedatangan peristiwa yang sama. Traceroute dan MTR dapat membantu menyelidiki jalur, tetapi jumlah hop saja tidak menentukan rute mana yang lebih baik. Penting juga untuk tidak menganggap router perantara yang membatasi respons diagnostik sebagai kehilangan paket yang memengaruhi aplikasi.
Setelah memilih wilayah, ajukan satu pertanyaan lagi: bagaimana sumber data dan server tertentu ini benar-benar terhubung? Pemeriksaan tambahan itu memperlihatkan perbedaan yang tidak dapat dijelaskan oleh nama kota saja.
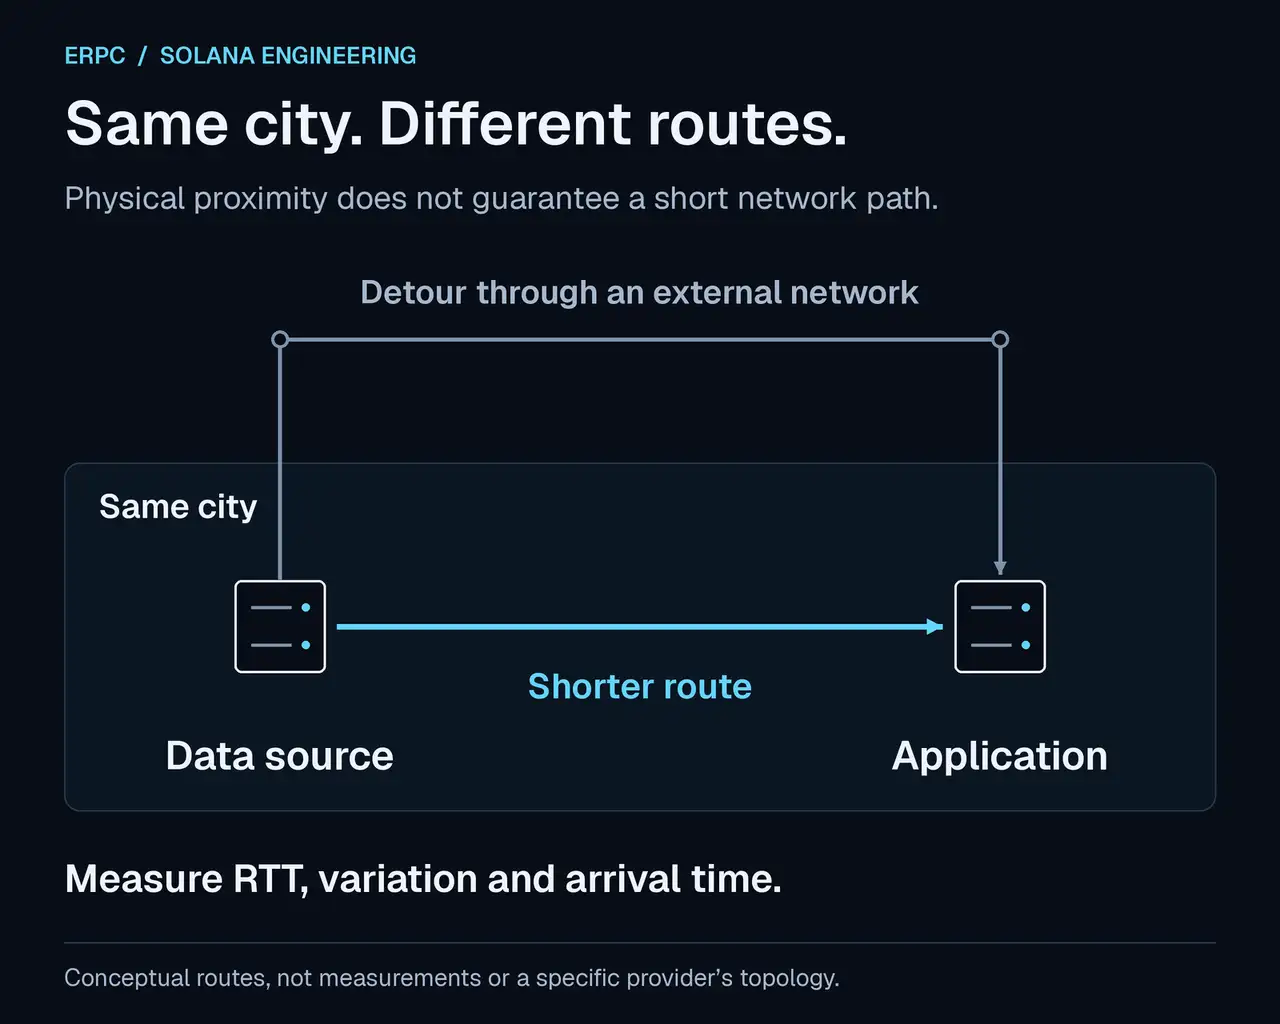
Dua server di kota yang sama dapat memiliki rute dan waktu pulang-pergi yang berbeda. Diagram ini bersifat konseptual dan tidak menggambarkan rute sebenarnya milik penyedia tertentu.
Mitos 3: spesifikasi jaringan tinggi berarti bandwidth yang dapat digunakan cukup
Bandwidth adalah kapasitas koneksi. Angka bandwidth dalam spesifikasi server dapat berarti beberapa hal: kecepatan port fisik, bandwidth yang dialokasikan ke VM, bandwidth berkelanjutan, atau batas lonjakan sementara. NIC yang cepat tidak berarti aplikasi dapat terus menggunakan seluruh kapasitasnya.
Dokumentasi AWS, misalnya, membedakan bandwidth dasar dan bandwidth lonjakan serta menjelaskan batasan terkait tujuan lalu lintas, aliran, dan laju paket. Ini merupakan contoh cara membaca spesifikasi; bukan berarti semua VPS memiliki batas yang sama dengan AWS. [2]
Saat memilih paket, periksa apakah bandwidth bersifat khusus atau bersama, syarat pemakaian berkelanjutan, kuota transfer, serta apakah tujuan lalu lintas yang berbeda diperlakukan berbeda. Dalam pengujian, pertahankan lalu lintas ke endpoint yang sama dengan kondisi langganan yang akan digunakan di produksi, sambil mengamati throughput penerimaan, paket yang dibuang, transmisi ulang, dan beban CPU secara bersamaan.
Hasil tinggi dalam tes kecepatan singkat tidak membuktikan bahwa server mampu memproses aliran produksi secara terus-menerus. Di sisi lain, throughput penerimaan yang rendah belum tentu berarti kekurangan bandwidth. Pisahkan masalah pengaturan penerimaan dan keterbatasan pemrosesan sebelum meningkatkan koneksi.
Mitos 4: CPU lebih bagus, core lebih banyak, atau GHz maksimum lebih tinggi membuat aplikasi cepat
Frekuensi boost maksimum CPU bukanlah kecepatan clock yang dipertahankan pada setiap beban. Operasi sebenarnya bergantung pada daya, suhu, firmware, kontrol frekuensi, dan beban lain. Dokumentasi Linux menjelaskan bahwa mengaktifkan boost mengizinkan penggunaannya; hal itu tidak menunjukkan bahwa CPU benar-benar sedang melakukan boost. [3]
Jika pekerjaan penting terkonsentrasi pada satu thread, menambah core saja tidak membuat pekerjaan itu selesai lebih cepat. Pemakaian CPU total dapat tampak rendah sementara satu core atau event loop sudah jenuh. Panduan resmi Node.js juga menjelaskan bagaimana callback yang berat membuat pekerjaan lain menunggu. [4]
Periksa frekuensi clock, suhu, pemakaian setiap core, dan waktu pemrosesan pada beban kerja sebenarnya. Dalam lingkungan virtual, waktu menunggu alokasi CPU juga dapat memberikan informasi. Lakukan profiling untuk mengetahui berapa banyak waktu digunakan oleh dekode, komputasi, alokasi memori, dan pencatatan log.
Pilih kombinasi kinerja clock CPU, alokasi sumber daya, pengaturan yang mempertahankan kinerja, dan implementasi aplikasi. Membandingkan nomor model saja tidak dapat menentukan kecepatan seluruh aplikasi.
Mitos 5: jika menggunakan gRPC, pengaturan bawaan klien sudah cukup
Terbentuknya koneksi gRPC tidak membuktikan bahwa koneksi itu mampu menerima volume data yang diperlukan pada kecepatan yang dibutuhkan. HTTP/2 memiliki kontrol aliran: penerima memberi tahu pengirim berapa banyak data yang dapat diterima. Kontrol ini berlaku pada tingkat stream dan koneksi, sehingga jendela penerimaan beserta pembaruannya dapat membatasi throughput meskipun jaringan masih memiliki kapasitas tersisa. [5][6]
Jendela penerimaan memberi tahu pengirim berapa banyak data yang boleh dikirim tanpa pembaruan berikutnya dari penerima. Nilai awal, penyesuaian otomatis, dan prioritas pengaturan berbeda menurut SDK dan pustaka. Menulis angka besar dalam berkas konfigurasi tidak membuktikan bahwa klien bekerja sesuai harapan. Periksa pengaturan stream dan koneksi, interaksinya dengan pengaturan adaptif, serta versi yang digunakan.
Lakukan perubahan sambil mengukur throughput penerimaan sebenarnya dan antrean pemrosesan pada kondisi langganan yang sama. Ukuran maksimum pesan yang diterima, buffer penerimaan TCP, dan jendela penerimaan HTTP/2 adalah pengaturan yang berbeda. Keepalive memeriksa apakah koneksi masih hidup; keepalive tidak menambah kapasitas pemrosesan atau bandwidth.
FAQ gRPC ERPC memuat langkah pemecahan masalah dan contoh konfigurasi klien untuk stream yang throughput-nya tetap datar sementara ketertinggalannya bertambah. Gunakan contoh tersebut sebagai titik awal, lalu verifikasi terhadap volume langganan dan kapasitas pemrosesan Anda sendiri. Sebelum menggunakan contoh konfigurasi, catat SDK yang digunakan beserta versinya. Temukan tempat SDK tersebut mengatur jendela penerimaan untuk stream dan koneksi serta penyesuaian otomatis, lalu bandingkan dengan contoh dalam FAQ. Jika menggunakan SDK yang berbeda, periksa pengaturan yang sesuai dalam dokumentasinya, alih-alih menyalin nama parameter dan nilainya tanpa perubahan. [7]
Mitos 6: menerima semua blok lengkap menghasilkan keputusan paling awal
“Terima semuanya dahulu, lalu cari yang penting.” Ini merupakan cara yang dapat dipahami untuk memulai pengembangan, tetapi menambah pekerjaan yang mungkin tidak diperlukan sebelum mengambil keputusan. Mentransfer, mendekode, mengalokasikan memori, dan menelusuri data yang tidak diperlukan semuanya menghabiskan sumber daya bandwidth dan CPU yang terbatas.
Jika ingin bereaksi terhadap perubahan pasar, program, atau akun tertentu, tentukan terlebih dahulu peristiwa dan field yang diperlukan untuk keputusan. Yellowstone gRPC menyediakan filter langganan transaksi dan akun, serta cara mengambil hanya sebagian data akun. Notifikasi blok lengkap dan notifikasi pembaruan individual juga merupakan hal yang berbeda. [8]
Untuk kebutuhan seperti “hitung ulang kondisi setiap kali pasar A berubah”, buat daftar informasi yang mengidentifikasi pasar A, keadaan yang digunakan dalam perhitungan, dan peristiwa yang memperbarui keadaan tersebut. Data yang dibutuhkan bergantung pada spesifikasi program, jadi bandingkan spesifikasi itu dengan pembaruan yang diterima. Gunakan daftar tersebut untuk mempersempit langganan, lalu pastikan keadaan yang diperlukan untuk mengambil keputusan tetap lengkap.
Dengan sumber daya dan kondisi yang sama, jika satu aplikasi menunggu penguraian serta pencarian seluruh record sedangkan aplikasi lain dapat segera memproses pembaruan yang diperlukan, aplikasi kedua menghindari waktu tunggu tersebut. Pesaing yang lebih terfokus dapat berulang kali bereaksi lebih awal karena alasan di luar koneksi jaringan. Menentukan apa yang dapat diabaikan merupakan bagian dari desain berlatensi rendah.
Pengindeksan, audit, penelitian, dan penyimpanan historis memang dapat membutuhkan semua data. Sediakan jalur terpisah untuk beban itu. Memisahkannya dari pengambilan keputusan segera memungkinkan Anda merancang kapasitas dan kelengkapan yang diperlukan oleh masing-masing jalur. Namun, pastikan filter tidak menghapus pembaruan yang dibutuhkan untuk keputusan yang benar. Pemrosesan batch juga dapat meningkatkan throughput total pada kondisi tertentu, jadi pilih berdasarkan waktu tunggu yang dapat ditoleransi aplikasi.
Pada layanan Shared gRPC ERPC saat ini, langganan
blocks yang tidak kosong memerlukan layanan Dedicated. Langganan transactions atau blocksMeta dapat memenuhi kebutuhan tertentu, tetapi keduanya tidak menyediakan data yang sama dengan blok lengkap. Memilih Dedicated tetap membutuhkan kapasitas pemrosesan sisi penerima dan desain langganan yang sesuai. [9]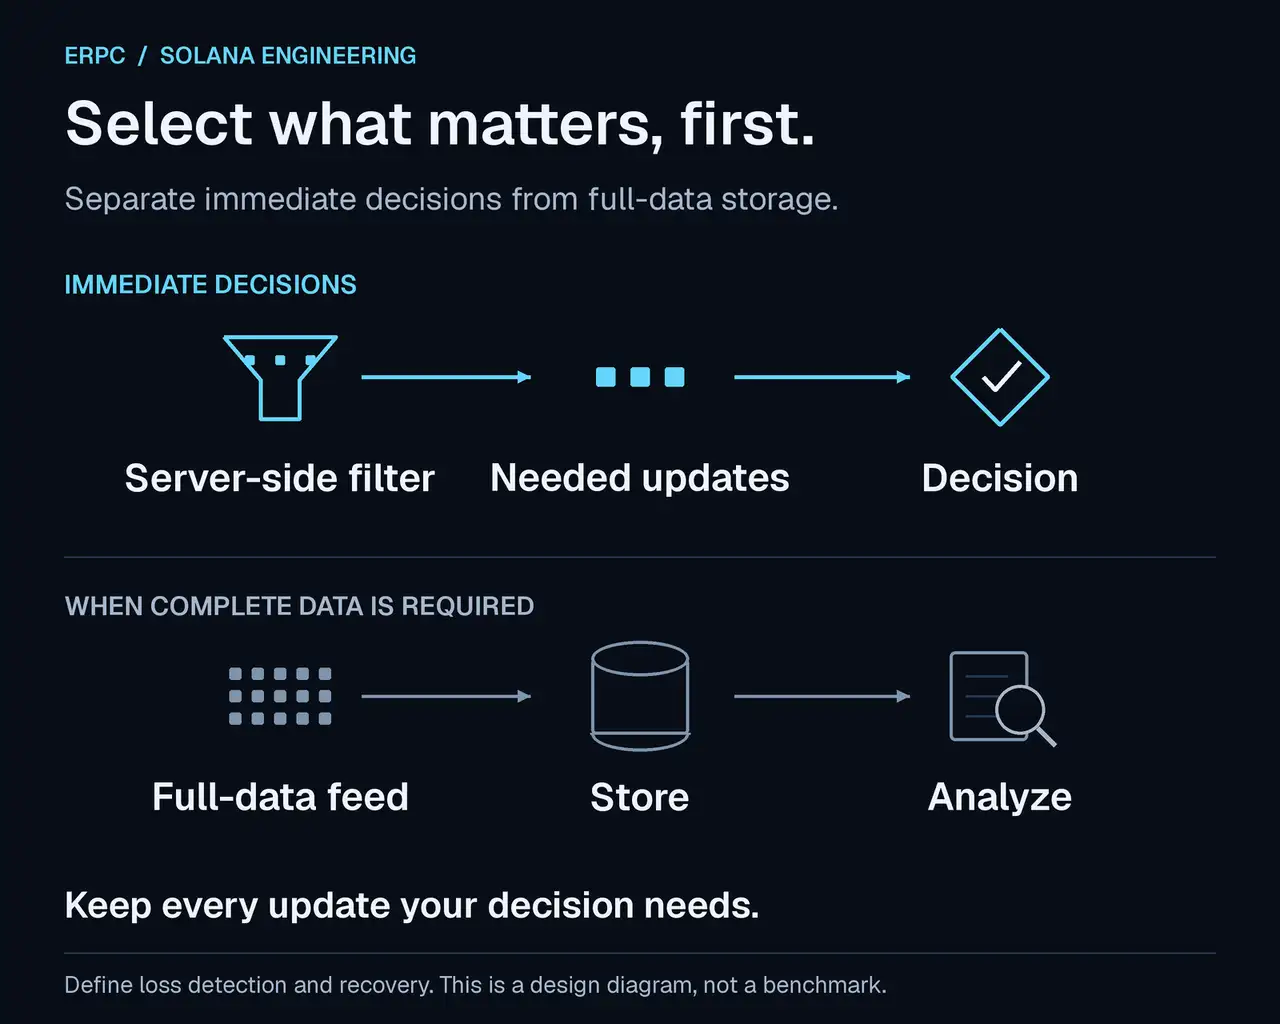
Gunakan satu jalur untuk pembaruan yang diperlukan bagi keputusan segera dan jalur lain untuk penyimpanan lengkap serta analisis. Diagram ini menggambarkan pendekatan arsitektur. Pastikan penyaringan mempertahankan keadaan yang diperlukan untuk keputusan yang benar, dan tentukan cara memulihkan data yang hilang.
Mitos 7: jika data terus datang, pemrosesan pasti mampu mengikuti
Antrean dapat terbentuk antara penerimaan data dan pengolahan data menjadi keadaan yang dapat mendukung keputusan. Jika pekerjaan masuk terus melampaui kapasitas pemrosesan, keterlambatan menumpuk meskipun koneksi tetap terbuka. Buffer yang lebih besar dapat menyerap lonjakan sementara, tetapi jika kekurangan pemrosesan berlangsung terus, buffer hanya menyimpan lebih banyak data lama.
Perhatikan contoh hipotetis yang dimulai tanpa pekerjaan tertunda. Aplikasi menerima 12.000 peristiwa dengan jenis yang sama per detik dan menyelesaikan pemrosesan 10.000 peristiwa per detik. Jika setiap peristiwa dapat disimpan dalam antrean tanpa dibuang atau digabungkan, pekerjaan tertunda bertambah 2.000 peristiwa per detik dan mencapai 20.000 setelah 10 detik. Koneksi tetap aktif dan data terus muncul, sementara pekerjaan yang diperlukan untuk mengambil keputusan semakin tertinggal. Angka-angka ini menjelaskan mekanismenya, bukan hasil pengukuran kinerja ERPC.
Jangan hanya mengukur jumlah peristiwa yang diterima. Ukur juga pemrosesan yang selesai, panjang antrean, usia item tertua yang belum diproses, dan waktu dari penerimaan hingga keputusan selesai. Pantau kesehatan koneksi dan kebaruan data secara terpisah.
Pertahankan hanya pekerjaan yang diperlukan untuk menjaga penerimaan di dalam loop penerimaan. Pertimbangkan memisahkan penulisan database, pencatatan seluruh payload, panggilan API eksternal, dan komputasi berat ke jalur pemrosesan lain. Tetapkan batas kapasitas antrean dan kebijakan ketika antrean penuh. Antrean terbatas tetap dapat membuat pekerjaan di hulu menunggu setelah penuh; antrean itu sendiri tidak menyelesaikan kekurangan kapasitas pemrosesan. [10]
Untuk pembaruan yang hanya mementingkan keadaan terbaru, keadaan lama mungkin dapat digabungkan. Peristiwa transaksi yang membutuhkan urutan atau pemrosesan lengkap tidak boleh dibuang sembarangan. Rancang deteksi celah, replay, dan pemulihan keadaan setelah koneksi ulang sesuai kebutuhan aplikasi.
STREAM_GUARD_SLOW_READER ERPC adalah respons perlindungan terhadap penulisan data ke stream yang tidak maju cukup cepat atau keterlambatan pengiriman yang teramati. Jangan menentukan penyebab hanya berdasarkan pengamatan tersebut. Selidiki koneksi, host, volume langganan, dan laju konsumsi aplikasi. Sebelum menyambung ulang, simpan status, pesan, metadata, dan trailer pertama jika tersedia, lalu baca alasan serta syarat percobaan ulang yang diberikan server. Mengirim ulang permintaan yang sama setelah ditolak tanpa memperbaikinya akan membiarkan penyebab tetap ada. [7]Mitos 8: ping atau rata-rata yang cepat berarti aplikasi cepat saat dibutuhkan
Ping memberikan gambaran waktu pulang-pergi jaringan. Interval ini berbeda dari latensi aplikasi, yang mencakup pemrosesan di sumber, isi langganan, waktu tunggu penerimaan, dekode, dan pengambilan keputusan. Rata-rata juga dapat menyembunyikan sejumlah kecil keterlambatan yang besar.
p50 adalah median. p95 dan p99 menunjukkan nilai yang masing-masing mencakup 95% dan 99% hasil pengukuran pada atau di bawah nilai tersebut. p99 bukan nilai maksimum. Sertakan jumlah sampel dan periode pengukuran, lalu periksa nilai selama lonjakan peristiwa, maksimum, timeout, putus koneksi, dan data hilang. [11]
Saat membandingkan penyedia, samakan peristiwa, jenis data, commitment, dan kondisi langganan. Bila memungkinkan, terima pada host pengukuran yang sama dan gunakan jam monotonik untuk mengukur durasi di dalam aplikasi. Saat mengurangkan timestamp dari host yang berbeda, perhitungkan perbedaan jam yang dapat mencemari pengukuran.
Menyimpan hanya peristiwa yang berhasil dapat membuat konfigurasi dengan banyak data hilang tampak cepat. Memilih satu hasil tercepat dan memilih konfigurasi yang lebih kecil kemungkinannya tertinggal saat dibutuhkan di produksi adalah dua keputusan yang berbeda.
Mitos 9: data yang paling awal sama finalnya dan bermakna sama
Shreds, notifikasi transaksi, pembaruan akun, dan notifikasi blok tidak mewakili informasi yang sama pada tahap yang sama. Menggunakan data dari tahap lebih awal dapat menyisakan lebih banyak rekonstruksi atau interpretasi untuk aplikasi. Perbandingan perlu menyamakan bukan hanya waktu penerimaan, tetapi juga apa yang dapat diketahui pada saat itu. [8][12]
Bedakan pula tingkat commitment Solana:
processed, confirmed, dan finalized. Jika pengamatan awal digunakan dalam keputusan, aplikasi perlu memeriksa status konfirmasinya kemudian dan memperbaiki keadaan bila perlu. Pisahkan penerimaan pembaruan awal dari syarat untuk mengambil tindakan definitif pada sistem eksternal. [13]Contohnya, sekadar membandingkan notifikasi yang diterima pada commitment berbeda dan menyatakan salah satunya sekian milidetik lebih cepat bukanlah perbandingan pekerjaan yang sama. Tentukan informasi dan finalitas yang dibutuhkan aplikasi, lalu ukur waktu yang dibutuhkan hingga aplikasi siap mengambil keputusan dalam kondisi itu.
Mitos 10: pengiriman berhasil berarti transaksi dieksekusi lebih dahulu
Respons
sendTransaction yang berhasil berarti RPC menerima transaksi. Respons itu tidak menjamin pemrosesan atau konfirmasi oleh klaster. Spesifikasi Solana secara tegas meminta pemeriksaan status signature secara terpisah. [14]Meskipun informasi masuk mendukung keputusan lebih awal, jalur pengiriman, masa berlaku blockhash, perebutan akun yang dapat ditulis, sumber daya komputasi, biaya prioritas, dan syarat keberhasilan transaksi sendiri tetap penting. SWQoS berkaitan dengan penerimaan serta prioritas koneksi menuju leader, sedangkan biaya prioritas memengaruhi prioritas penjadwalan. Perannya berbeda, dan keduanya tidak menjamin urutan eksekusi maupun keberhasilan tanpa syarat. [15][16]
Catat penyelesaian keputusan, awal pengiriman, penerimaan RPC, hasil eksekusi, dan status konfirmasi yang diperlukan secara terpisah. Saat mencoba ulang, bedakan pula pengiriman kembali transaksi dengan signature yang sama dari pembuatan transaksi baru agar aplikasi menghindari tindakan ganda yang tidak disengaja.
Hanya dengan mengamati seluruh jalur dari penerimaan hingga konfirmasi, Anda dapat menentukan perbaikan mana yang mendekatkan aplikasi pada sasaran.
Pengukuran yang perlu disiapkan terlebih dahulu
Mulailah dengan tiga pemeriksaan berikut.
- Pilih satu keputusan, lalu tuliskan pembaruan apa yang diperlukan dan keadaan apa yang harus tersedia sebelum aplikasi dapat mengambil keputusan.
- Selama periode pengukuran yang sama, catat jumlah peristiwa yang diterima, yang selesai diproses, dan yang masih tertunda untuk jenis peristiwa yang sama. Jika pekerjaan masuk antrean, ukur juga waktu yang berlalu sejak aplikasi menerima peristiwa tertunda yang paling lama.
- Jika pekerjaan tertunda atau waktu tunggu terus bertambah, cari tempat pekerjaan menumpuk. Pilih satu perubahan yang sesuai pada langganan, pemrosesan, pengaturan, atau lingkungan eksekusi, lalu bandingkan hasil sebelum dan sesudahnya.
Waktu sejak data diterima aplikasi menunjukkan waktu tunggu di dalam aplikasi. Ukur keterlambatan dari terjadinya peristiwa asal hingga diterima aplikasi secara terpisah. Setelah catatan awal tersedia, gunakan tabel berikut untuk memperluas pemeriksaan.
| Tahap | Yang dicatat | Yang dapat diidentifikasi |
|---|---|---|
| Jaringan dan penerimaan | Throughput penerimaan sebenarnya, transmisi ulang dan kehilangan, selisih kedatangan peristiwa yang sama | Batas rute, bandwidth, dan pengaturan penerimaan |
| Aplikasi | Jumlah diterima dan selesai, panjang antrean, usia item tertua | Kekurangan pemrosesan berkelanjutan dan penumpukan data usang |
| Waktu hingga keputusan | p50, p95, p99, dan maksimum dari penerimaan hingga keputusan selesai | Pemrosesan yang memakan banyak waktu atau sumber daya dan keterlambatan saat lonjakan |
| Pengiriman dan konfirmasi | Awal pengiriman, penerimaan RPC, status signature, kesalahan eksekusi | Keterlambatan dan kegagalan setelah penerimaan |
| Kondisi perbandingan | Wilayah, host, SDK dan versi, langganan, commitment, periode, jumlah sampel | Perbedaan semu akibat kondisi yang berbeda |
Simpan hasil dasar, kemudian verifikasi satu perubahan pada satu waktu sesuai gejalanya: cakupan langganan, pemisahan pemrosesan, pengaturan klien, serta lokasi atau sumber daya. Jika memperbesar jendela, periksa juga peningkatan pemakaian memori dan antrean. Jika mempersempit langganan, pastikan informasi yang diperlukan tidak hilang.
p99 waktu total tidak dihitung dengan sekadar menjumlahkan p99 setiap tahap. Hitung dari waktu total setiap peristiwa yang dipasangkan, lalu gunakan pengukuran per tahap untuk menemukan penyebab. Uji selama lonjakan peristiwa nyata selain pada beban rata-rata.
ERPC menyiapkan infrastruktur agar pengembang dapat menyempurnakan logika
Ketika jaringan, server, pengiriman data, dan klien dipilih secara terpisah, waktu tunggu dapat tersisa di antaranya meskipun masing-masing memiliki spesifikasi bagus. ERPC menyatukan pengiriman data Solana dan lingkungan pemrosesan dalam satu platform, mengurangi pekerjaan berulang untuk memilih lokasi serta sumber daya dari awal.
SUPER VPS dan Premium VPS menyediakan konfigurasi clock tinggi serta alokasi sumber daya tanpa overcommitment, sementara Bare Metal menyediakan mesin yang didedikasikan secara fisik. ERPC mendekatkan jaringan dan server ke lingkungan pengiriman datanya serta menyiapkan CPU, memori, penyimpanan, dan konektivitas untuk pemrosesan berkelanjutan. Spesifikasi rinci tersedia untuk setiap paket dan wilayah. [17][18]
| Kendala pengembangan yang umum | Infrastruktur dan informasi melalui ERPC | Yang disempurnakan dalam aplikasi |
|---|---|---|
| Jarak yang tidak terlihat dari nama kota | Konfigurasi wilayah dan jaringan untuk memilih lingkungan pengiriman serta pemrosesan bersama | Ukur waktu kedatangan dan variasinya pada kondisi langganan Anda |
| Perebutan sumber daya dan kinerja berkelanjutan | SUPER VPS dan Premium VPS ber-clock tinggi tanpa overcommitment, serta Bare Metal khusus | Identifikasi pemrosesan yang memakan banyak waktu atau sumber daya dan bagian yang berjalan berurutan |
| Volume data dan metode koneksi | gRPC, Shreds, RPC, serta pilihan bersama atau khusus sesuai beban | Tentukan peristiwa dan field yang diperlukan |
| Pengaturan penerimaan dan pemecahan masalah | Solana Stream SDK, contoh konfigurasi, dokumentasi filter, dan FAQ berdasarkan kesalahan | Verifikasi pengaturan efektif, antrean, koneksi ulang, dan pemulihan |
ERPC membantu pengembang melanjutkan pemilihan dan penyetelan infrastruktur, sehingga ada lebih banyak waktu untuk menentukan apa yang diamati, informasi yang dipakai untuk keputusan, dan kapan transaksi dikirim. Dengan layanan dan lokasi yang sesuai, menyelaraskan volume langganan dengan kapasitas pemrosesan mengubah kinerja infrastruktur menjadi kecepatan aplikasi.
Mulailah dengan menentukan informasi yang benar-benar dibutuhkan keputusan Anda. Terima lebih awal, proses tanpa waktu tunggu yang tidak perlu, dan verifikasi hasilnya. ERPC akan terus menyediakan lingkungan dan informasi untuk mendukung perbaikan tersebut.
Sumber daya implementasi
- FAQ gRPC ERPC: https://erpc.global/id/faq/grpc/general/
- Filter langganan dan batas Shared saat ini: https://erpc.global/id/doc/geyser-grpc/filter/
- Praktik terbaik implementasi gRPC: https://erpc.global/id/doc/geyser-grpc/best-practices/
- Solana Stream SDK: https://github.com/ValidatorsDAO/solana-stream
- ERPC VPS: https://erpc.global/id/vps/
- ERPC Bare Metal: https://erpc.global/id/baremetal/
- Dasbor ERPC: https://dashboard.erpc.global/
- Discord resmi Validators DAO: https://discord.gg/C7ZQSrCkYR
Referensi teknis
- RIPE IPmap, visualisasi ketidakefisienan rute: https://ipmap.ripe.net/
- AWS, bandwidth jaringan instans: https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/ec2-instance-network-bandwidth.html
- Linux Kernel, CPU Performance Scaling: https://docs.kernel.org/admin-guide/pm/cpufreq.html
- Node.js, menghindari pemblokiran event loop: https://nodejs.org/en/learn/asynchronous-work/dont-block-the-event-loop
- IETF RFC 9113, kontrol aliran HTTP/2: https://httpwg.org/specs/rfc9113.html#FlowControl
- gRPC, Flow Control: https://grpc.io/docs/guides/flow-control/
- ERPC, pengaturan penerimaan, pembaca lambat, dan retry dalam FAQ gRPC: https://erpc.global/id/faq/grpc/general/
- Yellowstone gRPC, spesifikasi langganan dan filter: https://github.com/rpcpool/yellowstone-grpc
- ERPC, aturan filter Shared saat ini: https://erpc.global/id/doc/geyser-grpc/filter/
- Tokio, antrean dan backpressure: https://tokio.rs/tokio/tutorial/channels
- AWS CloudWatch, definisi persentil: https://docs.aws.amazon.com/AmazonCloudWatch/latest/monitoring/Statistics-definitions.html
- ERPC, Shreds UDP Forwarding: https://erpc.global/id/doc/shredstream/udp-forwarding/
- Solana, Transaction Confirmation & Expiration: https://solana.com/developers/cookbook/transactions/confirmation
- Solana, sendTransaction: https://solana.com/docs/rpc/http/sendtransaction
- Solana, Stake-weighted Quality of Service: https://solana.com/docs/defi/stake-weighted-qos
- Solana, biaya transaksi: https://solana.com/docs/core/fees
- ERPC, konfigurasi dan spesifikasi VPS: https://erpc.global/id/vps/
- ERPC, konfigurasi dan spesifikasi Bare Metal: https://erpc.global/id/baremetal/