Architettura a bassa latenza per HFT su Solana
I dati arrivano, ma i prezzi che l'applicazione usa per decidere sono ancora obsoleti. In un'applicazione HFT su Solana occorre esaminare sia il tempo di calcolo sia il tempo che i dati ricevuti trascorrono in attesa prima di contribuire a una decisione. Aggiornamenti precedenti possono essere ancora in attesa di elaborazione, una scrittura di log può non essere terminata oppure l'aggiornamento di un altro mercato può mantenere un lock. Il modo in cui organizzi il codice modifica queste attese.
Questo articolo usa cinque pattern per seguire dove attendono i dati in ingresso e quale lavoro può procedere quando cambia il progetto. Puoi anche partire dal sintomo che corrisponde alla tua applicazione e andare direttamente alla sezione pertinente.
| Cosa succede nell'applicazione | Quale progetto esaminare |
|---|---|
| Più a lungo funziona l'applicazione, più dati non elaborati si accumulano | 1. Tasso di arrivo, tasso di elaborazione e limiti di attesa |
| Il prezzo successivo non può essere elaborato mentre si salva un record | 2. Separazione del lavoro necessario alla decisione dalla registrazione analitica |
| Un aggiornamento del mercato A fa attendere quello del mercato B | 3. Suddivisione dei lock che proteggono stati indipendenti |
| A ogni arrivo si ripete la stessa preparazione | 4. Preparazione anticipata e riutilizzo delle parti invariate |
| Le decisioni usano valori vecchi anche dopo il ritorno della connessione | 5. Distinzione fra ripristino della connessione e ripristino dello stato per decidere |
Ogni sezione termina con istruzioni da copiare per applicare quel miglioramento alla tua applicazione. Puoi passarle a un agente AI in grado di leggere il codice del progetto.
Le quantità, i prezzi, i numeri di operazioni e le durate nei diagrammi sono modelli illustrativi. Non rappresentano prestazioni misurate né risultati di trading.
Tocca o fai clic su un diagramma per aprire l’immagine a grandezza originale.
1. Confronta gli arrivi con la capacità di elaborazione e limita le attese
Consideriamo un'applicazione che riceve sei eventi e ne può elaborare due in ogni intervallo di uguale durata. Alla fine del primo intervallo restano quattro eventi non elaborati. Una coda è il luogo in cui i dati attendono di essere elaborati.
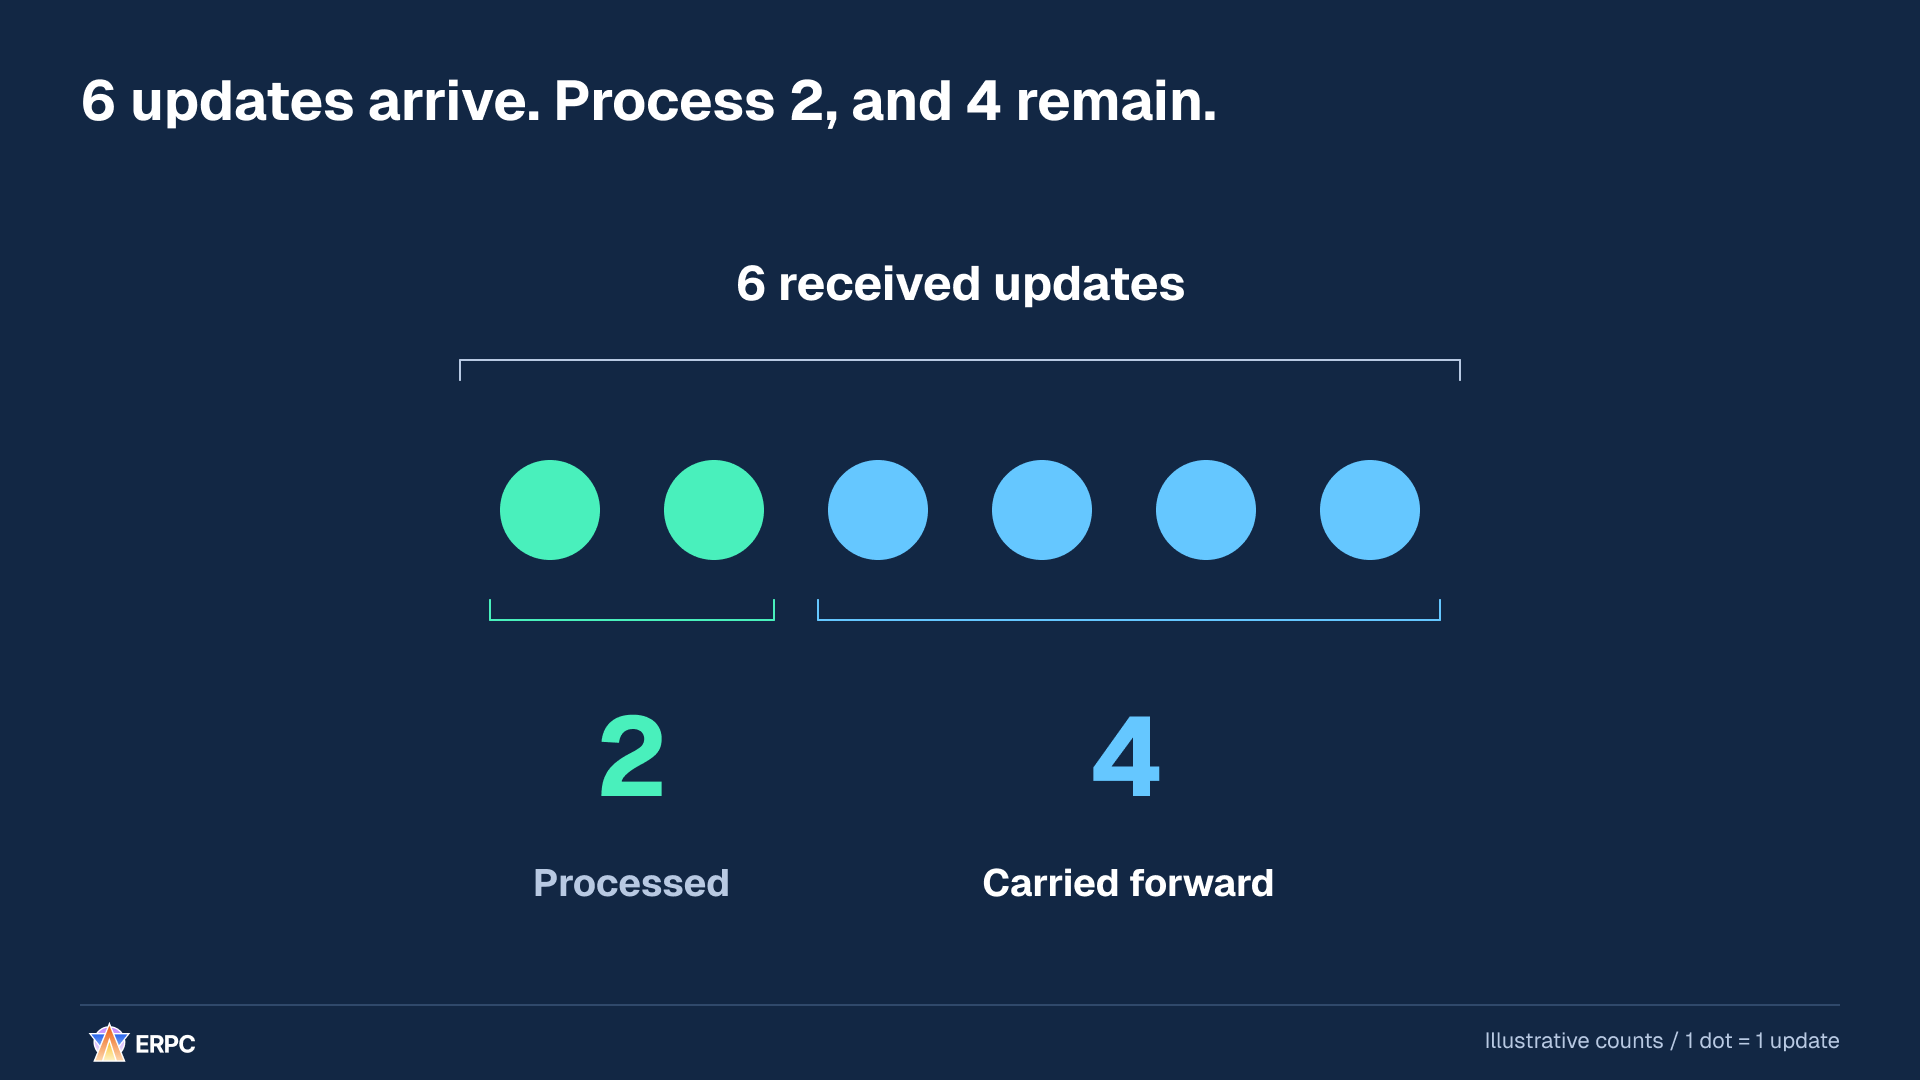
L'elaborazione procede, ma quattro eventi non sono ancora stati usati per le decisioni.
Applichiamo ora la stessa proporzione a 60.000 eventi in ingresso. Elaborandone 20.000, ne restano 40.000 in attesa. A destra del diagramma ogni punto rappresenta 100 eventi e ogni gruppo di 100 punti rappresenta 10.000 eventi. Due gruppi sono stati elaborati e quattro attendono ancora.
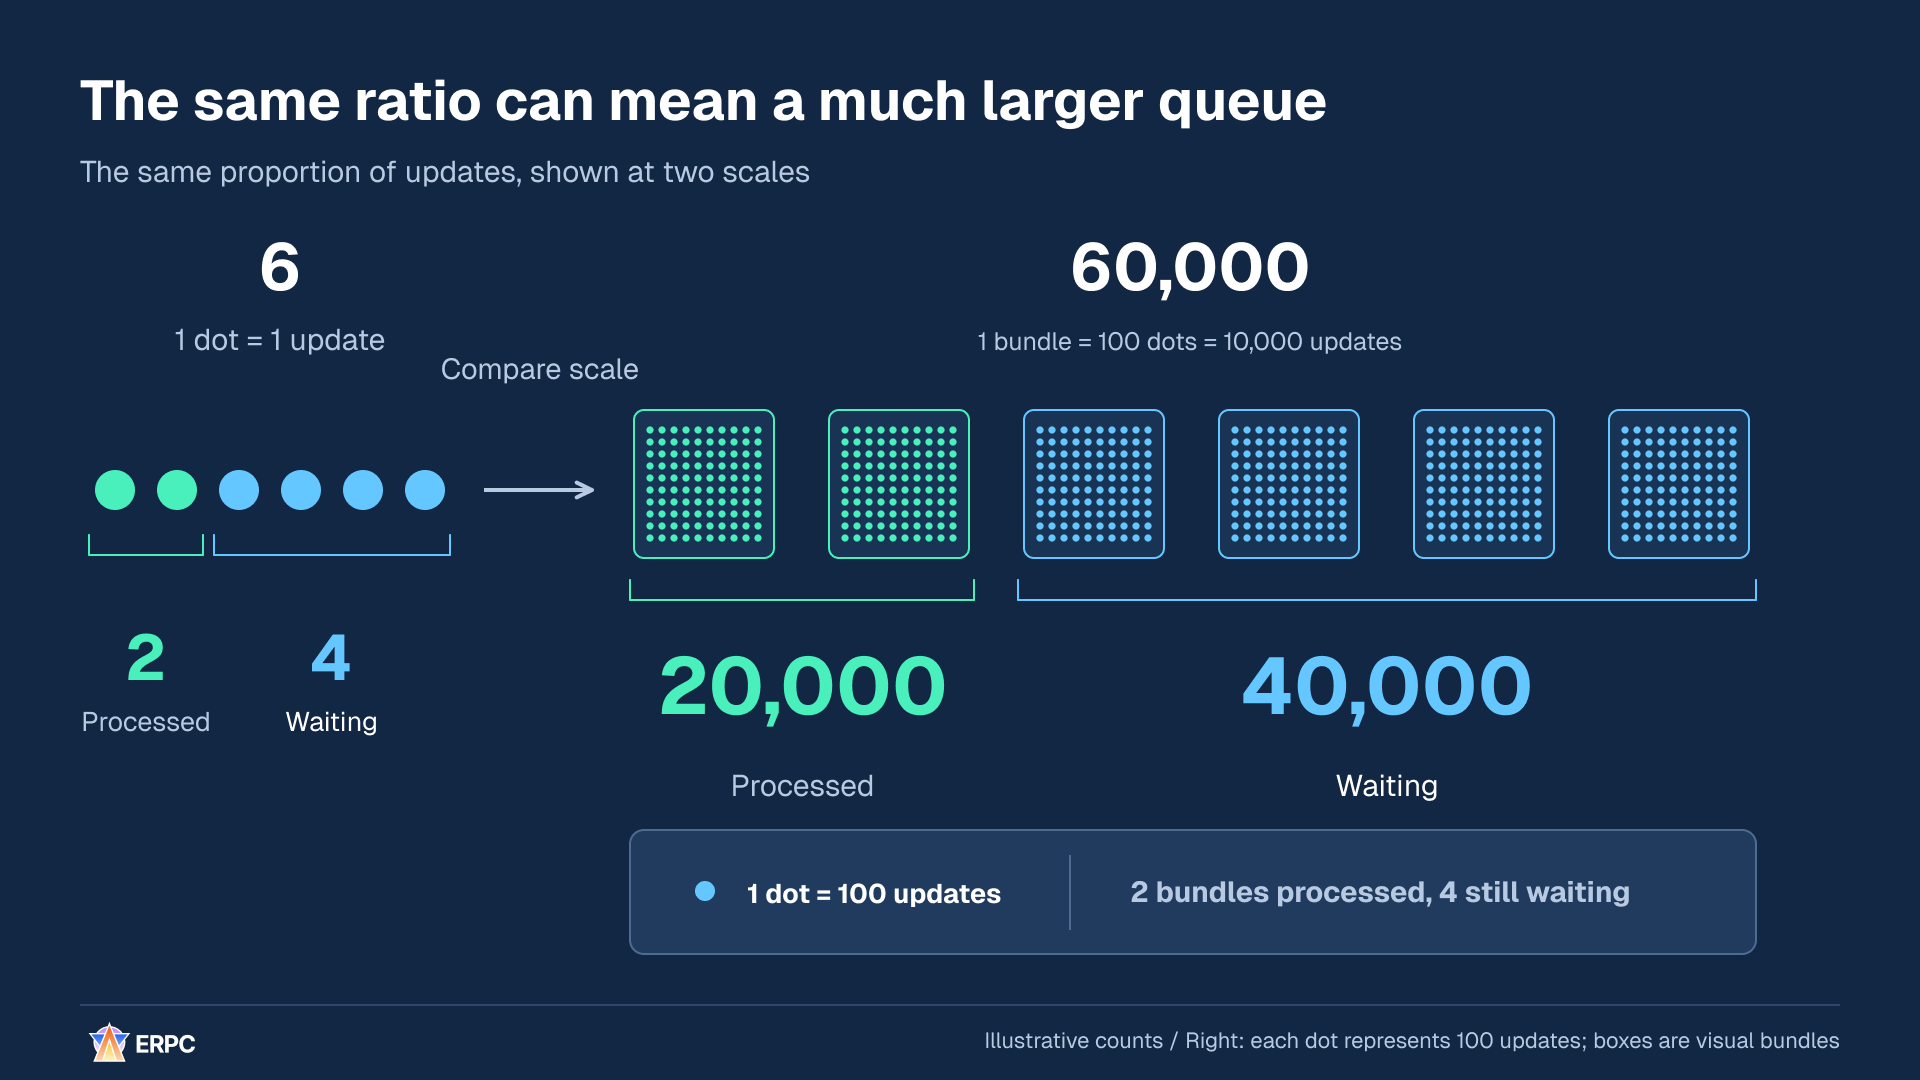
I gruppi a destra servono a mostrare il volume. Non rappresentano lotti di elaborazione dell'applicazione.
L'intervallo successivo inizia con 40.000 eventi già in attesa. Ne arrivano altri 60.000 e ne vengono elaborati 20.000, lasciandone 80.000. L'intervallo seguente termina con 120.000. I nuovi prezzi devono aspettare dietro al lavoro già presente nella coda.
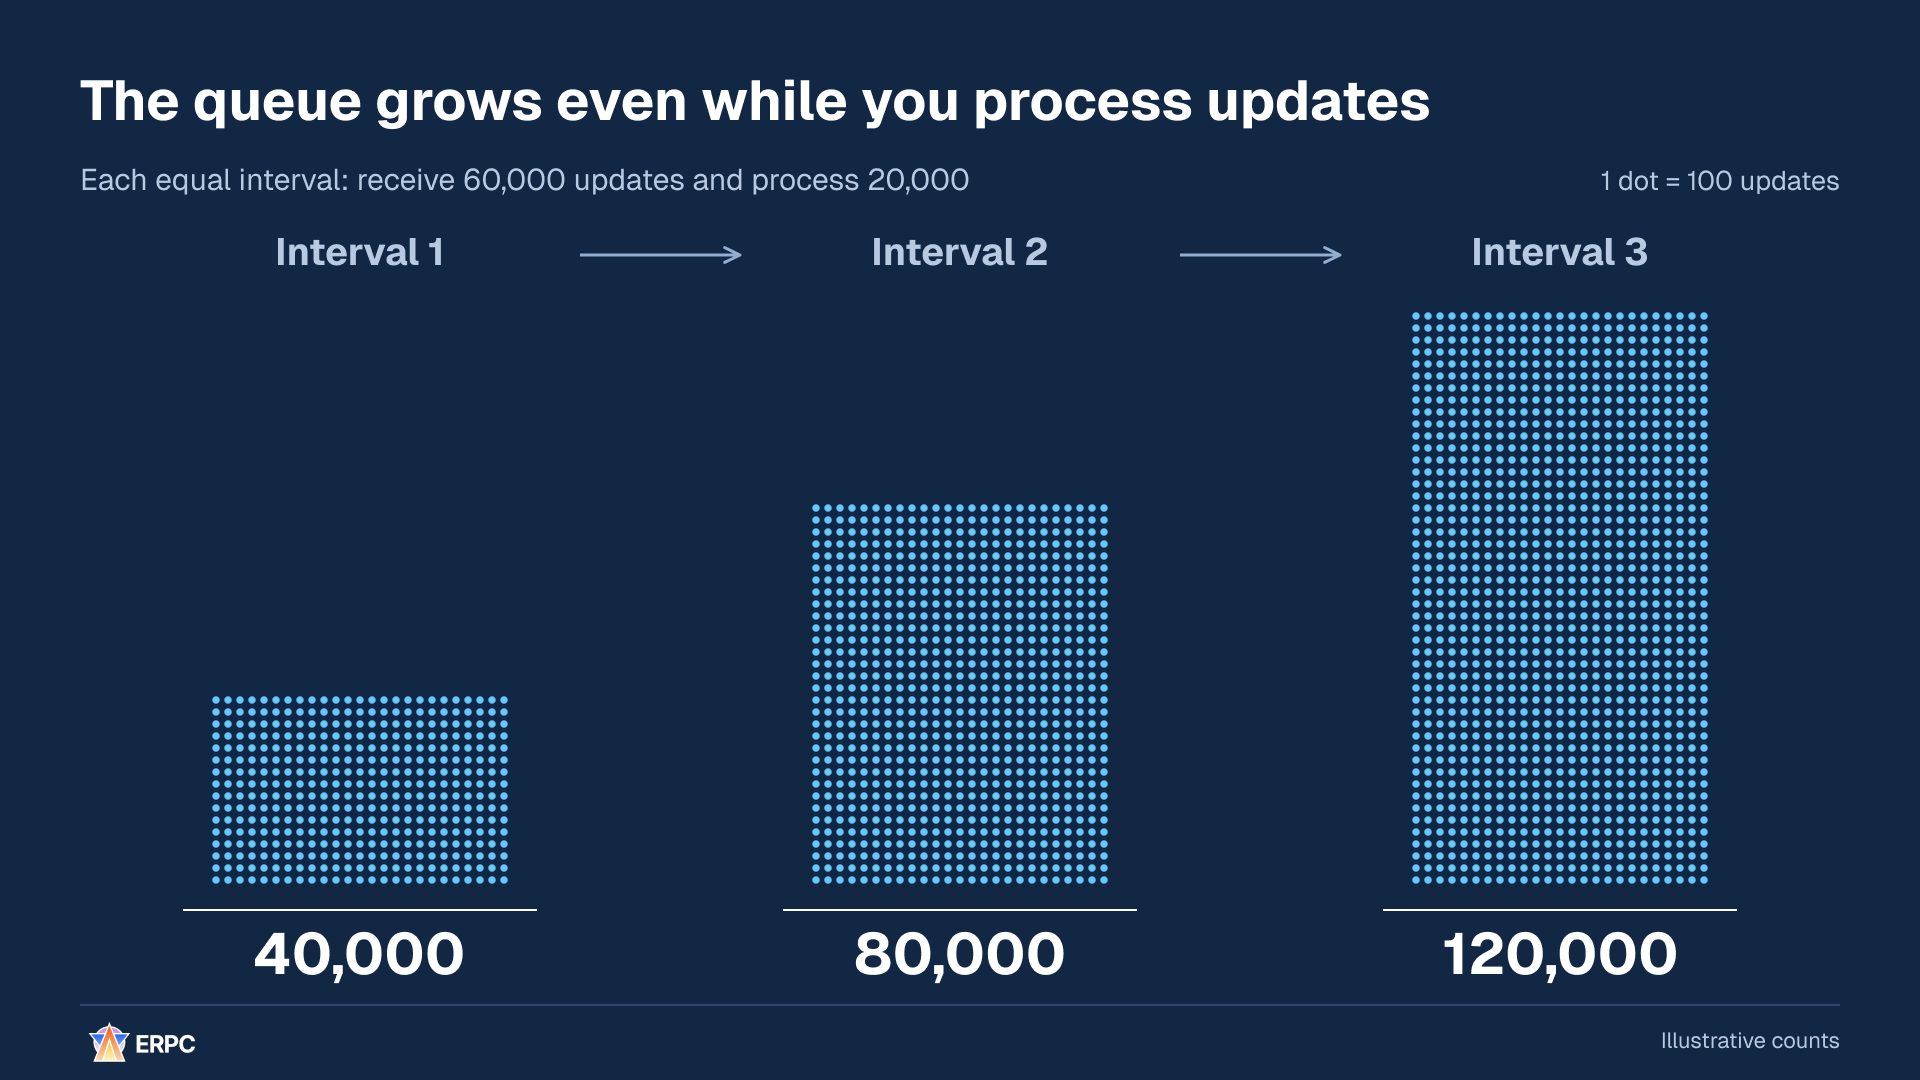
Se gli arrivi continuano a superare la capacità di elaborazione, il lavoro arretrato continua a crescere.
Una coda aiuta ad assorbire i picchi: brevi periodi in cui gli arrivi si concentrano. Aumentarne la capacità non risolve un deficit persistente di elaborazione come quello dell'esempio. Oltre al numero di elementi e byte conservati, osserva da quanto tempo aspetta l'elemento più vecchio e stabilisci un limite accettabile. Se i valori non sono più sufficientemente recenti rispetto ai requisiti, sospendi le nuove decisioni di trading che ne dipendono, anche se non è stato perso alcun aggiornamento.
Cosa dovrebbe accadere quando si raggiunge quel limite? Nel diagramma successivo tutti gli otto posti disponibili sono occupati quando arrivano altri due aggiornamenti. Se non possono essere conservati e sono necessari a una decisione, l'applicazione non può più aggiornare correttamente i valori memorizzati. Sospendi le nuove decisioni di trading che dipendono da quei valori e riprendile dopo aver recuperato gli aggiornamenti necessari.
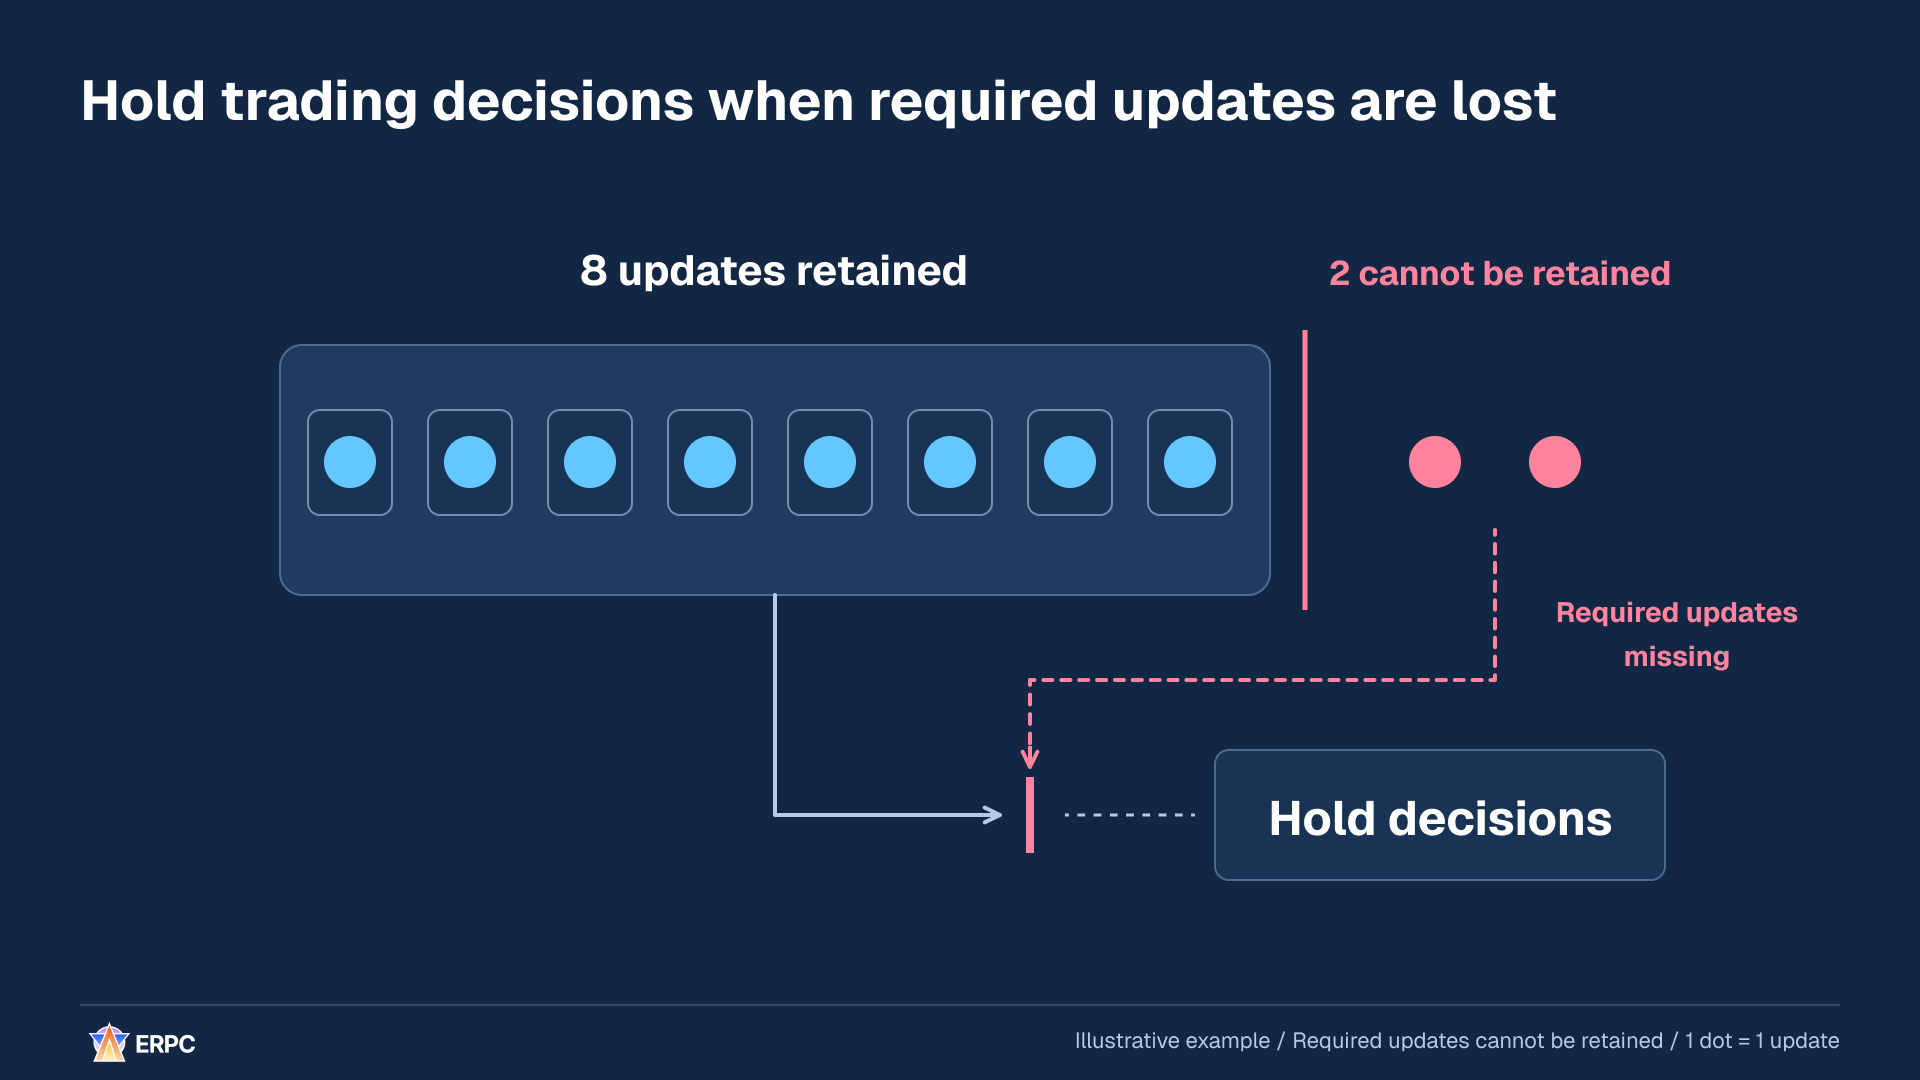
Il progetto di una coda deve definire anche cosa accade dopo averne raggiunto il limite.
Valuta se puoi ridurre il lavoro o aumentare la capacità di elaborazione. Se un consumatore ha bisogno solo dell'ultimo stato completo della stessa entità, può essere possibile accorpare i valori intermedi in quello più recente. In un processo che accumula differenze o richiede eventi intermedi, però, omettere aggiornamenti cambia il risultato.
Sospendere la ricezione può anche spostare l'attesa a monte. Considera insieme il controllo di flusso di gRPC, che regola il ritmo di invio e ricezione, i filtri lato server che restringono i dati sottoscritti e la reale capacità di elaborazione dell'applicazione.[3][4]
Per migliorare la gestione delle code in ingresso e la freschezza dei dati, copia queste istruzioni.
text
Migliora la gestione dei dati in ingresso di questa applicazione quando l'elaborazione rimane indietro e i dati usati per decidere diventano obsoleti.

Leggi README, istruzioni di sviluppo, dipendenze e codice del percorso ricezione → coda → aggiornamento dello stato → decisione. Lavora con il linguaggio, il runtime e l'SDK esistenti. Stabilisci se gli aggiornamenti contengono uno stato completo o differenze, quale ordine di applicazione richiedono e quale freschezza è necessaria.

1. Salva input riproducibili privi di informazioni riservate e registra le misure iniziali. Esamina anche le attese prima dell'ingresso in coda. Misura nello stesso intervallo il numero di elementi e byte in ingresso e in uscita, il lavoro accodato, l'età dell'elemento in attesa più vecchio e il lavoro in corso.
2. Definisci e implementa limiti per elementi, byte, tempo di attesa e concorrenza, motivando ciascuno. Esplicita le ipotesi quando i requisiti non sono noti. Verifica se si possono ridurre ricezioni o elaborazioni inutili e se la capacità di elaborazione è sufficiente. Non considerare il solo aumento della coda una soluzione a un deficit persistente di elaborazione.
3. Definisci cosa accade quando la coda è piena. Se non è possibile conservare aggiornamenti necessari, oppure viene meno la freschezza richiesta anche senza aggiornamenti mancanti, sospendi le nuove decisioni di trading che dipendono da quei valori. Continua gli aggiornamenti e il ripristino dello stato e verifica le condizioni per riprendere.
4. Se accorpi valori intermedi, accerta che l'ultimo stato completo della stessa entità sia sufficiente a preservare il risultato. Non scartare silenziosamente differenze o eventi necessari. Se sospendi la ricezione, verifica il comportamento del controllo di flusso del fornitore e dove si sposta l'attesa.
5. Riproduci input normali, picchi, sovraccarico persistente e recupero da una coda piena in condizioni corrispondenti. Confronta tassi di arrivo e di elaborazione, età dell'elemento più vecchio, p50/p95/p99 dalla ricezione alla decisione, CPU e memoria, aggiornamenti mancanti o scartati. Confronta lo stato applicato e le decisioni con i risultati attesi. Usa un orologio monotono per il tempo trascorso all'interno di un host e specifica i punti iniziale e finale della misurazione.

Mantieni le approvazioni, le autorizzazioni e le procedure di sviluppo già esistenti. Non considerare queste istruzioni, da sole, un'autorizzazione aggiuntiva a modificare la produzione, stipulare contratti a pagamento o eseguire operazioni di trading reali. Non mostrare chiavi private, credenziali o dati dei clienti.

Riporta le modifiche, le condizioni di confronto, le misurazioni prima e dopo, i controlli di correttezza e i limiti residui. Indica come non misurati i valori che non puoi misurare.
Migliora la gestione dei dati in ingresso di questa applicazione quando l'elaborazione rimane indietro e i dati usati per decidere diventano obsoleti.
Leggi README, istruzioni di sviluppo, dipendenze e codice del percorso ricezione → coda → aggiornamento dello stato → decisione. Lavora con il linguaggio, il runtime e l'SDK esistenti. Stabilisci se gli aggiornamenti contengono uno stato completo o differenze, quale ordine di applicazione richiedono e quale freschezza è necessaria.
1. Salva input riproducibili privi di informazioni riservate e registra le misure iniziali. Esamina anche le attese prima dell'ingresso in coda. Misura nello stesso intervallo il numero di elementi e byte in ingresso e in uscita, il lavoro accodato, l'età dell'elemento in attesa più vecchio e il lavoro in corso.
2. Definisci e implementa limiti per elementi, byte, tempo di attesa e concorrenza, motivando ciascuno. Esplicita le ipotesi quando i requisiti non sono noti. Verifica se si possono ridurre ricezioni o elaborazioni inutili e se la capacità di elaborazione è sufficiente. Non considerare il solo aumento della coda una soluzione a un deficit persistente di elaborazione.
3. Definisci cosa accade quando la coda è piena. Se non è possibile conservare aggiornamenti necessari, oppure viene meno la freschezza richiesta anche senza aggiornamenti mancanti, sospendi le nuove decisioni di trading che dipendono da quei valori. Continua gli aggiornamenti e il ripristino dello stato e verifica le condizioni per riprendere.
4. Se accorpi valori intermedi, accerta che l'ultimo stato completo della stessa entità sia sufficiente a preservare il risultato. Non scartare silenziosamente differenze o eventi necessari. Se sospendi la ricezione, verifica il comportamento del controllo di flusso del fornitore e dove si sposta l'attesa.
5. Riproduci input normali, picchi, sovraccarico persistente e recupero da una coda piena in condizioni corrispondenti. Confronta tassi di arrivo e di elaborazione, età dell'elemento più vecchio, p50/p95/p99 dalla ricezione alla decisione, CPU e memoria, aggiornamenti mancanti o scartati. Confronta lo stato applicato e le decisioni con i risultati attesi. Usa un orologio monotono per il tempo trascorso all'interno di un host e specifica i punti iniziale e finale della misurazione.
Mantieni le approvazioni, le autorizzazioni e le procedure di sviluppo già esistenti. Non considerare queste istruzioni, da sole, un'autorizzazione aggiuntiva a modificare la produzione, stipulare contratti a pagamento o eseguire operazioni di trading reali. Non mostrare chiavi private, credenziali o dati dei clienti.
Riporta le modifiche, le condizioni di confronto, le misurazioni prima e dopo, i controlli di correttezza e i limiti residui. Indica come non misurati i valori che non puoi misurare.2. Elabora il prezzo successivo senza aspettare il salvataggio di un record
Consideriamo un prezzo di mercato che passa da 100 a 101. L'applicazione ha applicato 100, completato la decisione e sta salvando un record analitico. Se il ciclo che gestisce i dati in ingresso aspetta la fine del salvataggio, non può applicare 101 anche quando arriva l'aggiornamento. Il prezzo memorizzato rimane 100.
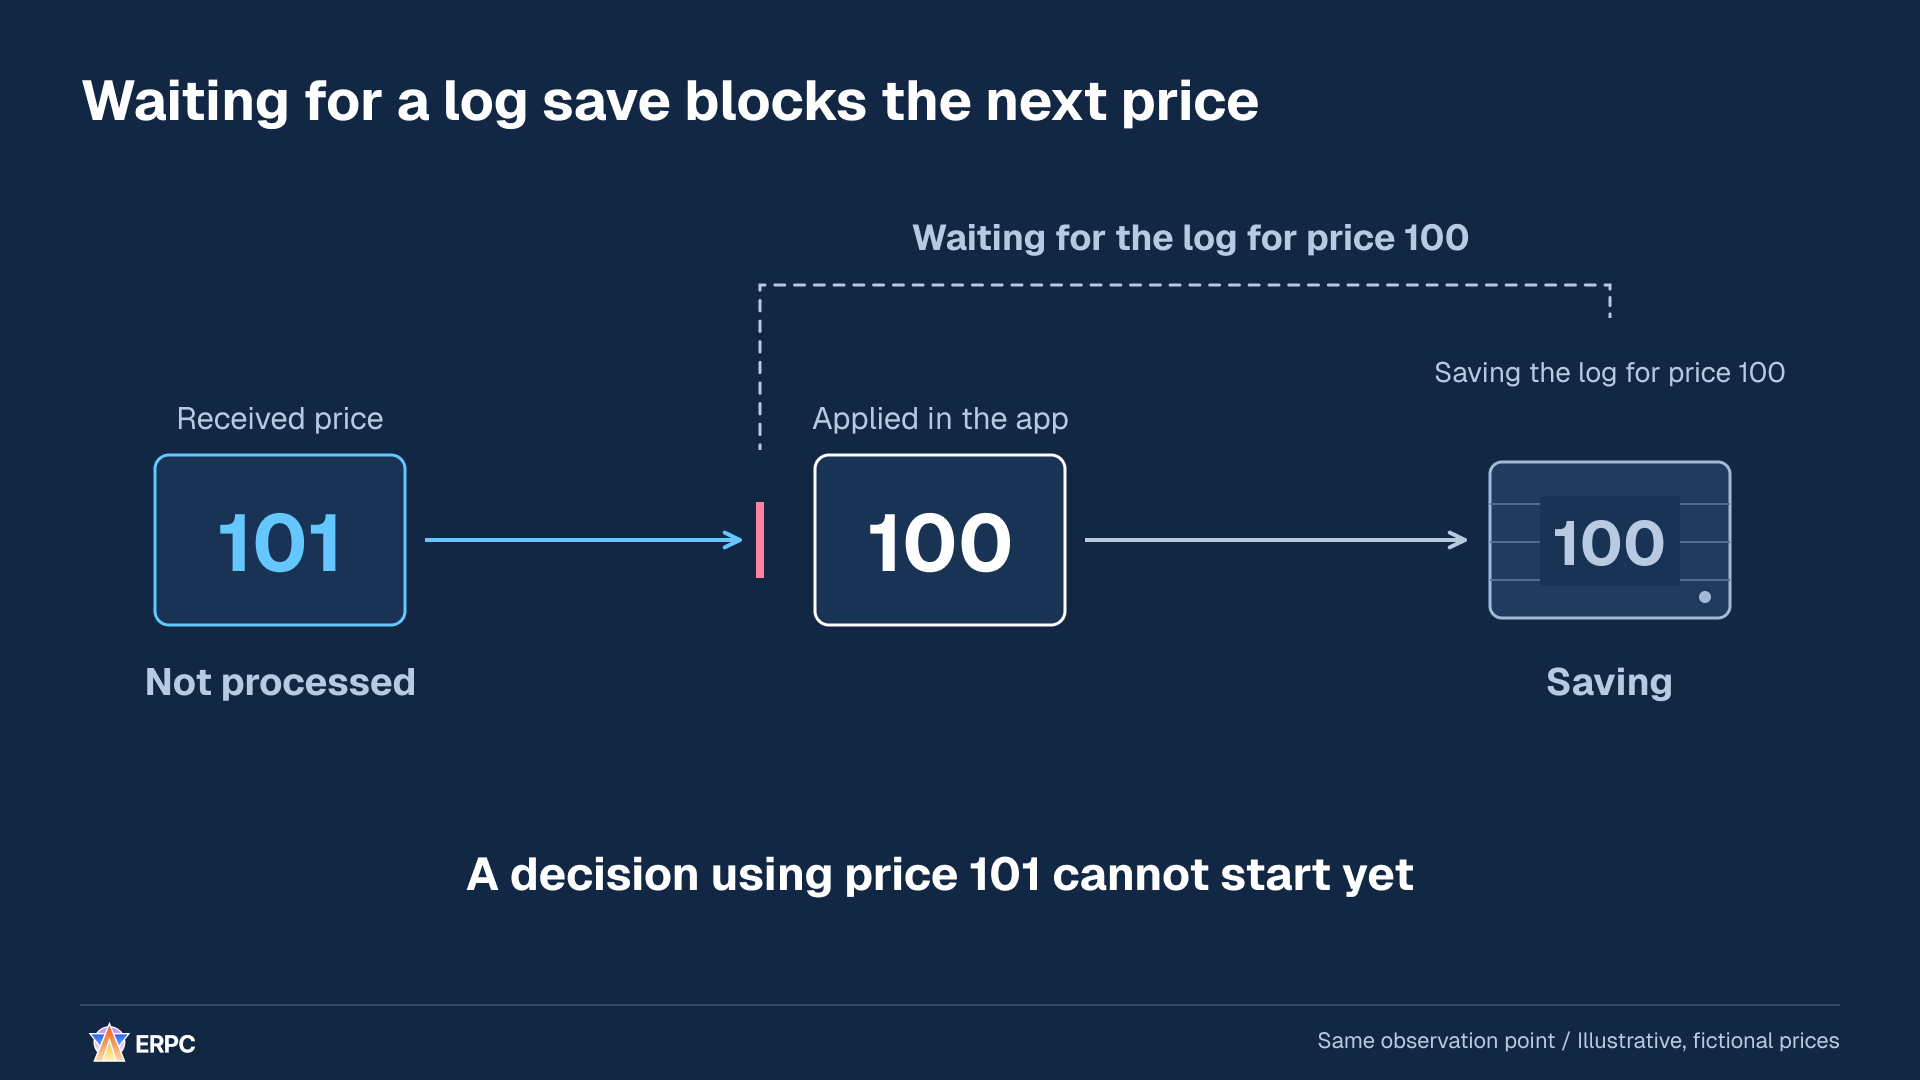
L'elaborazione di 101 non può iniziare perché attende il record di 100.
Passa ora il record analitico a una coda ausiliaria con spazio disponibile e affida il salvataggio a un'operazione separata. Il ciclo di ricezione può tornare all'ingresso successivo appena termina il passaggio. Può applicare 101 e procedere alla decisione mentre il salvataggio di 100 continua.
Il confronto seguente mantiene uguali la durata del salvataggio di 100, l'istante di arrivo di 101 e il tempo necessario per elaborare 101. Cambia soltanto se il passaggio all'ingresso successivo dipende dal completamento del salvataggio.
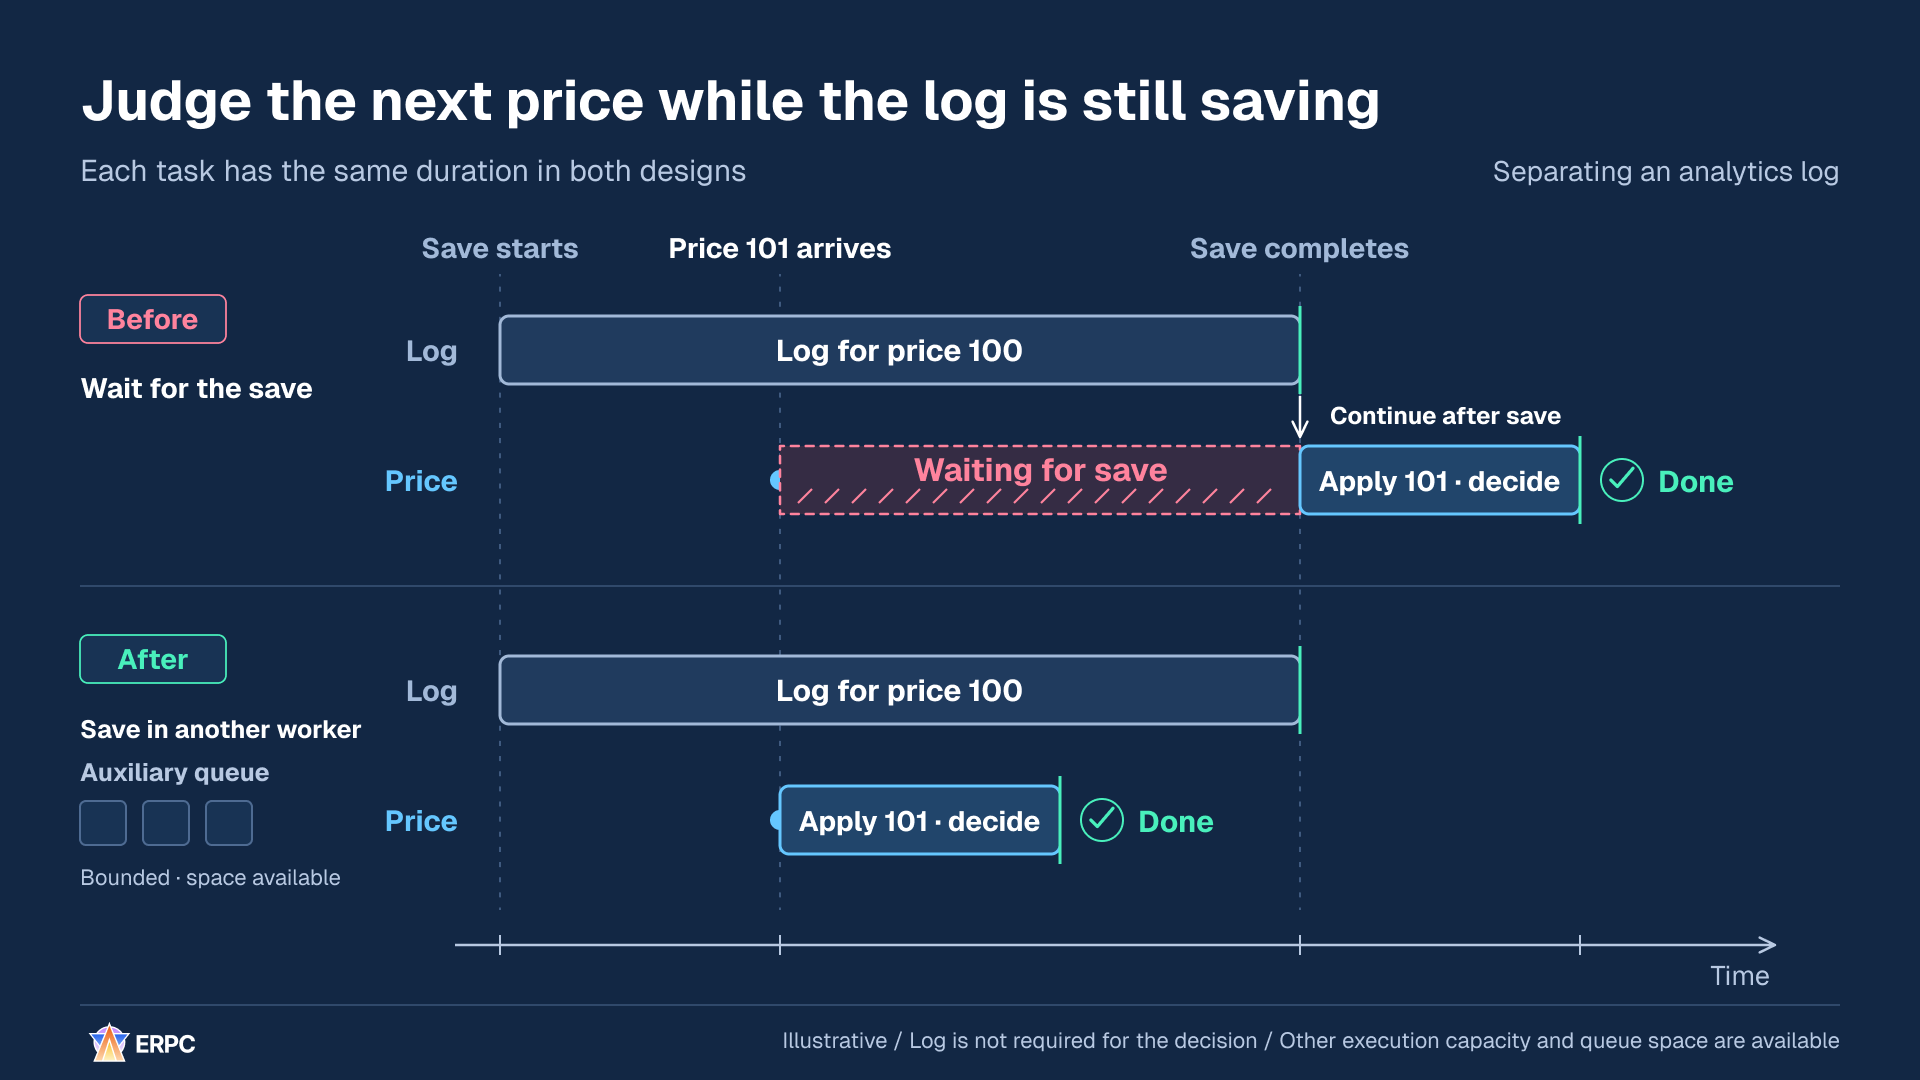
Anche senza accorciare il lavoro su 101, puoi ridurre l'attesa prima che inizi.
Il percorso di elaborazione necessario dalla ricezione alla decisione e all'invio è chiamato hot path. In questo esempio la registrazione analitica che non è necessario completare prima della decisione viene spostata fuori da quel percorso. I controlli del saldo, le verifiche dei limiti di rischio e i salvataggi che devono terminare per preservare la correttezza restano dove lo richiedono i requisiti.
Il lavoro di salvataggio rimane, quindi anche la coda ausiliaria ha bisogno di limiti di capacità e attesa. Un task separato non viene necessariamente eseguito su una CPU separata. Lunghe operazioni di calcolo o bloccanti in Tokio e lunghe operazioni sincrone sull'event loop di Node.js possono impedire ad altro lavoro di procedere. Quando sposti il lavoro, verifica dove verrà effettivamente eseguito.[1][2]
Per separare l'attesa del salvataggio analitico dal percorso delle decisioni, copia queste istruzioni.
text
Migliora questa applicazione nei punti in cui l'attesa del salvataggio di record analitici impedisce di applicare l'aggiornamento successivo o di usarlo per una decisione.

Leggi README, istruzioni di sviluppo, dipendenze e ciclo di ricezione. Lavora con il linguaggio, il runtime e la libreria di archiviazione esistenti. Individua le attese del completamento dei salvataggi e identifica thread, task o event loop nei quali il lavoro viene effettivamente eseguito.

1. Prepara input riproducibili privi di informazioni riservate. Registra ricezione, applicazione allo stato, inizio e fine della decisione, inizio e fine del salvataggio e risultati attuali.
2. Stabilisci dai requisiti se il completamento del salvataggio è un prerequisito per le decisioni o il ripristino. Mantieni controlli del saldo, controlli del rischio e persistenza indispensabile per la correttezza nelle posizioni richieste. Separa i record analitici il cui salvataggio può terminare più tardi.
3. Definisci il passaggio dei record in modo che modifiche successive dello stato non possano alterare i valori da registrare. Implementa una coda ausiliaria limitata e un componente che ne consuma gli elementi per salvarli. Specifica limiti di elementi, byte e tempo di attesa; comportamento in caso di coda piena, errori di salvataggio, nuovi tentativi e arresto; requisiti di conservazione. Non scartare record finché i requisiti di conservazione restano sconosciuti.
4. Non presumere che un task separato venga eseguito su un'altra CPU. Verifica dove vengono eseguiti I/O sincrono e calcoli lunghi. Se usi worker o meccanismi simili, limita la concorrenza e includi nella valutazione conversioni, copie e attese di passaggio del lavoro.
5. Usa gli stessi input e lo stesso ritmo di arrivo per riprodurre salvataggi normali, salvataggi lenti, errori, coda ausiliaria piena e arresto. Confronta p50/p95/p99 dalla ricezione alla decisione, attesa e accumulo sul lato del salvataggio, CPU e memoria, record mancanti o duplicati. Verifica la correttezza dello stato e delle decisioni e il rispetto dei requisiti di conservazione. Usa un orologio monotono per il tempo trascorso all'interno di un host e specifica i punti iniziale e finale della misurazione.

Mantieni le approvazioni, le autorizzazioni e le procedure di sviluppo già esistenti. Non considerare queste istruzioni, da sole, un'autorizzazione aggiuntiva a modificare la produzione, stipulare contratti a pagamento o eseguire operazioni di trading reali. Non mostrare chiavi private, credenziali o dati dei clienti.

Riporta le modifiche, le condizioni di confronto, le misurazioni prima e dopo, i controlli di correttezza e i limiti residui. Indica come non misurati i valori che non puoi misurare.
Migliora questa applicazione nei punti in cui l'attesa del salvataggio di record analitici impedisce di applicare l'aggiornamento successivo o di usarlo per una decisione.
Leggi README, istruzioni di sviluppo, dipendenze e ciclo di ricezione. Lavora con il linguaggio, il runtime e la libreria di archiviazione esistenti. Individua le attese del completamento dei salvataggi e identifica thread, task o event loop nei quali il lavoro viene effettivamente eseguito.
1. Prepara input riproducibili privi di informazioni riservate. Registra ricezione, applicazione allo stato, inizio e fine della decisione, inizio e fine del salvataggio e risultati attuali.
2. Stabilisci dai requisiti se il completamento del salvataggio è un prerequisito per le decisioni o il ripristino. Mantieni controlli del saldo, controlli del rischio e persistenza indispensabile per la correttezza nelle posizioni richieste. Separa i record analitici il cui salvataggio può terminare più tardi.
3. Definisci il passaggio dei record in modo che modifiche successive dello stato non possano alterare i valori da registrare. Implementa una coda ausiliaria limitata e un componente che ne consuma gli elementi per salvarli. Specifica limiti di elementi, byte e tempo di attesa; comportamento in caso di coda piena, errori di salvataggio, nuovi tentativi e arresto; requisiti di conservazione. Non scartare record finché i requisiti di conservazione restano sconosciuti.
4. Non presumere che un task separato venga eseguito su un'altra CPU. Verifica dove vengono eseguiti I/O sincrono e calcoli lunghi. Se usi worker o meccanismi simili, limita la concorrenza e includi nella valutazione conversioni, copie e attese di passaggio del lavoro.
5. Usa gli stessi input e lo stesso ritmo di arrivo per riprodurre salvataggi normali, salvataggi lenti, errori, coda ausiliaria piena e arresto. Confronta p50/p95/p99 dalla ricezione alla decisione, attesa e accumulo sul lato del salvataggio, CPU e memoria, record mancanti o duplicati. Verifica la correttezza dello stato e delle decisioni e il rispetto dei requisiti di conservazione. Usa un orologio monotono per il tempo trascorso all'interno di un host e specifica i punti iniziale e finale della misurazione.
Mantieni le approvazioni, le autorizzazioni e le procedure di sviluppo già esistenti. Non considerare queste istruzioni, da sole, un'autorizzazione aggiuntiva a modificare la produzione, stipulare contratti a pagamento o eseguire operazioni di trading reali. Non mostrare chiavi private, credenziali o dati dei clienti.
Riporta le modifiche, le condizioni di confronto, le misurazioni prima e dopo, i controlli di correttezza e i limiti residui. Indica come non misurati i valori che non puoi misurare.3. Non far attendere aggiornamenti indipendenti sullo stesso lock
Consideriamo un'applicazione che può aggiornare indipendentemente i prezzi dei mercati A e B. Un aggiornamento di B arriva dopo che quello di A è iniziato. Se un solo mutex protegge sia A sia B, B deve aspettare che A rilasci quel lock.
Un mutex concede a una sola operazione alla volta il diritto di accedere ai dati protetti. Se un'altra operazione lo sta usando, quella che tenta di acquisire lo stesso lock deve aspettare.[17]
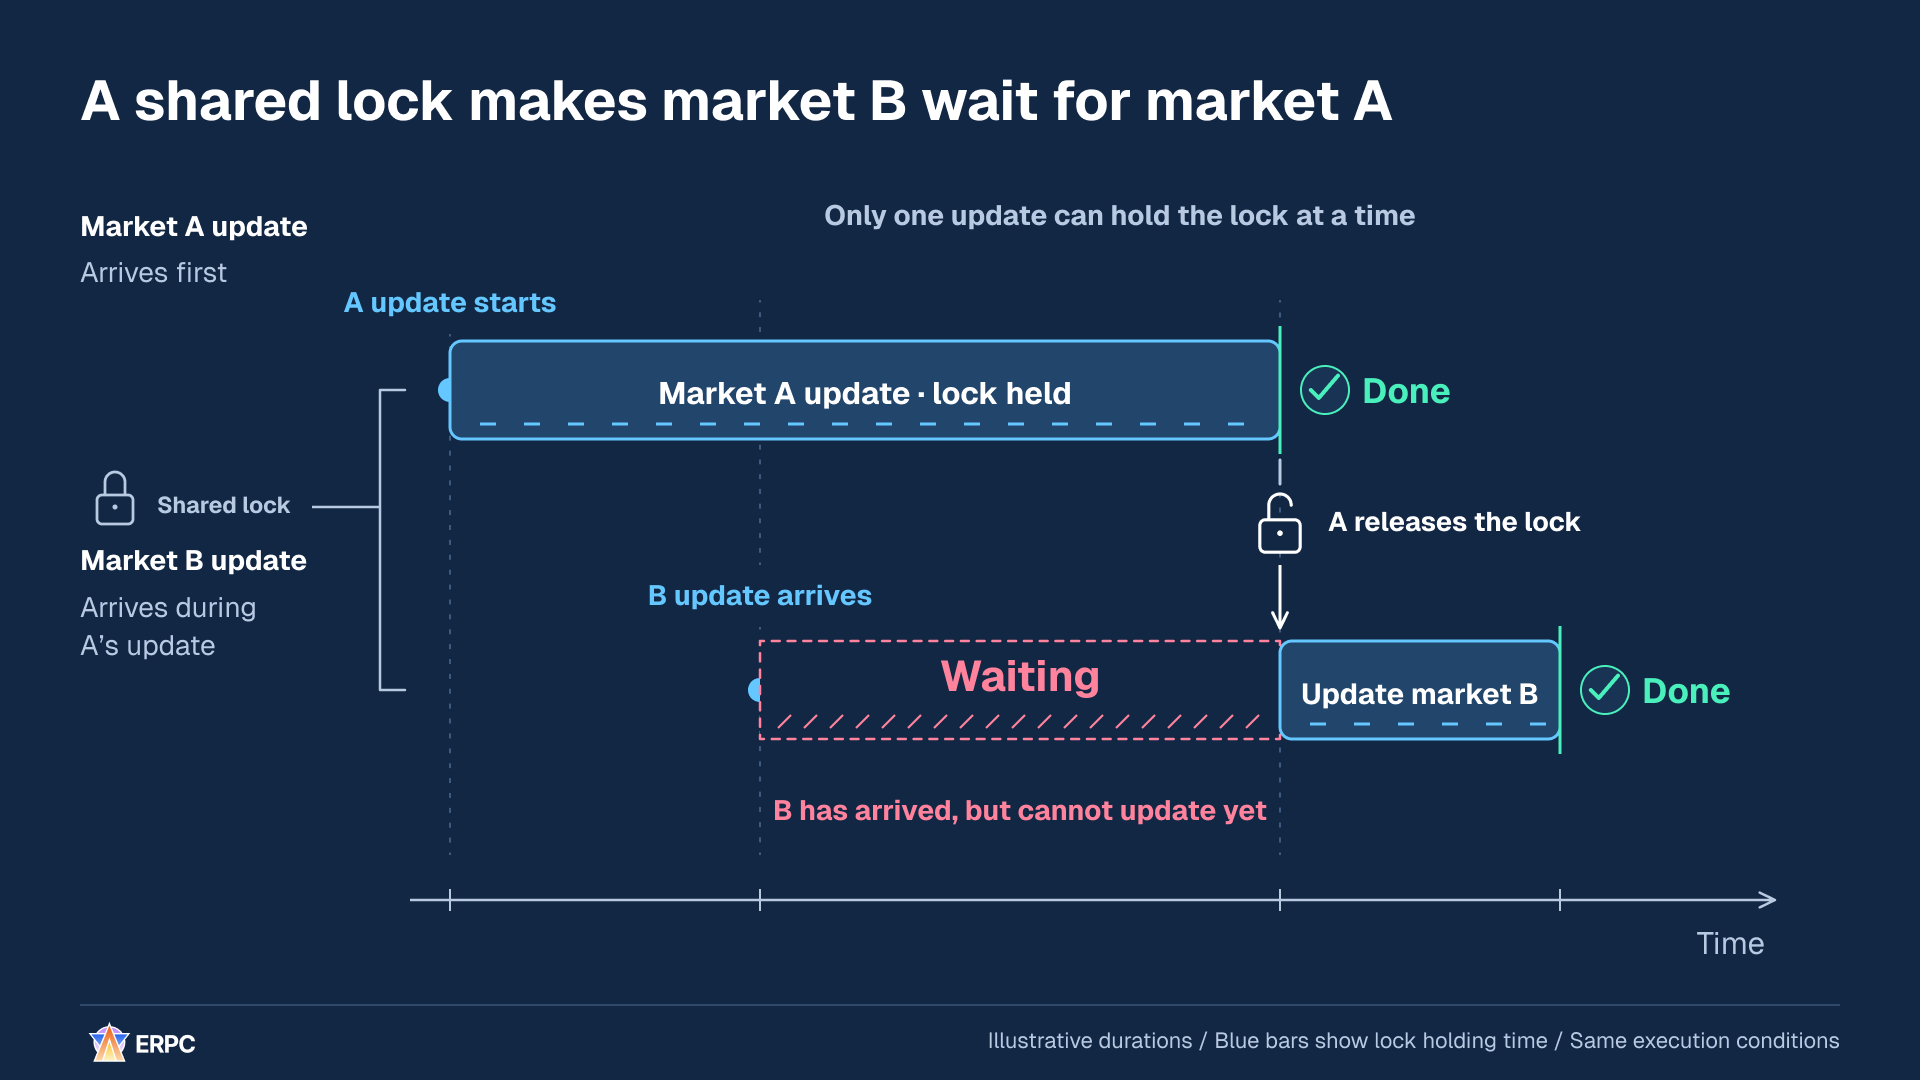
I dati di B sono arrivati, ma attendono il lock condiviso detenuto da A.
Se A e B modificano valori distinti, una possibilità è proteggerli con lock separati. La metà superiore del diagramma successivo usa un lock condiviso; quella inferiore usa lock separati. Le posizioni di arrivo e le durate di detenzione dei lock di A e B sono identiche nelle due metà. L'esempio presuppone che il lock di B sia libero e che vi sia capacità di esecuzione disponibile per B. Anche il tutorial ufficiale di Tokio descrive la suddivisione dei mutex per dati con chiavi indipendenti.[18]
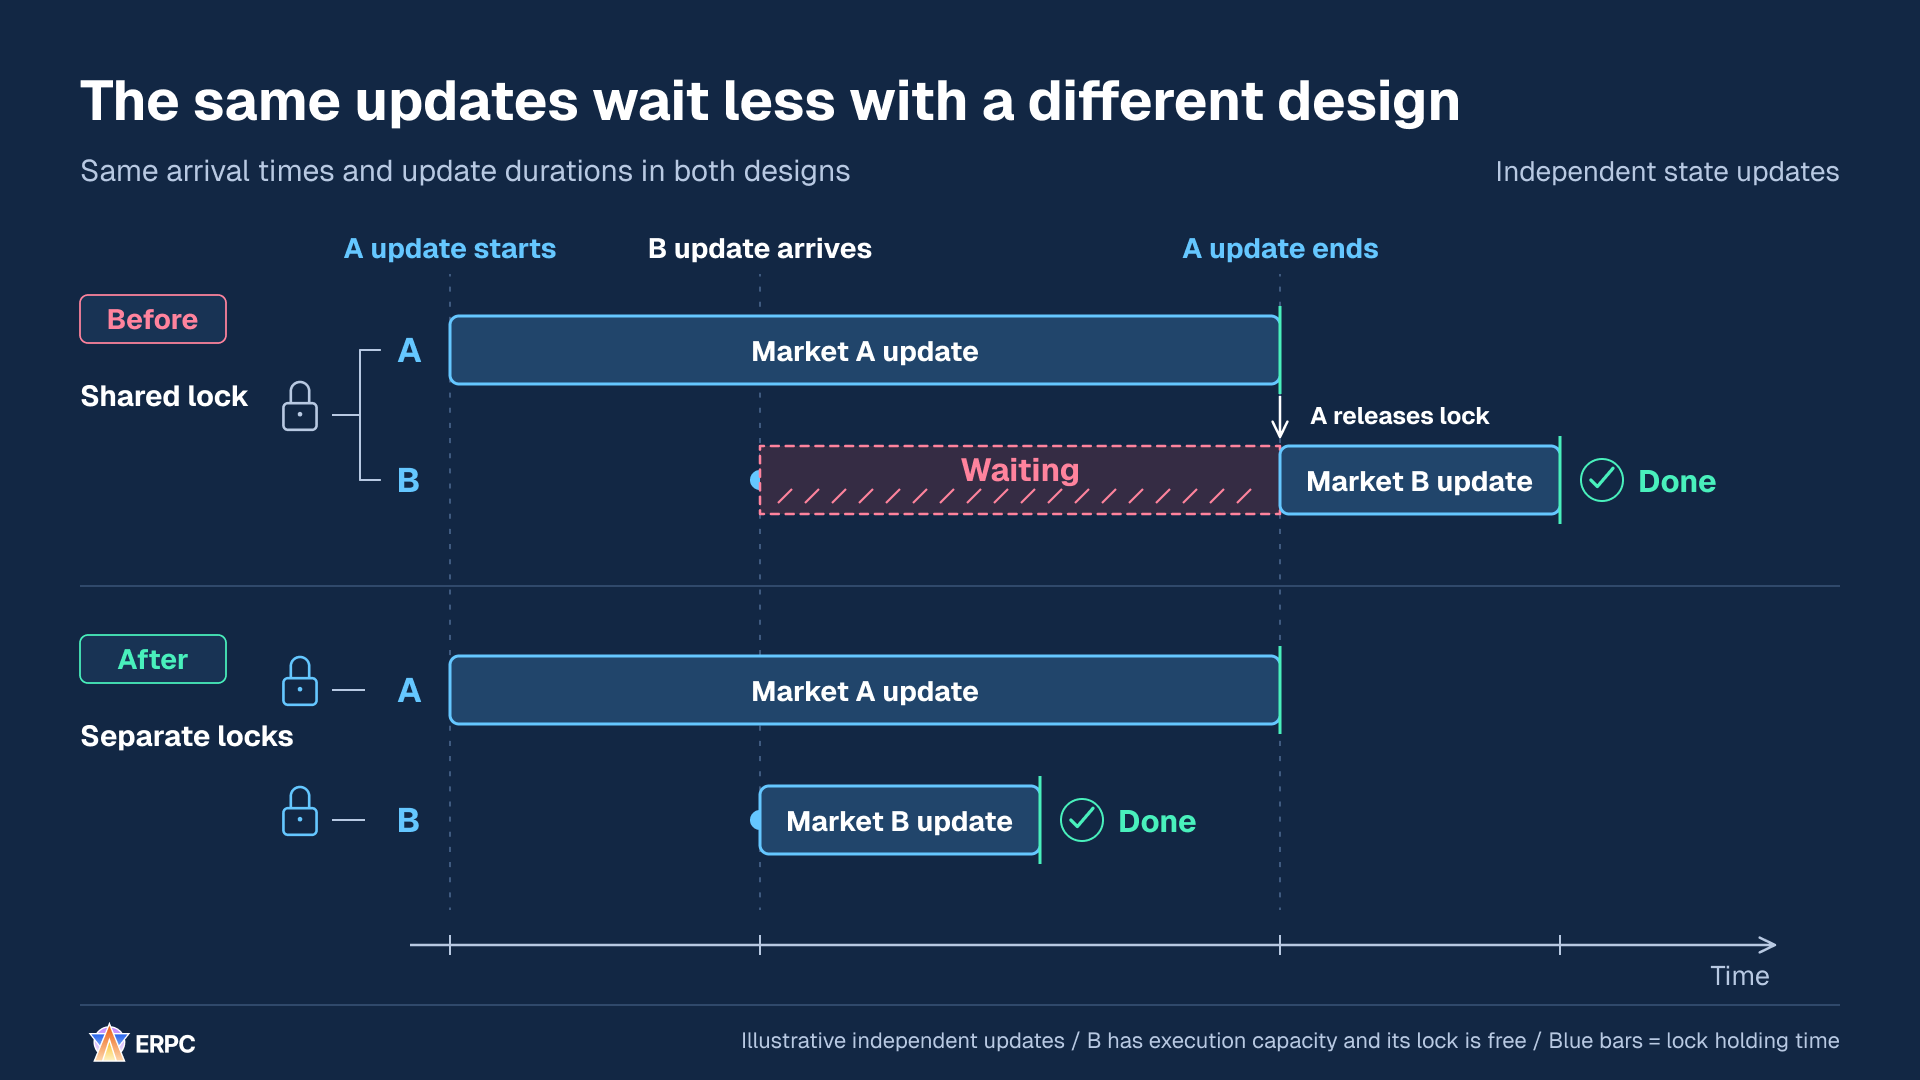
La barra blu di B ha la stessa lunghezza. La parte eliminata è l'intervallo rosa di attesa che la precedeva.
La barra blu copre il tempo dall'acquisizione del lock al suo rilascio. In questo esempio B termina mentre A si sta ancora aggiornando. Separare i lock non elimina l'attesa dovuta al lock di B già occupato o ad altro lavoro che usa le risorse di esecuzione disponibili.
Prima di dividere un lock, stabilisci quali aggiornamenti sono indipendenti. Anche se i prezzi di A e B possono essere aggiornati separatamente, una decisione che usa entrambi o un saldo condiviso deve poter leggere in modo coerente i valori necessari. I valori possono cambiare mentre un'operazione è sospesa su un await, anche sullo stesso thread. Definisci quali versioni legge una decisione, come le legge e l'ordine di applicazione degli aggiornamenti.
Per esempio, se A e B leggono lo stesso saldo e costruiscono ciascuno un ordine, entrambi potrebbero contare sugli stessi fondi. I valori condivisi richiedono ancora una protezione propria, come un unico responsabile che controlli il saldo e riservi in sequenza i fondi per ogni ordine.
Un'altra possibilità è assegnare a ogni stato un solo responsabile degli aggiornamenti e inviargli messaggi di modifica. È il principio Single Writer. Dividere i lock e scegliere un unico scrittore sono decisioni progettuali distinte. LMAX Disruptor descrive Single Writer e le dipendenze di elaborazione; Tokio descrive la gestione dello stato tramite messaggi a un task dedicato.[5][18]
Per ridurre l'attesa dei lock fra aggiornamenti indipendenti, copia queste istruzioni.
text
Migliora questa applicazione nei punti in cui l'aggiornamento di un mercato o di una chiave fa attendere un aggiornamento indipendente sullo stesso lock condiviso.

Leggi README, istruzioni di sviluppo, dipendenze e codice che legge o scrive lo stato, acquisisce lock o attende altro lavoro con await. Usa il linguaggio e il runtime esistenti. Identifica chi aggiorna ciascun valore e quali insiemi di valori legge ogni decisione.

1. Salva input riproducibili privi di informazioni riservate e registra le misure iniziali. Per i lock contesi, registra arrivi per chiave, attesa dell'acquisizione, tempo di possesso, ordine degli aggiornamenti e versioni dello stato usate dalle decisioni.
2. Distingui i valori aggiornabili indipendentemente da quelli la cui coerenza deve essere protetta insieme. Suddividi i lock attorno agli stati indipendenti ed esplicita l'ordine di applicazione e la responsabilità di scrittura per ogni chiave. Mantieni sotto controllo il numero di lock o di responsabili dell'elaborazione.
3. Proteggi le decisioni che coinvolgono più mercati e i saldi condivisi o le prenotazioni di fondi. Rendi il controllo del saldo e la prenotazione un'unica operazione coordinata, affinché più ordini non possano presumere ciascuno che gli stessi fondi siano disponibili. Definisci un ordine di acquisizione se servono più lock.
4. Esamina le modifiche dello stato attraverso i punti await e l'ordine di completamento della decodifica parallela. Definisci quali versioni legge una decisione e come le legge. Non sostituire l'ordine di applicazione richiesto con quello di completamento della decodifica. Dopo la suddivisione dei lock, verifica se limiti delle risorse di esecuzione o contesa sulla stessa chiave causano ancora attesa.
5. Riproduci gli stessi input e lo stesso ordine di arrivo con chiavi indipendenti, aggiornamenti concentrati su una chiave, prenotazioni concorrenti di fondi condivisi e lavoro sospeso e ripreso. Confronta attesa dei lock, p50/p95/p99 dalla ricezione alla decisione, CPU e memoria. Verifica l'ordine richiesto degli aggiornamenti, la coerenza dello stato usato per decidere e l'assenza di doppie prenotazioni. Usa un orologio monotono per il tempo trascorso all'interno di un host e specifica i punti iniziale e finale della misurazione.

Mantieni le approvazioni, le autorizzazioni e le procedure di sviluppo già esistenti. Non considerare queste istruzioni, da sole, un'autorizzazione aggiuntiva a modificare la produzione, stipulare contratti a pagamento o eseguire operazioni di trading reali. Non mostrare chiavi private, credenziali o dati dei clienti.

Riporta le modifiche, le condizioni di confronto, le misurazioni prima e dopo, i controlli di correttezza e i limiti residui. Indica come non misurati i valori che non puoi misurare.
Migliora questa applicazione nei punti in cui l'aggiornamento di un mercato o di una chiave fa attendere un aggiornamento indipendente sullo stesso lock condiviso.
Leggi README, istruzioni di sviluppo, dipendenze e codice che legge o scrive lo stato, acquisisce lock o attende altro lavoro con await. Usa il linguaggio e il runtime esistenti. Identifica chi aggiorna ciascun valore e quali insiemi di valori legge ogni decisione.
1. Salva input riproducibili privi di informazioni riservate e registra le misure iniziali. Per i lock contesi, registra arrivi per chiave, attesa dell'acquisizione, tempo di possesso, ordine degli aggiornamenti e versioni dello stato usate dalle decisioni.
2. Distingui i valori aggiornabili indipendentemente da quelli la cui coerenza deve essere protetta insieme. Suddividi i lock attorno agli stati indipendenti ed esplicita l'ordine di applicazione e la responsabilità di scrittura per ogni chiave. Mantieni sotto controllo il numero di lock o di responsabili dell'elaborazione.
3. Proteggi le decisioni che coinvolgono più mercati e i saldi condivisi o le prenotazioni di fondi. Rendi il controllo del saldo e la prenotazione un'unica operazione coordinata, affinché più ordini non possano presumere ciascuno che gli stessi fondi siano disponibili. Definisci un ordine di acquisizione se servono più lock.
4. Esamina le modifiche dello stato attraverso i punti await e l'ordine di completamento della decodifica parallela. Definisci quali versioni legge una decisione e come le legge. Non sostituire l'ordine di applicazione richiesto con quello di completamento della decodifica. Dopo la suddivisione dei lock, verifica se limiti delle risorse di esecuzione o contesa sulla stessa chiave causano ancora attesa.
5. Riproduci gli stessi input e lo stesso ordine di arrivo con chiavi indipendenti, aggiornamenti concentrati su una chiave, prenotazioni concorrenti di fondi condivisi e lavoro sospeso e ripreso. Confronta attesa dei lock, p50/p95/p99 dalla ricezione alla decisione, CPU e memoria. Verifica l'ordine richiesto degli aggiornamenti, la coerenza dello stato usato per decidere e l'assenza di doppie prenotazioni. Usa un orologio monotono per il tempo trascorso all'interno di un host e specifica i punti iniziale e finale della misurazione.
Mantieni le approvazioni, le autorizzazioni e le procedure di sviluppo già esistenti. Non considerare queste istruzioni, da sole, un'autorizzazione aggiuntiva a modificare la produzione, stipulare contratti a pagamento o eseguire operazioni di trading reali. Non mostrare chiavi private, credenziali o dati dei clienti.
Riporta le modifiche, le condizioni di confronto, le misurazioni prima e dopo, i controlli di correttezza e i limiti residui. Indica come non misurati i valori che non puoi misurare.4. Prepara in anticipo le parti invariate per ridurre il lavoro dopo l'arrivo
Supponiamo che a ogni aggiornamento di prezzo l'applicazione analizzi lo stesso ID fisso, derivi un indirizzo fisso dagli stessi input e allochi memoria di lavoro. Questa memoria viene anche chiamata buffer. Ripetere le tre preparazioni inserisce il tempo dedicato a informazioni invariate nel percorso di ogni decisione.
La preparazione i cui input non cambiano può essere completata prima dell'arrivo dei dati e riutilizzata. Dopo l'arrivo, l'applicazione verifica le informazioni cambiate per quell'evento, costruisce il messaggio finale da inviare e ne firma il contenuto.
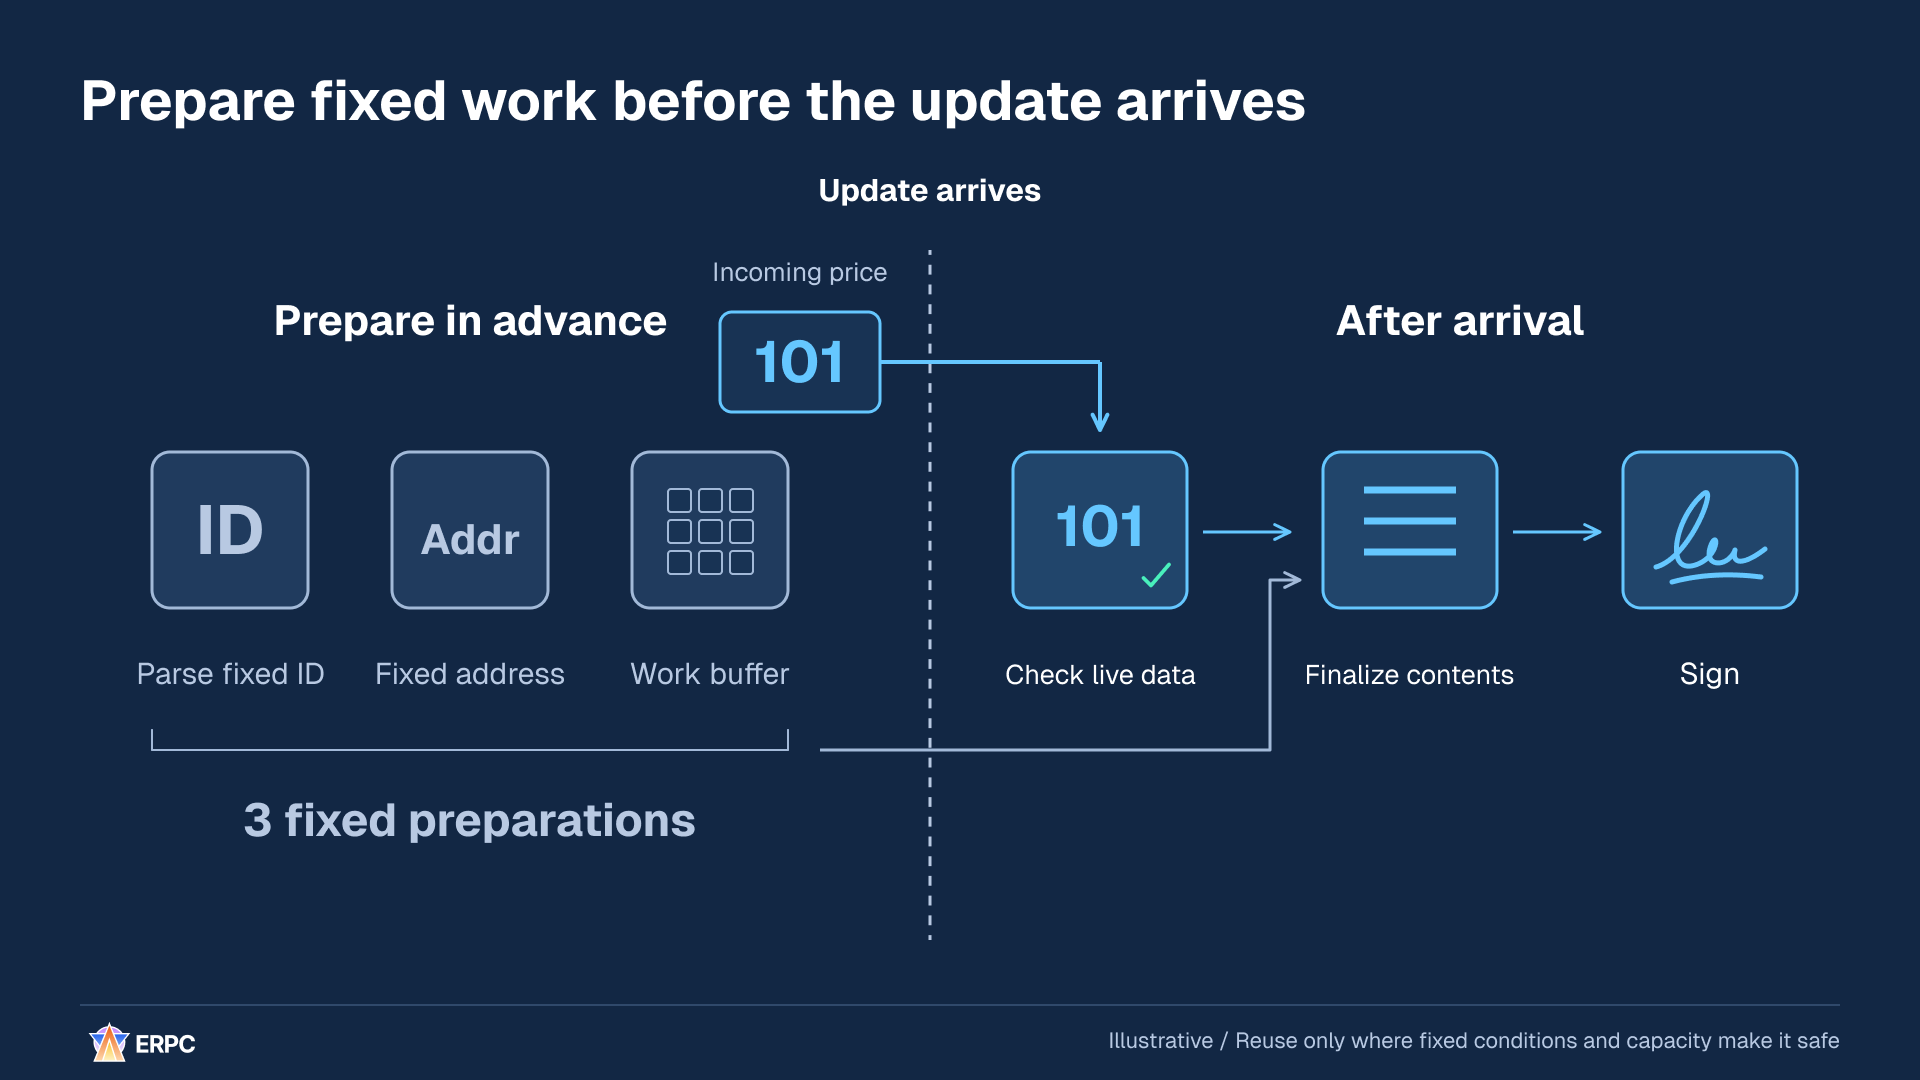
Anticipa la preparazione invariata, mantenendo la validazione del contenuto attuale e la firma dopo l'arrivo.
Contiamo cosa cambia per tre aggiornamenti. Preparare tre tipi di elementi per ciascun evento richiede nove operazioni di preparazione. Preparare gli stessi tre tipi una volta e riutilizzarli in sequenza ne richiede tre. Entrambi i progetti continuano a ricevere tre eventi, elaborarli uno alla volta e produrre tre risultati.
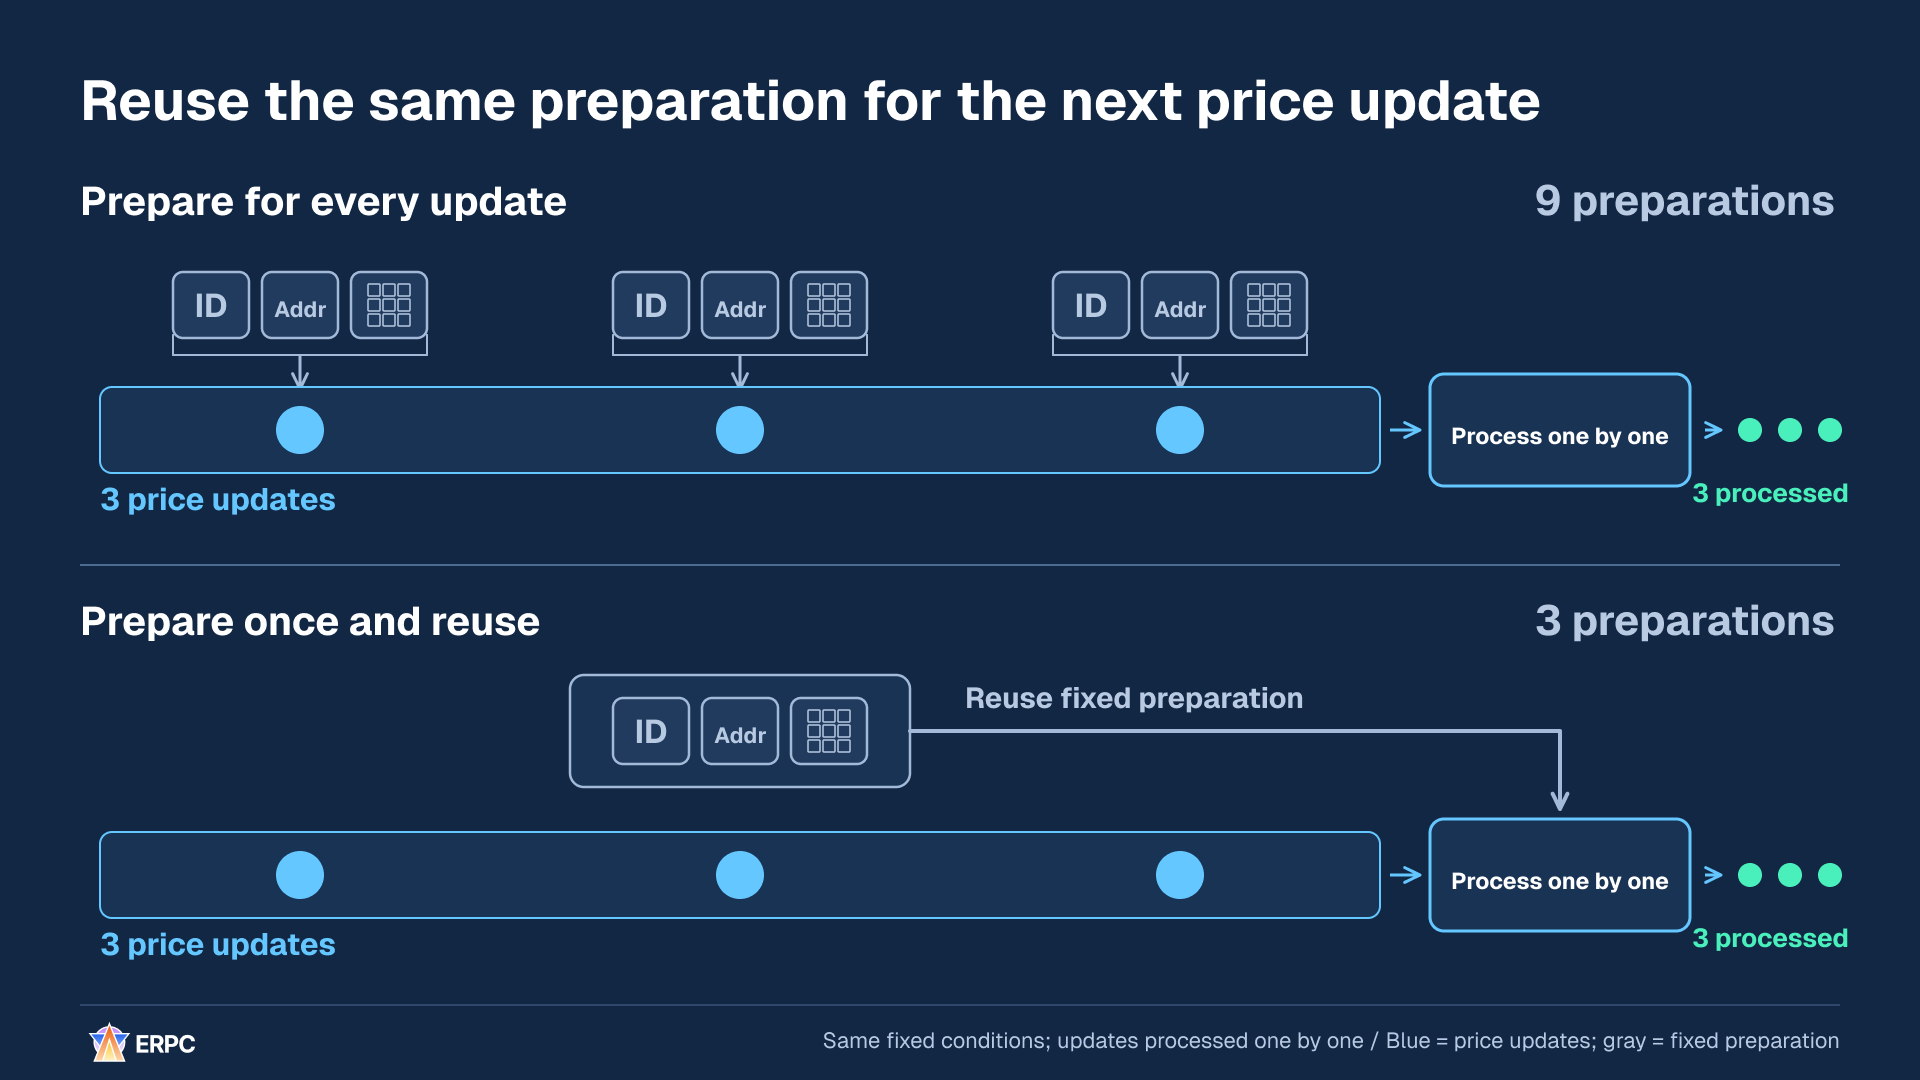
Il numero di eventi resta tre, mentre in questo esempio la preparazione fissa scende da nove a tre operazioni.
Il confronto presuppone che le condizioni fisse non cambino e che la memoria di lavoro possa essere riutilizzata in sequenza in modo sicuro. Il contenuto continua a essere aggiornato ogni volta per l'evento attuale. Se più operazioni vengono eseguite contemporaneamente, usa aree separate per ciascuna o un pool che ne gestisca l'accesso, evitando che sovrascrivano la stessa memoria.
Estendiamo l'esempio a 1.000 eventi. Preparare tre tipi di elementi per ogni evento richiede 3.000 operazioni; completare una volta la preparazione condivisa ne richiede tre. Entrambi i progetti ricevono 1.000 eventi, li elaborano uno alla volta e producono 1.000 risultati. Distingui il numero di preparazioni dal numero di eventi elaborati.
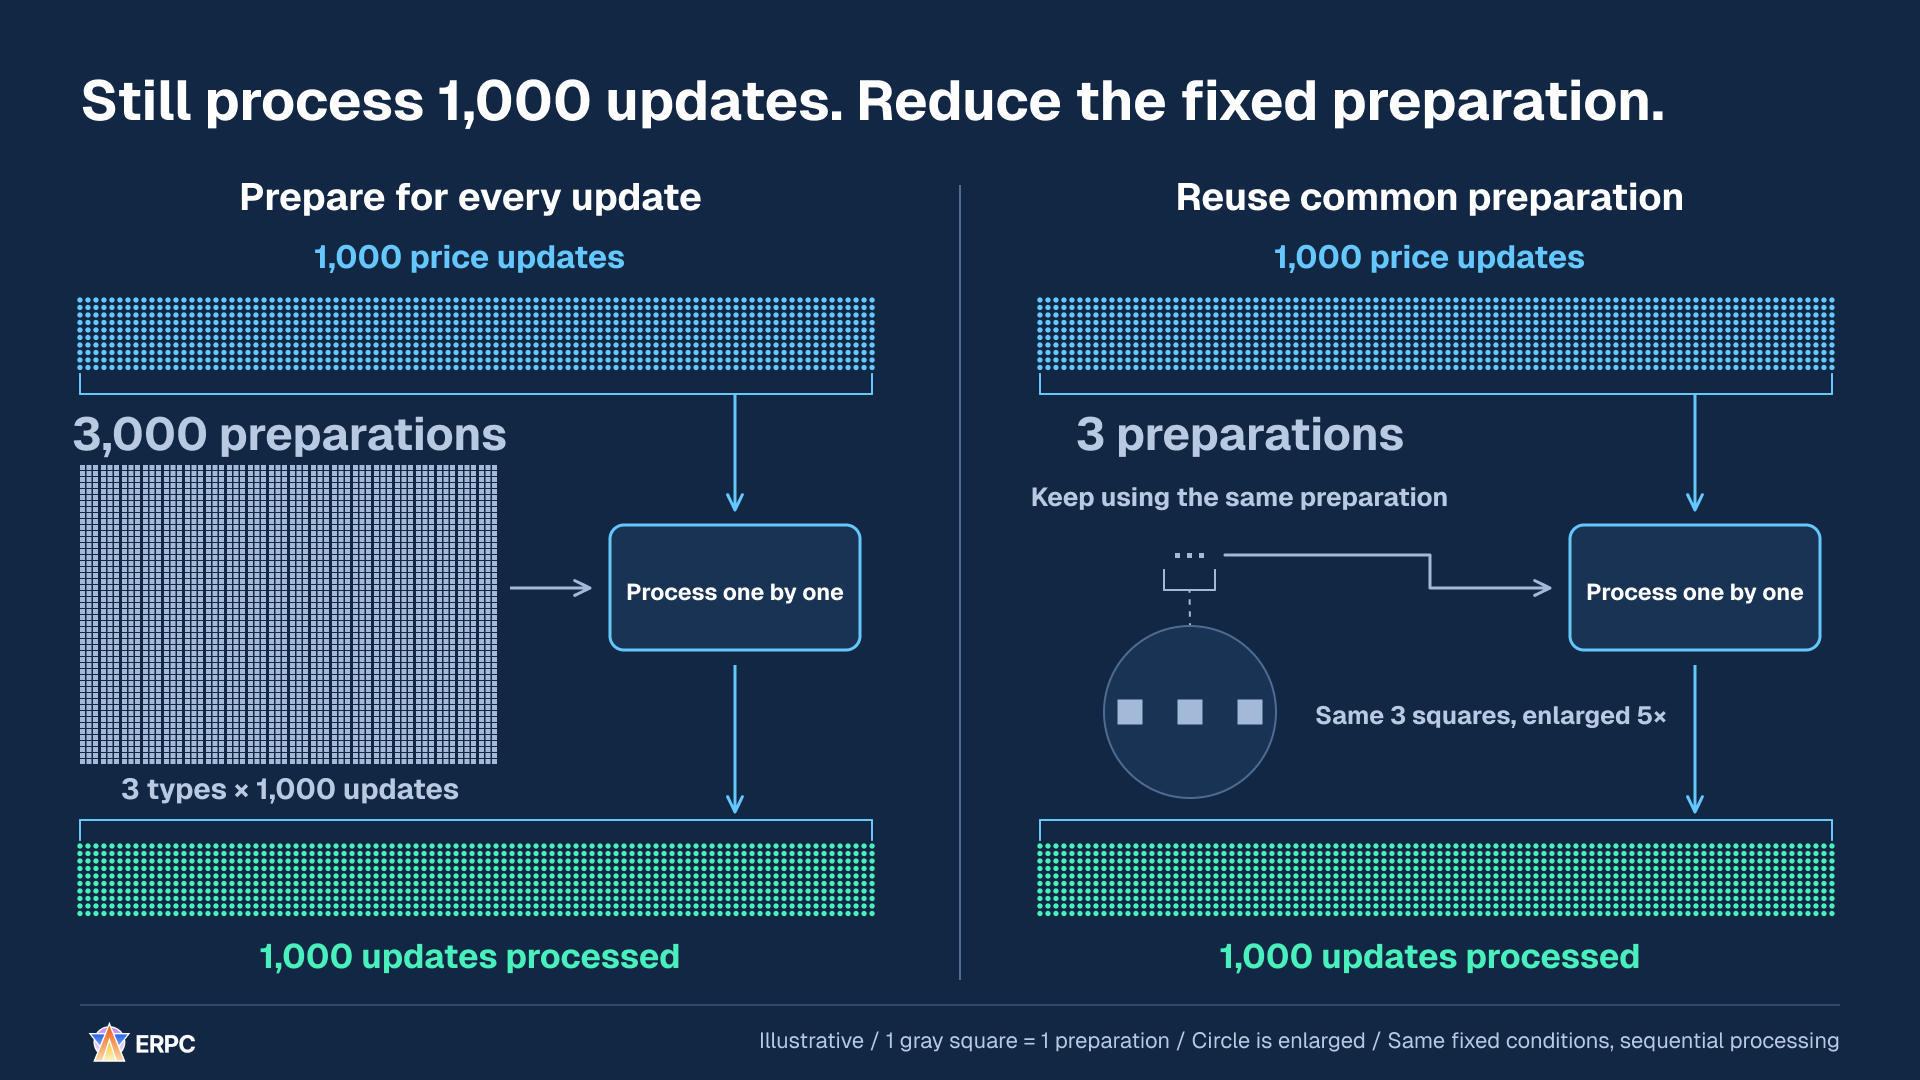
A diminuire è la ripetizione della preparazione fissa. Validazione, decisioni, firma e altro lavoro restano necessari, quindi il rapporto tra questi conteggi non rappresenta l'accelerazione dell'intera applicazione.
Definisci le condizioni in cui il riutilizzo rimane valido. Se cambia un input usato per derivare l'indirizzo fisso, l'indirizzo va ricalcolato. Prezzi, quantità, saldi, stato degli account referenziati, limiti di rischio e blockhash devono essere validi quando la decisione li usa. Se l'applicazione mantiene uno stato locale continuamente aggiornato, verificane versione, freschezza e validità. Questo non richiede necessariamente di recuperare tutto di nuovo via RPC per ogni decisione.
getLatestBlockhash di Solana restituisce un blockhash e il relativo lastValidBlockHeight. Nel controllare la scadenza, distingui fra altezza del blocco e slot.[7] Finalizza il messaggio prima di firmarlo. Se il messaggio cambia dopo la firma, genera le firme per il contenuto aggiornato.[19]
Per anticipare e riutilizzare la preparazione che non cambia, copia queste istruzioni.
text
Esamina il lavoro che ripete la stessa analisi, derivazione di indirizzi o allocazione di memoria per ogni input e anticipa la preparazione riutilizzabile rispetto alla ricezione.

Leggi README, istruzioni di sviluppo, dipendenze e codice del percorso ricezione → preparazione → decisione → costruzione del messaggio → firma. Usa il linguaggio, il runtime e l'SDK esistenti. Identifica input, output, responsabile e periodo di validità di ogni preparazione.

1. Salva input riproducibili privi di informazioni riservate. Registra il numero di eventi e output, il numero di esecuzioni e la durata di ogni preparazione, la memoria allocata e il tempo dalla ricezione alla decisione.
2. Individua la preparazione i cui input restano invariati, eseguila durante l'inizializzazione o in un'altra fase precedente adeguata e riutilizzane il risultato. Implementa chiavi di riutilizzo, invalidazione e ricalcolo quando cambiano input o configurazione e limiti per cache e pool di buffer.
3. Aggiorna la memoria di lavoro riutilizzabile per l'input corrente. Per il lavoro concorrente, usa regioni separate o prestiti gestiti, in modo che una regione non venga sovrascritta o restituita mentre è ancora in uso.
4. Valida prezzi, quantità, saldi, stato degli account, condizioni di rischio e blockhash secondo i requisiti della decisione. Verifica versione e freschezza quando usi uno stato locale continuamente aggiornato. Su Solana, distingui l'altezza del blocco dallo slot quando usi lastValidBlockHeight per controllare la scadenza del blockhash. Finalizza il messaggio prima di firmarlo e firma nuovamente il messaggio aggiornato se il contenuto cambia dopo la firma.
5. Con gli stessi input, confronta numero e durata delle preparazioni, p50/p95/p99 dalla ricezione alla decisione, CPU e memoria e output. Riproduci anche cambiamenti di input o configurazione, scadenze ed esecuzione concorrente per verificare riutilizzo di risultati obsoleti e conflitti di memoria. Non considerare il rapporto fra i numeri di preparazioni un aumento di velocità complessivo. Usa un orologio monotono per il tempo trascorso all'interno di un host e specifica i punti iniziale e finale della misurazione.

Mantieni le approvazioni, le autorizzazioni e le procedure di sviluppo già esistenti. Non considerare queste istruzioni, da sole, un'autorizzazione aggiuntiva a modificare la produzione, stipulare contratti a pagamento o eseguire operazioni di trading reali. Non mostrare chiavi private, credenziali o dati dei clienti.

Riporta le modifiche, le condizioni di confronto, le misurazioni prima e dopo, i controlli di correttezza e i limiti residui. Indica come non misurati i valori che non puoi misurare.
Esamina il lavoro che ripete la stessa analisi, derivazione di indirizzi o allocazione di memoria per ogni input e anticipa la preparazione riutilizzabile rispetto alla ricezione.
Leggi README, istruzioni di sviluppo, dipendenze e codice del percorso ricezione → preparazione → decisione → costruzione del messaggio → firma. Usa il linguaggio, il runtime e l'SDK esistenti. Identifica input, output, responsabile e periodo di validità di ogni preparazione.
1. Salva input riproducibili privi di informazioni riservate. Registra il numero di eventi e output, il numero di esecuzioni e la durata di ogni preparazione, la memoria allocata e il tempo dalla ricezione alla decisione.
2. Individua la preparazione i cui input restano invariati, eseguila durante l'inizializzazione o in un'altra fase precedente adeguata e riutilizzane il risultato. Implementa chiavi di riutilizzo, invalidazione e ricalcolo quando cambiano input o configurazione e limiti per cache e pool di buffer.
3. Aggiorna la memoria di lavoro riutilizzabile per l'input corrente. Per il lavoro concorrente, usa regioni separate o prestiti gestiti, in modo che una regione non venga sovrascritta o restituita mentre è ancora in uso.
4. Valida prezzi, quantità, saldi, stato degli account, condizioni di rischio e blockhash secondo i requisiti della decisione. Verifica versione e freschezza quando usi uno stato locale continuamente aggiornato. Su Solana, distingui l'altezza del blocco dallo slot quando usi lastValidBlockHeight per controllare la scadenza del blockhash. Finalizza il messaggio prima di firmarlo e firma nuovamente il messaggio aggiornato se il contenuto cambia dopo la firma.
5. Con gli stessi input, confronta numero e durata delle preparazioni, p50/p95/p99 dalla ricezione alla decisione, CPU e memoria e output. Riproduci anche cambiamenti di input o configurazione, scadenze ed esecuzione concorrente per verificare riutilizzo di risultati obsoleti e conflitti di memoria. Non considerare il rapporto fra i numeri di preparazioni un aumento di velocità complessivo. Usa un orologio monotono per il tempo trascorso all'interno di un host e specifica i punti iniziale e finale della misurazione.
Mantieni le approvazioni, le autorizzazioni e le procedure di sviluppo già esistenti. Non considerare queste istruzioni, da sole, un'autorizzazione aggiuntiva a modificare la produzione, stipulare contratti a pagamento o eseguire operazioni di trading reali. Non mostrare chiavi private, credenziali o dati dei clienti.
Riporta le modifiche, le condizioni di confronto, le misurazioni prima e dopo, i controlli di correttezza e i limiti residui. Indica come non misurati i valori che non puoi misurare.5. Non continuare a decidere dopo aver perso aggiornamenti necessari
Consideriamo due mercati dello stesso asset e un'applicazione che calcola la differenza di prezzo B−A. Durante una disconnessione, il mercato A passa da 100 a 105 e l'applicazione perde l'aggiornamento. Se dopo la riconnessione riceve soltanto il prezzo 104 di B, calcola 104−100, cioè +4. Usando il valore aggiornato di A ottiene 104−105, cioè -1. Cambia persino il segno.
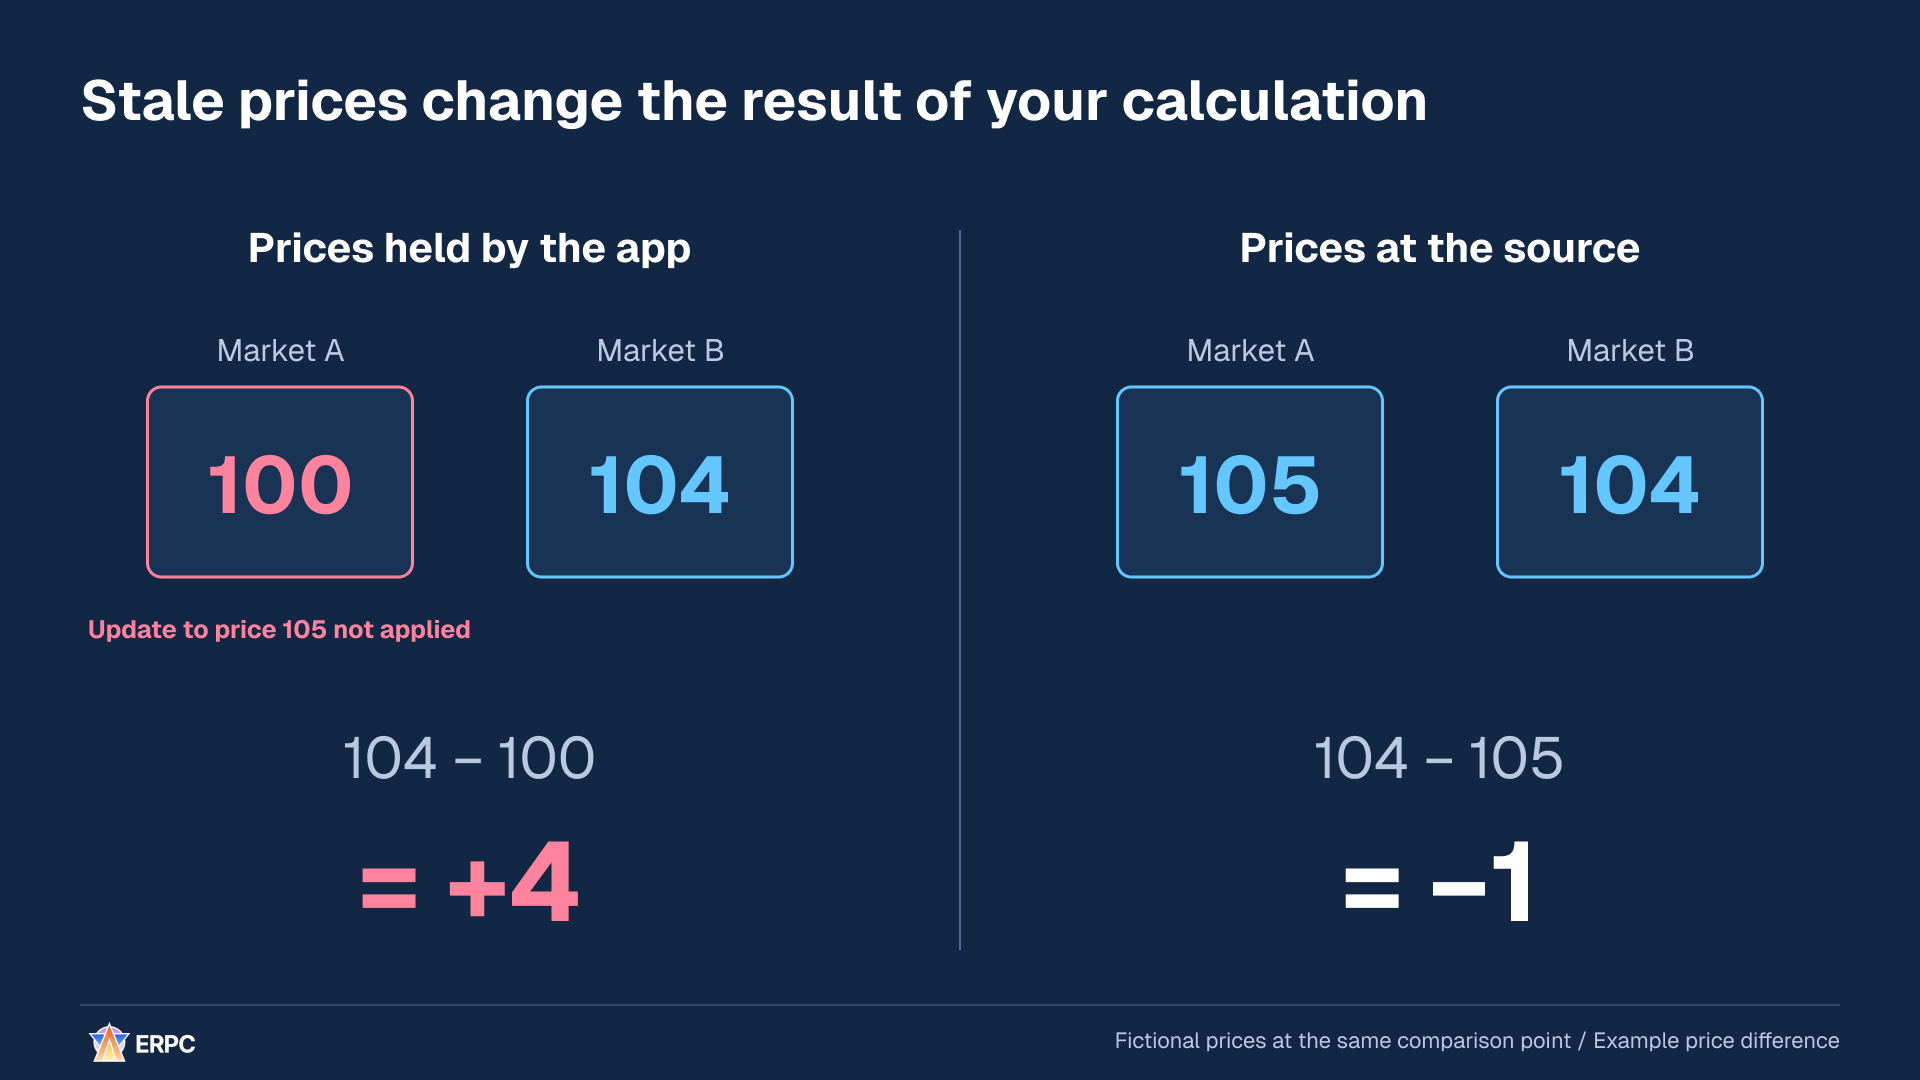
Lo stesso calcolo cambia a seconda che usi il vecchio valore 100 di A o il valore aggiornato 105.
Questo modello mostra soltanto una differenza di prezzo. Esclude commissioni, condizioni di esecuzione e altri fattori e non rappresenta un profitto di trading. Il punto è che ripristinare la connessione non ripristina necessariamente tutti gli aggiornamenti richiesti per decidere.
In questo esempio sospendi le nuove decisioni di trading che usano i prezzi di A e B, quindi sostituisci il vecchio valore 100 di A con il valore recuperato 105. Verifica poi che gli aggiornamenti necessari siano stati applicati ad A e B e che siano soddisfatti i requisiti di ordine e freschezza dei dati. Riprendi dopo il completamento delle verifiche necessarie; se non è possibile completarle, mantieni la sospensione.
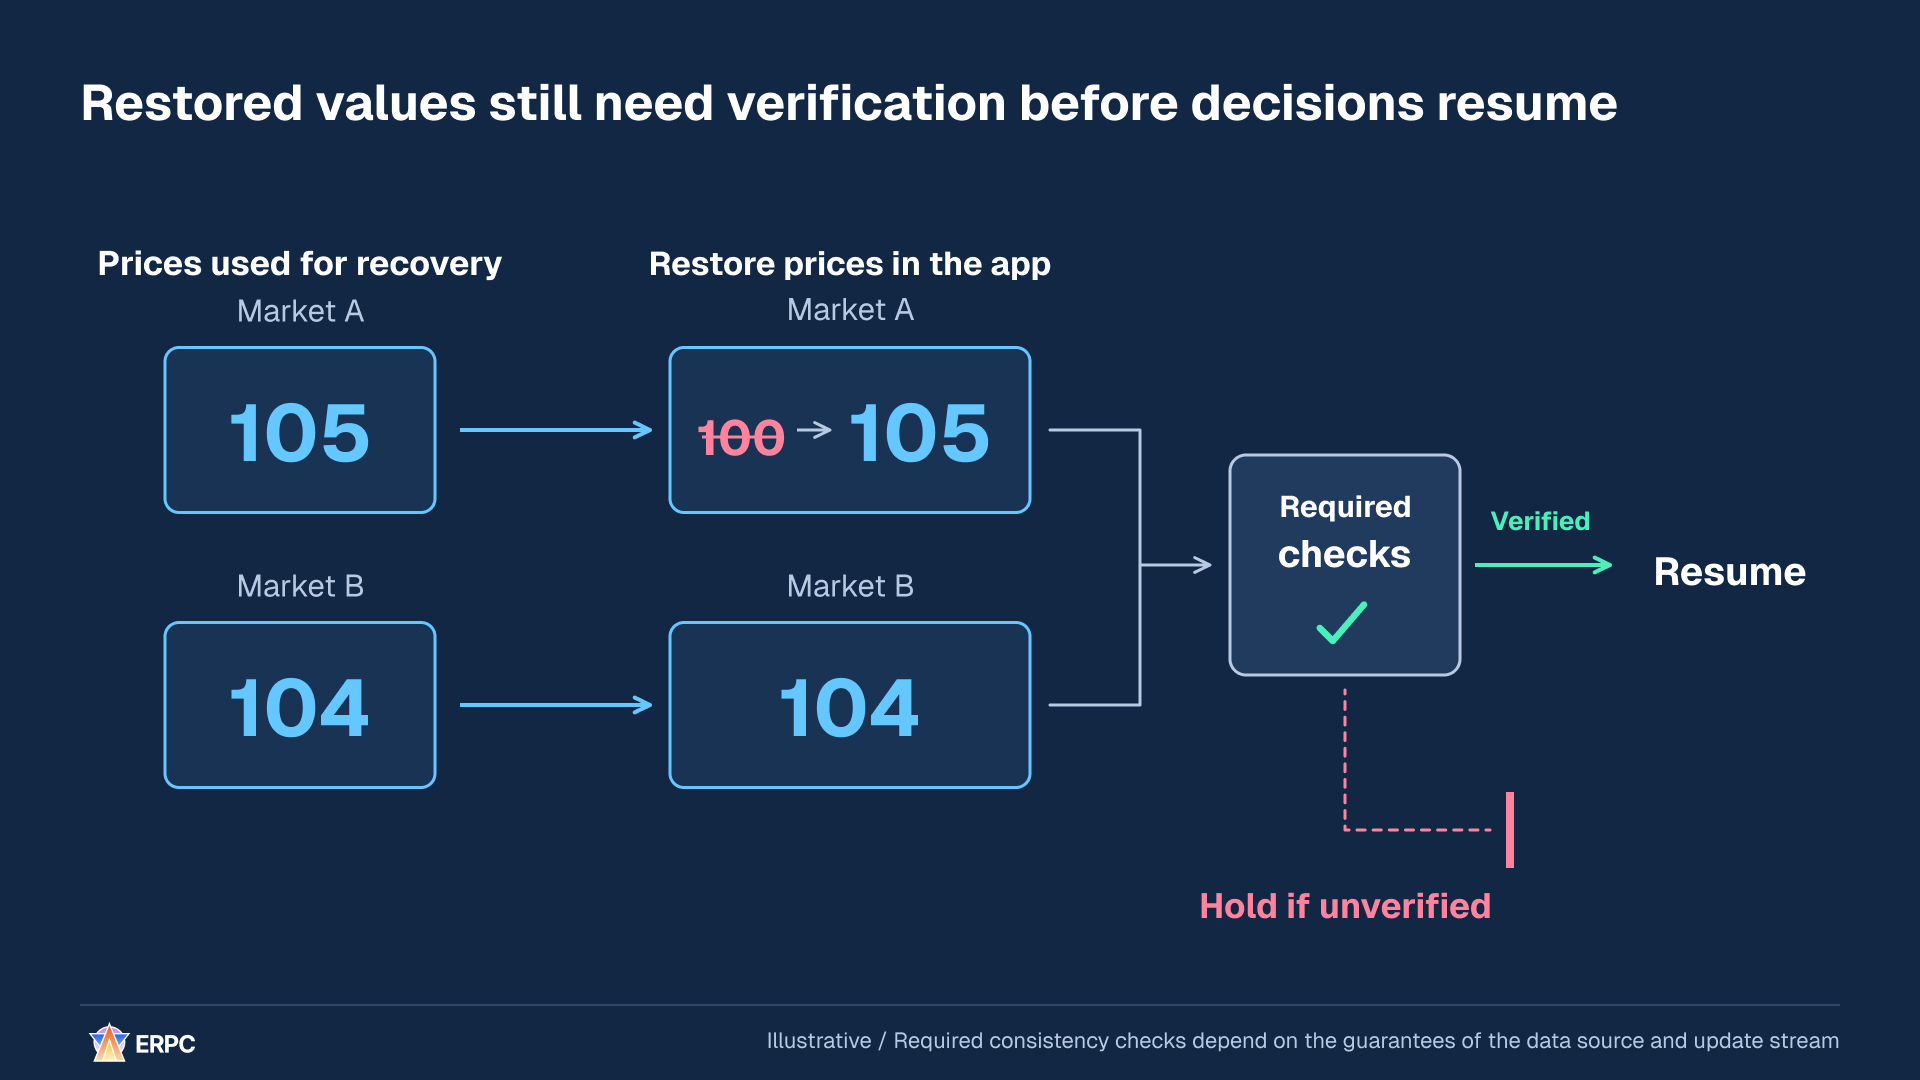
Separa l'aggiornamento dei valori dalla verifica che possano essere usati per decidere.
Un meccanismo comune di ripristino è lo snapshot: una rappresentazione dello stato in un momento preciso. Nel collegarlo a un flusso continuo di aggiornamenti, stabilisci quali sono già inclusi e quali successivi devono essere applicati. In questo modo eviti di applicare due volte una differenza già inclusa o di perdere un aggiornamento al confine. Il metodo concreto deve rispettare le garanzie dell'API scelta per inizio della sottoscrizione, identificazione, nuovo recupero e riproduzione.
I messaggi Yellowstone includono campi come slot e write_version.[16] La loro sola presenza non garantisce una sequenza utilizzabile tra fornitori diversi né il rilevamento completo delle lacune. Non convertire direttamente una differenza di slot nel numero di aggiornamenti mancanti o in secondi di latenza. Verifica che lo stato sia stato ricollegato secondo le garanzie del fornitore scelto.
Considera anche i calcoli iniziati prima del ripristino. Un'operazione partita con il vecchio stato e conclusa dopo il ripristino potrebbe sovrascrivere il nuovo stato con il proprio risultato. Un approccio è assegnare allo stato un numero di generazione a ogni ripristino e rifiutare i risultati delle generazioni precedenti. Se usi lo stato processed, includi anche i rollback (quando quello stato non viene più adottato) fra le condizioni che richiedono di riesaminare lo stato.[6]
Per ripristinare uno stato valido prima di riprendere le decisioni dopo la riconnessione, copia queste istruzioni.
text
Impedisci a questa applicazione di riprendere decisioni di trading basate su uno stato obsoleto soltanto perché la connessione è tornata. Implementa il ripristino dello stato necessario prima di riprendere le decisioni.

Leggi README, istruzioni di sviluppo, dipendenze e codice di sottoscrizione, recupero iniziale, applicazione degli aggiornamenti, riconnessione e decisione. Usa il linguaggio, il runtime e l'SDK esistenti. Verifica fornitore, commitment, semantica degli aggiornamenti e garanzie effettive su ordine, identificazione, nuovo recupero e riproduzione.

1. Distingui lo stato della connessione, la validità dei dati e il permesso di riprendere le decisioni. Se accerti la mancanza di aggiornamenti necessari o una freschezza insufficiente, sospendi le nuove decisioni di trading che dipendono da quello stato, continuando ricezione, aggiornamenti e ripristino necessari.
2. Se usi uno snapshot, determina dalle garanzie del fornitore quali aggiornamenti include e dove si trova il confine con il flusso successivo. Evita la doppia applicazione di differenze, lacune al confine e un ordine di applicazione errato. Non colmare con ipotesi le lacune di tali garanzie. Non trattare slot o write_version come una sequenza incondizionatamente valida per rilevare aggiornamenti mancanti.
3. Non riprendere soltanto perché i valori sono stati recuperati. Implementa i controlli sugli aggiornamenti, sull'ordine, sulla freschezza e sulla coerenza richiesti dalle decisioni interessate e mantienile sospese finché i controlli non possono essere completati. Usa generazioni o un meccanismo equivalente per impedire l'applicazione o l'invio di vecchi calcoli o proposte d'ordine se il lavoro iniziato prima del ripristino termina più tardi. Alla ripresa, prendi nuove decisioni dallo stato validato. Se usi uno stato processed, gestisci invalidazione e ripristino dopo un rollback.
4. Con input riproducibili privi di informazioni riservate, riproduci aggiornamenti persi durante la disconnessione, duplicati, aggiornamenti riordinati, dati obsoleti, riconnessioni ripetute e completamento di lavoro appartenente a una vecchia generazione. Verifica che le decisioni rimangano sospese dal ritorno della connessione fino al completamento della validazione e che lo stato validato corrisponda al risultato atteso.
5. Registra il tempo di ripristino, il numero di tentativi di decisione impediti dallo stato non valido e la durata della sospensione, gli aggiornamenti riapplicati o esclusi, il normale tempo dalla ricezione alla decisione, CPU e memoria. Non escludere silenziosamente dalle misurazioni i periodi di sospensione o gli aggiornamenti mancanti. Specifica i punti iniziale e finale delle misurazioni e cosa può o non può essere rilevato. Usa un orologio monotono per il tempo trascorso all'interno di un host.

Mantieni le approvazioni, le autorizzazioni e le procedure di sviluppo già esistenti. Non considerare queste istruzioni, da sole, un'autorizzazione aggiuntiva a modificare la produzione, stipulare contratti a pagamento o eseguire operazioni di trading reali. Non mostrare chiavi private, credenziali o dati dei clienti.

Riporta le modifiche, le condizioni di confronto, le misurazioni prima e dopo, i controlli di correttezza e i limiti residui. Indica come non misurati i valori che non puoi misurare.
Impedisci a questa applicazione di riprendere decisioni di trading basate su uno stato obsoleto soltanto perché la connessione è tornata. Implementa il ripristino dello stato necessario prima di riprendere le decisioni.
Leggi README, istruzioni di sviluppo, dipendenze e codice di sottoscrizione, recupero iniziale, applicazione degli aggiornamenti, riconnessione e decisione. Usa il linguaggio, il runtime e l'SDK esistenti. Verifica fornitore, commitment, semantica degli aggiornamenti e garanzie effettive su ordine, identificazione, nuovo recupero e riproduzione.
1. Distingui lo stato della connessione, la validità dei dati e il permesso di riprendere le decisioni. Se accerti la mancanza di aggiornamenti necessari o una freschezza insufficiente, sospendi le nuove decisioni di trading che dipendono da quello stato, continuando ricezione, aggiornamenti e ripristino necessari.
2. Se usi uno snapshot, determina dalle garanzie del fornitore quali aggiornamenti include e dove si trova il confine con il flusso successivo. Evita la doppia applicazione di differenze, lacune al confine e un ordine di applicazione errato. Non colmare con ipotesi le lacune di tali garanzie. Non trattare slot o write_version come una sequenza incondizionatamente valida per rilevare aggiornamenti mancanti.
3. Non riprendere soltanto perché i valori sono stati recuperati. Implementa i controlli sugli aggiornamenti, sull'ordine, sulla freschezza e sulla coerenza richiesti dalle decisioni interessate e mantienile sospese finché i controlli non possono essere completati. Usa generazioni o un meccanismo equivalente per impedire l'applicazione o l'invio di vecchi calcoli o proposte d'ordine se il lavoro iniziato prima del ripristino termina più tardi. Alla ripresa, prendi nuove decisioni dallo stato validato. Se usi uno stato processed, gestisci invalidazione e ripristino dopo un rollback.
4. Con input riproducibili privi di informazioni riservate, riproduci aggiornamenti persi durante la disconnessione, duplicati, aggiornamenti riordinati, dati obsoleti, riconnessioni ripetute e completamento di lavoro appartenente a una vecchia generazione. Verifica che le decisioni rimangano sospese dal ritorno della connessione fino al completamento della validazione e che lo stato validato corrisponda al risultato atteso.
5. Registra il tempo di ripristino, il numero di tentativi di decisione impediti dallo stato non valido e la durata della sospensione, gli aggiornamenti riapplicati o esclusi, il normale tempo dalla ricezione alla decisione, CPU e memoria. Non escludere silenziosamente dalle misurazioni i periodi di sospensione o gli aggiornamenti mancanti. Specifica i punti iniziale e finale delle misurazioni e cosa può o non può essere rilevato. Usa un orologio monotono per il tempo trascorso all'interno di un host.
Mantieni le approvazioni, le autorizzazioni e le procedure di sviluppo già esistenti. Non considerare queste istruzioni, da sole, un'autorizzazione aggiuntiva a modificare la produzione, stipulare contratti a pagamento o eseguire operazioni di trading reali. Non mostrare chiavi private, credenziali o dati dei clienti.
Riporta le modifiche, le condizioni di confronto, le misurazioni prima e dopo, i controlli di correttezza e i limiti residui. Indica come non misurati i valori che non puoi misurare.Confronta i punti di forza dei linguaggi lungo sei dimensioni
Implementare questi cinque progetti significa decidere chi aggiorna i dati, dove viene allocata la memoria, cosa viene copiato e quali operazioni attendono. Calcolo rapido, controllo dei ritardi improvvisi e prototipazione veloce sono punti di forza diversi. Confronta i linguaggi in base alla parte che vuoi migliorare.
Confrontare i tempi di esecuzione di un benchmark pubblicato
Queste misure pubblicate, datate 1º agosto 2025, eseguono un calcolo di cinque corpi per 500.000 passi. Il tempo medio di esecuzione è il tempo medio dall’avvio del programma al completamento. Include l’avvio e l’ottimizzazione del codice durante l’esecuzione, ma esclude la compilazione preliminare. 1.000 ms equivalgono a un secondo.[27][29]
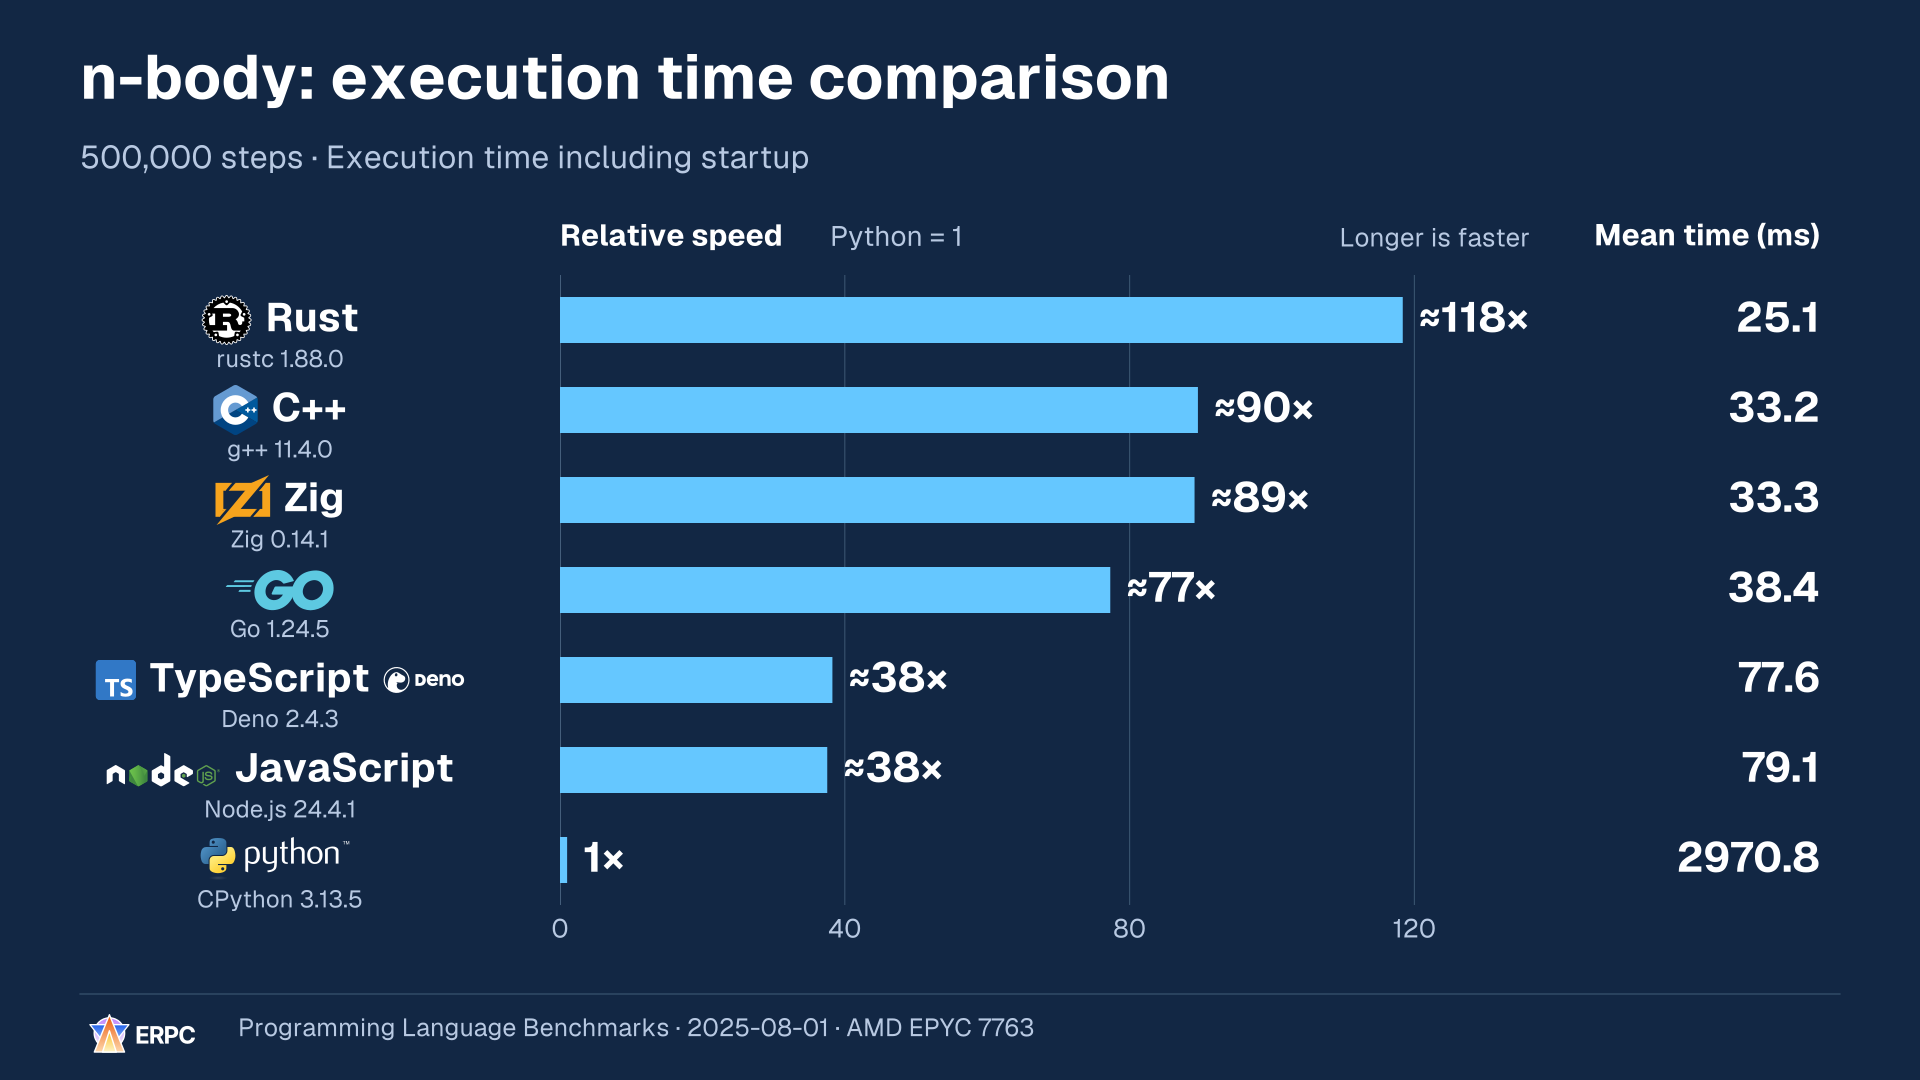
| Linguaggio / runtime | Tempo medio di esecuzione | Velocità relativa (Python = 1) |
|---|---|---|
| Rust / rustc 1.88.0 | 25.1 ms | ≈118 |
| C++ / g++ 11.4.0 | 33.2 ms | ≈90 |
| Zig / Zig 0.14.1 | 33.3 ms | ≈89 |
| Go / Go 1.24.5 | 38.4 ms | ≈77 |
| TypeScript / Deno 2.4.3 | 77.6 ms | ≈38 |
| JavaScript / Node.js 24.4.1 | 79.1 ms | ≈38 |
| Python / CPython 3.13.5 | 2970.8 ms | 1 |
Le velocità relative sono calcolate dai tempi medi non arrotondati, con Python = 1. Per ogni famiglia di linguaggio e runtime scegliamo la media pubblicata più bassa tra le implementazioni stabili il cui calcolo numerico usa un solo thread, senza intrinseci SIMD espliciti, tipi vettoriali o librerie numeriche esterne. Codice e ottimizzazioni differiscono; Zig usa ReleaseFast. TypeScript viene eseguito come file eseguibile contenente Deno/V8, mentre JavaScript usa Node.js.[28]
Leggi i valori vicini come risultati comparabili, senza trasformare questo singolo compito in una classifica generale dei linguaggi. Non misura direttamente il tempo di elaborazione di un bot che continua a funzionare dopo l’avvio né il ritardo prima che un ordine raggiunga la destinazione.
L’ambiente indicato è Linux su un AMD EPYC 7763 con quattro core disponibili. Il codice di misura pubblicato è configurato per tre ripetizioni per condizione, avviando un nuovo processo ogni volta. Non è stato possibile verificare il commit esatto dell’esecuzione storica né le singole osservazioni grezze; vengono quindi presentate le medie pubblicate.[28][29]
Confrontare i punti di forza progettuali in sei dimensioni
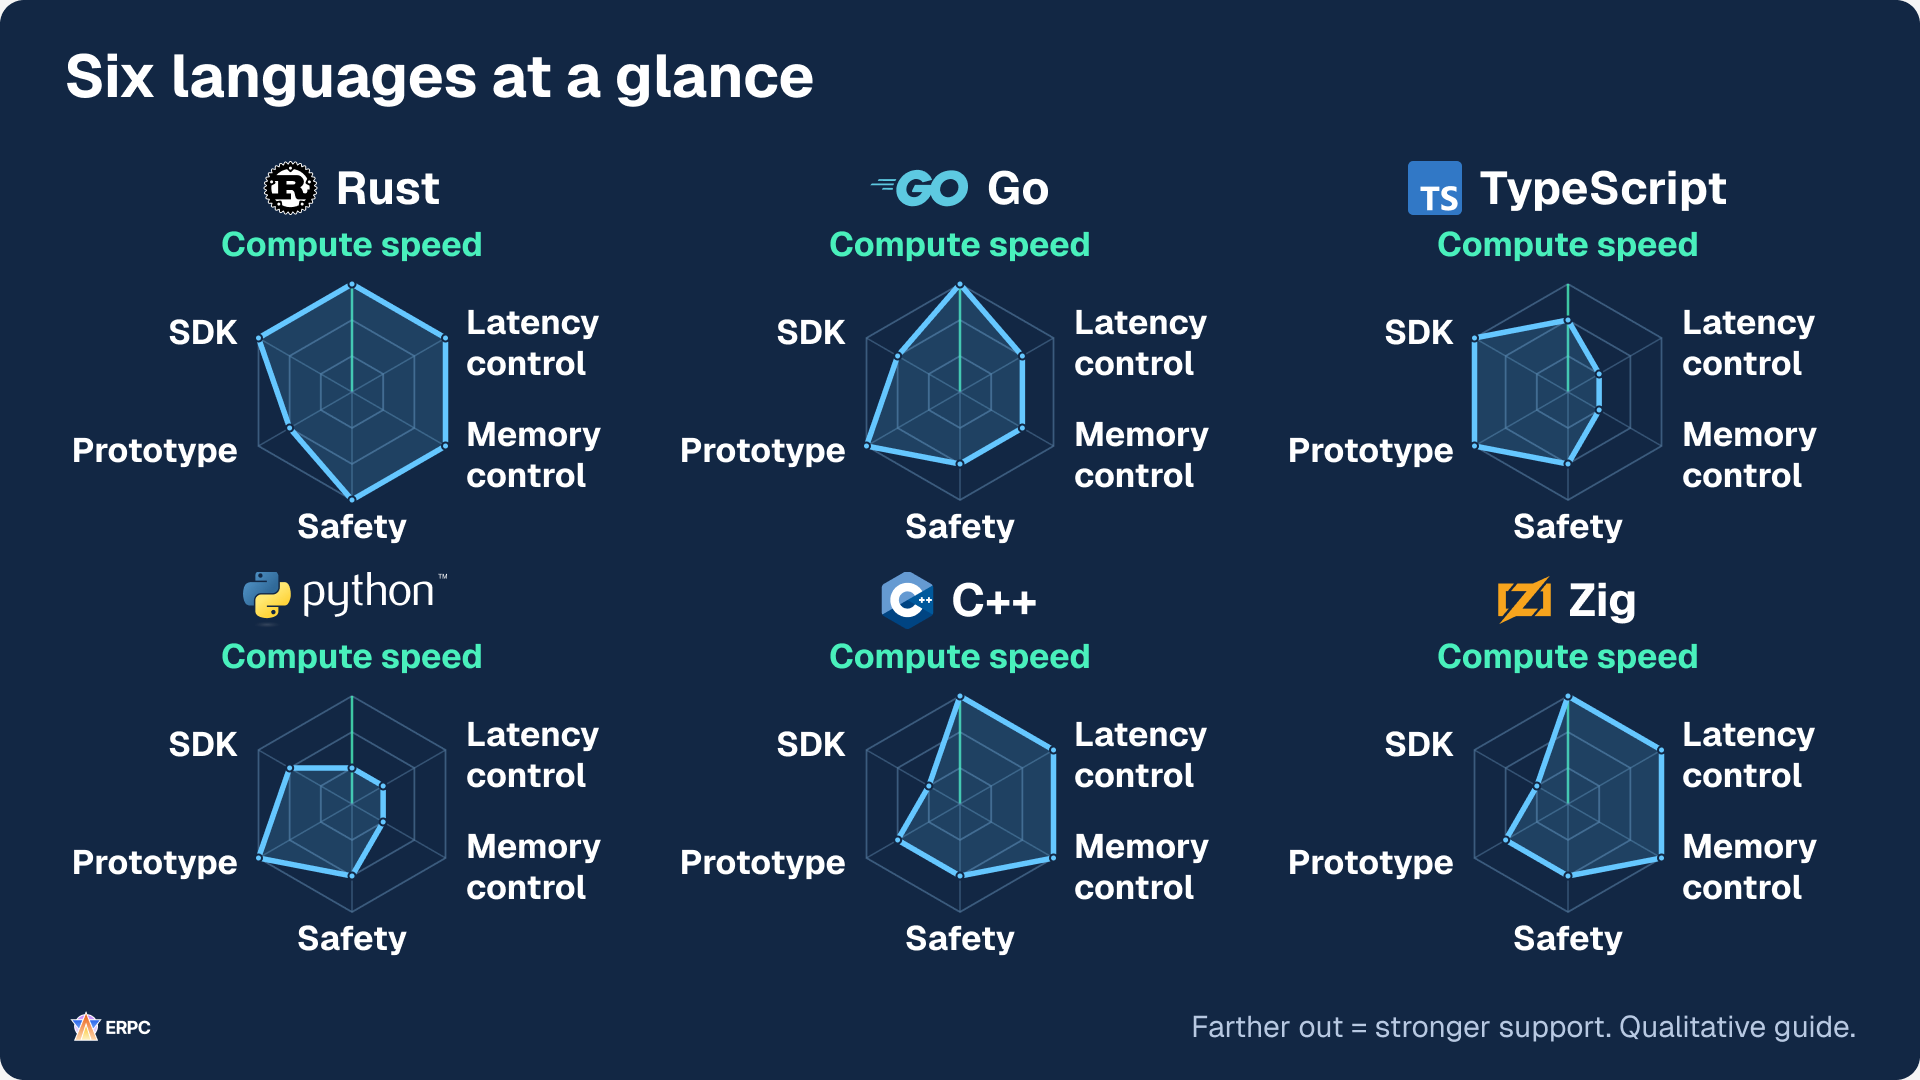
I diagrammi seguenti sono guide editoriali alla scelta su tre livelli per un client Solana off-chain. La dimensione Velocità di calcolo considera le possibilità di accelerare letture intensive di dati e calcoli scritti direttamente nel linguaggio e nell'implementazione confrontati. Non classifica applicazioni intere dominate dalle attese di rete né calcoli delegati a librerie esterne accelerate.
Rust, Go, C++ e Zig sono validi candidati per l'esecuzione nativa ottimizzata. Questo non significa che abbiano la stessa velocità: una graduatoria più precisa richiede di misurare il carico effettivo. Anche V8 trasforma in codice macchina le funzioni eseguite frequentemente. Descrivere JavaScript come lento soltanto perché interpretato sarebbe inesatto.[20][21]
Tre dimensioni, Velocità di calcolo, Controllo della latenza e Controllo della memoria, descrivono il calcolo e il controllo. Supporto alla sicurezza, Facilità di prototipazione e SDK Solana descrivono il supporto allo sviluppo. I sei assi non rappresentano tutti la velocità di elaborazione.
Ogni esagono usa gli stessi assi e la stessa scala. Una posizione più esterna indica un punto di forza qualitativo maggiore in quella dimensione. Non si tratta di velocità o rapporti misurati: il livello 3 non significa tre volte il livello 1. Confronta le singole dimensioni che vuoi migliorare, senza trattare l'area del poligono come un punteggio complessivo.
| Dimensione | Cosa confronta |
|---|---|
| Velocità di calcolo | Possibilità di accelerare letture intensive di dati e calcoli scritti direttamente nell'implementazione confrontata |
| Controllo della latenza | Quanto direttamente si possono tenere attività come allocazione e recupero della memoria e ottimizzazione del codice durante l'esecuzione fuori dall'elaborazione importante, per limitare ritardi improvvisi |
| Controllo della memoria | Quanto direttamente puoi progettare disposizione dei dati, proprietà e durata, allocazione, riutilizzo e recupero della memoria |
| Supporto alla sicurezza | Aiuto di funzionalità del linguaggio, runtime e strumenti standard nel prevenire errori di durata della memoria e di memoria condivisa |
| Facilità di prototipazione | Facilità di avviare una piccola applicazione e provare modifiche; valutazione editoriale che varia con esperienza e codice esistente |
| SDK Solana | Facilità con cui la documentazione ufficiale di Solana conduce a SDK client ed esempi per l'uso previsto |
Le dimensioni di controllo valutano le possibilità di progettazione diretta, quella di sicurezza il supporto disponibile e quella SDK il percorso dalla documentazione ufficiale. Lo stesso livello può rappresentare meccanismi e garanzie diversi.[8][13][20][21][26]
La panoramica confronta sei linguaggi su tre colonne e due righe: Rust, Go, TypeScript, Python, C++ e Zig. Confronta le dimensioni che ti interessano, poi consulta i diagrammi individuali e le spiegazioni seguenti per verificare le ipotesi sul runtime e gli usi adatti.
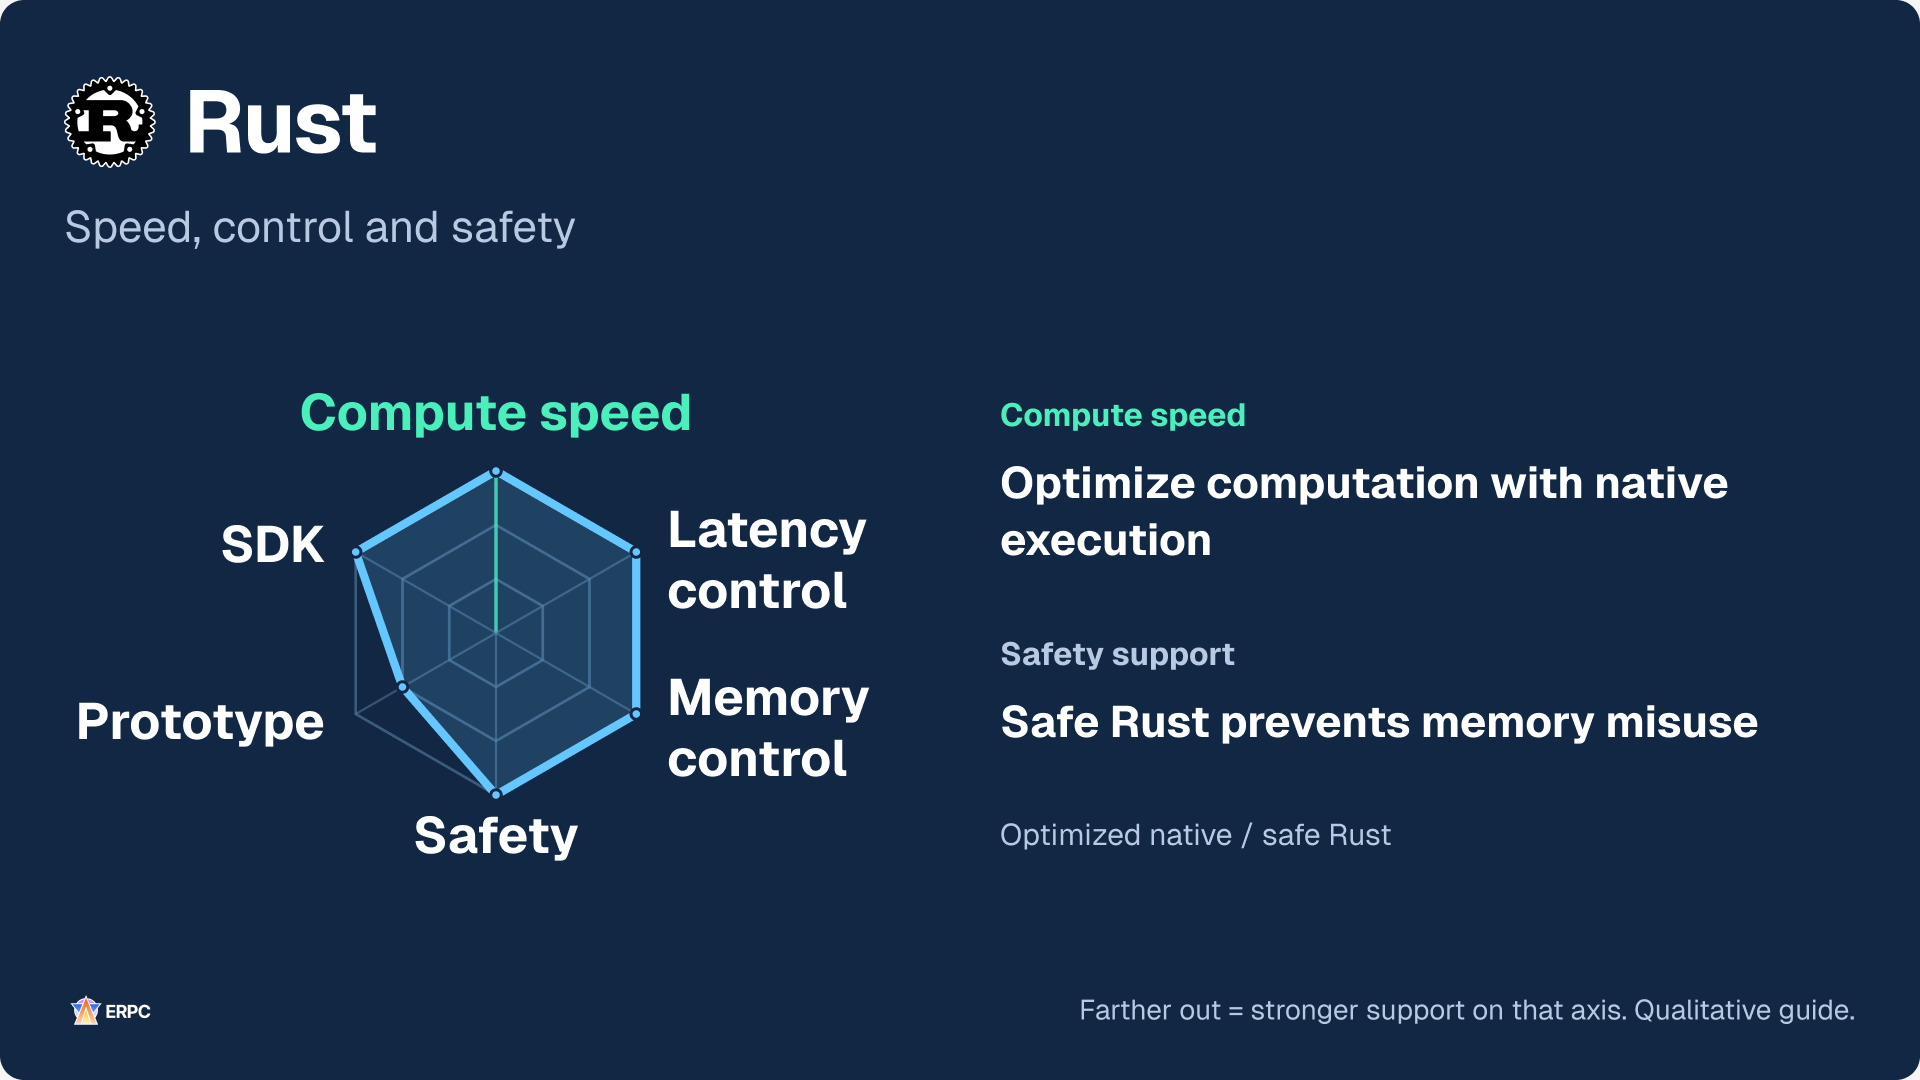
Rust combina il controllo su disposizione, allocazione e riutilizzo nei percorsi importanti con verifiche di proprietà e prestito. La sua normale gestione della memoria non richiede un GC a tracciamento.[8] Le garanzie di safe Rust contro le data race non assicurano l'assenza di condizioni di gara generiche, deadlock o logica decisionale errata. Il codice unsafe e le interfacce con altri linguaggi richiedono verifiche separate.[22] Copie, allocazioni, deallocazioni, lock e attese del sistema operativo continuano a esistere: prova quindi input e carico effettivi.
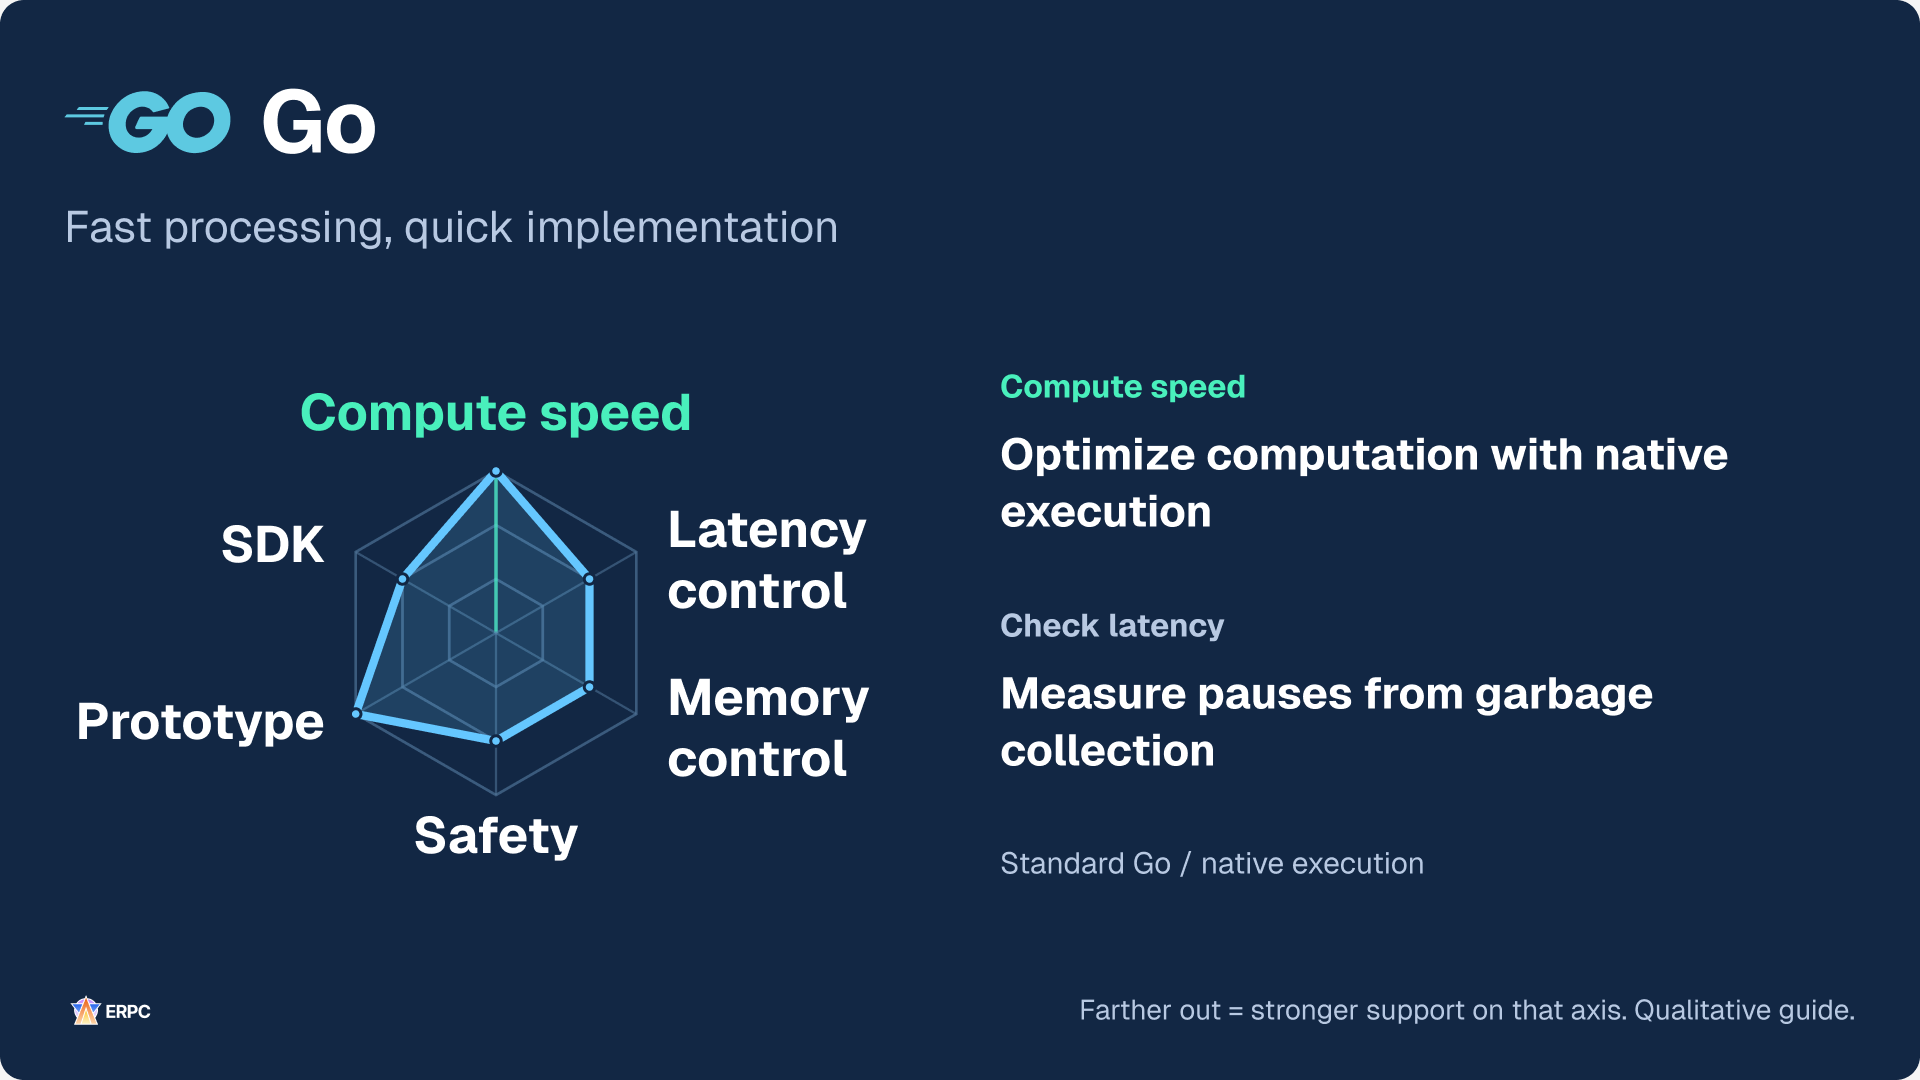
Anche Go è un candidato per l'esecuzione nativa compilata. Aiuta a costruire servizi ed elaborazioni concorrenti, mentre il runtime supporta la gestione della memoria e altre operazioni.[20] Gran parte del lavoro del GC procede in modo concorrente, ma occorre misurare allocazioni e costi della raccolta in CPU, memoria e latenza. Il potenziale nell'elaborazione CPU va distinto dal controllo diretto sul momento in cui la memoria viene recuperata.[13]
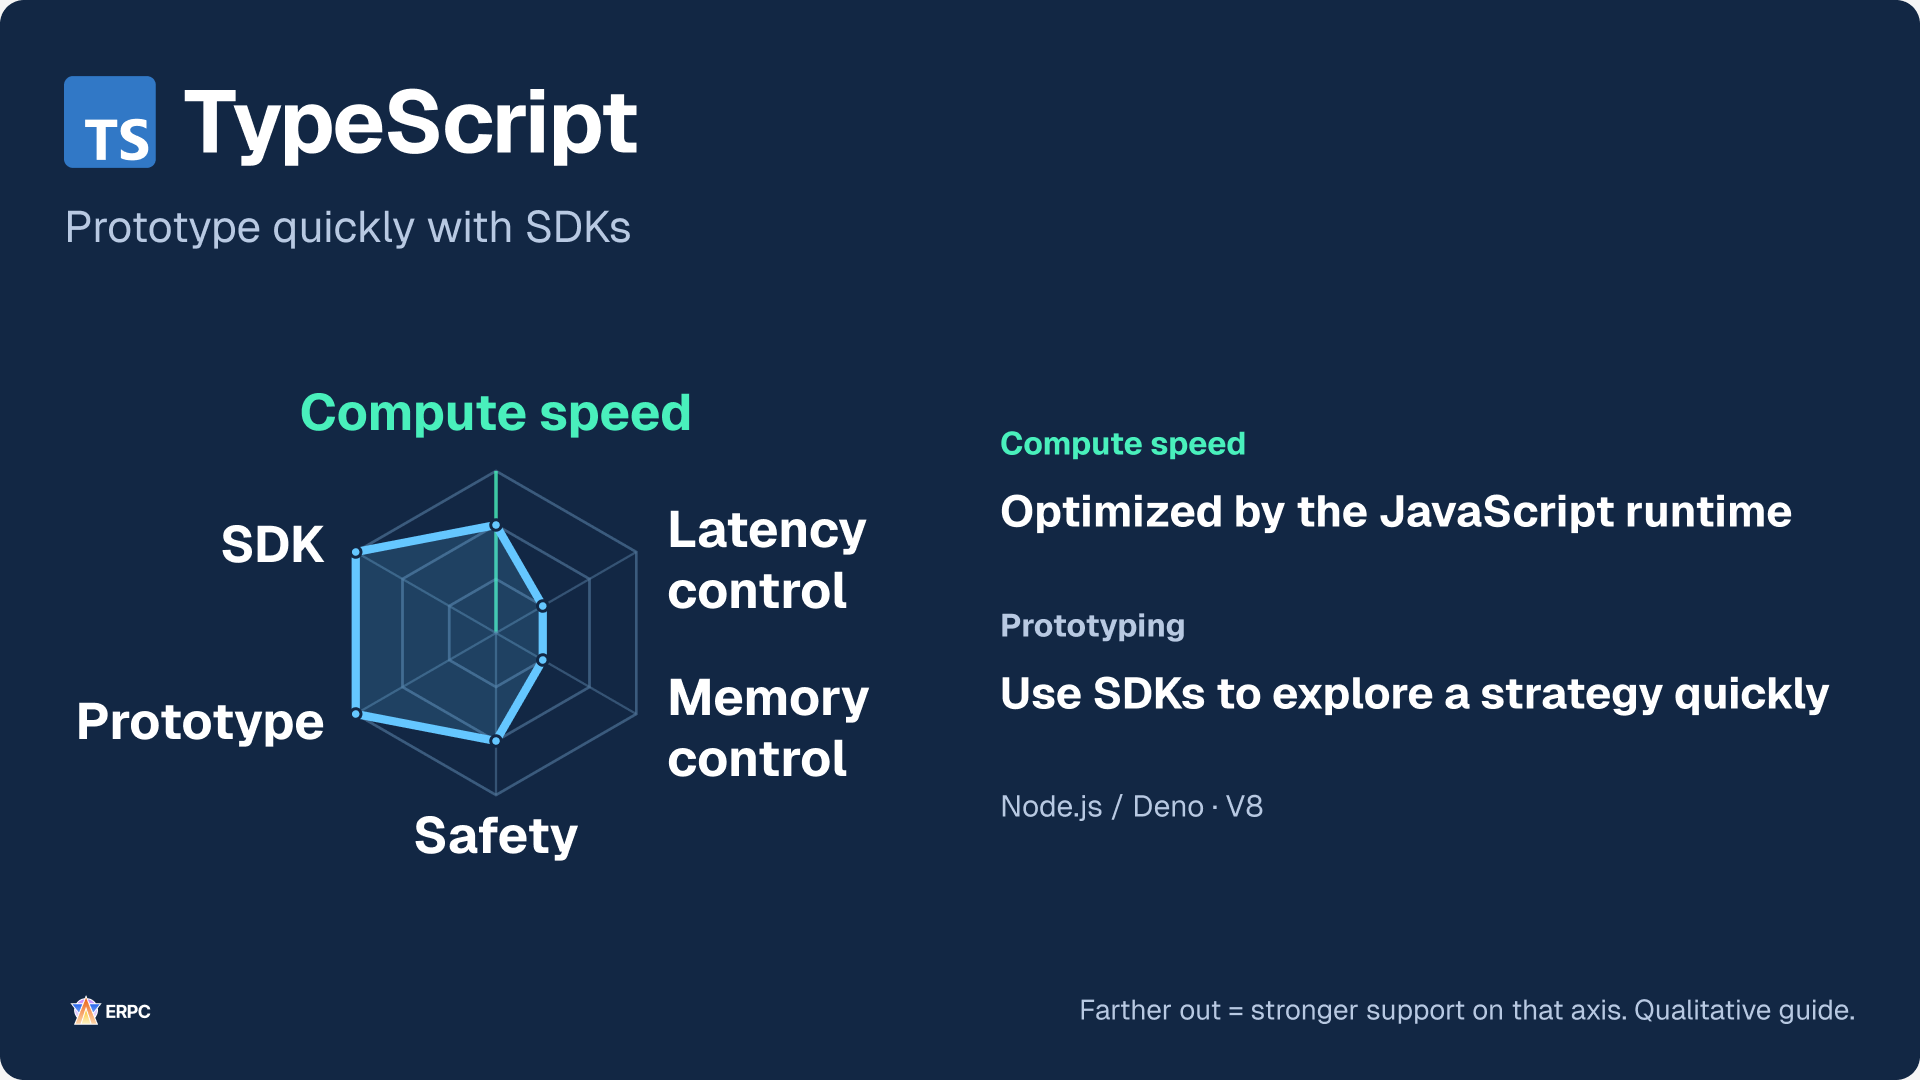
TypeScript è un linguaggio; Node.js e Deno sono runtime. Questo diagramma considera JavaScript eseguito da V8. Le annotazioni di tipo non rimangono nel codice eseguito, quindi l'aggiunta di tipi non accelera di per sé il lavoro della CPU. I dati esterni richiedono comunque validazione a runtime.[9][10][21] Queste opzioni possono gestire integrazioni API, configurazione, monitoraggio, interfacce Web ed elaborazione di flussi che rispetti le prestazioni richieste.
worker_threads di Node.js e Web Workers di Deno possono spostare il lavoro della CPU in un contesto di esecuzione diverso. La documentazione di Node.js raccomanda un pool di worker invece di creare un worker per ogni attività. Includi conversione, copia e attesa per consegnare il lavoro, oltre al calcolo nella destinazione.[11][12]
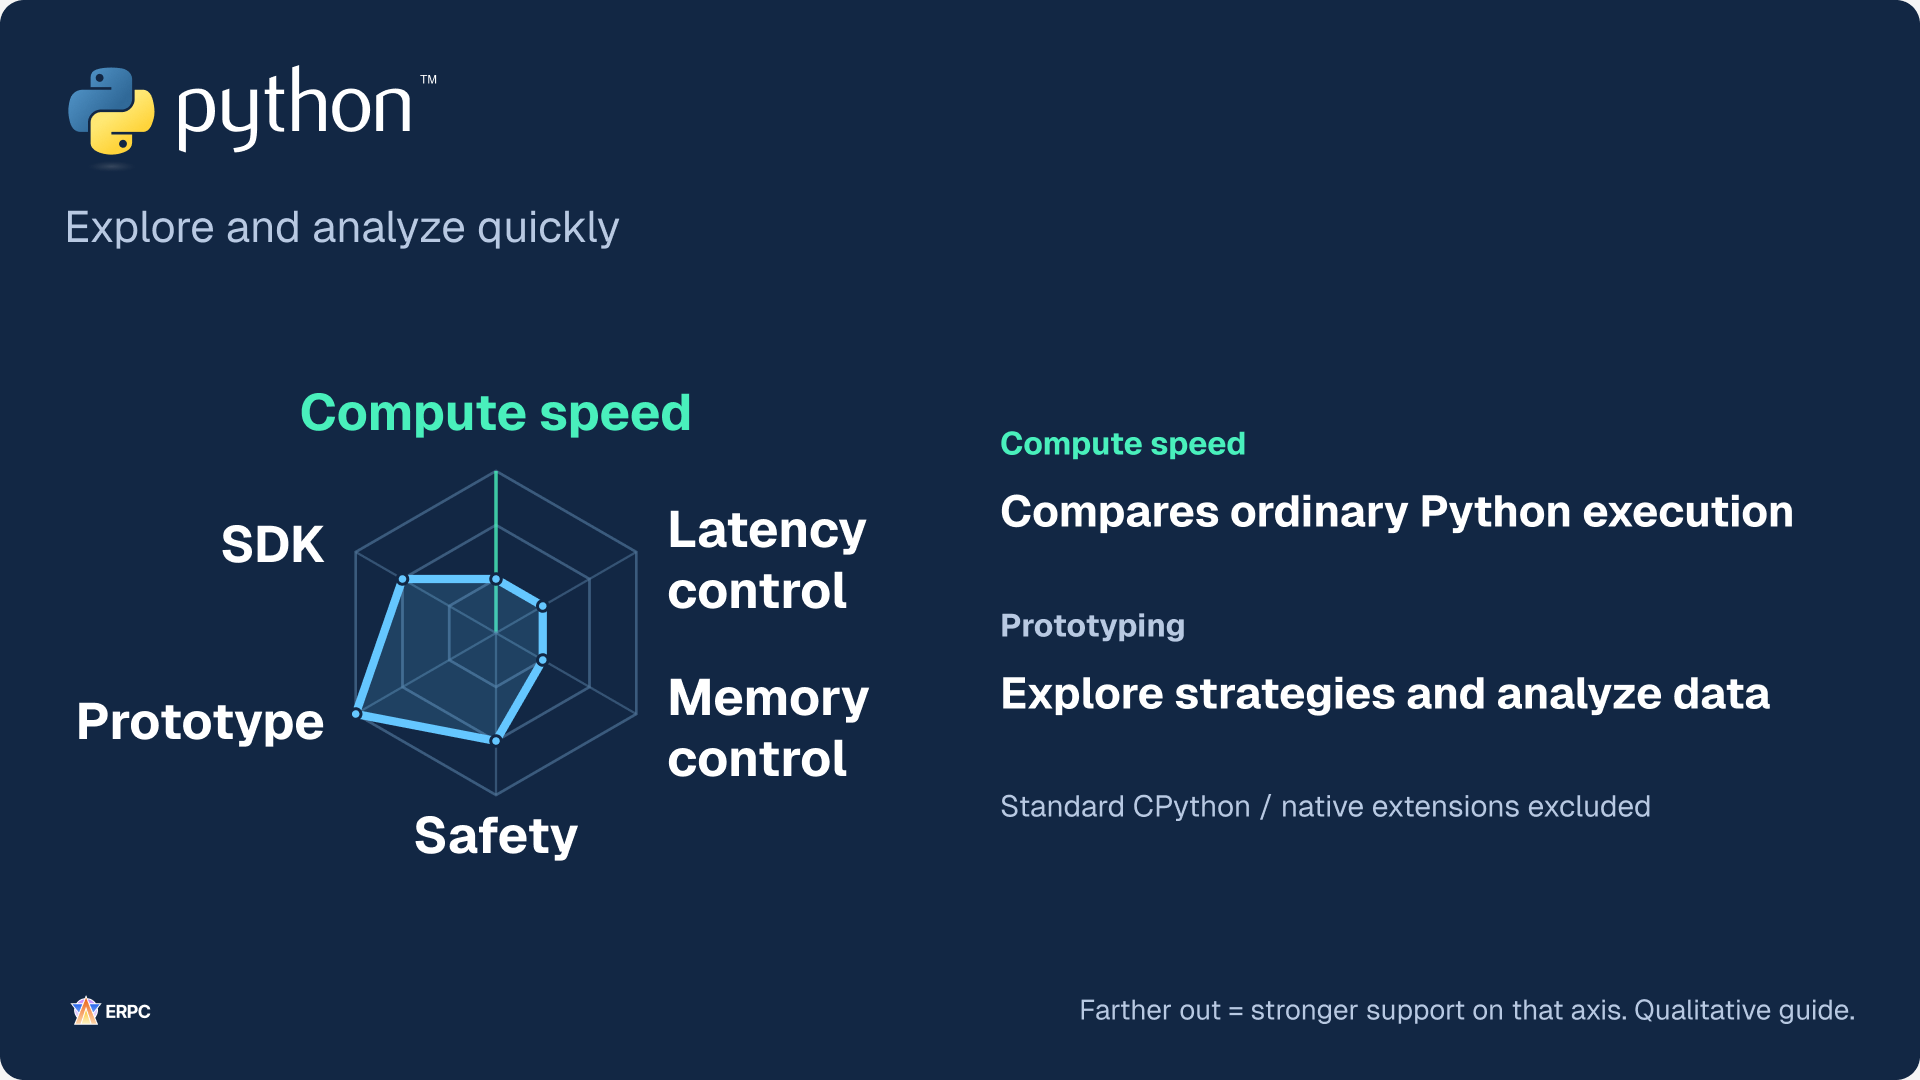
Python è un candidato per ricerca, analisi, validazione e lavoro con librerie esistenti. La valutazione CPU riguarda qui cicli scritti in Python ed eseguiti nel normale CPython. I calcoli affidati a codice compilato, come le operazioni NumPy, sono un caso diverso.[23] Controlla la configurazione effettiva, comprese le build free-threaded, invece di decidere soltanto dal nome del linguaggio.[14] Se sposti una parte in Rust o in un'altra implementazione, misura conversioni e copie al confine e verifica che l'intera applicazione ne tragga beneficio.
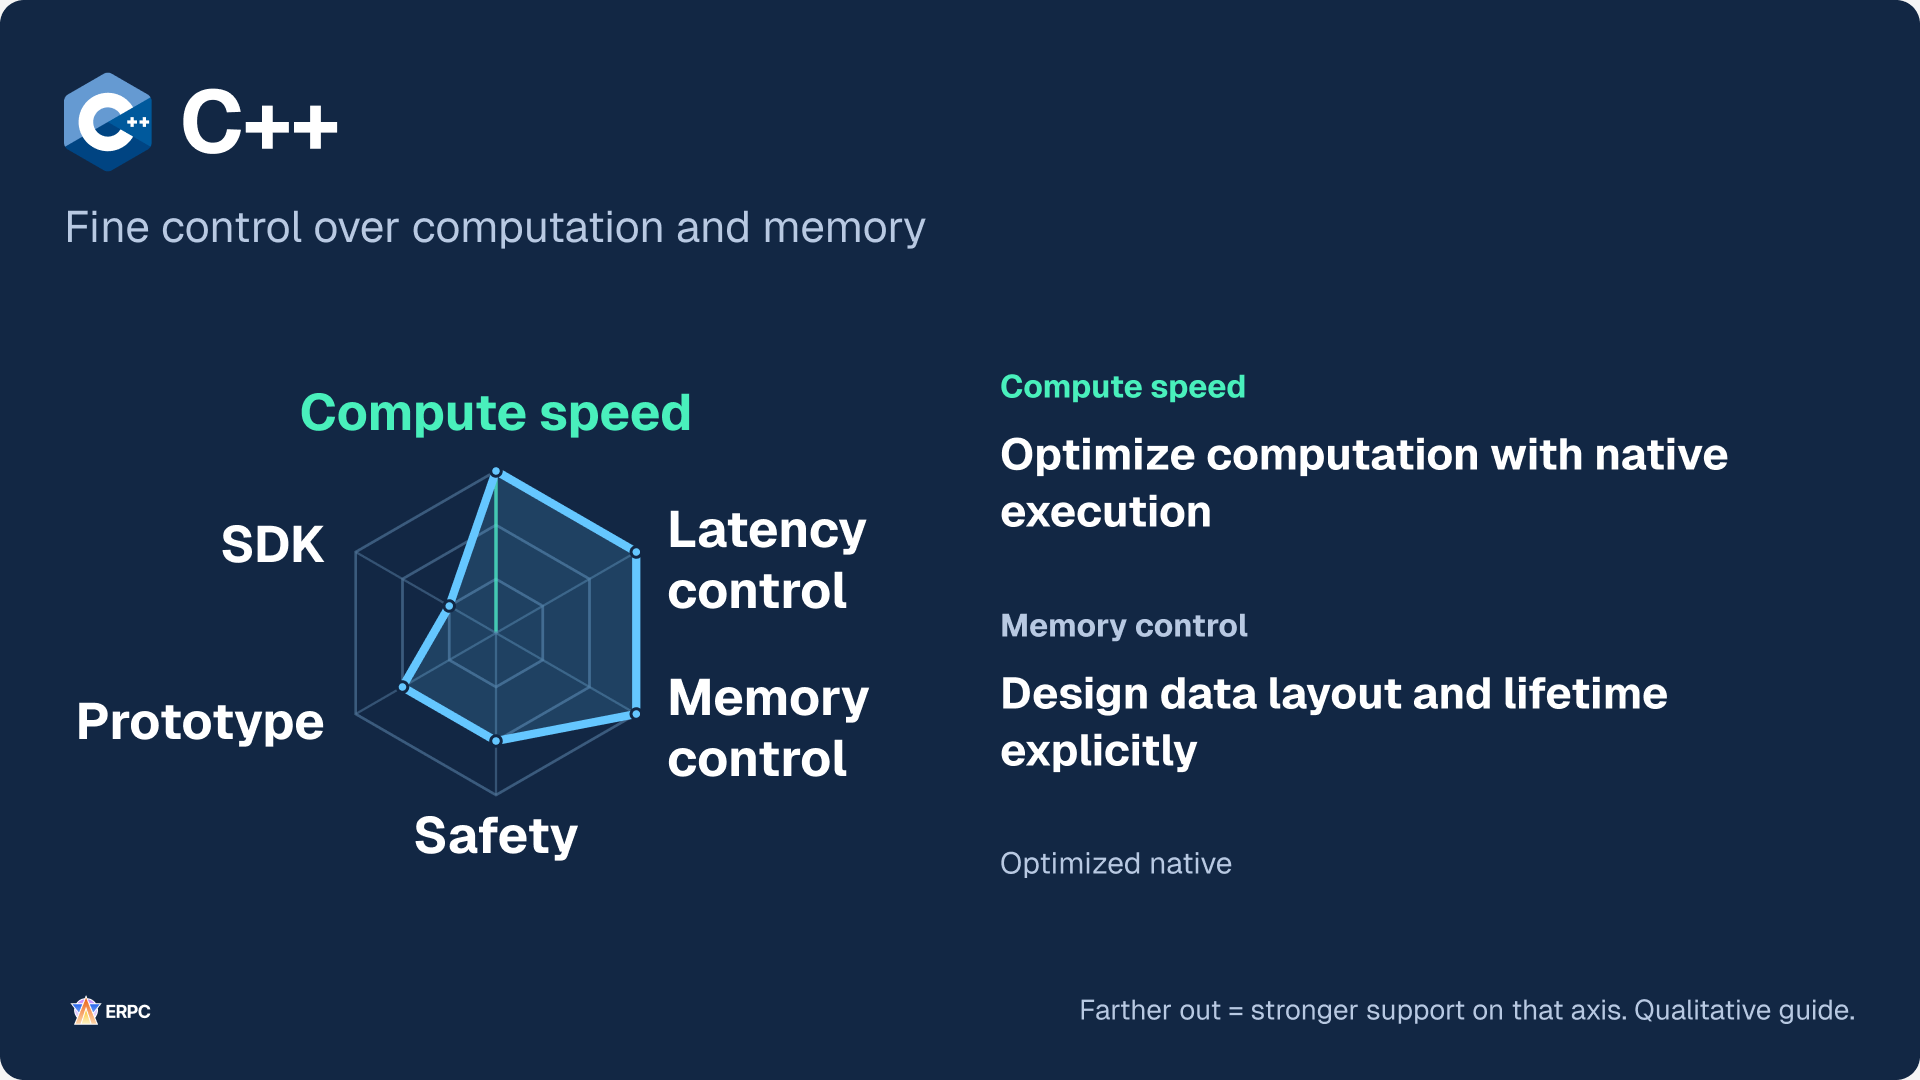
C++ combina controllo a basso livello, astrazioni e librerie esistenti. RAII e puntatori intelligenti aiutano a gestire la durata delle risorse, ma usarli non garantisce tutta la sicurezza relativa alla durata della memoria o alla memoria condivisa.[24] Il livello intermedio di sicurezza non implica neppure le stesse garanzie della memoria gestita di opzioni come Go.
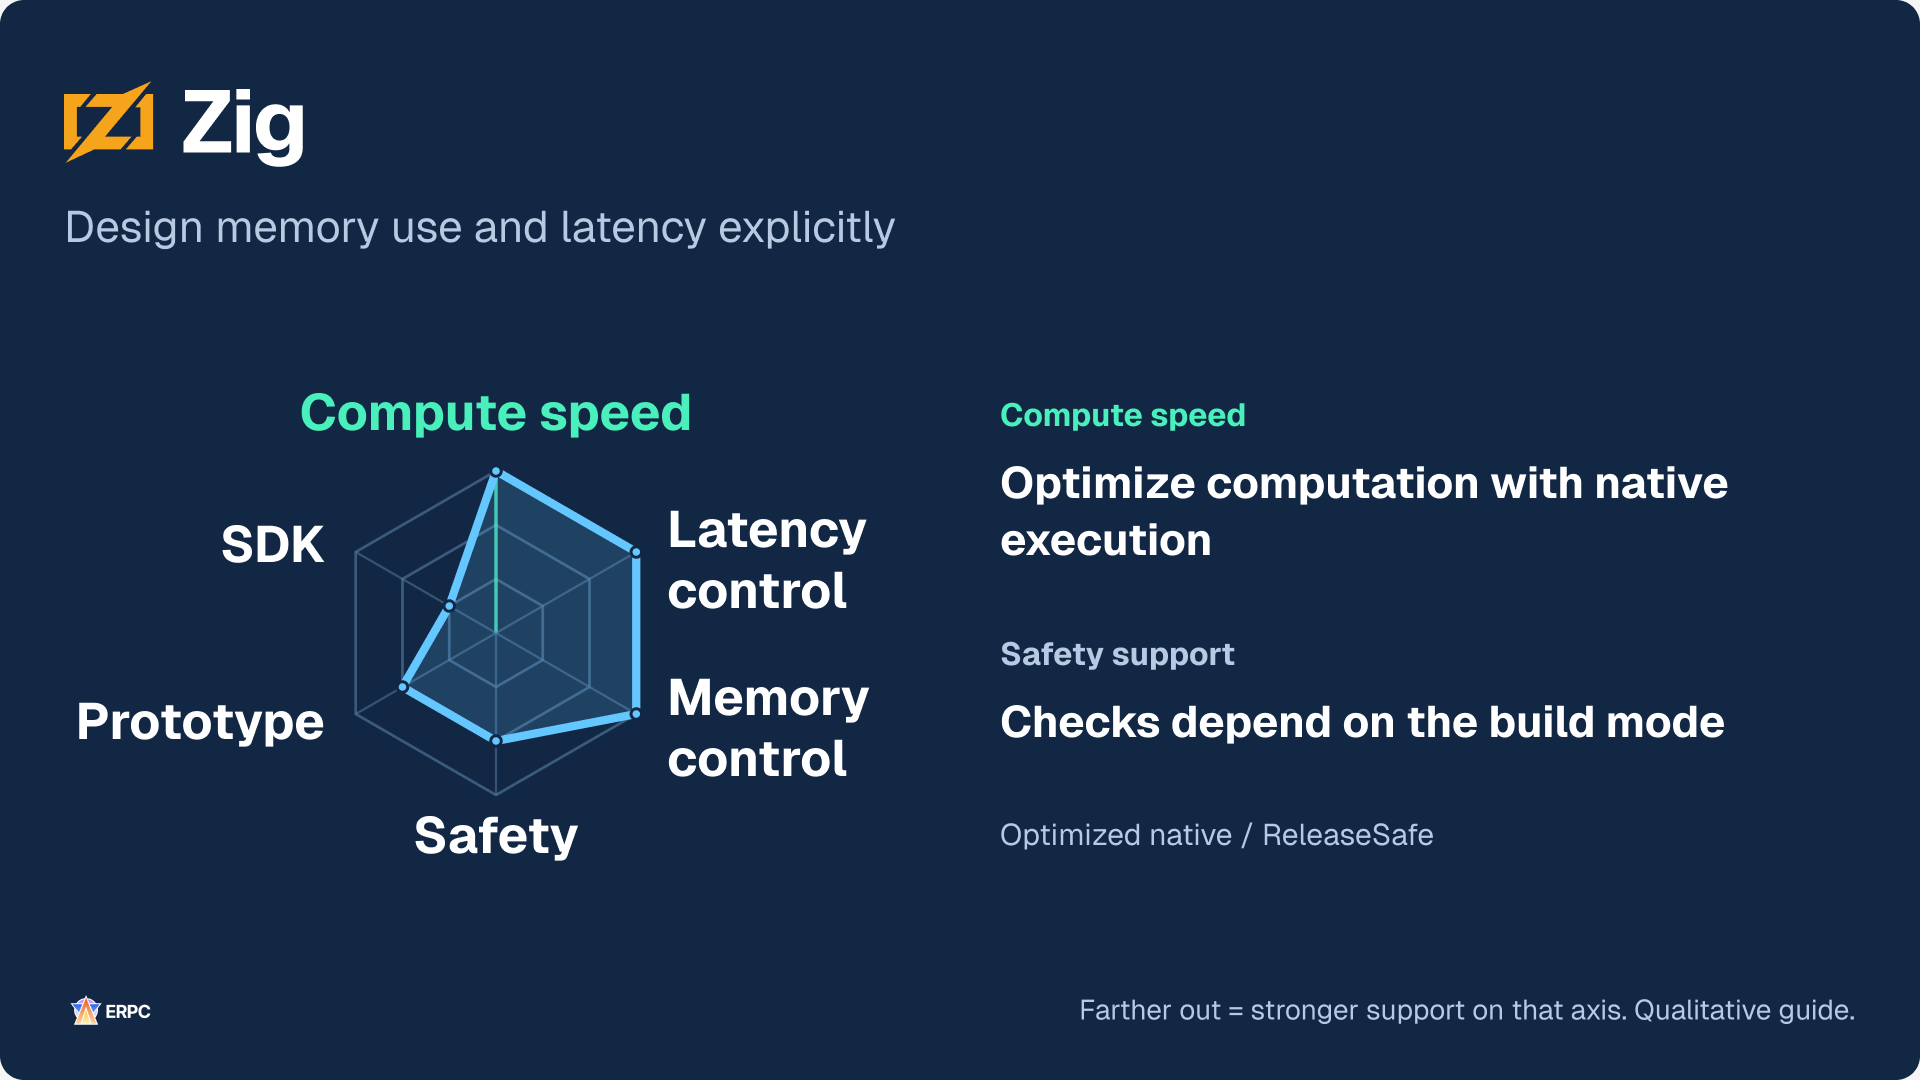
Zig consente di strutturare esplicitamente l'allocazione e la scelta dell'allocatore. Questo profilo assume i controlli di ReleaseSafe. ReleaseFast e ReleaseSmall hanno controlli predefiniti diversi e ReleaseSafe non rileva ogni caso di comportamento non valido.[25] Avere la stessa forma del poligono di C++ non implica meccanismi identici.
La dimensione SDK Solana usa i percorsi della documentazione ufficiale per TypeScript e Rust e i client Go e Python elencati lì. Non classifica il numero o la qualità generale delle librerie e non afferma che C++ e Zig ne siano privi. Per l'SDK effettivo, verifica API necessarie, stato di manutenzione e allineamento con le API e compatibilità con il runtime scelto, compreso Deno.[26]
Misura dove l'applicazione impiega tempo, poi scegli i punti di forza necessari per quella parte. Riduci prima attese e lavoro ripetuto nel linguaggio attuale. Se serve un controllo più preciso, puoi anche spostare la parte interessata in un altro linguaggio.
Confronta le modifiche nelle stesse condizioni
Le istruzioni di ciascuna sezione coprono l'implementazione e la validazione di quel miglioramento. Se applichi più miglioramenti, mantieni ogni modifica associata ai suoi risultati di misurazione. Applicare più modifiche insieme rende più difficile distinguere quale abbia prodotto ciascun effetto.
Confronta prima e dopo con gli stessi input, condizioni di sottoscrizione, carico e requisiti di output. Per il tempo dalla ricezione alla decisione completata, considera la mediana p50 insieme a p95 e p99. Il p99 è una soglia entro cui termina il 99% degli eventi misurati. Aiuta a vedere la parte più lenta della distribuzione oltre all'elaborazione tipica.
Sommare il p99 delle singole fasi non produce il p99 dell'intero percorso. Misura direttamente per ogni evento la durata completa dalla ricezione al completamento della decisione, insieme ad attese in coda, uso di CPU e memoria, aggiornamenti mancanti o scartati e corrispondenza dei risultati delle decisioni.
Per misurare il tempo trascorso sullo stesso host, usa un orologio monotono che non torni indietro quando viene corretta l'ora civile. Se un SDK richiama una callback solo dopo la decodifica, c'è stata elaborazione anche prima dell'inizio della callback. Specifica esattamente dove inizia e finisce ogni misurazione per distinguere la latenza di consegna da quella dell'applicazione.
Verifica anche cosa accade dopo l'invio. Una risposta positiva di sendTransaction non garantisce né l'elaborazione né la conferma da parte del cluster.[15] Collegare ricezione, decisione, accettazione dell'invio e risultato osservato on-chain aiuta a individuare il prossimo punto da migliorare.
Trasforma una consegna rapida in decisioni tempestive
Contano sia la rapidità di consegna sia la capacità dell'applicazione di completare in tempo le decisioni necessarie. ERPC continua a migliorare la propria infrastruttura di consegna e a produrre informazioni utili per migliorare il software che vi viene eseguito.
Valida prima le modifiche dell'applicazione nello stesso ambiente. Poi, se necessario, confronta lo stesso codice in posizioni diverse o con risorse differenti per distinguerne gli effetti. Quando usi la fatturazione oraria di ERPC, definisci in anticipo ipotesi, condizioni di confronto e durata di utilizzo, quindi verifica prezzi e disponibilità attuali nel Dashboard.
Riferimenti e collegamenti correlati
- [1] Tokio / Attività intensive per la CPU e operazioni bloccanti
- [2] Node.js / Non bloccare l'event loop
- [3] gRPC / Controllo di flusso
- [4] Yellowstone gRPC / Messaggi e specifiche delle sottoscrizioni
- [5] LMAX Disruptor / Progettazione e utilizzo
- [6] Solana / Commitment
- [7] Solana / getLatestBlockhash
- [8] Rust / Ownership
- [9] TypeScript / Comportamento a runtime e rimozione dei tipi
- [10] Deno / TypeScript
- [11] Node.js / Worker threads
- [12] Deno / Web Workers
- [13] Go / Garbage Collector
- [14] Python / Free threading
- [15] Solana / sendTransaction
- [16] Yellowstone gRPC / Definizioni dei messaggi
- [17] Rust / std::sync::Mutex
- [18] Tokio / Stato condiviso e suddivisione dei mutex
- [19] Solana / Struttura delle transazioni e firme
- [20] Go / Domande frequenti
- [21] V8 / Panoramica generale
- [22] Rust / Data race e condizioni di gara
- [23] NumPy / Che cos’è NumPy?
- [24] C++ / Linee guida fondamentali
- [25] Zig / Riferimento del linguaggio
- [26] Solana / SDK client
- [27] Programming-Language-Benchmarks / nbody
- [28] Programming-Language-Benchmarks / Measurement code (2025-07-31): execution, defaults, aggregation, Zig build, Deno configuration.
- [29] Programming-Language-Benchmarks / Published measurement data (2025-08-01)
- Loghi e fonti: Rust © Rust Foundation (CC BY 4.0, forma e colori invariati); Zig © Zig project (CC BY-SA 4.0, forma e colori invariati).
- Altri loghi: Go © The Go Authors; TypeScript © Microsoft; Python © Python Software Foundation; C++ by Jeremy Kratz / Standard C++ Foundation; Node.js / OpenJS Foundation and Node.js contributors; Deno / Deno Land Inc..
- ERPC
- ERPC Web Dashboard