10 ความเข้าใจผิดที่ทำให้แอป Solana ช้าลง: ทำไมระบบที่ควรเร็วจึงยังช้า
การเชื่อมต่อของคุณเร็ว CPU ก็ทันสมัย เซิร์ฟเวอร์อยู่ในเมืองเดียวกับผู้ให้บริการข้อมูล แต่แอปพลิเคชันยังตอบสนองต่อข้อมูลที่ต้องการได้ช้า การเชื่อมต่อยังเปิดอยู่ ทว่าข้อมูลที่กำลังประมวลผลค่อย ๆ ล้าหลังสถานะล่าสุดมากขึ้น
เมื่อพัฒนาแอปพลิเคชันที่ต้องการความหน่วงต่ำบน Solana สถานการณ์นี้ไม่ได้มีสาเหตุเพียงอย่างเดียวเสมอไป เส้นทางเครือข่าย การตั้งค่าการรับข้อมูล ข้อมูลที่สมัครรับ และการรอภายในแอปพลิเคชัน อาจรวมกันจนทำให้ใช้ประสิทธิภาพของโครงสร้างพื้นฐานความเร็วสูงที่เลือกมาได้ไม่เต็มที่
ที่ ERPC ซึ่งดำเนินงานโดย ELSOUL LABO B.V. ทีมสนับสนุนของเราพบคำถามเกี่ยวกับลูปรับข้อมูลที่หยุดค้าง การตั้งค่าไคลเอนต์ การสมัครรับข้อมูลที่กว้างเกินความจำเป็น และการพยายามเชื่อมต่อใหม่โดยยังไม่แก้ข้อผิดพลาดเดิมอยู่เสมอ ทางเลือกที่แทบไม่ก่อปัญหาในเว็บแอปพลิเคชันทั่วไป อาจกลายเป็นข้อจำกัดในการซื้อขายความถี่สูงและการประมวลผลแบบเรียลไทม์
บทความนี้สำรวจความเข้าใจผิด 10 ประการที่อยู่เบื้องหลังปัญหาเหล่านี้ เพื่อช่วยให้คุณประเมินทั้งการเลือกโครงสร้างพื้นฐานและการออกแบบที่ส่งต่อประสิทธิภาพไปจนถึงการตัดสินใจและส่งธุรกรรม
คู่มือนี้สำหรับนักพัฒนาที่มีประสบการณ์สร้างเว็บแอปพลิเคชัน และกำลังเริ่มทำแอปซื้อขายความถี่สูง (HFT) หรือแอปแบบเรียลไทม์อื่น ๆ บน Solana โดยครอบคลุมการเลือกสภาพแวดล้อมและการตรวจสอบเบื้องต้น ในบทความนี้ การสมัครรับข้อมูลหมายถึงการเลือกว่าต้องการให้แอปได้รับการอัปเดตข้อมูลใดอย่างต่อเนื่อง
เริ่มจากกำหนดว่างานใดต้องเสร็จเร็วขึ้น
เวลาไปกลับของเครือข่าย เวลาที่ข้อมูลมาถึง เวลาที่ใช้ตัดสินใจ และเวลาจนธุรกรรมได้รับการยืนยัน เป็นคนละตัวชี้วัด ping ที่เร็วไม่ช่วยให้ตัดสินใจเร็วขึ้นหากการประมวลผลหลังรับข้อมูลติดขัด และ RPC ที่ตอบกลับเร็วก็ไม่ได้หมายความว่าธุรกรรมดำเนินการแล้วเสมอไป
ตัวอย่างเช่น แอปที่รับการอัปเดตสถานะตลาด คำนวณเงื่อนไขใหม่ แล้วส่งธุรกรรมเมื่อเงื่อนไขครบ ให้แยกเวลาจนการอัปเดตมาถึง เวลาจนคำนวณเสร็จ และเวลาจนตรวจสอบผลธุรกรรมที่ส่งไปได้ การระบุว่าต้องการลดช่วงเวลาใดช่วยให้รู้ว่าควรตรวจสอบตรงไหน
จากนั้นวัดการสังเกต การประมวลผลหลังรับข้อมูล และการส่งกับการยืนยันแยกกัน การปรับปรุงเริ่มจากการไม่ย่อเรื่องความเร็วให้เหลือเพียงชื่อผลิตภัณฑ์เดียวหรือตัวเลขเดียว
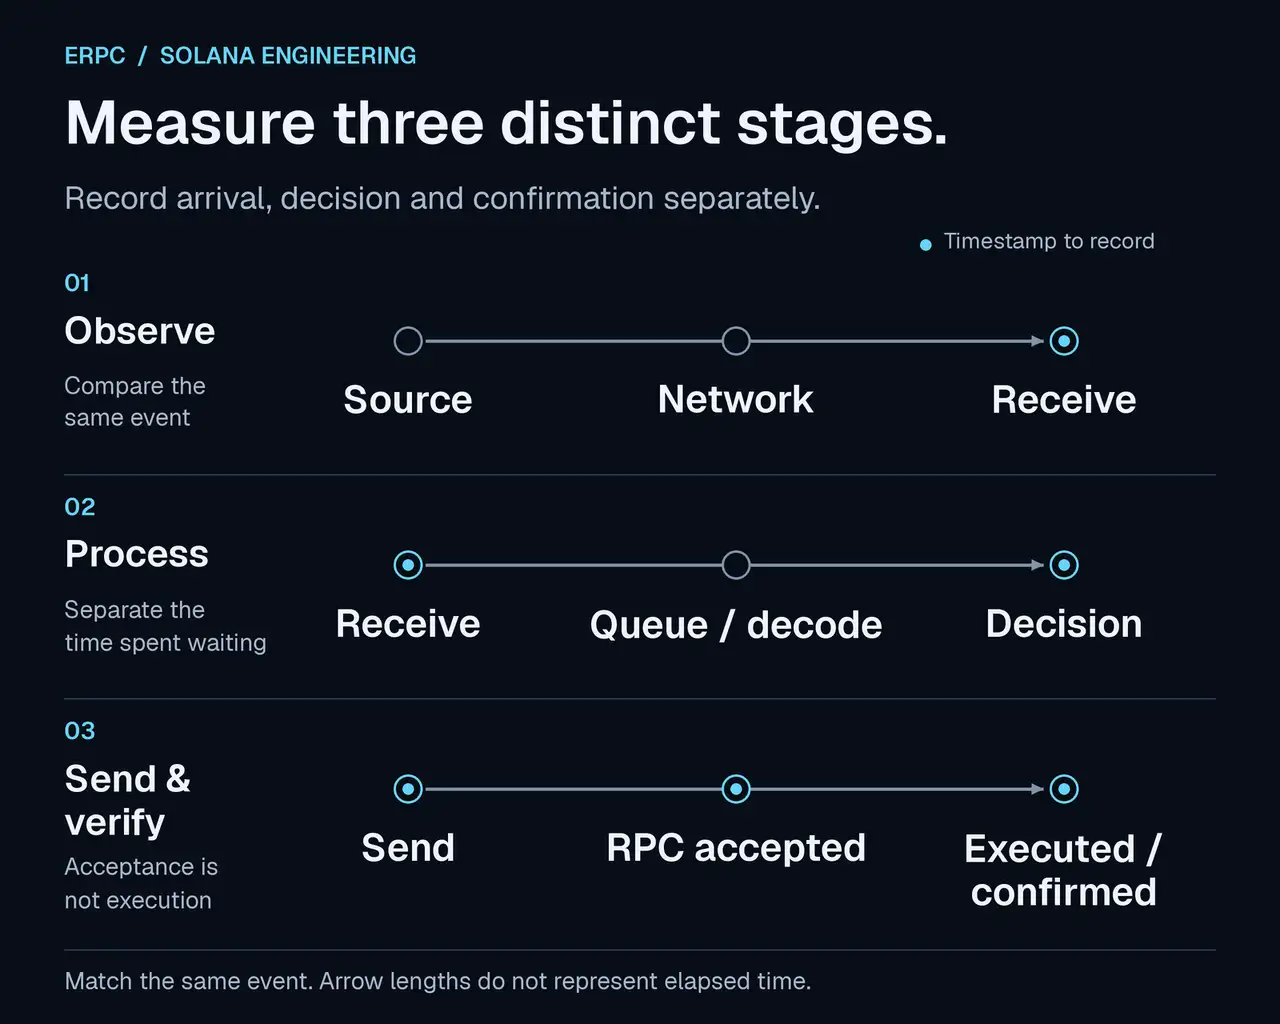
วัดการสังเกต การประมวลผลภายในแอป และการส่งกับการยืนยันแยกกัน แผนภาพนี้ไม่แสดงระยะเวลาที่วัดได้จริงหรือความแตกต่างด้านประสิทธิภาพระหว่างช่วง
ความเข้าใจผิด 1: VM ขนาดเล็กยังทำงานได้ แสดงว่ามีทรัพยากรเพียงพอ
VM ขนาดเล็กบนคลาวด์เคยรองรับเว็บแอปหรือเวิร์กโหลด Ethereum ก่อนหน้าได้ดี ประสบการณ์นั้นอาจทำให้คิดว่าการตั้งค่าเดิมจะรองรับสตรีม Solana ได้เช่นกัน แต่แอปที่เรียก RPC เป็นครั้งคราวกับแอปที่รับและประมวลผลการอัปเดตจำนวนมากอย่างต่อเนื่องต้องการทรัพยากรต่างกัน
กำหนดขนาดระบบตามปริมาณข้อมูล อัตราที่ข้อมูลมาถึง งานต่อหนึ่งเหตุการณ์ และความหน่วงที่ยอมรับได้ แต่ละวินาทีมีเหตุการณ์เข้ามากี่รายการ ถ่ายโอนกี่ไบต์ การถอดรหัสและตัดสินใจใช้เวลา CPU และหน่วยความจำเท่าใด ควรเผื่อทรัพยากรให้รับมือได้ทั้งทราฟฟิกปกติและช่วงที่พุ่งสูง แม้อยู่บนเชนเดียวกัน ขอบเขตการสมัครรับข้อมูลและวิธีเขียนโปรแกรมก็ทำให้ความต้องการต่างกันได้
ความยากคือแอปที่มีทรัพยากรไม่พออาจยังดูเหมือนทำงานได้ ข้อมูลอาจปรากฏบนหน้าจอเรื่อย ๆ ทั้งที่เก่าลงเรื่อย ๆ หรืออาจตรวจไม่พบช่วงข้อมูลที่ขาดหายระหว่างเชื่อมต่อใหม่ จำนวนเหตุการณ์ที่รับเพียงอย่างเดียวไม่สามารถบอกเรื่องนี้ได้ ต้องดูจำนวนที่ประมวลผลเสร็จ อายุของข้อมูลที่ยังไม่ถูกประมวลผล และความต่อเนื่องของเหตุการณ์ที่การสมัครรับข้อมูลควรครอบคลุมด้วย
หากอ้างอิงเพียงประสบการณ์เดิม นักพัฒนาอาจไม่เคยสงสัยความสามารถของฝั่งรับ และยังคงมองว่าเอ็นด์พอยต์ข้อมูลเป็นต้นเหตุ การทดลองในสภาพแวดล้อมที่มีทรัพยากรเผื่อมากขึ้นอาจทำให้งานค้างหรือข้อมูลที่ขาดหายซึ่งไม่เคยเห็นมาก่อนปรากฏชัดขึ้น
ในการตรวจสอบ ให้เปรียบเทียบโดยใช้เอ็นด์พอยต์ การสมัครรับข้อมูล ระดับ commitment (ขั้นการยืนยันของข้อมูลที่ขอรับ ซึ่งจะอธิบายในความเข้าใจผิด 9), SDK และการตั้งค่า รวมถึงงานประมวลผลเหมือนกัน บนสภาพแวดล้อมรับและประมวลผลที่มีทรัพยากรมากขึ้น ใช้รีเจียนเดียวกัน บันทึกความต่างของ CPU หน่วยความจำ และเครือข่าย แล้วเปรียบเทียบอัตรารับข้อมูล งานที่เสร็จ งานค้าง เหตุการณ์ที่ขาดหาย และเวลาจนตัดสินใจ เนื่องจากภาระงานเปลี่ยนตามเวลา จึงควรเปรียบเทียบในช่วงเวลาเดียวกันหากทำได้ โดยคำนึงถึงข้อจำกัดจำนวนการเชื่อมต่อและภาระที่สร้างให้บริการ
หากเปลี่ยนสภาพแวดล้อมแล้วดีขึ้น แสดงว่าเงื่อนไขด้านการรับหรือประมวลผลมีส่วนต่อผลลัพธ์ หากเปลี่ยน CPU หน่วยความจำ และเครือข่ายพร้อมกัน ยังต้องตรวจสอบเพิ่มเติมเพื่อระบุว่าทรัพยากรใดส่งผล การเลือกทรัพยากรตามปริมาณและอัตราของข้อมูลที่จัดการจริงเป็นเงื่อนไขพื้นฐานของการประมวลผลความหน่วงต่ำ
ความเข้าใจผิด 2: อยู่เมืองเดียวกันจึงใกล้กันบนเครือข่าย
“เซิร์ฟเวอร์ทั้งสองอยู่ Frankfurt จึงน่าจะใกล้กัน” “วางระบบที่ Tokyo น่าจะเร็วที่สุดสำหรับญี่ปุ่น” ชื่อเมืองช่วยในการพิจารณาตำแหน่งติดตั้ง แต่ไม่ได้รับประกันเส้นทางจริงที่ทราฟฟิกจะใช้
เส้นทางขึ้นอยู่กับการเชื่อมต่อระหว่างศูนย์ข้อมูล การเชื่อมต่อระหว่างผู้ให้บริการเครือข่าย และการเลือกเส้นทาง แม้เซิร์ฟเวอร์อยู่เมืองเดียวกัน ก็อาจอ้อมผ่านเครือข่ายภายนอก ตัวอย่างเช่น RIPE IPmap ระบุว่าหนึ่งในประโยชน์ของเครื่องมือคือการแสดงเส้นทางที่ไม่มีประสิทธิภาพ เช่น ทราฟฟิกออกนอกประเทศแล้วกลับเข้ามาอีกครั้ง [1]
วัด RTT ระหว่างแหล่งข้อมูลจริงกับโฮสต์ที่รันแอป ความแปรผันตามเวลา การส่งซ้ำหรือการสูญหาย และเวลาที่เหตุการณ์เดียวกันมาถึง Traceroute และ MTR ช่วยสำรวจเส้นทางได้ แต่จำนวน hop อย่างเดียวตัดสินไม่ได้ว่าเส้นทางใดดีกว่า อีกทั้งไม่ควรเข้าใจผิดว่าการที่เราเตอร์ระหว่างทางจำกัดคำตอบสำหรับการวินิจฉัยคือการสูญหายของแพ็กเก็ตที่กระทบแอป
หลังเลือกรีเจียนแล้ว ให้ถามเพิ่มอีกข้อว่าแหล่งข้อมูลนี้กับเซิร์ฟเวอร์เครื่องนี้เชื่อมต่อกันจริงอย่างไร การตรวจสอบเพิ่มขั้นนี้จะเปิดเผยความแตกต่างที่ชื่อเมืองเพียงอย่างเดียวบอกไม่ได้
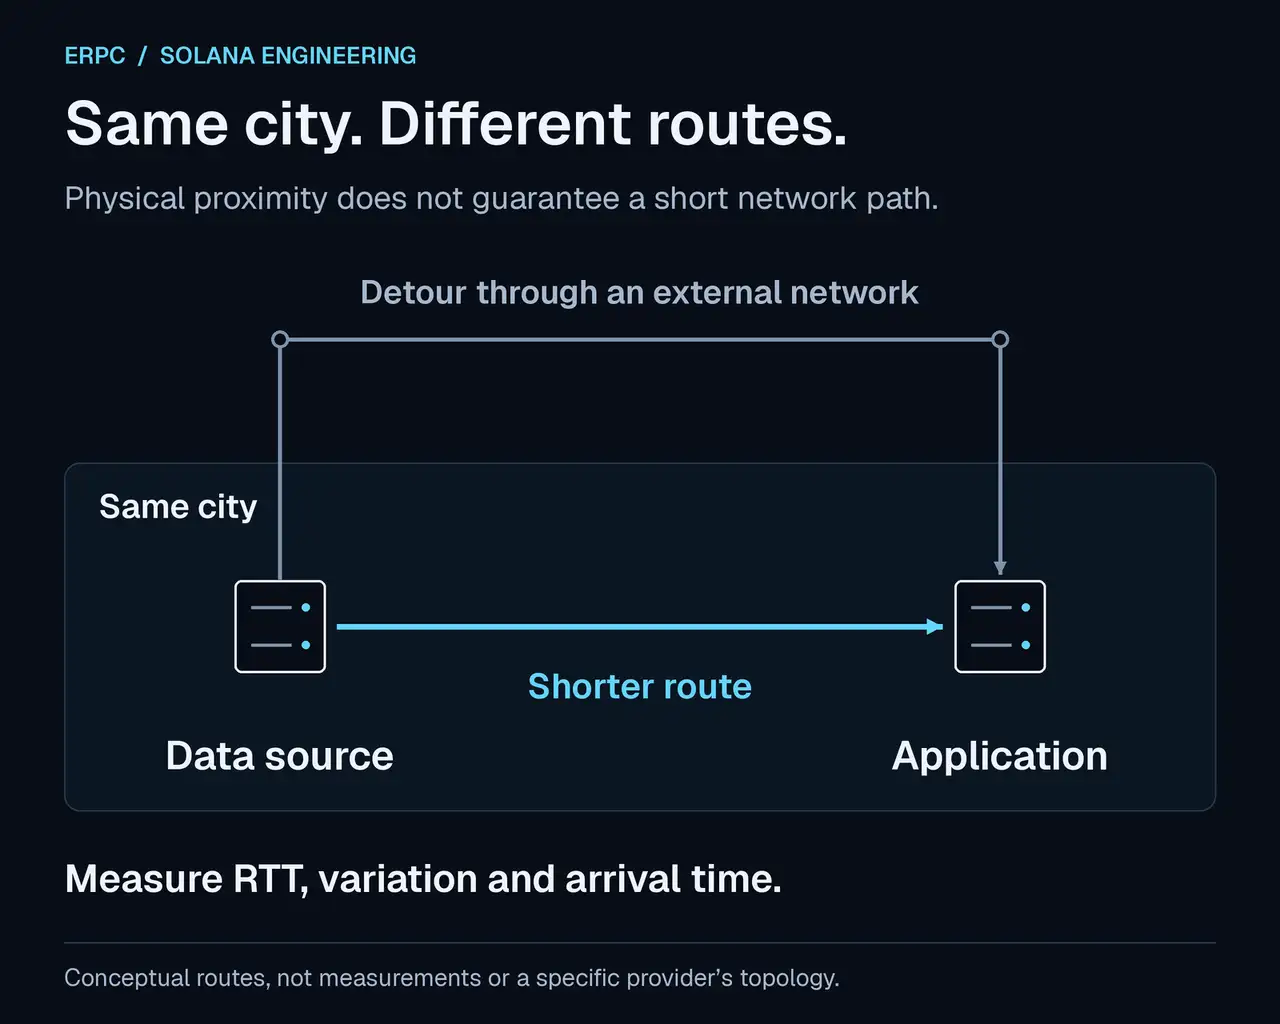
เซิร์ฟเวอร์สองเครื่องในเมืองเดียวกันอาจใช้เส้นทางและมีเวลาไปกลับต่างกัน แผนภาพนี้อธิบายแนวคิด ไม่ได้แสดงเส้นทางจริงของผู้ให้บริการรายใด
ความเข้าใจผิด 3: สเปกเครือข่ายสูงหมายถึงมีแบนด์วิดท์ให้ใช้เพียงพอ
แบนด์วิดท์ในสเปกเซิร์ฟเวอร์อาจหมายถึงหลายอย่าง ทั้งความเร็วพอร์ตจริง แบนด์วิดท์ที่จัดสรรให้เครื่องเสมือน แบนด์วิดท์ที่ใช้ได้ต่อเนื่อง หรือเพดานสำหรับการเร่งชั่วคราว การมี NIC ที่เร็วไม่ได้หมายความว่าแอปจะใช้ความจุทั้งหมดได้อย่างต่อเนื่อง
ตัวอย่างเช่น เอกสาร AWS แยก baseline bandwidth ออกจาก burst bandwidth และอธิบายข้อจำกัดที่เกี่ยวกับปลายทางของทราฟฟิก flow และอัตราแพ็กเก็ต นี่เป็นตัวอย่างวิธีอ่านสเปก ไม่ได้หมายความว่า VPS ทุกแห่งมีข้อจำกัดเหมือน AWS [2]
เมื่อเลือกแพลน ให้ตรวจสอบว่าแบนด์วิดท์เป็นแบบเฉพาะหรือใช้ร่วมกัน เงื่อนไขการใช้งานต่อเนื่อง โควตาการถ่ายโอน และการปฏิบัติต่อทราฟฟิกที่ไปยังปลายทางต่างกัน ในการทดสอบ ให้คงทราฟฟิกไปยังเอ็นด์พอยต์เดียวกันด้วยเงื่อนไขการสมัครรับข้อมูลแบบที่จะใช้จริง พร้อมดูอัตรารับข้อมูล แพ็กเก็ตที่ถูกทิ้ง การส่งซ้ำ และภาระ CPU ไปด้วยกัน
ผลทดสอบความเร็วระยะสั้นที่สูงไม่ได้พิสูจน์ว่าเซิร์ฟเวอร์จะประมวลผลสตรีมในระบบจริงได้ต่อเนื่อง ในขณะเดียวกัน อัตรารับข้อมูลต่ำก็ไม่ได้แปลว่าแบนด์วิดท์ไม่พอเสมอไป ควรแยกปัญหาการตั้งค่ารับข้อมูลออกจากข้อจำกัดการประมวลผลก่อนอัปเกรดการเชื่อมต่อ
ความเข้าใจผิด 4: CPU รุ่นดีกว่า คอร์มากกว่า หรือ GHz สูงสุดมากกว่า ทำให้แอปเร็ว
ความถี่บูสต์สูงสุดของ CPU ไม่ใช่ความเร็วสัญญาณนาฬิกาที่รักษาไว้ได้กับทุกเวิร์กโหลด การทำงานจริงขึ้นอยู่กับพลังงาน อุณหภูมิ เฟิร์มแวร์ การควบคุมความถี่ และภาระงานอื่น เอกสาร Linux อธิบายว่าการเปิด boost คือการอนุญาตให้ใช้งาน ไม่ใช่หลักฐานว่า CPU กำลังบูสต์จริง [3]
หากงานสำคัญกระจุกอยู่ในเธรดเดียว การเพิ่มคอร์อย่างเดียวจะไม่ทำให้งานนั้นเสร็จเร็วขึ้น การใช้ CPU รวมอาจดูต่ำทั้งที่คอร์หนึ่งหรือ event loop เต็มกำลังแล้ว คู่มือทางการของ Node.js ก็อธิบายว่า callback ที่ทำงานหนักทำให้งานอื่นต้องรออย่างไร [4]
ตรวจสอบความถี่ อุณหภูมิ การใช้แต่ละคอร์ และเวลาประมวลผลภายใต้ภาระงานจริง ในสภาพแวดล้อมเสมือน เวลาที่ต้องรอการจัดสรร CPU ก็เป็นเบาะแสได้ ทำ profiling เพื่อดูว่าใช้เวลาไปกับการถอดรหัส การคำนวณ การจัดสรรหน่วยความจำ และการเขียนล็อกเท่าใด
เลือกโดยพิจารณาร่วมกันทั้งประสิทธิภาพสัญญาณนาฬิกา CPU การจัดสรรทรัพยากร การตั้งค่าที่รักษาประสิทธิภาพต่อเนื่อง และการเขียนแอป การเปรียบเทียบชื่อรุ่นเพียงอย่างเดียวไม่อาจระบุความเร็วของแอปทั้งระบบได้
ความเข้าใจผิด 5: ถ้าใช้ gRPC การตั้งค่าเริ่มต้นของไคลเอนต์ก็เพียงพอ
การเชื่อมต่อ gRPC สำเร็จไม่ได้พิสูจน์ว่าสามารถรับข้อมูลปริมาณที่ต้องการด้วยความเร็วที่ต้องการได้ HTTP/2 มี flow control ซึ่งฝั่งรับใช้แจ้งฝั่งส่งว่ารับข้อมูลได้เท่าใด การควบคุมทำงานทั้งระดับสตรีมและระดับการเชื่อมต่อ ดังนั้น receive window และการอัปเดตหน้าต่างดังกล่าวอาจจำกัดอัตรารับข้อมูลได้ แม้ลิงก์เครือข่ายยังเหลือความจุ [5][6]
Receive window แจ้งฝั่งส่งว่าส่งข้อมูลได้เท่าใดก่อนต้องได้รับการอัปเดตอีกครั้งจากฝั่งรับ ค่าเริ่มต้น การปรับอัตโนมัติ และลำดับความสำคัญของการตั้งค่าต่างกันตาม SDK และไลบรารี การใส่ตัวเลขมาก ๆ ในไฟล์ตั้งค่าไม่ได้ยืนยันว่าไคลเอนต์ทำงานตามที่ตั้งใจ ต้องตรวจทั้งระดับสตรีมและการเชื่อมต่อ ความสัมพันธ์กับการตั้งค่า adaptive และเวอร์ชันที่ใช้งาน
ปรับค่าไปพร้อมกับวัดอัตรารับข้อมูลจริงและงานประมวลผลค้างภายใต้เงื่อนไขการสมัครรับข้อมูลเดียวกัน ขนาดข้อความสูงสุดที่รับได้ บัฟเฟอร์รับของ TCP และ receive window ของ HTTP/2 เป็นคนละการตั้งค่า ส่วน keepalive ตรวจว่าการเชื่อมต่อยังทำงานอยู่ ไม่ได้เพิ่มกำลังประมวลผลหรือแบนด์วิดท์
FAQ ของ ERPC gRPC มีขั้นตอนวิเคราะห์และตัวอย่างการตั้งค่าไคลเอนต์สำหรับสตรีมที่อัตรารับข้อมูลคงที่แต่ตามข้อมูลไม่ทัน ใช้ตัวอย่างเป็นจุดเริ่มต้น แล้วตรวจสอบกับปริมาณข้อมูลที่สมัครรับและความสามารถในการประมวลผลของคุณเอง ก่อนใช้ตัวอย่างการตั้งค่า ให้บันทึกชื่อ SDK และเวอร์ชันที่ใช้อยู่ ตรวจสอบว่า SDK นั้นตั้ง receive window ระดับสตรีมและการเชื่อมต่อ รวมถึงการปรับอัตโนมัติไว้ที่ใด แล้วเทียบกับตัวอย่างใน FAQ หากใช้ SDK ต่างจากตัวอย่าง ให้ตรวจสอบการตั้งค่าที่สอดคล้องกันในเอกสารของ SDK นั้น แทนการคัดลอกชื่อพารามิเตอร์และค่ามาใช้ตรง ๆ [7]
ความเข้าใจผิด 6: รับทุกบล็อกแบบเต็มแล้วจะตัดสินใจได้เร็วที่สุด
“รับทุกอย่างก่อน แล้วค่อยหาสิ่งสำคัญ” เป็นวิธีเริ่มพัฒนาที่เข้าใจง่าย แต่เพิ่มงานที่อาจไม่จำเป็นก่อนการตัดสินใจด้วย การถ่ายโอน ถอดรหัส จัดสรรหน่วยความจำ และค้นหาข้อมูลที่ไม่จำเป็น ล้วนใช้แบนด์วิดท์และ CPU ที่มีจำกัด
หากต้องการตอบสนองต่อการเปลี่ยนแปลงของตลาด โปรแกรม หรือบัญชีใดโดยเฉพาะ ให้กำหนดเหตุการณ์และฟิลด์ที่จำเป็นต่อการตัดสินใจก่อน Yellowstone gRPC มีตัวกรองการสมัครรับข้อมูลธุรกรรมและบัญชี รวมถึงวิธีรับเฉพาะบางส่วนของข้อมูลบัญชี การแจ้งเตือนบล็อกแบบเต็มกับการแจ้งเตือนการอัปเดตแต่ละรายการก็เป็นคนละอย่าง [8]
หากข้อกำหนดคือ “คำนวณเงื่อนไขใหม่ทุกครั้งที่ตลาด A เปลี่ยนแปลง” ให้เขียนรายการข้อมูลที่ใช้ระบุตลาด A สถานะที่ใช้คำนวณ และเหตุการณ์ที่อัปเดตสถานะนั้น ข้อมูลที่จำเป็นขึ้นอยู่กับข้อกำหนดของโปรแกรม จึงควรเทียบข้อกำหนดกับการอัปเดตที่ได้รับ ใช้รายการนี้ลดขอบเขตการสมัครรับข้อมูล แล้วตรวจสอบว่าสถานะที่จำเป็นต่อการตัดสินใจยังครบถ้วน
เมื่อใช้ทรัพยากรและเงื่อนไขเหมือนกัน หากแอปหนึ่งต้องรอคลี่ข้อมูลและค้นหาทุกรายการ แต่อีกแอปประมวลผลการอัปเดตที่จำเป็นได้ทันที แอปหลังย่อมตัดเวลารอนั้นออกได้ คู่แข่งที่โฟกัสมากกว่าอาจตอบสนองก่อนซ้ำ ๆ ด้วยเหตุผลนอกเหนือจากการเชื่อมต่อเครือข่าย การตัดสินว่าอะไรละไว้ได้จึงเป็นส่วนหนึ่งของการออกแบบความหน่วงต่ำ
งานทำดัชนี ตรวจสอบ วิจัย และเก็บประวัติอาจจำเป็นต้องใช้ข้อมูลทั้งหมด ควรจัดเส้นทางแยกสำหรับงานเหล่านี้ การแยกจากการตัดสินใจทันทีช่วยให้กำหนดความสามารถและความครบถ้วนที่แต่ละเส้นทางต้องการได้ อย่างไรก็ตาม ต้องตรวจสอบว่าตัวกรองไม่ได้ตัดการอัปเดตที่จำเป็นต่อการตัดสินใจที่ถูกต้องออกไป การประมวลผลแบบแบตช์ก็อาจเพิ่มปริมาณงานรวมได้ในบางกรณี จึงควรเลือกตามเวลารอที่แอปยอมรับได้
บริการ Shared gRPC ปัจจุบันของ ERPC กำหนดให้การสมัครรับ
blocks ที่ไม่ว่างต้องใช้ Dedicated คำว่าไม่ว่างในที่นี้หมายถึงมีการกำหนดรายการสมัครรับข้อมูลในส่วน blocks ของคำขอ บางความต้องการอาจใช้ transactions หรือ blocksMeta ได้ แต่ทั้งสองอย่างไม่ได้ให้ข้อมูลเหมือนบล็อกแบบเต็ม แม้เลือก Dedicated แล้ว ก็ยังต้องมีความสามารถในการประมวลผลฝั่งรับและการออกแบบการสมัครรับข้อมูลที่เหมาะสม [9]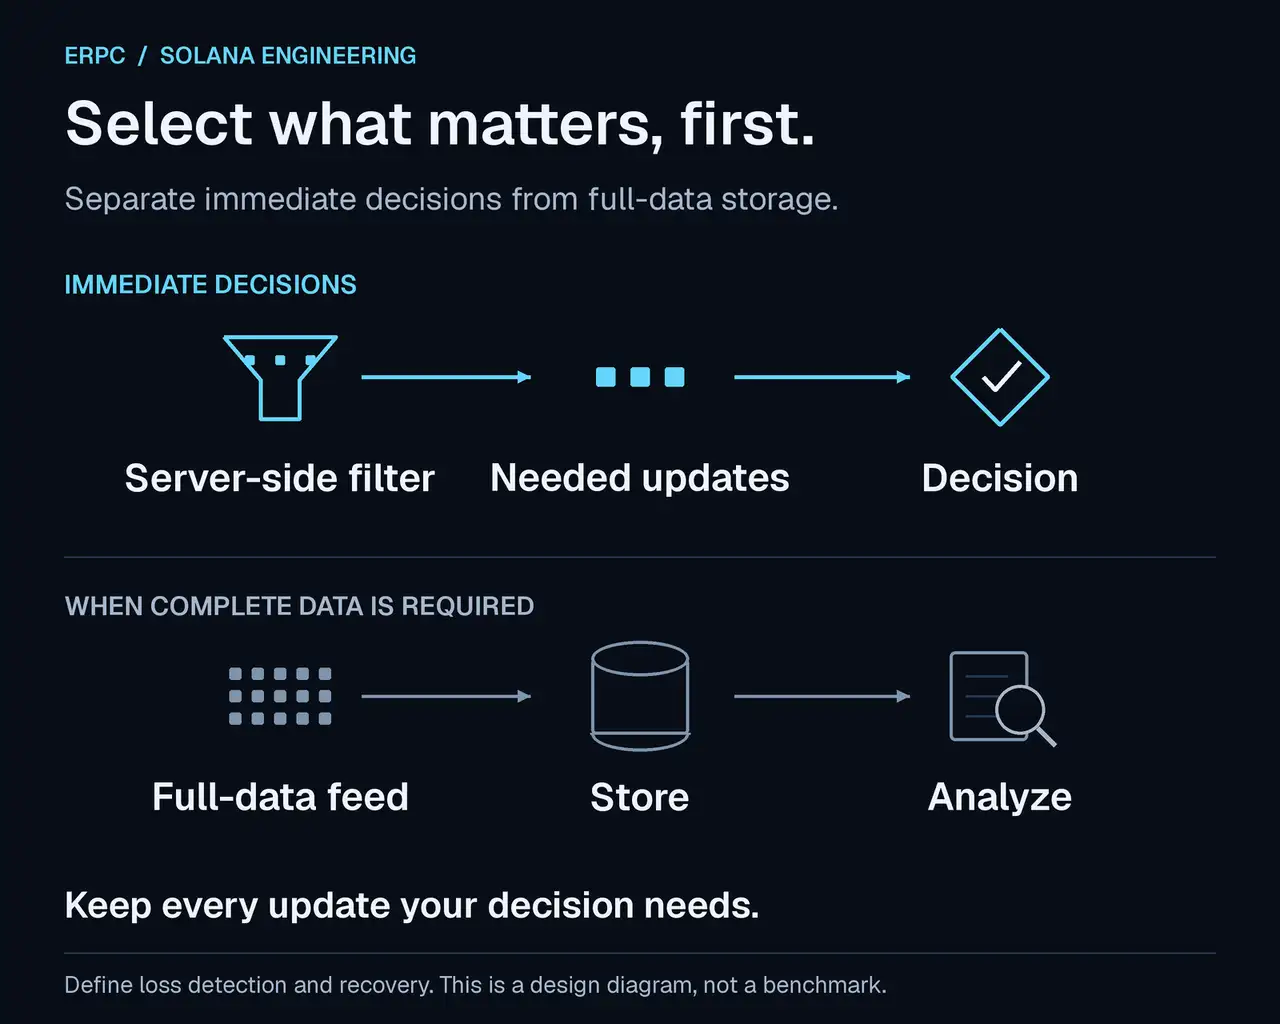
แยกเส้นทางสำหรับการอัปเดตที่ใช้ตัดสินใจทันทีออกจากเส้นทางเก็บข้อมูลทั้งหมดและวิเคราะห์ แผนภาพนี้แสดงแนวทางออกแบบสถาปัตยกรรม ตรวจสอบว่าตัวกรองยังเก็บสถานะที่จำเป็นต่อการตัดสินใจที่ถูกต้อง และกำหนดวิธีกู้คืนเมื่อข้อมูลขาดหาย
ความเข้าใจผิด 7: ข้อมูลยังเข้ามา แสดงว่าประมวลผลทัน
อาจเกิดคิวระหว่างการรับข้อมูลกับการประมวลผลจนพร้อมใช้ตัดสินใจ หากงานที่ไหลเข้ามามากกว่ากำลังประมวลผลอย่างต่อเนื่อง ความล่าช้าจะสะสมแม้การเชื่อมต่อยังเปิดอยู่ บัฟเฟอร์ใหญ่ช่วยรองรับการพุ่งสูงชั่วคราว แต่เมื่อกำลังประมวลผลไม่พอต่อเนื่อง ก็เพียงเก็บข้อมูลเก่าไว้มากขึ้น
ลองพิจารณาตัวอย่างสมมติที่เริ่มต้นโดยไม่มีงานค้าง แอปรับเหตุการณ์ชนิดเดียวกัน 12,000 รายการต่อวินาที และประมวลผลเสร็จ 10,000 รายการต่อวินาที หากเก็บทุกเหตุการณ์ไว้ในคิวได้โดยไม่ทิ้งหรือรวมเหตุการณ์ งานค้างจะเพิ่มขึ้น 2,000 รายการต่อวินาที และเป็น 20,000 รายการหลังผ่านไป 10 วินาที การเชื่อมต่อยังทำงานและข้อมูลยังปรากฏต่อเนื่อง แต่งานที่จำเป็นต่อการตัดสินใจจะตามไม่ทัน ตัวเลขเหล่านี้ใช้เพื่ออธิบายกลไก ไม่ใช่ผลวัดประสิทธิภาพจริงของ ERPC
อย่าวัดเพียงจำนวนเหตุการณ์ที่รับ ต้องวัดงานที่ประมวลผลเสร็จ ความยาวคิว อายุของรายการที่ค้างนานที่สุด และเวลาจากรับข้อมูลจนตัดสินใจเสร็จด้วย ตรวจสอบสุขภาพการเชื่อมต่อและความสดใหม่ของข้อมูลแยกกัน
ในลูปรับข้อมูล ให้เหลือเฉพาะงานที่จำเป็นต่อการรับข้อมูลอย่างต่อเนื่อง พิจารณาแยกการเขียนฐานข้อมูล ล็อก payload ทั้งหมด การเรียก API ภายนอก และการคำนวณหนักออกไปยังเส้นทางประมวลผลอื่น กำหนดความจุคิวและนโยบายเมื่อคิวเต็ม คิวที่มีขอบเขตยังทำให้งานต้นทางต้องรอได้เมื่อเต็ม จึงไม่ได้แก้ปัญหากำลังประมวลผลไม่พอด้วยตัวเอง [10]
สำหรับการอัปเดตที่สนใจเพียงสถานะล่าสุด อาจรวมสถานะเก่าเข้าด้วยกันได้ แต่เหตุการณ์ธุรกรรมที่ต้องประมวลผลตามลำดับหรือครบทุกเหตุการณ์ไม่ควรถูกทิ้งโดยไม่มีหลักเกณฑ์ ออกแบบการตรวจจับช่องว่าง การ replay และการกู้คืนสถานะหลังเชื่อมต่อใหม่ตามความต้องการของแอป
STREAM_GUARD_SLOW_READER ของ ERPC เป็นการตอบสนองเพื่อปกป้องระบบเมื่อการเขียนข้อมูลคืบหน้าไม่เพียงพอหรือพบความล่าช้าในการส่งข้อมูล ไม่ควรใช้การสังเกตนี้เพียงอย่างเดียวตัดสินสาเหตุ ต้องตรวจการเชื่อมต่อ โฮสต์ ปริมาณข้อมูลที่สมัครรับ และอัตราที่แอปนำข้อมูลไปใช้ ก่อนเชื่อมต่อใหม่ ให้เก็บ status, message, metadata และ trailers ครั้งแรกเท่าที่ได้รับ แล้วอ่านเหตุผลและเงื่อนไขการลองใหม่ที่เซิร์ฟเวอร์แจ้ง การส่งคำขอเดิมที่ถูกปฏิเสธซ้ำโดยไม่แก้ไขยังคงทิ้งสาเหตุเดิมไว้ [7]ความเข้าใจผิด 8: ping หรือค่าเฉลี่ยเร็ว หมายถึงเร็วในเวลาที่สำคัญ
Ping เป็นตัวบ่งชี้เวลาไปกลับของเครือข่าย แต่เป็นคนละช่วงกับความหน่วงของแอป ซึ่งรวมการประมวลผลที่ต้นทาง เนื้อหาที่สมัครรับ การรอรับ การถอดรหัส และการตัดสินใจ ค่าเฉลี่ยยังอาจซ่อนความล่าช้ามาก ๆ ที่เกิดขึ้นเพียงบางครั้งด้วย
p50 คือค่ามัธยฐาน ส่วน p95 และ p99 คือจุดที่ผลวัด 95% และ 99% ตามลำดับมีค่าน้อยกว่าหรือเท่ากับค่านั้น p99 ไม่ใช่ค่าสูงสุด ควรระบุจำนวนตัวอย่างและช่วงเวลาที่วัด พร้อมตรวจค่าช่วงที่เหตุการณ์เข้ามามาก ค่าสูงสุด timeout การหลุดของการเชื่อมต่อ และข้อมูลที่ขาดหาย [11]
เมื่อเปรียบเทียบผู้ให้บริการ ให้จับคู่เหตุการณ์ ชนิดข้อมูล commitment และเงื่อนไขการสมัครรับข้อมูลที่ตรงกัน หากเป็นไปได้ ให้รับบนโฮสต์วัดเดียวกัน และใช้ monotonic clock ซึ่งเป็นนาฬิกาที่ไม่เดินย้อนกลับ สำหรับวัดระยะเวลาภายในแอป เริ่มจากบันทึกเวลาที่เหตุการณ์เดียวกันมาถึงแอปและเวลาที่ตัดสินใจเสร็จ แล้วหาผลต่าง เมื่อนำ timestamp จากคนละโฮสต์มาลบกัน ต้องคำนึงถึงความต่างของนาฬิกาที่อาจปะปนในผลวัด
การเก็บเฉพาะเหตุการณ์ที่สำเร็จอาจทำให้ระบบที่ข้อมูลขาดหายบ่อยดูเร็ว การเลือกผลครั้งเดียวที่เร็วที่สุดกับการเลือกสภาพแวดล้อมที่มีโอกาสตามไม่ทันน้อยกว่าในเวลาสำคัญของระบบจริง เป็นคนละการตัดสินใจ
ความเข้าใจผิด 9: ข้อมูลที่มาถึงก่อนมีความหมายและระดับการยืนยันเหมือนกัน
Shreds การแจ้งเตือนธุรกรรม การอัปเดตบัญชี และการแจ้งเตือนบล็อก ไม่ใช่ข้อมูลเดียวกันในขั้นตอนเดียวกัน การใช้ข้อมูลจากขั้นตอนก่อนหน้าอาจทำให้แอปต้องทำงานสร้างข้อมูลกลับคืนหรือแปลความเพิ่มเติม การเปรียบเทียบต้องเทียบให้ตรงทั้งเวลาที่รับและสิ่งที่รู้ได้ ณ เวลานั้น [8][12]
ต้องแยกระดับ commitment ของ Solana ได้แก่
processed, confirmed และ finalized ด้วย หากใช้สิ่งที่สังเกตได้ตั้งแต่เนิ่น ๆ มาตัดสินใจ แอปต้องตรวจสถานะการยืนยันภายหลังและแก้สถานะเมื่อจำเป็น แยกการรับการอัปเดตเร็วออกจากเงื่อนไขสำหรับดำเนินการขั้นสุดท้ายในระบบภายนอก [13]ตัวอย่างเช่น การนำการแจ้งเตือนที่รับด้วย commitment ต่างกันมาเทียบตรง ๆ แล้วบอกว่าฝั่งหนึ่งเร็วกว่าเป็นจำนวนมิลลิวินาที ไม่ใช่การเปรียบเทียบงานเดียวกัน กำหนดข้อมูลและระดับความแน่นอนของการยืนยันที่แอปต้องการก่อน แล้วจึงวัดว่าใช้เวลาเท่าใดจนพร้อมตัดสินใจภายใต้เงื่อนไขนั้น
ความเข้าใจผิด 10: ส่งสำเร็จหมายความว่าธุรกรรมจะถูกดำเนินการก่อน
ผลตอบกลับ
sendTransaction ที่สำเร็จหมายถึง RPC รับธุรกรรมไว้แล้ว ไม่ได้รับประกันว่าคลัสเตอร์ประมวลผลหรือยืนยันแล้ว ข้อกำหนดของ Solana ระบุชัดว่าต้องตรวจสถานะของ signature แยกต่างหาก [14]แม้ข้อมูลที่รับมาจะช่วยให้ตัดสินใจได้เร็ว เส้นทางส่ง ความถูกต้องของ blockhash การแย่งใช้บัญชีที่เขียนได้ ทรัพยากรคำนวณ ค่าธรรมเนียมลำดับความสำคัญ และเงื่อนไขความสำเร็จของธุรกรรมเองยังมีผล SWQoS เกี่ยวข้องกับการรับเข้าระบบและลำดับความสำคัญของการเชื่อมต่อไปยัง leader ส่วน priority fees มีผลต่อลำดับความสำคัญในการจัดตาราง ทั้งสองมีบทบาทต่างกัน และไม่มีอย่างใดรับประกันลำดับดำเนินการหรือความสำเร็จโดยไม่มีเงื่อนไข [15][16]
บันทึกเวลาตัดสินใจเสร็จ เริ่มส่ง RPC รับคำขอ ผลการดำเนินการ และสถานะการยืนยันที่ต้องการแยกกัน เมื่อส่งซ้ำ ให้แยกระหว่างการส่งธุรกรรมที่มี signature เดิมอีกครั้งกับการสร้างธุรกรรมใหม่ เพื่อป้องกันการกระทำซ้ำโดยไม่ตั้งใจ
เมื่อสังเกตได้ตลอดเส้นทางตั้งแต่รับข้อมูลจนถึงการยืนยัน จึงจะระบุได้ว่าการปรับปรุงใดช่วยให้เข้าใกล้เป้าหมาย
ตัวชี้วัดที่ควรเริ่มเก็บก่อน
เริ่มตรวจสอบด้วย 3 ขั้นตอนนี้
- เลือกการตัดสินใจหนึ่งอย่าง แล้วเขียนว่าต้องใช้การอัปเดตใดและต้องมีสถานะใดครบก่อนที่แอปจะตัดสินใจได้
- ในช่วงเวลาวัดเดียวกัน ให้บันทึกจำนวนเหตุการณ์ชนิดเดียวกันที่รับ ประมวลผลเสร็จ และยังค้างอยู่ หากมีงานอยู่ในคิว ให้วัดเวลาที่ผ่านไปนับจากแอปรับเหตุการณ์ค้างที่เก่าที่สุดด้วย
- หากงานค้างหรือเวลารอเพิ่มขึ้นต่อเนื่อง ให้หาว่างานสะสมอยู่ตรงไหน เลือกปรับหนึ่งอย่างที่ตรงกับอาการ ไม่ว่าจะเป็นข้อมูลที่สมัครรับ วิธีประมวลผล การตั้งค่า หรือสภาพแวดล้อมที่รันแอป แล้วเปรียบเทียบผลก่อนและหลัง
เวลาที่นับจากแอปรับข้อมูลบอกถึงการรอภายในแอป ส่วนความล่าช้าตั้งแต่เหตุการณ์เกิดที่ต้นทางจนแอปรับข้อมูลต้องวัดแยกกัน เมื่อมีข้อมูลบันทึกเบื้องต้นแล้ว ให้ใช้ตารางต่อไปนี้ขยายขอบเขตการตรวจสอบ
| ช่วง | สิ่งที่ต้องบันทึก | ปัญหาที่ช่วยระบุ |
|---|---|---|
| เครือข่ายและการรับข้อมูล | อัตรารับข้อมูลจริง การส่งซ้ำและสูญหาย เวลามาถึงที่ต่างกันของเหตุการณ์เดียวกัน | ข้อจำกัดของเส้นทาง แบนด์วิดท์ และการตั้งค่ารับข้อมูล |
| แอปพลิเคชัน | จำนวนที่รับและประมวลผลเสร็จ ความยาวคิว อายุรายการเก่าที่สุด | กำลังประมวลผลที่ไม่พอต่อเนื่องและข้อมูลเก่าที่สะสม |
| เวลาจนตัดสินใจ | p50, p95, p99 และเวลาสูงสุดจากรับข้อมูลจนตัดสินใจเสร็จ | งานที่ใช้ทรัพยากรมากและความล่าช้าเมื่อเหตุการณ์พุ่งสูง |
| การส่งและการยืนยัน | เวลาเริ่มส่ง RPC รับคำขอ สถานะ signature ข้อผิดพลาดในการดำเนินการ | ความล่าช้าและความล้มเหลวหลังรับข้อมูล |
| เงื่อนไขการเปรียบเทียบ | รีเจียน โฮสต์ SDK และเวอร์ชัน การสมัครรับข้อมูล commitment ช่วงเวลาและจำนวนตัวอย่าง | ความต่างที่ดูเหมือนเกิดจากประสิทธิภาพแต่จริง ๆ มาจากเงื่อนไขต่างกัน |
เก็บค่าฐานไว้ แล้วตรวจสอบการเปลี่ยนแปลงทีละอย่างตามอาการ ได้แก่ ขอบเขตการสมัครรับข้อมูล การแยกงานประมวลผล การตั้งค่าไคลเอนต์ และตำแหน่งหรือทรัพยากร หากขยาย window ให้ดูด้วยว่าหน่วยความจำและงานค้างเพิ่มหรือไม่ หากลดขอบเขตการสมัครรับข้อมูล ให้ตรวจว่าข้อมูลจำเป็นไม่หายไป
p99 ของเวลารวมไม่ได้คำนวณด้วยการบวก p99 ของแต่ละช่วงโดยตรง ต้องคำนวณจากเวลารวมของแต่ละเหตุการณ์ที่จับคู่กัน และใช้ผลวัดแยกช่วงค้นหาสาเหตุ ทดสอบทั้งภาระเฉลี่ยและช่วงที่เหตุการณ์พุ่งสูงจริง
ERPC เตรียมโครงสร้างพื้นฐาน เพื่อให้นักพัฒนาปรับปรุงตรรกะของตน
เมื่อเลือกเครือข่าย เซิร์ฟเวอร์ การส่งข้อมูล และไคลเอนต์แยกกัน แม้แต่ละส่วนมีสเปกดี ก็อาจยังมีเวลารอระหว่างส่วน ERPC รวมการส่งข้อมูล Solana และสภาพแวดล้อมประมวลผลไว้บนแพลตฟอร์มเดียว เพื่อลดงานที่นักพัฒนาต้องทำซ้ำในการเลือกตำแหน่งและทรัพยากรจากศูนย์
SUPER VPS และ Premium VPS ระบุการใช้ CPU ความถี่สูงและจัดสรรทรัพยากรโดยไม่ overcommit ส่วน Bare Metal ให้เครื่องจริงที่ใช้งานเฉพาะราย ERPC จัดเครือข่ายและเซิร์ฟเวอร์ไว้ใกล้สภาพแวดล้อมส่งข้อมูล พร้อมเตรียม CPU หน่วยความจำ สตอเรจ และการเชื่อมต่อสำหรับการประมวลผลต่อเนื่อง สามารถตรวจสอบสเปกเฉพาะของแต่ละแพลนและรีเจียนได้ [17][18]
| อุปสรรคที่พบบ่อยในการพัฒนา | โครงสร้างพื้นฐานและข้อมูลที่ ERPC มีให้ | สิ่งที่ควรปรับปรุงในแอป |
|---|---|---|
| ระยะทางที่ชื่อเมืองบอกไม่ได้ | รีเจียนและเครือข่ายที่ช่วยให้เลือกสภาพแวดล้อมส่งข้อมูลและประมวลผลร่วมกัน | วัดเวลามาถึงและความแปรผันตามเงื่อนไขข้อมูลที่สมัครรับ |
| การแย่งทรัพยากรและประสิทธิภาพต่อเนื่อง | SUPER VPS และ Premium VPS ความถี่สูงที่ไม่ overcommit และ Bare Metal เฉพาะราย | ระบุงานหนักและการประมวลผลแบบลำดับ |
| ปริมาณข้อมูลและวิธีเชื่อมต่อ | gRPC, Shreds, RPC และทางเลือกแบบใช้ร่วมกันหรือเฉพาะรายตามเวิร์กโหลด | กำหนดเหตุการณ์และฟิลด์ที่จำเป็น |
| การตั้งค่ารับข้อมูลและแก้ปัญหา | Solana Stream SDK ตัวอย่างการตั้งค่า เอกสารตัวกรอง และ FAQ แยกตามข้อผิดพลาด | ตรวจสอบค่าที่มีผลจริง คิว การเชื่อมต่อใหม่ และการกู้คืน |
ERPC ช่วยให้นักพัฒนาเดินหน้าเลือกและปรับโครงสร้างพื้นฐาน เพื่อมีเวลามากขึ้นในการพัฒนาว่าจะสังเกตอะไร ใช้ข้อมูลใดตัดสินใจ และส่งเมื่อใด เมื่อเลือกบริการและตำแหน่งเหมาะสมแล้ว การทำให้ปริมาณข้อมูลที่สมัครรับสอดคล้องกับความสามารถประมวลผลจะเปลี่ยนประสิทธิภาพอินฟราให้เป็นความเร็วของแอป
เริ่มจากตัดสินว่าข้อมูลใดจำเป็นต่อการตัดสินใจจริง ๆ รับข้อมูลนั้นให้เร็ว ประมวลผลโดยไม่รอเกินจำเป็น และตรวจสอบผล ERPC จะยังคงจัดเตรียมสภาพแวดล้อมและข้อมูลเพื่อสนับสนุนการปรับปรุงนี้อย่างต่อเนื่อง
แหล่งข้อมูลสำหรับการพัฒนา
- ERPC gRPC FAQ: https://erpc.global/th/faq/grpc/general/
- ตัวกรองการสมัครรับข้อมูลและข้อจำกัด Shared ปัจจุบัน: https://erpc.global/th/doc/geyser-grpc/filter/
- แนวทางที่ดีสำหรับการพัฒนา gRPC: https://erpc.global/th/doc/geyser-grpc/best-practices/
- Solana Stream SDK: https://github.com/ValidatorsDAO/solana-stream
- ERPC VPS: https://erpc.global/th/vps/
- ERPC Bare Metal: https://erpc.global/th/baremetal/
- ERPC Dashboard: https://dashboard.erpc.global/
- Discord ทางการของ Validators DAO: https://discord.gg/C7ZQSrCkYR
เอกสารอ้างอิงทางเทคนิค
- RIPE IPmap การแสดงเส้นทางที่ไม่มีประสิทธิภาพ: https://ipmap.ripe.net/
- AWS แบนด์วิดท์เครือข่ายของอินสแตนซ์: https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/ec2-instance-network-bandwidth.html
- Linux Kernel การปรับประสิทธิภาพ CPU: https://docs.kernel.org/admin-guide/pm/cpufreq.html
- Node.js การหลีกเลี่ยงการบล็อก event loop: https://nodejs.org/en/learn/asynchronous-work/dont-block-the-event-loop
- IETF RFC 9113 การควบคุมการไหลของ HTTP/2: https://httpwg.org/specs/rfc9113.html#FlowControl
- gRPC การควบคุมการไหล: https://grpc.io/docs/guides/flow-control/
- ERPC การตั้งค่ารับข้อมูล slow reader และ retry ใน gRPC FAQ: https://erpc.global/th/faq/grpc/general/
- Yellowstone gRPC ข้อกำหนดการสมัครรับข้อมูลและตัวกรอง: https://github.com/rpcpool/yellowstone-grpc
- ERPC กฎตัวกรอง Shared ปัจจุบัน: https://erpc.global/th/doc/geyser-grpc/filter/
- Tokio คิวและ backpressure: https://tokio.rs/tokio/tutorial/channels
- AWS CloudWatch นิยามเปอร์เซ็นไทล์: https://docs.aws.amazon.com/AmazonCloudWatch/latest/monitoring/Statistics-definitions.html
- ERPC Shreds UDP Forwarding: https://erpc.global/th/doc/shredstream/udp-forwarding/
- Solana การยืนยันและการหมดอายุของธุรกรรม: https://solana.com/developers/cookbook/transactions/confirmation
- Solana sendTransaction: https://solana.com/docs/rpc/http/sendtransaction
- Solana คุณภาพบริการที่ถ่วงน้ำหนักตามสเตค: https://solana.com/docs/defi/stake-weighted-qos
- Solana ค่าธรรมเนียมธุรกรรม: https://solana.com/docs/core/fees
- ERPC การกำหนดค่าและสเปก VPS: https://erpc.global/th/vps/
- ERPC การกำหนดค่าและสเปก Bare Metal: https://erpc.global/th/baremetal/