








ช่วยให้แอป Solana ของคุณทำงานเร็วขึ้น: ทบทวนปริมาณข้อมูล gRPC การประมวลผลขณะรับข้อมูล และทรัพยากรขณะทำงาน
แอป Solana ที่คุณกำลังพัฒนาอาจทำงานได้เร็วขึ้น ปริมาณข้อมูลที่รับเข้ามา การประมวลผลหลังจากนั้น และทรัพยากรอย่าง CPU กับเครือข่าย ล้วนส่งผลร่วมกัน การทบทวนองค์ประกอบเหล่านี้อาจช่วยดึงประสิทธิภาพจากซอฟต์แวร์ที่มีอยู่ได้มากขึ้น
คุณเริ่มพัฒนา HFT บน Solana เชื่อมต่อกับ Geyser gRPC และเห็นข้อมูลในล็อกแล้ว แต่การตัดสินใจยังไม่เร็วเท่าที่คาดหวัง เวลารอระหว่างการรับข้อมูลกับการตัดสินใจอาจเป็นเบาะแสว่าควรปรับปรุงตรงไหน เริ่มจากหาจุดที่สังเกตได้ในโค้ดปัจจุบันก่อน
ที่ ERPC การพูดคุยและข้อเสนอแนะจากลูกค้าทำให้เราได้ทบทวนทั้งการส่งข้อมูล การตั้งค่าการรับ และการประมวลผลของแอป มุมมองที่ได้ช่วยให้เราปรับปรุงบริการส่งข้อมูลและเอกสาร บทความนี้อธิบายกลไกและขั้นตอนตรวจสอบ เพื่อให้นักพัฒนาที่เพิ่งเริ่มจัดการสตรีมความเร็วสูงและข้อมูลปริมาณมากค้นหาจุดปรับปรุงในสภาพแวดล้อมของตนเองได้
เริ่มจากตรวจสอบเรื่องเล็ก ๆ หนึ่งเรื่องในโค้ดปัจจุบัน
ศัพท์เทคนิคและคำสั่งวินิจฉัยสามารถค้นคว้าเมื่อจำเป็นต้องใช้ได้ หากคุณมีเอเจนต์ AI ที่อ่านโค้ดของโปรเจกต์ได้ ลองส่งคำขอสั้น ๆ ด้านล่างก่อน โดยเพิ่มข้อมูลว่าแอปรันอยู่ที่ไหนและรู้สึกว่าช้าในช่วงใด ข้อกำหนดที่ยังไม่ตัดสินใจหรือค่าที่วัดไม่ได้สามารถคงไว้ตามนั้น แล้วเริ่มจากสิ่งที่ตรวจสอบได้
text
ฉันอยากทราบว่าแอป Solana ของฉันยังมีโอกาสตอบสนองได้เร็วขึ้นหรือไม่
ก่อนอื่นให้อ่านโค้ดปัจจุบัน และระบุจุดที่รับข้อมูลกับจุดที่การตัดสินใจโดยใช้ข้อมูลนั้นเสร็จสมบูรณ์ คงเงื่อนไขการสมัครรับเดิมไว้ แล้วเสนอการเปลี่ยนแปลงที่เล็กที่สุดเพื่อวัดจำนวนเหตุการณ์และเวลาที่ผ่านไปในช่วงนั้น
สำหรับงานแรกนี้ ขอเพียงแสดงจุดวัด การเปลี่ยนแปลงที่เสนอ สิ่งที่จะทราบได้ และส่วนที่ยังไม่ได้วัด หากเข้าโฮสต์ไม่ได้ ให้เริ่มจากสิ่งที่สังเกตได้ภายในแอป อย่าแสดงข้อมูลลับ เปลี่ยนระบบ production หรือสร้างทรัพยากรที่มีค่าใช้จ่าย
ฉันอยากทราบว่าแอป Solana ของฉันยังมีโอกาสตอบสนองได้เร็วขึ้นหรือไม่
ก่อนอื่นให้อ่านโค้ดปัจจุบัน และระบุจุดที่รับข้อมูลกับจุดที่การตัดสินใจโดยใช้ข้อมูลนั้นเสร็จสมบูรณ์ คงเงื่อนไขการสมัครรับเดิมไว้ แล้วเสนอการเปลี่ยนแปลงที่เล็กที่สุดเพื่อวัดจำนวนเหตุการณ์และเวลาที่ผ่านไปในช่วงนั้น
สำหรับงานแรกนี้ ขอเพียงแสดงจุดวัด การเปลี่ยนแปลงที่เสนอ สิ่งที่จะทราบได้ และส่วนที่ยังไม่ได้วัด หากเข้าโฮสต์ไม่ได้ ให้เริ่มจากสิ่งที่สังเกตได้ภายในแอป อย่าแสดงข้อมูลลับ เปลี่ยนระบบ production หรือสร้างทรัพยากรที่มีค่าใช้จ่ายผลลัพธ์แรกที่มีประโยชน์คือรู้ว่าควรวัดอะไรและตรงไหนในโค้ดของตนเอง การแยกช่วงที่สังเกตได้ออกจากช่วงที่ยังไม่ได้วัดช่วยให้เลือกสิ่งที่จะตรวจสอบต่อได้ง่ายขึ้น ช่วงท้ายบทความมีพรอมป์ต์ที่ละเอียดขึ้นสำหรับการวินิจฉัยต่อไป
ตัวอย่างเช่น เอเจนต์อาจตอบว่า “รับข้อมูลที่
onData ใน stream.ts และการตัดสินใจเสร็จสมบูรณ์ที่ onDecisionComplete ใน strategy.ts ขอเสนอการเปลี่ยนแปลงเพื่อสรุปรวมจำนวนเหตุการณ์ที่รับมา จำนวนการตัดสินใจที่เสร็จสมบูรณ์ และเวลาที่ผ่านไปในช่วงนี้ ในข้อเสนอการวัดนี้ ช่วงก่อน callback อยู่นอกขอบเขตการวัด” นี่คือตัวอย่างคำตอบที่ใช้ชื่อไฟล์และชื่อฟังก์ชัน TypeScript ที่สมมติขึ้น ไม่ว่าจะใช้ภาษาโปรแกรมใด ให้ตรวจสอบว่าสามส่วนนี้สอดคล้องกัน ได้แก่ ตำแหน่งในโค้ดจริง ข้อมูลที่จะเพิ่มการบันทึก และข้อจำกัดของการวัดครั้งนี้ หากการรับข้อมูลและการตัดสินใจไม่ได้มีความสัมพันธ์แบบหนึ่งต่อหนึ่ง ให้ขอให้เอเจนต์เสนอความสัมพันธ์และหน่วยที่ใช้ในการนับด้วยเพิ่มมุมมองเรื่องสตรีมต่อยอดจากประสบการณ์พัฒนา Web
บริการแบบจัดการให้ช่วยให้นักพัฒนาสร้างฟีเจอร์ Web ได้หลายอย่างโดยไม่ต้องลงรายละเอียดขององค์ประกอบเซิร์ฟเวอร์แต่ละส่วน ประสบการณ์นั้นยังเป็นพื้นฐานในการทำงานกับสตรีม Solana ได้เช่นกัน แล้วเพิ่มมุมมองว่ามีข้อมูลไหลเข้ามาต่อเนื่องมากเพียงใด และแอปประมวลผลได้เร็วแค่ไหน
การเชื่อมต่อ SDK กับ Solana อาจดูง่ายพอ ๆ กัน แต่การสมัครรับธุรกรรมหรือการอัปเดตบัญชีในวงกว้างทำให้ภาระงานเปลี่ยนไป ความต้องการแบนด์วิดท์ CPU และหน่วยความจำขึ้นอยู่กับรายการที่สมัครรับ ขนาดข้อความ การบีบอัด การประมวลผลของแอปพลิเคชัน และปริมาณทราฟฟิกในขณะนั้น จึงไม่มีตัวเลขเมกะไบต์ต่อวินาทีค่าเดียวที่ตายตัวสำหรับ “Solana”
จุดเริ่มต้นคือการนำความสัมพันธ์ระหว่างงานที่เข้ามากับกำลังประมวลผลมาเป็นส่วนหนึ่งของการออกแบบและการวัดผล
สตรีมที่ยังไหลอยู่ก็อาจสะสมคิวได้
เริ่มจากเปรียบเทียบข้อมูลที่เข้ามาในช่วง 1 วินาทีเดียวกันด้วยสี่เหลี่ยมขนาดเท่ากัน สี่เหลี่ยมแต่ละช่องแทน 1,000 ข้อความ หากสมมติว่าข้อความละ 1 kB ก็รวมเป็น 1 MB ตัวอย่างที่รับน้อยได้รับ 2 MB ต่อวินาที ส่วนตัวอย่างที่รับมากได้รับ 12 MB ต่อวินาที โดยแอปฝั่งรับมีกำลังประมวลผลเท่ากันทั้งสองกรณี นี่คือแบบจำลองเพื่ออธิบายปริมาณเพย์โหลดของข้อความในหน่วยฐานสิบ โดยไม่รวมการบีบอัดและส่วนหัวของโปรโตคอล
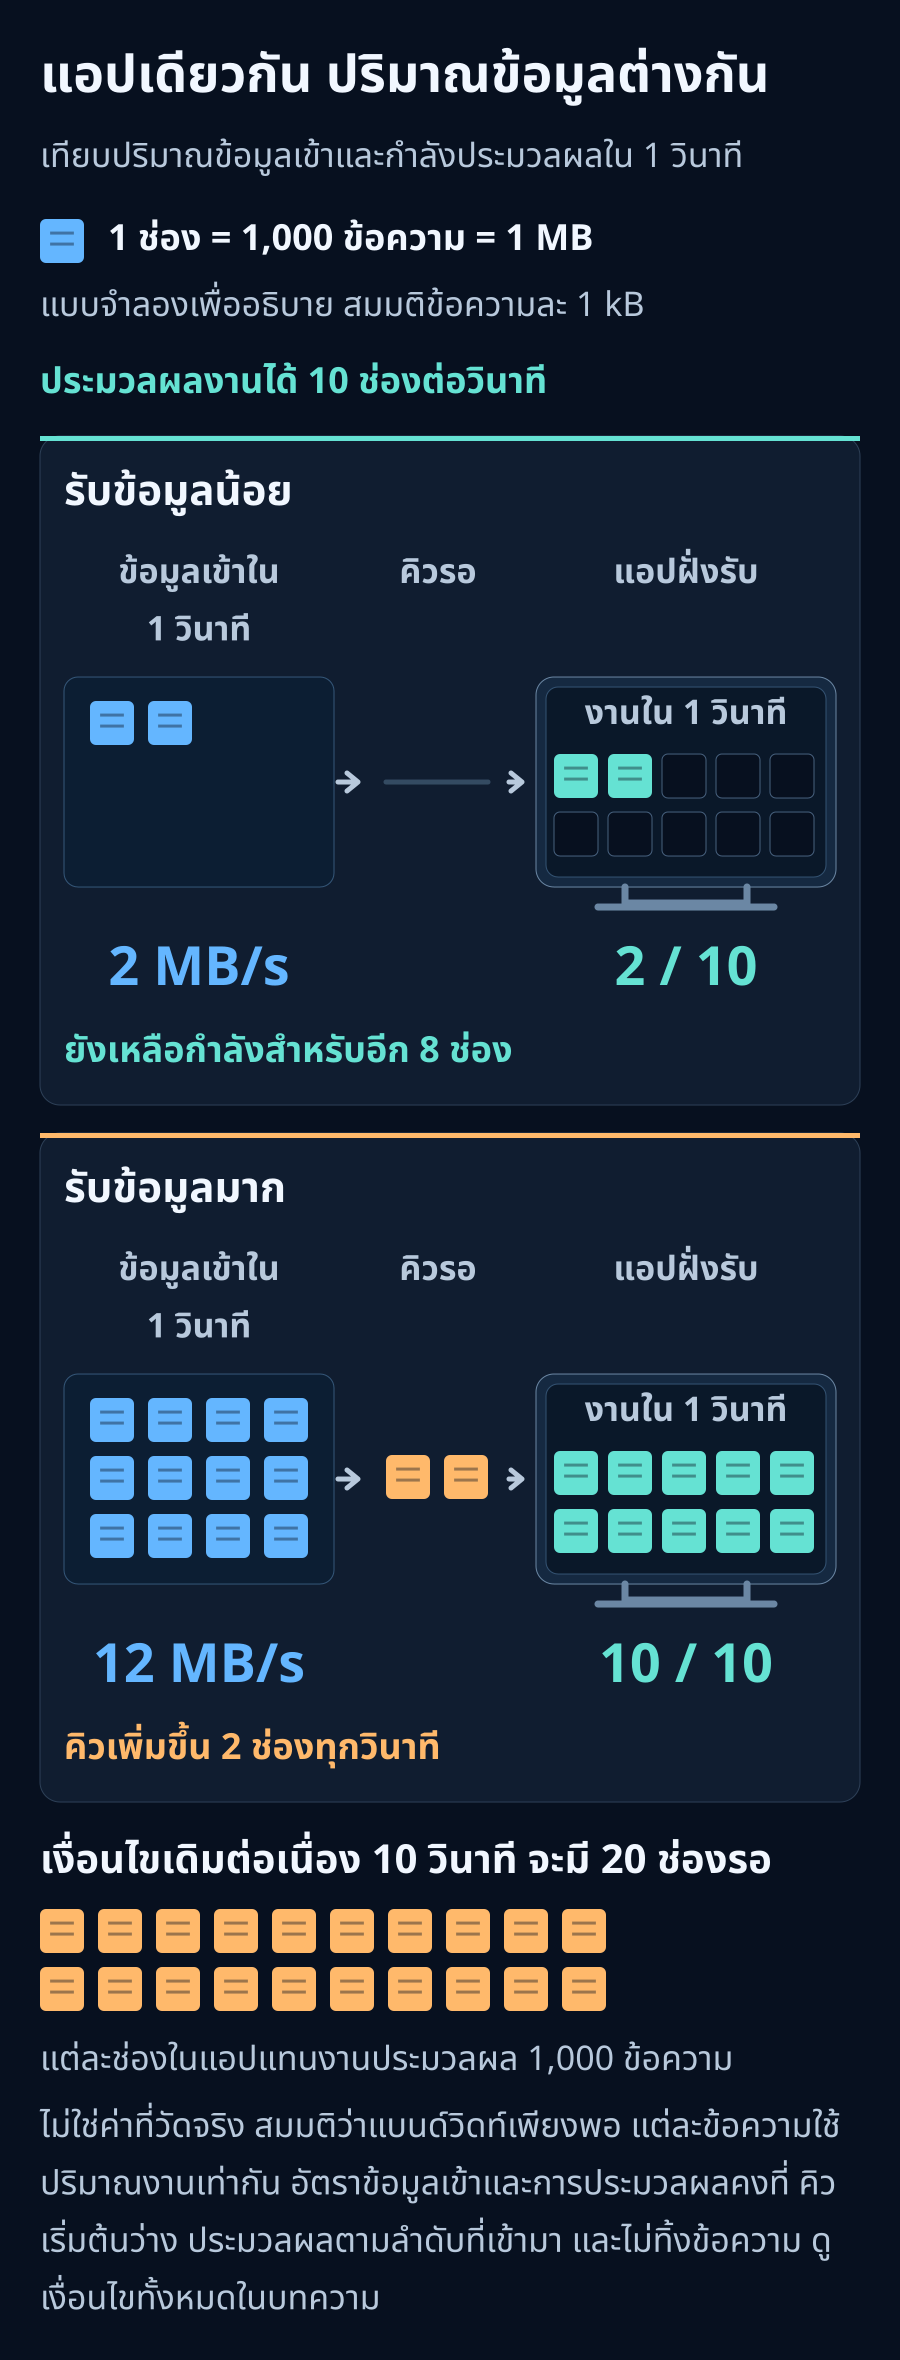
ลองดูแบบจำลองเพื่ออธิบายหลักการ: มีเหตุการณ์เข้ามา 12,000 รายการต่อวินาที แต่คอมพิวเตอร์ประมวลผลได้ 10,000 รายการต่อวินาที แต่ละเหตุการณ์ใช้ปริมาณงานเท่ากัน คิวเริ่มต้นว่าง ประมวลผลตามลำดับที่เข้ามา และไม่มีการทิ้งเหตุการณ์ใด
ทุกวินาทีจะมีเหตุการณ์ค้างเพิ่มอีก 2,000 รายการ หลังผ่านไปสิบวินาที จะมี 20,000 รายการรออยู่ เหตุการณ์ใหม่ที่เข้าคิวในขณะนั้นต้องรอประมาณสองวินาทีก่อนเริ่มประมวลผล ล็อกยังคงวิ่งต่อไปในขณะที่คิวก็ยาวขึ้นเรื่อย ๆ
ตัวเลขนี้เป็นสมมติฐานเพื่ออธิบาย ไม่ใช่ค่าที่วัดจาก Solana หรือ ERPC แบบจำลองกำหนดให้อัตราข้อมูลเข้าและกำลังประมวลผลคงที่ ในการใช้งานจริง ข้อมูลอาจเข้ามาเป็นช่วงที่หนาแน่น และแต่ละเหตุการณ์อาจใช้เวลาประมวลผลไม่เท่ากัน จึงอาจเกิดเวลารอได้แม้กำลังประมวลผลโดยเฉลี่ยจะเพียงพอ
การควบคุมการไหลของ gRPC หรือ flow control จะปรับการส่งให้สอดคล้องกับปริมาณที่ฝั่งรับยอมรับได้ เมื่อประมวลผลไม่ทัน การรออาจไม่ได้อยู่แค่ในคิวของแอปพลิเคชัน แต่ขยายไปถึงไลบรารีสื่อสารหรือฝั่งส่ง การเชื่อมต่อที่ยังทำงานอยู่ หรือการเขียนข้อมูลไปยัง API สำหรับส่งสำเร็จ ไม่ได้ยืนยันว่าข้อมูลยังใหม่เพียงใดเมื่อมาถึง[1]
เลือกข้อมูลที่จำเป็นก่อนส่งผ่านเครือข่าย
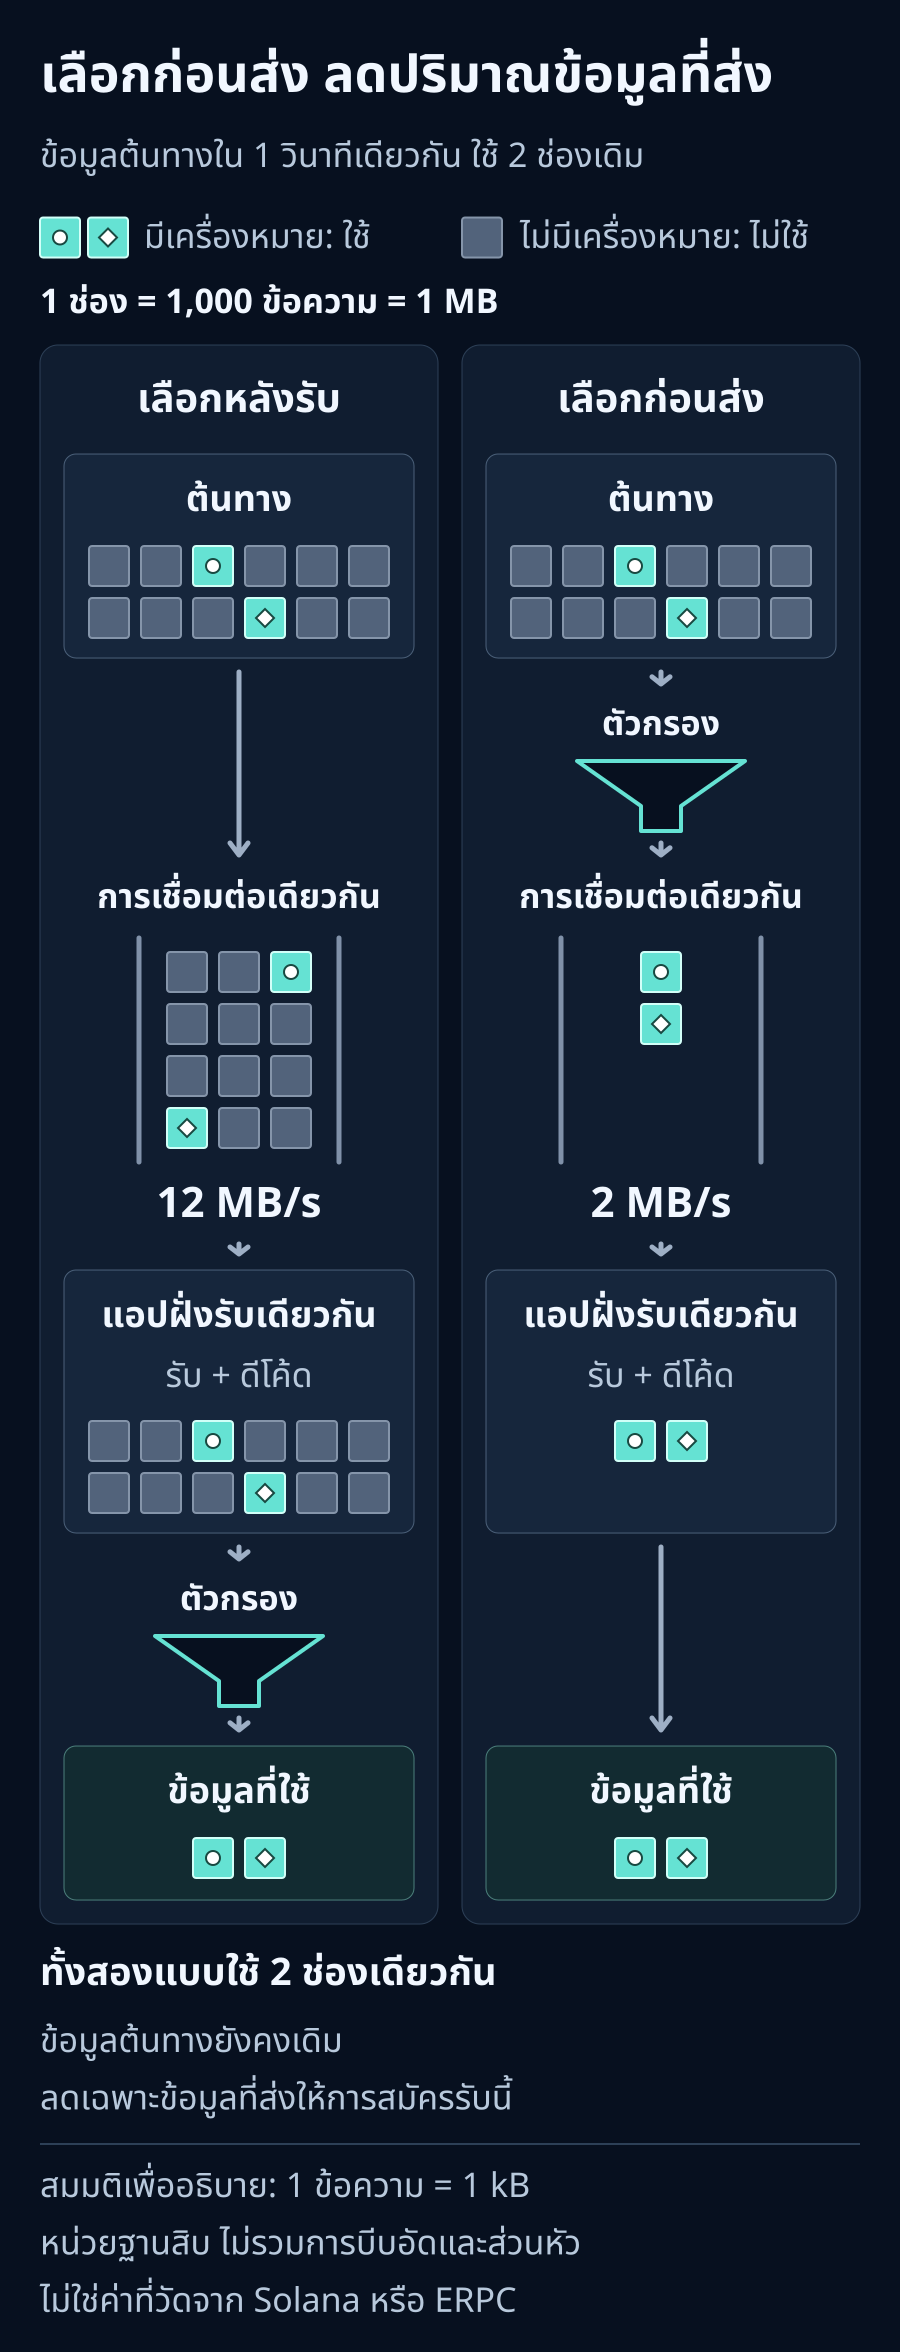
หากการตัดสินใจของคุณใช้ข้อมูลเฉพาะบางโปรแกรมหรือบางบัญชี ให้ระบุข้อมูลที่จำเป็นก่อน แล้วใช้ตัวกรองการสมัครรับที่ทำงานฝั่งเซิร์ฟเวอร์ Yellowstone gRPC รองรับตัวกรองสำหรับธุรกรรมและบัญชี ตรวจสอบวิธีรวมเงื่อนไขและขอบเขตที่ใช้ได้จากข้อกำหนดของ API, SDK และบริการที่ใช้งาน[2]
หากยังไม่รู้ว่าควรกรองอะไร ให้ตรวจสอบโค้ดเพื่อหาว่าแอปใช้ค่าใดในการตัดสินใจ และค่าเหล่านั้นมาจากฟิลด์ใดของการแจ้งเตือน สร้างเงื่อนไขการสมัครรับที่เป็นตัวเลือกจากความสัมพันธ์นี้ แล้วตรวจสอบว่ายังครอบคลุมเหตุการณ์ที่ทราบว่าจำเป็นหรือไม่ การยืนยันทั้งจำนวนเหตุการณ์ที่ลดลงและการคงอยู่ของข้อมูลที่จำเป็นจะเป็นพื้นฐานสำหรับการเปรียบเทียบครั้งถัดไป
การรับข้อมูลทั้งหมดแล้วทิ้งส่วนที่ไม่ต้องการในไคลเอนต์ยังคงมีงานถ่ายโอน การถอดรหัสลับ (decryption) และการถอดรหัสรูปแบบข้อมูล (decoding) ที่เกิดขึ้นไปแล้วจนถึงจุดนั้น การกรองที่ฝั่งส่งช่วยลดงานส่วนนี้ได้ ในตัวอย่างข้างต้น หากลดข้อมูลเข้าเหลือ 2,000 เหตุการณ์ต่อวินาทีที่จำเป็น กำลังประมวลผลเดิม 10,000 รายการต่อวินาทีก็จะมีส่วนเผื่อเหลืออยู่
ลองเปรียบกับการจราจร: ความยาวถนนคือระยะทางที่สัญญาณต้องเดินทาง จำนวนเลนคือแบนด์วิดท์ ด่านเก็บค่าผ่านทางคือกำลังประมวลผลของฝั่งรับ และแถวรถคืองานที่รออยู่ การส่งเฉพาะรถที่จำเป็นผ่านด่านเดียวกันย่อมสร้างคิวต่างจากการพารถทุกคันในบริเวณนั้นมาที่ด่าน การทำให้ถนนสั้นลงกับการลดจำนวนรถเป็นการปรับปรุงคนละด้าน
การสื่อสารมีข้อจำกัดทางกายภาพด้วย การถ่ายโอน 100 MB ที่ 1 Gbps ใช้เวลาอย่างน้อย 0.8 วินาทีในทางทฤษฎี ส่วนที่ 10 Gbps ใช้ 0.08 วินาที ตัวเลขนี้เป็นค่าต่ำสุดที่คำนวณด้วยหน่วยฐานสิบ โดยยังไม่รวมระยะทาง โอเวอร์เฮดของโปรโตคอล การส่งซ้ำ และเวลารอในคิว ไม่ได้หมายความว่าแต่ละเหตุการณ์ในสตรีมจะล่าช้า 0.8 วินาทีเท่ากันทั้งหมด
แม้การคำนวณหนึ่งครั้งจะเร็วกว่าการสื่อสารผ่านเครือข่าย การส่งข้อมูลที่ไม่จำเป็นก็ยังมีต้นทุน ต้องพิจารณาเวลาเดินทางของสัญญาณ ปริมาณที่ผ่านลิงก์ได้ต่อหน่วยเวลา และปริมาณงานที่ทำเสร็จได้หลังข้อมูลมาถึงแยกกัน
บางแอปพลิเคชันต้องใช้ข้อมูลทั้งหมด เช่น การสร้างดัชนีครบชุด การตรวจสอบ และการวิจัย กรณีเหล่านี้ต้องมีกำลังรับข้อมูล ประมวลผล และจัดเก็บที่รองรับภาระงานนั้น การรับการแจ้งเตือนแต่ละรายการทั้งหมดก็ยังต่างจากการรอบล็อกเต็ม ซึ่งเป็นข้อมูลที่รวบรวมและประกอบขึ้นใหม่ในรูปของบล็อก ตรวจสอบว่าการตัดสินใจของคุณต้องรอข้อมูลที่ไม่เกี่ยวข้องหรือรอการรวบรวมเสร็จโดยไม่จำเป็นหรือไม่[2]
ทบทวนการประมวลผลขณะรับข้อมูลและทรัพยากรขณะทำงาน
Rust ช่วยลดต้นทุนการประมวลผลได้ เพื่อใช้ประโยชน์จากความเร็วนั้น ควรดูปริมาณข้อมูลเข้า แบนด์วิดท์ที่ใช้งานได้จริง เวลารอการเขียนฐานข้อมูล ล็อก และส่วนที่ประมวลผลตามลำดับด้วย ในรันไทม์แบบอะซิงโครนัส การจัดงานที่ใช้ CPU มากและงานที่บล็อกเธรดให้อยู่ในส่วนที่เหมาะสมของระบบก็อาจช่วยปรับปรุงแอปได้เช่นกัน[3]
รักษาลูปรับข้อมูลให้สั้นและแยกงานหนักออกไป กำหนดขนาดสูงสุดของคิวและพฤติกรรมเมื่อคิวเต็ม คิวที่ไม่จำกัดขนาดอาจซ่อนความล่าช้าที่เพิ่มขึ้นไว้ในรูปของการใช้หน่วยความจำที่สูงขึ้น คิวที่จำกัดขนาดก็ไม่ได้แก้ปัญหากำลังประมวลผลไม่เพียงพออย่างต่อเนื่องเช่นกัน รักษาลำดับและความครบถ้วนที่จำเป็นไว้ ขณะเลือกระหว่างลดขอบเขตการสมัครรับ ปรับการประมวลผลให้มีประสิทธิภาพ แบ่งงาน ทำงานขนาน หรือเพิ่มทรัพยากร
เริ่มจากวัดตั้งแต่รับข้อมูลจนการตัดสินใจเสร็จ แล้วค่อยตรวจสอบจุดที่มีเวลารออย่างละเอียด ตารางต่อไปนี้เป็นวิธีเริ่มมองแต่ละส่วน ชื่อเมตริกและคำสั่งแบบละเอียดอยู่ในพรอมป์ต์วินิจฉัยด้านล่างด้วย จึงเลือกใช้รายการที่เกี่ยวข้องเมื่อจำเป็นได้
| ทรัพยากร | สิ่งที่ควรตรวจสอบก่อน |
|---|---|
| CPU | งานกระจุกอยู่ที่คอร์เดียวหรือไม่ ตรวจสอบการใช้งานรวมและรายคอร์ รวมถึงข้อจำกัด CPU ของสภาพแวดล้อมที่รัน |
| หน่วยความจำ | เหตุการณ์ที่รอประมวลผลหรือการใช้หน่วยความจำเพิ่มขึ้นต่อเนื่องหรือไม่ ดูปริมาณข้อมูลในคิวควบคู่กับเวลารอของเหตุการณ์ที่เก่าที่สุด |
| ดิสก์และฐานข้อมูล | การรับข้อมูลกำลังรอให้บันทึกเสร็จหรือไม่ ตรวจสอบการเขียนฐานข้อมูลและเวลารอจัดเก็บ หากแอปไม่บันทึกข้อมูล สามารถเริ่มตรวจสอบส่วนอื่นได้ |
| เครือข่าย | ลิงก์และการตั้งค่าเหมาะกับปริมาณข้อมูลเข้าหรือไม่ ตรวจสอบอัตราการส่งจริง เวลาไปกลับ และการส่งซ้ำ |
เมื่อตรวจสอบการสื่อสารให้ละเอียดขึ้น การตั้งค่าไลบรารีก็อาจให้เบาะแสเพิ่มเติมได้ HTTP/2 มี flow-control window ทั้งระดับสตรีมและการเชื่อมต่อ เพื่อกำหนดว่าอีกฝ่ายส่งข้อมูลเพิ่มได้เท่าไร หากปริมาณที่อนุญาตนี้เล็กเมื่อเทียบกับ bandwidth-delay product ซึ่งคือแบนด์วิดท์คูณด้วยเวลาไปกลับ ปริมาณการส่งอาจชนเพดานแม้ลิงก์ยังมีความจุเหลือ ในกรณีที่เข้าข่าย ให้ตรวจสอบไลบรารีและอุปกรณ์ตัวกลาง พร้อมยืนยันขอบเขตของการตั้งค่าและการใช้หน่วยความจำขณะปรับค่า[4]
วัดความใหม่และเวลารอควบคู่กับการรับข้อมูล
หากต้องการเริ่มตรวจสอบงานค้างภายในแอปพลิเคชัน ให้คงการสมัครรับปัจจุบันไว้ แล้วบันทึกจำนวนเหตุการณ์ที่รับมา จำนวนเหตุการณ์ที่ประมวลผลเสร็จ จำนวนรายการในคิว และเวลารอของเหตุการณ์เก่าที่สุดในช่วงสังเกตเดียวกัน หากไม่รู้ว่าควรวัดตรงไหน ให้ใช้พรอมป์ต์ด้านล่างขอให้เอเจนต์ตรวจสอบโค้ด หากไม่มีคิวที่ระบุไว้ชัดเจน ให้เริ่มจากเวลาตั้งแต่รับข้อมูลจนตัดสินใจเสร็จ แล้วเปรียบเทียบกับรุ่นสำหรับวินิจฉัยที่ตัดการประมวลผลหนักออก
รหัสเทียมต่อไปนี้ไม่ผูกกับภาษาหรือ SDK ใด และแสดงว่าควรวางการวัดไว้ตรงไหน ขณะเพิ่มการวัดลงในโค้ดจริง ให้คงลำดับการประมวลผลและรูปแบบการทำงานพร้อมกันเดิมไว้
text
เมื่อรับข้อมูล:
  เพิ่มจำนวนเหตุการณ์ที่รับแล้วอีก 1
  บันทึกเวลารับด้วยนาฬิกา monotonic โดยผูกไว้กับเหตุการณ์นั้น
  ส่งต่อเข้าสู่การประมวลผลเดิม

เมื่อการตัดสินใจที่ใช้เหตุการณ์เดียวกันเสร็จสมบูรณ์:
  เพิ่มจำนวนเหตุการณ์ที่เสร็จแล้วอีก 1
  คำนวณและรวบรวมเวลาที่ผ่านไปนับจากการรับ
เมื่อรับข้อมูล:
เพิ่มจำนวนเหตุการณ์ที่รับแล้วอีก 1
บันทึกเวลารับด้วยนาฬิกา monotonic โดยผูกไว้กับเหตุการณ์นั้น
ส่งต่อเข้าสู่การประมวลผลเดิม
เมื่อการตัดสินใจที่ใช้เหตุการณ์เดียวกันเสร็จสมบูรณ์:
เพิ่มจำนวนเหตุการณ์ที่เสร็จแล้วอีก 1
คำนวณและรวบรวมเวลาที่ผ่านไปนับจากการรับหากการรับข้อมูลกับการตัดสินใจไม่ได้สัมพันธ์กันแบบหนึ่งต่อหนึ่ง ให้กำหนดความสัมพันธ์และหน่วยที่จะนับก่อน การสรุปผลสังเกตตามช่วงเวลาคงที่ช่วยให้เปรียบเทียบผลได้โดยไม่เพิ่มข้อความล็อกทุกเหตุการณ์
เมื่อตรวจสอบเพิ่มเติม ให้บันทึกจำนวนไบต์ที่รับมา จำนวนไบต์ในคิว ค่า p50/p95/p99 ของเวลาประมวลผล ข้อผิดพลาด และการเชื่อมต่อใหม่ด้วย ค่า p99 คือเกณฑ์ที่เวลาประมวลผลที่วัดได้ 99% มีค่าไม่เกินเกณฑ์นั้น ระบุด้วยว่าแต่ละค่าวัดที่จุดใด ทราฟฟิกที่ NIC ขนาด Protobuf และขนาดออบเจ็กต์หลังถอดรหัสเป็นคนละปริมาณกัน
ใช้ monotonic clock เพื่อวัดเวลาที่ผ่านไปภายในโฮสต์เดียว โดยแยกจุดรับข้อมูล เข้าคิว ออกจากคิว และทำงานเสร็จ หากข้อมูลถูกถอดรหัสเสร็จก่อน callback ของ SDK ทำงาน ช่วงก่อน callback นั้นถือว่ายังไม่ได้วัด หากเปรียบเทียบกับ timestamp ของฝั่งส่ง ให้ตรวจสอบการซิงโครไนซ์นาฬิกาและจุดที่สร้าง timestamp อย่าเรียกผลต่างนั้นว่าความหน่วงเครือข่ายล้วน ๆ โดยอัตโนมัติ
หากเวลารอลดลงเมื่อนำการประมวลผลตามตรรกะงานของแอปพลิเคชันออกโดยไม่เปลี่ยนการสมัครรับ นั่นเป็นเบาะแสให้ตรวจสอบผลกระทบจากการเพิ่มการประมวลผลส่วนนั้น อย่างไรก็ตาม การทำงานหลัง callback ที่รวดเร็วเพียงอย่างเดียวไม่ได้พิสูจน์ว่าข้อมูลที่มาถึงเป็นข้อมูลล่าสุด
คุณยังสามารถเทียบตัวระบุเหตุการณ์กับสตรีมอ้างอิงที่ใช้เงื่อนไขการสมัครรับและ commitment (ขั้นการยืนยันของข้อมูลที่ใช้งาน) เดียวกันได้ ตรวจสอบด้วยว่าสตรีมอ้างอิงเองไม่ได้สะสมข้อมูลค้างอยู่ ช่องว่างระหว่างหมายเลข slot เพียงอย่างเดียวไม่ใช่หลักฐานว่าข้อมูลหาย และไม่สามารถแปลงเป็นจำนวนวินาทีคงที่ได้ เพราะบาง slot ไม่มีเหตุการณ์ที่ตรงกับตัวกรอง และ slot อาจถูกข้ามได้[5]
mtr ช่วยตรวจสอบความหน่วงและรูปแบบการตอบกลับตามเส้นทาง การสูญเสียที่พบเฉพาะ hop ระหว่างทางอาจเกิดจากเราเตอร์จำกัดการตอบกลับของตัวเอง ให้เทียบพฤติกรรมตลอดทางจนถึงปลายทางกับการส่ง TCP ซ้ำ อัตราถ่ายโอนจริง และเส้นทางอื่น mtr เพียงอย่างเดียวไม่สามารถยืนยันว่าแบนด์วิดท์เต็มหรือศูนย์ข้อมูลมีปัญหาได้[6]
พรอมป์ต์วิเคราะห์ปัญหาสำหรับเอเจนต์ AI
ส่งข้อความต่อไปนี้ให้เอเจนต์ที่อ่านโค้ดของโปรเจกต์ได้ เริ่มจากบอกว่าโค้ดรันอยู่ที่ไหน และในสถานการณ์ใดมีส่วนไหนที่รู้สึกว่าช้า เอเจนต์สามารถเริ่มตรวจสอบการเชื่อมต่อ การสมัครรับ และการประมวลผลหลังรับข้อมูลจากโค้ดได้ ไม่จำเป็นต้องวาง API key หรือข้อมูลรับรองในบทสนทนา
หากยังไม่ได้กำหนดเหตุการณ์ที่ต้องใช้หรือความล่าช้าที่ยอมรับได้ ให้บอกว่ายังไม่กำหนด อธิบายด้วยคำพูดของคุณเองว่าต้องการดูข้อมูลอะไรและตัดสินใจเรื่องใด ค่าที่เก็บไม่ได้ให้ระบุว่ายังไม่ได้วัด แล้วเริ่มจากส่วนที่ตรวจสอบได้ในตอนนี้
text
ตรวจสอบว่าไคลเอนต์ Solana Geyser gRPC ของฉันยังมีโอกาสตอบสนองได้เร็วขึ้นหรือไม่ หากมีความล่าช้า งานค้าง หรือการตัดการเชื่อมต่อ ให้แยกสาเหตุและช่วยปรับปรุง อย่าสรุปว่ากำลังประมวลผลข้อมูลล่าสุดเพียงเพราะเชื่อมต่อสำเร็จหรือเห็นเหตุการณ์ในล็อก และอย่าตัดสินล่วงหน้าว่าสาเหตุอยู่ที่ไคลเอนต์หรือผู้ให้บริการ

1. ระบุเป้าหมาย: เหตุการณ์ที่ต้องใช้ ความใหม่ของข้อมูลที่ยอมรับได้ ข้อกำหนดด้านลำดับและข้อมูลสูญหาย ตัวกรองการสมัครรับ commitment ภูมิภาคของ endpoint เวอร์ชันจริงของภาษา/SDK/ไลบรารี gRPC และสภาพแวดล้อมที่รัน ตรวจสอบโค้ด การตั้งค่า และ lockfile ที่อ่านได้ก่อน ถามเฉพาะข้อมูลที่ยังขาด คงข้อกำหนดที่ยังไม่ตัดสินใจไว้ในสถานะยังไม่กำหนดอย่างชัดเจน และตรวจสอบสภาพปัจจุบันก่อน ห้ามแสดงข้อมูลลับ และปกปิดข้อมูลอ่อนไหวในล็อกที่นำมาแชร์

2. วัดตั้งแต่รับข้อมูลจนทำงานเสร็จ ให้ความสำคัญกับการรับข้อมูล การประมวลผลเสร็จ และเวลารอก่อน โดยเริ่มจากสิ่งที่วัดได้ บันทึกเหตุการณ์ต่อวินาที ไบต์ต่อวินาที เหตุการณ์ที่ทำเสร็จต่อวินาที จำนวนรายการ/ไบต์/เวลารอของเหตุการณ์เก่าที่สุดในคิว p50/p95/p99 ข้อผิดพลาด การตัดการเชื่อมต่อ การเชื่อมต่อใหม่ และการทิ้งข้อมูล หากไม่มีคิวที่ระบุไว้ชัดเจน ให้แจ้งข้อเท็จจริงนั้นและระบุช่วงการประมวลผลที่สังเกตได้ ระบุจุดสังเกตและช่วงที่ยังไม่ได้วัด แยกทราฟฟิกที่ NIC ไบต์ที่ส่งผ่านเครือข่าย ขนาด Protobuf และออบเจ็กต์หลังถอดรหัส ใช้ monotonic clock สำหรับเวลาที่ผ่านไปในเครื่องเดียว ส่วนเวลาจากภายนอกต้องตรวจสอบการซิงโครไนซ์และต้นทางของ timestamp อย่าแปลงช่องว่างระหว่าง slot เป็นข้อมูลสูญหายหรือระยะเวลาคงที่โดยตรง

3. แยกข้อจำกัดของ CPU หน่วยความจำ ดิสก์ และเครือข่าย ตรวจสอบ CPU รายคอร์หรือเธรด เวลา steal และขีดจำกัด CPU, RSS/GC/swap/PSI, เวลารอ I/O, ไบต์/แพ็กเก็ตที่ถูกทิ้ง/ข้อผิดพลาดของ NIC, การส่ง TCP ซ้ำ และ RTT เครื่องมือ Linux ที่อาจใช้ได้ เช่น mpstat, pidstat, vmstat, iostat, sar, ss -ti และ /proc/pressure/ หากไม่มีเครื่องมือหรือสิทธิ์ ให้ระบุข้อจำกัดนั้นและแจ้งคำสั่งขั้นต่ำที่ต้องใช้ หากเข้าถึงโฮสต์ไม่ได้ ให้หาข้อมูลจากหน้าจัดการหรือเครื่องมือวัดภายในแอปพลิเคชัน และระบุค่าที่เก็บไม่ได้ว่ายังไม่ได้วัด ห้ามแต่งผลลัพธ์ขึ้นเอง

4. ตรวจสอบหน้าต่าง HTTP/2 ทั้งระดับสตรีมและการเชื่อมต่อ บัฟเฟอร์รับ TCP พร็อกซี VPN และ sidecar อ่านเอกสารทางการของ SDK เวอร์ชันที่ติดตั้ง และพิจารณา bandwidth-delay product ตรวจสอบการแปลง JSON การเขียนล็อกทุกเหตุการณ์ การเรียกฐานข้อมูลหรือ API ภายนอกแบบซิงโครนัส งานที่บล็อก ล็อก การสร้าง task แบบไม่จำกัด และคิวที่ไม่จำกัดขนาดภายในหรือรอบลูปรับข้อมูล อย่าถือว่าการใช้ Rust หรือโค้ด async เพียงอย่างเดียวเป็นคำตอบ

5. หากมี mtr หรือเครื่องมือเทียบเท่า ให้ตรวจวัดแบบจำกัดจำนวนครั้งไปยังโฮสต์ endpoint ที่ใช้งานจริง บนระบบที่รองรับ อาจใช้: mtr --tcp --port <PORT> --report --report-cycles 30 <HOST> ใช้พอร์ตจริง อย่าเดาว่าเป็นพอร์ต TLS มาตรฐาน อย่าสรุปว่ามีความผิดปกติจาก loss ที่ hop ระหว่างทางเพียงจุดเดียว ให้เทียบพฤติกรรมที่ปลายทาง การส่งซ้ำ และเส้นทางอื่น อย่าใช้ mtr แทนการวัดแบนด์วิดท์

6. บันทึกค่าฐานด้วยการสมัครรับปัจจุบันและเปลี่ยนทีละตัวแปร คงการสมัครรับเดิมเมื่อเปรียบเทียบเส้นทางรับข้อมูลที่ทำงานน้อยที่สุดกับระบบที่มีการประมวลผลตามตรรกะงานของแอปพลิเคชัน ให้แยกการเปลี่ยนตัวกรองเป็นการเปรียบเทียบอีกครั้งหนึ่ง ก่อนลดขอบเขตการสมัครรับ ให้จับคู่ข้อมูลที่ใช้ตัดสินใจกับการแจ้งเตือนที่ให้ข้อมูลนั้น และตรวจสอบว่าตัวกรองที่เสนอครอบคลุมเหตุการณ์ที่ทราบว่าจำเป็น ออกแบบคิวที่จำกัดขนาดและการทำงานขนานให้รักษาลำดับและความครบถ้วนที่ต้องการ พร้อมระบุพฤติกรรมเมื่อคิวเต็ม อย่าทิ้งข้อมูลที่จำเป็นโดยไม่แจ้ง เก็บรายละเอียดข้อผิดพลาดทั้งหมดและเวลาที่กำหนดให้ลองใหม่ ห้ามเชื่อมต่อใหม่ในช่วงที่ถูกกำหนดให้หยุดพัก

7. รายงานข้อเท็จจริงที่สังเกตได้ สาเหตุที่เป็นไปได้ สมมติฐานที่ยังไม่ทดสอบ การเปลี่ยนแปลงที่ตรวจทานได้ และค่าที่วัดก่อนกับหลังแยกกัน ประเมิน CPU, RAM, แบนด์วิดท์ ประสิทธิภาพการจัดเก็บ และตำแหน่งติดตั้งจากขอบเขตการสมัครรับและค่าที่วัด รวมส่วนเผื่อสำหรับช่วงโหลดสูงสุด อย่ากำหนดสเปกฮาร์ดแวร์ Solana แบบตายตัวที่อ้างว่าใช้ได้กับทุกงาน หากจำเป็น ให้เสนอแผนเปรียบเทียบเครื่องหรือศูนย์ข้อมูลโดยใช้การสมัครรับ SDK และ commitment เดียวกัน

หากฉันใช้ ERPC ให้อ่าน gRPC FAQ ฉบับปัจจุบันและทำตามขั้นตอนของรหัสข้อผิดพลาดนั้นโดยตรง:
https://erpc.global/en/faq/grpc/general/
หากเชื่อมต่อ ERPC User MCP หรือ CLI อยู่ ให้ตรวจสอบว่ามีคำสั่งและสิทธิ์ใดใช้งานได้จริง การเข้าถึงบัญชีไม่ได้หมายความว่าจะตรวจสอบภายในโฮสต์ได้ ก่อนสร้าง VPS ที่มีค่าใช้จ่าย เปลี่ยนสัญญา อัปเดตระบบ production หรือรีสตาร์ต ให้แจ้งค่าใช้จ่าย วัตถุประสงค์ และระยะเวลาทดสอบ แล้วขออนุมัติจากฉัน ทำการวิเคราะห์และการปรับปรุงที่ตรวจทานได้ให้เสร็จก่อน
ตรวจสอบว่าไคลเอนต์ Solana Geyser gRPC ของฉันยังมีโอกาสตอบสนองได้เร็วขึ้นหรือไม่ หากมีความล่าช้า งานค้าง หรือการตัดการเชื่อมต่อ ให้แยกสาเหตุและช่วยปรับปรุง อย่าสรุปว่ากำลังประมวลผลข้อมูลล่าสุดเพียงเพราะเชื่อมต่อสำเร็จหรือเห็นเหตุการณ์ในล็อก และอย่าตัดสินล่วงหน้าว่าสาเหตุอยู่ที่ไคลเอนต์หรือผู้ให้บริการ
1. ระบุเป้าหมาย: เหตุการณ์ที่ต้องใช้ ความใหม่ของข้อมูลที่ยอมรับได้ ข้อกำหนดด้านลำดับและข้อมูลสูญหาย ตัวกรองการสมัครรับ commitment ภูมิภาคของ endpoint เวอร์ชันจริงของภาษา/SDK/ไลบรารี gRPC และสภาพแวดล้อมที่รัน ตรวจสอบโค้ด การตั้งค่า และ lockfile ที่อ่านได้ก่อน ถามเฉพาะข้อมูลที่ยังขาด คงข้อกำหนดที่ยังไม่ตัดสินใจไว้ในสถานะยังไม่กำหนดอย่างชัดเจน และตรวจสอบสภาพปัจจุบันก่อน ห้ามแสดงข้อมูลลับ และปกปิดข้อมูลอ่อนไหวในล็อกที่นำมาแชร์
2. วัดตั้งแต่รับข้อมูลจนทำงานเสร็จ ให้ความสำคัญกับการรับข้อมูล การประมวลผลเสร็จ และเวลารอก่อน โดยเริ่มจากสิ่งที่วัดได้ บันทึกเหตุการณ์ต่อวินาที ไบต์ต่อวินาที เหตุการณ์ที่ทำเสร็จต่อวินาที จำนวนรายการ/ไบต์/เวลารอของเหตุการณ์เก่าที่สุดในคิว p50/p95/p99 ข้อผิดพลาด การตัดการเชื่อมต่อ การเชื่อมต่อใหม่ และการทิ้งข้อมูล หากไม่มีคิวที่ระบุไว้ชัดเจน ให้แจ้งข้อเท็จจริงนั้นและระบุช่วงการประมวลผลที่สังเกตได้ ระบุจุดสังเกตและช่วงที่ยังไม่ได้วัด แยกทราฟฟิกที่ NIC ไบต์ที่ส่งผ่านเครือข่าย ขนาด Protobuf และออบเจ็กต์หลังถอดรหัส ใช้ monotonic clock สำหรับเวลาที่ผ่านไปในเครื่องเดียว ส่วนเวลาจากภายนอกต้องตรวจสอบการซิงโครไนซ์และต้นทางของ timestamp อย่าแปลงช่องว่างระหว่าง slot เป็นข้อมูลสูญหายหรือระยะเวลาคงที่โดยตรง
3. แยกข้อจำกัดของ CPU หน่วยความจำ ดิสก์ และเครือข่าย ตรวจสอบ CPU รายคอร์หรือเธรด เวลา steal และขีดจำกัด CPU, RSS/GC/swap/PSI, เวลารอ I/O, ไบต์/แพ็กเก็ตที่ถูกทิ้ง/ข้อผิดพลาดของ NIC, การส่ง TCP ซ้ำ และ RTT เครื่องมือ Linux ที่อาจใช้ได้ เช่น mpstat, pidstat, vmstat, iostat, sar, ss -ti และ /proc/pressure/ หากไม่มีเครื่องมือหรือสิทธิ์ ให้ระบุข้อจำกัดนั้นและแจ้งคำสั่งขั้นต่ำที่ต้องใช้ หากเข้าถึงโฮสต์ไม่ได้ ให้หาข้อมูลจากหน้าจัดการหรือเครื่องมือวัดภายในแอปพลิเคชัน และระบุค่าที่เก็บไม่ได้ว่ายังไม่ได้วัด ห้ามแต่งผลลัพธ์ขึ้นเอง
4. ตรวจสอบหน้าต่าง HTTP/2 ทั้งระดับสตรีมและการเชื่อมต่อ บัฟเฟอร์รับ TCP พร็อกซี VPN และ sidecar อ่านเอกสารทางการของ SDK เวอร์ชันที่ติดตั้ง และพิจารณา bandwidth-delay product ตรวจสอบการแปลง JSON การเขียนล็อกทุกเหตุการณ์ การเรียกฐานข้อมูลหรือ API ภายนอกแบบซิงโครนัส งานที่บล็อก ล็อก การสร้าง task แบบไม่จำกัด และคิวที่ไม่จำกัดขนาดภายในหรือรอบลูปรับข้อมูล อย่าถือว่าการใช้ Rust หรือโค้ด async เพียงอย่างเดียวเป็นคำตอบ
5. หากมี mtr หรือเครื่องมือเทียบเท่า ให้ตรวจวัดแบบจำกัดจำนวนครั้งไปยังโฮสต์ endpoint ที่ใช้งานจริง บนระบบที่รองรับ อาจใช้: mtr --tcp --port <PORT> --report --report-cycles 30 <HOST> ใช้พอร์ตจริง อย่าเดาว่าเป็นพอร์ต TLS มาตรฐาน อย่าสรุปว่ามีความผิดปกติจาก loss ที่ hop ระหว่างทางเพียงจุดเดียว ให้เทียบพฤติกรรมที่ปลายทาง การส่งซ้ำ และเส้นทางอื่น อย่าใช้ mtr แทนการวัดแบนด์วิดท์
6. บันทึกค่าฐานด้วยการสมัครรับปัจจุบันและเปลี่ยนทีละตัวแปร คงการสมัครรับเดิมเมื่อเปรียบเทียบเส้นทางรับข้อมูลที่ทำงานน้อยที่สุดกับระบบที่มีการประมวลผลตามตรรกะงานของแอปพลิเคชัน ให้แยกการเปลี่ยนตัวกรองเป็นการเปรียบเทียบอีกครั้งหนึ่ง ก่อนลดขอบเขตการสมัครรับ ให้จับคู่ข้อมูลที่ใช้ตัดสินใจกับการแจ้งเตือนที่ให้ข้อมูลนั้น และตรวจสอบว่าตัวกรองที่เสนอครอบคลุมเหตุการณ์ที่ทราบว่าจำเป็น ออกแบบคิวที่จำกัดขนาดและการทำงานขนานให้รักษาลำดับและความครบถ้วนที่ต้องการ พร้อมระบุพฤติกรรมเมื่อคิวเต็ม อย่าทิ้งข้อมูลที่จำเป็นโดยไม่แจ้ง เก็บรายละเอียดข้อผิดพลาดทั้งหมดและเวลาที่กำหนดให้ลองใหม่ ห้ามเชื่อมต่อใหม่ในช่วงที่ถูกกำหนดให้หยุดพัก
7. รายงานข้อเท็จจริงที่สังเกตได้ สาเหตุที่เป็นไปได้ สมมติฐานที่ยังไม่ทดสอบ การเปลี่ยนแปลงที่ตรวจทานได้ และค่าที่วัดก่อนกับหลังแยกกัน ประเมิน CPU, RAM, แบนด์วิดท์ ประสิทธิภาพการจัดเก็บ และตำแหน่งติดตั้งจากขอบเขตการสมัครรับและค่าที่วัด รวมส่วนเผื่อสำหรับช่วงโหลดสูงสุด อย่ากำหนดสเปกฮาร์ดแวร์ Solana แบบตายตัวที่อ้างว่าใช้ได้กับทุกงาน หากจำเป็น ให้เสนอแผนเปรียบเทียบเครื่องหรือศูนย์ข้อมูลโดยใช้การสมัครรับ SDK และ commitment เดียวกัน
หากฉันใช้ ERPC ให้อ่าน gRPC FAQ ฉบับปัจจุบันและทำตามขั้นตอนของรหัสข้อผิดพลาดนั้นโดยตรง:
https://erpc.global/en/faq/grpc/general/
หากเชื่อมต่อ ERPC User MCP หรือ CLI อยู่ ให้ตรวจสอบว่ามีคำสั่งและสิทธิ์ใดใช้งานได้จริง การเข้าถึงบัญชีไม่ได้หมายความว่าจะตรวจสอบภายในโฮสต์ได้ ก่อนสร้าง VPS ที่มีค่าใช้จ่าย เปลี่ยนสัญญา อัปเดตระบบ production หรือรีสตาร์ต ให้แจ้งค่าใช้จ่าย วัตถุประสงค์ และระยะเวลาทดสอบ แล้วขออนุมัติจากฉัน ทำการวิเคราะห์และการปรับปรุงที่ตรวจทานได้ให้เสร็จก่อนลองโค้ดเดิมในสภาพแวดล้อมที่เปรียบเทียบกันได้
ผลการวัดอาจแสดงโอกาสปรับปรุงทรัพยากร CPU หน่วยความจำ หรือเส้นทางเครือข่าย CPU ที่แรงขึ้น หน่วยความจำเพิ่ม การแบ่งงาน หรือการย้ายไปใกล้แหล่งข้อมูล ล้วนเป็นตัวเลือกที่พิจารณาได้ การเชื่อมตัวเลือกเหล่านี้เข้ากับปริมาณข้อมูลของแอปและผลสังเกตช่วยให้เหตุผลที่จะลองและผลที่ต้องตรวจสอบชัดเจนขึ้น
ERPC VPS เป็นตัวเลือกหนึ่งสำหรับรันไคลเอนต์สตรีมใกล้โครงสร้างพื้นฐาน Solana การคิดค่าบริการรายชั่วโมงช่วยให้เปรียบเทียบโค้ดและการสมัครรับแบบเดียวกันกับสภาพแวดล้อมปัจจุบันได้ ตรวจสอบราคา ภูมิภาค และความพร้อมใช้งานล่าสุดใน Dashboard แม้ใช้ ERPC ความต้องการทรัพยากรก็ยังขึ้นอยู่กับข้อมูลที่สมัครรับและการประมวลผลของแอปพลิเคชัน[7]
นอกจากอัตรารับข้อมูลแล้ว ให้เปรียบเทียบอัตราการเพิ่มของคิว ความใหม่ของข้อมูลเมื่อประมวลผลเสร็จ p99 และข้อผิดพลาด บันทึกช่วงเวลาที่วัดและโหลดของบล็อกเชนด้วย การเปรียบเทียบพร้อมกันหรือวัดซ้ำช่วยลดโอกาสเข้าใจผิดว่าความเปลี่ยนแปลงของทราฟฟิกตามเวลาเป็นความแตกต่างด้านประสิทธิภาพของสภาพแวดล้อม
เมื่อติดต่อฝ่ายสนับสนุน ให้ส่งการตั้งค่าการสมัครรับที่ปกปิดข้อมูลอ่อนไหวแล้ว เวอร์ชัน SDK ภูมิภาค timestamp ข้อความผิดพลาดฉบับเต็ม และค่าที่วัดได้แล้ว ค่าที่ยังเก็บไม่ได้สามารถระบุว่ายังไม่ได้วัดได้ตามตรง
ทุกครั้งที่มีข้อมูลจากการสังเกตเพิ่มขึ้น การเลือกสิ่งที่จะลองปรับต่อไปก็ง่ายขึ้น คงข้อมูลที่จำเป็นไว้แล้วตรวจสอบผลการปรับปรุงทีละขั้น เราจะพัฒนาข้อมูลและโครงสร้างพื้นฐานที่สนับสนุนการพัฒนาของคุณต่อไปเช่นกัน
เอกสารอ้างอิงและลิงก์ที่เกี่ยวข้อง
- [1] gRPC Flow Control: https://grpc.io/docs/guides/flow-control/
- [2] ข้อกำหนดการสมัครรับข้อมูล Yellowstone gRPC: https://github.com/rpcpool/yellowstone-grpc/blob/master/README.md
- [3] Tokio: CPU-bound tasks and blocking code: https://docs.rs/tokio/latest/tokio/index.html#cpu-bound-tasks-and-blocking-code
- [4] การควบคุมการไหลของ HTTP/2: https://www.rfc-editor.org/rfc/rfc9113.html#section-5.2
- [5] คำศัพท์ Solana: https://solana.com/docs/references/terminology
- [6] เอกสารทางการของ mtr: https://github.com/traviscross/mtr
- [7] ERPC VPS: https://erpc.global/th/vps/
- Linux PSI: https://docs.kernel.org/accounting/psi.html
- API สำหรับวัดประสิทธิภาพของ Node.js: https://nodejs.org/api/perf_hooks.html
- ERPC gRPC FAQ: https://erpc.global/th/faq/grpc/general/
- ERPC Web Dashboard: https://dashboard.erpc.global/th/
- Discord ทางการของ Validators DAO: https://discord.gg/C7ZQSrCkYR


