“Solana 数据延迟或不完整?”检查接收端基础设施的哪些环节
订阅了高速 Solana Shreds 数据流,却只收到零星的数据包。收到的 Shreds 可以正常解析,但缺少必要的片段,无法提取交易。同一台服务器上的 gRPC 又运行正常,让人不知道该从哪里查起。
遇到这种情况,除了检查发送端,也需要检查应用服务器及其所在的数据中心。即使 ERPC 很快就转发了 Shreds,路径中的 UDP 限制或接收服务器上的处理瓶颈,也可能让应用无法利用这一速度优势。
选择 Shreds 数据流时,需要把数据包到达的路径,以及到达后转化为可用数据的过程连起来考虑。网络质量、距离和数据中心的运营策略,也是 Geyser Yellowstone gRPC、常规 RPC 与 API 通信,以及交易提交共同依赖的性能条件。
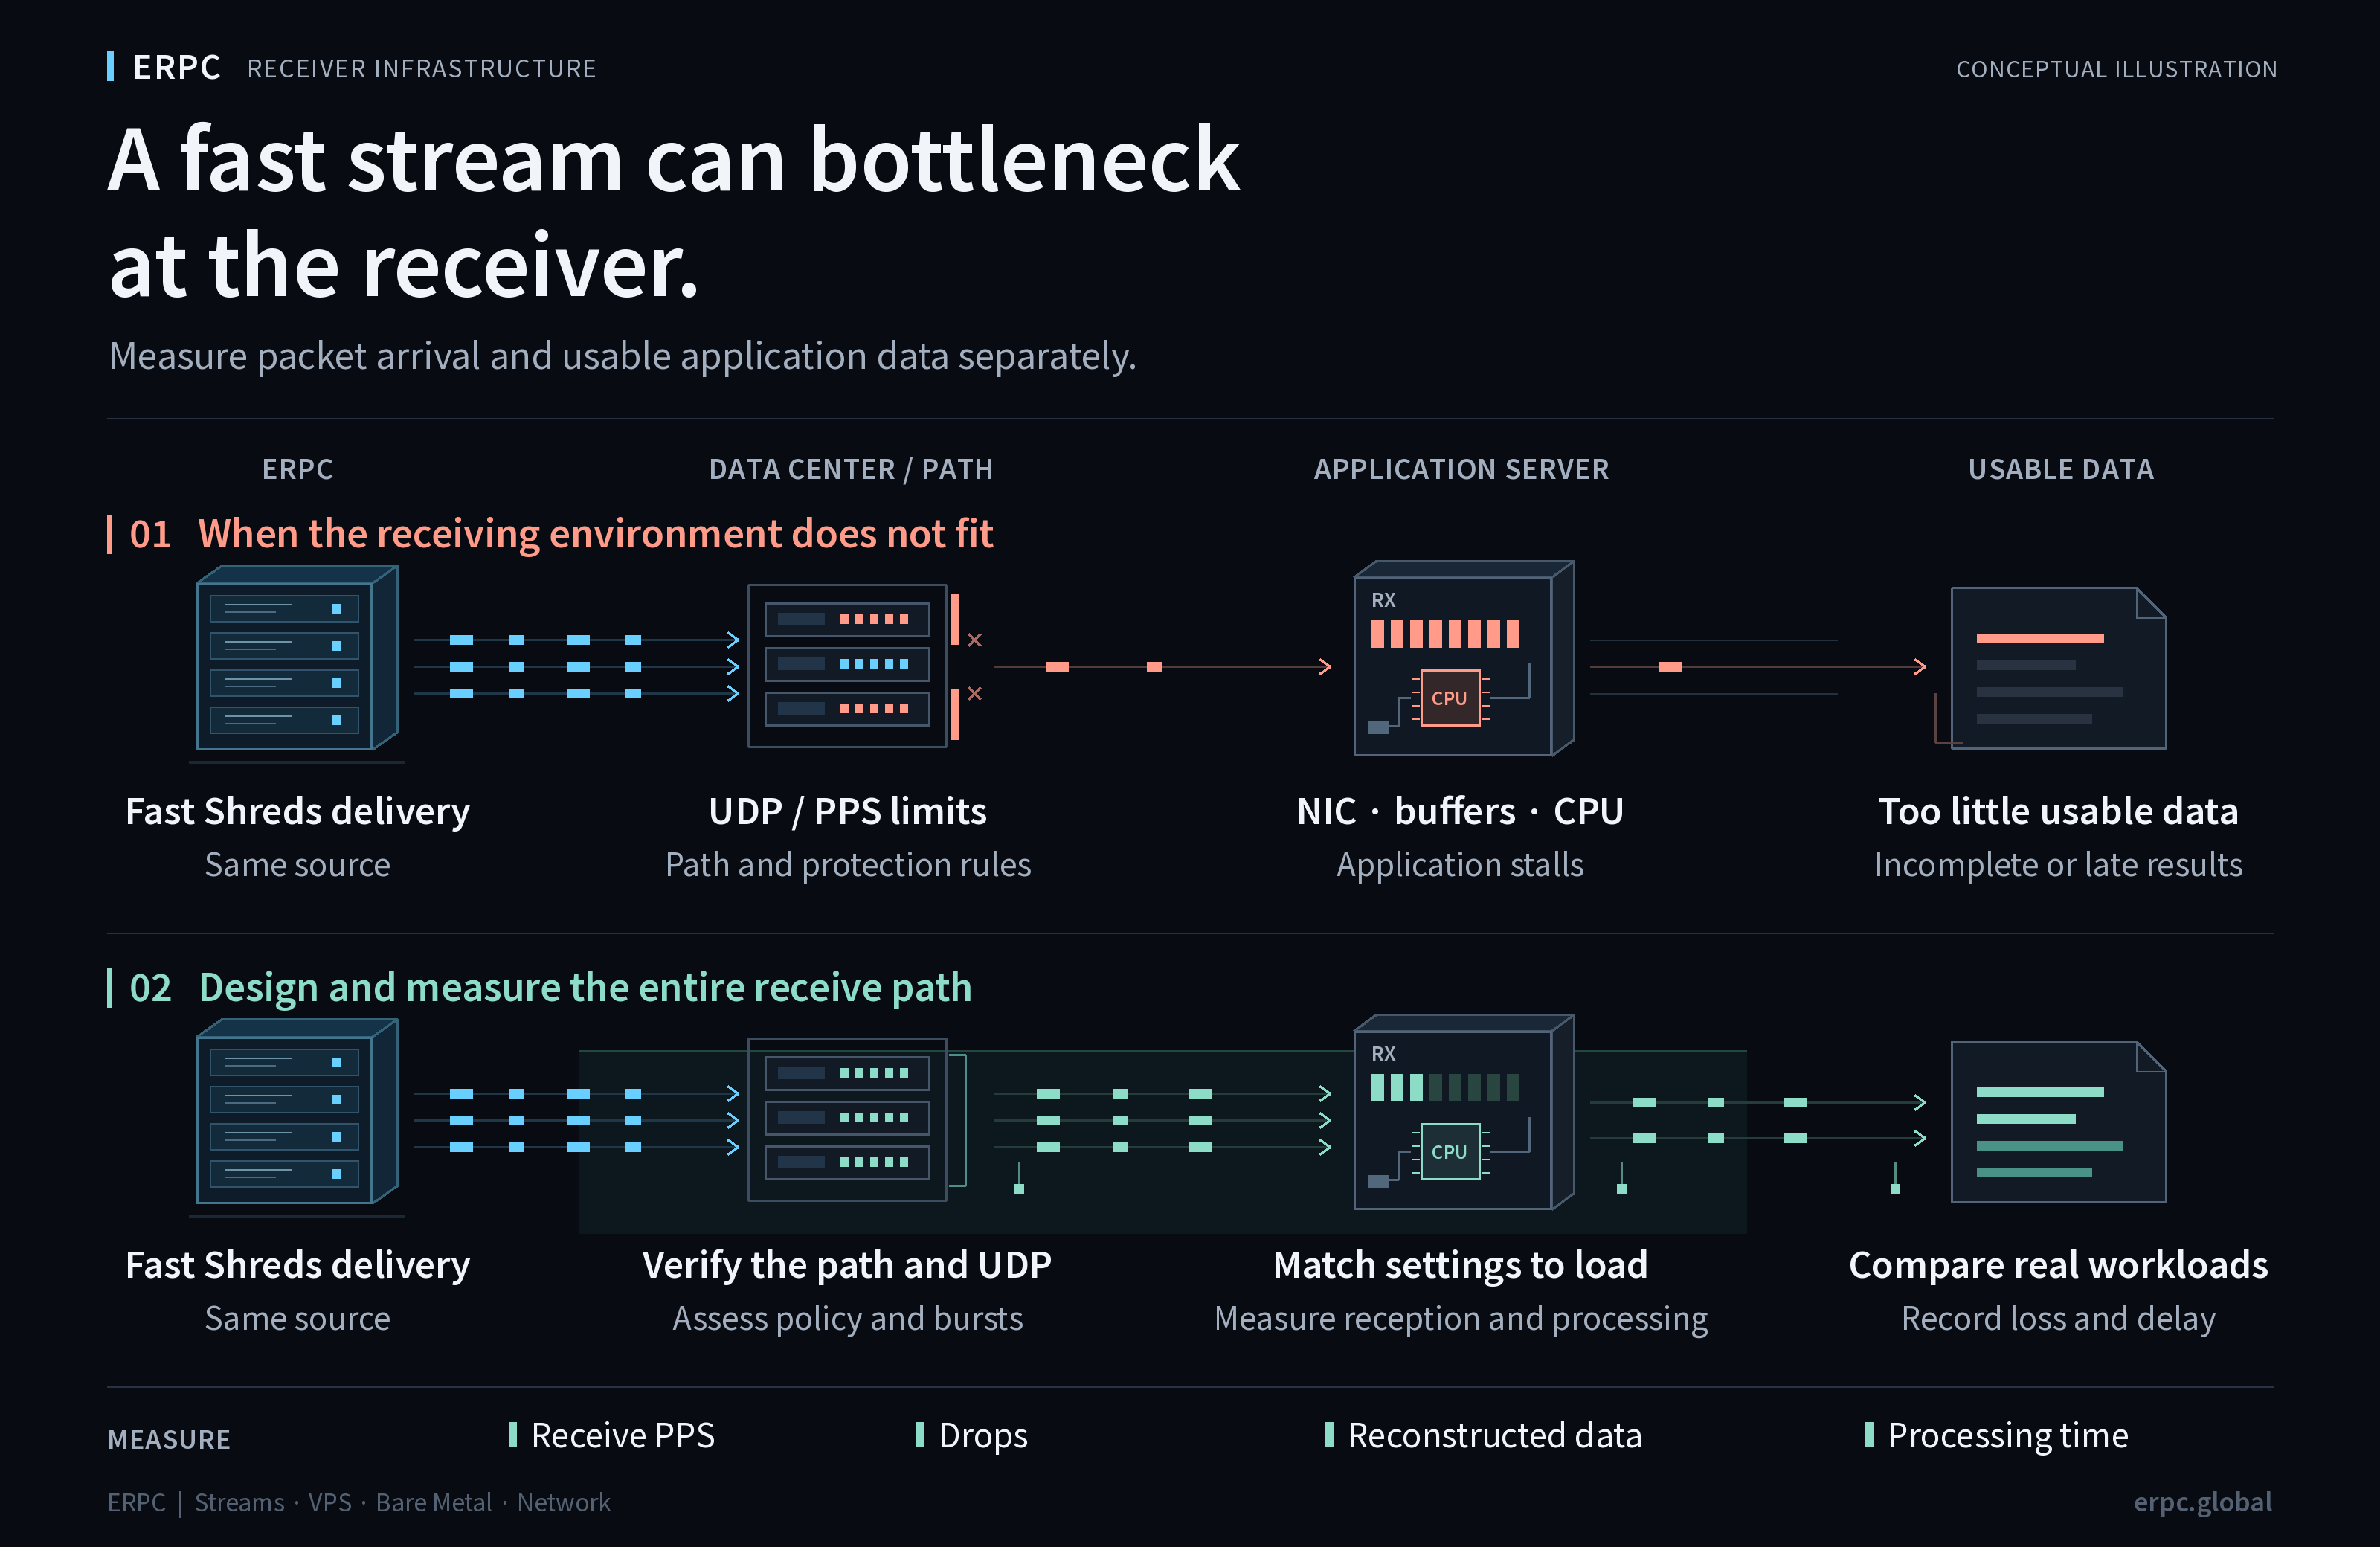
发送端记录与实际收到的可用数据,是不同的事实
在 ERPC 最近收到的一次支持咨询中,发送端的短时测量记录了约 3,400–3,900 packets/sec,而接收端报告只有约 13 packets/sec,并且无法完成 slot 重建。
这些数值的测量时段和统计区间不同,测量方法是否具有可比性也尚未确认。因此,它们不能用于确定送达成功率或丢包率。仅凭发送端记录无法证明数据已经到达对端,截至本文撰写时,最终原因仍未查明。
同样,不能仅凭每秒几千个数据包,就判断负载已经高到普通服务器无法处理。需要确认的是实际路径、适用的限制、短时间内的流量集中情况、接收处理方式,以及每个计数器究竟统计了什么。
同在法兰克福,网络路径也可能不同
数据流发送端和应用服务器都位于法兰克福,却可能分别部署在不同的数据中心。在这种配置下,流量可能先离开一处设施,经过外部网络,再进入另一处设施。区域名称相同,并不意味着设施、网络运营商或中间设备相同。
对于部署在同一站点的 ERPC 数据流或 RPC 服务与 ERPC VPS 或 Bare Metal 主机,服务端和应用服务器位于邻近的机架中,两者之间的通信通过内部网络完成。这就是 ERPC“零距离通信”的思路:除了选择同一个城市,还要一起设计物理部署位置和通往接收应用的通信路径。
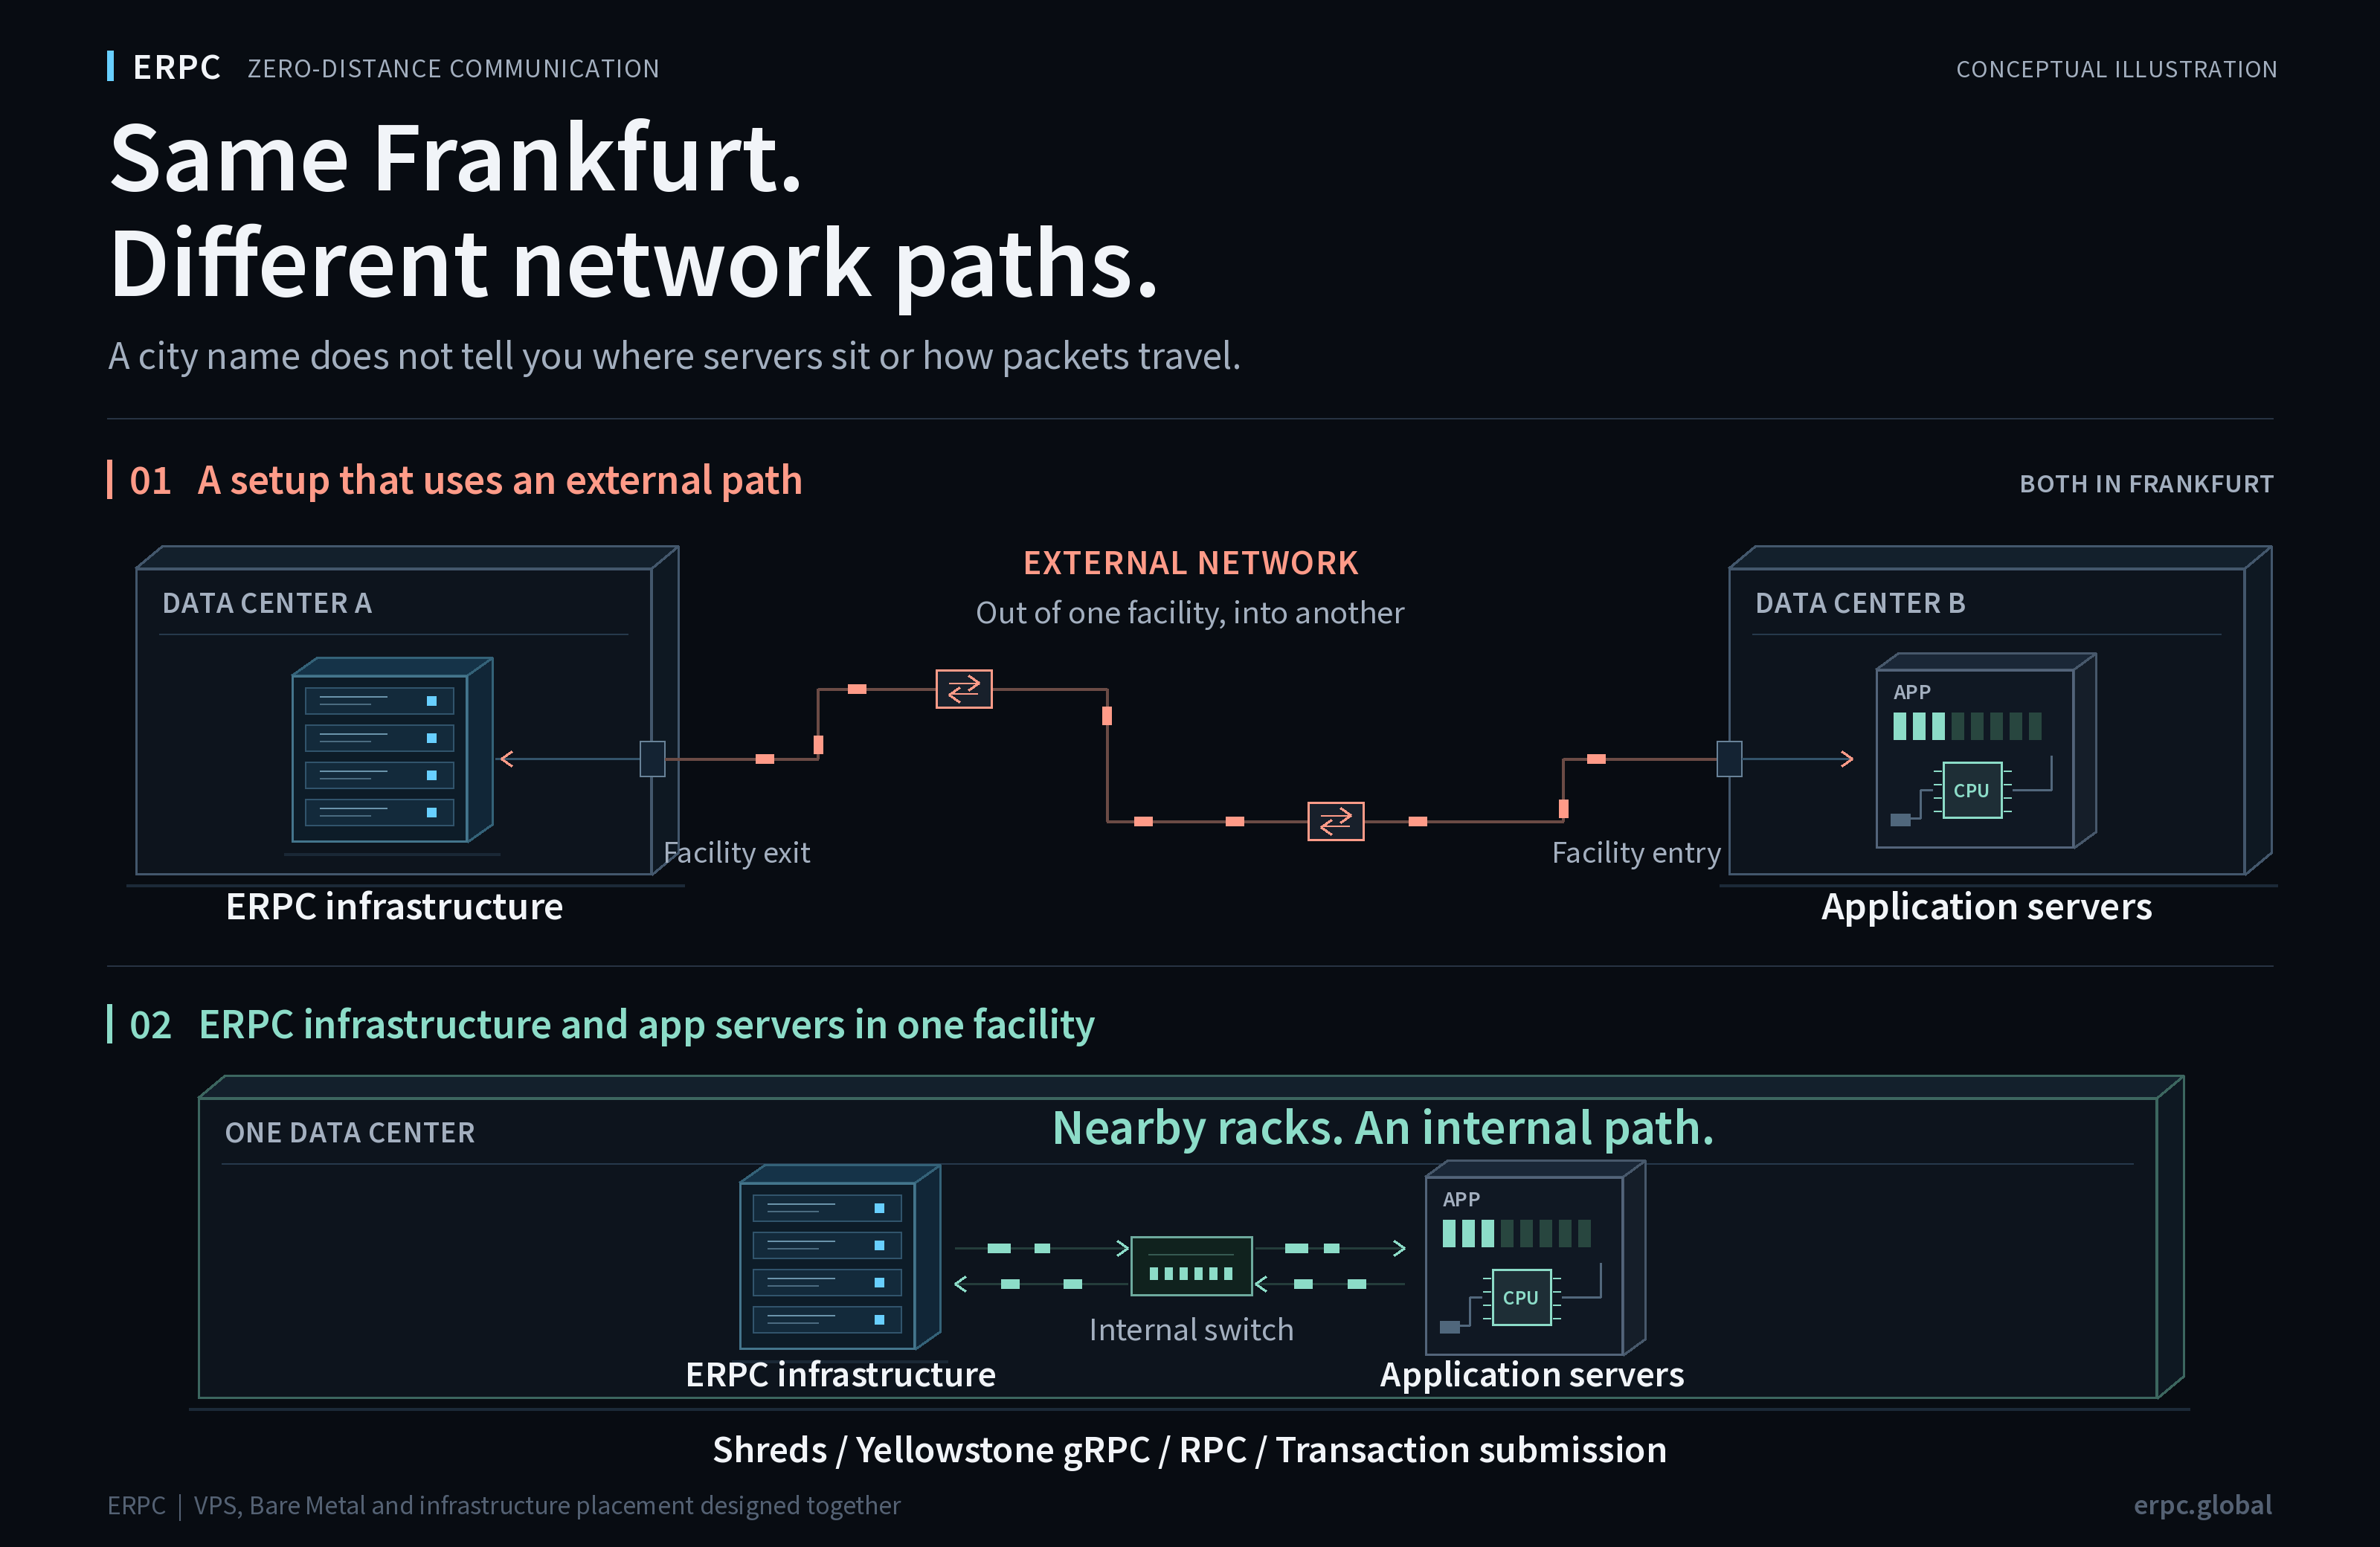
避免 ERPC 服务与应用服务器之间绕行外部网络,可以缩短路径,减少这一段通信受外部网络拥塞和路由变化影响的因素。较短的路径与接收、处理所需的资源相结合,才有利于发挥高速数据流的价值。效果需要分别通过数据包到达和应用处理来验证。
网络条件影响各种通信
在 Shreds 中,片段缺失是显而易见的问题;同一基础设施的质量,也会广泛影响数据接收、API 请求和交易提交。协议不同,应用看到的症状和需要测量的位置也会不同。
| 通信类型 | 网络影响体现在哪里 | 在应用中检查什么 |
|---|---|---|
| Shreds / UDP | 数据包丢失与延迟,以及重建所需片段的到达 | 有效 Shreds,以及数据能够完成重建所需的时间 |
| Geyser Yellowstone gRPC | TCP 重传等待、数据流积压与延迟 | 接收并处理同一更新所需的时间 |
| RPC、API 与服务间通信 | 请求和响应的往返,以及拥塞时的等待 | 响应时间及其波动 |
| 交易提交 | 通往接收节点的请求路径 | 从提交请求到收到节点响应的时间 |
邻近部署与适当的运营策略,为这些通信共同提供支持。接收节点的响应时间,与交易在链上被纳入区块并最终确定所需的时间,应分别测量。
只看 Gbps,无法了解 PPS 和突发流量
带宽表示单位时间内能够传输的数据量。PPS 表示每秒处理的数据包数量。即使连接还有剩余带宽,也可能触及数据包速率上限或针对 UDP 的限制。云服务商的官方文档也将带宽与 PPS 配额作为不同的约束条件。[1]
此外,Shreds 并不一定匀速到达。短时间内集中到达的突发流量,会造成平均值无法反映的队列压力。如果数据包积累的速度超过网络设备或接收端的处理速度,超出队列容量的部分就可能被丢弃。[2]
向主机服务商确认的内容不应只有线路速度,还应包括是否允许持续接收 UDP、如何处理短时突发、PPS 限制,以及 DDoS 防护的适用规则。重点是确认如何安全地允许必要流量通过,而不是一概关闭防护功能。
gRPC 正常运行,不代表 UDP 接收也正常
基于 TCP 的 gRPC 与通过 UDP 转发的原始 Shreds,使用不同的传输机制。TCP 提供重传和顺序控制,gRPC 流式通信则通过流量控制适应接收端的处理容量。UDP 本身不会重传丢失的数据包,也不会让发送端等待接收应用赶上处理进度。[3]
因此,同一台服务器上的 gRPC 正常运行,并不能证明 UDP 路径或接收处理也正常。需要分别检查各协议的过滤规则、端口、传输路径和接收实现。gRPC 的处理延迟也可能表现为等待时间增加或连接断开。
此外,gRPC 的 transactions/sec 与 UDP 的 packets/sec,单位和所处的处理阶段都不同。不能直接用这两个数值比较传输量或计算丢失率。
从数据包到达,到数据可用
在标准 UDP 套接字接收过程中,到达主机的数据包会经过网卡、内核和套接字接收缓冲区,随后才交给应用。如果其中某个环节处理不及,数据包即使已经到达主机,也可能被丢弃。Linux 接口接收计数器包含在后续阶段被丢弃的数据包,因此接收计数增加,并不等于数据已交付应用。[4]
即使 CPU 总体利用率较低,处理也可能集中在某个接收队列或核心上。需要检查网卡队列、中断分配和 CPU 单核性能。在应用中,应根据实际情况将接收与后续处理分开,避免在接收循环中塞入繁重的解析工作或大量日志输出。接收缓冲区能够吸收暂时的流量集中,但无法解决持续处理能力不足的问题。[5]
Shreds 是区块数据的片段。前向纠错(FEC)可以利用同一组中的 data shreds 和 coding shreds 恢复缺失的数据,但重建仍需要足够的片段。收到更多重复数据包,也不能替代缺失的片段。[6]
根据具体实现,接收端可以在整个 slot 完成之前,利用已经凑齐的片段重建 entries。[9] 除了数据包总数,还应测量去重后的有效 Shreds、成功重建的数据,以及应用识别目标事件所需的时间。
在相同时间窗口内,分别测量各个阶段
将发送端与接收端的目标地址、端口和测量时间窗口对齐。随后分别记录以下阶段,有助于缩小下一步调查范围。
| 测量位置 | 记录内容 | 可以判断什么 |
|---|---|---|
| 发送端 | 针对目标地址的发送记录,以及计数器的定义 | 发送过程中的哪个阶段得到了观测 |
| 接收主机入口 | 目标 UDP 流量的抓包、网卡统计,以及抓包自身的丢包情况 | 在该观测点实际看到了多少流量 |
| 操作系统与套接字 | UDP 错误、接收缓冲区丢包,以及队列变化 | 主机内部的接收处理是否出现积压 |
| Shreds 重建 | 有效且不重复的 Shreds、重建成功情况、缺失数据和错误 | 能否从数据包中提取所需数据 |
| 应用 | 待处理任务,以及识别同一事件的时间戳 | 数据到达的速度是否真正转化为应用收益 |
如果抓包只看到少量数据包,首先核对过滤条件、观测接口、抓包自身的遗漏和网卡丢包。有些操作系统计数器覆盖整个主机或网络命名空间,需要确认其统计范围,再与目标应用的测量结果对应。[4][5]
确认瓶颈所在的阶段后,再修改配置。仅仅增大缓冲区或环形队列,可能只是把瓶颈转移到其他地方,或增加等待时间。ERPC 当前的接收配置与检查步骤见文档:
选择服务器,也要选择运营策略
Solana Foundation 在介绍高性能验证节点时,强调了能够控制网卡、物理核心、驱动程序和网络环境的重要性。但不应将完整验证节点的要求直接套用到每一个 Shreds 接收应用上。接收应用需要的是与自身数据流及处理工作负载相匹配的配置。[7]
降低成本或功耗,本身都是合理的运营目标。与此同时,HFT 和实时应用需要 CPU 迅速响应、持续的处理能力,以及较短的网络等待时间。从节能状态唤醒所需的时间,也是与延迟相关的一项权衡。[8]
除了 CPU 型号和核心数,还要了解资源如何共享、如何应对持续负载、UDP 流量适用什么条件,以及实际的网络路径。
ERPC 将数据流与接收环境一并考虑
ERPC 持续优化靠近 Solana 基础设施的数据中心选址、网络路径、硬件和运营配置,在提供 Shreds 和 gRPC 的同时,也提供 VPS 与 Bare Metal。您可以根据处理工作量选择 VPS;如果需要独占物理资源,则可以比较 Bare Metal。
了解所提供环境的配置和运行方式,也有助于技术支持。我们可以对照发送端记录与接收端测量,明确下一步需要在网络、操作系统或应用中检查什么。在本文提到的咨询中,我们也检查了发送端测量结果,并请接收端补充测量。
将数据流、接收主机的位置和应用实现放在一起评估,更容易判断从所选服务到所需数据之间,还缺少什么条件。
通过按小时计费,与当前环境进行比较
如果您对当前接收环境存在疑问,可以按小时使用 ERPC VPS 或 Bare Metal,并用相同的数据流和应用进行比较。所需区域的当前价格、可用资源和订购条件,请在控制面板中确认。
先选择可用的配置,记录接收数量、成功重建的数据、处理积压,以及识别同一事件的时间戳。跨主机比较时间戳时,也要检查时钟同步精度。在不同时间段重复测量,比较路径中的哪些阶段产生了差异,再据此选择适合自身应用的服务器和数据中心。
- VPS: https://erpc.global/zh/vps/
- Bare Metal: https://erpc.global/zh/baremetal/
- 控制面板: https://dashboard.erpc.global/zh/
相关文章
- Solana Stream SDK v4.0.0: https://erpc.global/zh/news/2026/11/07/erpc-solana-stream-sdk-v4-20261107/
- [9] Shreds UDP Forwarding Premium: https://erpc.global/zh/news/2026/11/03/erpc-shreds-udp-forwarding-premium-20261103/
- Validators DAO 官方 Discord: https://discord.gg/C7ZQSrCkYR
技术资料
- [1] AWS EC2 带宽与 PPS 配额: https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/monitoring-network-performance-ena.html
- [2] IETF UDP Usage Guidelines,突发流量: https://www.rfc-editor.org/rfc/rfc8085.html#section-3.1.6
- [3] Linux UDP: https://man7.org/linux/man-pages/man7/udp.7.html
- [3] Linux TCP: https://man7.org/linux/man-pages/man7/tcp.7.html
- [3] gRPC Flow Control: https://grpc.io/docs/guides/flow-control/
- [4] Linux Interface statistics: https://docs.kernel.org/networking/statistics.html
- [4] libpcap 抓包行为与丢包: https://github.com/the-tcpdump-group/libpcap/blob/master/doc/README.linux
- [5] Linux 网络处理的扩展与分配: https://docs.kernel.org/networking/scaling.html
- [5] Linux 套接字接收缓冲区: https://man7.org/linux/man-pages/man7/socket.7.html
- [5] Red Hat UDP 丢包调查: https://docs.redhat.com/en/documentation/red_hat_enterprise_linux/10/html/network_troubleshooting_and_performance_tuning/tuning-udp-connections
- [6] Anza Turbine Block Propagation: https://docs.anza.xyz/consensus/turbine-block-propagation/
- [7] Solana Foundation,高性能验证节点硬件: https://solana.com/news/high-performance-solana-validators-run-on-bare-metal-hardware
- [8] Linux CPU Idle Time Management: https://docs.kernel.org/admin-guide/pm/cpuidle.html