拖慢Solana应用的十个误区:为什么高速配置仍然会慢
连接速度很快,CPU也很新,服务器甚至与数据提供方位于同一座城市。然而,应用对所需信息的反应依然迟缓。连接没有断开,正在处理的数据却逐渐落后于最新状态。
在Solana上开发低延迟应用时,这种情况未必只有一个原因。网络路由、接收配置、订阅的数据,以及应用内部的等待,可能共同限制所选高速基础设施的性能发挥。
ERPC由ELSOUL LABO B.V.运营。我们的支持团队反复遇到接收循环停滞、客户端配置、订阅范围过宽,以及未解决原始错误就不断重连等问题。在传统Web应用中影响不大的选择,到了高频交易和实时处理场景,可能就会成为瓶颈。
本文梳理这些问题背后的十个误区,帮助你同时检查基础设施的选择,以及将其性能传递到决策和交易提交环节的设计。
本指南面向具有Web应用开发经验、准备在Solana上实现高频交易(HFT)或其他实时应用的开发者,介绍如何选择运行环境以及从哪些检查开始。本文所说的“订阅”,是指选择应用需要持续接收哪些数据更新。
首先明确:希望哪件事更早完成
网络往返时间、数据到达时间、决策时间,以及交易得到确认所需的时间,是不同的指标。如果收到数据后的处理停滞,ping再快也无法让决策及时完成。RPC响应迅速,也不意味着交易已经执行。
例如,一个应用接收某个市场的状态更新,重新计算条件,并在条件满足时提交交易。这时,应分别考察更新到达前的时间、完成重新计算所需的时间,以及确认已提交交易结果所需的时间。把“更快”具体化为希望缩短的时间区间,就能明确从哪里排查。
根据这一目标,分别测量观察、接收后的处理,以及提交与确认。改善的起点,是不再用单个产品名称或单一数字概括速度。
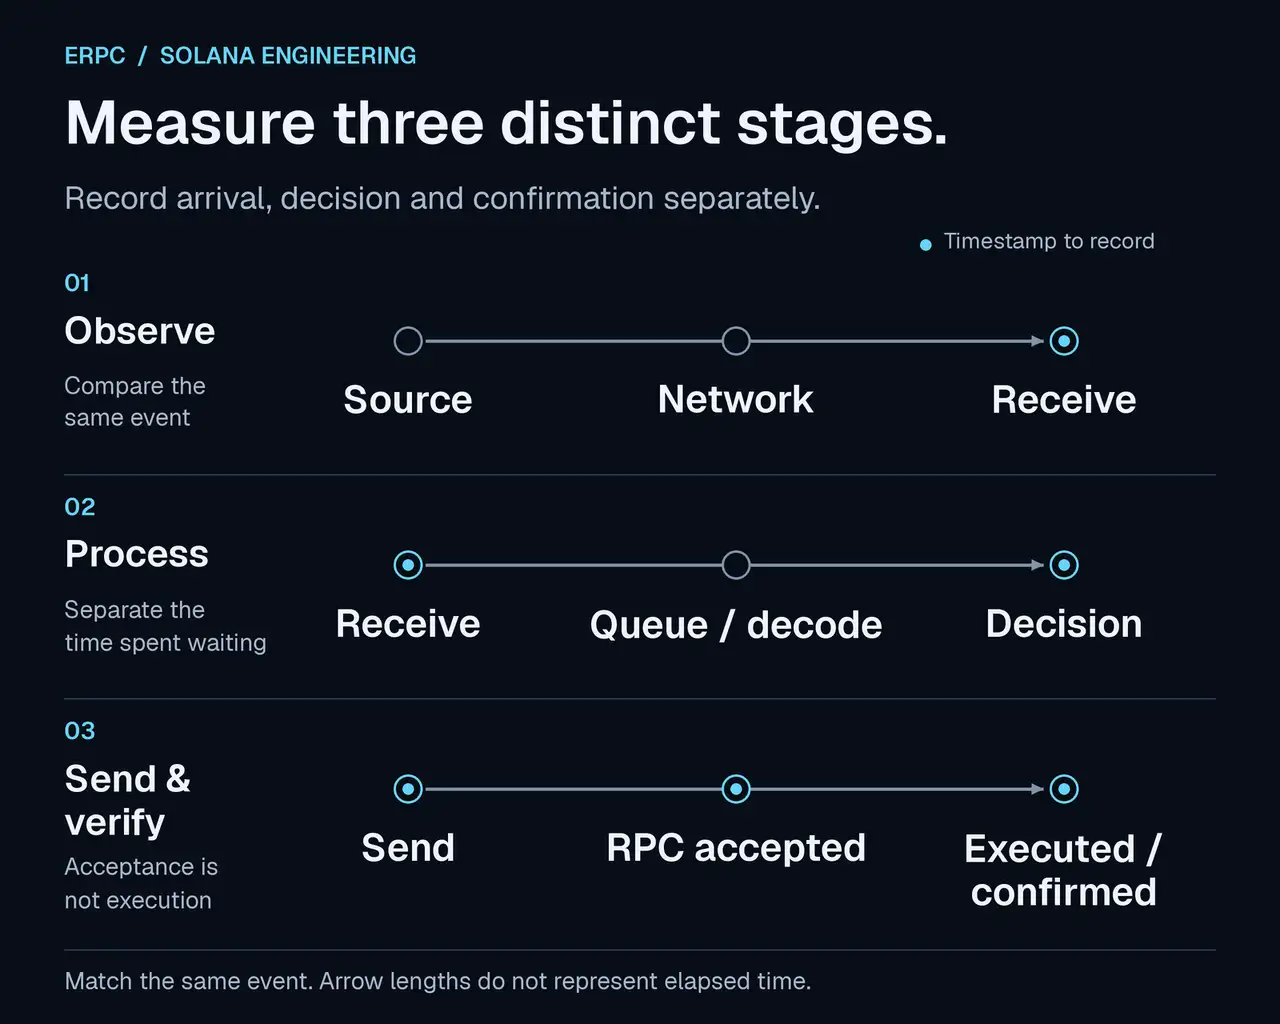
分别测量观察、应用内部处理,以及提交与确认三个阶段。此图用于说明测量阶段,不代表各阶段的实测耗时或性能差异。
误区1:小型VM能运行,就说明性能足够
小型云VM曾经很好地承载了某个Web应用或Ethereum工作负载,这种经验容易让人认为,相同配置也能处理Solana数据流。但偶尔发起RPC查询的应用,与持续接收、处理大范围更新的应用,所需资源并不相同。
应根据数据量、到达速率、每个事件的处理工作和可接受延迟确定环境规模。每秒会收到多少事件?传输多少字节?解码和决策消耗多少CPU时间与内存?除了正常流量,还要预留应对突发流量的余量。即使在同一条链上,订阅范围与实现方式也会改变资源需求。
难点在于,资源不足的应用可能看起来仍在正常工作。屏幕持续显示数据,内容却越来越陈旧;重连期间的缺口也可能没有被发现。只看接收事件数无法识别这些问题。还应检查处理完成的事件数、未处理数据的等待时间,以及订阅应覆盖事件的连续性。
如果只参照过去的经验,开发者可能始终不怀疑接收端的处理能力,而持续将问题归因于数据端点。尝试资源更充裕的环境,有时能暴露之前没有察觉的积压或数据缺失。
排查时,在资源更充裕的接收与处理环境中,使用相同端点、订阅、commitment(请求的确认级别,详见误区9)、SDK及配置,以及相同处理任务进行比较。保持区域一致,记录CPU、内存和网络的差异,并比较接收吞吐量、完成的工作量、积压、缺失事件和决策耗时。工作负载会随时间变化,因此应尽可能在同一时段比较,同时遵守连接数限制,控制对服务施加的负载。
更换环境后有所改善,说明接收或处理条件对结果存在影响。如果CPU、内存和网络同时发生变化,还需要进一步检查才能确定起作用的资源。按照实际处理的数据量与到达速率选择资源,是低延迟处理的前提。
误区2:位于同一城市,网络距离就一定近
“都在Frankfurt,所以肯定很近。”“部署在Tokyo,对日本用户一定最快。”城市名称有助于筛选部署位置,但不能保证流量实际经过的路径。
路径取决于数据中心之间的连接、网络运营商之间的连接,以及路由选择。即使服务器位于同一城市,通信也可能绕经外部网络。例如,RIPE IPmap将流量离开某个国家后又返回等低效路由的可视化,列为其用途之一。[1]
应测量实际数据源与运行应用的主机之间的RTT、随时间变化的波动、重传或丢包,以及同一事件的到达时间。Traceroute和MTR能帮助调查路径,但不能仅凭跳数判断哪条路径更好。也不能把中间路由器限制诊断响应,直接认定为影响应用的数据包丢失。
选定区域后,再问一步:这个具体的数据源与这台具体的服务器,实际上如何连接?这项额外检查能够揭示城市名称无法说明的差异。
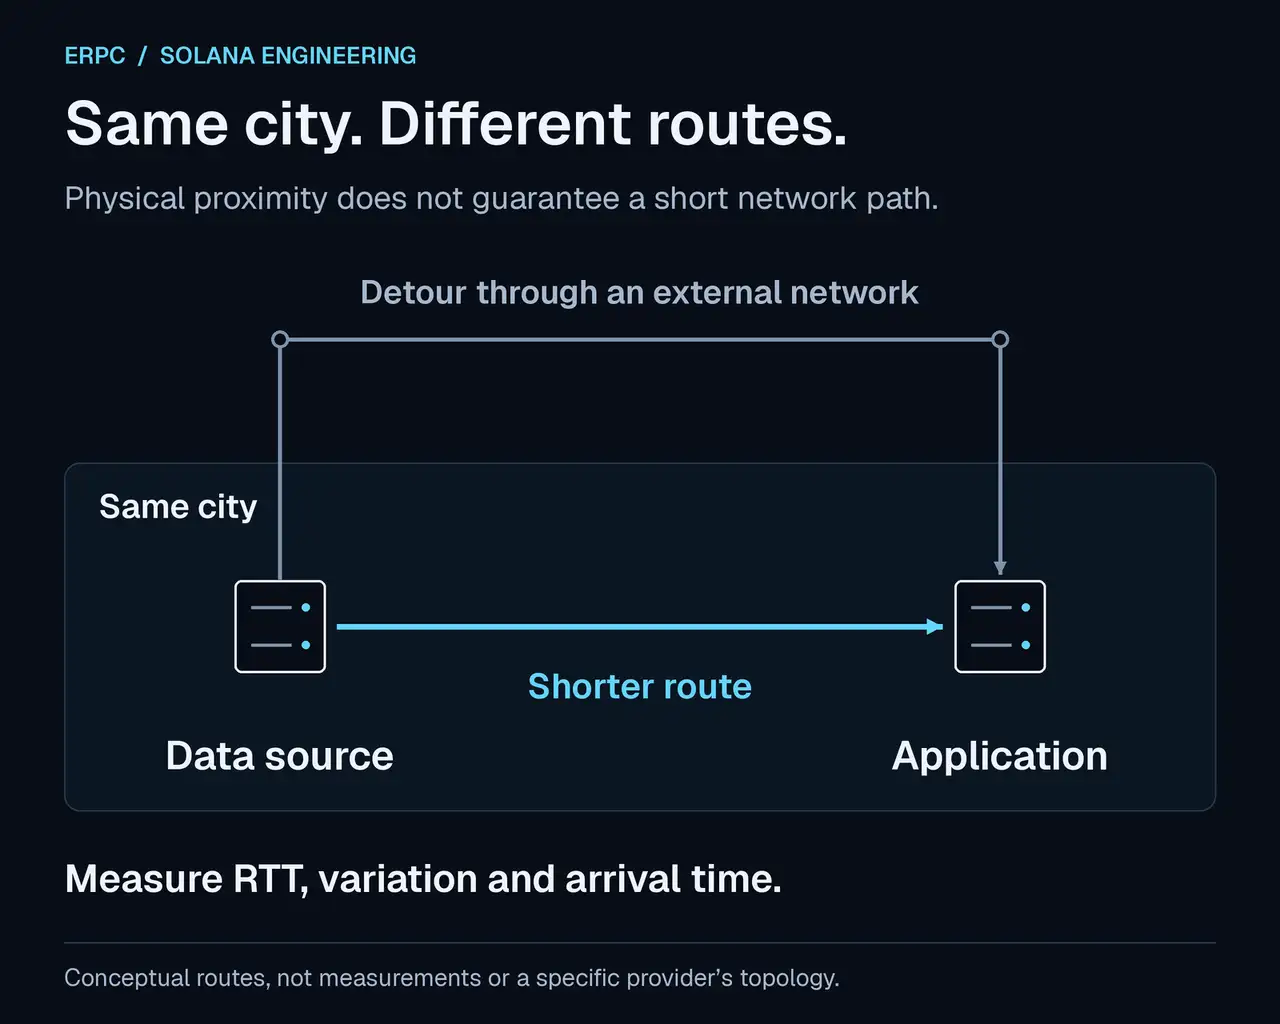
同一城市内的两台服务器,通信路径和往返时间仍可能不同。此图用于解释路由差异,并非任何特定服务商的实际网络。
误区3:网络规格高,可用带宽就一定充足
服务器规格中的带宽可能指不同内容:物理端口速率、分配给虚拟机的带宽、持续带宽,或临时突发上限。配备高速网卡,并不意味着应用能持续用满其全部容量。
例如,AWS文档区分基准带宽与突发带宽,并说明与流量目的地、流和包速率有关的限制。这是理解规格的例子,不代表所有VPS都具有与AWS相同的限制。[2]
选择方案时,要确认带宽是独享还是共享、持续使用的条件、流量额度,以及不同目的地的流量是否适用不同的限制。测试时,应使用计划在生产中采用的相同端点和订阅条件持续通信,并同时观察接收吞吐量、丢包、重传和CPU负载。
短时间测速得到高分,不能证明服务器能够持续处理生产数据流。同时,接收吞吐量低也不一定意味着带宽不足。升级网络前,应先区分接收配置问题与处理能力限制。
误区4:CPU型号更好、核心更多、最大GHz更高,应用就快
CPU的最大加速频率,不是它在所有工作负载下都会维持的时钟频率。实际运行受功耗、温度、固件、频率控制和其他负载影响。Linux文档也解释了,启用boost只是允许使用加速功能,不代表CPU当时确实处于加速状态。[3]
如果关键工作集中在一个线程中,仅增加核心数不会让该工作更早完成。总体CPU使用率看似很低时,某个核心或事件循环仍可能已经饱和。Node.js官方指南也说明了重型回调如何让其他工作等待。[4]
应在实际负载下检查时钟频率、温度、各核心使用率和处理耗时。在虚拟环境中,等待CPU分配的时间也有参考价值。通过性能分析,确认解码、计算、内存分配和日志输出各自消耗了多少时间。
需要综合选择CPU时钟性能、资源分配、可持续发挥性能的配置和应用实现。只比较型号,无法确定整个应用的运行速度。
误区5:使用gRPC,客户端默认配置就足够
建立gRPC连接,不代表能够以所需速度接收所需数据量。HTTP/2通过流量控制,由接收方告知发送方可以接收多少数据。控制同时存在于流和连接两个层级,因此即使网络链路尚有余量,接收窗口及其更新也可能限制吞吐量。[5][6]
接收窗口告知发送方,在接收方再次更新之前,最多可以发送多少数据。初始值、自动调整和配置优先级因SDK与库而异。在配置文件里写入一个大数值,并不能证明客户端按预期运行。要检查流和连接两个层级的配置、它们与自适应配置的关系,以及所用版本。
调整时,应在相同订阅条件下测量实际接收吞吐量和处理积压。单条消息的最大接收大小、TCP接收缓冲区,以及HTTP/2接收窗口,是不同的配置。Keepalive检查连接是否存活,并不会增加处理能力或带宽。
ERPC gRPC FAQ提供了排查步骤和客户端配置示例,适用于吞吐量持平而延迟不断增加的数据流。可以将示例作为起点,再根据自身订阅量与处理能力验证。[7]
使用配置示例前,先记录SDK的名称和版本。找到该SDK中流(stream)和连接(connection)接收窗口以及自动调整的配置位置,再与FAQ示例对照。如果使用的是另一种SDK,应查阅其文档,确认对应配置,而不要原样照搬参数名和数值。
误区6:接收所有完整区块,就能最早作出判断
“先接收全部数据,再寻找有用信息。”这是开始开发时容易理解的方式,但也会增加作出判断前并不需要的工作。传输、解码、为无关数据分配内存并进行搜索,都会消耗有限的带宽和CPU资源。
如果希望响应某个市场、程序或账户的变化,应先定义决策所需的事件和字段。Yellowstone gRPC提供交易与账户订阅过滤器,也能只获取部分账户数据。完整区块通知与单条更新通知,本身也是不同的数据形式。[8]
例如,需求是“市场A的状态变化时,重新计算条件”,就应列出识别市场A的信息、计算所需的状态,以及更新这些状态的事件。所需数据因程序规范而异,因此要将规范与实际收到的更新对照。根据这份清单缩小订阅范围,再确认决策所需的状态仍然完整。
在资源与条件相同的情况下,如果一个应用等待全部记录解析并搜索完毕,另一个应用能立即处理必要更新,后者就省去了这段等待。专注于特定目标的竞争者反复更早响应,原因可能不只在网络连接。决定哪些信息可以忽略,也是低延迟设计的一部分。
索引、审计、研究和历史存储可能确实需要全量数据。应为这类负载提供独立路径。将它与即时决策分离,可以分别设计所需的处理能力和完整性。不过,必须验证过滤没有排除正确决策所需的更新。批处理在某些情况下也能提高总吞吐量,应根据应用可容忍的等待时间选择。
在ERPC当前的Shared gRPC服务中,非空的
blocks订阅需要Dedicated服务。transactions订阅或blocksMeta可能满足特定需求,但两者提供的数据都不等同于完整区块。选择Dedicated服务后,仍需具备合适的接收端处理能力和订阅设计。[9]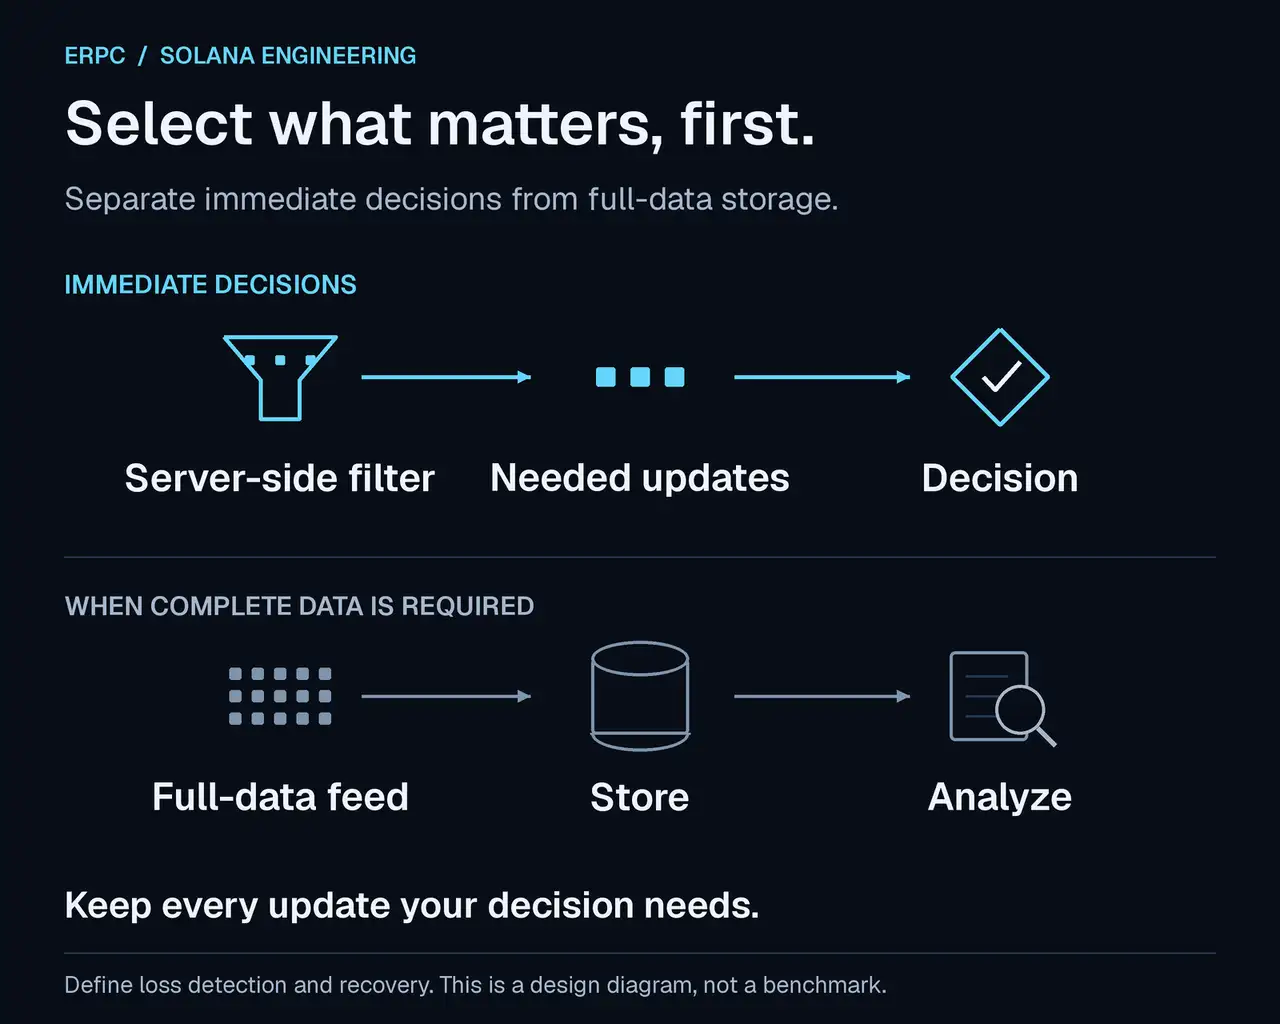
将即时决策所需的更新与全量存储、分析分到不同的处理路径。确认过滤后仍保留正确决策所需的状态,并定义数据缺失后的恢复方式。此图说明一种架构设计方式。
误区7:数据一直在到达,处理就一定跟得上
从数据被接收,到处理成可供决策使用的状态之间,可能形成队列。如果持续流入的工作超过处理能力,即使连接保持畅通,延迟也会累积。更大的缓冲区可以吸收短时突发,但面对持续的处理不足,只会容纳更多旧数据。
下面是一个用于理解机制的假设示例。初始没有待处理事件,应用每秒接收12,000个同类事件,每秒完成处理10,000个。如果所有事件都能保留在队列中,中途没有丢弃或合并,待处理事件就会每秒增加2,000个,10秒后达到20,000个。连接保持正常,屏幕上也不断显示数据,但决策所需的处理仍会越来越落后。这些数字只用于说明机制,不是ERPC的实测性能。
不要只测量收到的事件数。还要测量处理完成量、队列长度、最早一条未处理数据的等待时间,以及从接收到决策结束的时间。连接健康与数据新鲜度应分开监控。
接收循环中只保留维持接收所需的工作。考虑将数据库写入、完整载荷日志、外部API调用和重型计算分到其他处理路径。为队列设置容量上限,以及队列满时的处理策略。有界队列填满后仍会让上游工作等待;它本身不能解决处理能力不足。[10]
对于只关心最新状态的更新,有时可以合并旧状态。但要求按顺序处理或完整处理的交易事件,不能任意丢弃。应根据应用需求设计缺口检测、重放和重连后的状态恢复。
ERPC的
STREAM_GUARD_SLOW_READER是针对写入进展不足或观测到分发延迟而采取的保护响应。不能仅据此认定原因。需要检查连接、主机、订阅量,以及应用的消费速率。重连前,应保留能够获取的首次status、message、metadata和trailers,再阅读服务器提供的原因与重试条件。未修正就重新发送相同的被拒请求,原始原因仍然存在。[7]误区8:ping或平均值很快,关键时刻就会快
Ping能提供网络往返时间的参考。它测量的区间不同于应用延迟,后者还包括数据源处理、订阅内容、接收等待、解码和决策。平均值也可能掩盖少数较大的延迟。
p50是中位数。p95和p99分别表示95%和99%的测量值不超过的数值位置。p99不是最大值。应附上样本数和测量时段,并检查事件集中到达时的结果、最大值、超时、断连和数据缺失。[11]
比较提供方时,应匹配相同事件、数据类型、commitment和订阅条件。尽可能在同一台测量主机上接收,并用单调时钟测量应用内部的经过时间。对来自不同主机的时间戳做减法时,要考虑时钟偏差对测量的影响。
只保留成功事件,可能让经常缺失数据的配置看起来很快。选择最快的一次结果,与选择生产关键时刻更不容易落后的配置,是不同的判断。
误区9:最早到达的数据,含义与最终确定性都相同
Shreds、交易通知、账户更新和区块通知,并不代表同一阶段的同一种信息。使用更早阶段的数据,可能需要应用自行完成更多重建或解释。比较时,不仅要对齐接收时刻,还要对齐该时刻究竟能知道什么。[8][12]
也要区分Solana的
processed、confirmed和finalized commitment级别。如果使用早期观察结果作出决策,应用需要在之后检查确认状态,并在必要时修正自身状态。接收早期更新的处理,与在外部系统中执行最终操作所需满足的条件,应分开设计。[13]例如,简单比较不同commitment下收到的通知,并宣称其中一个快了多少毫秒,并不是在比较同一项工作。先确定应用所需的信息与最终确定性,再测量在这些条件下达到可作出决策状态所需的时间。
误区10:提交成功,就会先执行
sendTransaction成功返回,意味着RPC接受了交易,不保证集群已经处理或确认。Solana规范明确要求另外检查交易签名的状态。[14]即使输入信息支持应用较早作出判断,提交路径、blockhash有效性、可写账户竞争、计算资源、优先费,以及交易自身的成功条件,仍然影响结果。SWQoS涉及通向leader的准入和连接优先级,优先费则影响调度优先级。两者角色不同,也都不会无条件保证执行顺序或成功。[15][16]
应分别记录决策完成、提交开始、RPC接受、执行结果,以及所需的确认状态。重试时,也要区分重新发送同一签名的交易与构造新交易,以避免意外的重复操作。
只有能够观察从接收到确认的整条路径,才能识别哪些改善会让你更接近目标。
最先建立的测量项目
先按以下三个步骤检查。
- 选择一项决策,写出它需要哪些更新,以及应用能够作出判断前必须具备哪些状态。
- 在同一测量时段内,记录同类事件的接收数量、处理完成数量和待处理数量。如果使用队列,还应测量最早一条待处理事件从应用接收至今经过了多久。
- 如果待处理数量或等待时间持续增长,查明工作积压在哪里。根据症状,从订阅内容、处理方式、配置或运行环境中选择一项调整,比较调整前后的结果。
从应用接收时刻开始计算的时间,用于检查应用内部的积压。事件在数据源发生后到达应用所经历的延迟,需要另外测量。完成这些初步记录后,再利用下表扩大检查范围。
| 阶段 | 记录内容 | 帮助识别的问题 |
|---|---|---|
| 网络与接收 | 实际接收吞吐量、重传与丢失、同一事件的到达差 | 路由、带宽和接收配置限制 |
| 应用 | 接收与处理完成数量、队列长度、最早未处理数据的等待时间 | 持续处理不足和陈旧数据累积 |
| 决策耗时 | 接收到决策完成的p50、p95、p99与最大耗时 | 高成本工作和突发期间的延迟 |
| 提交与确认 | 提交开始、RPC接受、签名状态、执行错误 | 接收之后的延迟与失败 |
| 比较条件 | 区域、主机、SDK及版本、订阅、commitment、时段与样本数 | 条件不同造成的表面差异 |
保留基线,然后根据症状逐项验证调整:订阅范围、处理分离、客户端配置,以及部署位置或资源。扩大窗口时,也要检查内存占用和积压是否增加。缩小订阅范围时,要确认必要信息没有丢失。
总耗时的p99,不能通过简单相加各阶段的p99得出。应根据每个对应事件的总耗时计算,再用分阶段测量定位原因。除了平均负载,也要在实际的事件突发期间测试。
ERPC准备基础设施,让开发者专注打磨逻辑
网络、服务器、数据分发和客户端分别选择时,即使每项规格都很好,组合后仍可能留下等待。ERPC将Solana数据分发与处理环境整合到同一平台,减少开发者反复从零选择部署位置和资源的工作。
SUPER VPS和Premium VPS明确提供高时钟频率配置与不超额分配资源的设计,Bare Metal则提供物理独享机器。ERPC将网络与服务器放在靠近分发环境的位置,并为持续处理准备CPU、内存、存储和连接条件。具体规格可按方案与区域查询。[17][18]
| 常见开发障碍 | ERPC提供的基础设施与信息 | 应用中需要打磨的内容 |
|---|---|---|
| 城市名称无法揭示的距离 | 能够一起选择分发与处理环境的区域和网络配置 | 在自身订阅条件下测量到达时间及波动 |
| 资源竞争与持续性能 | 不超额分配资源的高时钟频率SUPER VPS、Premium VPS,以及独享Bare Metal | 找出高成本工作与串行处理 |
| 数据量与连接方式 | gRPC、Shreds、RPC,以及适合负载的共享或独享选项 | 定义所需事件与字段 |
| 接收配置与故障排查 | Solana Stream SDK、配置示例、过滤器文档和按错误分类的FAQ | 验证实际生效配置、队列、重连与恢复 |
ERPC帮助开发者推进基础设施选择与调优,让更多时间用于开发:观察什么、用哪些信息决策、何时提交。在选择合适服务与部署位置后,让订阅量匹配处理能力,才能将基础设施性能转化为应用速度。
先确定决策真正需要哪些信息,尽早接收,避免不必要的处理等待,并验证结果。ERPC将持续提供支持这些改善的环境与信息。
实现资源
- ERPC gRPC FAQ: https://erpc.global/zh/faq/grpc/general/
- 订阅过滤器与当前Shared限制: https://erpc.global/zh/doc/geyser-grpc/filter/
- gRPC实现最佳实践: https://erpc.global/zh/doc/geyser-grpc/best-practices/
- Solana Stream SDK: https://github.com/ValidatorsDAO/solana-stream
- ERPC VPS: https://erpc.global/zh/vps/
- ERPC Bare Metal: https://erpc.global/zh/baremetal/
- ERPC Dashboard: https://dashboard.erpc.global/
- Validators DAO官方Discord: https://discord.gg/C7ZQSrCkYR
技术参考资料
- RIPE IPmap,路由低效的可视化: https://ipmap.ripe.net/
- AWS,实例网络带宽: https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/ec2-instance-network-bandwidth.html
- Linux Kernel,CPU性能调节: https://docs.kernel.org/admin-guide/pm/cpufreq.html
- Node.js,避免阻塞事件循环: https://nodejs.org/en/learn/asynchronous-work/dont-block-the-event-loop
- IETF RFC 9113,HTTP/2流量控制: https://httpwg.org/specs/rfc9113.html#FlowControl
- gRPC,流量控制: https://grpc.io/docs/guides/flow-control/
- ERPC,gRPC FAQ中的接收配置、慢速接收端与重试: https://erpc.global/zh/faq/grpc/general/
- Yellowstone gRPC,订阅与过滤器规范: https://github.com/rpcpool/yellowstone-grpc
- ERPC,当前Shared过滤器规则: https://erpc.global/zh/doc/geyser-grpc/filter/
- Tokio,队列与背压: https://tokio.rs/tokio/tutorial/channels
- AWS CloudWatch,百分位数定义: https://docs.aws.amazon.com/AmazonCloudWatch/latest/monitoring/Statistics-definitions.html
- ERPC,Shreds UDP Forwarding: https://erpc.global/zh/doc/shredstream/udp-forwarding/
- Solana,交易确认与过期: https://solana.com/developers/cookbook/transactions/confirmation
- Solana,sendTransaction: https://solana.com/docs/rpc/http/sendtransaction
- Solana,按质押权重分配服务质量: https://solana.com/docs/defi/stake-weighted-qos
- Solana,交易费用: https://solana.com/docs/core/fees
- ERPC,VPS配置与规格: https://erpc.global/zh/vps/
- ERPC,Bare Metal配置与规格: https://erpc.global/zh/baremetal/