








Haz tu aplicación Solana más rápida: revisa el volumen de datos gRPC, el procesamiento de recepción y los recursos de ejecución
La aplicación Solana que estás desarrollando podría funcionar más rápido. El volumen de datos que recibe, el procesamiento posterior y recursos como la CPU y la red trabajan en conjunto. Revisar esa combinación puede ayudarte a obtener más rendimiento del software que ya tienes.
Has empezado a desarrollar HFT en Solana, te has conectado a Geyser gRPC y ves datos en los registros. Sin embargo, las decisiones no llegan tan rápido como esperabas. Las esperas entre la recepción y una decisión pueden dar pistas sobre qué mejorar. Empieza por localizar lo que puedes observar en tu código actual.
En ERPC, las conversaciones y los comentarios de los clientes nos dan oportunidades para revisar la distribución de datos, la configuración de recepción y el procesamiento de las aplicaciones. Esas observaciones orientan las mejoras de nuestra distribución y documentación. Este artículo explica los mecanismos y los pasos de investigación para que quienes trabajan por primera vez con flujos rápidos y de gran volumen puedan explorar mejoras en su propio entorno.
Empieza con una pequeña comprobación en tu código actual
Puedes consultar los términos técnicos y los comandos de diagnóstico a medida que resulten útiles. Si tienes un agente de IA capaz de leer el código de tu proyecto, prueba primero la breve petición que sigue. Añade dónde se ejecuta la aplicación y cuándo la notas lenta. Los requisitos todavía sin decidir y las mediciones no disponibles pueden permanecer así mientras empiezas.
text
Quiero averiguar si mi aplicación Solana tiene margen para responder más rápido.
Primero, lee el código actual e identifica dónde se reciben los datos y dónde termina la decisión que los utiliza. Mantén la suscripción sin cambios y propón la modificación más pequeña que permita medir la cantidad de eventos y el tiempo transcurrido en ese intervalo.
Para esta primera tarea, muestra los puntos de medición, el cambio propuesto, lo que permitiría averiguar y lo que seguiría sin medirse. Si no hay acceso al host, empieza por lo que puede observarse dentro de la aplicación. No muestres información confidencial, no modifiques producción ni crees recursos de pago.
Quiero averiguar si mi aplicación Solana tiene margen para responder más rápido.
Primero, lee el código actual e identifica dónde se reciben los datos y dónde termina la decisión que los utiliza. Mantén la suscripción sin cambios y propón la modificación más pequeña que permita medir la cantidad de eventos y el tiempo transcurrido en ese intervalo.
Para esta primera tarea, muestra los puntos de medición, el cambio propuesto, lo que permitiría averiguar y lo que seguiría sin medirse. Si no hay acceso al host, empieza por lo que puede observarse dentro de la aplicación. No muestres información confidencial, no modifiques producción ni crees recursos de pago.El primer resultado útil es saber dónde y qué medir en tu propio código. Separar los intervalos observables de los que no se han medido ayuda a elegir qué investigar después. Más adelante se incluye un prompt más detallado para profundizar en el diagnóstico.
Por ejemplo, un agente podría responder: «La recepción está en
stream.ts, en onData; la decisión se completa en strategy.ts, en onDecisionComplete. Propongo un cambio que agregue los recuentos de eventos recibidos y decisiones completadas, junto con el tiempo transcurrido en ese intervalo. El tramo anterior al callback queda fuera del alcance de esta propuesta de medición». Este ejemplo utiliza nombres ficticios de archivos y funciones en TypeScript. Sea cual sea el lenguaje de programación, comprueba que estos tres elementos sean coherentes entre sí: los puntos del código real, los registros que se añadirían y los límites de esta medición. Si las recepciones y las decisiones no tienen una relación de uno a uno, pide al agente que también proponga cómo relacionarlas y la unidad de conteo.Añade una perspectiva de flujos a tu experiencia en desarrollo web
Los servicios gestionados permiten desarrollar muchas funciones web sin pensar en los componentes individuales del servidor. Esa experiencia sigue siendo una base para trabajar con los flujos de Solana. Añade una visión de cuántos datos llegan continuamente y con qué rapidez los procesa la aplicación.
Conectar un SDK a Solana puede parecer igual de sencillo. Pero suscribirse a una amplia variedad de transacciones o actualizaciones de cuentas cambia la carga de trabajo. Las necesidades de ancho de banda, CPU y memoria dependen de la suscripción, el tamaño de los mensajes, la compresión, el procesamiento de la aplicación y el tráfico del momento. No existe una cifra única y fija de megabytes por segundo para «Solana».
El punto de partida es incorporar la relación entre el trabajo entrante y la capacidad de procesamiento al diseño y a las mediciones.
Un flujo activo también puede acumular una cola
Primero, compara los datos que llegan durante el mismo segundo mediante cuadrados del mismo tamaño. Cada cuadrado representa 1.000 mensajes; suponiendo 1 kB por mensaje, eso suma 1 MB. El ejemplo de menor volumen recibe 2 MB por segundo y el de mayor volumen, 12 MB por segundo. La aplicación receptora tiene la misma capacidad de procesamiento en ambos casos. Es un modelo ilustrativo del volumen de la carga útil de los mensajes en unidades decimales, sin compresión ni cabeceras de protocolo.
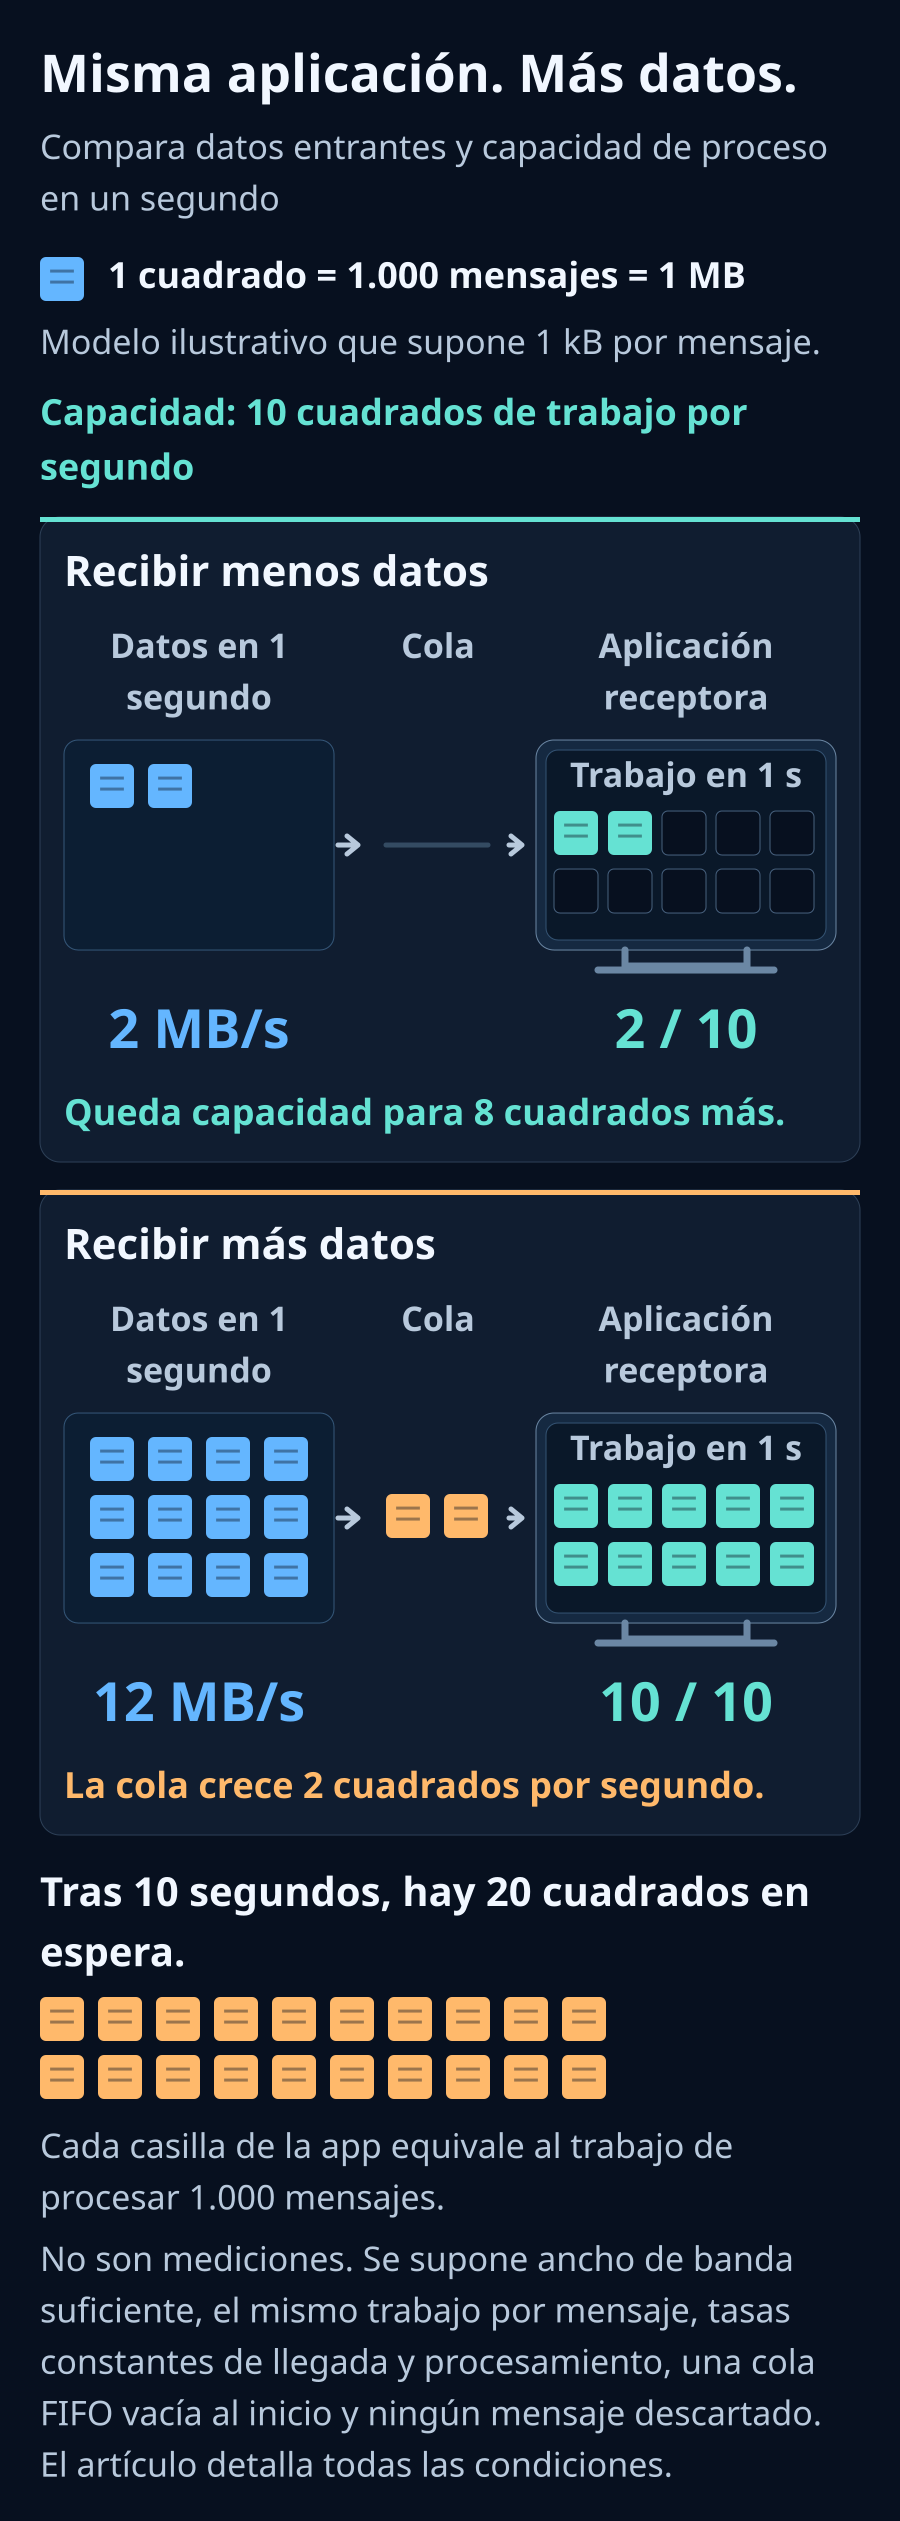
Consideremos un modelo ilustrativo: llegan 12.000 eventos por segundo y un equipo puede procesar 10.000 por segundo. Cada evento requiere el mismo trabajo, la cola está inicialmente vacía, los eventos se procesan en orden de llegada y no se descarta ninguno.
Cada segundo quedan otros 2.000 eventos sin procesar. Después de diez segundos, hay 20.000 eventos en espera. Un evento que se incorpora a la cola en ese momento espera aproximadamente dos segundos antes de que empiece su procesamiento. Los registros siguen avanzando mientras la cola sigue creciendo.
Son supuestos explicativos, no mediciones de Solana ni de ERPC. El modelo supone una entrada y una capacidad constantes. El tráfico real llega en ráfagas y el coste de procesamiento varía, por lo que pueden producirse esperas incluso cuando la capacidad media es suficiente.
El control de flujo de gRPC ajusta la transmisión a lo que el receptor puede aceptar. Cuando el procesamiento se queda atrás, la espera puede extenderse más allá de la cola de la aplicación, hasta las bibliotecas de comunicación o el emisor. Una conexión activa o una escritura exitosa en una API de envío no demuestra que los datos estén actualizados al llegar.[1]
Elige los datos que necesitas antes de que crucen la red
Si tus decisiones solo necesitan información de determinados programas o cuentas, define primero esos datos y aplica filtros de suscripción en el servidor. Yellowstone gRPC admite filtros para transacciones y cuentas. Comprueba las combinaciones exactas y las opciones disponibles en las especificaciones de la API, el SDK y el servicio que utilices.[2]
Si no sabes qué filtrar, revisa el código para identificar los valores que utiliza tu aplicación al tomar decisiones y qué campos de las notificaciones los proporcionan. A partir de esa correspondencia, plantea condiciones de suscripción y comprueba que incluyan los eventos necesarios que ya conoces. Verificar tanto la reducción de eventos como la conservación de los datos necesarios te da una base sólida para la siguiente comparación.
Recibirlo todo y descartar los datos innecesarios en el cliente implica que el trabajo de transferencia, descifrado y decodificación hasta ese punto ya se ha realizado. Filtrar en el emisor puede reducir ese trabajo. En el ejemplo anterior, limitar la entrada a los 2.000 eventos por segundo que necesitas deja margen a la misma capacidad de procesamiento de 10.000 eventos por segundo.
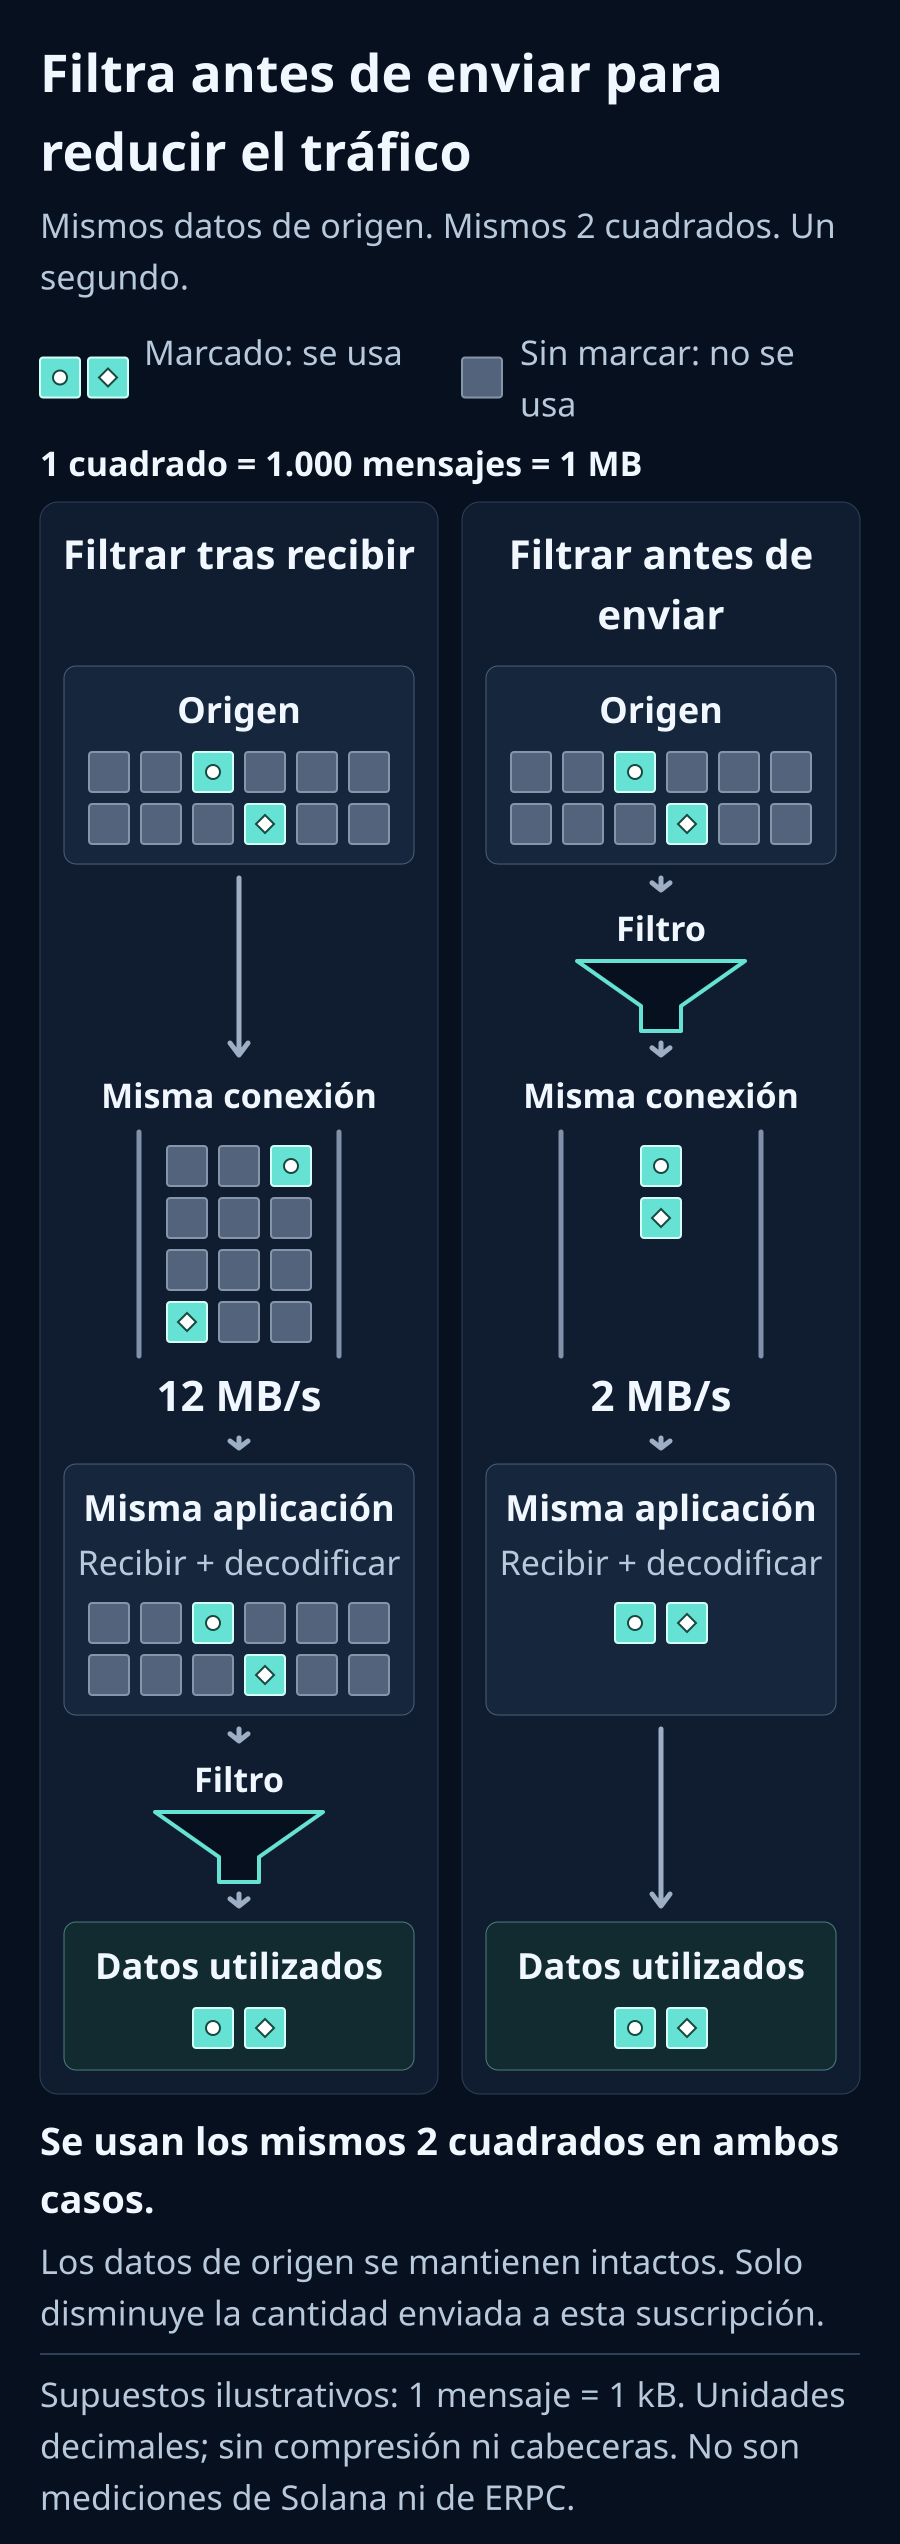
Piensa en el tráfico: la longitud de la carretera representa la distancia de propagación, los carriles representan el ancho de banda, el peaje representa la capacidad de procesamiento al recibir y la fila de coches representa el trabajo en espera. Enviar solo los coches necesarios al mismo peaje produce una cola distinta de dirigir hacia él todos los coches de los alrededores. Acortar la carretera y reducir el número de coches son mejoras diferentes.
La comunicación también tiene límites físicos. Transferir 100 MB a 1 Gbps tarda, en teoría, al menos 0,8 segundos; a 10 Gbps, tarda 0,08 segundos. Estos límites inferiores utilizan unidades decimales y excluyen la distancia, la sobrecarga del protocolo, las retransmisiones y el trabajo en cola. No significan que cada evento individual de un flujo se retrase 0,8 segundos.
Aunque un cálculo sea más rápido que un intercambio por la red, enviar datos innecesarios sigue teniendo un coste. Considera por separado el tiempo de propagación, cuánto puede cruzar el enlace por unidad de tiempo y cuánto trabajo puede completarse después de la llegada.
Algunas aplicaciones necesitan todos los datos, como los índices completos, la auditoría y la investigación. Requieren capacidad de recepción, procesamiento y almacenamiento para esa carga. Recibir todas las notificaciones individuales también es distinto de esperar a un bloque completo: datos agregados y reconstruidos como un bloque. Comprueba si tu decisión depende innecesariamente de datos ajenos a ella o de que termine la agregación.[2]
Revisa el procesamiento de recepción y los recursos de ejecución
Rust puede ayudar a reducir el coste de procesamiento. Para aprovechar esa velocidad, examina también el volumen entrante, la capacidad efectiva del enlace, el tiempo de espera de las escrituras en bases de datos, los bloqueos y las secciones secuenciales. En un entorno de ejecución asíncrono, asignar el trabajo intensivo en CPU y el que bloquea un hilo a partes adecuadas del sistema también puede mejorar la aplicación.[3]
Mantén corto el bucle de recepción y separa las tareas costosas. Define un límite de cola y qué ocurre cuando se llena. Una cola ilimitada puede ocultar el aumento del retraso como un aumento del consumo de memoria. Una cola acotada tampoco resuelve una insuficiencia sostenida de capacidad de procesamiento. Conserva el orden y la integridad necesarios al elegir entre suscripciones más selectivas, procesamiento más eficiente, particionado, paralelismo y recursos adicionales.
Empieza por medir desde la recepción hasta el final de la decisión y después investiga dónde aparece la espera. La tabla siguiente propone una primera forma de revisar cada área. Los nombres detallados de las métricas y los comandos también aparecen en el prompt de diagnóstico posterior, para que utilices los puntos que resulten relevantes.
| Recurso | Qué comprobar primero |
|---|---|
| CPU | ¿El trabajo se concentra en un solo núcleo? Comprueba el uso total y por núcleo, junto con los límites de CPU del entorno de ejecución |
| Memoria | ¿Siguen creciendo los eventos pendientes o el uso de memoria? Observa la cantidad de datos en cola junto con el tiempo de espera del evento más antiguo |
| Disco y base de datos | ¿La recepción espera a que termine el almacenamiento? Comprueba las escrituras en la base de datos y las esperas de almacenamiento. Si la aplicación no conserva datos, otras áreas ofrecen un punto de partida |
| Red | ¿El enlace y su configuración se ajustan al volumen entrante? Comprueba las tasas de transferencia reales, el tiempo de ida y vuelta y las retransmisiones |
Al investigar la comunicación con más detalle, la configuración de las bibliotecas puede aportar otras pistas. HTTP/2 dispone de ventanas de control de flujo tanto por flujo como por conexión que determinan cuántos datos adicionales puede enviar el otro extremo. Si ese margen es pequeño respecto al producto ancho de banda-retardo, es decir, el ancho de banda multiplicado por el tiempo de ida y vuelta, el rendimiento puede alcanzar un límite aunque el enlace tenga capacidad disponible. En ese caso, revisa la biblioteca y los intermediarios, comprobando el alcance del ajuste y su coste de memoria al modificarlo.[4]
Mide la actualidad y la espera, además de la recepción
Para empezar a comprobar si se acumula trabajo en la aplicación, conserva la suscripción actual y registra, durante el mismo periodo de observación, los eventos recibidos, los eventos completados, el número de elementos en la cola y la espera del evento más antiguo. Si no sabes dónde medir, usa el prompt de más abajo para que un agente inspeccione el código. Si no hay una cola explícita, empieza por el tiempo entre la recepción y la finalización de la decisión y compáralo con una versión de diagnóstico que elimine el procesamiento costoso.
El siguiente pseudocódigo, independiente del lenguaje y del SDK, muestra dónde corresponden las mediciones. Conserva el orden de procesamiento y la concurrencia actuales al añadir instrumentación al código real.
text
Cuando se reciben datos:
  Aumentar en 1 el contador de eventos recibidos
  Registrar una marca de tiempo de recepción monotónica asociada a ese evento
  Pasar el evento al procesamiento existente

Cuando termina la decisión que utiliza el mismo evento:
  Aumentar en 1 el contador de eventos completados
  Calcular y agregar el tiempo transcurrido desde la recepción
Cuando se reciben datos:
Aumentar en 1 el contador de eventos recibidos
Registrar una marca de tiempo de recepción monotónica asociada a ese evento
Pasar el evento al procesamiento existente
Cuando termina la decisión que utiliza el mismo evento:
Aumentar en 1 el contador de eventos completados
Calcular y agregar el tiempo transcurrido desde la recepciónSi la recepción y las decisiones no tienen una relación uno a uno, define primero esa correspondencia y la unidad que contarás. Resumir las observaciones en un intervalo fijo permite comparar resultados sin añadir un mensaje de registro por cada evento.
Para profundizar en el diagnóstico, registra también los bytes recibidos, los bytes de la cola, p50/p95/p99 del tiempo de procesamiento, los errores y las reconexiones. El p99 es el valor que el 99 % de los tiempos de procesamiento medidos no supera. Indica dónde se toma cada medida. El tráfico de la tarjeta de red, el tamaño Protobuf y el tamaño de los objetos decodificados son cantidades diferentes.
Utiliza un reloj monotónico para los tiempos transcurridos dentro de un mismo host y separa recepción, entrada en cola, salida de cola y finalización. Si la decodificación ya ha terminado cuando se ejecuta el callback del SDK, el intervalo anterior a ese callback no está medido. Para comparar con una marca de tiempo del emisor, comprueba la sincronización de los relojes y dónde se genera esa marca. No llames automáticamente latencia pura de red a la diferencia.
Si la espera disminuye al retirar el procesamiento de la aplicación sin cambiar la suscripción, es una pista para investigar el efecto de añadir ese procesamiento. Que el trabajo posterior al callback sea rápido no demuestra por sí solo que los datos llegaran actualizados.
También puedes comparar identificadores de eventos con un flujo de referencia que tenga la misma suscripción y el mismo commitment, es decir, la etapa de confirmación de los datos que utilizas. Comprueba que el flujo de referencia tampoco esté acumulando retraso. Un salto entre números de slot no demuestra por sí solo una pérdida de datos ni se traduce en una cantidad fija de segundos: algunos slots no contienen eventos que coincidan con los filtros, y los slots pueden omitirse.[5]
mtr ayuda a investigar la latencia y los patrones de respuesta de una ruta. La pérdida en un único salto intermedio puede reflejar que un router limita sus respuestas. Contrasta el comportamiento hasta el destino con las retransmisiones TCP, las velocidades efectivas de transferencia y otra ruta. mtr por sí solo no puede demostrar que se haya agotado el ancho de banda ni que exista un fallo en un centro de datos.[6]
Un prompt de diagnóstico para tu agente de IA
Entrega el siguiente texto a un agente que pueda leer el código de tu proyecto. Empieza por indicar dónde se ejecuta y cuándo y de qué forma lo notas lento. El agente puede investigar primero la conexión, la suscripción y el procesamiento posterior a la recepción a partir del código. No necesitas pegar claves API ni credenciales en la conversación.
Si aún no has definido los eventos necesarios o el retraso aceptable, indica que están por determinar. Explica con tus propias palabras qué información quieres observar y qué decisiones quieres tomar. Trata las mediciones no disponibles como no medidas y empieza por lo que puedas inspeccionar ahora.
text
Investiga si mi cliente Solana Geyser gRPC tiene margen para responder más rápido. Si hay retrasos, acumulaciones o desconexiones, aísla sus causas y ayuda a mejorarlos. No deduzcas que se están procesando datos actuales solo porque la conexión funciona o aparecen eventos en los registros. No decidas de antemano si la causa está en el cliente o en el proveedor.

1. Establece el objetivo: eventos necesarios, actualidad aceptable, requisitos de orden y pérdida de datos, filtros de suscripción, commitment, región del endpoint, versiones reales del lenguaje, SDK y biblioteca gRPC, y entorno de ejecución. Inspecciona primero el código, la configuración y los archivos de bloqueo disponibles; pregunta únicamente por la información que falte. Deja explícitamente sin definir los requisitos aún no decididos e investiga primero el estado actual. No muestres secretos y oculta la información sensible en los registros compartidos.

2. Mide desde la recepción hasta la finalización. Prioriza la recepción, la finalización y los tiempos de espera, empezando por lo que se pueda medir. Registra eventos/segundo, bytes/segundo, eventos completados/segundo, cantidad y bytes de la cola, espera del evento más antiguo, p50/p95/p99, errores, desconexiones, reconexiones y descartes. Si no hay una cola explícita, indícalo e identifica los intervalos de procesamiento que puedes observar. Indica los puntos de observación y los intervalos no medidos. Distingue entre tráfico de la tarjeta de red, bytes transmitidos, tamaño Protobuf y objetos decodificados. Usa un reloj monotónico para el tiempo local transcurrido; verifica la sincronización y el origen de las marcas de tiempo externas. No conviertas directamente un salto entre slots en pérdida de datos ni en una duración fija.

3. Separa las limitaciones de CPU, memoria, disco y red. Inspecciona CPU por núcleo o hilo, tiempo de CPU sustraído y límites de CPU, RSS/GC/swap/PSI, esperas de E/S, bytes/descartes/errores de la tarjeta de red, retransmisiones TCP y RTT. Algunas herramientas Linux posibles son mpstat, pidstat, vmstat, iostat, sar, ss -ti y /proc/pressure/. Si faltan herramientas o permisos, indícalo y proporciona los comandos mínimos necesarios. Si no se puede acceder al host, busca información en la consola de administración o en la instrumentación de la aplicación y marca como no medidas las magnitudes no disponibles. Nunca inventes resultados.

4. Inspecciona las ventanas HTTP/2 de flujo y conexión, los búferes de recepción TCP, proxies, VPN y sidecars. Consulta la documentación oficial de la versión instalada del SDK y considera el producto ancho de banda-retardo. Revisa la conversión JSON, el registro por evento, las llamadas síncronas a bases de datos o API externas, el trabajo bloqueante, los bloqueos, la creación ilimitada de tareas y las colas sin límite dentro del bucle de recepción o a su alrededor. No trates Rust o el código asíncrono por sí solos como una solución.

5. Cuando estén disponibles mtr o un equivalente, realiza una medición finita al host real del endpoint. En sistemas compatibles, considera: mtr --tcp --port <PORT> --report --report-cycles 30 <HOST>. Usa el puerto real en vez de suponer un puerto TLS estándar. No califiques como fallo la pérdida en un único salto intermedio; compárala con el comportamiento en destino, las retransmisiones y otras rutas. No uses mtr como sustituto de una medición de ancho de banda.

6. Registra una referencia inicial con la suscripción actual y cambia una sola variable cada vez. Mantén la misma suscripción al comparar una ruta mínima de recepción con la cadena que incluye el procesamiento de la aplicación. Trata los cambios de filtros como una comparación separada. Antes de restringir la suscripción, relaciona los datos de entrada de las decisiones con sus notificaciones y verifica que los filtros propuestos incluyan los eventos necesarios ya identificados. Diseña colas acotadas y paralelismo que conserven el orden y la integridad requeridos, y especifica qué ocurre si la cola se llena. No descartes silenciosamente datos necesarios. Guarda todos los detalles de los errores y los plazos para volver a intentarlo; no te reconectes durante una pausa impuesta.

7. Informa por separado de hechos observados, posibles causas, hipótesis sin comprobar, cambios revisables y mediciones antes y después. Estima CPU, RAM, ancho de banda, rendimiento de almacenamiento y ubicación a partir de la suscripción y las mediciones, incluido un margen para los picos. No inventes un requisito de hardware fijo y universal para Solana. Si hace falta, propone comparar máquinas o centros de datos con la misma suscripción, SDK y commitment.

Si uso ERPC, lee su FAQ de gRPC actual y sigue las instrucciones del código de error exacto:
https://erpc.global/en/faq/grpc/general/
Si ERPC User MCP o una CLI está conectado, verifica las operaciones y permisos realmente disponibles. Acceder a la cuenta no implica acceso al diagnóstico del host. Antes de crear un VPS de pago, cambiar un contrato, actualizar producción o reiniciarla, presenta el coste, el objetivo y la duración de la prueba y obtén mi aprobación. Completa primero el diagnóstico y las mejoras revisables.
Investiga si mi cliente Solana Geyser gRPC tiene margen para responder más rápido. Si hay retrasos, acumulaciones o desconexiones, aísla sus causas y ayuda a mejorarlos. No deduzcas que se están procesando datos actuales solo porque la conexión funciona o aparecen eventos en los registros. No decidas de antemano si la causa está en el cliente o en el proveedor.
1. Establece el objetivo: eventos necesarios, actualidad aceptable, requisitos de orden y pérdida de datos, filtros de suscripción, commitment, región del endpoint, versiones reales del lenguaje, SDK y biblioteca gRPC, y entorno de ejecución. Inspecciona primero el código, la configuración y los archivos de bloqueo disponibles; pregunta únicamente por la información que falte. Deja explícitamente sin definir los requisitos aún no decididos e investiga primero el estado actual. No muestres secretos y oculta la información sensible en los registros compartidos.
2. Mide desde la recepción hasta la finalización. Prioriza la recepción, la finalización y los tiempos de espera, empezando por lo que se pueda medir. Registra eventos/segundo, bytes/segundo, eventos completados/segundo, cantidad y bytes de la cola, espera del evento más antiguo, p50/p95/p99, errores, desconexiones, reconexiones y descartes. Si no hay una cola explícita, indícalo e identifica los intervalos de procesamiento que puedes observar. Indica los puntos de observación y los intervalos no medidos. Distingue entre tráfico de la tarjeta de red, bytes transmitidos, tamaño Protobuf y objetos decodificados. Usa un reloj monotónico para el tiempo local transcurrido; verifica la sincronización y el origen de las marcas de tiempo externas. No conviertas directamente un salto entre slots en pérdida de datos ni en una duración fija.
3. Separa las limitaciones de CPU, memoria, disco y red. Inspecciona CPU por núcleo o hilo, tiempo de CPU sustraído y límites de CPU, RSS/GC/swap/PSI, esperas de E/S, bytes/descartes/errores de la tarjeta de red, retransmisiones TCP y RTT. Algunas herramientas Linux posibles son mpstat, pidstat, vmstat, iostat, sar, ss -ti y /proc/pressure/. Si faltan herramientas o permisos, indícalo y proporciona los comandos mínimos necesarios. Si no se puede acceder al host, busca información en la consola de administración o en la instrumentación de la aplicación y marca como no medidas las magnitudes no disponibles. Nunca inventes resultados.
4. Inspecciona las ventanas HTTP/2 de flujo y conexión, los búferes de recepción TCP, proxies, VPN y sidecars. Consulta la documentación oficial de la versión instalada del SDK y considera el producto ancho de banda-retardo. Revisa la conversión JSON, el registro por evento, las llamadas síncronas a bases de datos o API externas, el trabajo bloqueante, los bloqueos, la creación ilimitada de tareas y las colas sin límite dentro del bucle de recepción o a su alrededor. No trates Rust o el código asíncrono por sí solos como una solución.
5. Cuando estén disponibles mtr o un equivalente, realiza una medición finita al host real del endpoint. En sistemas compatibles, considera: mtr --tcp --port <PORT> --report --report-cycles 30 <HOST>. Usa el puerto real en vez de suponer un puerto TLS estándar. No califiques como fallo la pérdida en un único salto intermedio; compárala con el comportamiento en destino, las retransmisiones y otras rutas. No uses mtr como sustituto de una medición de ancho de banda.
6. Registra una referencia inicial con la suscripción actual y cambia una sola variable cada vez. Mantén la misma suscripción al comparar una ruta mínima de recepción con la cadena que incluye el procesamiento de la aplicación. Trata los cambios de filtros como una comparación separada. Antes de restringir la suscripción, relaciona los datos de entrada de las decisiones con sus notificaciones y verifica que los filtros propuestos incluyan los eventos necesarios ya identificados. Diseña colas acotadas y paralelismo que conserven el orden y la integridad requeridos, y especifica qué ocurre si la cola se llena. No descartes silenciosamente datos necesarios. Guarda todos los detalles de los errores y los plazos para volver a intentarlo; no te reconectes durante una pausa impuesta.
7. Informa por separado de hechos observados, posibles causas, hipótesis sin comprobar, cambios revisables y mediciones antes y después. Estima CPU, RAM, ancho de banda, rendimiento de almacenamiento y ubicación a partir de la suscripción y las mediciones, incluido un margen para los picos. No inventes un requisito de hardware fijo y universal para Solana. Si hace falta, propone comparar máquinas o centros de datos con la misma suscripción, SDK y commitment.
Si uso ERPC, lee su FAQ de gRPC actual y sigue las instrucciones del código de error exacto:
https://erpc.global/en/faq/grpc/general/
Si ERPC User MCP o una CLI está conectado, verifica las operaciones y permisos realmente disponibles. Acceder a la cuenta no implica acceso al diagnóstico del host. Antes de crear un VPS de pago, cambiar un contrato, actualizar producción o reiniciarla, presenta el coste, el objetivo y la duración de la prueba y obtén mi aprobación. Completa primero el diagnóstico y las mejoras revisables.Prueba el mismo código en un entorno comparable
Las mediciones pueden revelar oportunidades para mejorar los recursos de CPU o memoria, o la ruta de red. Una CPU más potente, más memoria, dividir el trabajo o situarse más cerca del origen son opciones posibles. Relacionar esas decisiones con el volumen de datos de tu aplicación y las observaciones aclara tanto el motivo para probarlas como el efecto que conviene verificar.
ERPC VPS es una opción para ejecutar clientes de streaming cerca de la infraestructura de Solana. La facturación por horas permite comparar el mismo código y la misma suscripción con tu entorno actual. Consulta los precios, las regiones y la disponibilidad vigentes en el Dashboard. También en ERPC, las necesidades de recursos dependen de tu suscripción y del procesamiento de la aplicación.[7]
Compara el crecimiento de la cola, la actualidad al terminar el procesamiento, p99 y errores, además de la tasa de recepción. Registra el periodo de medición y la carga de la cadena. Las comparaciones simultáneas o las mediciones repetidas ayudan a no confundir los cambios de tráfico a lo largo del tiempo con diferencias entre entornos.
Para solicitar soporte, comparte la configuración de suscripción con los datos sensibles ocultos, la versión del SDK, la región, las marcas de tiempo, los mensajes de error completos y las mediciones que tengas. Puedes señalar como no medidos los valores que aún no hayas obtenido.
Cada nueva observación facilita elegir el siguiente cambio que probar. Conserva los datos que necesitas y comprueba las mejoras paso a paso. Seguiremos mejorando la información y la infraestructura que apoyan tu desarrollo.
Referencias y enlaces relacionados
- [1] gRPC Flow Control: https://grpc.io/docs/guides/flow-control/
- [2] Especificación de suscripciones de Yellowstone gRPC: https://github.com/rpcpool/yellowstone-grpc/blob/master/README.md
- [3] Tokio: CPU-bound tasks and blocking code: https://docs.rs/tokio/latest/tokio/index.html#cpu-bound-tasks-and-blocking-code
- [4] Control de flujo HTTP/2: https://www.rfc-editor.org/rfc/rfc9113.html#section-5.2
- [5] Terminología de Solana: https://solana.com/docs/references/terminology
- [6] Documentación oficial de mtr: https://github.com/traviscross/mtr
- [7] ERPC VPS: https://erpc.global/es/vps/
- Linux PSI: https://docs.kernel.org/accounting/psi.html
- API de medición de Node.js: https://nodejs.org/api/perf_hooks.html
- ERPC gRPC FAQ: https://erpc.global/es/faq/grpc/general/
- ERPC Web Dashboard: https://dashboard.erpc.global/es/
- Discord oficial de Validators DAO: https://discord.gg/C7ZQSrCkYR


