Architecture à faible latence pour le HFT sur Solana
Les données arrivent, mais les prix utilisés par votre application pour prendre ses décisions sont encore périmés. Dans une application de HFT sur Solana, il faut examiner le temps de calcul et le temps pendant lequel les données reçues attendent avant de contribuer à une décision. Des mises à jour précédentes peuvent encore attendre leur traitement, une écriture de journal peut être inachevée, ou la mise à jour d'un autre marché peut détenir un verrou. La façon dont vous organisez le code modifie ces attentes.
Cet article présente cinq modèles pour suivre les endroits où les données attendent et le travail qui peut avancer lorsque la conception change. Vous pouvez aussi partir du symptôme qui correspond à votre application et consulter directement la section concernée.
| Ce qui se passe dans l'application | La conception à examiner |
|---|---|
| Les données non traitées s'accumulent à mesure que l'application fonctionne | 1. Débit d'arrivée, débit de traitement et limites d'attente |
| Le prix suivant ne peut pas être traité pendant la sauvegarde d'un enregistrement | 2. Séparation du travail nécessaire aux décisions et de la journalisation analytique |
| Une mise à jour du marché A fait attendre celle du marché B | 3. Division des verrous qui protègent des états indépendants |
| La même préparation est répétée à chaque arrivée | 4. Préparation anticipée et réutilisation des parties inchangées |
| Les décisions utilisent d'anciennes valeurs même après le rétablissement de la connexion | 5. Distinction entre retour de la connexion et restauration de l'état utilisé pour décider |
Chaque section se termine par des instructions à copier pour appliquer l'amélioration correspondante à votre application. Confiez-les à un agent d'IA capable de lire le code de votre projet.
Les quantités, les prix, les nombres d'opérations et les durées des schémas sont des modèles explicatifs. Ils ne représentent ni des performances mesurées ni des résultats de trading.
Appuyez ou cliquez sur un schéma pour ouvrir l’image en taille réelle.
1. Comparez les arrivées à la capacité de traitement et limitez les attentes
Prenons une application qui reçoit six événements et peut en traiter deux durant chaque intervalle de même durée. À la fin du premier intervalle, quatre événements restent non traités. Une file d'attente est l'endroit où les données attendent leur traitement.
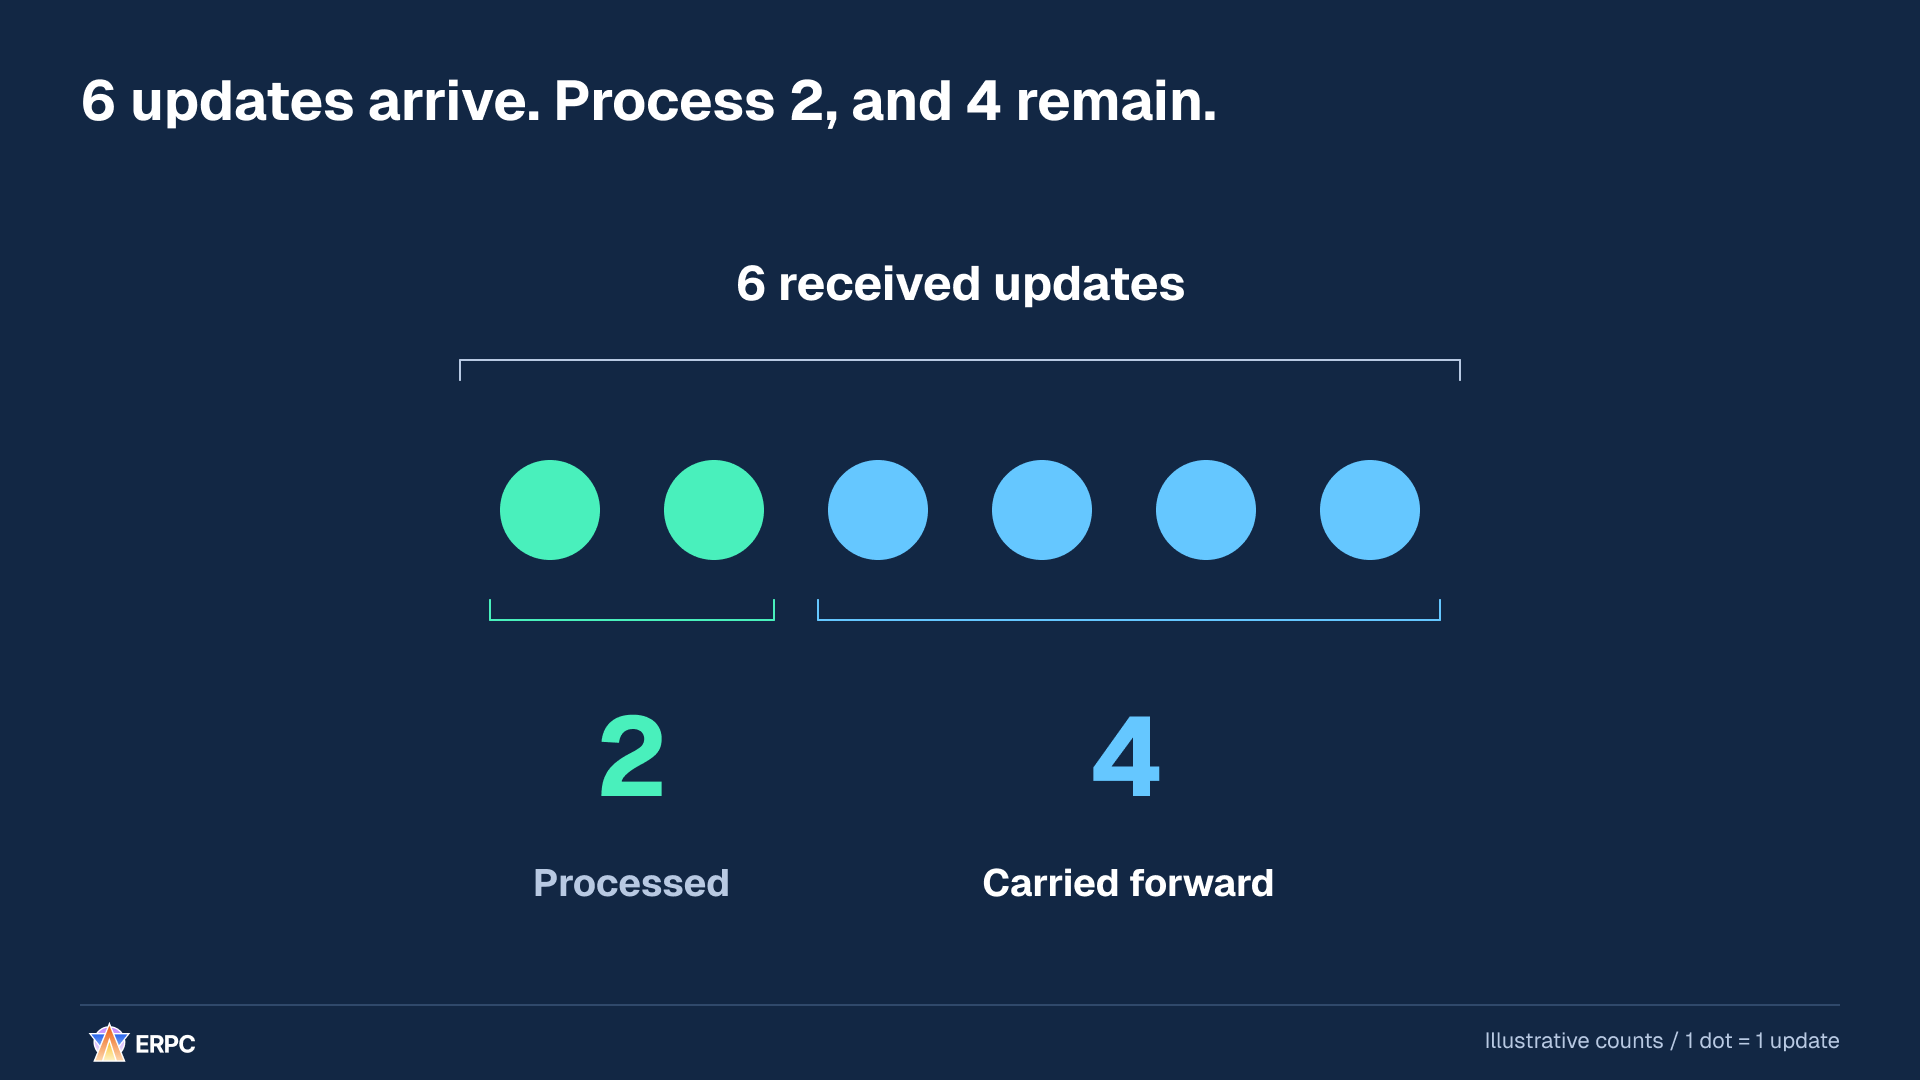
Le traitement avance, mais quatre événements n'ont pas encore servi aux décisions.
Appliquons maintenant la même proportion à 60 000 événements reçus. En traiter 20 000 en laisse 40 000 en attente. À droite du schéma, chaque point représente 100 événements et chaque groupe de 100 points représente 10 000 événements. Deux groupes sont traités et quatre attendent encore.
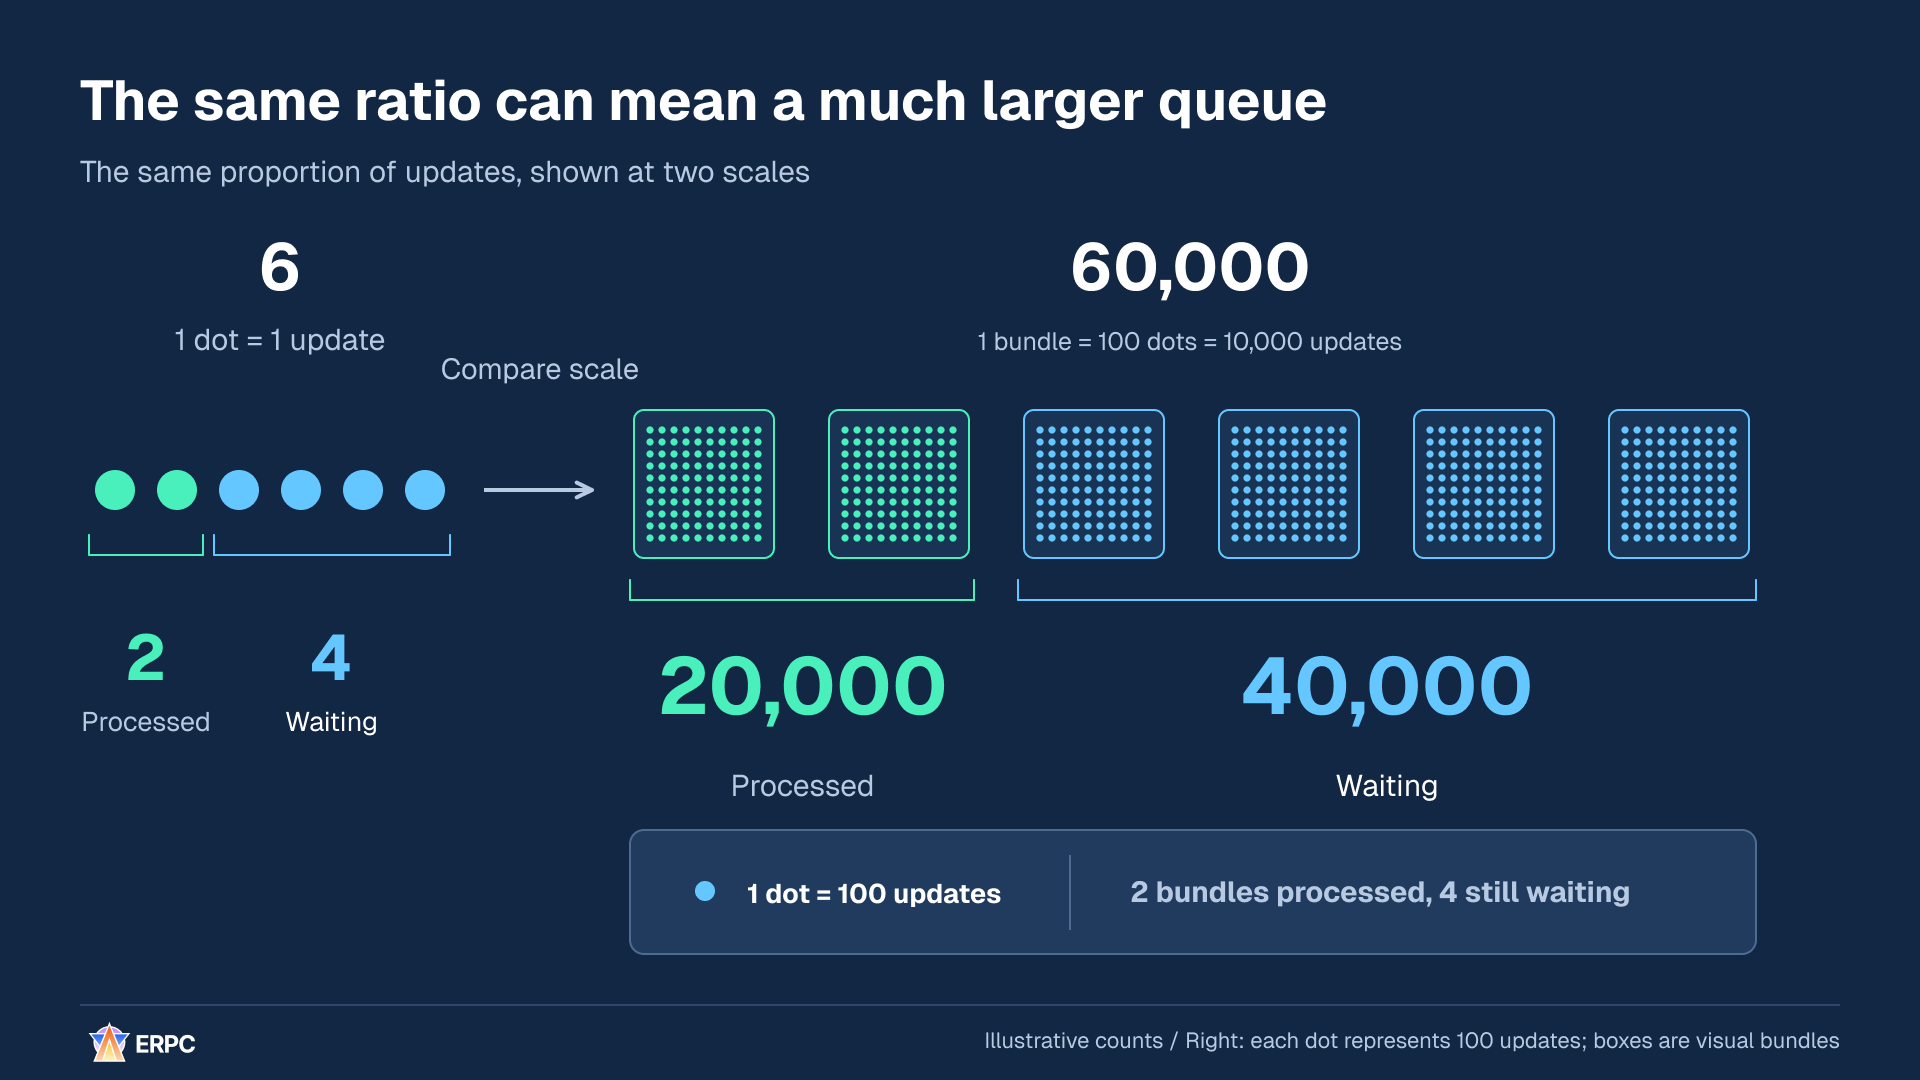
Les groupes de droite servent à visualiser le volume. Ils ne représentent pas des lots traités ensemble par l'application.
L'intervalle suivant commence avec 40 000 événements déjà en attente. Il en arrive 60 000 de plus et 20 000 sont traités : il en reste donc 80 000. L'intervalle suivant se termine avec 120 000 événements. Les nouveaux prix doivent attendre derrière le travail déjà présent dans la file.
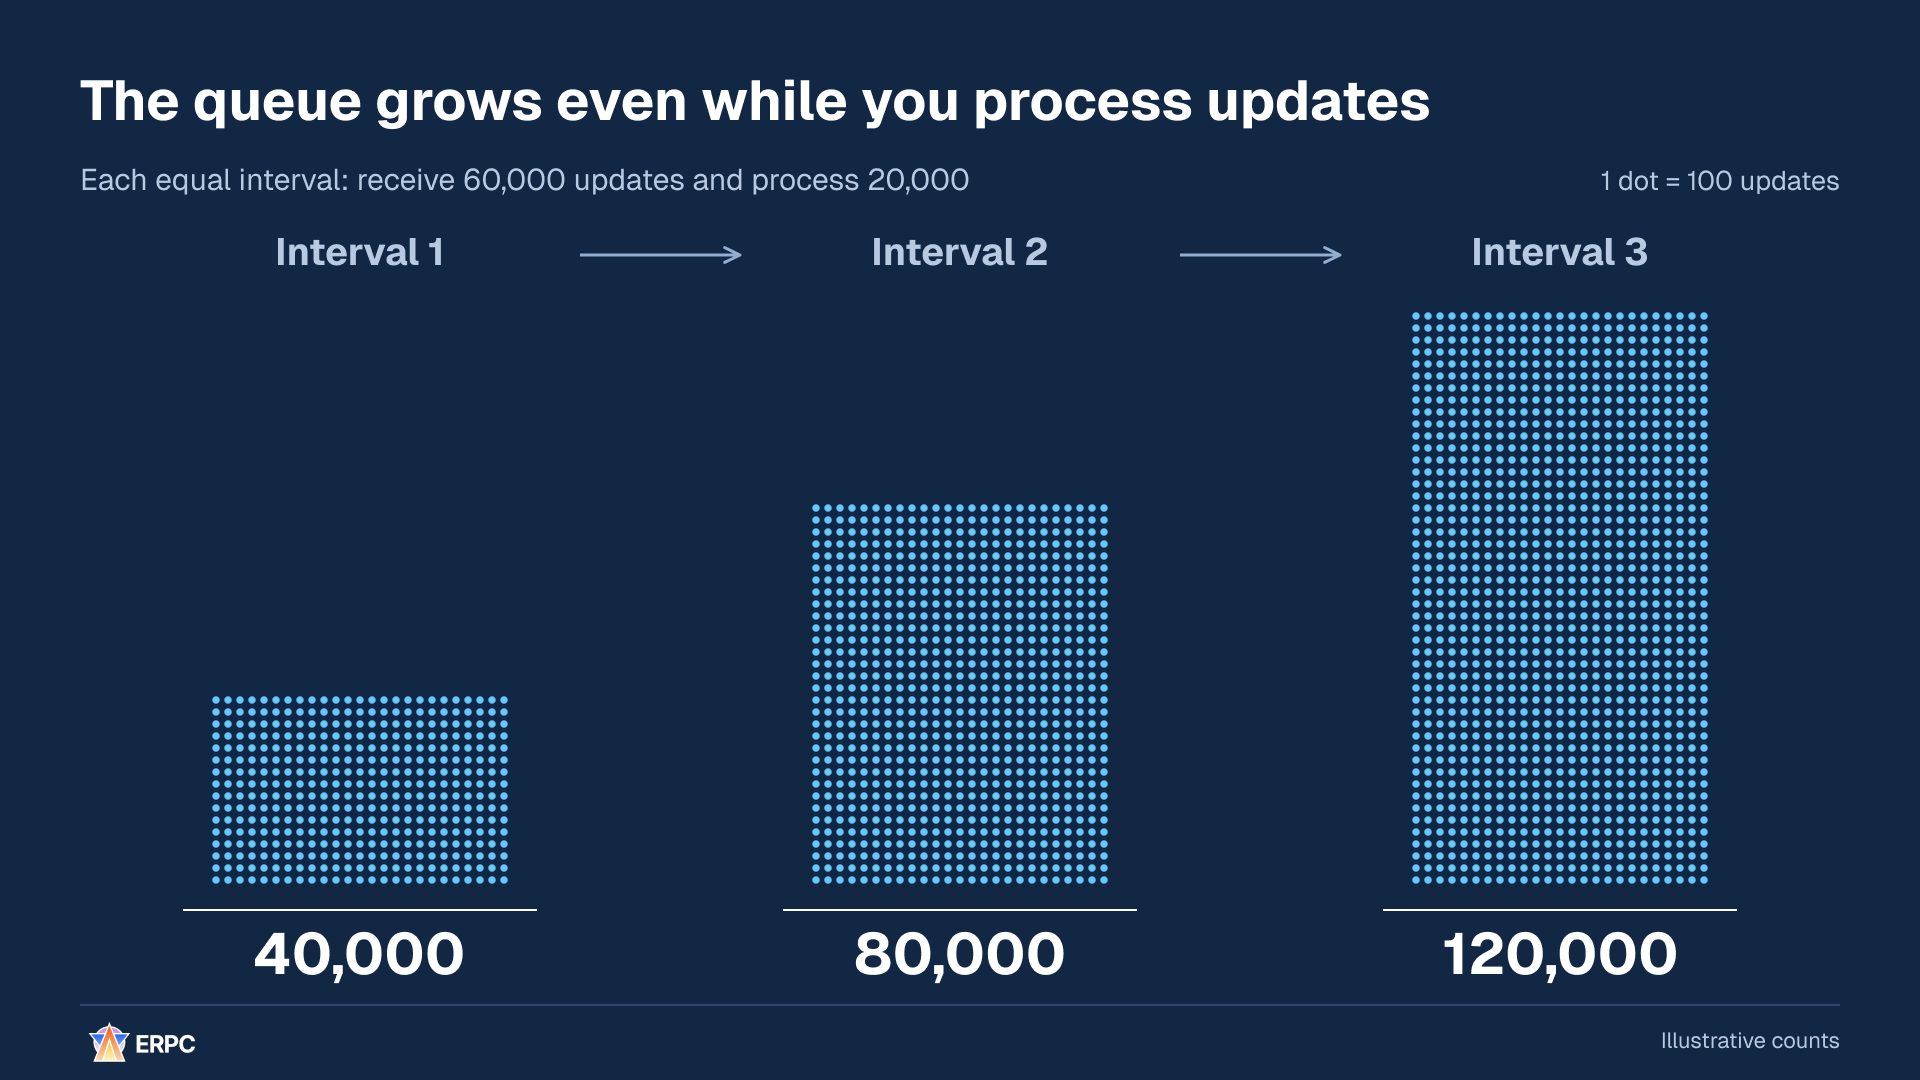
Lorsque les arrivées continuent de dépasser la capacité de traitement, le retard continue de s'accumuler.
Une file aide à absorber les pics, ces courtes périodes où les arrivées sont concentrées. Augmenter sa capacité ne résout pas un déficit durable de traitement comme celui de cet exemple. Outre le nombre d'éléments et d'octets conservés, mesurez depuis combien de temps le plus ancien élément attend et fixez une limite acceptable. Si la fraîcheur requise n'est plus respectée, suspendez les nouvelles décisions de trading qui dépendent de ces valeurs, même si aucune mise à jour n'a été perdue.
Que doit-il se passer lorsque cette limite est atteinte ? Dans le schéma suivant, les huit emplacements disponibles sont occupés quand deux nouvelles mises à jour arrivent. Si elles ne peuvent pas être conservées et sont nécessaires à une décision, l'application ne peut plus actualiser correctement ses valeurs stockées. Suspendez les nouvelles décisions de trading qui dépendent de ces valeurs et reprenez après avoir récupéré les mises à jour nécessaires.
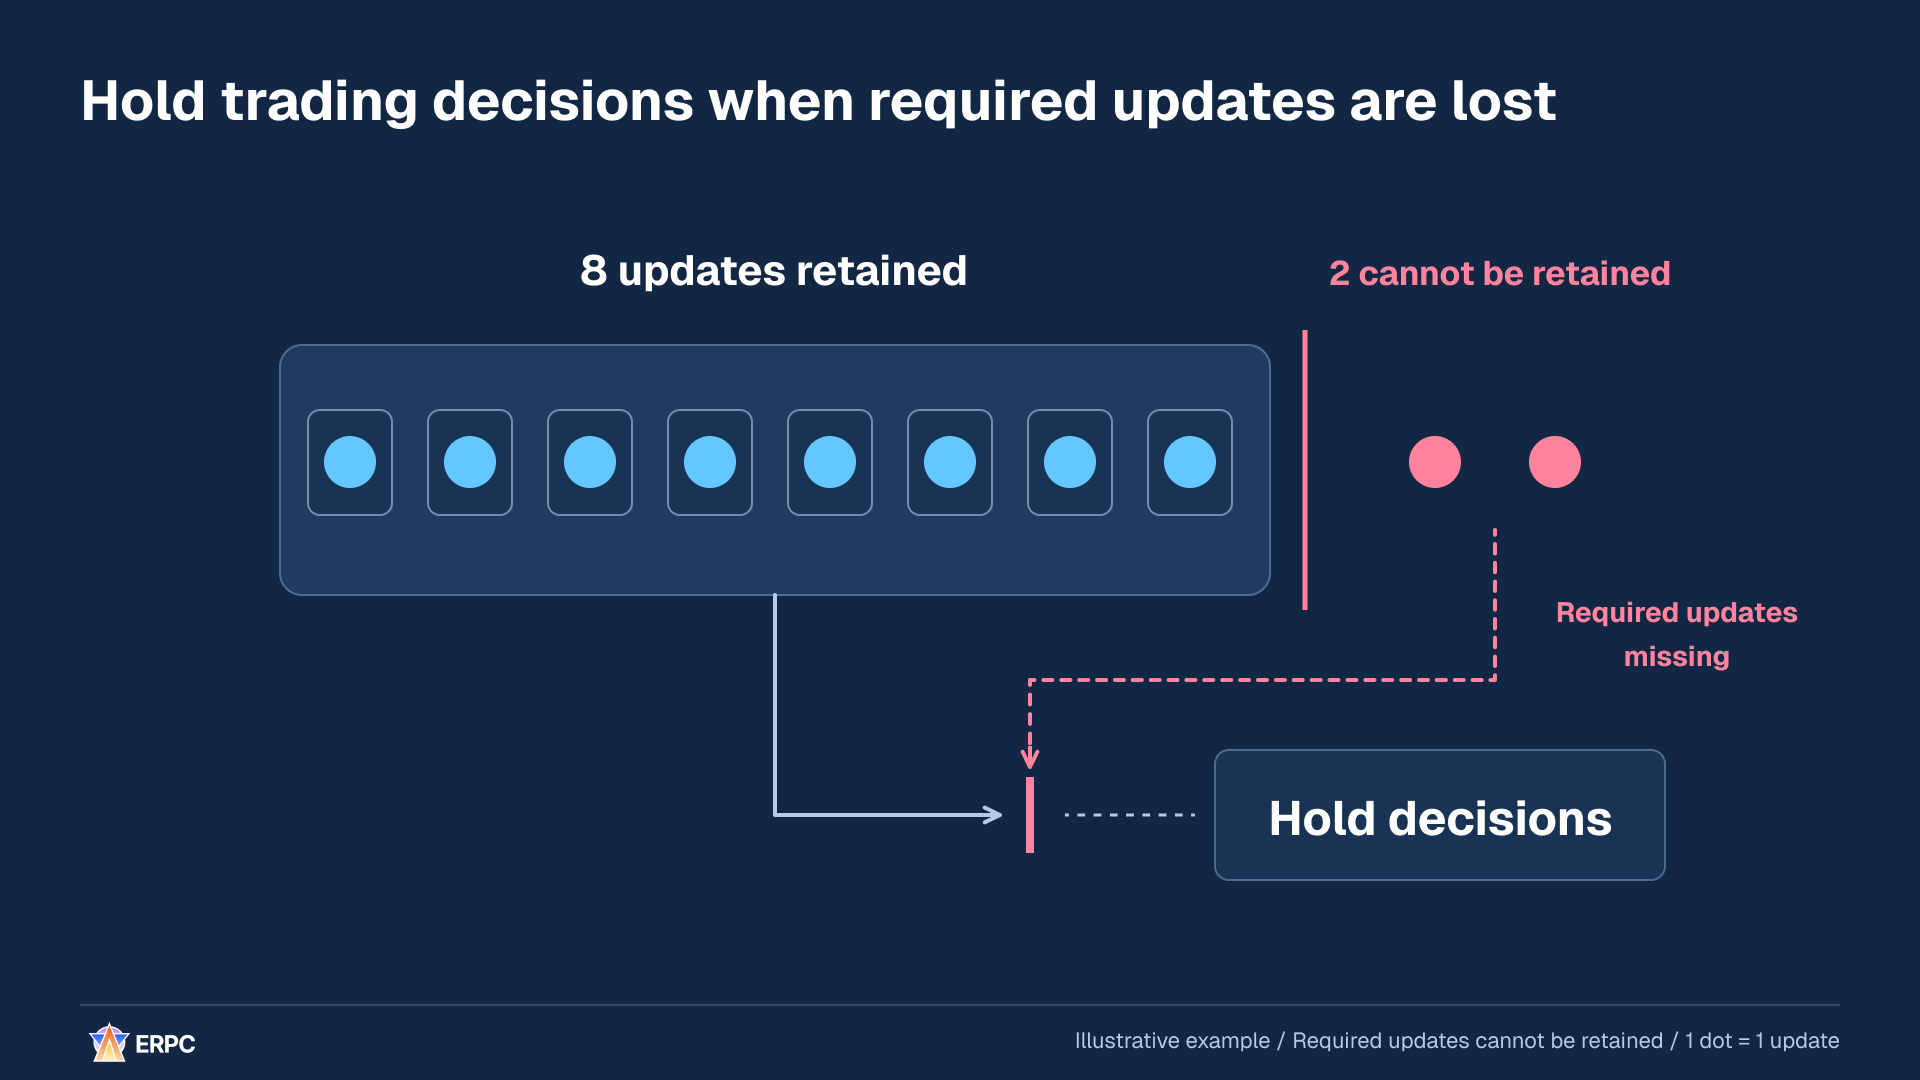
La conception d'une file doit aussi définir ce qui se passe après avoir atteint sa limite.
Examinez si vous pouvez réduire le travail ou augmenter la capacité de traitement. Si un consommateur n'a besoin que du dernier état complet d'une même entité, il est parfois possible de regrouper les valeurs intermédiaires pour ne conserver que la plus récente. En revanche, pour un traitement qui cumule des différences ou utilise les événements intermédiaires, omettre des mises à jour change le résultat.
Suspendre la réception peut aussi déplacer l'attente vers l'amont. Considérez ensemble le contrôle de flux gRPC, qui régule le rythme d'envoi et de réception, les filtres côté serveur qui limitent les données auxquelles vous êtes abonné, et la capacité réelle de traitement de l'application.[3][4]
Pour améliorer la capacité de la file de réception et la fraîcheur des données de votre application, copiez ces instructions.
text
Améliore la gestion des données entrantes de cette application lorsque le traitement prend du retard et que les données utilisées pour décider deviennent périmées.

Lis le README, les consignes de développement, les dépendances et le code réception → file → mise à jour de l'état → décision. Travaille avec le langage, l'environnement d'exécution et le SDK existants. Détermine si les mises à jour contiennent un état complet ou des deltas, leur ordre d'application requis et les exigences de fraîcheur.

1. Conserve des entrées reproductibles sans informations confidentielles et relève la situation initiale. Examine aussi l'attente avant l'entrée dans la file. Mesure sur le même intervalle les nombres d'éléments et d'octets entrants et sortants, le travail en attente, l'âge du plus ancien élément en attente et le travail en cours.
2. Définis et implémente des limites sur le nombre d'éléments, les octets, le temps d'attente et la concurrence, en justifiant chacune. Explicite les hypothèses lorsque les exigences sont inconnues. Vérifie s'il est possible de réduire la réception ou le traitement inutiles et si la capacité de traitement suffit. Ne considère pas l'agrandissement de la file, à lui seul, comme une solution à un déficit de traitement durable.
3. Définis le comportement lorsque la file est pleine. Si les mises à jour nécessaires ne peuvent pas être conservées, ou si la fraîcheur requise est perdue même sans mises à jour manquantes, suspends les nouvelles décisions de trading qui dépendent de ces valeurs. Poursuis les mises à jour et la restauration de l'état, puis vérifie les conditions de reprise.
4. Si des valeurs intermédiaires sont regroupées, établis que le dernier état complet de la même entité suffit pour préserver le résultat. Ne supprime pas silencieusement des deltas ou événements nécessaires. Si la réception est suspendue, vérifie le contrôle de flux du fournisseur et l'endroit vers lequel l'attente se déplace.
5. Rejoue dans des conditions identiques les entrées normales, les rafales, une surcharge durable et la récupération après saturation de la file. Compare les débits d'arrivée et de traitement, l'âge du plus ancien élément, les p50/p95/p99 entre réception et fin de décision, le CPU et la mémoire, ainsi que les mises à jour manquantes ou supprimées. Compare l'état appliqué et les décisions aux résultats attendus. Utilise une horloge monotone pour les durées à l'intérieur d'un hôte et indique les bornes de mesure.

Respecte les approbations, autorisations et procédures de développement existantes. Ces instructions seules n'accordent aucune autorisation supplémentaire de modifier la production, de souscrire des contrats payants ou d'effectuer des transactions réelles. N'affiche pas de clés privées, d'identifiants d'accès ou de données clients.

Présente les changements, les conditions de comparaison, les mesures avant et après, les contrôles de correction et les limites restantes. Signale comme non mesurées les valeurs qui ne peuvent pas être mesurées.
Améliore la gestion des données entrantes de cette application lorsque le traitement prend du retard et que les données utilisées pour décider deviennent périmées.
Lis le README, les consignes de développement, les dépendances et le code réception → file → mise à jour de l'état → décision. Travaille avec le langage, l'environnement d'exécution et le SDK existants. Détermine si les mises à jour contiennent un état complet ou des deltas, leur ordre d'application requis et les exigences de fraîcheur.
1. Conserve des entrées reproductibles sans informations confidentielles et relève la situation initiale. Examine aussi l'attente avant l'entrée dans la file. Mesure sur le même intervalle les nombres d'éléments et d'octets entrants et sortants, le travail en attente, l'âge du plus ancien élément en attente et le travail en cours.
2. Définis et implémente des limites sur le nombre d'éléments, les octets, le temps d'attente et la concurrence, en justifiant chacune. Explicite les hypothèses lorsque les exigences sont inconnues. Vérifie s'il est possible de réduire la réception ou le traitement inutiles et si la capacité de traitement suffit. Ne considère pas l'agrandissement de la file, à lui seul, comme une solution à un déficit de traitement durable.
3. Définis le comportement lorsque la file est pleine. Si les mises à jour nécessaires ne peuvent pas être conservées, ou si la fraîcheur requise est perdue même sans mises à jour manquantes, suspends les nouvelles décisions de trading qui dépendent de ces valeurs. Poursuis les mises à jour et la restauration de l'état, puis vérifie les conditions de reprise.
4. Si des valeurs intermédiaires sont regroupées, établis que le dernier état complet de la même entité suffit pour préserver le résultat. Ne supprime pas silencieusement des deltas ou événements nécessaires. Si la réception est suspendue, vérifie le contrôle de flux du fournisseur et l'endroit vers lequel l'attente se déplace.
5. Rejoue dans des conditions identiques les entrées normales, les rafales, une surcharge durable et la récupération après saturation de la file. Compare les débits d'arrivée et de traitement, l'âge du plus ancien élément, les p50/p95/p99 entre réception et fin de décision, le CPU et la mémoire, ainsi que les mises à jour manquantes ou supprimées. Compare l'état appliqué et les décisions aux résultats attendus. Utilise une horloge monotone pour les durées à l'intérieur d'un hôte et indique les bornes de mesure.
Respecte les approbations, autorisations et procédures de développement existantes. Ces instructions seules n'accordent aucune autorisation supplémentaire de modifier la production, de souscrire des contrats payants ou d'effectuer des transactions réelles. N'affiche pas de clés privées, d'identifiants d'accès ou de données clients.
Présente les changements, les conditions de comparaison, les mesures avant et après, les contrôles de correction et les limites restantes. Signale comme non mesurées les valeurs qui ne peuvent pas être mesurées.2. Traitez le prix suivant sans attendre la sauvegarde d'un enregistrement
Prenons un prix de marché qui passe de 100 à 101. L'application a appliqué 100, terminé sa décision et enregistre maintenant une trace analytique. Si la boucle qui traite les données reçues attend la fin de cette sauvegarde, elle ne peut pas appliquer 101, même lorsque la mise à jour arrive. Le prix stocké reste 100.
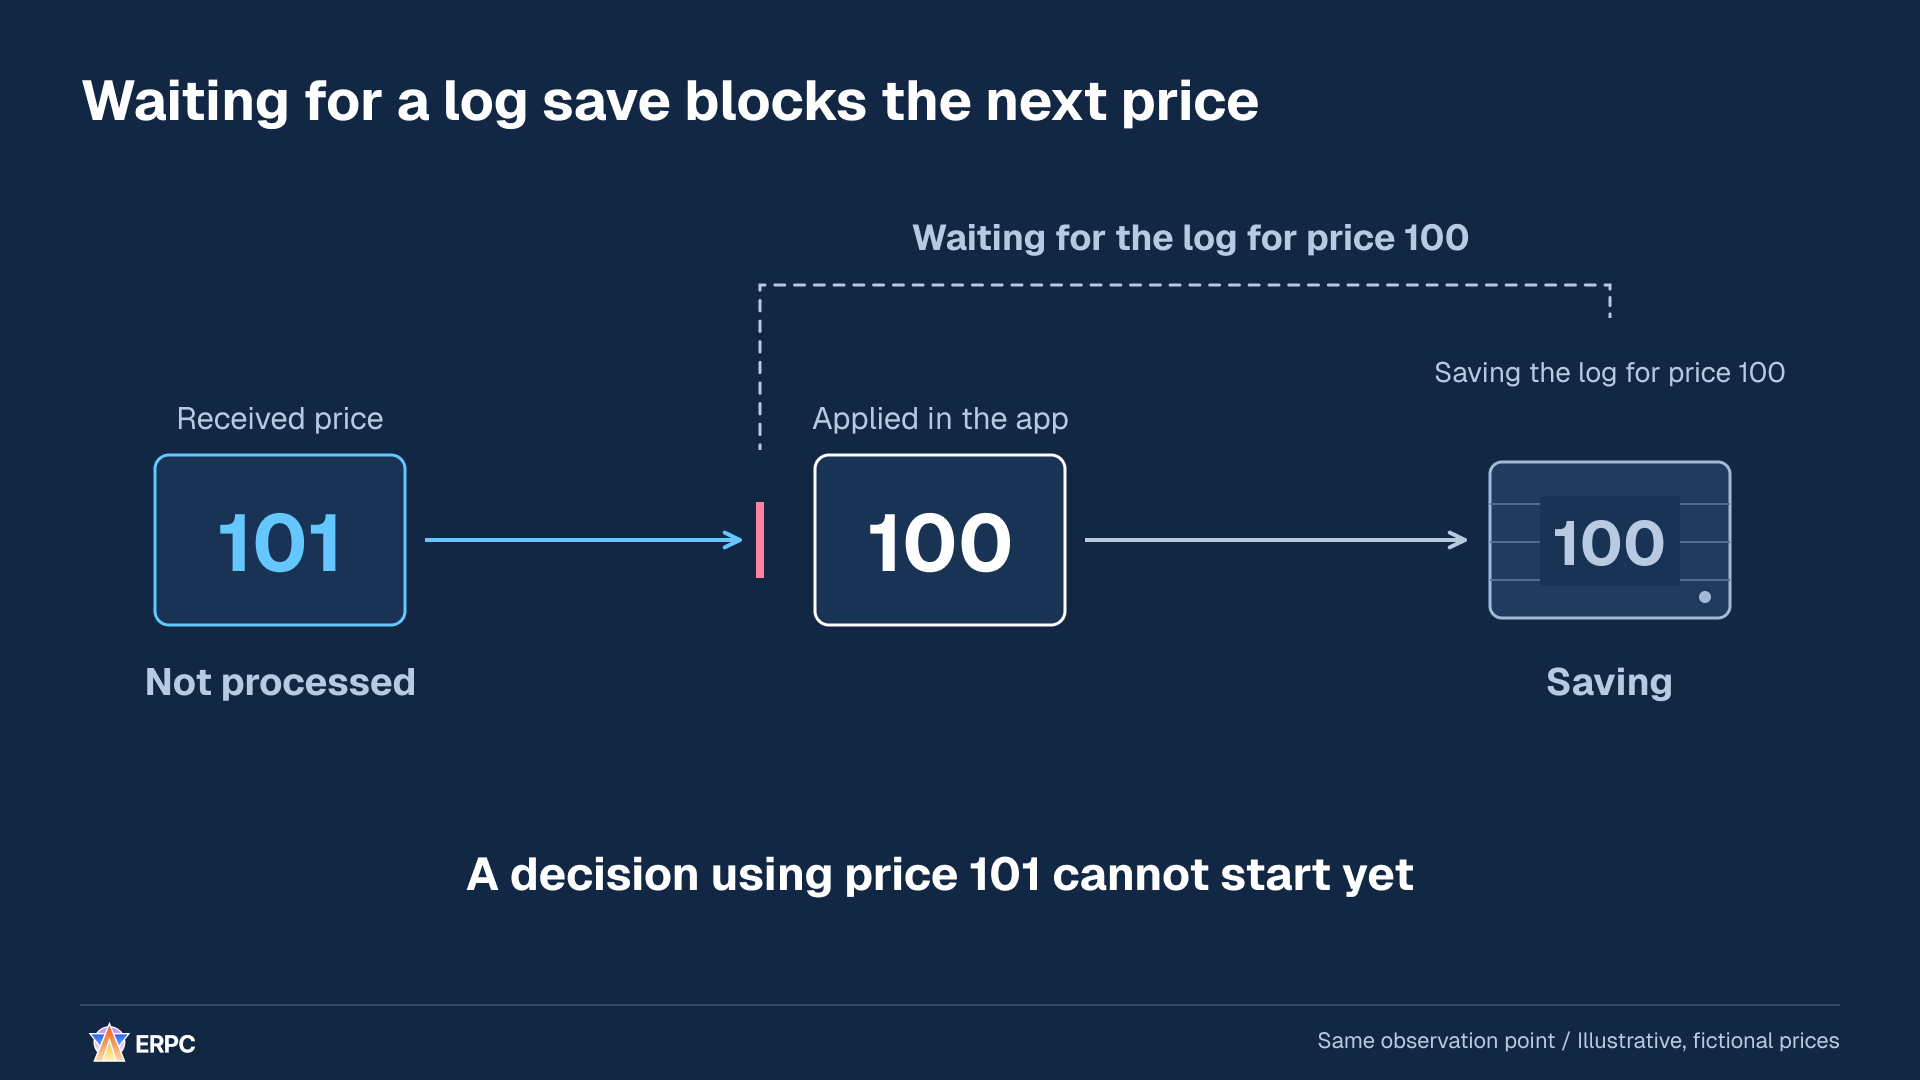
Le traitement de 101 ne peut pas commencer parce qu'il attend l'enregistrement de 100.
Transmettez maintenant la trace analytique à une file auxiliaire disposant de place et confiez la sauvegarde à une opération séparée. La boucle de réception peut revenir à l'entrée suivante dès que le transfert est terminé. Elle peut appliquer 101 et prendre une décision pendant que la sauvegarde de 100 se poursuit.
La comparaison suivante conserve la même durée de sauvegarde pour 100, le même instant d'arrivée pour 101 et la même durée de traitement de 101. Ce qui change, c'est la dépendance entre le passage à l'entrée suivante et la fin de la sauvegarde.
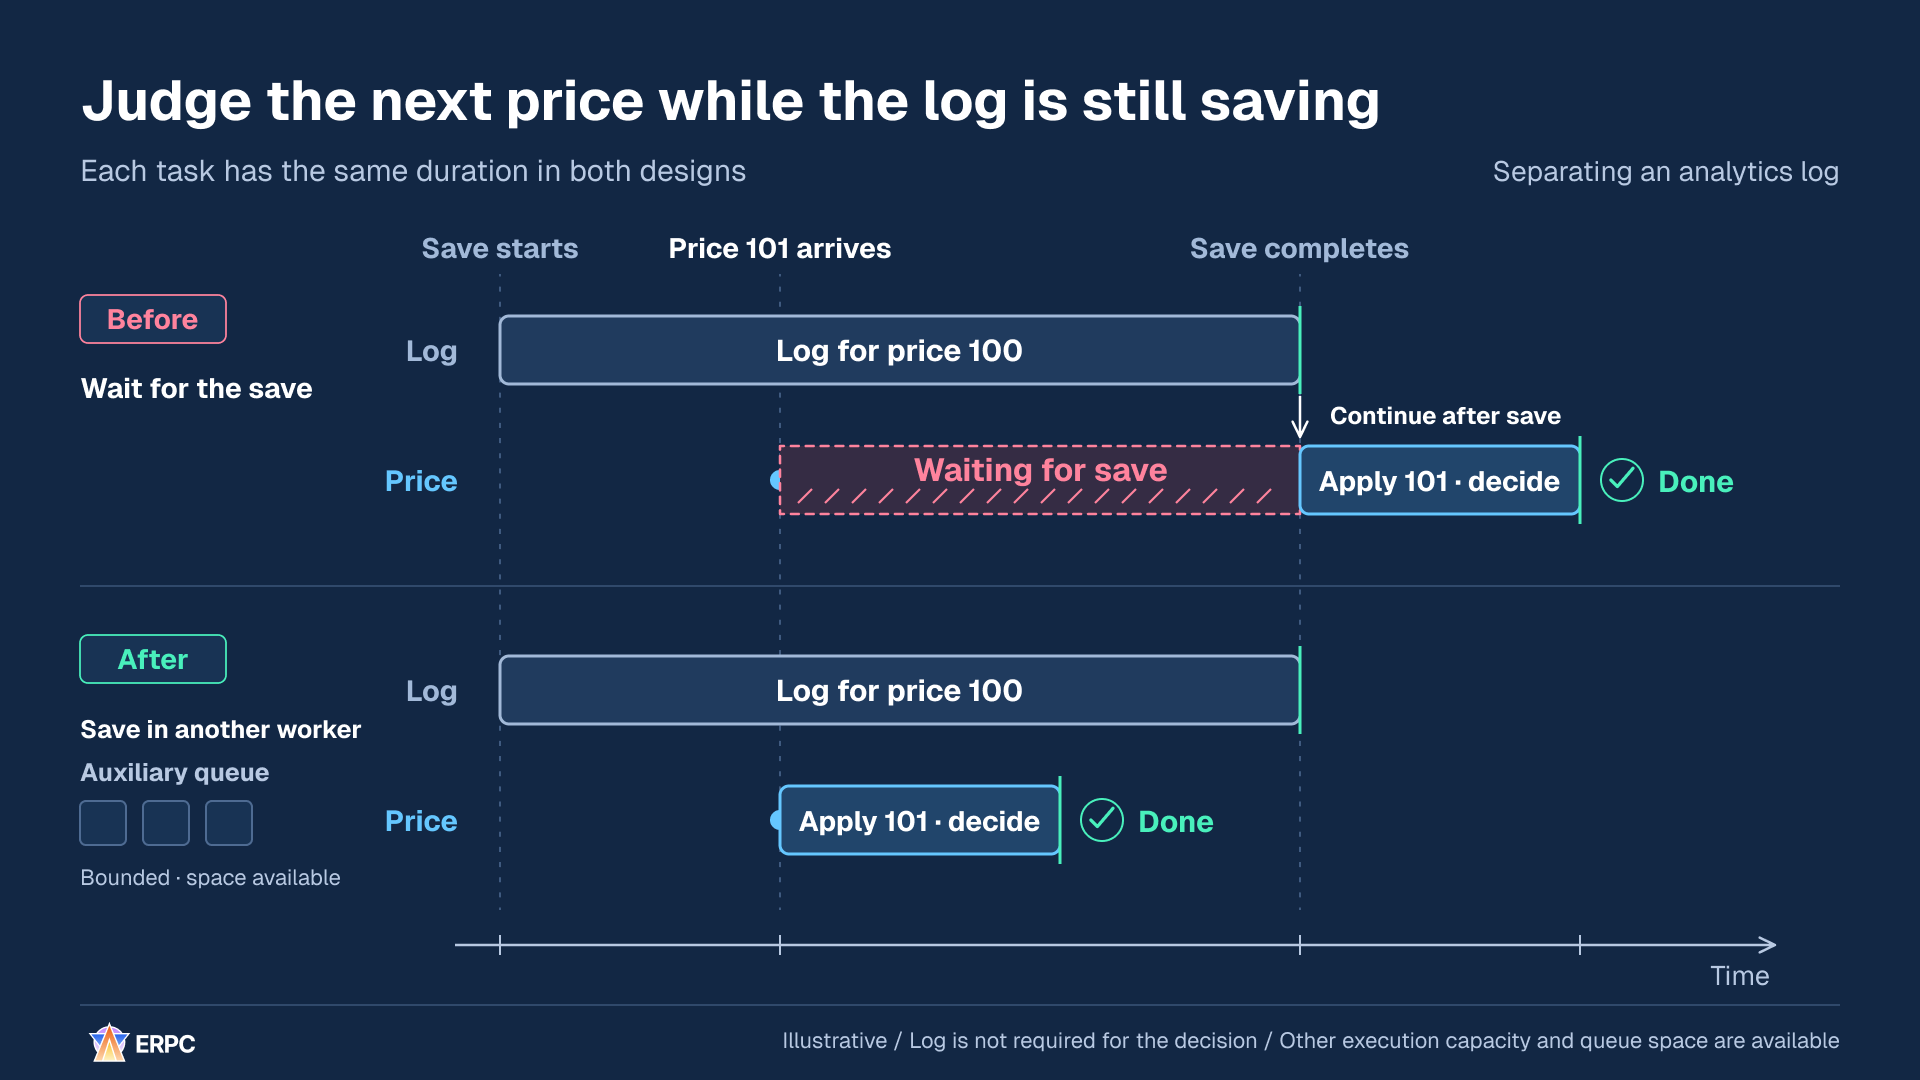
Même sans raccourcir le travail sur 101 lui-même, vous pouvez réduire l'attente avant son démarrage.
Le chemin de traitement nécessaire entre la réception, la décision et la soumission est appelé hot path. Dans cet exemple, la journalisation analytique qui n'a pas besoin de retarder la décision est déplacée hors de ce chemin. Les contrôles de solde, les vérifications des limites de risque et les sauvegardes dont l'achèvement est nécessaire à la correction restent aux endroits imposés par les exigences.
Le travail de sauvegarde existe toujours : la file auxiliaire a donc aussi besoin de limites de capacité et d'attente. Une tâche distincte ne s'exécute pas forcément sur un processeur distinct. Des opérations longues et intensives en calcul ou bloquantes dans Tokio, ainsi que de longues opérations synchrones sur la boucle événementielle de Node.js, peuvent empêcher d'autres tâches de progresser. Lorsque vous déplacez du travail, vérifiez où il sera réellement exécuté.[1][2]
Pour séparer l'écriture des journaux analytiques du chemin de décision, copiez ces instructions.
text
Améliore cette application lorsque l'attente de la sauvegarde des enregistrements analytiques empêche d'appliquer la mise à jour suivante ou de l'utiliser pour décider.

Lis le README, les consignes de développement, les dépendances et la boucle de réception. Travaille avec le langage, l'environnement d'exécution et la bibliothèque de stockage existants. Repère les attentes de fin de sauvegarde et identifie les threads, tâches ou boucles d'événements dans lesquels le travail s'exécute réellement.

1. Prépare des entrées reproductibles sans informations confidentielles. Relève la réception, l'application de l'état, le début et la fin de la décision, le début et la fin de la sauvegarde, ainsi que les résultats actuels.
2. Détermine à partir des exigences si la fin de la sauvegarde est une condition préalable aux décisions ou à la récupération. Conserve les contrôles de solde, de risque et la persistance nécessaire à la correction aux endroits où ils sont requis. Sépare les enregistrements analytiques dont la sauvegarde peut se terminer plus tard.
3. Définis le transfert des enregistrements afin que les modifications ultérieures de l'état ne changent pas les valeurs enregistrées. Implémente une file auxiliaire bornée et un consommateur chargé de la sauvegarde. Précise les limites d'éléments, d'octets et d'attente, le comportement en cas de file pleine, d'échec de sauvegarde, de nouvelle tentative ou d'arrêt, ainsi que les exigences de conservation. Ne supprime pas d'enregistrements tant que ces exigences restent inconnues.
4. Ne suppose pas qu'une tâche séparée s'exécute sur un autre CPU. Vérifie où s'exécutent les entrées-sorties synchrones et les longs traitements CPU. Si des workers ou des mécanismes similaires sont utilisés, limite la concurrence et inclus dans l'évaluation la conversion, la copie et l'attente du transfert.
5. Avec les mêmes entrées et le même rythme d'arrivée, reproduis des sauvegardes normales, lentes ou en échec, une file auxiliaire pleine et l'arrêt. Compare les p50/p95/p99 entre réception et fin de décision, l'attente et l'accumulation côté sauvegarde, le CPU et la mémoire, ainsi que les enregistrements manquants ou dupliqués. Vérifie la correction de l'état et des décisions ainsi que les exigences de conservation des enregistrements. Utilise une horloge monotone pour les durées à l'intérieur d'un hôte et indique les bornes de mesure.

Respecte les approbations, autorisations et procédures de développement existantes. Ces instructions seules n'accordent aucune autorisation supplémentaire de modifier la production, de souscrire des contrats payants ou d'effectuer des transactions réelles. N'affiche pas de clés privées, d'identifiants d'accès ou de données clients.

Présente les changements, les conditions de comparaison, les mesures avant et après, les contrôles de correction et les limites restantes. Signale comme non mesurées les valeurs qui ne peuvent pas être mesurées.
Améliore cette application lorsque l'attente de la sauvegarde des enregistrements analytiques empêche d'appliquer la mise à jour suivante ou de l'utiliser pour décider.
Lis le README, les consignes de développement, les dépendances et la boucle de réception. Travaille avec le langage, l'environnement d'exécution et la bibliothèque de stockage existants. Repère les attentes de fin de sauvegarde et identifie les threads, tâches ou boucles d'événements dans lesquels le travail s'exécute réellement.
1. Prépare des entrées reproductibles sans informations confidentielles. Relève la réception, l'application de l'état, le début et la fin de la décision, le début et la fin de la sauvegarde, ainsi que les résultats actuels.
2. Détermine à partir des exigences si la fin de la sauvegarde est une condition préalable aux décisions ou à la récupération. Conserve les contrôles de solde, de risque et la persistance nécessaire à la correction aux endroits où ils sont requis. Sépare les enregistrements analytiques dont la sauvegarde peut se terminer plus tard.
3. Définis le transfert des enregistrements afin que les modifications ultérieures de l'état ne changent pas les valeurs enregistrées. Implémente une file auxiliaire bornée et un consommateur chargé de la sauvegarde. Précise les limites d'éléments, d'octets et d'attente, le comportement en cas de file pleine, d'échec de sauvegarde, de nouvelle tentative ou d'arrêt, ainsi que les exigences de conservation. Ne supprime pas d'enregistrements tant que ces exigences restent inconnues.
4. Ne suppose pas qu'une tâche séparée s'exécute sur un autre CPU. Vérifie où s'exécutent les entrées-sorties synchrones et les longs traitements CPU. Si des workers ou des mécanismes similaires sont utilisés, limite la concurrence et inclus dans l'évaluation la conversion, la copie et l'attente du transfert.
5. Avec les mêmes entrées et le même rythme d'arrivée, reproduis des sauvegardes normales, lentes ou en échec, une file auxiliaire pleine et l'arrêt. Compare les p50/p95/p99 entre réception et fin de décision, l'attente et l'accumulation côté sauvegarde, le CPU et la mémoire, ainsi que les enregistrements manquants ou dupliqués. Vérifie la correction de l'état et des décisions ainsi que les exigences de conservation des enregistrements. Utilise une horloge monotone pour les durées à l'intérieur d'un hôte et indique les bornes de mesure.
Respecte les approbations, autorisations et procédures de développement existantes. Ces instructions seules n'accordent aucune autorisation supplémentaire de modifier la production, de souscrire des contrats payants ou d'effectuer des transactions réelles. N'affiche pas de clés privées, d'identifiants d'accès ou de données clients.
Présente les changements, les conditions de comparaison, les mesures avant et après, les contrôles de correction et les limites restantes. Signale comme non mesurées les valeurs qui ne peuvent pas être mesurées.3. Ne faites pas attendre des mises à jour indépendantes sur le même verrou
Prenons une application capable d'actualiser indépendamment les prix des marchés A et B. Une mise à jour de B arrive après le début de celle de A. Si un même mutex protège A et B, B doit attendre que A libère ce verrou.
Un mutex accorde à une seule opération à la fois le droit d'accéder aux données protégées. Si une autre opération l'utilise, celle qui tente d'obtenir le même verrou doit attendre.[17]
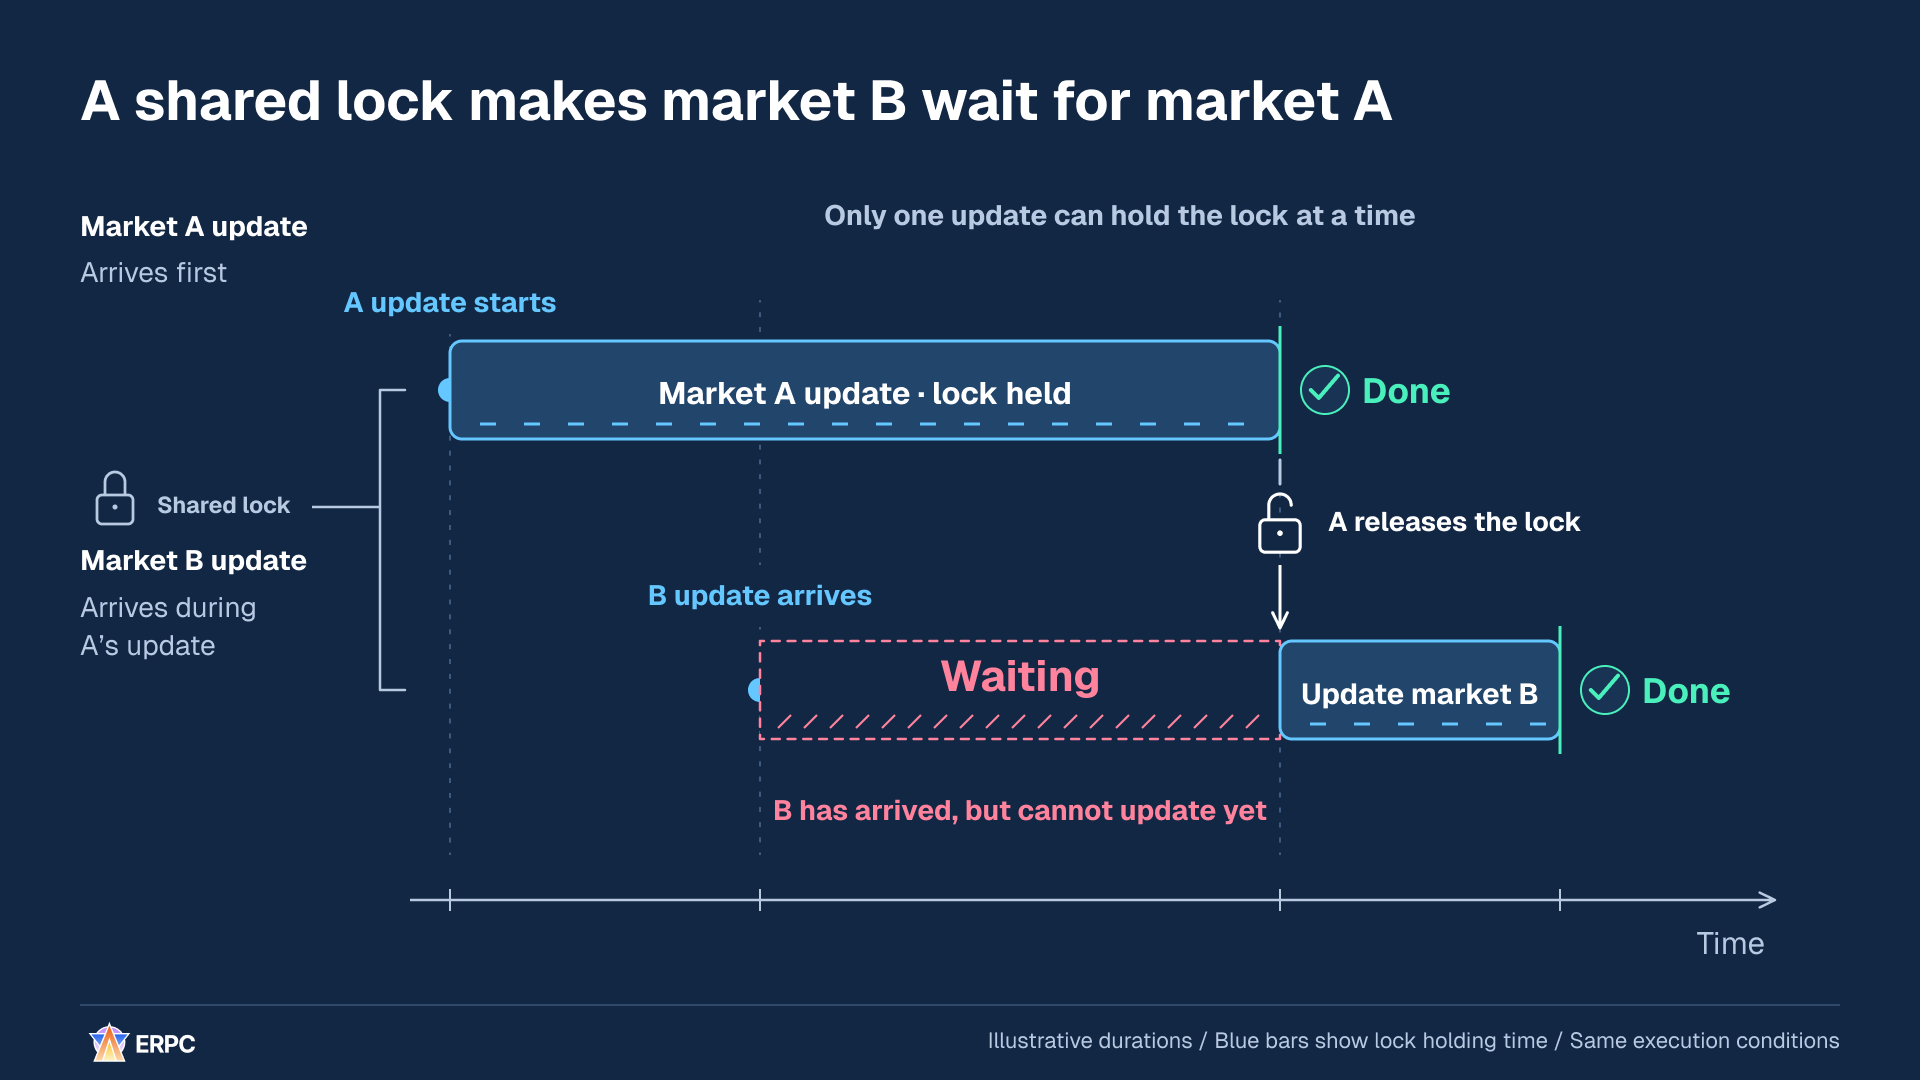
Les données de B sont arrivées, mais elles attendent le verrou partagé détenu par A.
Si A et B modifient chacun des valeurs distinctes, une possibilité consiste à les protéger par des verrous séparés. La moitié supérieure du schéma suivant utilise un verrou partagé, la moitié inférieure des verrous séparés. Les positions d'arrivée et les durées de détention du verrou pour A et B sont identiques dans les deux parties. L'exemple suppose que le verrou de B est libre et qu'une capacité d'exécution est disponible pour B. Le tutoriel officiel de Tokio décrit également le partitionnement des mutex pour des données aux clés indépendantes.[18]
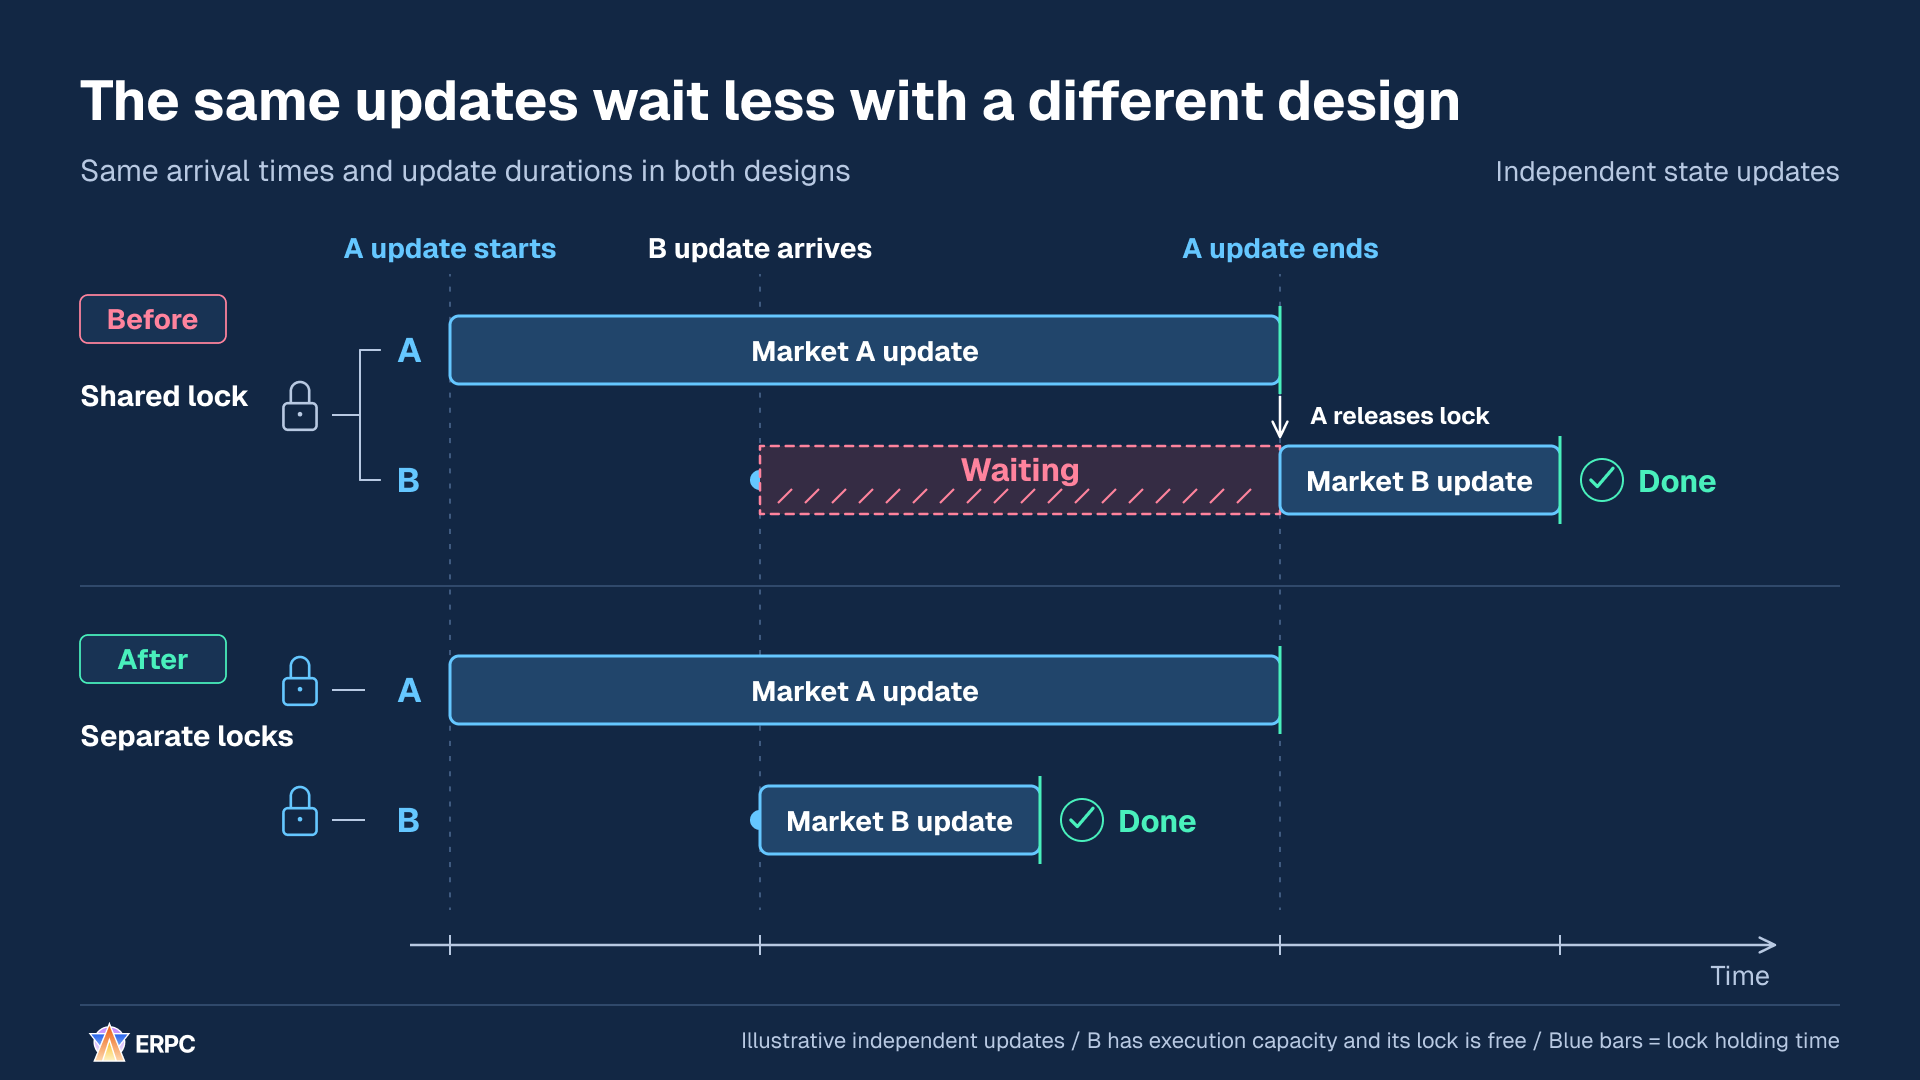
La barre bleue de B garde la même longueur. La partie supprimée est l'intervalle d'attente rose qui la précédait.
La barre bleue couvre la durée entre l'acquisition et la libération du verrou. Dans cet exemple, B termine pendant que A est encore en cours de mise à jour. Des verrous séparés n'éliminent pas une attente causée par l'occupation du propre verrou de B ou par d'autres tâches utilisant les ressources d'exécution disponibles.
Avant de diviser un verrou, établissez quelles mises à jour sont indépendantes. Même si les prix de A et B peuvent être actualisés séparément, une décision qui utilise les deux prix ou un solde partagé doit encore lire les valeurs nécessaires de façon cohérente. Les valeurs peuvent changer pendant qu'une opération est suspendue sur un await, même sur le même thread. Définissez les versions lues par une décision, la manière de les lire et l'ordre d'application des mises à jour.
Par exemple, si A et B lisent le même solde et construisent chacun un ordre, tous deux peuvent compter sur les mêmes fonds. Les valeurs partagées doivent toujours être protégées, par exemple par un responsable unique qui vérifie le solde et réserve les fonds de chaque ordre à tour de rôle.
Une autre possibilité consiste à attribuer à chaque état un seul responsable des modifications et à lui envoyer des messages de mise à jour. C'est le principe Single Writer. Diviser les verrous et désigner un seul responsable des écritures sont deux décisions de conception distinctes. LMAX Disruptor décrit Single Writer et les dépendances entre traitements, tandis que Tokio décrit la gestion d'état par messages envoyés à une tâche dédiée.[5][18]
Pour réduire l'attente des verrous entre des mises à jour d'état indépendantes, copiez ces instructions.
text
Améliore cette application lorsqu'une mise à jour d'un marché ou d'une clé fait attendre une mise à jour indépendante sur le même verrou partagé.

Lis le README, les consignes de développement, les dépendances et le code qui lit ou écrit l'état, acquiert des verrous ou attend d'autres opérations avec await. Utilise le langage et l'environnement d'exécution existants. Identifie qui met à jour chaque valeur et quels ensembles de valeurs chaque décision lit.

1. Conserve des entrées reproductibles sans informations confidentielles et relève la situation initiale. Pour les verrous soumis à contention, enregistre les arrivées par clé, l'attente d'acquisition, la durée de détention, l'ordre des mises à jour et les versions de l'état utilisées pour décider.
2. Distingue les valeurs pouvant être mises à jour indépendamment de celles dont la cohérence doit être protégée ensemble. Sépare les verrous autour des états indépendants et explicite, pour chaque clé, l'ordre d'application et la responsabilité des écritures. Maîtrise le nombre de verrous ou de responsables du traitement.
3. Protège les décisions qui concernent plusieurs marchés ainsi que les soldes partagés ou les réservations de fonds. Fais du contrôle du solde et de la réservation une seule opération coordonnée, afin que plusieurs ordres ne puissent pas chacun supposer que les mêmes fonds sont disponibles. Définis un ordre d'acquisition si plusieurs verrous sont nécessaires.
4. Examine les changements d'état de part et d'autre des points await et l'ordre de fin lors du décodage parallèle. Définis les versions lues par une décision et la manière de les lire. Ne laisse pas l'ordre de fin du décodage remplacer l'ordre d'application requis. Après séparation des verrous, vérifie si des limites de ressources d'exécution ou une contention sur la même clé provoquent encore de l'attente.
5. Rejoue les mêmes entrées dans le même ordre d'arrivée avec des clés indépendantes, des mises à jour concentrées sur une clé, des réservations concurrentes de fonds partagés et du travail suspendu puis repris. Compare l'attente des verrous, les p50/p95/p99 entre réception et fin de décision, le CPU et la mémoire. Vérifie l'ordre de mise à jour requis, la cohérence de l'état utilisé pour décider et l'absence de double réservation. Utilise une horloge monotone pour les durées à l'intérieur d'un hôte et indique les bornes de mesure.

Respecte les approbations, autorisations et procédures de développement existantes. Ces instructions seules n'accordent aucune autorisation supplémentaire de modifier la production, de souscrire des contrats payants ou d'effectuer des transactions réelles. N'affiche pas de clés privées, d'identifiants d'accès ou de données clients.

Présente les changements, les conditions de comparaison, les mesures avant et après, les contrôles de correction et les limites restantes. Signale comme non mesurées les valeurs qui ne peuvent pas être mesurées.
Améliore cette application lorsqu'une mise à jour d'un marché ou d'une clé fait attendre une mise à jour indépendante sur le même verrou partagé.
Lis le README, les consignes de développement, les dépendances et le code qui lit ou écrit l'état, acquiert des verrous ou attend d'autres opérations avec await. Utilise le langage et l'environnement d'exécution existants. Identifie qui met à jour chaque valeur et quels ensembles de valeurs chaque décision lit.
1. Conserve des entrées reproductibles sans informations confidentielles et relève la situation initiale. Pour les verrous soumis à contention, enregistre les arrivées par clé, l'attente d'acquisition, la durée de détention, l'ordre des mises à jour et les versions de l'état utilisées pour décider.
2. Distingue les valeurs pouvant être mises à jour indépendamment de celles dont la cohérence doit être protégée ensemble. Sépare les verrous autour des états indépendants et explicite, pour chaque clé, l'ordre d'application et la responsabilité des écritures. Maîtrise le nombre de verrous ou de responsables du traitement.
3. Protège les décisions qui concernent plusieurs marchés ainsi que les soldes partagés ou les réservations de fonds. Fais du contrôle du solde et de la réservation une seule opération coordonnée, afin que plusieurs ordres ne puissent pas chacun supposer que les mêmes fonds sont disponibles. Définis un ordre d'acquisition si plusieurs verrous sont nécessaires.
4. Examine les changements d'état de part et d'autre des points await et l'ordre de fin lors du décodage parallèle. Définis les versions lues par une décision et la manière de les lire. Ne laisse pas l'ordre de fin du décodage remplacer l'ordre d'application requis. Après séparation des verrous, vérifie si des limites de ressources d'exécution ou une contention sur la même clé provoquent encore de l'attente.
5. Rejoue les mêmes entrées dans le même ordre d'arrivée avec des clés indépendantes, des mises à jour concentrées sur une clé, des réservations concurrentes de fonds partagés et du travail suspendu puis repris. Compare l'attente des verrous, les p50/p95/p99 entre réception et fin de décision, le CPU et la mémoire. Vérifie l'ordre de mise à jour requis, la cohérence de l'état utilisé pour décider et l'absence de double réservation. Utilise une horloge monotone pour les durées à l'intérieur d'un hôte et indique les bornes de mesure.
Respecte les approbations, autorisations et procédures de développement existantes. Ces instructions seules n'accordent aucune autorisation supplémentaire de modifier la production, de souscrire des contrats payants ou d'effectuer des transactions réelles. N'affiche pas de clés privées, d'identifiants d'accès ou de données clients.
Présente les changements, les conditions de comparaison, les mesures avant et après, les contrôles de correction et les limites restantes. Signale comme non mesurées les valeurs qui ne peuvent pas être mesurées.4. Préparez les parties inchangées à l'avance pour réduire le travail après réception
Supposons qu'à chaque mise à jour de prix, l'application analyse le même identifiant fixe, dérive une adresse fixe à partir des mêmes entrées et alloue de la mémoire de travail. Cette mémoire de travail est aussi appelée tampon. Répéter ces trois préparations place le temps consacré à des informations inchangées sur le chemin de chaque décision.
Une préparation dont les entrées ne changent pas peut être terminée avant l'arrivée des données et réutilisée. Après réception, l'application vérifie les informations qui ont changé pour cet événement, construit le message définitif à envoyer et signe son contenu.
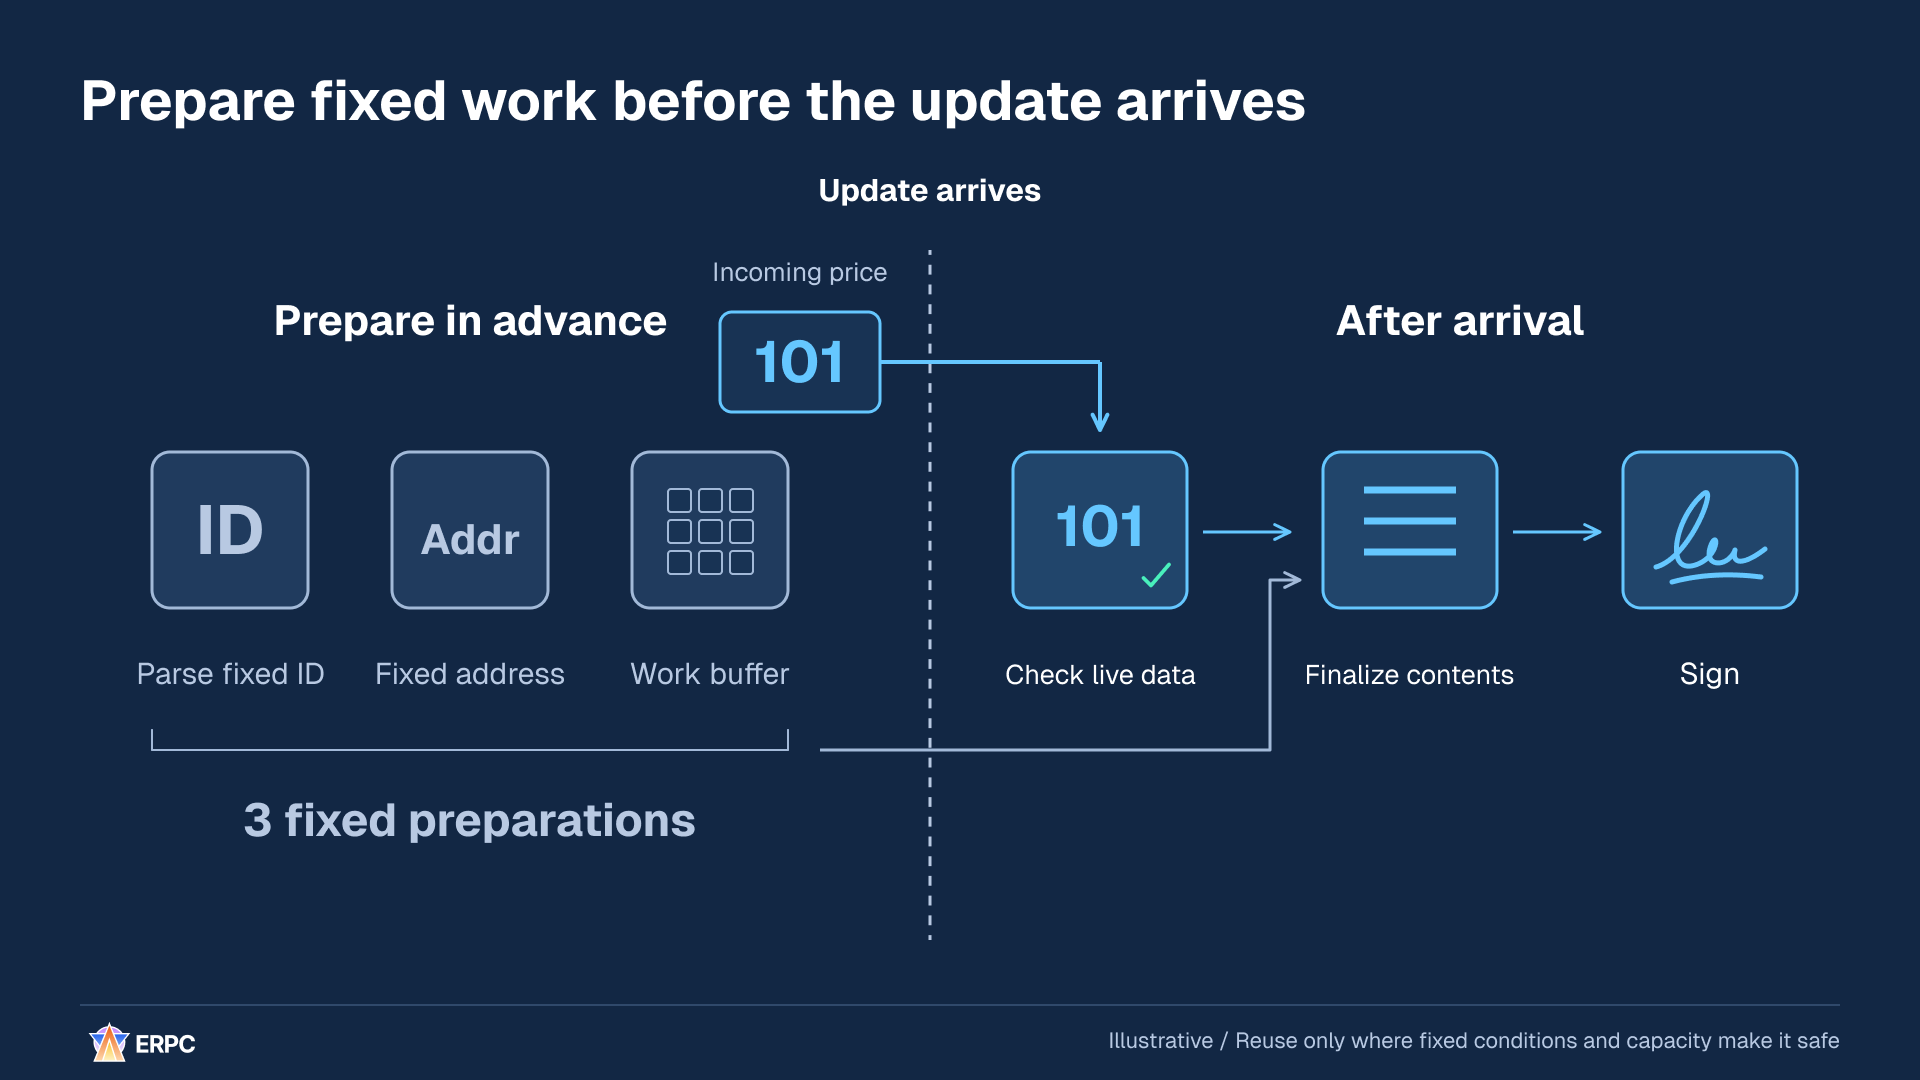
Avancez la préparation des parties inchangées, tout en conservant la validation du contenu actuel et la signature après réception.
Comptons ce qui change pour trois mises à jour. Préparer trois catégories d'éléments pour chaque événement demande neuf opérations de préparation. Préparer ces trois catégories une seule fois, puis les réutiliser successivement, en demande trois. Les deux conceptions reçoivent toujours trois événements, les traitent un par un et produisent trois sorties.
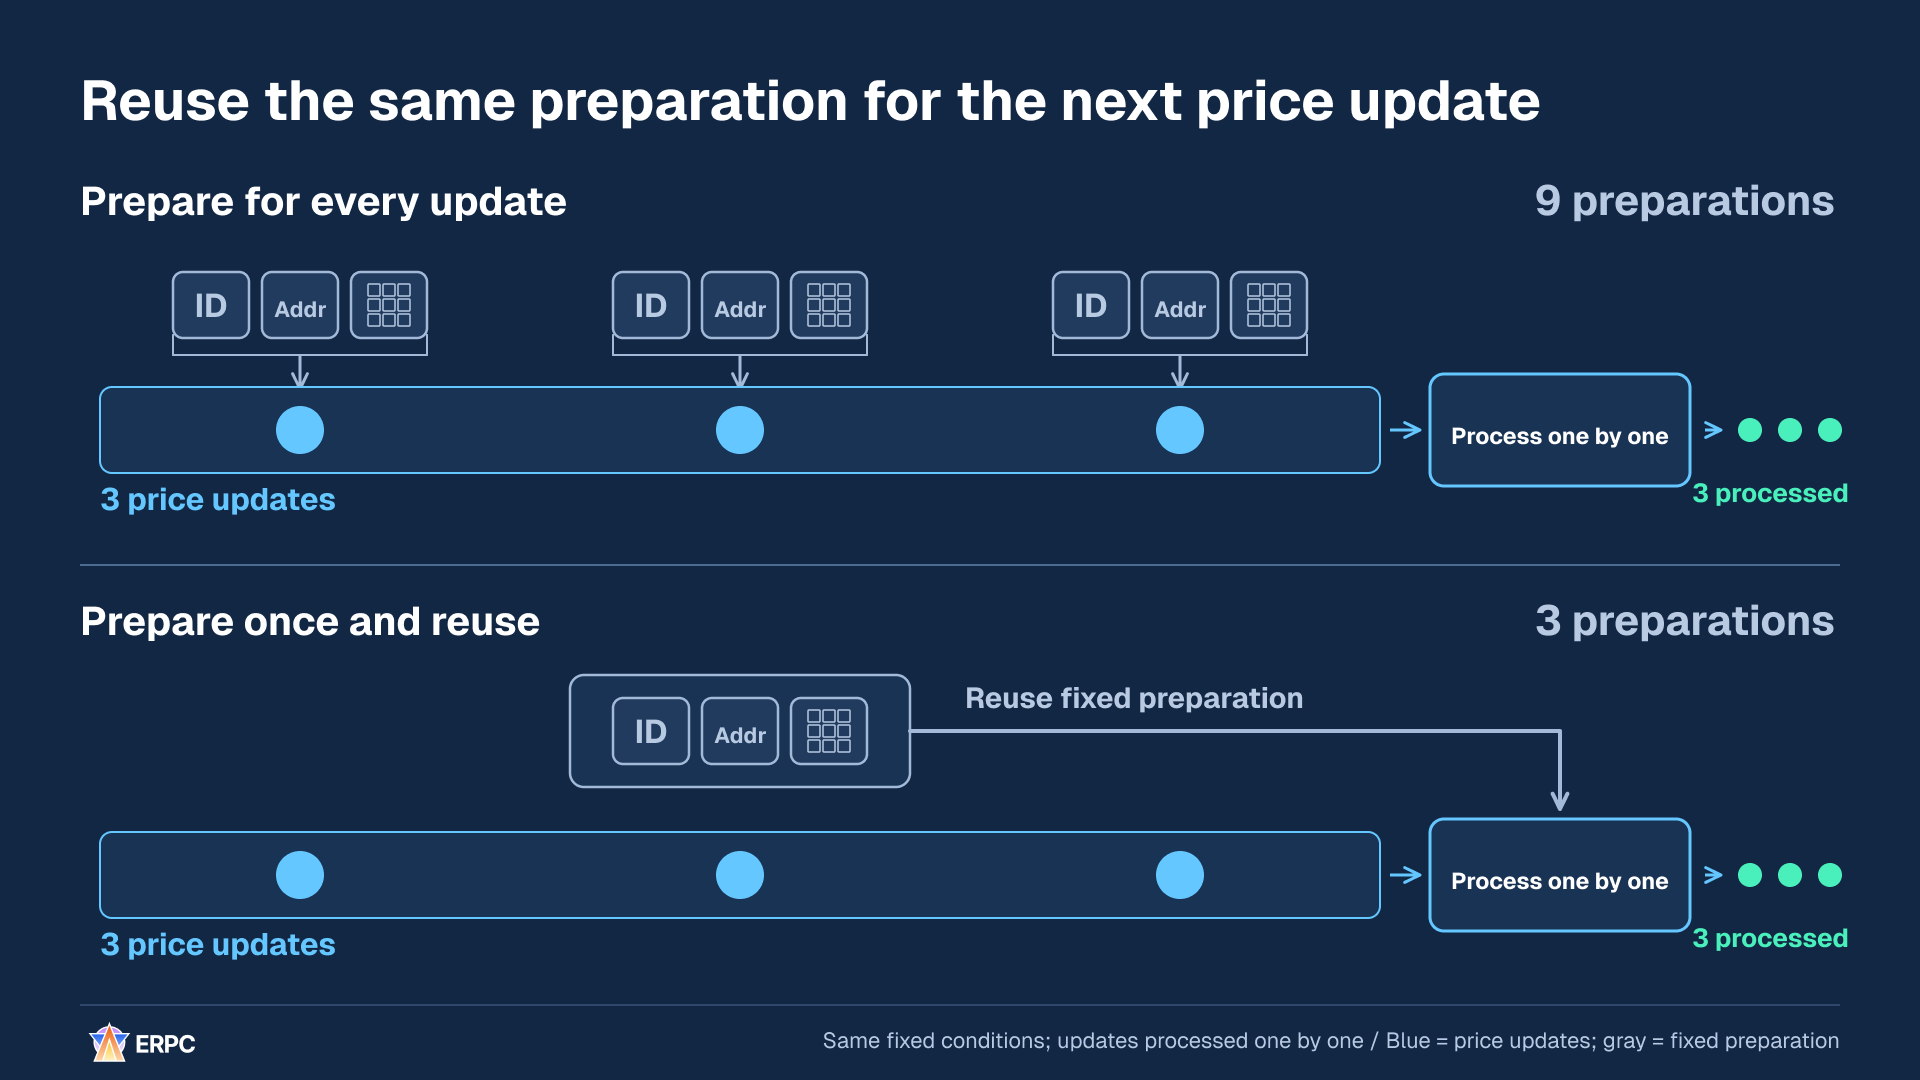
Le nombre d'événements reste trois, tandis que la préparation fixe passe de neuf à trois opérations dans cet exemple.
Cette comparaison suppose que les conditions fixes ne changent pas et que la mémoire de travail peut être réutilisée en séquence sans conflit. Son contenu est toujours actualisé pour l'événement courant. Si plusieurs opérations s'exécutent simultanément, utilisez des zones distinctes pour chacune ou un pool qui en gère l'accès afin qu'elles n'écrasent pas la même mémoire.
Étendons l'exemple à 1 000 événements. Préparer trois catégories d'éléments pour chaque événement demande 3 000 opérations ; effectuer la préparation commune une seule fois en demande trois. Les deux conceptions reçoivent 1 000 événements, les traitent un par un et produisent 1 000 sorties. Distinguez le nombre de préparations du nombre d'événements traités.
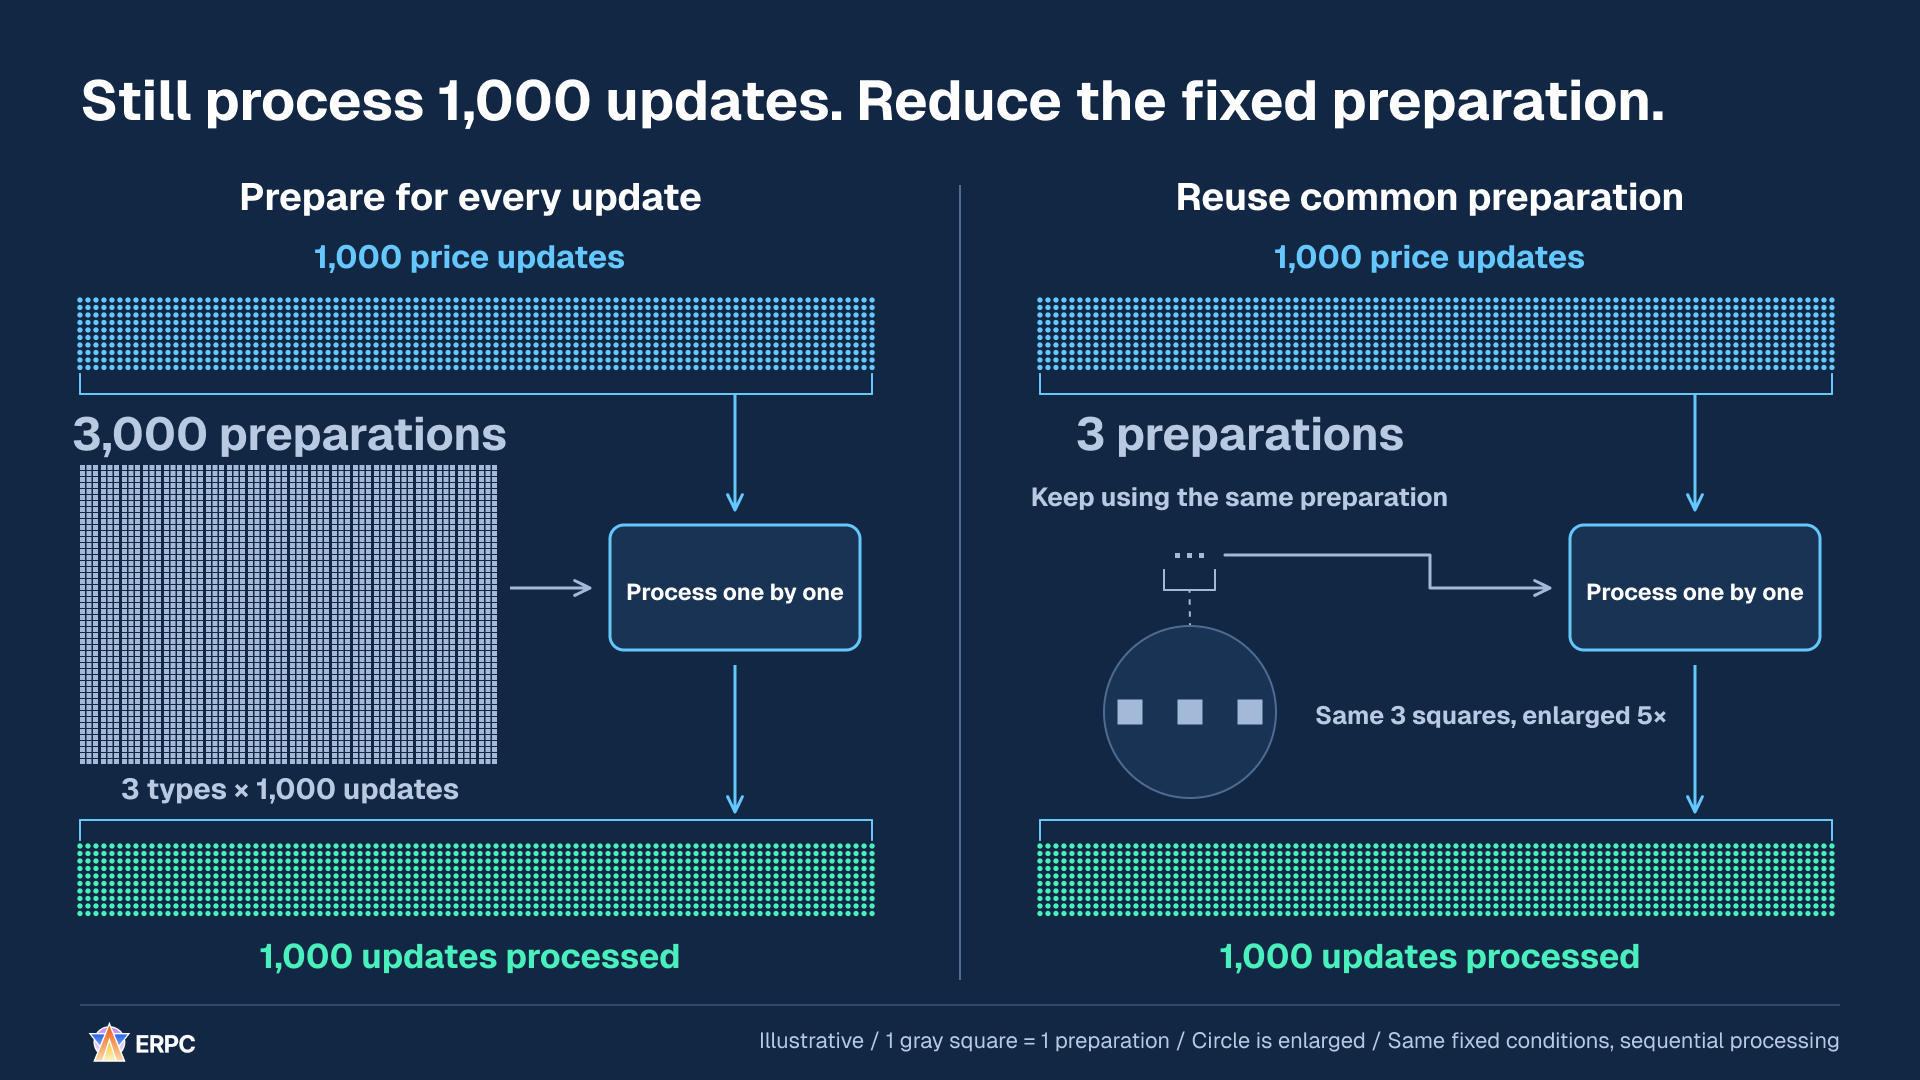
Ce qui diminue, c'est la répétition de la préparation fixe. La validation, les décisions, la signature et les autres tâches restent nécessaires : le rapport entre ces nombres ne représente donc pas une accélération de l'application entière.
Définissez les conditions de validité de la réutilisation. Si une entrée utilisée pour dériver l'adresse fixe change, l'adresse doit être recalculée. Les prix, quantités, soldes, états des comptes référencés, limites de risque et blockhashes doivent être valides au moment de la décision. Si l'application maintient un état local continuellement actualisé, vérifiez sa version, sa fraîcheur et sa validité. Cela n'impose pas nécessairement de tout récupérer à nouveau par RPC pour chaque décision.
La méthode getLatestBlockhash de Solana renvoie un blockhash et son lastValidBlockHeight. Distinguez hauteur de bloc et slot lors du contrôle de l'expiration.[7] Finalisez le message avant de le signer. Si le message est modifié après signature, produisez les signatures correspondant au contenu actualisé.[19]
Pour réutiliser les préparations fixes et réduire le travail après réception, copiez ces instructions.
text
Examine le travail qui répète la même analyse syntaxique, la même dérivation d'adresse ou la même allocation mémoire pour chaque entrée, et déplace les préparations réutilisables avant la réception.

Lis le README, les consignes de développement, les dépendances et le code réception → préparation → décision → construction du message → signature. Utilise le langage, l'environnement d'exécution et le SDK existants. Identifie les entrées, sorties, responsable et période de validité de chaque préparation.

1. Conserve des entrées reproductibles sans informations confidentielles. Relève les nombres d'événements et de sorties, le nombre d'exécutions et la durée de chaque préparation, la mémoire allouée et la durée entre réception et fin de décision.
2. Identifie les préparations dont les entrées restent inchangées, réalise-les à l'initialisation ou à une autre étape antérieure appropriée, puis réutilise leurs résultats. Implémente les clés de réutilisation, l'invalidation et le recalcul lorsque les entrées ou la configuration changent, ainsi que des limites pour les caches et les pools de buffers.
3. Mets à jour la mémoire de travail réutilisable pour l'entrée courante. Pour les opérations concurrentes, utilise des zones distinctes ou des prêts gérés, afin qu'une zone ne soit ni écrasée ni rendue pendant son utilisation.
4. Valide les prix, quantités, soldes, états des comptes, conditions de risque et blockhashes selon les exigences de la décision. Vérifie la version et la fraîcheur lorsqu'un état local continuellement mis à jour est utilisé. Pour Solana, distingue la hauteur de bloc du slot lorsque lastValidBlockHeight sert à vérifier l'expiration d'un blockhash. Finalise le message avant de le signer, puis signe à nouveau le message modifié si son contenu change après la signature.
5. Avec les mêmes entrées, compare le nombre et la durée des préparations, les p50/p95/p99 entre réception et fin de décision, le CPU et la mémoire, ainsi que les sorties. Reproduis aussi des changements d'entrées ou de configuration, une expiration et une exécution concurrente pour détecter la réutilisation de résultats périmés et les conflits mémoire. Ne transforme pas le rapport des nombres de préparations en facteur d'accélération global. Utilise une horloge monotone pour les durées à l'intérieur d'un hôte et indique les bornes de mesure.

Respecte les approbations, autorisations et procédures de développement existantes. Ces instructions seules n'accordent aucune autorisation supplémentaire de modifier la production, de souscrire des contrats payants ou d'effectuer des transactions réelles. N'affiche pas de clés privées, d'identifiants d'accès ou de données clients.

Présente les changements, les conditions de comparaison, les mesures avant et après, les contrôles de correction et les limites restantes. Signale comme non mesurées les valeurs qui ne peuvent pas être mesurées.
Examine le travail qui répète la même analyse syntaxique, la même dérivation d'adresse ou la même allocation mémoire pour chaque entrée, et déplace les préparations réutilisables avant la réception.
Lis le README, les consignes de développement, les dépendances et le code réception → préparation → décision → construction du message → signature. Utilise le langage, l'environnement d'exécution et le SDK existants. Identifie les entrées, sorties, responsable et période de validité de chaque préparation.
1. Conserve des entrées reproductibles sans informations confidentielles. Relève les nombres d'événements et de sorties, le nombre d'exécutions et la durée de chaque préparation, la mémoire allouée et la durée entre réception et fin de décision.
2. Identifie les préparations dont les entrées restent inchangées, réalise-les à l'initialisation ou à une autre étape antérieure appropriée, puis réutilise leurs résultats. Implémente les clés de réutilisation, l'invalidation et le recalcul lorsque les entrées ou la configuration changent, ainsi que des limites pour les caches et les pools de buffers.
3. Mets à jour la mémoire de travail réutilisable pour l'entrée courante. Pour les opérations concurrentes, utilise des zones distinctes ou des prêts gérés, afin qu'une zone ne soit ni écrasée ni rendue pendant son utilisation.
4. Valide les prix, quantités, soldes, états des comptes, conditions de risque et blockhashes selon les exigences de la décision. Vérifie la version et la fraîcheur lorsqu'un état local continuellement mis à jour est utilisé. Pour Solana, distingue la hauteur de bloc du slot lorsque lastValidBlockHeight sert à vérifier l'expiration d'un blockhash. Finalise le message avant de le signer, puis signe à nouveau le message modifié si son contenu change après la signature.
5. Avec les mêmes entrées, compare le nombre et la durée des préparations, les p50/p95/p99 entre réception et fin de décision, le CPU et la mémoire, ainsi que les sorties. Reproduis aussi des changements d'entrées ou de configuration, une expiration et une exécution concurrente pour détecter la réutilisation de résultats périmés et les conflits mémoire. Ne transforme pas le rapport des nombres de préparations en facteur d'accélération global. Utilise une horloge monotone pour les durées à l'intérieur d'un hôte et indique les bornes de mesure.
Respecte les approbations, autorisations et procédures de développement existantes. Ces instructions seules n'accordent aucune autorisation supplémentaire de modifier la production, de souscrire des contrats payants ou d'effectuer des transactions réelles. N'affiche pas de clés privées, d'identifiants d'accès ou de données clients.
Présente les changements, les conditions de comparaison, les mesures avant et après, les contrôles de correction et les limites restantes. Signale comme non mesurées les valeurs qui ne peuvent pas être mesurées.5. Ne continuez pas à décider après avoir manqué des mises à jour nécessaires
Prenons deux marchés du même actif, avec une application qui calcule la différence de prix B−A. Pendant une déconnexion, le marché A passe de 100 à 105 et l'application manque cette mise à jour. Si elle reçoit seulement le prix 104 de B après reconnexion, elle calcule 104−100, soit +4. Avec la valeur actualisée de A, elle obtient 104−105, soit -1. Même le signe change.
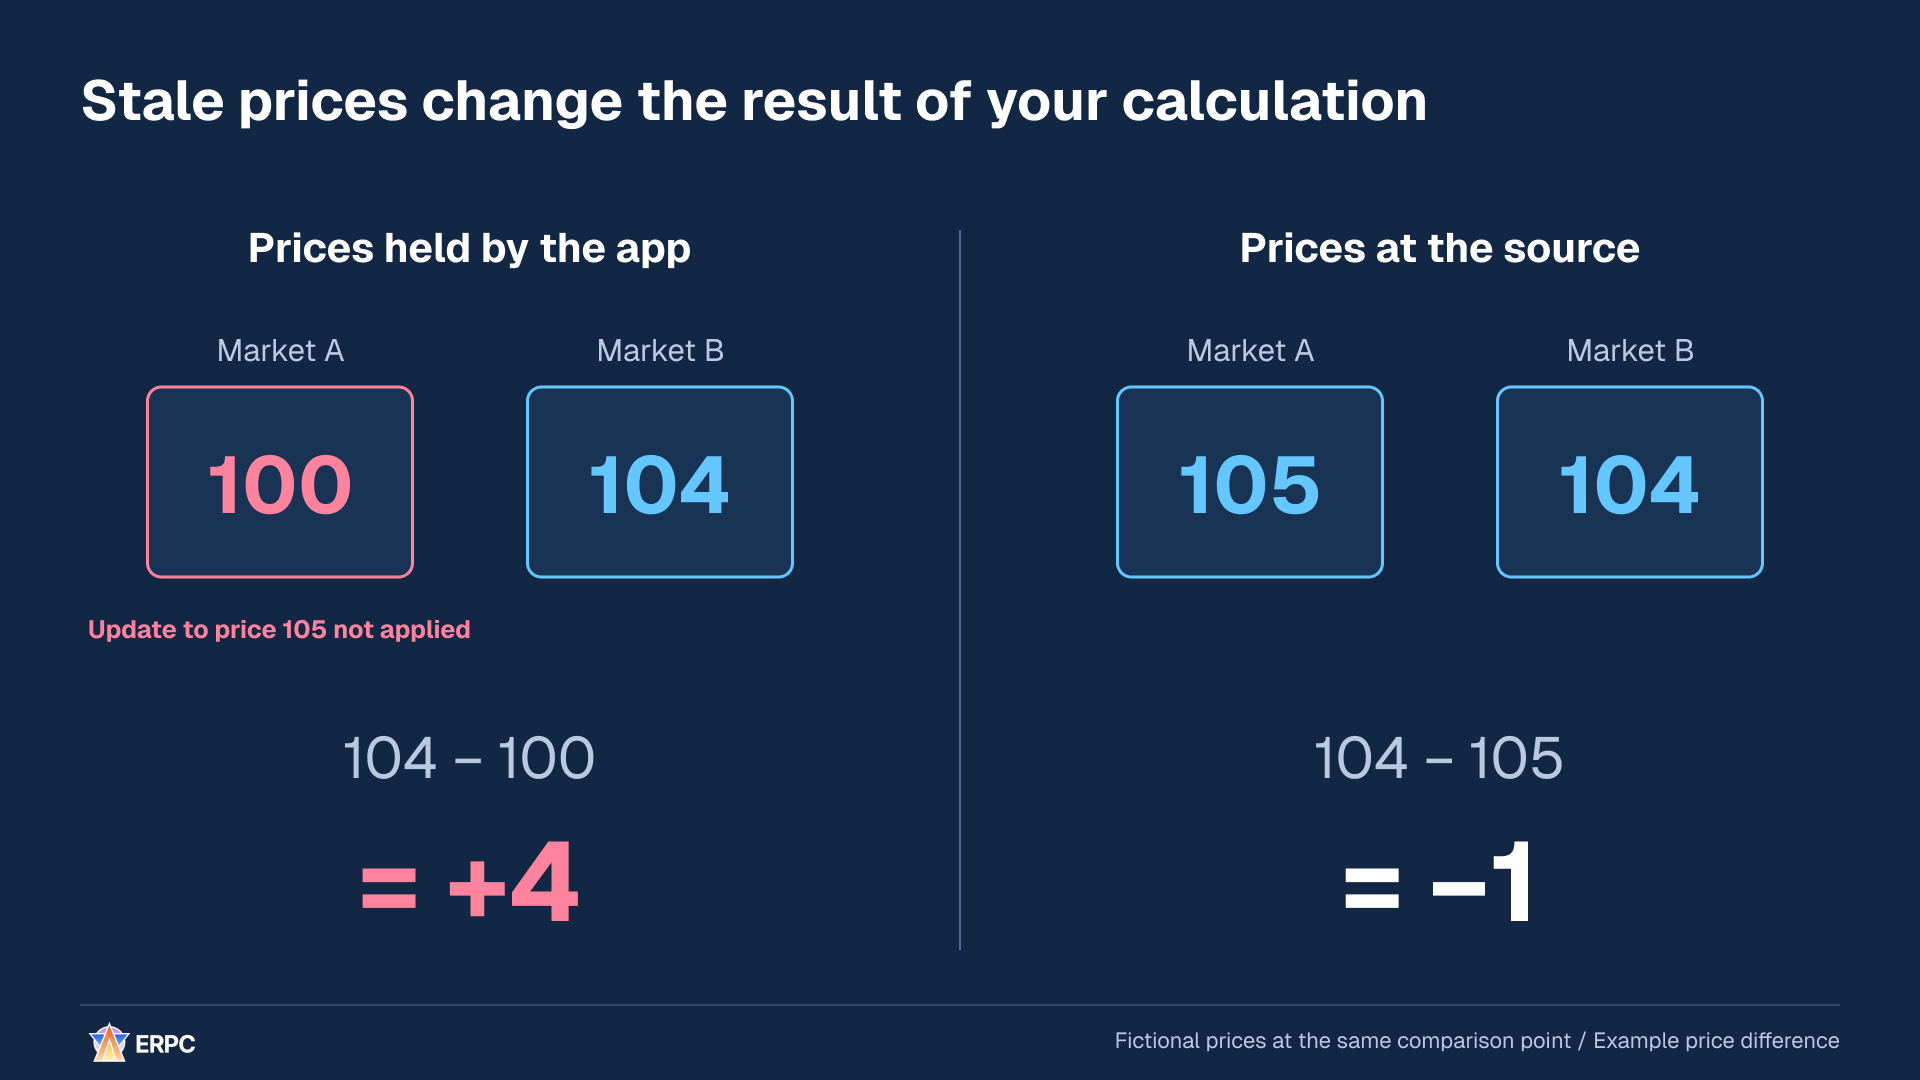
Le résultat du même calcul change selon qu'il utilise l'ancienne valeur 100 de A ou sa valeur actualisée 105.
Ce modèle montre uniquement une différence de prix. Il exclut les frais, les conditions d'exécution et d'autres facteurs, et ne représente pas un bénéfice de trading. Il illustre qu'une connexion rétablie ne restaure pas forcément toutes les mises à jour nécessaires à une décision.
Dans cet exemple, suspendez les nouvelles décisions de trading utilisant les prix de A et B, puis remplacez l'ancienne valeur 100 de A par la valeur récupérée 105. Vérifiez ensuite que les mises à jour nécessaires ont été appliquées à A et B et que les conditions requises d'ordre et de fraîcheur sont satisfaites. Reprenez une fois les vérifications nécessaires terminées ; si elles ne peuvent pas être menées à bien, maintenez la suspension.
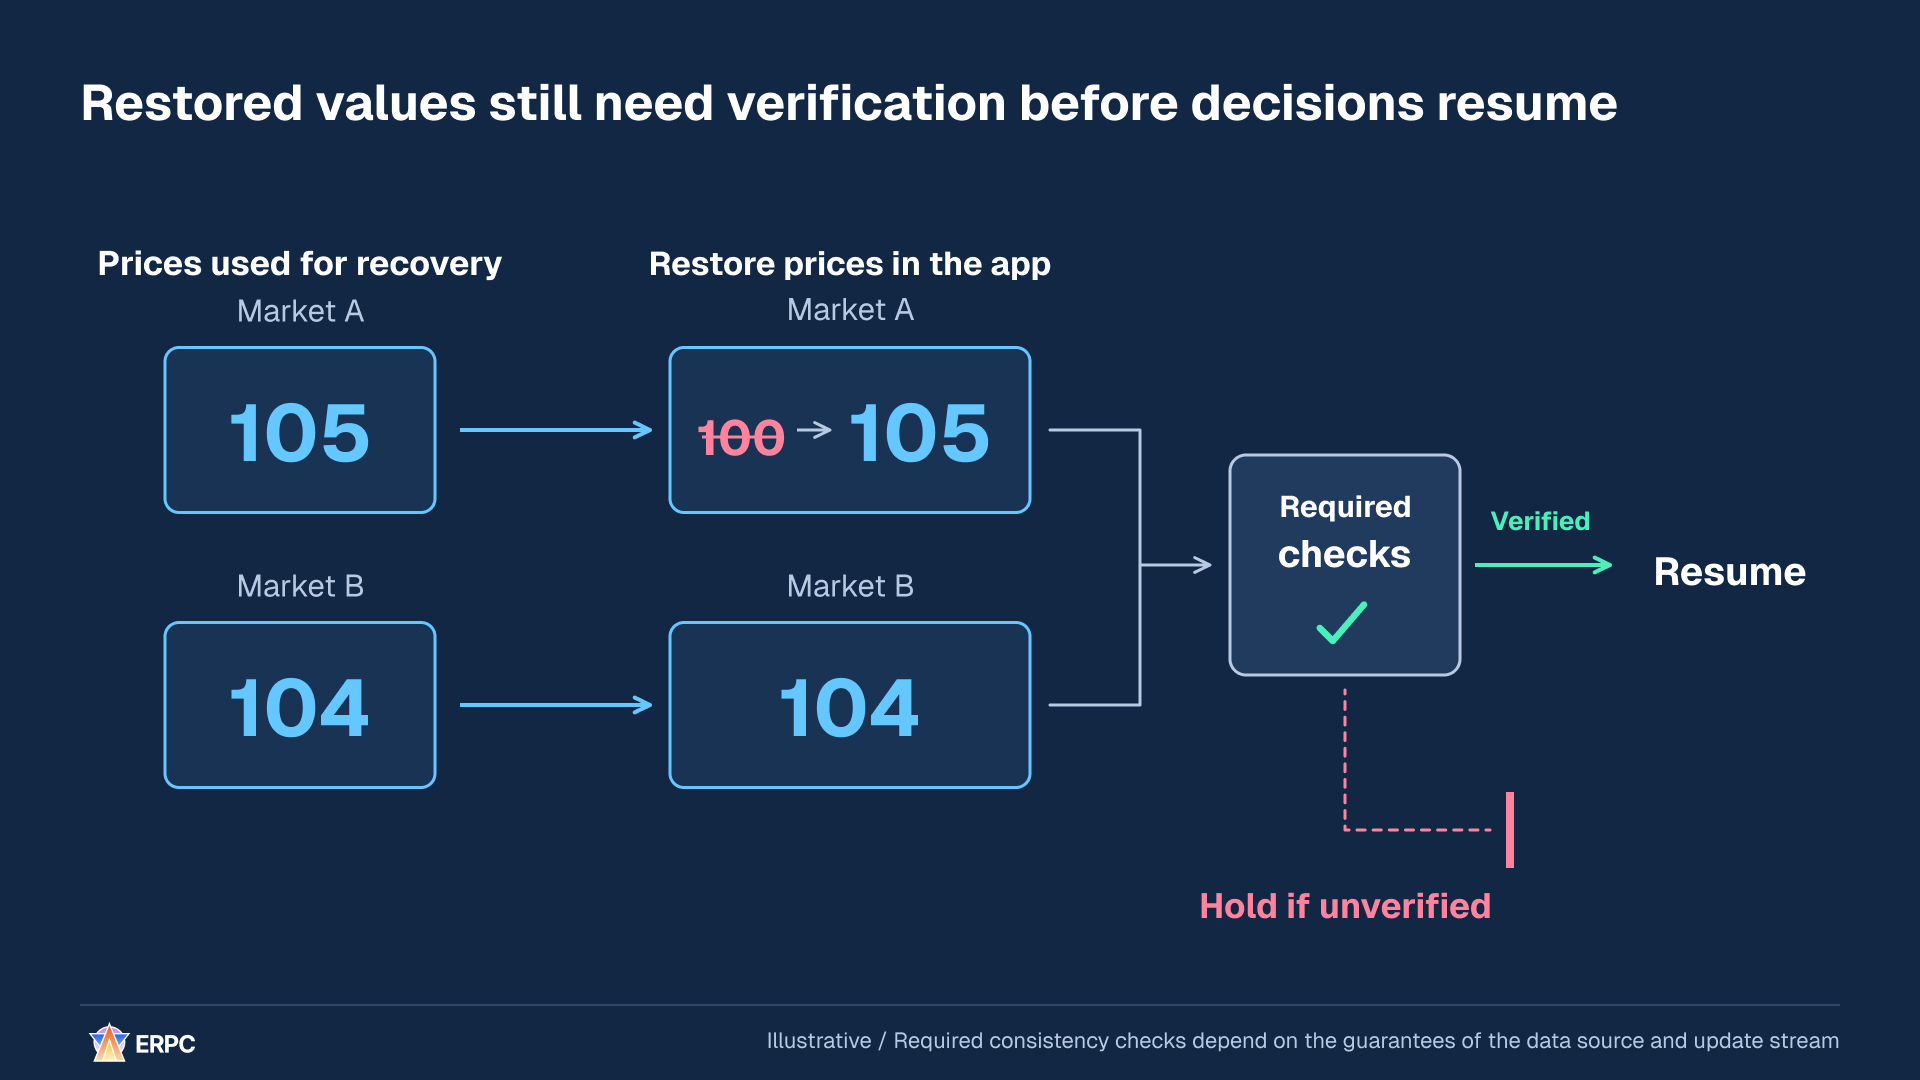
Séparez la mise à jour des valeurs de la vérification de leur aptitude à servir aux décisions.
Un mécanisme courant de restauration est le snapshot, une image de l'état à un instant donné. Pour le raccorder à un flux continu de mises à jour, déterminez lesquelles sont déjà incluses et lesquelles doivent être appliquées ensuite. Cela évite d'appliquer deux fois une différence déjà incluse ou de perdre une mise à jour à la frontière. La méthode précise doit respecter les garanties de l'API choisie concernant le démarrage des abonnements, l'identification, la récupération et la relecture.
Les messages Yellowstone contiennent notamment les champs slot et write_version.[16] Leur simple présence ne garantit ni une séquence utilisable entre fournisseurs ni une détection exhaustive des données manquantes. Ne transformez pas directement un écart de slots en nombre de mises à jour manquantes ou en secondes de latence. Vérifiez que l'état a été raccordé conformément aux garanties du fournisseur choisi.
Tenez aussi compte des calculs commencés avant la restauration. Une opération lancée sur un ancien état mais terminée après la reprise pourrait écraser le nouvel état avec son résultat. Une solution consiste à associer un numéro de génération à l'état au fil des restaurations et à refuser les résultats d'une génération antérieure. Si vous utilisez un état processed, incluez également les rollbacks (lorsque cet état n'est plus retenu) parmi les raisons de réexaminer l'état.[6]
Pour restaurer un état valide avant de reprendre les décisions après une reconnexion, copiez ces instructions.
text
Empêche cette application de reprendre des décisions de trading sur un état périmé simplement parce que sa connexion est revenue. Implémente la restauration de l'état nécessaire avant la reprise des décisions.

Lis le README, les consignes de développement, les dépendances et le code d'abonnement, de chargement initial, d'application des mises à jour, de reconnexion et de décision. Utilise le langage, l'environnement d'exécution et le SDK existants. Vérifie le fournisseur, le commitment, la sémantique des mises à jour et les garanties réelles d'ordre, d'identification, de nouveau chargement et de rejeu.

1. Distingue le statut de connexion, la validité des données et l'autorisation de reprendre les décisions. Si l'absence de mises à jour nécessaires ou une fraîcheur insuffisante est établie, suspends les nouvelles décisions de trading qui dépendent de cet état, tout en poursuivant la réception, les mises à jour et la récupération nécessaires.
2. Si un snapshot est utilisé, détermine à partir des garanties du fournisseur les mises à jour qu'il contient et sa frontière avec le flux qui suit. Empêche la double application des deltas, les lacunes à la frontière et un ordre d'application incorrect. Ne comble pas les lacunes de ces garanties par des hypothèses. Ne considère pas slot ou write_version comme une séquence inconditionnelle permettant de détecter les mises à jour manquantes.
3. Ne reprends pas les décisions au seul motif que les valeurs ont été chargées. Implémente les contrôles des mises à jour, de l'ordre, de la fraîcheur et de la cohérence nécessaires aux décisions concernées, et maintiens leur suspension tant que ces contrôles ne peuvent pas être terminés. Utilise des générations ou un mécanisme équivalent pour empêcher l'application ou l'envoi d'anciens calculs ou propositions d'ordres si un travail commencé avant la récupération se termine plus tard. À la reprise, prends de nouvelles décisions à partir de l'état validé. Si l'état processed est utilisé, gère l'invalidation et la restauration après un rollback.
4. Avec des entrées reproductibles sans informations confidentielles, reproduis des mises à jour manquées pendant une déconnexion, des doublons, des mises à jour réordonnées, des données périmées, des reconnexions répétées et la fin d'un travail provenant d'une ancienne génération. Vérifie que les décisions restent suspendues entre le retour de la connexion et la fin de la validation, et que l'état validé correspond au résultat attendu.
5. Relève le temps de récupération, le nombre de tentatives de décision empêchées par un état invalide et la durée de suspension, les mises à jour réappliquées ou exclues, la durée normale entre réception et fin de décision, le CPU et la mémoire. N'exclus pas silencieusement des mesures les périodes de suspension ou les mises à jour manquantes. Indique les bornes de mesure et ce qui peut ou ne peut pas être détecté. Utilise une horloge monotone pour les durées à l'intérieur d'un hôte.

Respecte les approbations, autorisations et procédures de développement existantes. Ces instructions seules n'accordent aucune autorisation supplémentaire de modifier la production, de souscrire des contrats payants ou d'effectuer des transactions réelles. N'affiche pas de clés privées, d'identifiants d'accès ou de données clients.

Présente les changements, les conditions de comparaison, les mesures avant et après, les contrôles de correction et les limites restantes. Signale comme non mesurées les valeurs qui ne peuvent pas être mesurées.
Empêche cette application de reprendre des décisions de trading sur un état périmé simplement parce que sa connexion est revenue. Implémente la restauration de l'état nécessaire avant la reprise des décisions.
Lis le README, les consignes de développement, les dépendances et le code d'abonnement, de chargement initial, d'application des mises à jour, de reconnexion et de décision. Utilise le langage, l'environnement d'exécution et le SDK existants. Vérifie le fournisseur, le commitment, la sémantique des mises à jour et les garanties réelles d'ordre, d'identification, de nouveau chargement et de rejeu.
1. Distingue le statut de connexion, la validité des données et l'autorisation de reprendre les décisions. Si l'absence de mises à jour nécessaires ou une fraîcheur insuffisante est établie, suspends les nouvelles décisions de trading qui dépendent de cet état, tout en poursuivant la réception, les mises à jour et la récupération nécessaires.
2. Si un snapshot est utilisé, détermine à partir des garanties du fournisseur les mises à jour qu'il contient et sa frontière avec le flux qui suit. Empêche la double application des deltas, les lacunes à la frontière et un ordre d'application incorrect. Ne comble pas les lacunes de ces garanties par des hypothèses. Ne considère pas slot ou write_version comme une séquence inconditionnelle permettant de détecter les mises à jour manquantes.
3. Ne reprends pas les décisions au seul motif que les valeurs ont été chargées. Implémente les contrôles des mises à jour, de l'ordre, de la fraîcheur et de la cohérence nécessaires aux décisions concernées, et maintiens leur suspension tant que ces contrôles ne peuvent pas être terminés. Utilise des générations ou un mécanisme équivalent pour empêcher l'application ou l'envoi d'anciens calculs ou propositions d'ordres si un travail commencé avant la récupération se termine plus tard. À la reprise, prends de nouvelles décisions à partir de l'état validé. Si l'état processed est utilisé, gère l'invalidation et la restauration après un rollback.
4. Avec des entrées reproductibles sans informations confidentielles, reproduis des mises à jour manquées pendant une déconnexion, des doublons, des mises à jour réordonnées, des données périmées, des reconnexions répétées et la fin d'un travail provenant d'une ancienne génération. Vérifie que les décisions restent suspendues entre le retour de la connexion et la fin de la validation, et que l'état validé correspond au résultat attendu.
5. Relève le temps de récupération, le nombre de tentatives de décision empêchées par un état invalide et la durée de suspension, les mises à jour réappliquées ou exclues, la durée normale entre réception et fin de décision, le CPU et la mémoire. N'exclus pas silencieusement des mesures les périodes de suspension ou les mises à jour manquantes. Indique les bornes de mesure et ce qui peut ou ne peut pas être détecté. Utilise une horloge monotone pour les durées à l'intérieur d'un hôte.
Respecte les approbations, autorisations et procédures de développement existantes. Ces instructions seules n'accordent aucune autorisation supplémentaire de modifier la production, de souscrire des contrats payants ou d'effectuer des transactions réelles. N'affiche pas de clés privées, d'identifiants d'accès ou de données clients.
Présente les changements, les conditions de comparaison, les mesures avant et après, les contrôles de correction et les limites restantes. Signale comme non mesurées les valeurs qui ne peuvent pas être mesurées.Comparez les atouts des langages selon six dimensions
La mise en œuvre de ces cinq conceptions demande de décider qui met à jour les données, où la mémoire est allouée, ce qui est copié et quelles opérations attendent. La rapidité des calculs, le contrôle des délais soudains et la rapidité du prototypage sont des atouts différents. Comparez les langages selon la partie que vous souhaitez améliorer.
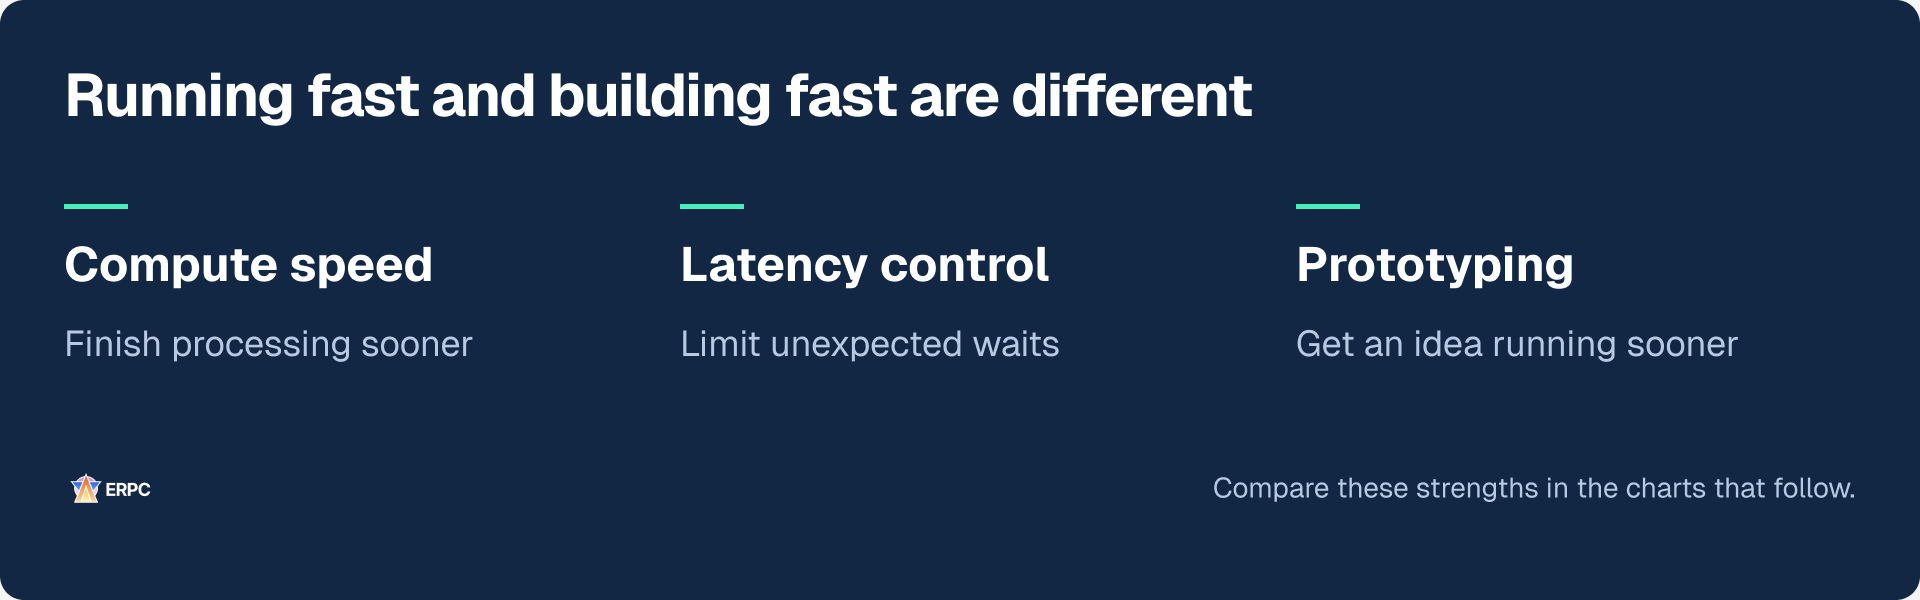
Comparer les durées d’exécution d’un benchmark publié
Ces mesures publiées, datées du 1er août 2025, exécutent un calcul de cinq corps sur 500 000 étapes. La durée moyenne d’exécution est le temps moyen entre le démarrage du programme et son achèvement. Elle comprend le démarrage et l’optimisation du code pendant l’exécution, mais exclut la compilation préalable. 1 000 ms correspondent à une seconde.[27][29]
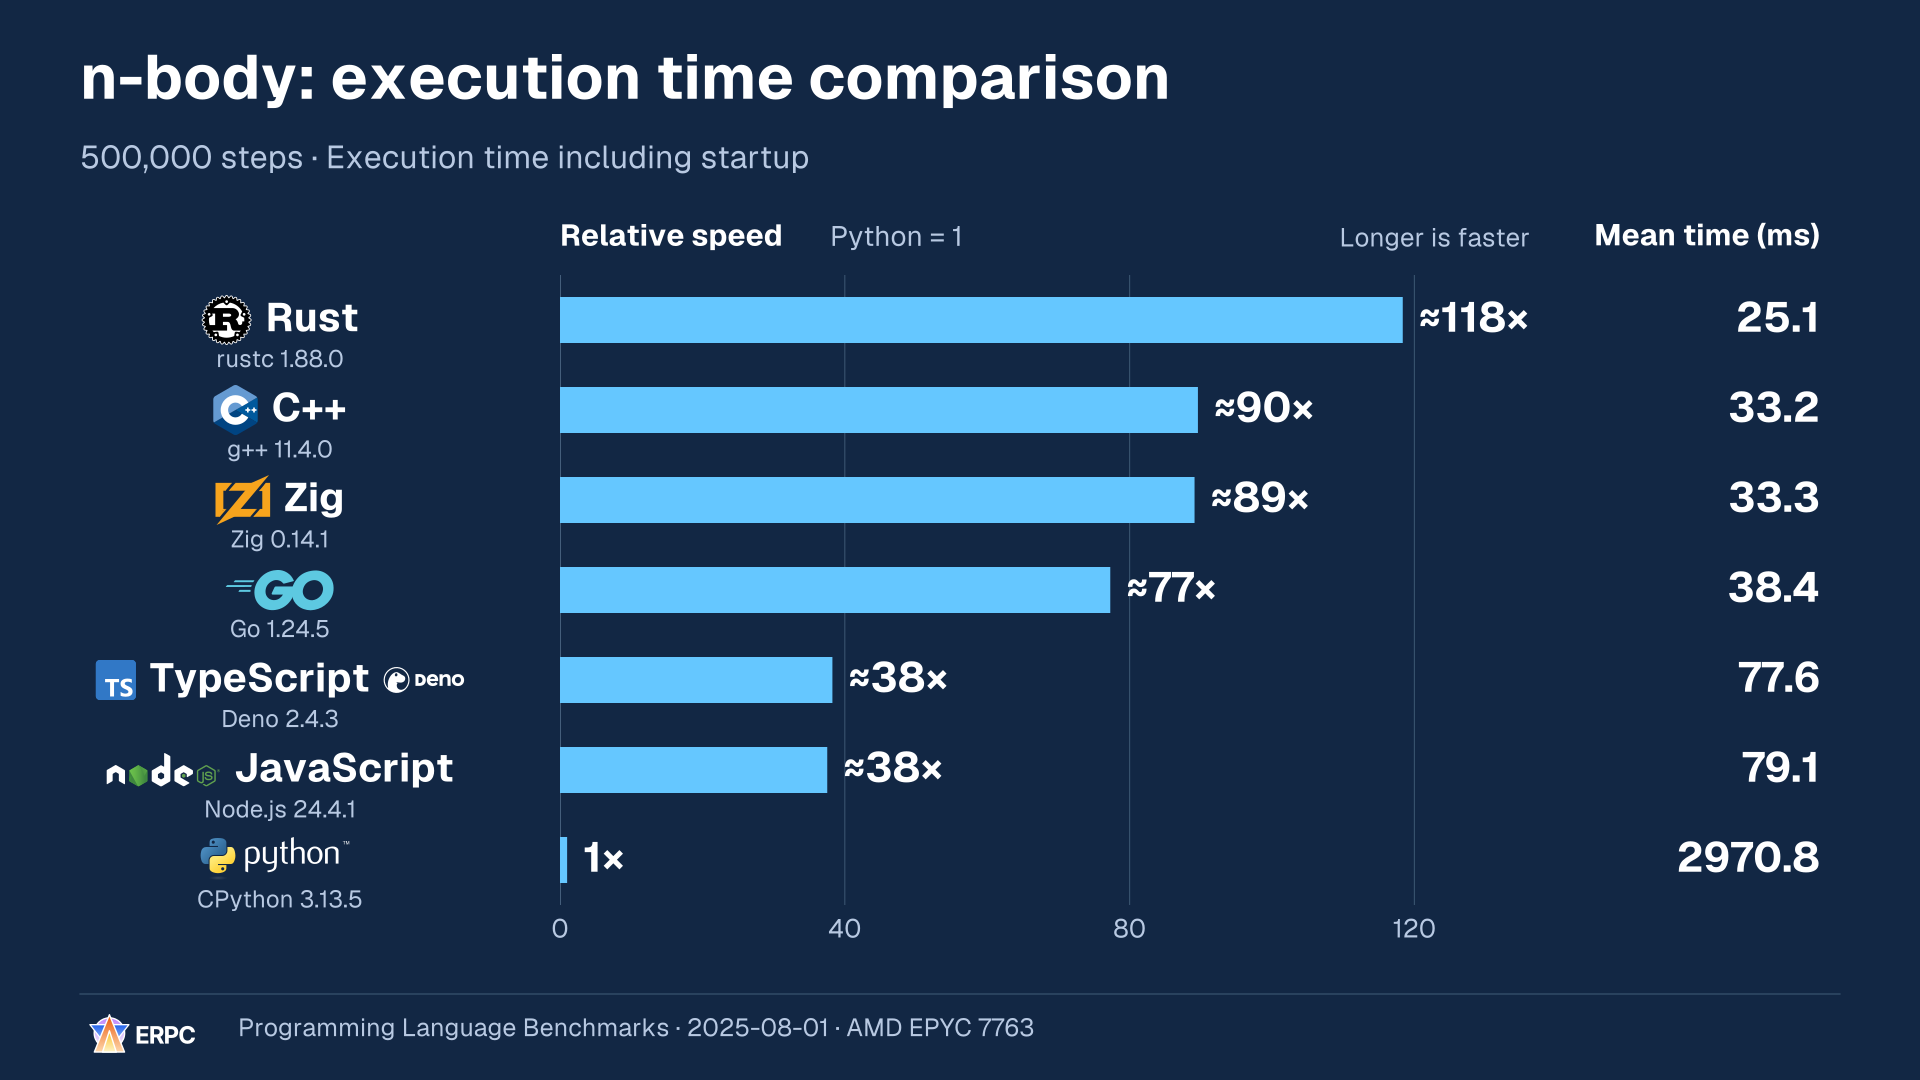
| Langage / environnement | Durée moyenne d’exécution | Vitesse relative (Python = 1) |
|---|---|---|
| Rust / rustc 1.88.0 | 25.1 ms | ≈118 |
| C++ / g++ 11.4.0 | 33.2 ms | ≈90 |
| Zig / Zig 0.14.1 | 33.3 ms | ≈89 |
| Go / Go 1.24.5 | 38.4 ms | ≈77 |
| TypeScript / Deno 2.4.3 | 77.6 ms | ≈38 |
| JavaScript / Node.js 24.4.1 | 79.1 ms | ≈38 |
| Python / CPython 3.13.5 | 2970.8 ms | 1 |
Les vitesses relatives sont calculées à partir des moyennes non arrondies, avec Python = 1. Pour chaque famille de langage et d’environnement, nous retenons la plus petite moyenne publiée parmi les implémentations stables dont le calcul numérique utilise un seul thread, sans intrinsics SIMD explicites, types vectoriels ni bibliothèques numériques externes. Le code et les optimisations diffèrent ; Zig utilise ReleaseFast. TypeScript s’exécute sous forme d’un fichier contenant Deno/V8, tandis que JavaScript utilise Node.js.[28]
Considérez les valeurs proches comme des résultats comparables, sans transformer cette seule tâche en classement général des langages. Elle ne mesure directement ni le temps de traitement d’un bot qui continue à fonctionner après le démarrage, ni le délai d’acheminement d’un ordre.
L’environnement indiqué est Linux sur un AMD EPYC 7763 avec quatre cœurs disponibles. Le code de mesure publié prévoit trois répétitions par condition, avec un nouveau processus à chaque fois. Le commit exact de l’exécution historique et les observations brutes n’ont pas pu être vérifiés ; nous présentons donc les moyennes publiées.[28][29]
Comparer les atouts de conception selon six dimensions
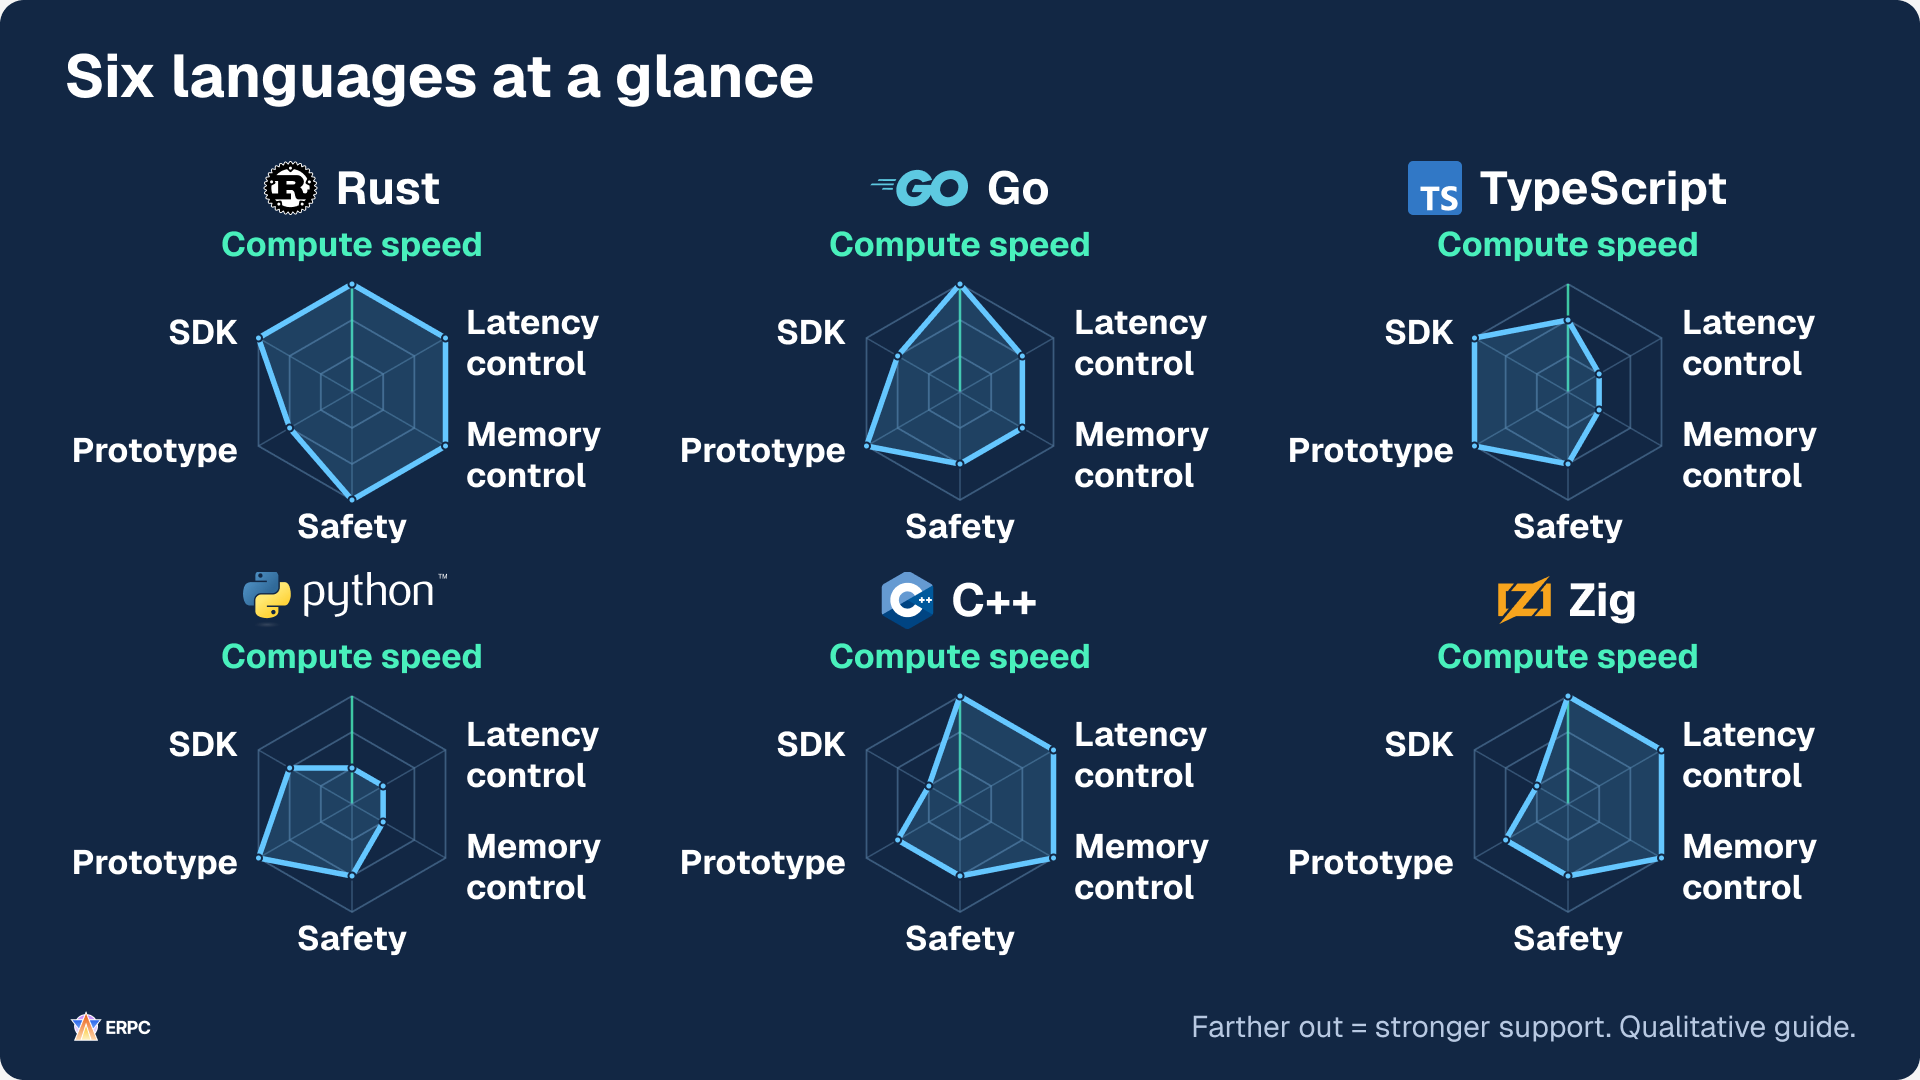
Les schémas suivants sont des guides éditoriaux de sélection à trois niveaux pour un client Solana hors chaîne. L'axe Vitesse de calcul examine les possibilités d'accélérer les lectures intensives de données et les calculs écrits directement dans le langage et l'implémentation comparés. Il ne classe ni les applications entières dominées par l'attente réseau ni les calculs délégués à des bibliothèques externes accélérées.
Rust, Go, C++ et Zig sont de solides candidats à une exécution native optimisée. Cela ne signifie pas qu'ils ont la même vitesse : un classement plus précis exige de mesurer la charge réelle. V8 transforme également les fonctions fréquemment exécutées en code machine. Décrire JavaScript comme lent au seul motif qu'il est interprété serait inexact.[20][21]
Trois dimensions, Vitesse de calcul, Contrôle de la latence et Contrôle de la mémoire, décrivent les calculs et leur contrôle. Aide à la sûreté, Facilité de prototypage et SDK Solana décrivent l'aide au développement. Les six axes ne représentent donc pas tous une vitesse de traitement.
Chaque hexagone utilise les mêmes axes et la même échelle. Une position plus extérieure indique un atout qualitatif plus fort sur cet axe. Il ne s'agit pas de vitesses ou de rapports mesurés : le niveau 3 ne signifie pas trois fois le niveau 1. Comparez les dimensions que vous souhaitez améliorer individuellement, au lieu de considérer la surface du polygone comme une note globale.
| Dimension | Ce qui est comparé |
|---|---|
| Vitesse de calcul | Les possibilités d'accélérer les lectures intensives de données et les calculs écrits directement dans l'implémentation comparée |
| Contrôle de la latence | La possibilité de tenir directement des tâches comme l'allocation et la récupération de mémoire ou l'optimisation du code à l'exécution à l'écart des traitements importants, pour limiter les délais soudains |
| Contrôle de la mémoire | La possibilité de concevoir directement la disposition des données, leur propriété et leur durée de vie, l'allocation, la réutilisation et la récupération de mémoire |
| Aide à la sûreté | L'aide des fonctions du langage, des environnements d'exécution et des outils standard pour éviter les erreurs de durée de vie et de mémoire partagée |
| Facilité de prototypage | La facilité à exécuter une petite application et à essayer des modifications ; une appréciation éditoriale qui dépend de l'expérience et du code existant |
| SDK Solana | La facilité avec laquelle la documentation officielle de Solana mène aux SDK clients et aux exemples adaptés à l'usage prévu |
Les dimensions de contrôle évaluent les possibilités directes de conception, la sûreté évalue les aides disponibles et la dimension SDK évalue le chemin proposé par la documentation officielle. Un même niveau peut correspondre à des mécanismes et garanties différents.[8][13][20][21][26]
La vue d'ensemble compare six langages sur trois colonnes et deux lignes : Rust, Go, TypeScript, Python, C++ et Zig. Comparez les dimensions qui vous intéressent, puis consultez les schémas individuels et les explications ci-dessous pour vérifier les hypothèses d'exécution et les usages adaptés.
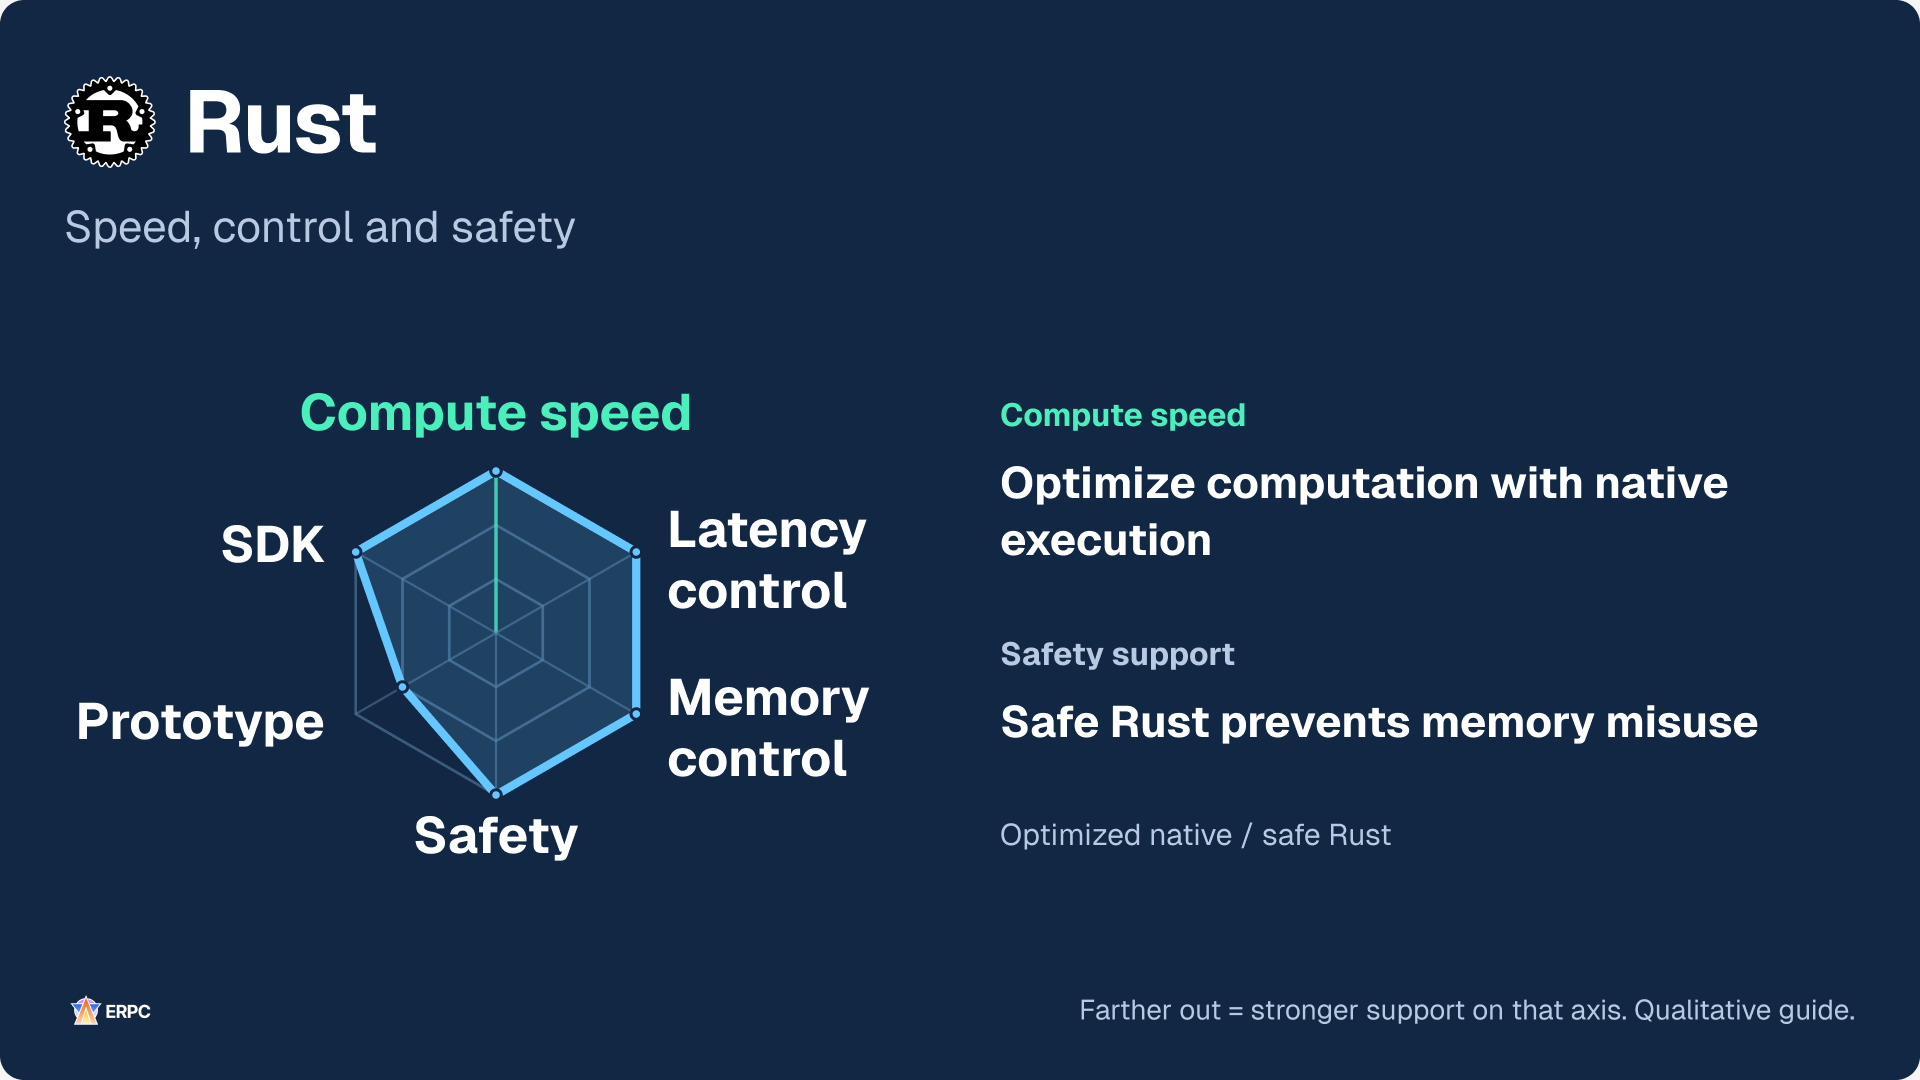
Rust associe le contrôle de la disposition, de l'allocation et de la réutilisation sur les chemins importants aux vérifications de propriété et d'emprunt. Sa gestion habituelle de la mémoire ne nécessite pas de GC par traçage.[8] Les garanties de Rust sûr contre les data races ne garantissent pas l'absence de conditions de course générales, de blocages mutuels ou d'erreurs dans la logique de décision. Le code unsafe et les interfaces avec d'autres langages demandent une vérification distincte.[22] Les copies, allocations, libérations, verrous et attentes du système d'exploitation subsistent : testez donc les entrées et la charge réelles.
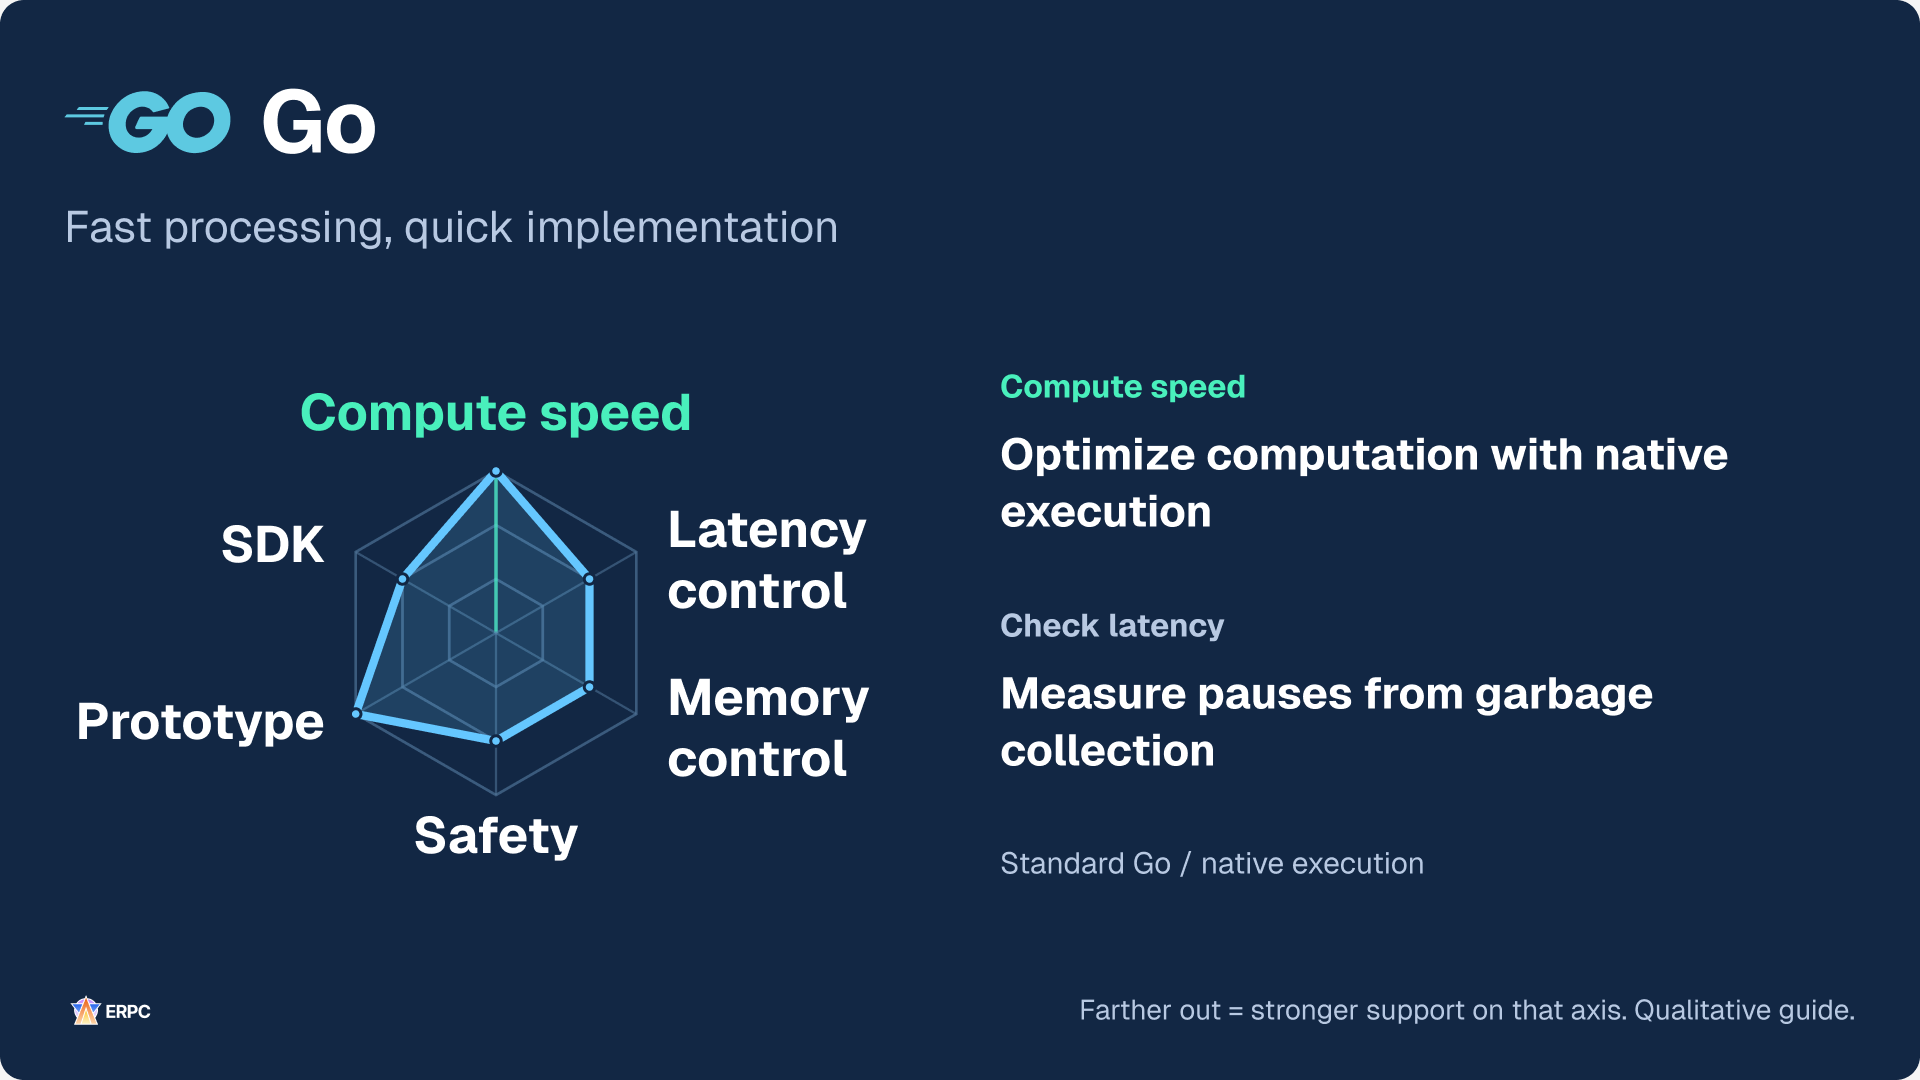
Go est lui aussi un candidat à l'exécution compilée native. Il facilite la construction de services et de traitements concurrents, tandis que son environnement d'exécution prend en charge la gestion mémoire et d'autres opérations.[20] La majeure partie du travail du GC s'effectue de manière concurrente, mais mesurez les allocations et le coût de la collecte en CPU, en mémoire et en latence. Le potentiel de traitement CPU et le contrôle direct du moment de libération sont deux questions distinctes.[13]
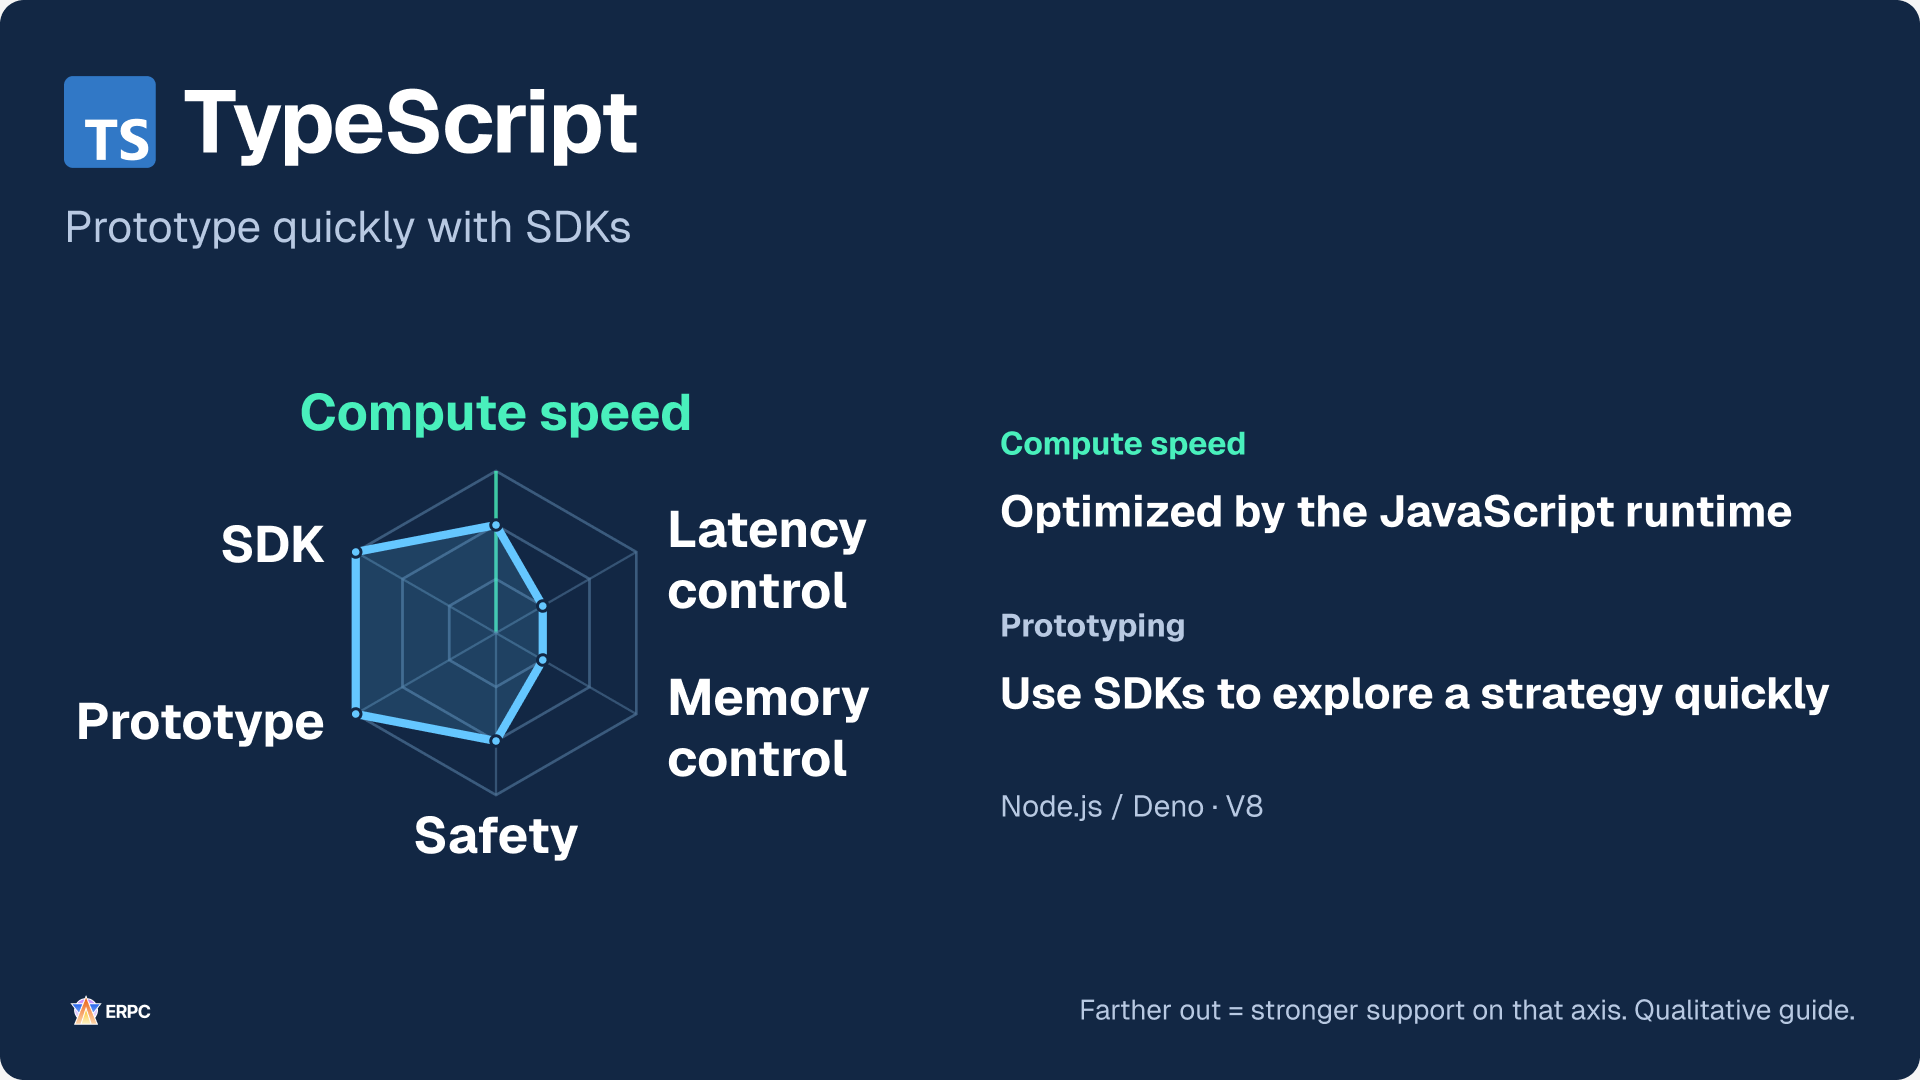
TypeScript est un langage ; Node.js et Deno sont des environnements d'exécution. Ce schéma considère JavaScript exécuté par V8. Les annotations de type sont effacées à l'exécution ; ajouter des types n'accélère donc pas en soi le travail CPU. Les données externes nécessitent toujours une validation à l'exécution.[9][10][21] Ces options peuvent servir à l'intégration d'API, à la configuration, à la surveillance, aux interfaces Web et au traitement de flux qui respecte les performances requises.
Node.js worker_threads et les Web Workers de Deno permettent de déplacer le travail CPU vers un autre contexte d'exécution. La documentation Node.js recommande un pool de workers plutôt que la création d'un worker par tâche. Incluez dans l'évaluation la conversion, la copie et l'attente avant soumission, en plus du calcul à destination.[11][12]
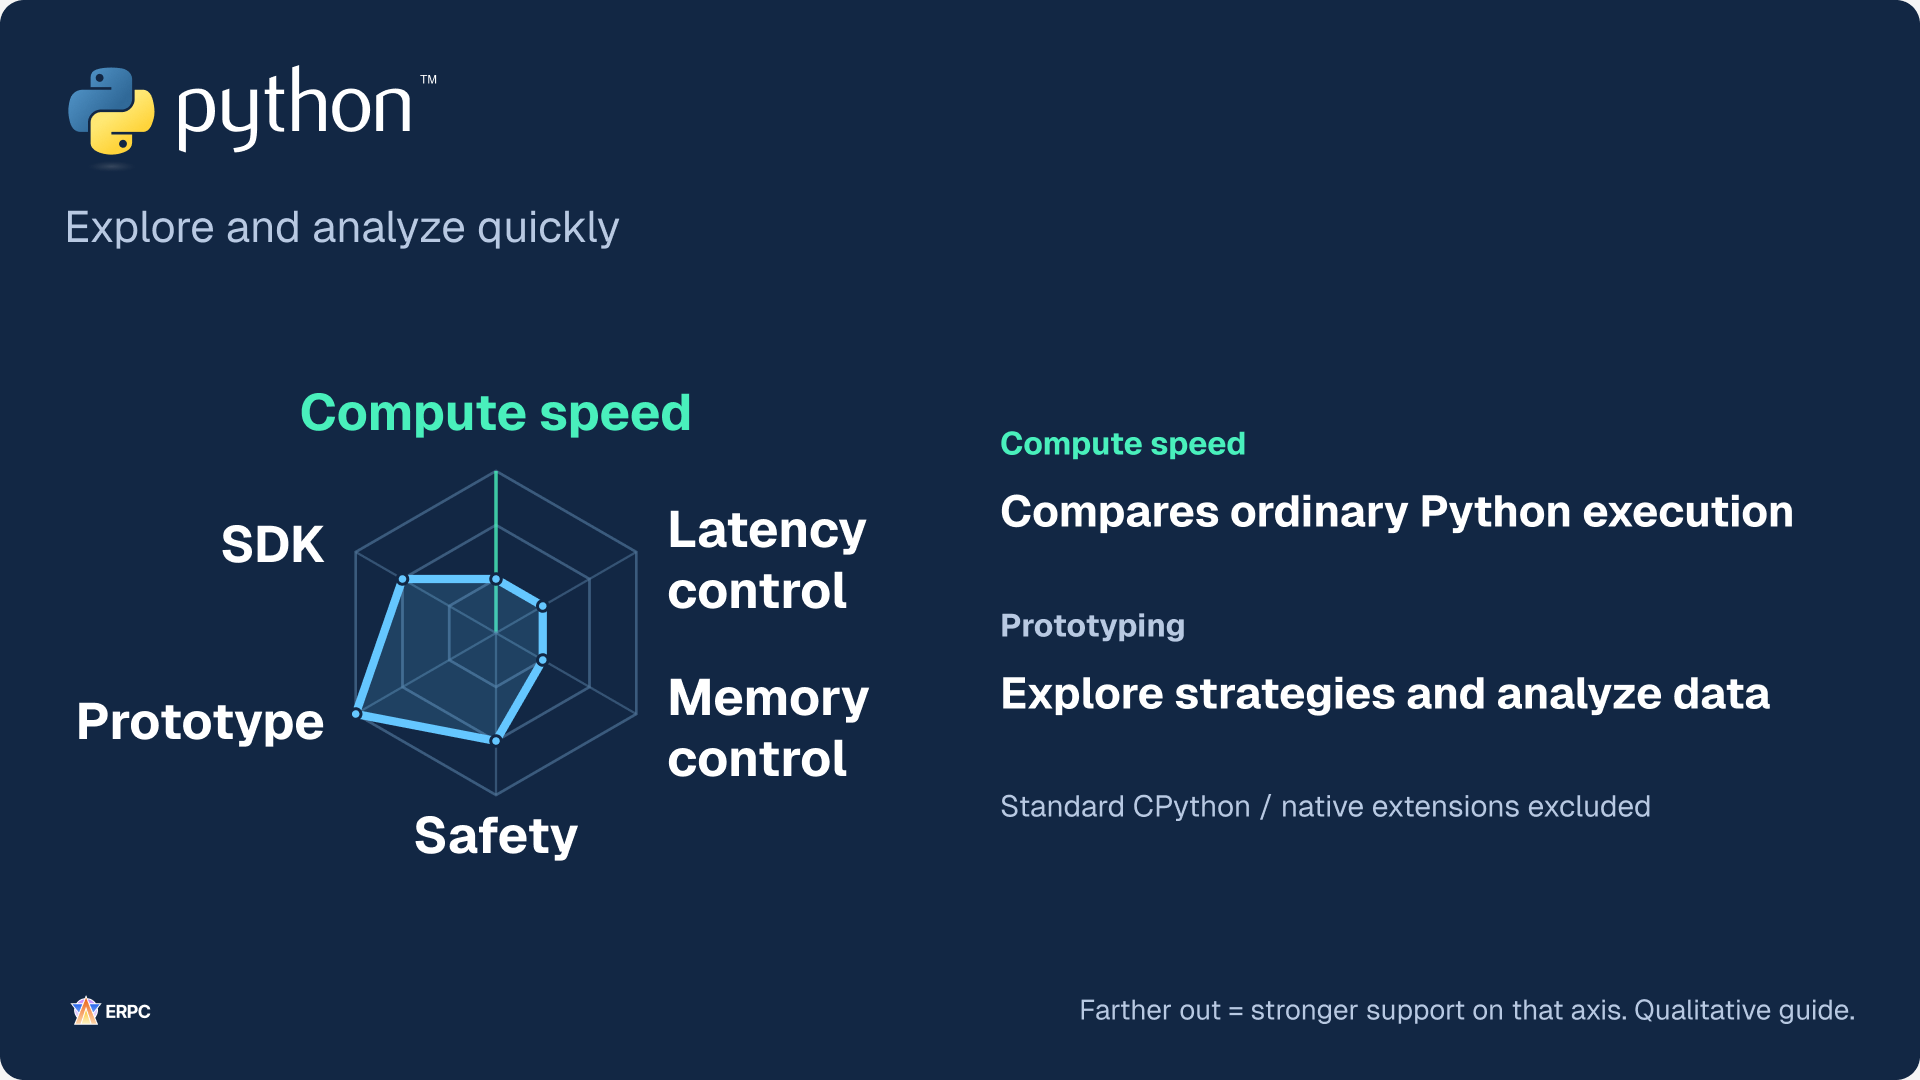
Python est un candidat pour la recherche, l'analyse, la validation et le travail avec des bibliothèques existantes. L'évaluation CPU porte ici sur les boucles écrites en Python et exécutées dans CPython ordinaire. Le calcul délégué à du code compilé, comme les opérations NumPy, relève d'un autre cas.[23] Vérifiez la configuration réelle, y compris les versions free-threaded, au lieu de décider à partir du seul nom du langage.[14] Si vous déplacez une partie vers Rust ou une autre implémentation, mesurez les conversions et copies à la frontière et vérifiez le bénéfice pour l'application entière.
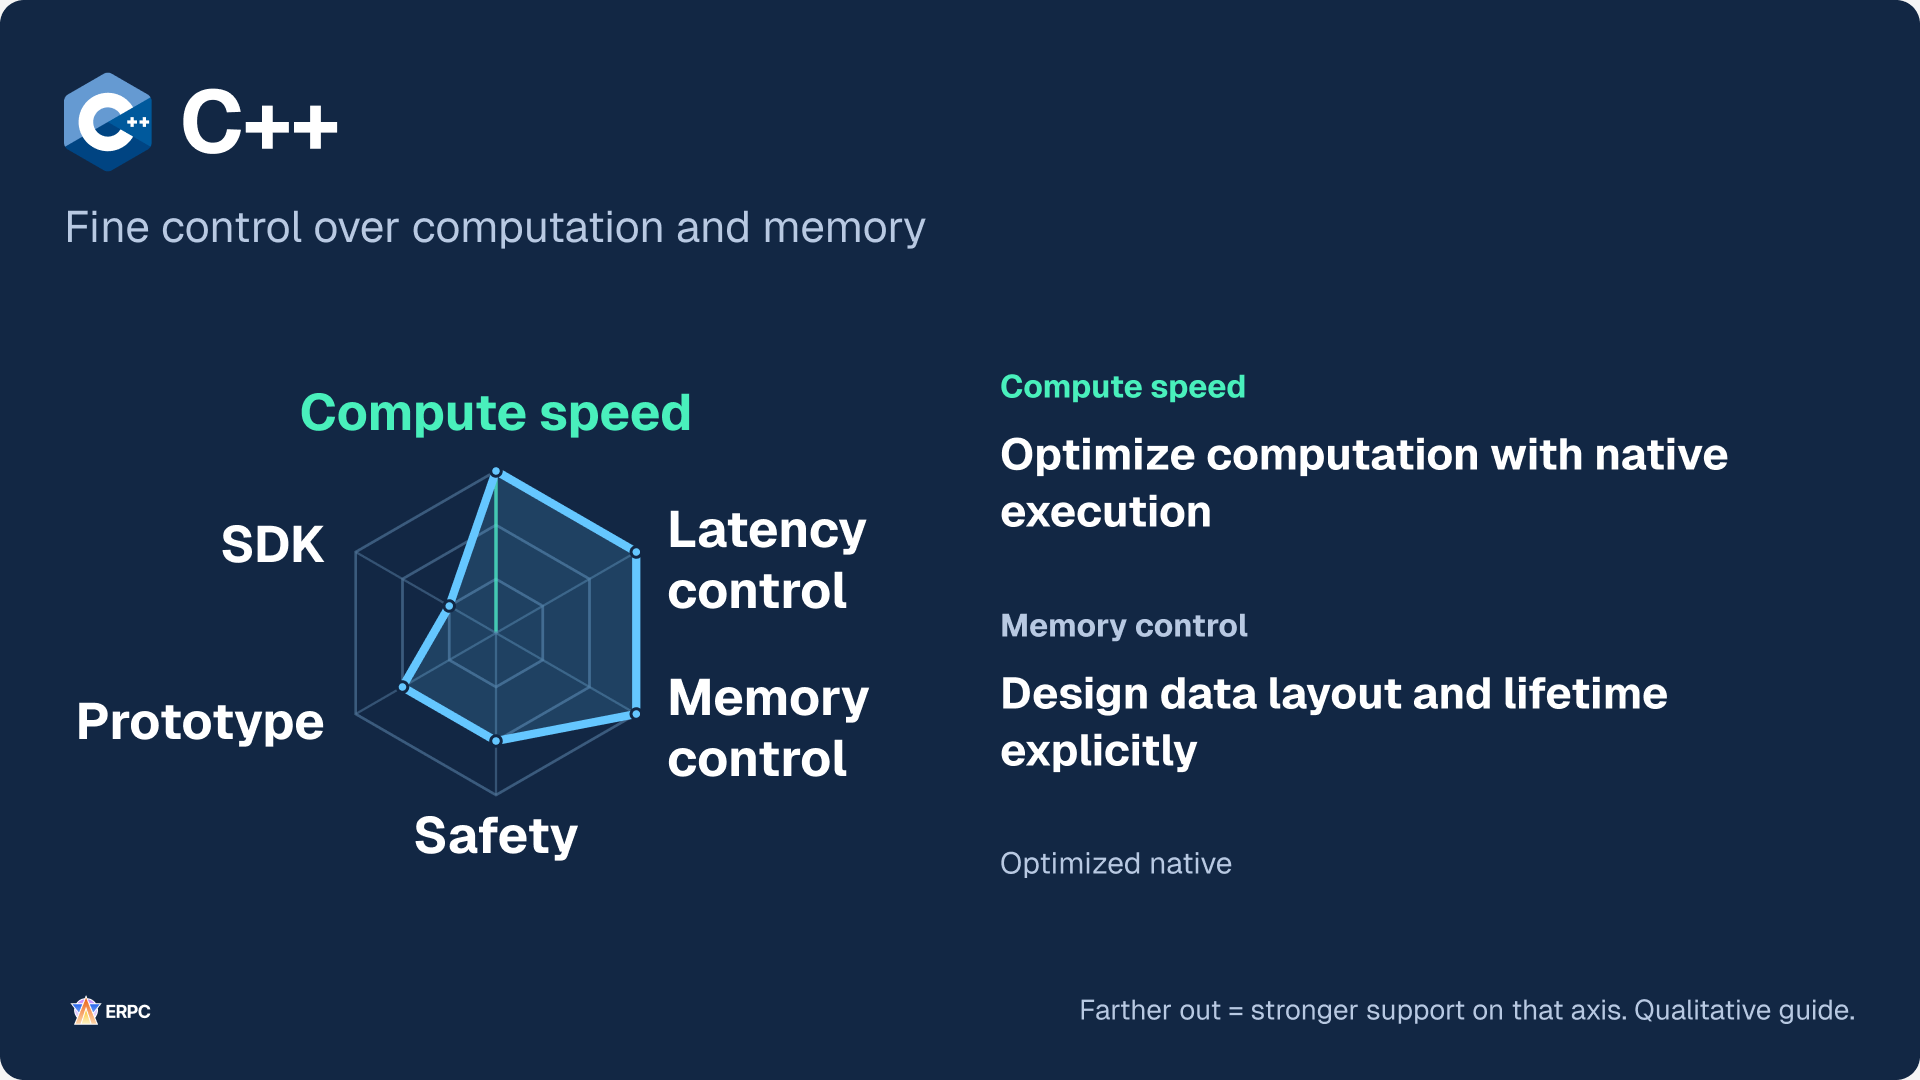
C++ associe le contrôle de bas niveau aux abstractions et aux bibliothèques existantes. RAII et les pointeurs intelligents aident à gérer la durée de vie des ressources, mais leur emploi ne garantit pas toute la sûreté des durées de vie ou de la mémoire partagée.[24] Son niveau intermédiaire de sûreté ne signifie pas non plus les mêmes garanties que celles de la mémoire gérée dans des options comme Go.
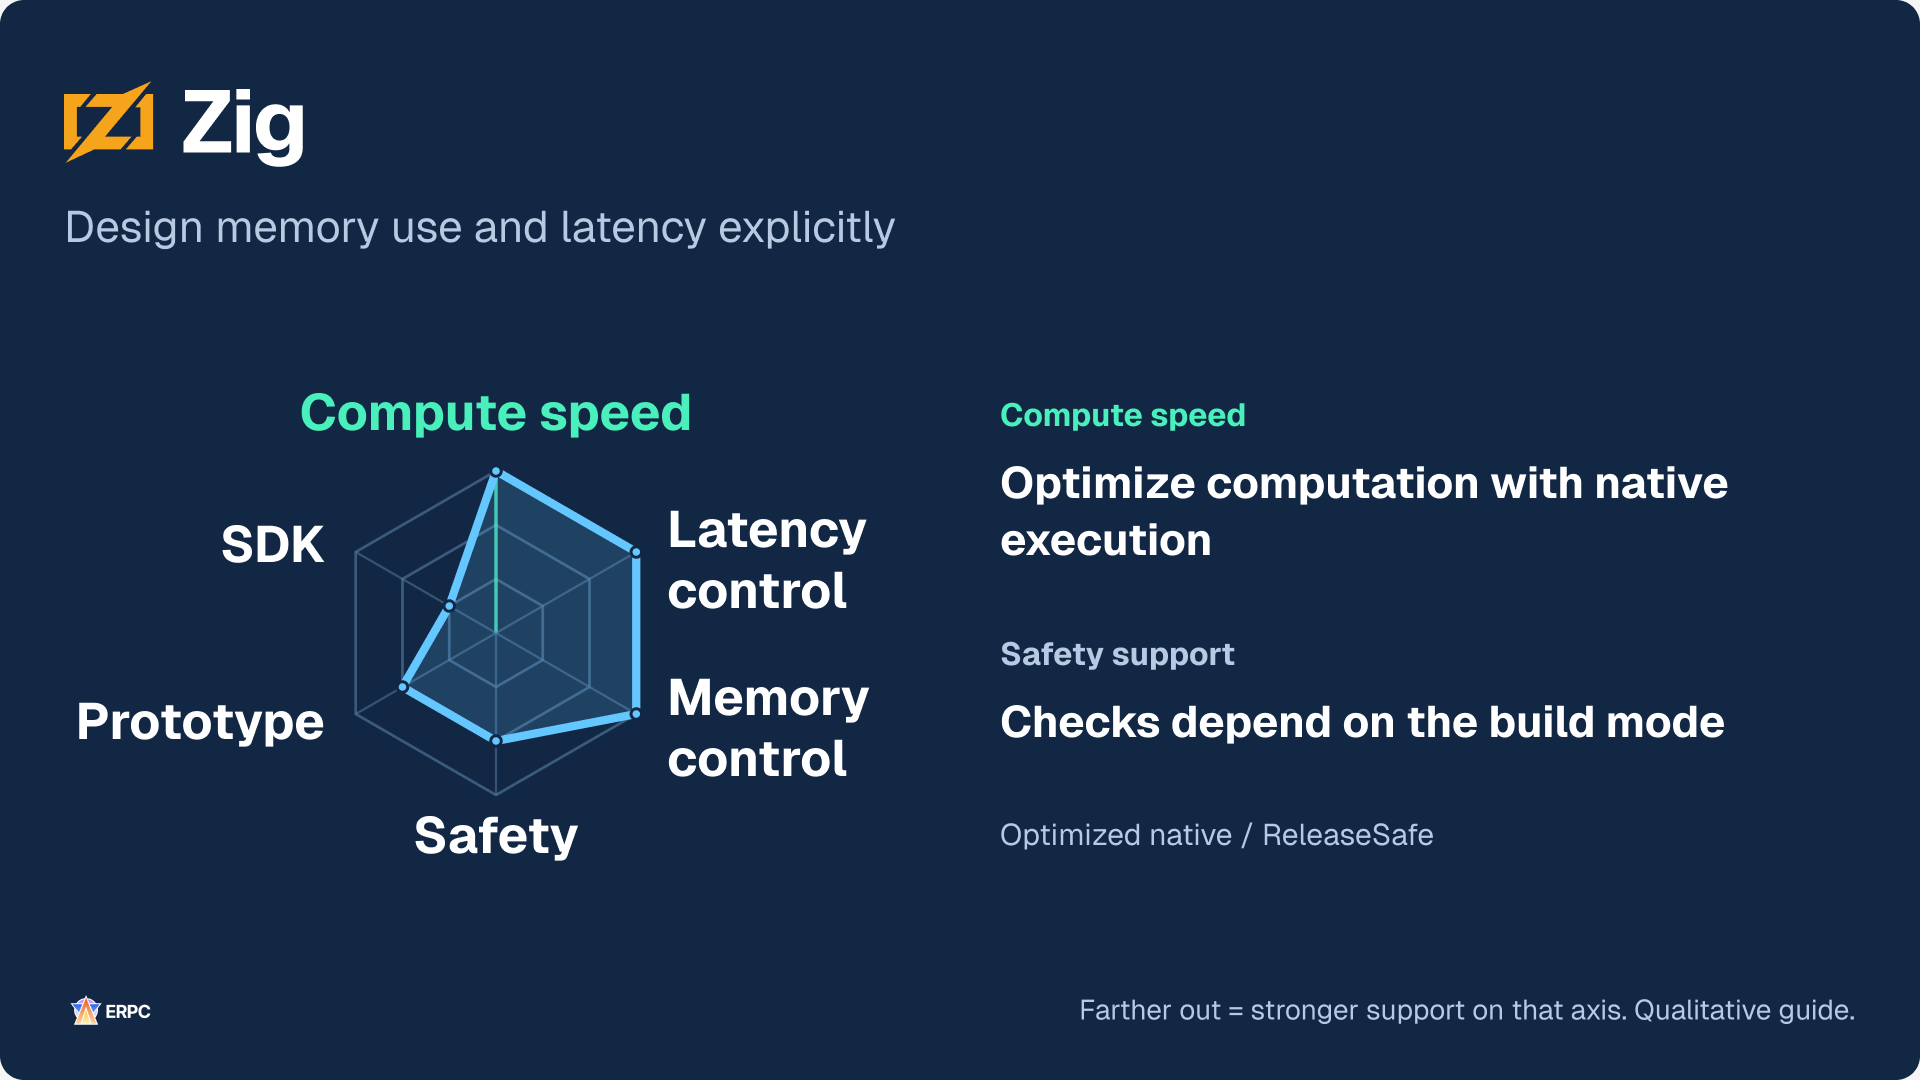
Zig permet de structurer explicitement l'allocation et le choix de l'allocateur. Ce profil suppose les vérifications de ReleaseSafe. ReleaseFast et ReleaseSmall ont des vérifications par défaut différentes, et ReleaseSafe ne détecte pas toutes les formes de comportement invalide.[25] Un polygone de même forme que celui de C++ ne signifie pas des mécanismes identiques.
La dimension SDK Solana s'appuie sur les chemins de documentation officielle pour TypeScript et Rust, ainsi que sur les clients Go et Python qui y sont répertoriés. Elle ne classe ni le nombre général ni la qualité des bibliothèques, et ne prétend pas que C++ ou Zig en sont dépourvus. Pour le SDK retenu, vérifiez les API nécessaires, le suivi de maintenance et la compatibilité avec l'environnement d'exécution choisi, y compris Deno.[26]
Mesurez où votre application passe du temps, puis choisissez les atouts dont cette partie a besoin. Réduisez d'abord l'attente et le travail répété dans le langage actuel. Si un contrôle plus fin est nécessaire, déplacer la partie concernée vers un autre langage reste une option.
Comparez les changements dans les mêmes conditions
Les instructions de chaque section couvrent la mise en œuvre et la validation de l'amélioration correspondante. Si vous appliquez plusieurs améliorations, conservez le lien entre chaque changement et ses résultats de mesure. Appliquer plusieurs changements ensemble rend plus difficile l'identification de celui qui a influencé chaque résultat.
Comparez l'avant et l'après avec les mêmes entrées, conditions d'abonnement, charges et exigences de sortie. Pour le temps entre la réception et la fin de la décision, examinez la médiane p50 ainsi que p95 et p99. Le p99 est un seuil dans lequel 99% des événements mesurés sont terminés. Il permet d'observer la partie lente de la distribution en plus du traitement habituel.
Additionner les p99 des étapes ne donne pas le p99 de bout en bout. Mesurez directement, pour chaque événement, la durée complète entre réception et fin de décision, ainsi que les attentes en file, l'usage du processeur et de la mémoire, les mises à jour manquantes ou rejetées et la concordance des résultats de décision.
Pour mesurer une durée sur un même hôte, utilisez une horloge monotone qui ne recule pas lorsque l'heure civile est corrigée. Si un SDK n'appelle un callback qu'après le décodage, un traitement a aussi eu lieu avant le début du callback. Indiquez précisément le début et la fin de chaque mesure pour distinguer la latence de livraison de celle de l'application.
Vérifiez également ce qui se passe après la soumission. Une réponse positive de sendTransaction ne garantit ni le traitement ni la confirmation par le cluster.[15] Mettre en relation réception, décision, acceptation de la soumission et résultat observé sur la chaîne aide à choisir la prochaine amélioration.
Transformez une livraison rapide en décisions prises à temps
La rapidité de livraison et la capacité de l'application à terminer les décisions nécessaires à temps comptent toutes deux. ERPC continue d'améliorer son infrastructure de livraison et de produire des informations utiles pour améliorer les logiciels qui y fonctionnent.
Validez d'abord les modifications de l'application dans le même environnement. Comparez ensuite, si nécessaire, le même code sur différents emplacements ou avec différentes ressources afin de distinguer leurs effets. Avec la facturation horaire d'ERPC, définissez à l'avance l'hypothèse, les conditions de comparaison et la durée d'utilisation, puis consultez le Dashboard pour les tarifs et disponibilités actuels.
Références et liens associés
- [1] Tokio / Tâches intensives en calcul et blocage
- [2] Node.js / Ne pas bloquer la boucle événementielle
- [3] gRPC / Contrôle de flux
- [4] Yellowstone gRPC / Messages et spécifications des abonnements
- [5] LMAX Disruptor / Conception et utilisation
- [6] Solana / Commitment
- [7] Solana / getLatestBlockhash
- [8] Rust / Propriété
- [9] TypeScript / Comportement à l'exécution et effacement des types
- [10] Deno / TypeScript
- [11] Node.js / Worker threads
- [12] Deno / Web Workers
- [13] Go / Ramasse-miettes
- [14] Python / Free threading
- [15] Solana / sendTransaction
- [16] Yellowstone gRPC / Définition des messages
- [17] Rust / std::sync::Mutex
- [18] Tokio / État partagé et partitionnement des mutex
- [19] Solana / Structure des transactions et signatures
- [20] Go / FAQ
- [21] V8 / Vue d'ensemble
- [22] Rust / Data races et conditions de course
- [23] NumPy / Qu'est-ce que NumPy ?
- [24] C++ / Recommandations fondamentales
- [25] Zig / Référence du langage
- [26] Solana / SDK clients
- [27] Programming-Language-Benchmarks / nbody
- [28] Programming-Language-Benchmarks / Measurement code (2025-07-31): execution, defaults, aggregation, Zig build, Deno configuration.
- [29] Programming-Language-Benchmarks / Published measurement data (2025-08-01)
- Logos et sources: Rust © Rust Foundation (CC BY 4.0, forme et couleurs inchangées); Zig © Zig project (CC BY-SA 4.0, forme et couleurs inchangées).
- Autres logos: Go © The Go Authors; TypeScript © Microsoft; Python © Python Software Foundation; C++ by Jeremy Kratz / Standard C++ Foundation; Node.js / OpenJS Foundation and Node.js contributors; Deno / Deno Land Inc..
- ERPC
- ERPC Web Dashboard