「Solanaのデータが遅い、少ない」そんなときに見直したい受信環境
高速なSolana Shredsストリームを契約したのに、パケットが少ししか届かない。届いたShredsを解析できても、必要な断片が揃わず、トランザクションを取り出せない。同じサーバーではgRPCが動いているため、どこを調べればよいのか分からない。
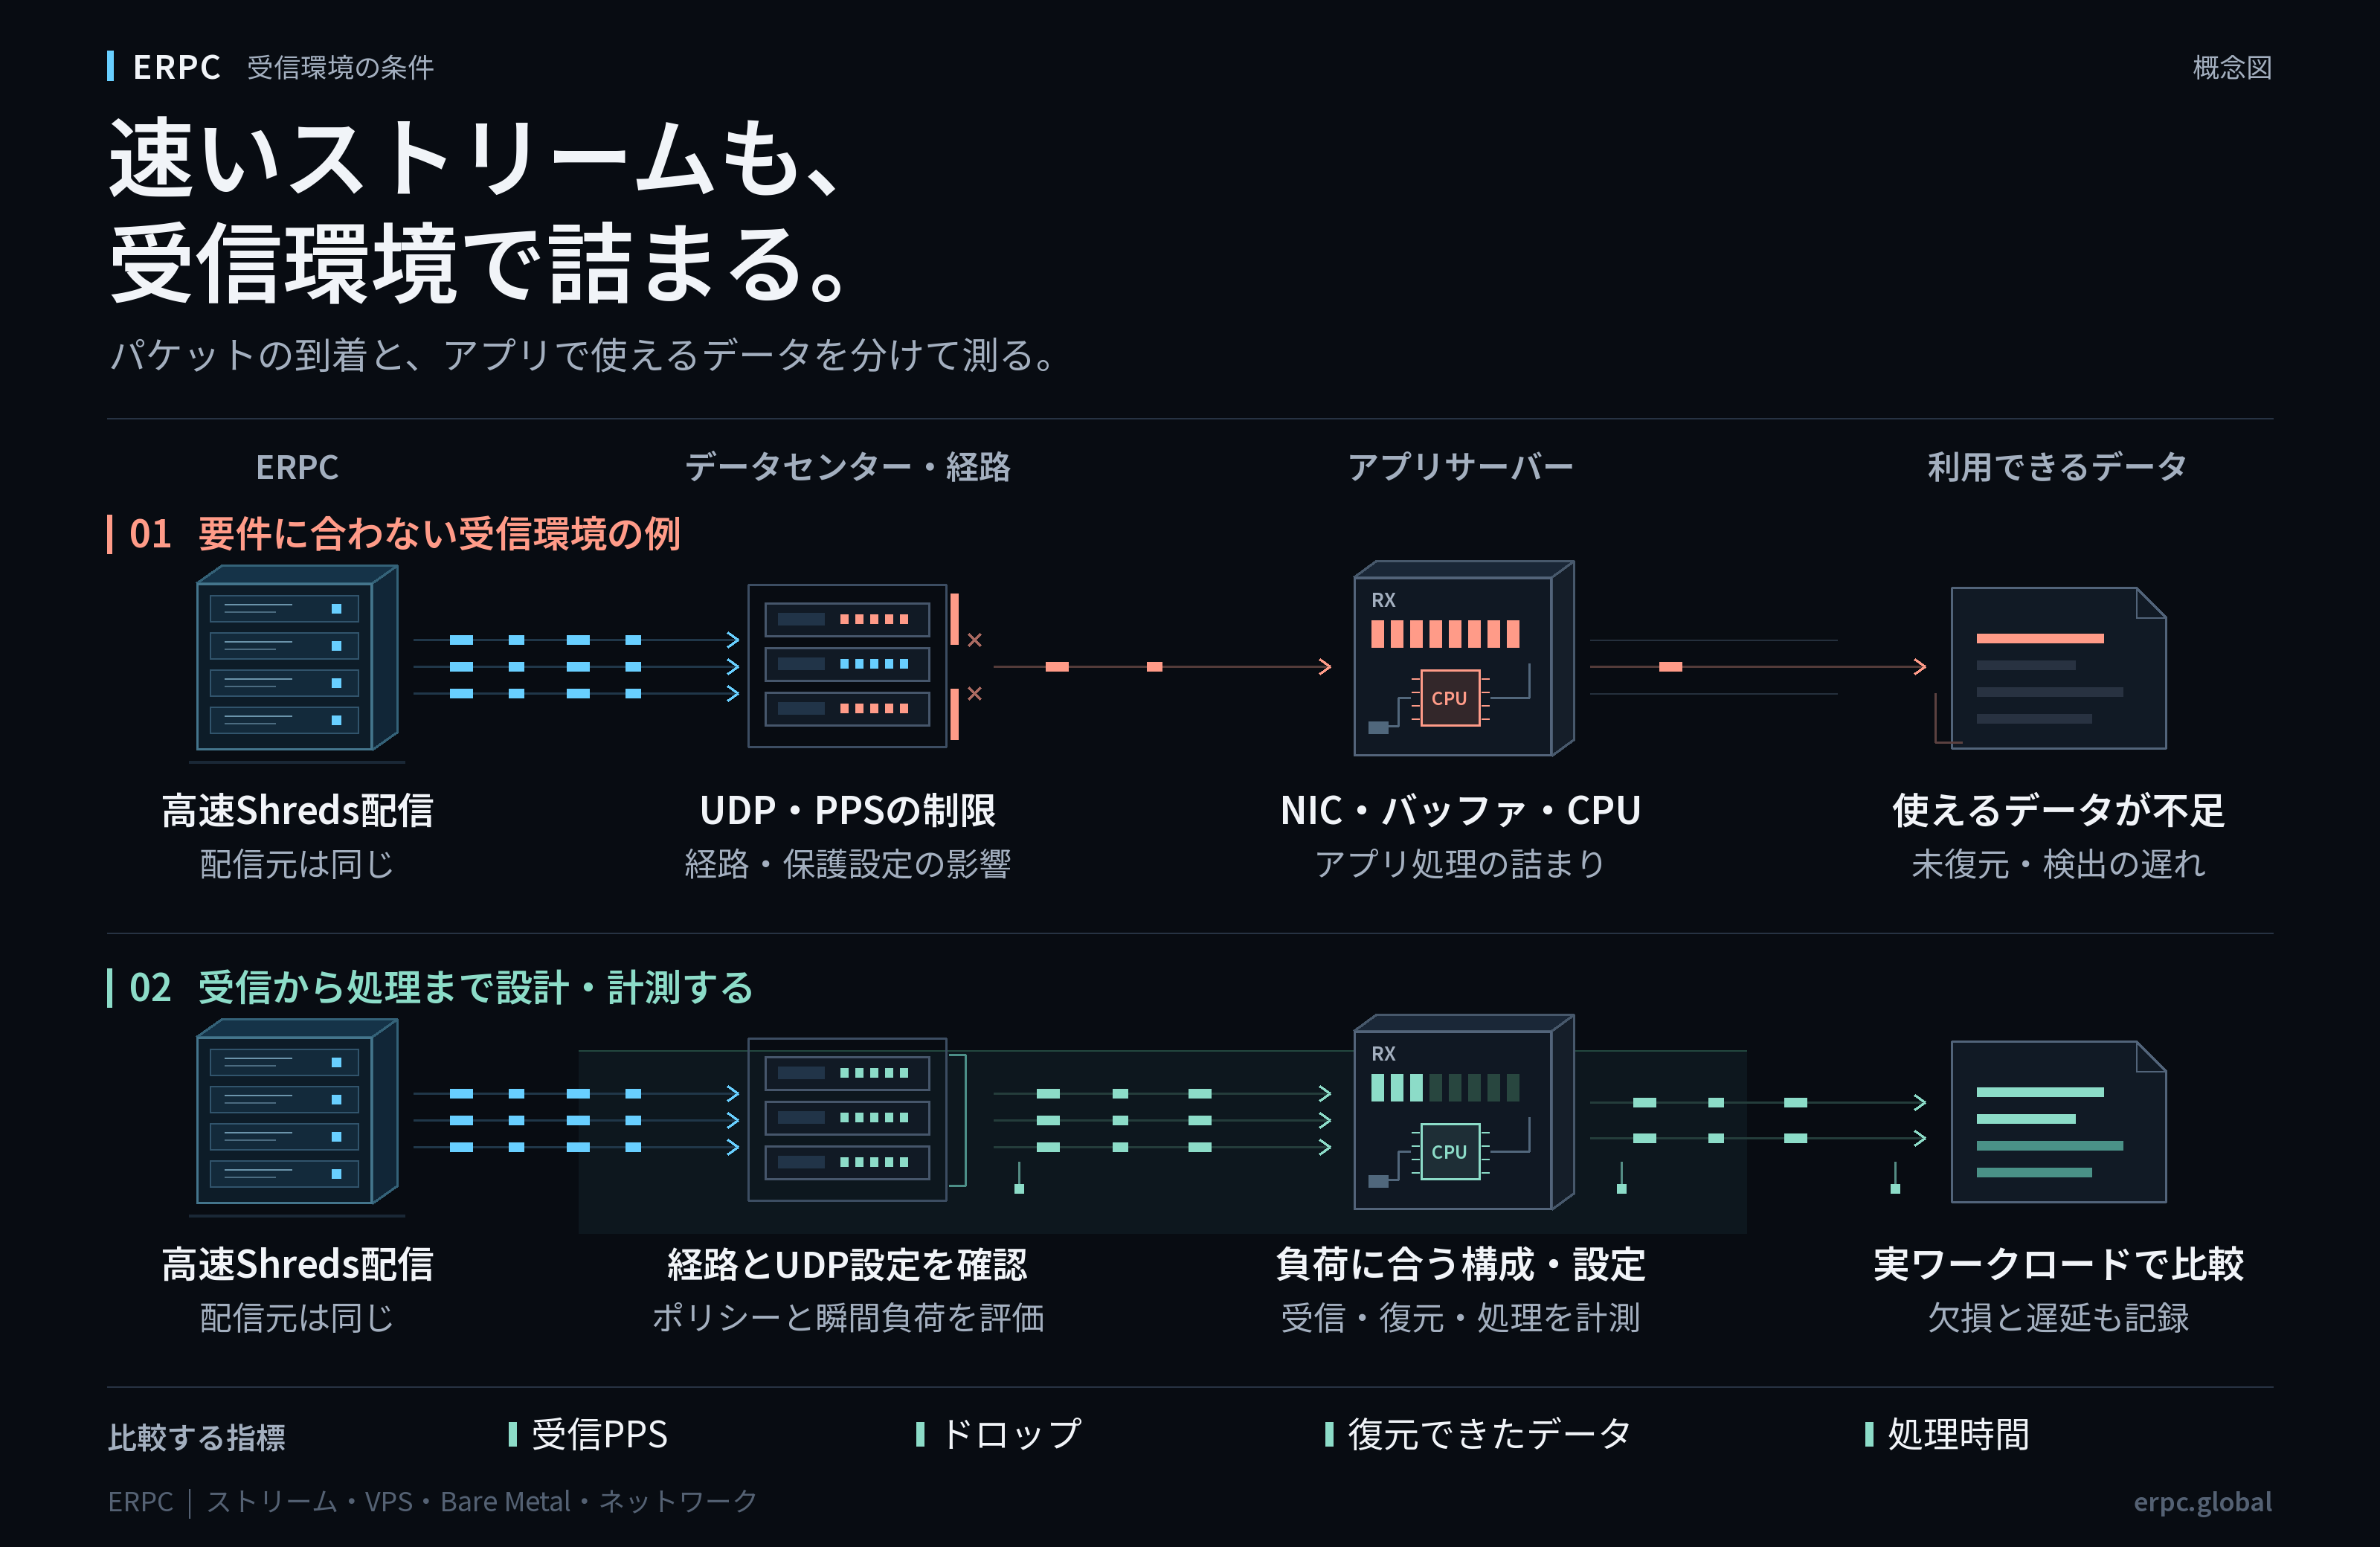
このようなとき、配信元の確認とあわせて見直したいのが、アプリケーションサーバーと、そのサーバーを置くデータセンターです。ERPCから速く配信されていても、途中のネットワークでUDPが制限されたり、受信サーバーで処理が詰まったりすれば、その速さをアプリケーションで活かせません。
Shredsを選ぶときは、届くまでの経路と、届いてから使えるデータになるまでを、一続きで考える必要があります。このネットワーク品質、距離、データセンターの運用方針は、Geyser Yellowstone gRPC、通常のRPC・API通信、トランザクション送信にも共通する性能条件です。
送信記録と、受信できたデータは別の事実
ERPCに寄せられた直近の相談では、送信側の短時間計測で約3,400〜3,900 packets/secが記録される一方、受信側からは約13 packets/secしか得られず、Slotの復元も完了しないという報告がありました。
両側の数値は測定の時間帯と集計区間が異なり、測定方法の対応も確認できていません。そのため、配信成功率や損失率を示すものではありません。送信記録だけでは相手への到達を確認できず、最終原因は記事執筆時点では未特定です。
また、数千PPSという値だけを見て、通常のサーバーでは処理できないほどの負荷だと判断するのも適切ではありません。確認したいのは、実際の経路、制限、短時間の集中、受信処理、そして何を数えたかです。
同じフランクフルトでも、通信経路は違う
配信元とアプリケーションサーバーが、どちらもフランクフルトにある。それでも、別々のデータセンターに置かれていれば、通信が一度施設の外へ出て、外部ネットワークを経由して戻ってくる構成があります。リージョン名が同じでも、施設、ネットワーク事業者、経由する機器まで同じとは限りません。
ERPCの同一拠点のストリーム・RPCとVPS・Bare Metalを組み合わせる構成では、サービスを提供するサーバーとアプリケーションサーバーを近接ラックに配置し、その間の通信を内部ネットワークで完結させます。これが、ERPCの「ゼロ距離通信」の発想です。都市名だけを合わせるより踏み込み、受信アプリまでの物理配置と通信経路を一緒に設計します。
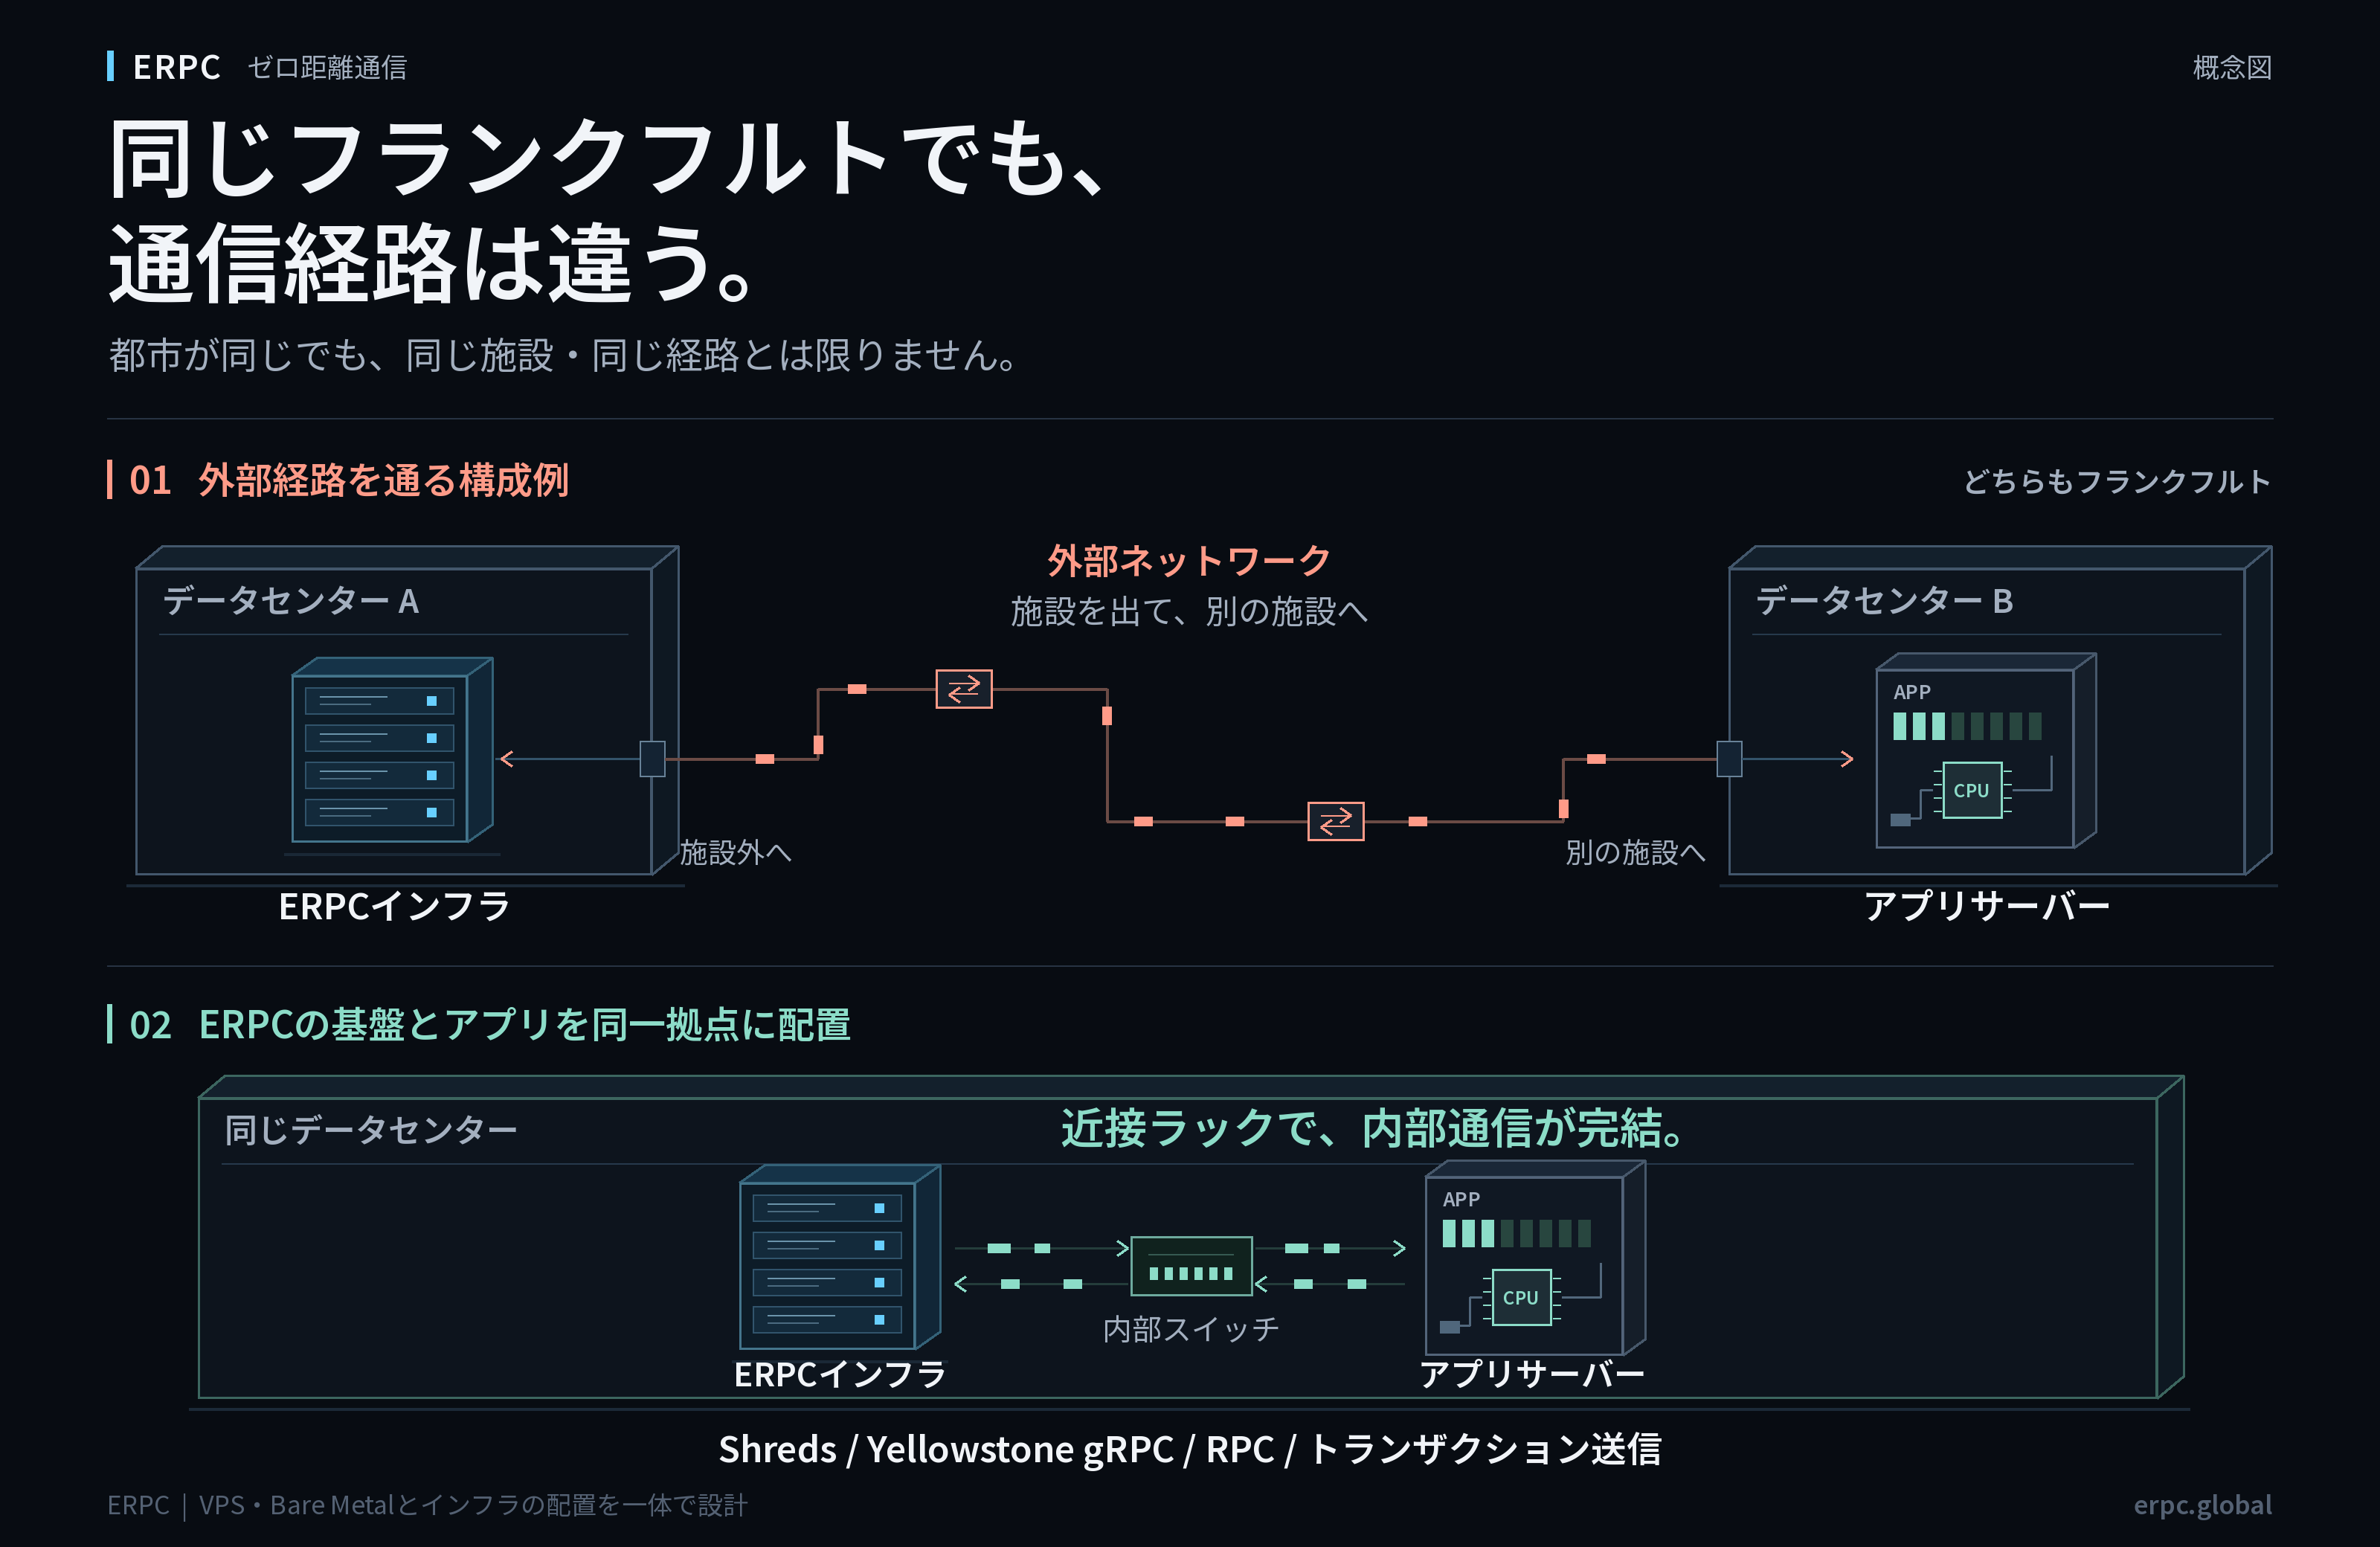
ERPCのサービスとアプリケーションサーバーの間で外部への迂回を避けることで、経路を短くし、その区間で外部ネットワークの混雑や経路変動に左右される要因を減らせます。短い経路と、受信・処理に必要なリソースを組み合わせることが、高速ストリームを活かす土台になります。結果は、パケット到着とアプリケーション処理の両方で確かめます。
ネットワークの条件は、すべての通信に影響する
Shredsでは欠損した断片が目に見える問題になりますが、同じ基盤の品質は、データの受信、APIへのリクエスト、トランザクション送信に広く影響します。プロトコルによって、アプリケーションが見る症状や測定する場所が変わります。
| 通信 | ネットワークの影響が表れる場所 | アプリケーションで確かめるもの |
|---|---|---|
| Shreds / UDP | パケットの欠損・遅延、復元に必要な断片の到着 | 有効なShredsと、データを復元できるまでの時間 |
| Geyser Yellowstone gRPC | TCPの再送待ち、ストリームの滞留・遅れ | 同じ更新を受信して処理できるまでの時間 |
| RPC・API・サービス間通信 | リクエストと応答の往復、混雑時の待ち時間 | 応答時間と、そのばらつき |
| トランザクション送信 | 送信先ノードまでのリクエスト経路 | 送信要求からノードの応答を受け取るまでの時間 |
近接配置と適切な運用方針は、この通信全体を支えます。送信先ノードからの応答時間と、チェーン上で採用・確定されるまでの時間は別々に測定します。
回線のGbpsだけでは分からない、PPSとバースト
帯域は、一定時間に運べるデータの量です。PPSは、1秒あたりに処理するパケットの数を表します。回線帯域に余裕があっても、パケット数の上限やUDPに適用される制限に達することがあります。実際に、クラウドの公式資料でも、帯域とPPSの上限は別の制約として扱われています。[1]
さらに、Shredsの到着は常に均等とは限りません。短時間にまとまって届くバーストでは、平均値から見えないキューの混雑が生じます。ネットワーク機器や受信側が処理するより速くパケットが積み上がれば、待ち行列を超えた分が破棄される可能性があります。[2]
受信先の事業者には、回線速度だけでなく、継続的なUDP受信と瞬間的な集中を許容するか、PPS制限やDDoS保護がどう適用されるかを確認してください。保護機能を一律に無効化するのではなく、必要な通信を安全に受け入れられる条件を確認することが重要です。
gRPCが動いていても、UDPの受信は別に確認する
TCPベースのgRPCとRaw ShredsのUDP転送では、通信の仕組みが異なります。TCPには再送と順序制御があり、gRPCのストリーミングには受信側の容量に合わせるフロー制御があります。UDP自体には、欠けたパケットを再送したり、受信アプリの処理に合わせて送信を待たせたりする仕組みがありません。[3]
そのため、同じサーバーでgRPCが正常に動くことは、UDPの経路や受信処理も正常である証拠にはなりません。プロトコルごとのフィルター、ポート、送信経路、受信実装を分けて確認する必要があります。gRPC側も、処理の遅れが待ち時間や切断として表れる場合があります。
なお、gRPCのtransactions/secとUDPのpackets/secは単位も処理段階も異なります。この2つの数値から、配信量や欠損率を直接比較することはできません。
パケットの到着から、使えるデータになるまで
一般的なUDPソケット受信では、ホストに到着したパケットはNIC、カーネル、ソケットの受信バッファを経由してアプリケーションに渡されます。この途中で処理が追いつかなければ、ホストに届いた後でも破棄され得ます。Linuxのインターフェース受信カウンターには、後段で破棄されたパケットが含まれるため、受信数の増加だけでアプリへの到達を確認したことにはなりません。[4]
CPU全体の使用率が低くても、特定の受信キューやコアに処理が集中することがあります。NICのキュー構成、割り込みの配置、CPUの単一コア性能も確認対象です。アプリケーション側では、受信ループに重い解析や大量のログ出力を詰め込まず、受信と後段の処理を適切に分けます。受信バッファは一時的な集中を吸収しますが、継続的な処理能力の不足を解消するものではありません。[5]
Shredsはブロックデータの断片です。FEC(前方誤り訂正)は同じグループのdata shredsとcoding shredsを使って欠損を補えますが、復元に必要な断片が不足すれば元のデータを取り出せません。重複パケットが増えても、欠けている断片の代わりにはなりません。[6]
実装によってはSlot全体の完了を待たず、必要な断片が揃った部分からentriesを復元できます。[9]評価したいのは総パケット数に加え、重複を除いた有効なShreds、復元できたデータ、そして目的のイベントをアプリケーションが認識するまでの時間です。
どこで詰まっているかを、同じ時間帯で測る
送信側と受信側で、対象の宛先・ポート・時間窓を合わせます。そのうえで、次の段階を分けて記録すると、次に調べる場所が絞れます。
| 測定する場所 | 記録するもの | 判断できること |
|---|---|---|
| 配信側 | 対象宛先への送信記録と、カウンターの定義 | 送信側でどの段階まで確認できたか |
| 受信ホストの入口 | 対象UDPのキャプチャ、NIC統計、キャプチャ自身の取りこぼし | 観測地点でどれだけ確認できたか |
| OS・ソケット | UDPエラー、受信バッファのドロップ、キューの増減 | ホスト内で受信処理が詰まっていないか |
| Shredsの復元 | 有効なユニークShreds、復元の成功・不足・エラー | パケットから必要なデータを取り出せているか |
| アプリケーション | 処理待ちと、同じイベントを認識する時刻 | 受信の速さを実際に活かせているか |
キャプチャの受信数が少なければ、まずフィルター条件、観測インターフェース、キャプチャ自身の取りこぼし、NIC側の損失を照合します。OSカウンターにはホストやネットワーク名前空間全体のものもあるため、集計範囲を確認して対象アプリの測定と対応付けます。[4][5]
設定変更は、詰まっている場所を確認してから行います。バッファやリングを大きくするだけでは、問題を別の場所へ移したり、待ち時間を増やしたりする場合があります。具体的なERPCの受信設定と確認手順は、現行ドキュメントにまとめています。
サーバーの仕様と、運用方針まで選ぶ
Solana Foundationは、高性能バリデータについて、NIC、物理コア、ドライバー、ネットワークなどを制御できる環境の重要性を説明しています。ただし、バリデータ全体の要件を、すべてのShreds受信アプリにそのまま当てはめる必要はありません。受信アプリでは、自分のストリームと処理内容に見合う構成を選びます。[7]
コストや消費電力を抑える運用には、それぞれの合理性があります。一方、HFTやリアルタイムアプリケーションでは、CPUがすぐ処理を始められること、負荷が続いても処理能力を維持できること、ネットワークの待ち時間を抑えることが重要です。省電力状態からの復帰時間も、遅延とのトレードオフになります。[8]
確認したいのは、CPUの型番やコア数に加えて、共有リソースの扱い、継続負荷への方針、UDPの運用条件、実際のネットワーク経路です。
ERPCは、ストリームと受信環境を一体で考える
ERPCは、Solanaのインフラに近いデータセンターの選定、ネットワーク経路、ハードウェア、運用設定に取り組み、ShredsやgRPCとあわせてVPS・Bare Metalを提供しています。必要な処理量に応じてVPSを選び、物理リソースを専有したい場合はBare Metalを比較できます。
提供している環境の構成と運用を理解していることは、サポートにもつながります。送信側の記録と受信側の測定を照合し、ネットワーク、OS、アプリケーションのどこを次に調べるべきか、具体的な確認を進められます。今回の相談でも、送信側の計測結果を確認し、受信側の追加計測を依頼しています。
ストリームの選択、受信ホストの配置、処理の実装を一緒に評価することで、期待するデータを得るために何が足りないかを判断しやすくなります。
時間課金で、現在の環境と比較する
現在の受信環境に疑問があれば、ERPCのVPSまたはBare Metalを時間課金で試し、同じストリームとアプリケーションで比較してください。希望リージョンの料金、空き状況、注文条件はダッシュボードで確認できます。
まずは利用可能な構成で、受信数、復元できたデータ、処理待ち、同じイベントの認識時刻を記録します。別ホスト間で時刻を比較する場合は、時計の同期精度も確認します。時間帯を変えて測定し、どの段階で違いが出るかを比べてください。その結果をもとに、ご自身のアプリケーションに合うサーバーとデータセンターを選べます。
- VPS: https://erpc.global/ja/vps/
- Bare Metal: https://erpc.global/ja/baremetal/
- ダッシュボード: https://dashboard.erpc.global/ja/
関連記事
- Solana Stream SDK v4.0.0: https://erpc.global/ja/news/2026/11/07/erpc-solana-stream-sdk-v4-20261107/
- [9] Shreds UDP Forwarding Premium: https://erpc.global/ja/news/2026/11/03/erpc-shreds-udp-forwarding-premium-20261103/
- Validators DAO 公式 Discord: https://discord.gg/C7ZQSrCkYR
技術資料
- [1] AWS EC2の帯域・PPS上限: https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/monitoring-network-performance-ena.html
- [2] IETF UDP Usage Guidelines、バースト: https://www.rfc-editor.org/rfc/rfc8085.html#section-3.1.6
- [3] Linux UDP: https://man7.org/linux/man-pages/man7/udp.7.html
- [3] Linux TCP: https://man7.org/linux/man-pages/man7/tcp.7.html
- [3] gRPC Flow Control: https://grpc.io/docs/guides/flow-control/
- [4] Linux Interface statistics: https://docs.kernel.org/networking/statistics.html
- [4] libpcapのキャプチャと取りこぼし: https://github.com/the-tcpdump-group/libpcap/blob/master/doc/README.linux
- [5] Linuxネットワーク処理の分散: https://docs.kernel.org/networking/scaling.html
- [5] Linuxソケット受信バッファ: https://man7.org/linux/man-pages/man7/socket.7.html
- [5] Red Hat UDPのドロップ調査: https://docs.redhat.com/en/documentation/red_hat_enterprise_linux/10/html/network_troubleshooting_and_performance_tuning/tuning-udp-connections
- [6] Anza Turbine Block Propagation: https://docs.anza.xyz/consensus/turbine-block-propagation/
- [7] Solana Foundation、高性能バリデータのハードウェア: https://solana.com/news/high-performance-solana-validators-run-on-bare-metal-hardware
- [8] Linux CPU Idle Time Management: https://docs.kernel.org/admin-guide/pm/cpuidle.html