あなたのアプリをもっと速く。Solana gRPCのデータ量・受信処理・実行環境を見直す
あなたが開発しているSolanaアプリは、もっと速く動く可能性があります。受け取るデータの量、受信後の処理の流れ、CPUやネットワークなどの実行環境。その組み合わせを見直すことで、いまのソフトウェアの性能をさらに引き出せるかもしれません。
SolanaでHFTの開発を始め、Geyser gRPCにも接続できた。ログにはデータが流れている。それでも、判断が期待した速さに届かない。こんなときは、受信から判断までに生まれる待ち時間が、改善の手掛かりになります。まず、現在のコードで観測できる場所を見つけるところから始めましょう。
ERPCでも、お客様とのご相談やフィードバックを通して、配信、受信設定、アプリケーションの処理を見直す機会をいただいています。そこで得た観点を、配信とドキュメントの改善に生かしています。この記事では、初めて高速・大容量ストリームを扱う方が、自分の環境で改善の余地を探せるように、仕組みと調べ方を紹介します。
まずは、いまのコードから小さく確かめる
専門用語や診断コマンドは、必要になったところから調べられます。プロジェクトのコードを読めるAIエージェントがあれば、最初は次の短い依頼文を渡してみてください。実行場所と、どの場面で遅さを感じるかを添えれば、未定の要件や取れない数値は、そのまま残して始められます。
text
私のSolanaアプリに、応答を速くできる余地があるか調べたいです。
まず現在のコードを読み、データを受け取る地点と、そのデータを使う判断が完了する地点を示してください。購読条件を変えずに、その区間の件数と経過時間を測る最小の変更案を作ってください。
今回は、計測箇所・変更案・そこから分かることと未測定のことを示すところまでで大丈夫です。ホストに入れない場合はアプリ側で確認できる範囲から始め、秘密情報は表示しないでください。本番の変更や有料リソースの作成は行わないでください。
私のSolanaアプリに、応答を速くできる余地があるか調べたいです。
まず現在のコードを読み、データを受け取る地点と、そのデータを使う判断が完了する地点を示してください。購読条件を変えずに、その区間の件数と経過時間を測る最小の変更案を作ってください。
今回は、計測箇所・変更案・そこから分かることと未測定のことを示すところまでで大丈夫です。ホストに入れない場合はアプリ側で確認できる範囲から始め、秘密情報は表示しないでください。本番の変更や有料リソースの作成は行わないでください。最初に知りたいのは、自分のコードのどこで、何を測ればよいかです。観測できた区間と未測定の区間を分けておくと、次に調べる場所を選びやすくなります。さらに切り分けたいときに使える詳しいプロンプトも、後半に用意しました。
AIからは、たとえば「受信は
stream.ts の onData、判断完了は strategy.ts の onDecisionComplete。受信件数・判断完了件数と、その区間の経過時間を集計する変更を提案します。この案では、コールバックより前の区間は計測対象外です」という返答が考えられます。これはTypeScriptの仮のファイル名・関数名を使った見本です。言語にかかわらず、実際のコード上の場所、追加する記録、今回分からない範囲の三つが対応しているかを確認しましょう。受信と判断が1対1でなければ、対応関係と集計単位も提案してもらいます。Web開発の経験に、ストリームを見る観点を加える
マネージドサービスを使うWeb開発では、サーバーの細かな構成を意識せずに機能を作れる場面が増えました。Solanaのストリームを扱うときも、その開発経験を土台にできます。そこに、継続的に流れ込むデータの量と、それを処理する速さを見る観点を加えていきます。
SolanaでもSDKで接続する手順は簡単です。しかし、広い範囲のトランザクションやアカウント更新を購読すると、アプリケーションが扱う仕事量は大きく変わります。必要な帯域やCPU・メモリは、購読対象、メッセージの大きさ、圧縮、処理内容、時間帯で変わります。「Solanaなら毎秒何MB」と一つの値には固定できません。
データが来る速さに、処理する速さが追いついているか。この関係を設計と測定の対象に加えることが、出発点です。
データが流れていても、待ち時間は積み上がる
まず、同じ1秒間に届くデータを、同じ大きさの四角で比べます。図の四角1個は1,000件のメッセージで、1件を1 kBと仮定すると合計1 MBです。少ない例では毎秒2 MB、多い例では毎秒12 MBが届き、受信するアプリの処理能力はどちらも同じです。10進単位のメッセージデータ量を表す説明用モデルで、圧縮や通信ヘッダは含めていません。
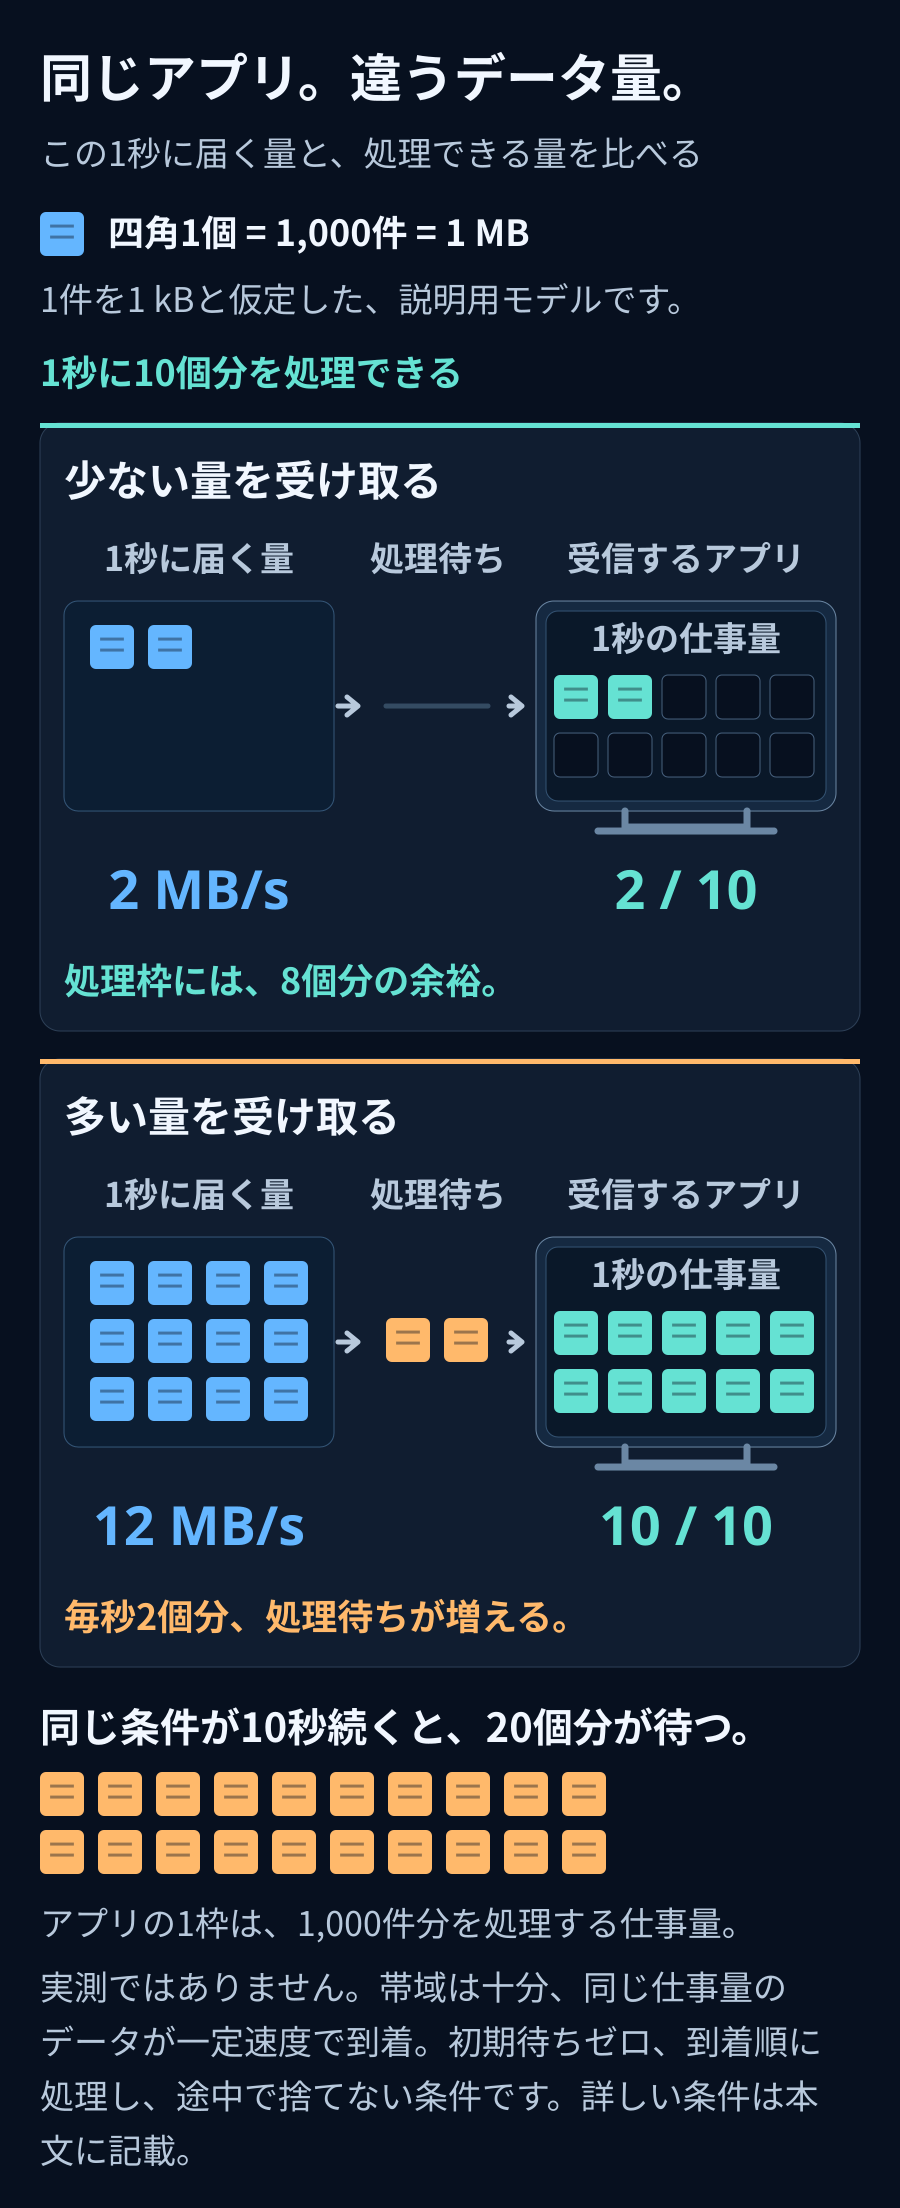
説明用に、1件当たりの仕事量が同じデータが毎秒12,000件届き、コンピューターが毎秒10,000件処理できるとします。初期の処理待ちはゼロで、到着順に処理し、途中でデータを捨てない条件です。
毎秒2,000件が未処理として残ります。10秒後には20,000件が待ち、その時点で新しくキューに入るイベントには、処理開始まで約2秒の待ちが生じます。ログは流れ続けますが、待ち行列は伸びています。
この数値はSolanaやERPCの実測ではありません。一定の流入・処理能力を仮定した説明用モデルです。実際にはデータの集中や1件ごとの処理時間の差があるため、平均の処理能力が足りていても待ち時間は発生します。
gRPCのflow controlは、受信側が受け取れる量に合わせて送信を調整します。処理が遅いと、アプリ内だけでなく、通信ライブラリや送信側まで待ちが広がる場合があります。接続が続いていることや、送信APIへの書き込みが成功したことだけでは、届いた時点の鮮度はわかりません。[1]
必要なデータを、ネットワークの手前で選ぶ
特定のプログラムやアカウントの情報だけで判断するなら、まず必要なデータを定義し、購読時のサーバー側フィルターを使います。Yellowstone gRPCには、トランザクションやアカウントを対象とするフィルターがあります。具体的な条件の組み合わせと利用可能な範囲は、使っているAPI・SDKとサービスの仕様で確認します。[2]
何を絞ればよいか分からない場合は、アプリが判断に使う値と、その値がどの通知のどの項目から得られるかをコードから整理します。そこから購読条件の候補を作り、既知の必要なイベントが含まれるかを検証します。件数の削減と、必要なデータが残っていることを一緒に確認すると、安心して次の比較に進めます。
全件を受信してからクライアント側で不要なデータを捨てても、そこまでの転送や復号・デコードの仕事はすでに発生しています。送信側で対象を絞れば、この仕事量から減らせます。上の例で必要な入力を毎秒2,000件に絞れれば、同じ毎秒10,000件の処理能力にも余裕ができます。
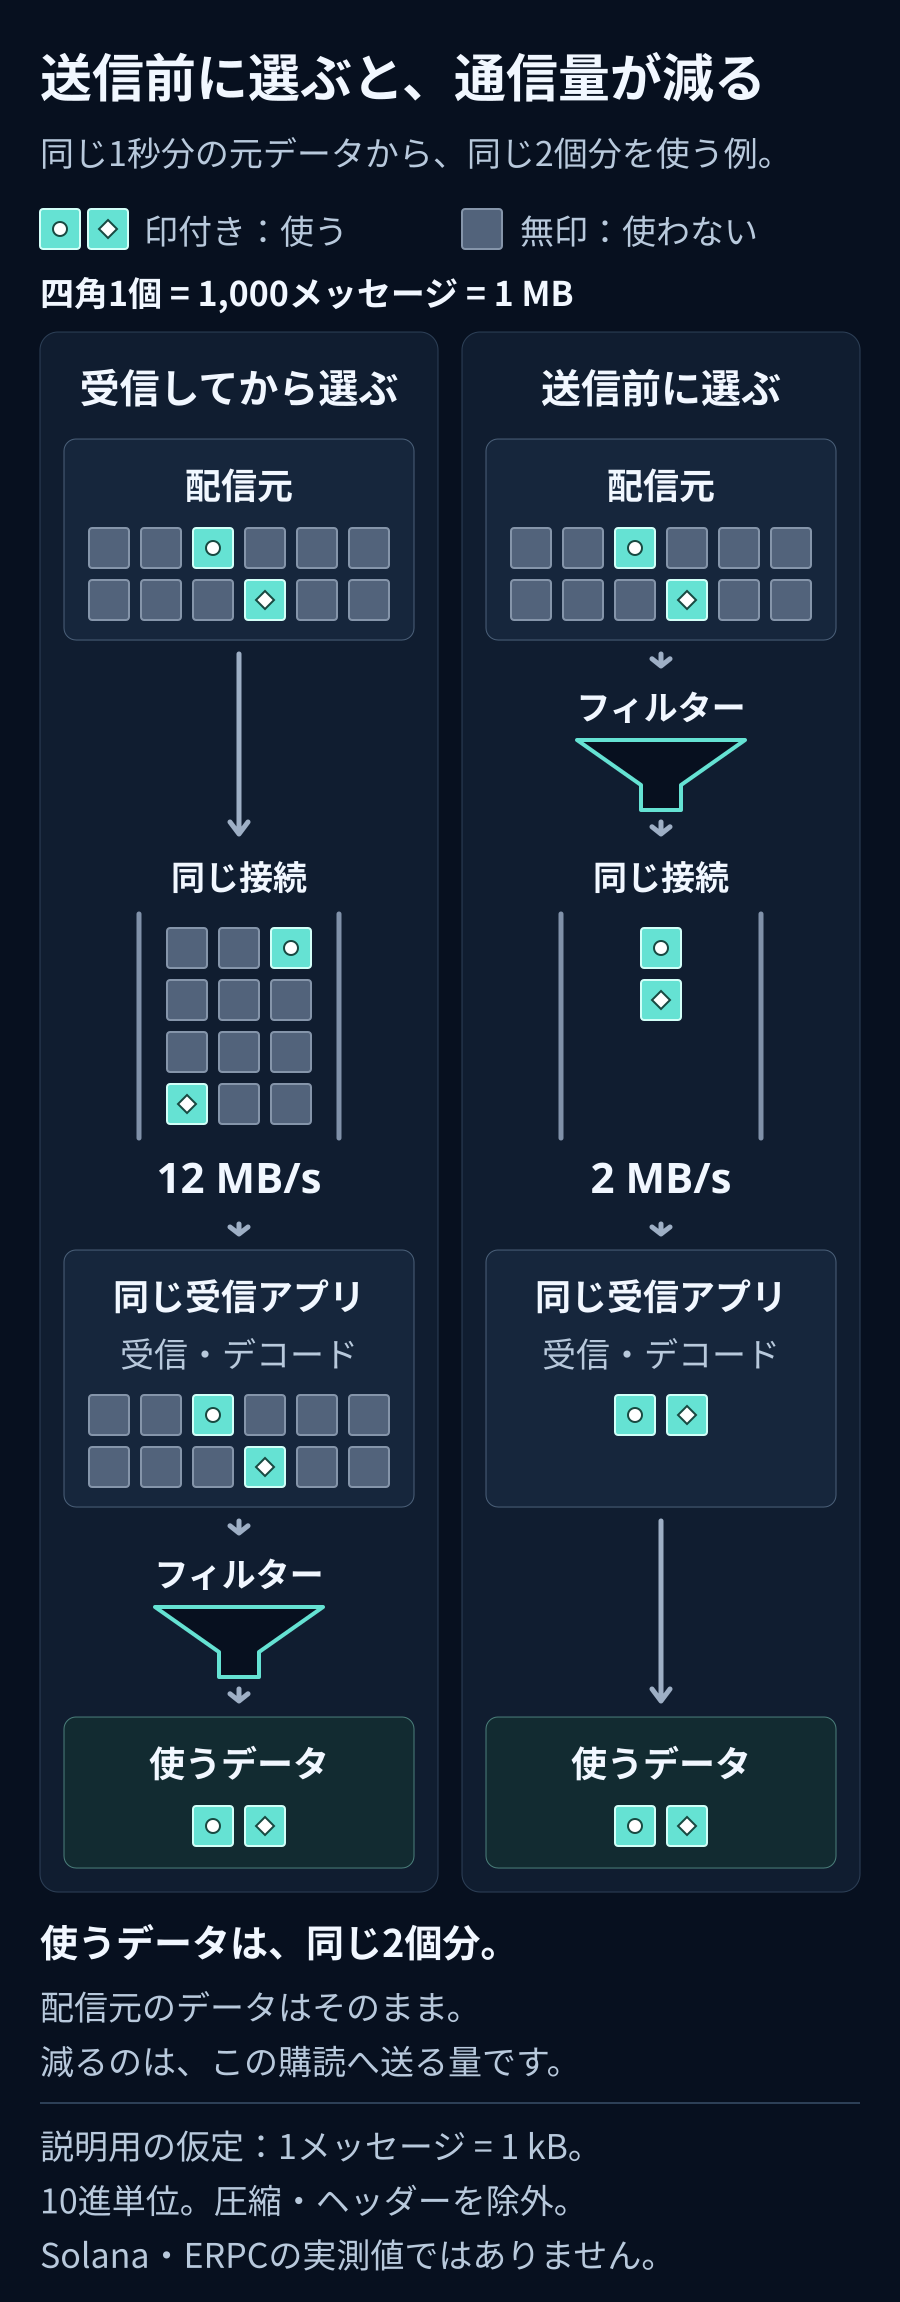
交通で考えると、道路の長さが伝搬距離、車線数が帯域、料金所の処理能力が受信処理、手前の車列が処理待ちです。同じ料金所へ、必要な車だけを送るか、周辺のすべての車を集めるかで、待ち方は変わります。遠い道を近くすることと、通す車を減らすことは、それぞれ別の改善です。
通信には物理的な下限もあります。100 MBを1 Gbpsで転送するだけでも、理論上0.8秒かかります。10 Gbpsなら0.08秒です。これは10進単位で計算した転送時間の下限で、距離、プロトコルのオーバーヘッド、再送、処理待ちは含みません。ストリーム内の各イベントが一律に0.8秒遅れる、という意味でもありません。
1件の計算が通信より速くても、不要なデータを送らせる費用は消えません。光が進む時間、一定時間に通せる量、到着後に処理できる量を、それぞれ考える必要があります。
全件インデックスや監査・研究など、全データが必要な用途もあります。その場合は、その量に見合う受信・処理・保存能力を用意します。また、個々の通知をすべて受け取ることと、フルブロック、つまり集約・再構成されたブロック単位のデータを待つことも別です。判断に不要なデータや集約完了を、処理の前提にしていないかを確認してください。[2]
受信処理と実行環境を見直す
Rustで処理コストを下げることは有効な選択肢です。その速さを活かすために、受信する量や回線の実効帯域、DBへの書き込みを待つ時間、ロックや直列処理の区間も見ていきます。非同期ランタイムでは、CPUを長時間使う仕事や、処理が終わるまでスレッドを待たせる仕事を適切に分けることも、改善につながります。[3]
受信ループは短く保ち、重い仕事を分離します。その際、キューの上限と、満杯になったときの扱いを決めます。無制限のキューは、遅れをメモリ消費に変えて隠してしまいます。上限付きキューも、持続的な処理能力不足そのものは解決しません。必要な順序とデータの完全性を守りながら、購読量の削減、処理の改善、分割、並列化、リソース増強を選びます。
まず受信から判断完了までを計測し、待ちがあると分かったところから詳しく調べます。次の表は、そのときの最初の見方です。詳しい指標名やコマンドは後半の診断プロンプトにもまとめてあるので、必要な項目から確認できます。
| 見る場所 | 最初に確かめたいこと |
|---|---|
| CPU | 1コアだけに処理が集中していないか。全体平均とコア別の使用率、実行環境のCPU制限を確認します |
| メモリ | 処理待ちの件数やメモリ使用量が増え続けていないか。待っているデータの量と、最古のイベントの待ち時間を一緒に見ます |
| ディスク・DB | 保存の完了を受信処理が待っていないか。DBへの書き込みや保存待ちの時間を確認します。保存しない構成では、ほかの箇所から調べられます |
| ネットワーク | 受信する量に回線や設定が合っているか。実際の転送量、通信の往復時間、再送を確認します |
通信側を詳しく調べるときは、ライブラリの設定も手掛かりになります。HTTP/2には、相手が追加で送信できるデータ量を調整するflow-control windowが、ストリーム単位と接続単位であります。その量が、帯域と往復時間の積である帯域遅延積に対して小さいと、回線に余裕があっても転送量が頭打ちになる場合があります。該当する場合は、使っているライブラリと中間機器を確認し、設定の適用先とメモリ消費を確かめながら調整します。[4]
「届いた件数」に、鮮度と待ち時間を加える
まずアプリ内の滞留を確かめるなら、現在の購読条件のまま、受信件数、処理完了件数、処理待ちの件数と最古イベントの待ち時間を、同じ観測時間で記録します。記録する場所が分からなければ、後半のプロンプトでエージェントにコードを調べてもらえます。明示的なキューがない場合は、受信後から判断完了までの時間と、重い処理を外した診断用構成との差から始めます。
計測箇所の考え方を、言語やSDKに依存しない擬似コードにすると、次のようになります。いまの処理順や並列数を保ち、実際のコードに合わせて計測を足します。
text
データを受信したとき:
  受信件数を1増やす
  そのイベントと対応する受信時刻を、単調時計で記録する
  既存の処理へ渡す

同じイベントを使う判断が完了したとき:
  処理完了件数を1増やす
  受信からの経過時間を計算し、集計する
データを受信したとき:
受信件数を1増やす
そのイベントと対応する受信時刻を、単調時計で記録する
既存の処理へ渡す
同じイベントを使う判断が完了したとき:
処理完了件数を1増やす
受信からの経過時間を計算し、集計する受信と判断が1対1でない構成では、先に対応関係と集計単位を決めます。観測結果は一定の時間ごとにまとめると、イベントごとのログ出力を増やさずに比較できます。
追加の切り分けでは、受信バイト数、キューのバイト数、処理時間のp50・p95・p99、エラーと再接続も記録します。p99は、測定した処理時間の99%がその値以下になる境界です。測定地点も明記します。NICの転送量、Protobufのサイズ、デコード後のオブジェクトの大きさは同じではありません。
同じホスト内の経過時間は、単調増加する時計で受信・キュー投入・取り出し・処理完了を分けて測ります。SDKのコールバック時点ですでにデコードが終わっているなら、その手前は未測定です。配信側の時刻と比較する場合は、時計の同期とタイムスタンプの生成地点を確認します。その差を、そのまま純粋な回線遅延と呼ばないようにします。
購読条件を変えずに業務処理を外したときに待ちが減るなら、その処理を加えた影響を調べる手掛かりになります。ただし、コールバック後の処理が速いだけでは、届いたデータが新鮮だとは証明できません。
同じ購読条件・commitment(どの確認段階のデータを扱うか)の参照ストリームとイベント識別子を比べる方法もあります。参照側も滞留していないことを確認してください。slot差だけで欠損を断定したり、固定の秒数に換算したりはできません。フィルター対象のイベントがないslotや、skipped slotもあるからです。[5]
mtrは経路の遅延や応答傾向を調べる材料になります。ただし、中間hopだけのlossは、ルーターの応答制限でも発生します。終端まで続く傾向、TCP再送、実効転送量、別経路との比較を合わせて判断します。mtr単体で帯域不足やデータセンター障害を確定することはできません。[6]
AIに渡す診断プロンプト
プロジェクトのコードを読めるエージェントに、次を貼り付けてください。最初に伝えるのは、実行場所と、どの場面で何が遅いと感じるかです。接続・購読・受信後の処理は、まずコードから調べてもらえます。APIキーや認証情報を、チャットへ貼り付ける必要はありません。
必要なイベントや許容する遅延がまだ決まっていなくても、「未定」と伝えて構いません。どの情報を見て何を判断したいかを、自分の言葉で説明してください。取れない計測値は未測定として扱い、いま確認できるところから始めます。
text
私のSolana Geyser gRPCクライアントに、応答を速くできる余地があるか調べてください。遅延・滞留・切断がある場合は、その原因を切り分けて改善してください。接続成功や受信ログだけで「最新データを処理できている」と判断しないでください。クライアントと配信側のどちらが原因かも、先に決めつけないでください。

1. 最初に目的を確認してください。必要なイベント、許容する鮮度、順序・欠損の許容範囲、購読フィルター、commitment、エンドポイントのリージョン、言語・SDK・gRPCライブラリの実バージョン、実行環境を整理してください。手元で読めるコード・設定・lockfileを優先し、足りないことだけ質問してください。未定の要件は未定として残し、まず現状を調べてください。秘密情報は表示せず、共有するログでは伏せてください。

2. 受信から処理完了までを計測してください。最初は受信・処理完了・待ち時間を優先し、測れる範囲から始めてください。件/秒とbytes/秒、処理件/秒、キューの件数・bytes・最古イベントの待ち、p50/p95/p99、エラー・切断・再接続・dropを記録してください。明示的なキューがなければ、その事実と観測できる処理区間を示してください。観測地点と未測定区間を明記し、NIC・wire・Protobuf・デコード後の値を混同しないでください。ホスト内の所要時間には単調時計を使い、外部時刻は同期と生成地点を確認してください。slot差だけを欠損や固定秒数に読み替えないでください。

3. CPU・メモリ・ディスク・ネットワークを切り分けてください。コア/スレッド別CPU、steal・CPU制限、RSS・GC・swap・PSI、I/O待ち、NICのbytes・drop・エラー、TCP再送、RTTを調べてください。利用できるLinuxツールの例は mpstat、pidstat、vmstat、iostat、sar、ss -ti、/proc/pressure/ です。権限やツールがなければ、その事実と必要な最小コマンドを示してください。ホストに入れない場合は、管理画面やアプリ内計測で取れる情報を探し、取れない項目は未測定としてください。結果を推測で埋めないでください。

4. HTTP/2のstream/connection両window、TCP受信バッファ、プロキシ・VPN・sidecarを確認してください。実際のSDKバージョンの公式仕様を調べ、帯域遅延積との関係を検討してください。受信ループ内のJSON変換、毎イベントのログ、同期DB/外部API、ブロッキング処理、ロック、無制限のタスク生成・キューも調べてください。Rustや非同期化だけで解決したとは扱わないでください。

5. mtr等を使える場合、接続先ホストに対して有限回で測定してください。対応環境では mtr --tcp --port <PORT> --report --report-cycles 30 <HOST> を検討できます。TLSの一般的なポートを決め打ちせず、実際の接続先を使ってください。中間hopだけのlossを障害と断定せず、終端・再送・別経路の結果と照合してください。mtrを帯域測定の代用にしないでください。

6. 現在の購読条件で基準値を取り、変更は一つずつ比較してください。同じ購読のまま、受信だけの最小処理と業務処理を加えた構成を比較してください。フィルターの変更は別の比較として扱ってください。購読を絞る前に、判断に使う値と通知の対応を確認し、候補フィルターが既知の必要なイベントを含むか検証してください。順序と完全性を保った上限付きキュー・並列化を設計し、満杯時の扱いを明記してください。必要なデータを勝手に捨てないでください。エラーの詳細とretry期限を保存し、停止期間中は再接続しないでください。

7. 観測事実、原因候補、未検証事項、改善差分、改善前後の数値を分けて報告してください。必要なCPU・RAM・帯域・保存性能と配置先は、購読量と実測から見積もり、ピーク時の余裕を含めてください。固定の「Solana必須スペック」を作らないでください。必要なら同じ購読・SDK・commitmentで別マシン/別データセンターを比較する計画を示してください。

ERPCを利用している場合は、現在のgRPC FAQを読み、エラーコードに対応する手順を確認してください。
https://erpc.global/en/faq/grpc/general/
接続済みのERPC User MCPやCLIがある場合は、実際に公開されている操作と権限を確認してください。契約情報へのアクセスだけでホスト内も診断できると仮定しないでください。有料VPSの作成・契約変更・本番の更新や再起動は、費用・目的・検証時間を提示して私の承認を得てください。まず診断とレビューできる改善案を完成させてください。
私のSolana Geyser gRPCクライアントに、応答を速くできる余地があるか調べてください。遅延・滞留・切断がある場合は、その原因を切り分けて改善してください。接続成功や受信ログだけで「最新データを処理できている」と判断しないでください。クライアントと配信側のどちらが原因かも、先に決めつけないでください。
1. 最初に目的を確認してください。必要なイベント、許容する鮮度、順序・欠損の許容範囲、購読フィルター、commitment、エンドポイントのリージョン、言語・SDK・gRPCライブラリの実バージョン、実行環境を整理してください。手元で読めるコード・設定・lockfileを優先し、足りないことだけ質問してください。未定の要件は未定として残し、まず現状を調べてください。秘密情報は表示せず、共有するログでは伏せてください。
2. 受信から処理完了までを計測してください。最初は受信・処理完了・待ち時間を優先し、測れる範囲から始めてください。件/秒とbytes/秒、処理件/秒、キューの件数・bytes・最古イベントの待ち、p50/p95/p99、エラー・切断・再接続・dropを記録してください。明示的なキューがなければ、その事実と観測できる処理区間を示してください。観測地点と未測定区間を明記し、NIC・wire・Protobuf・デコード後の値を混同しないでください。ホスト内の所要時間には単調時計を使い、外部時刻は同期と生成地点を確認してください。slot差だけを欠損や固定秒数に読み替えないでください。
3. CPU・メモリ・ディスク・ネットワークを切り分けてください。コア/スレッド別CPU、steal・CPU制限、RSS・GC・swap・PSI、I/O待ち、NICのbytes・drop・エラー、TCP再送、RTTを調べてください。利用できるLinuxツールの例は mpstat、pidstat、vmstat、iostat、sar、ss -ti、/proc/pressure/ です。権限やツールがなければ、その事実と必要な最小コマンドを示してください。ホストに入れない場合は、管理画面やアプリ内計測で取れる情報を探し、取れない項目は未測定としてください。結果を推測で埋めないでください。
4. HTTP/2のstream/connection両window、TCP受信バッファ、プロキシ・VPN・sidecarを確認してください。実際のSDKバージョンの公式仕様を調べ、帯域遅延積との関係を検討してください。受信ループ内のJSON変換、毎イベントのログ、同期DB/外部API、ブロッキング処理、ロック、無制限のタスク生成・キューも調べてください。Rustや非同期化だけで解決したとは扱わないでください。
5. mtr等を使える場合、接続先ホストに対して有限回で測定してください。対応環境では mtr --tcp --port <PORT> --report --report-cycles 30 <HOST> を検討できます。TLSの一般的なポートを決め打ちせず、実際の接続先を使ってください。中間hopだけのlossを障害と断定せず、終端・再送・別経路の結果と照合してください。mtrを帯域測定の代用にしないでください。
6. 現在の購読条件で基準値を取り、変更は一つずつ比較してください。同じ購読のまま、受信だけの最小処理と業務処理を加えた構成を比較してください。フィルターの変更は別の比較として扱ってください。購読を絞る前に、判断に使う値と通知の対応を確認し、候補フィルターが既知の必要なイベントを含むか検証してください。順序と完全性を保った上限付きキュー・並列化を設計し、満杯時の扱いを明記してください。必要なデータを勝手に捨てないでください。エラーの詳細とretry期限を保存し、停止期間中は再接続しないでください。
7. 観測事実、原因候補、未検証事項、改善差分、改善前後の数値を分けて報告してください。必要なCPU・RAM・帯域・保存性能と配置先は、購読量と実測から見積もり、ピーク時の余裕を含めてください。固定の「Solana必須スペック」を作らないでください。必要なら同じ購読・SDK・commitmentで別マシン/別データセンターを比較する計画を示してください。
ERPCを利用している場合は、現在のgRPC FAQを読み、エラーコードに対応する手順を確認してください。
https://erpc.global/en/faq/grpc/general/
接続済みのERPC User MCPやCLIがある場合は、実際に公開されている操作と権限を確認してください。契約情報へのアクセスだけでホスト内も診断できると仮定しないでください。有料VPSの作成・契約変更・本番の更新や再起動は、費用・目的・検証時間を提示して私の承認を得てください。まず診断とレビューできる改善案を完成させてください。同じコードを、比較できる環境で試す
観測した結果、CPUやメモリ、ネットワーク経路に改善の余地が見つかることもあります。CPUを強くする、メモリを増やす、仕事を分割する、配信元に近い環境へ移す。こうした選択を、自分のアプリが扱うデータ量と実測に結び付けると、試す理由と確かめたい効果が明確になります。
ERPC VPSは、Solanaインフラに近い場所でストリームクライアントを動かすための選択肢です。時間課金を使い、同じコード・購読条件で現在の環境と比較できます。料金・リージョン・在庫は利用時のDashboardで確認してください。ERPCの環境でも、必要なリソースは購読内容とアプリケーションの処理次第です。[7]
比較では、受信量だけでなく、キューの増加率、処理を終えた時点の鮮度、p99、エラーを見ます。観測時間とチェーンの負荷も記録し、同時比較または繰り返し測定で、時間帯の違いを環境の性能差と取り違えないようにします。
困ったときは、秘密情報を伏せた購読設定、SDKのバージョン、リージョン、時刻、エラー全文、得られた測定結果を添えてご相談ください。まだ取れていない数値は、そのまま未測定と伝えて構いません。
計測できたことが一つ増えると、次に試す変更を選びやすくなります。必要なデータを保ちながら、少しずつ改善を確かめていきましょう。私たちも、みなさんの開発を支える情報と環境を磨いていきます。
参考資料・関連リンク
- [1] gRPC Flow Control: https://grpc.io/docs/guides/flow-control/
- [2] Yellowstone gRPCの購読仕様: https://github.com/rpcpool/yellowstone-grpc/blob/master/README.md
- [3] Tokio: CPU-bound tasks and blocking code: https://docs.rs/tokio/latest/tokio/index.html#cpu-bound-tasks-and-blocking-code
- [4] HTTP/2 flow control: https://www.rfc-editor.org/rfc/rfc9113.html#section-5.2
- [5] Solana terminology: https://solana.com/docs/references/terminology
- [6] mtr公式資料: https://github.com/traviscross/mtr
- [7] ERPC VPS: https://erpc.global/ja/vps/
- Linux PSI: https://docs.kernel.org/accounting/psi.html
- Node.jsの計測API: https://nodejs.org/api/perf_hooks.html
- ERPC gRPC FAQ: https://erpc.global/ja/faq/grpc/general/
- ERPC Web Dashboard: https://dashboard.erpc.global/ja/
- Validators DAO 公式 Discord: https://discord.gg/C7ZQSrCkYR