Solana HFTのための 低遅延アーキテクチャ
データは届いているのに、アプリが判断に使う価格は古いまま。SolanaでHFTを行うアプリケーションでは、計算の速さに加えて、受信したデータが判断に使われるまでの待ち時間も調べる必要があります。前のデータが処理を待っている、記録の保存が終わらない、別の市場の更新にロックを取られている。こうした待ちは、コードの構成によって変わります。
この記事では、届いたデータがどこで待ち、設計を変えると何が進むのかを、5つのパターンで見ていきます。まず自分のアプリで起きている症状を選び、その節から読み進めても構いません。
| アプリで起きていること | 確認する設計 |
|---|---|
| 動かし続けるほど、未処理のデータが増える | 1. 届く量と処理量、待ちの上限 |
| 記録の保存中に、次の価格を処理できない | 2. 判断に必要な処理と、分析用記録の分離 |
| 市場Aの更新が、市場Bの更新まで待たせる | 3. 独立した状態を守るロックの分割 |
| 受信するたびに、同じ準備を繰り返している | 4. 変わらない準備の事前実行と再利用 |
| 再接続したのに、古い値で判断してしまう | 5. 接続の復帰と、判断に使う状態の復旧 |
各節の末尾に、その改善を自分のアプリへ取り入れるためのコピー用指示を用意しました。プロジェクトのコードを読めるAIエージェントへ渡して使えます。
図の件数・価格・処理回数・時間幅は、仕組みを説明するためのモデルです。実測した速度や取引の成果を示すものではありません。
図はタップまたはクリックで原寸画像を開けます。
1. 届く量と処理できる量を比べ、待ちの上限を決める
同じ長さの時間区間ごとに6件が届き、2件を処理できる例を考えます。最初の区間を終えた時点で、4件が未処理のまま残ります。このように、処理を待つデータの置き場をキューと呼びます。
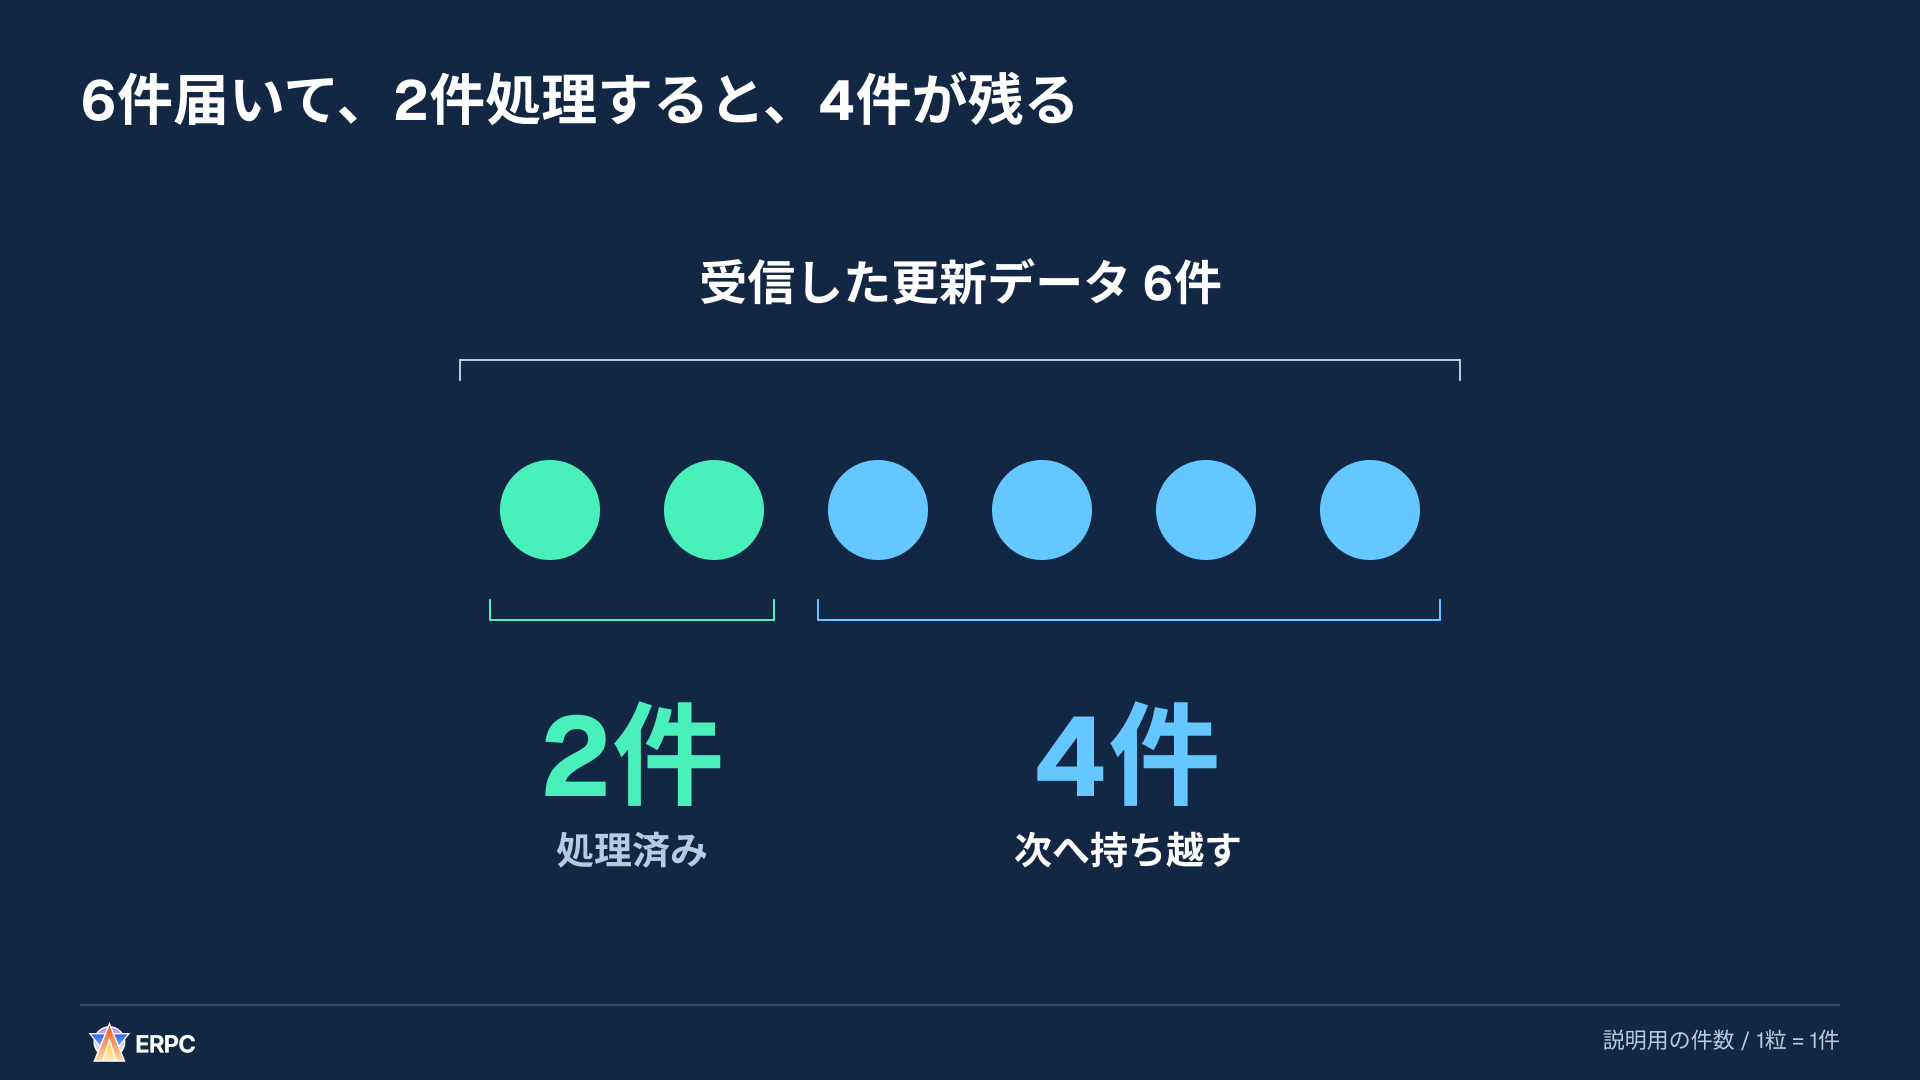
処理は進んでいますが、4件はまだ判断に使われていません。
同じ割合を、6万件の入力へ広げます。2万件を処理しても、4万件が待ちます。図の右では1点を100件、100点の束を1万件として描いているため、処理済みは2束分、待ちは4束分です。
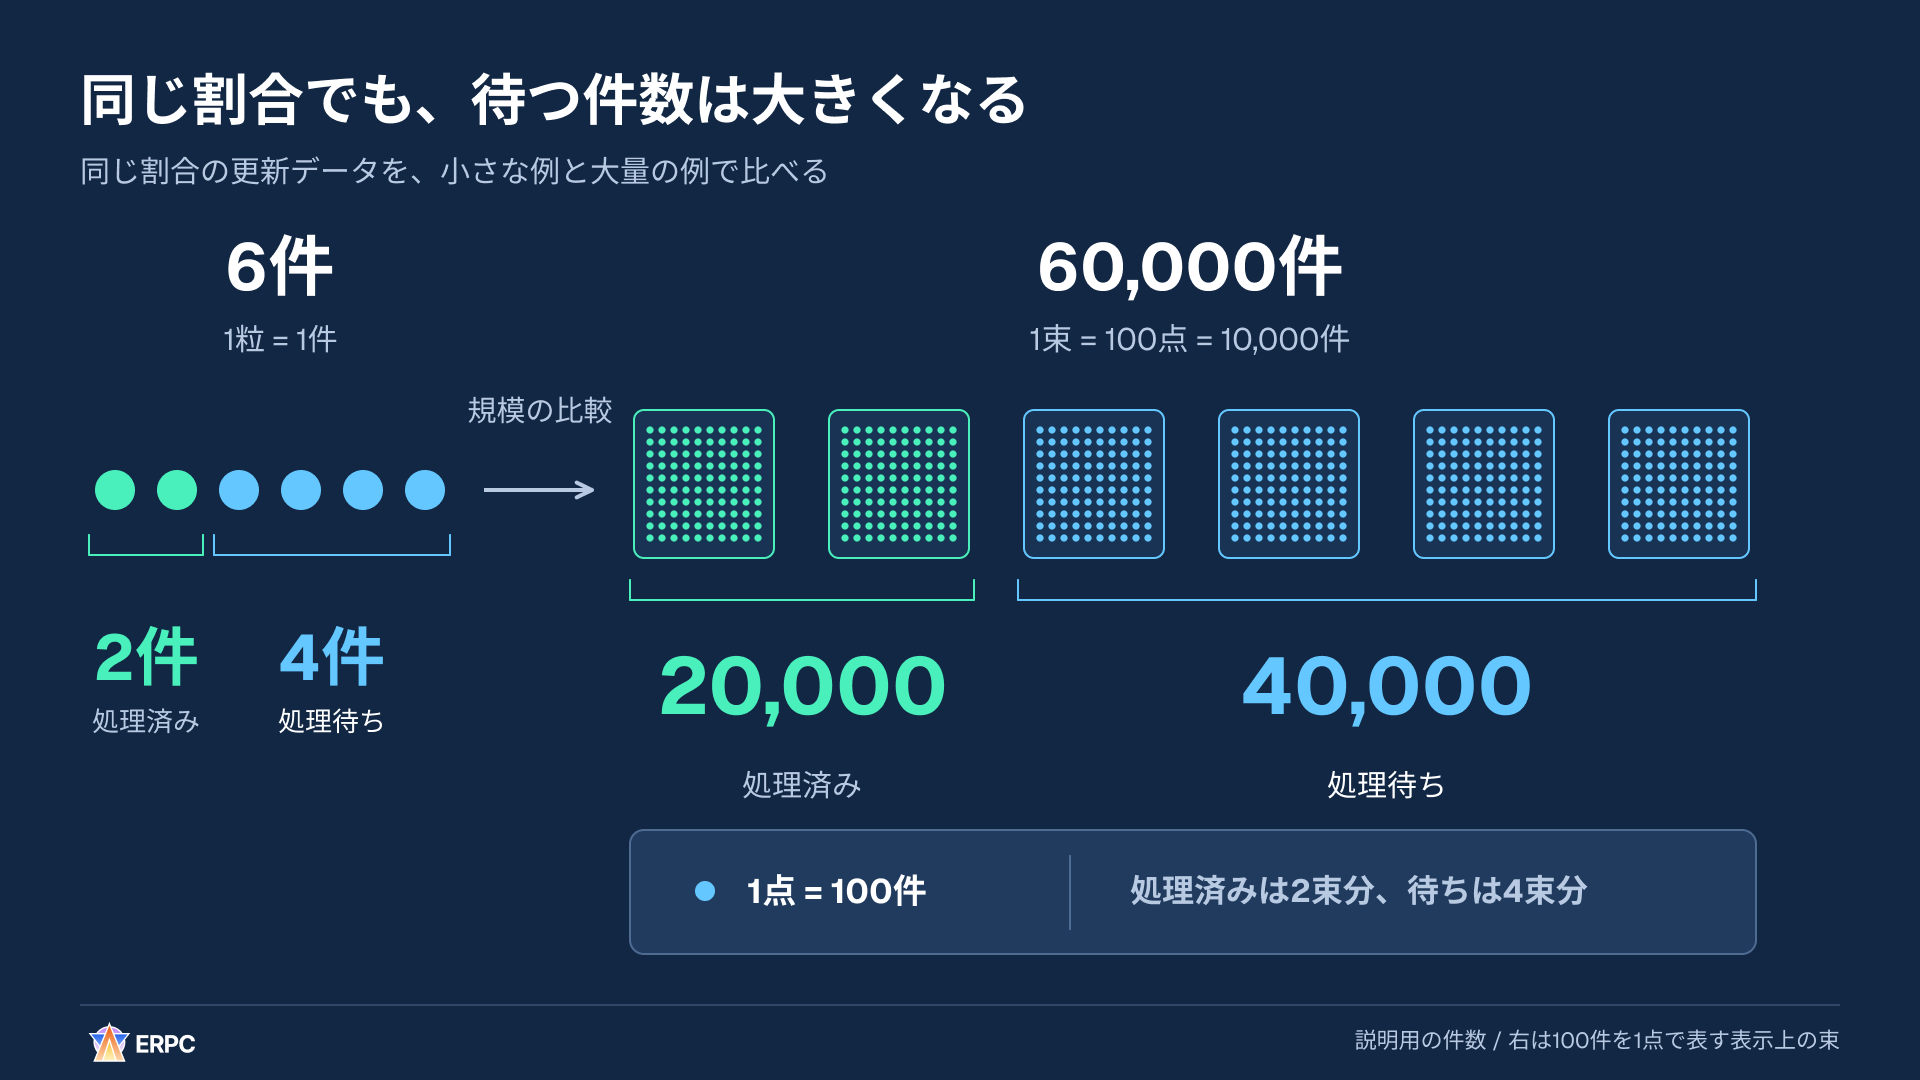
右の束は、量を見せるためのまとまりです。アプリが一度に処理する単位を表しているわけではありません。
次の区間は、前からの4万件を抱えて始まります。そこへ6万件が届き、2万件を処理するので、残りは8万件です。その次は12万件になります。新しく届いた価格も、先に並んだ仕事の後ろで待つことになります。
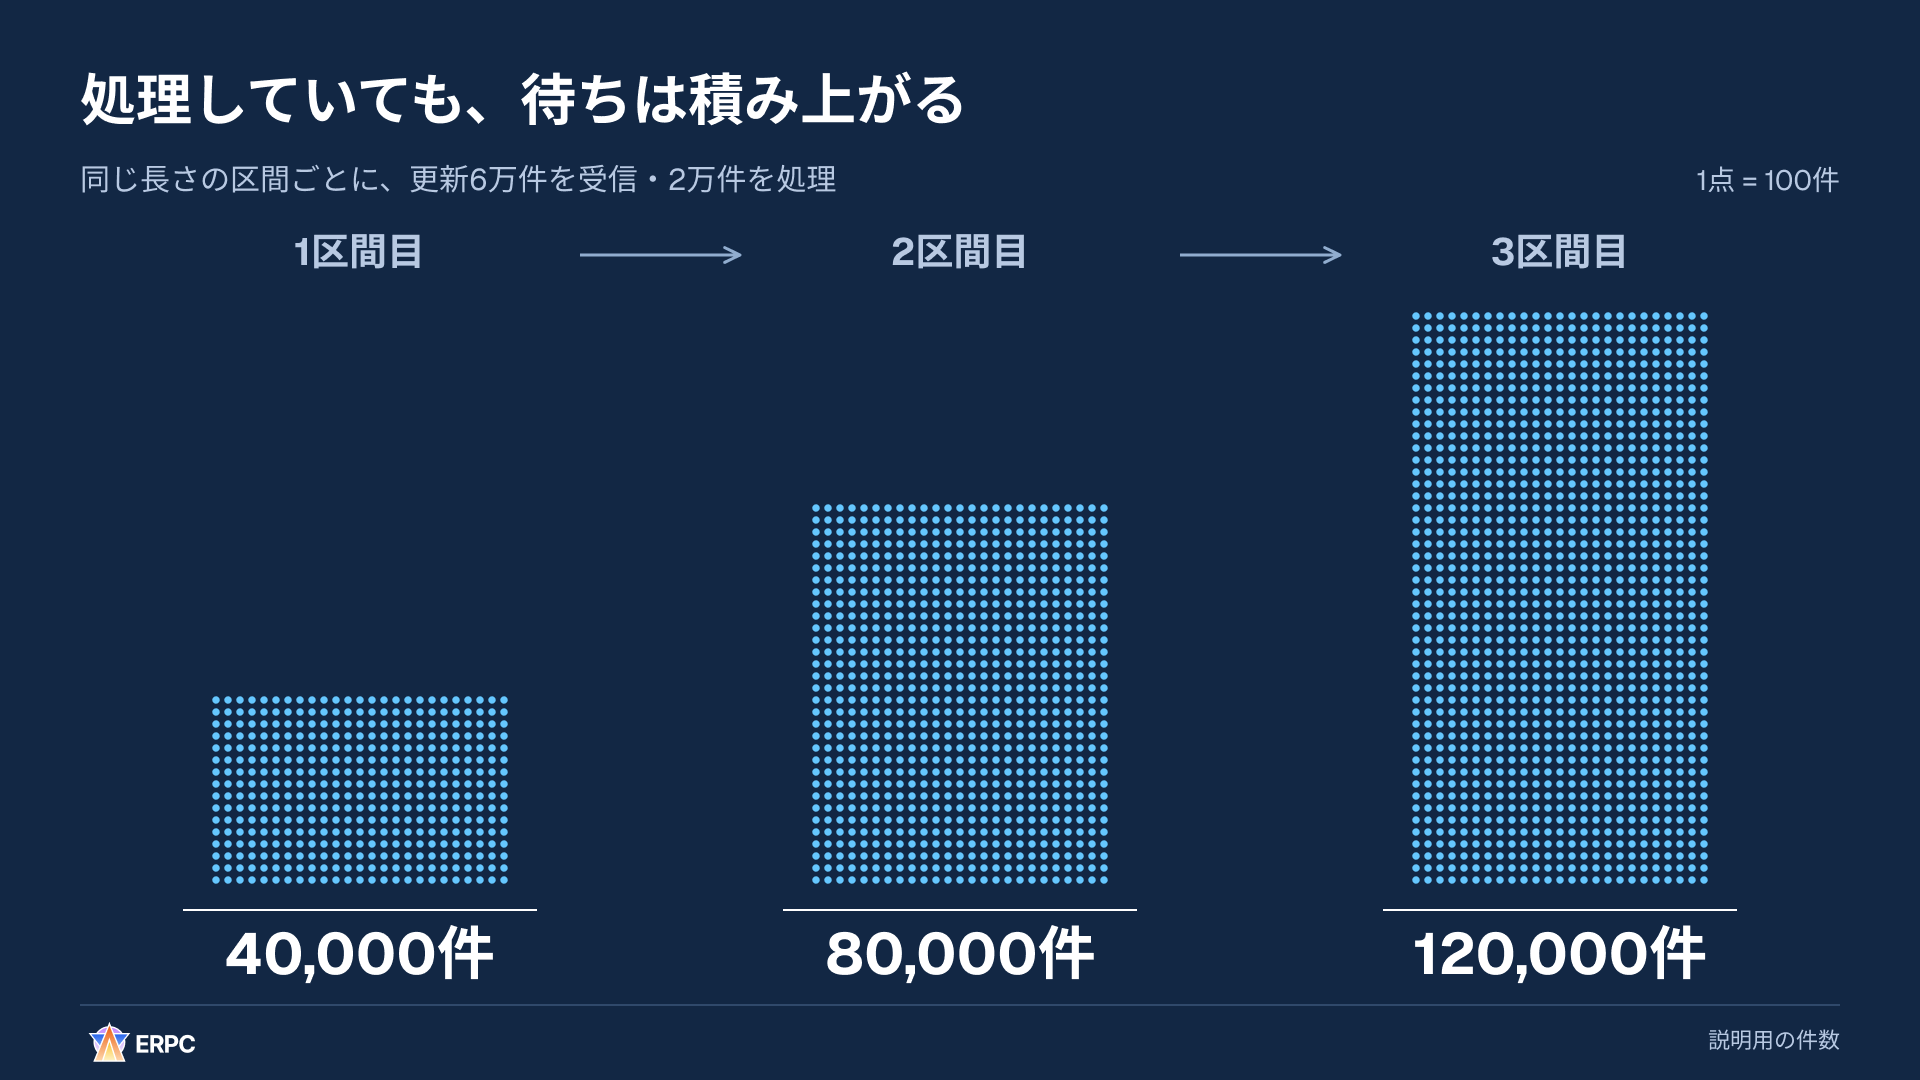
届く量が処理量を上回り続けると、未処理のデータも増え続けます。
キューは、短時間に入力が集中するバーストを受け止めるために役立ちます。ただし、容量を増やしても、この例のような持続的な処理能力の不足は解消しません。保持する件数・バイト数に加え、一番古いデータが何秒待っているかを観測し、許容できる上限を決めます。判断に必要な鮮度を満たせない場合は、更新の欠落がなくても、その値に依存する新たな取引判断を保留します。
では、上限に達したらどうするのでしょうか。次の図では、8件の保持枠が埋まったところへ、新しい2件が届いています。その2件を保持できず、しかも判断に必要な更新だった場合、アプリの保存値を正しく更新できません。その値に依存する新たな取引判断を保留し、必要な更新を補ってから再開します。
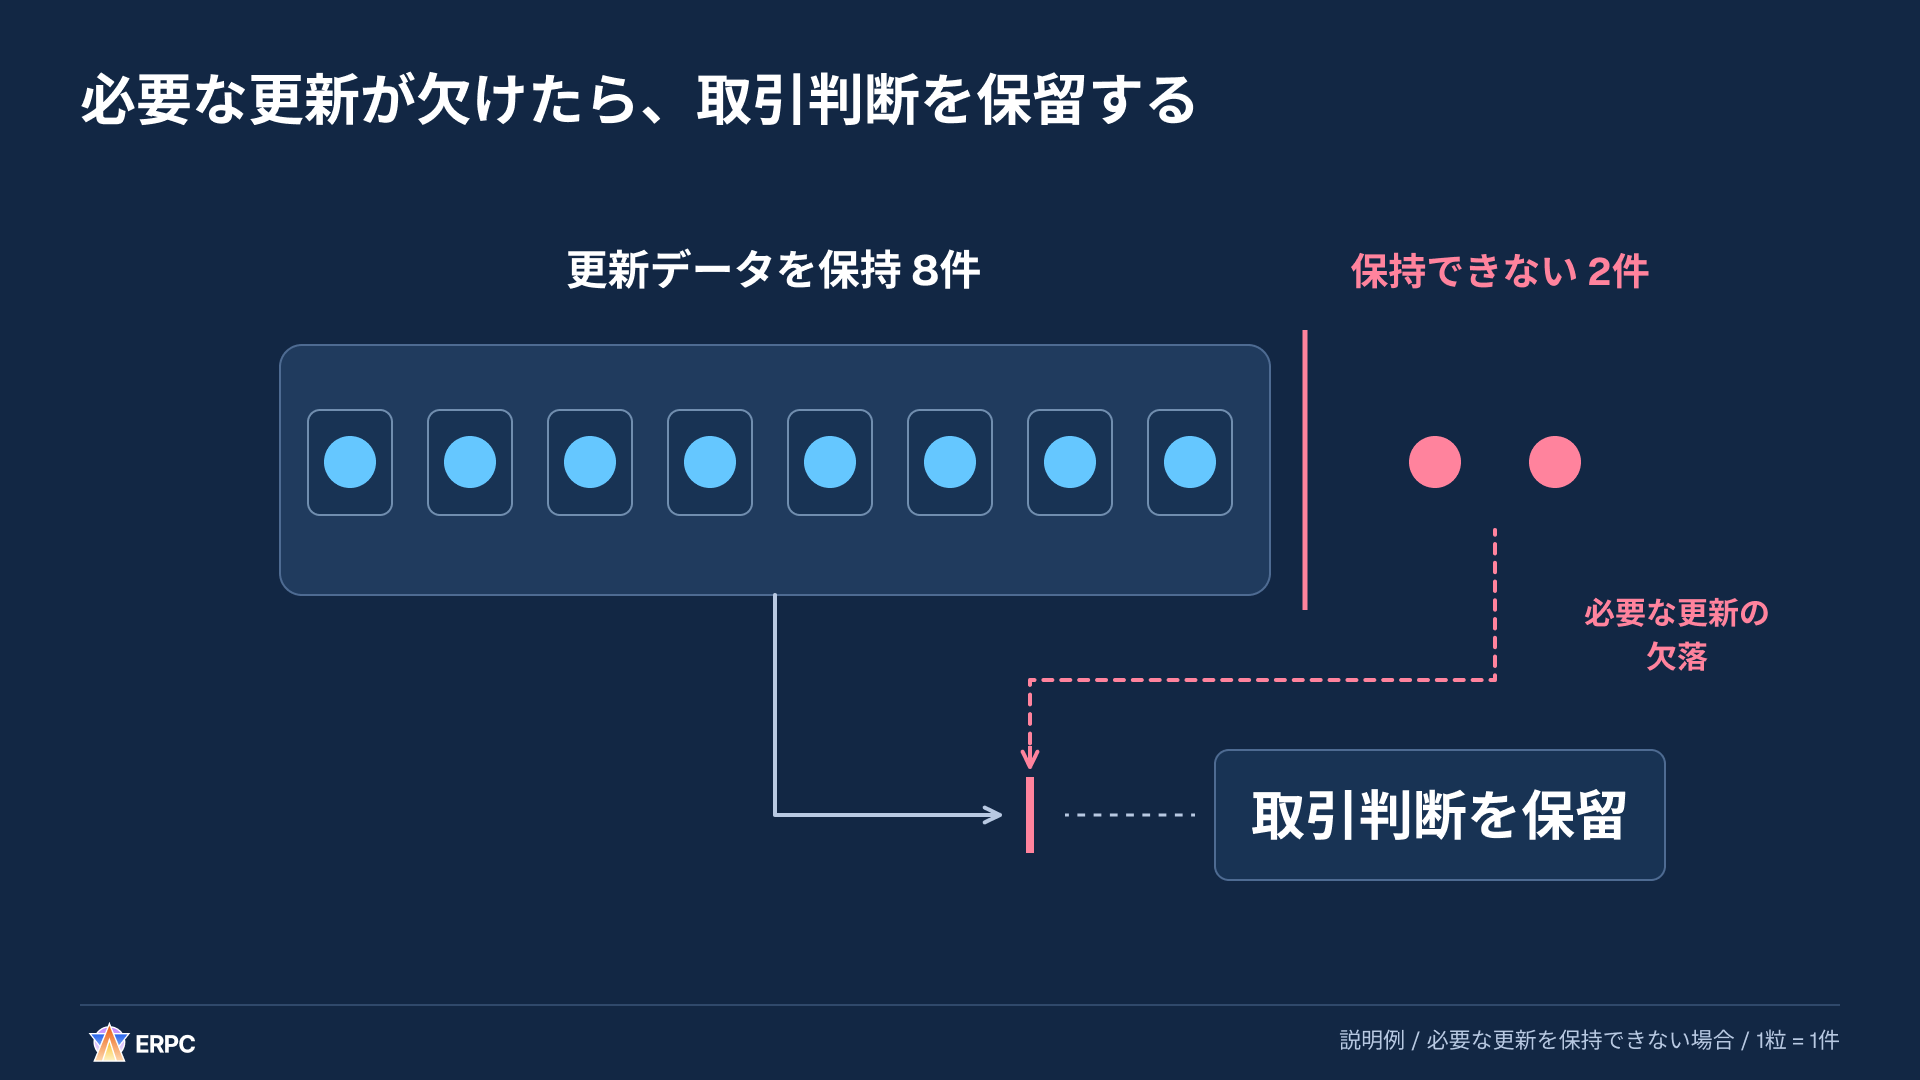
上限に達した後の動作まで決めて、キューの設計になります。
扱う仕事を減らせるか、処理能力を増やせるかも見直します。同じ対象の最新の完全な状態だけが必要なら、途中の値を最新値へまとめられる場合があります。一方、差分を足し合わせる処理や、途中のイベントも必要な処理では、更新を省くと結果が変わります。
受信を一時停止すると、待ちが配信側へ移る場合もあります。送受信のペースを調整するgRPCのflow control、受け取る対象を絞るサーバー側フィルター、アプリの処理能力を合わせて考えます。[3][4]
受信キューの詰まりとデータの鮮度を改善したい場合は、次の指示をコピーできます。
text
このアプリで、受信量に処理が追い付かず、判断に使うデータが古くなる問題を改善してください。

README・開発指示・依存関係と、受信→キュー→状態更新→判断のコードを読んでください。既存の言語・実行環境・SDKで進め、データが完全な状態か差分か、必要な適用順序と鮮度を確認してください。

1. 機密情報を除いた再現入力と変更前の値を保存してください。キューへ入る前の待ちも調べ、同じ区間の流入・流出件数とバイト数、滞留量、最古のデータの待ち時間、実行中の仕事数を測ってください。
2. 件数・バイト数・待ち時間・同時実行数の上限と、その根拠を決めて実装してください。必要な条件が不明なら仮定を示してください。不要な受信・処理を減らせるか、処理能力が足りるかも確認し、キューを大きくしただけで持続的な処理不足を解消したと扱わないでください。
3. 満杯時の動作を明示してください。必要な更新を保持できない場合、または欠落がなくても必要な鮮度を失った場合は、その値に依存する新たな取引判断を保留し、状態の更新・復旧を進めて再開条件を確認してください。
4. 途中の値をまとめる場合は、同じ対象の最新の完全な状態だけで結果を保てることを確認してください。必要な差分やイベントを黙って捨てないでください。受信を止める場合は、配信元のflow controlと、待ちが移る先も確認してください。
5. 通常入力、バースト、持続的な過負荷、満杯からの復帰を同じ条件で再生してください。流入と処理量、最古の待ち、受信から判断完了までのp50/p95/p99、CPU・メモリ、欠落・破棄を比較し、適用した状態と判断結果を期待する結果に照合してください。ホスト内の時間は単調時計で測り、測定の始点・終点を明記してください。

既存の承認・権限と開発手順を引き継いでください。この指示だけで、本番変更・有料契約・実売買の権限を追加しないでください。秘密鍵・認証情報・顧客データは出力しないでください。

最後に、変更箇所、比較条件、変更前後の値、正しさの確認、残る制約を報告してください。測れない値は未測定としてください。
このアプリで、受信量に処理が追い付かず、判断に使うデータが古くなる問題を改善してください。
README・開発指示・依存関係と、受信→キュー→状態更新→判断のコードを読んでください。既存の言語・実行環境・SDKで進め、データが完全な状態か差分か、必要な適用順序と鮮度を確認してください。
1. 機密情報を除いた再現入力と変更前の値を保存してください。キューへ入る前の待ちも調べ、同じ区間の流入・流出件数とバイト数、滞留量、最古のデータの待ち時間、実行中の仕事数を測ってください。
2. 件数・バイト数・待ち時間・同時実行数の上限と、その根拠を決めて実装してください。必要な条件が不明なら仮定を示してください。不要な受信・処理を減らせるか、処理能力が足りるかも確認し、キューを大きくしただけで持続的な処理不足を解消したと扱わないでください。
3. 満杯時の動作を明示してください。必要な更新を保持できない場合、または欠落がなくても必要な鮮度を失った場合は、その値に依存する新たな取引判断を保留し、状態の更新・復旧を進めて再開条件を確認してください。
4. 途中の値をまとめる場合は、同じ対象の最新の完全な状態だけで結果を保てることを確認してください。必要な差分やイベントを黙って捨てないでください。受信を止める場合は、配信元のflow controlと、待ちが移る先も確認してください。
5. 通常入力、バースト、持続的な過負荷、満杯からの復帰を同じ条件で再生してください。流入と処理量、最古の待ち、受信から判断完了までのp50/p95/p99、CPU・メモリ、欠落・破棄を比較し、適用した状態と判断結果を期待する結果に照合してください。ホスト内の時間は単調時計で測り、測定の始点・終点を明記してください。
既存の承認・権限と開発手順を引き継いでください。この指示だけで、本番変更・有料契約・実売買の権限を追加しないでください。秘密鍵・認証情報・顧客データは出力しないでください。
最後に、変更箇所、比較条件、変更前後の値、正しさの確認、残る制約を報告してください。測れない値は未測定としてください。2. 記録を待たず、次のデータを判断する
市場価格が100から101へ変わる例を考えます。アプリは100の反映と判断を終え、分析用の記録を保存しています。次の入力を処理するループが保存完了まで待つ構成では、その間に101が届いても反映できません。アプリが持つ価格は、100のままです。
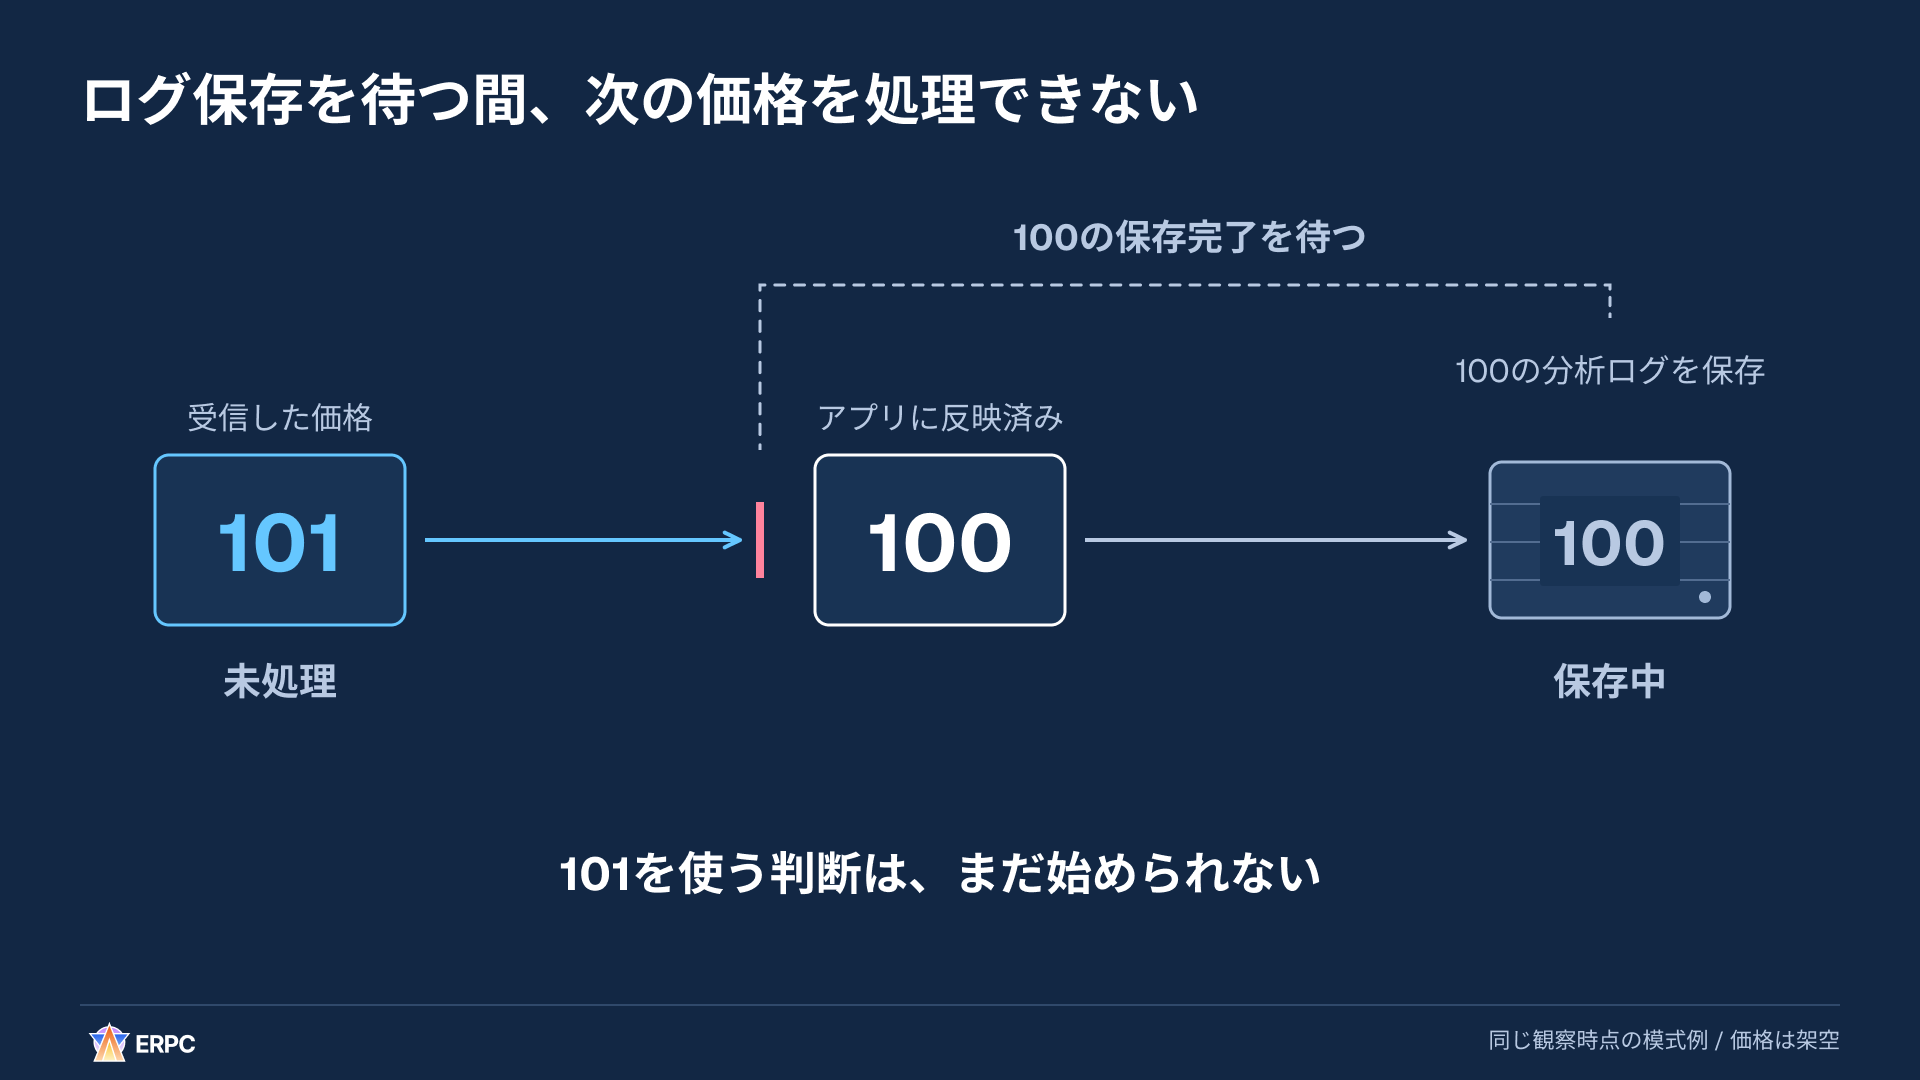
101の計算を始められない原因は、100の記録を待っていることです。
分析用記録を空きのある補助キューへ渡し、保存を別の処理に任せる構成に変えてみます。受信側は、記録を渡したところで次の入力へ戻れます。100の保存が続いていても、101を反映して判断へ進められます。
次の図では、100の保存が続く時間と、101が届く時点、101を処理する時間をそろえて比較しています。変えたのは、次の入力へ進むために保存完了を待つかどうかです。
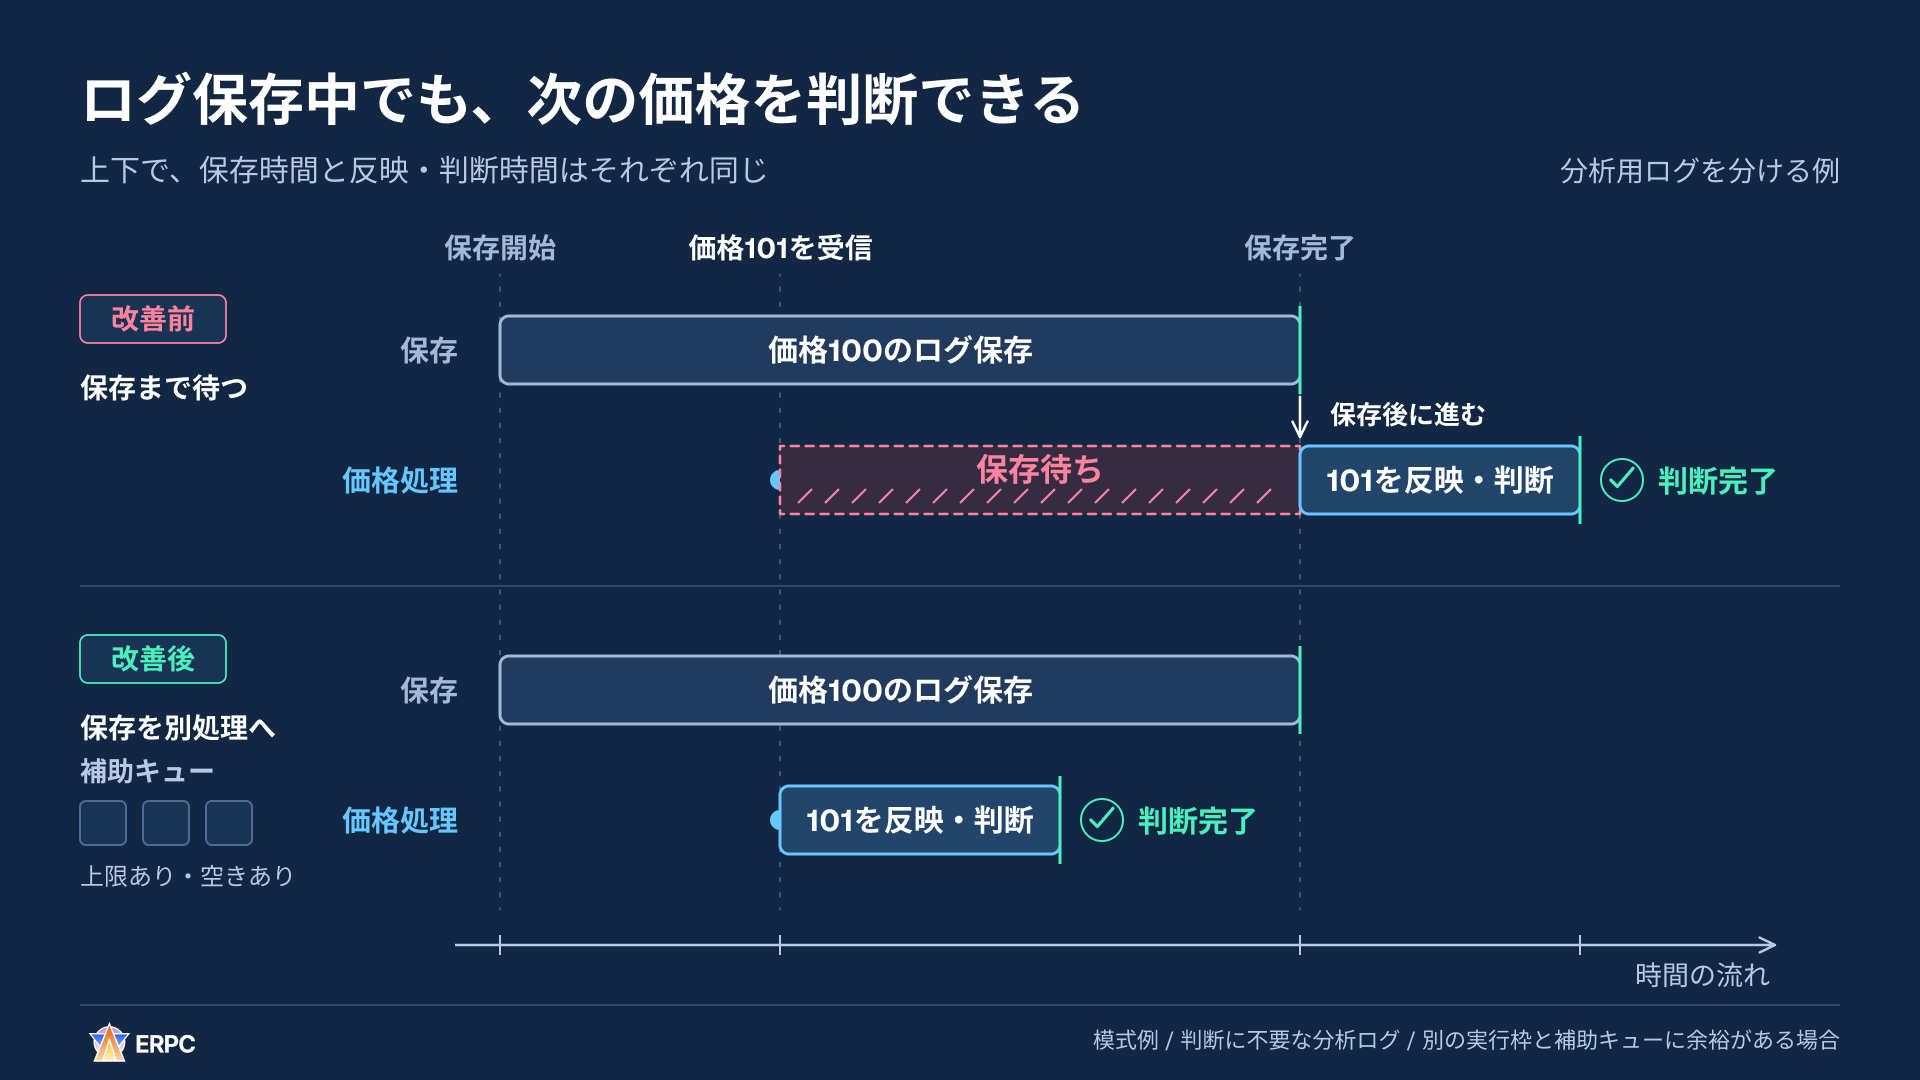
101の処理自体を短くしなくても、始めるまでの待ちを減らせます。
受信から判断・送信までに必要な処理経路を、ホットパスと呼びます。この例では、判断を待たせる必要がない分析用記録を、その経路から分けています。残高やリスク上限の確認、正しさのために完了が必要な保存処理は、要件を満たす位置に残します。
保存する仕事は残るため、補助キューにも容量と待ち時間の上限が必要です。また、別のタスクにしただけで、別のCPUで動くとは限りません。Tokioの長いCPU処理やブロッキング処理、Node.jsのevent loop上の長い同期処理は、ほかの仕事の進行を妨げる場合があります。処理を移すときは、実際にどこで実行されるかまで確認します。[1][2]
分析用の保存待ちを判断の経路から分けたい場合は、次の指示をコピーできます。
text
このアプリで、分析用の記録を保存する待ち時間が、次のデータの反映や判断を止める問題を改善してください。

README・開発指示・依存関係と受信ループを読み、既存の言語・実行環境・保存ライブラリで進めてください。保存の完了を待っている場所と、処理が実行されるスレッド・タスク・event loopを確認してください。

1. 機密情報を除いた再現入力を用意し、受信、状態反映、判断開始・完了、保存開始・完了の時点と、現在の結果を記録してください。
2. 保存の完了が判断や回復の前提かを要件から確認してください。残高・リスク確認や、正しさに必要な永続化は必要な位置に残し、後で保存してよい分析用記録を分離してください。
3. 記録する値が後の更新で変わらないよう受け渡し方法を決め、容量付きの補助キューと保存担当を実装してください。件数・バイト数・待ち時間の上限、満杯・保存失敗・再試行・終了時の動作、記録の保持条件を明示してください。保持要件が不明なまま記録を捨てないでください。
4. タスクを分けるだけで別CPUへ移ると仮定せず、同期I/Oや長いCPU処理が実際にどこで動くか確認してください。worker等を使う場合は実行数を制限し、変換・コピー・受け渡し待ちを含めて評価してください。
5. 同じ入力と到着ペースで、通常保存、遅い保存、保存失敗、補助キュー満杯、終了時を再現してください。受信から判断完了までのp50/p95/p99、保存側の待ちと滞留、CPU・メモリ、記録の欠落・重複を比較し、状態と判断の正しさ、記録の保持条件を確認してください。ホスト内の時間は単調時計で測り、測定の始点・終点を明記してください。

既存の承認・権限と開発手順を引き継いでください。この指示だけで、本番変更・有料契約・実売買の権限を追加しないでください。秘密鍵・認証情報・顧客データは出力しないでください。

最後に、変更箇所、比較条件、変更前後の値、正しさの確認、残る制約を報告してください。測れない値は未測定としてください。
このアプリで、分析用の記録を保存する待ち時間が、次のデータの反映や判断を止める問題を改善してください。
README・開発指示・依存関係と受信ループを読み、既存の言語・実行環境・保存ライブラリで進めてください。保存の完了を待っている場所と、処理が実行されるスレッド・タスク・event loopを確認してください。
1. 機密情報を除いた再現入力を用意し、受信、状態反映、判断開始・完了、保存開始・完了の時点と、現在の結果を記録してください。
2. 保存の完了が判断や回復の前提かを要件から確認してください。残高・リスク確認や、正しさに必要な永続化は必要な位置に残し、後で保存してよい分析用記録を分離してください。
3. 記録する値が後の更新で変わらないよう受け渡し方法を決め、容量付きの補助キューと保存担当を実装してください。件数・バイト数・待ち時間の上限、満杯・保存失敗・再試行・終了時の動作、記録の保持条件を明示してください。保持要件が不明なまま記録を捨てないでください。
4. タスクを分けるだけで別CPUへ移ると仮定せず、同期I/Oや長いCPU処理が実際にどこで動くか確認してください。worker等を使う場合は実行数を制限し、変換・コピー・受け渡し待ちを含めて評価してください。
5. 同じ入力と到着ペースで、通常保存、遅い保存、保存失敗、補助キュー満杯、終了時を再現してください。受信から判断完了までのp50/p95/p99、保存側の待ちと滞留、CPU・メモリ、記録の欠落・重複を比較し、状態と判断の正しさ、記録の保持条件を確認してください。ホスト内の時間は単調時計で測り、測定の始点・終点を明記してください。
既存の承認・権限と開発手順を引き継いでください。この指示だけで、本番変更・有料契約・実売買の権限を追加しないでください。秘密鍵・認証情報・顧客データは出力しないでください。
最後に、変更箇所、比較条件、変更前後の値、正しさの確認、残る制約を報告してください。測れない値は未測定としてください。3. 独立した更新を、同じロックで待たせない
市場Aと市場Bの価格を、それぞれ独立に更新できるアプリを考えます。Aの更新が始まった後で、Bの更新データが届きました。AとBを一つのMutex(排他ロック)で保護していると、BはAがロックを解放するまで待つことになります。
Mutexは、保護したデータを扱う権利を、一度に一つの処理へ渡す仕組みです。別の処理が使用中なら、同じロックを取得しようとする処理は待ちます。[17]
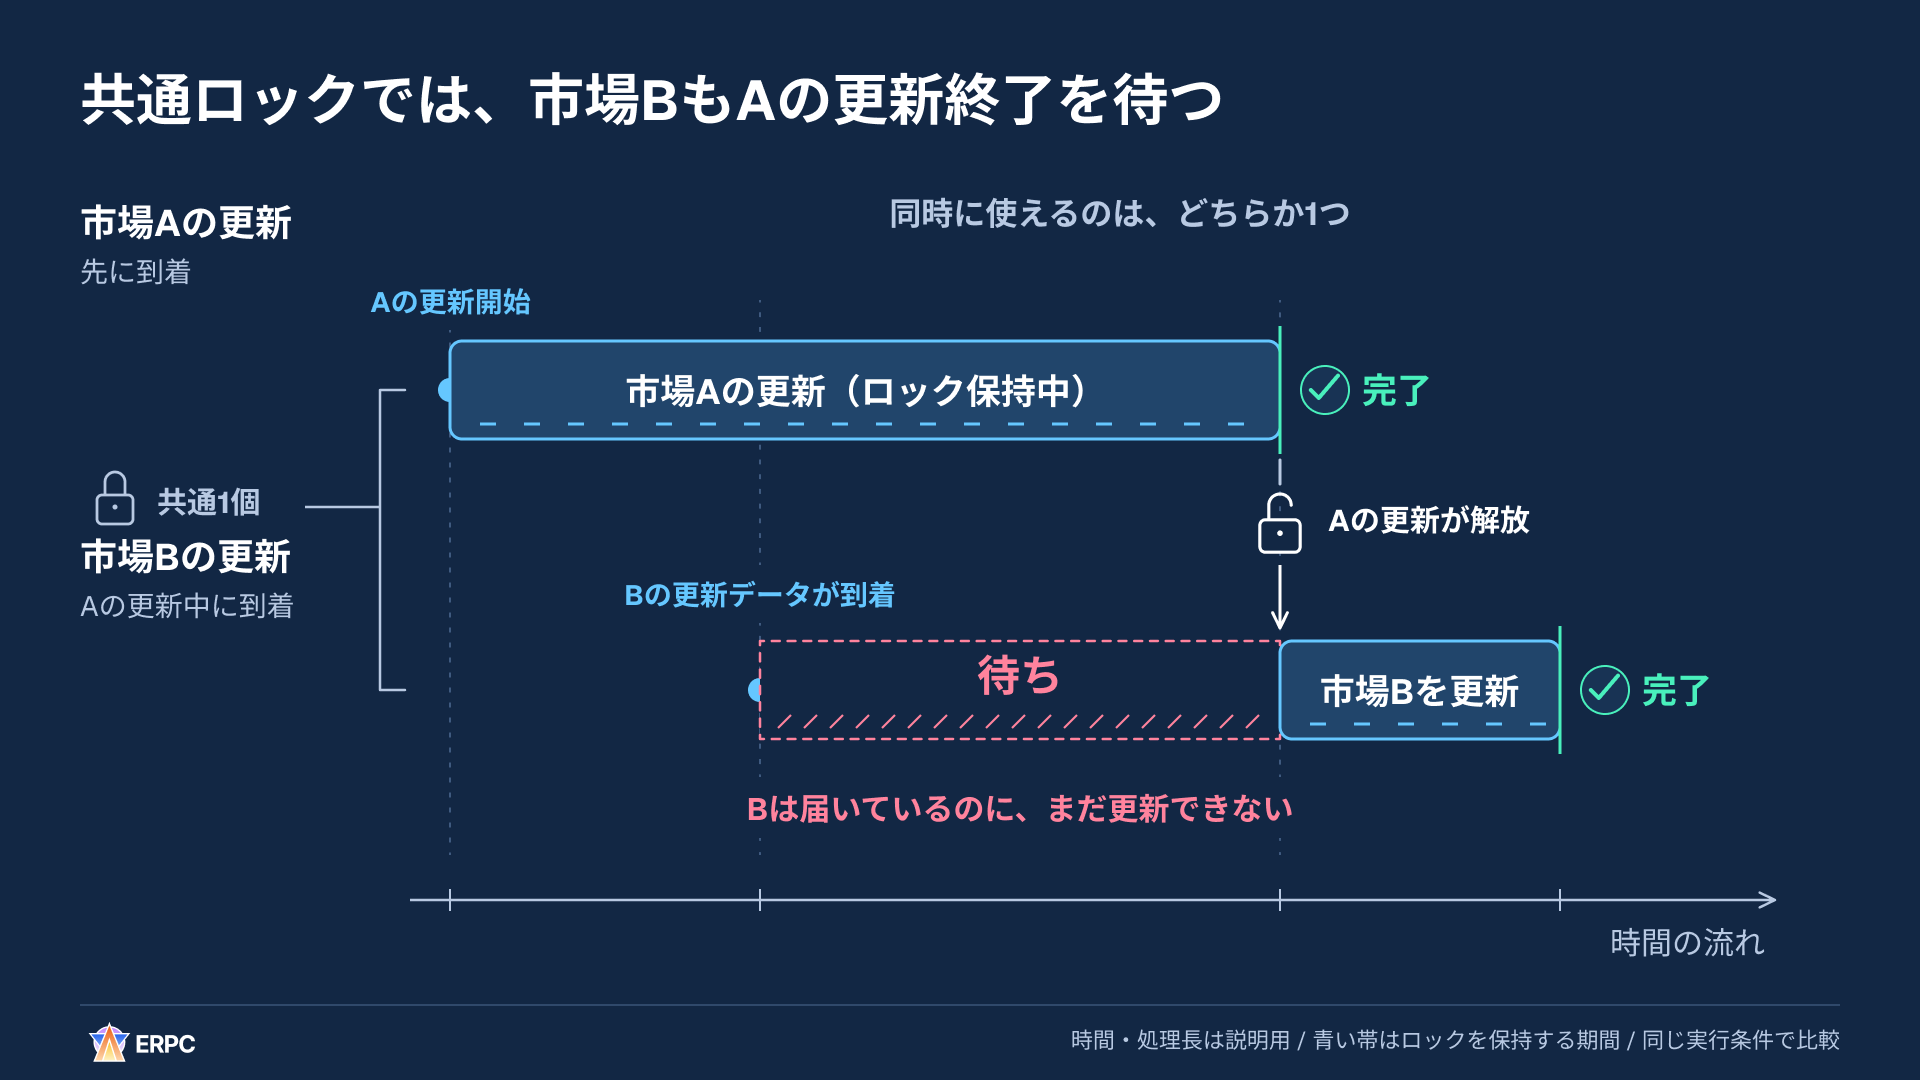
Bのデータは届いていますが、Aが使っている共通ロックを待っています。
AとBが別々の値だけを書き換えるなら、それぞれを別のロックで保護する方法があります。次の図は、上段が共通ロック、下段がロックを分けた構成です。A・Bの到着位置と、それぞれがロックを保持する時間は上下で同じです。Bのロックが空いていて、Bを実行する余力もある条件で比較しています。独立したキーを持つデータのロック分割は、Tokioの公式チュートリアルでも説明されています。[18]
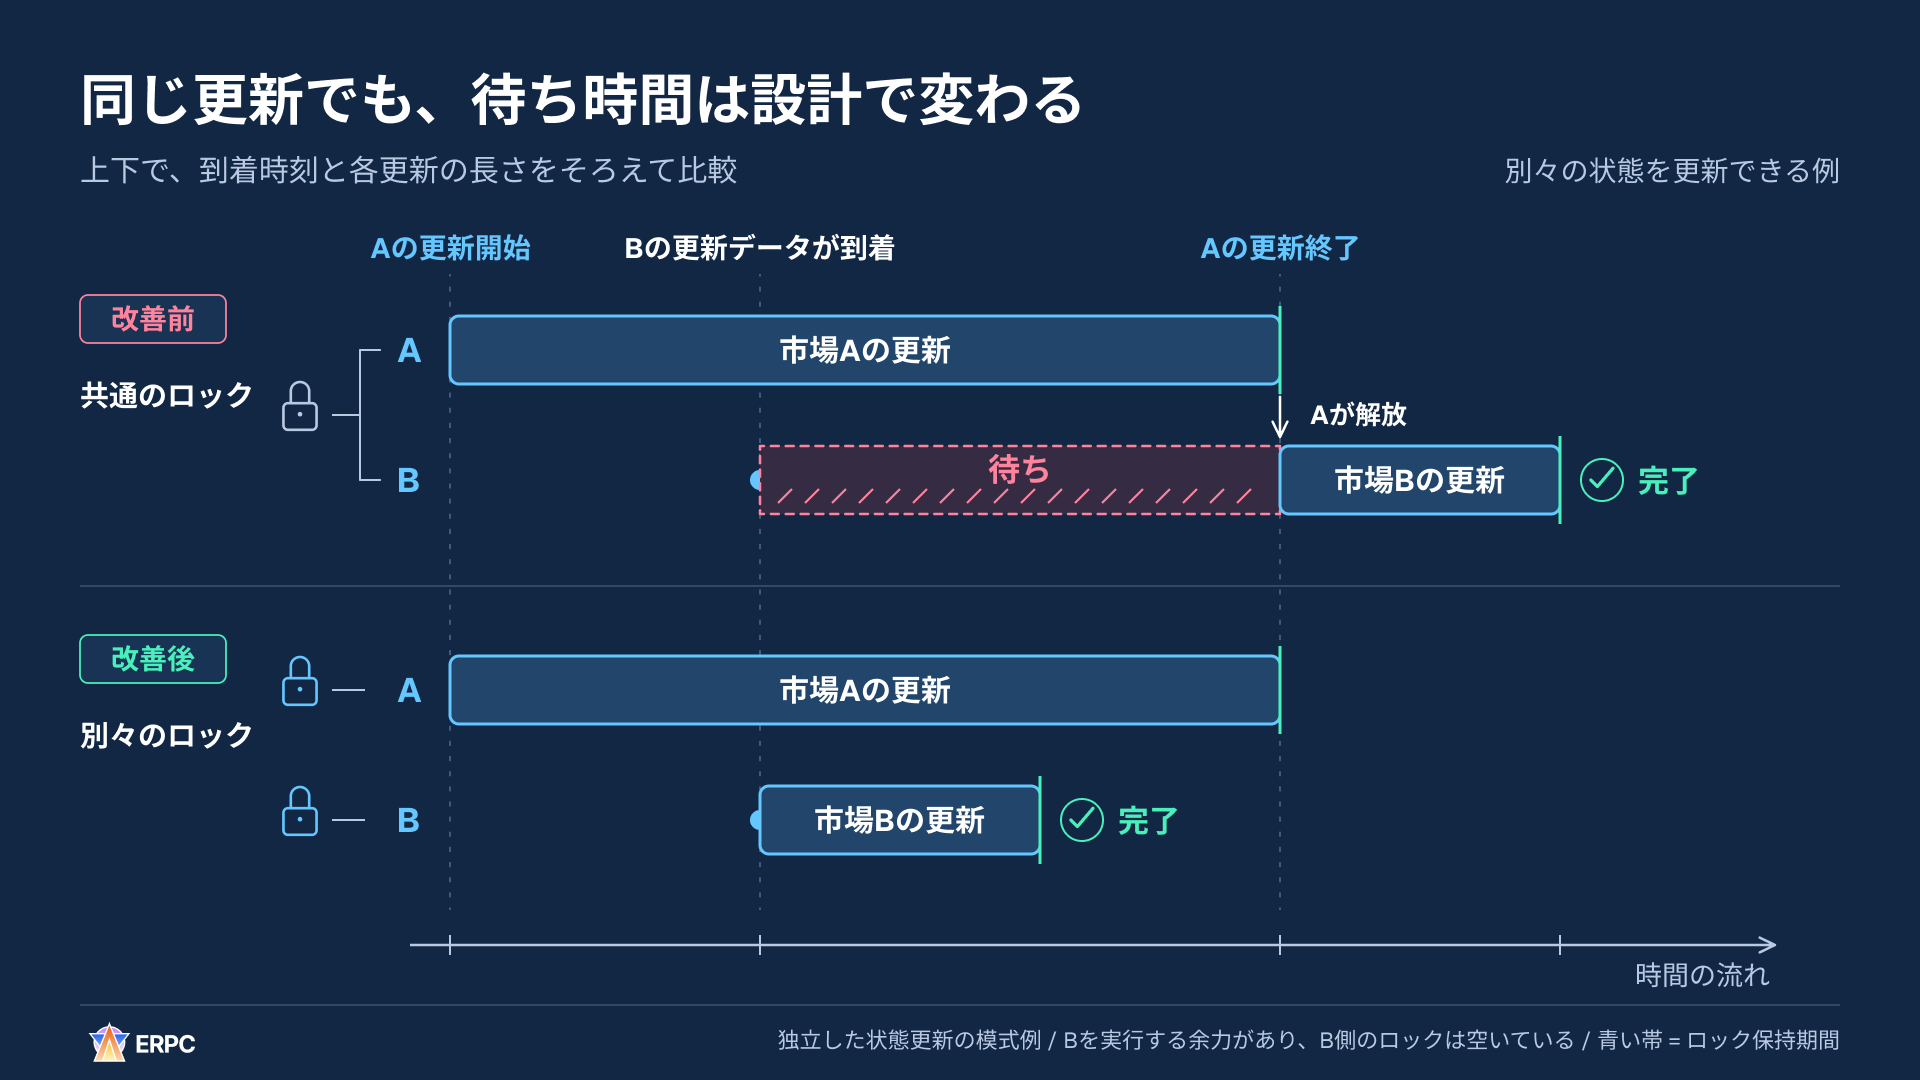
Bの青い帯の長さは同じです。取り除いたのは、その前にあるピンクの待ち時間です。
青い帯は、ロックを取得してから解放するまでの期間です。この例では、BはAの更新中に完了します。ロックを分けても、B自身のロックが使用中だったり、実行する場所がほかの仕事で埋まっていたりすれば、その待ちは残ります。
分割する際には、どの更新が独立しているかを確かめます。AとBの価格更新を別々に進められても、両方の価格や共通の残高を使って判断する処理には、必要な値を矛盾なく読む仕組みが要ります。同じスレッドでも、awaitで処理を中断している間に値が変わる場合があります。判断に使う値の版と読み取り方、更新を適用する順序を決めます。
たとえば、AとBが同じ残高を読み、それぞれ注文を作ると、両方が使えると考えた資金が重なることがあります。残高の確認と注文用の資金の確保を同じ担当で順に確定するなど、共通の値を守る仕組みは別に必要です。
状態ごとに更新担当を一つ置き、その担当へメッセージを送る方法もあります。書き手を一つにする考え方がSingle Writerです。ロックを分けることと、書き手を一つにすることは、それぞれ別の設計上の判断です。LMAX DisruptorではSingle Writerと処理の依存関係、Tokioでは専用タスクへのメッセージによる状態管理が説明されています。[5][18]
独立した更新どうしのロック待ちを減らしたい場合は、次の指示をコピーできます。
text
このアプリで、ある市場やキーの更新が、独立した別の更新まで共通ロックで待たせる問題を改善してください。

README・開発指示・依存関係と、状態の読み書き・ロック取得・awaitを含むコードを読んでください。既存の言語・実行環境で進め、各値の更新担当と、判断が参照する値の組を確認してください。

1. 機密情報を除いた再現入力と変更前の値を保存してください。競合するロックについて、キー別の到着、取得待ち、保持時間、更新順序、判断に使った状態の版を記録してください。
2. 別々に更新できる値と、同時に整合性を守る必要がある値を分けてください。独立な範囲のロックを分割し、各キーの更新順序と書き込み責任を明確にしてください。ロック数や処理担当が無制限に増えないよう管理してください。
3. 複数市場にまたがる判断と、共通の残高・資金予約の保護を設計してください。残高の確認と予約を一体として確定し、複数の注文が同じ資金を使えると判断しないようにしてください。複数ロックを使う場合は取得順序も決めてください。
4. await中の状態変更と、並列解析の完了順を調べてください。判断に使う版と読み取り方法を定義し、解析が終わった順に必要な適用順序を変えないでください。ロックを分けた後にも、実行資源や同じキーの競合による待ちが残るか確認してください。
5. 同じ入力・到着順で、独立キー、同じキーへの集中、共有資金の予約競合、処理の中断・再開を再現してください。ロック待ち、受信から判断完了までのp50/p95/p99、CPU・メモリを比較し、必要な更新順序、判断時の状態の整合性、資金の二重予約がないことを確認してください。ホスト内の時間は単調時計で測り、測定の始点・終点を明記してください。

既存の承認・権限と開発手順を引き継いでください。この指示だけで、本番変更・有料契約・実売買の権限を追加しないでください。秘密鍵・認証情報・顧客データは出力しないでください。

最後に、変更箇所、比較条件、変更前後の値、正しさの確認、残る制約を報告してください。測れない値は未測定としてください。
このアプリで、ある市場やキーの更新が、独立した別の更新まで共通ロックで待たせる問題を改善してください。
README・開発指示・依存関係と、状態の読み書き・ロック取得・awaitを含むコードを読んでください。既存の言語・実行環境で進め、各値の更新担当と、判断が参照する値の組を確認してください。
1. 機密情報を除いた再現入力と変更前の値を保存してください。競合するロックについて、キー別の到着、取得待ち、保持時間、更新順序、判断に使った状態の版を記録してください。
2. 別々に更新できる値と、同時に整合性を守る必要がある値を分けてください。独立な範囲のロックを分割し、各キーの更新順序と書き込み責任を明確にしてください。ロック数や処理担当が無制限に増えないよう管理してください。
3. 複数市場にまたがる判断と、共通の残高・資金予約の保護を設計してください。残高の確認と予約を一体として確定し、複数の注文が同じ資金を使えると判断しないようにしてください。複数ロックを使う場合は取得順序も決めてください。
4. await中の状態変更と、並列解析の完了順を調べてください。判断に使う版と読み取り方法を定義し、解析が終わった順に必要な適用順序を変えないでください。ロックを分けた後にも、実行資源や同じキーの競合による待ちが残るか確認してください。
5. 同じ入力・到着順で、独立キー、同じキーへの集中、共有資金の予約競合、処理の中断・再開を再現してください。ロック待ち、受信から判断完了までのp50/p95/p99、CPU・メモリを比較し、必要な更新順序、判断時の状態の整合性、資金の二重予約がないことを確認してください。ホスト内の時間は単調時計で測り、測定の始点・終点を明記してください。
既存の承認・権限と開発手順を引き継いでください。この指示だけで、本番変更・有料契約・実売買の権限を追加しないでください。秘密鍵・認証情報・顧客データは出力しないでください。
最後に、変更箇所、比較条件、変更前後の値、正しさの確認、残る制約を報告してください。測れない値は未測定としてください。4. 変わらない準備を先に済ませ、受信後の仕事を減らす
価格の更新データを受け取るたびに、同じ固定IDを解析し、同じ条件から固定アドレスを導出し、作業用メモリを確保しているとします。作業用メモリはバッファとも呼ばれます。この3種類の準備を毎回行うと、変わっていない情報を用意する時間も、判断までの経路へ入ります。
入力条件が変わらない準備は、データの到着前に済ませて再利用できます。到着後は、今回変わった情報を確認し、最終的に送るメッセージを組み立て、その内容へ署名します。
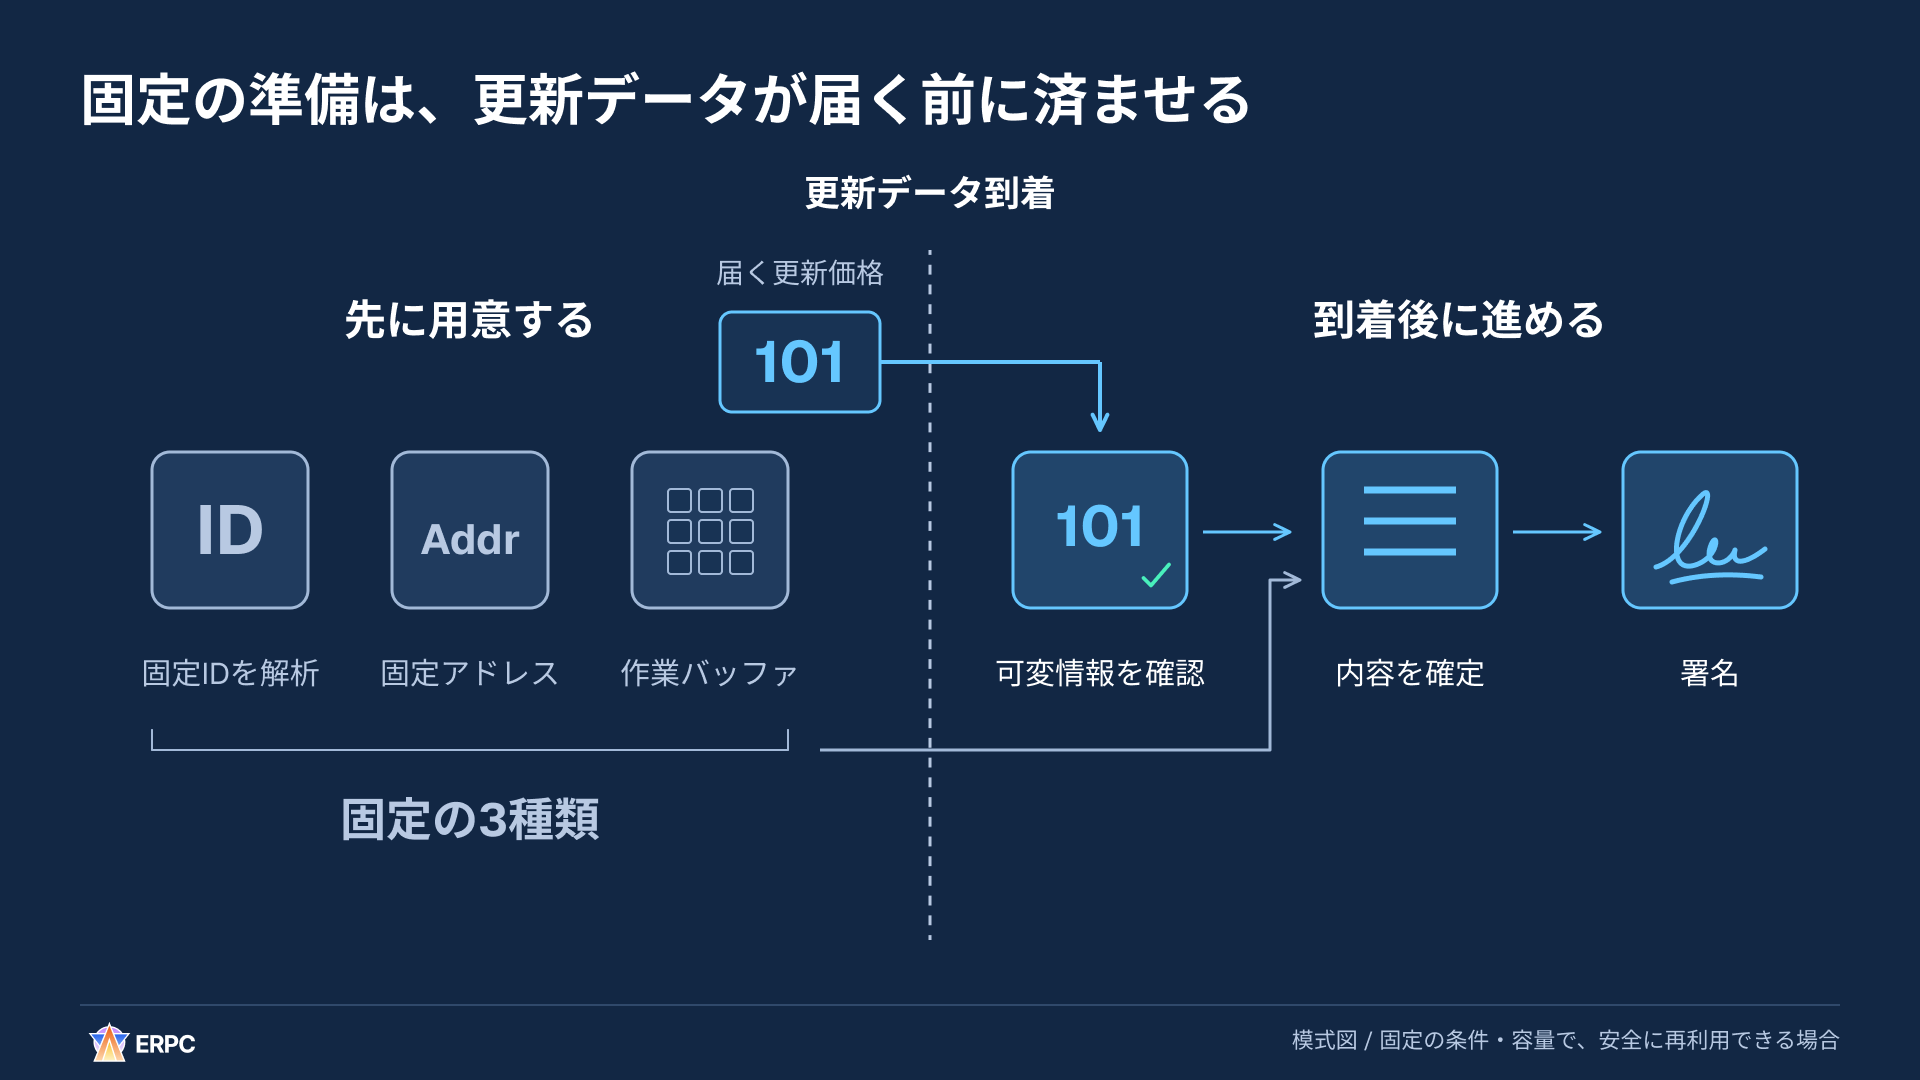
変わらない準備を前へ移し、今回の内容の確認と署名は到着後に行います。
何が減るのかを、3件の更新で数えます。毎回3種類を準備すると、合計9回です。先に用意した3種類を順に使い回せば、固定準備は3回で済みます。どちらも入力するデータは3件で、1件ずつ処理して3件を出力します。
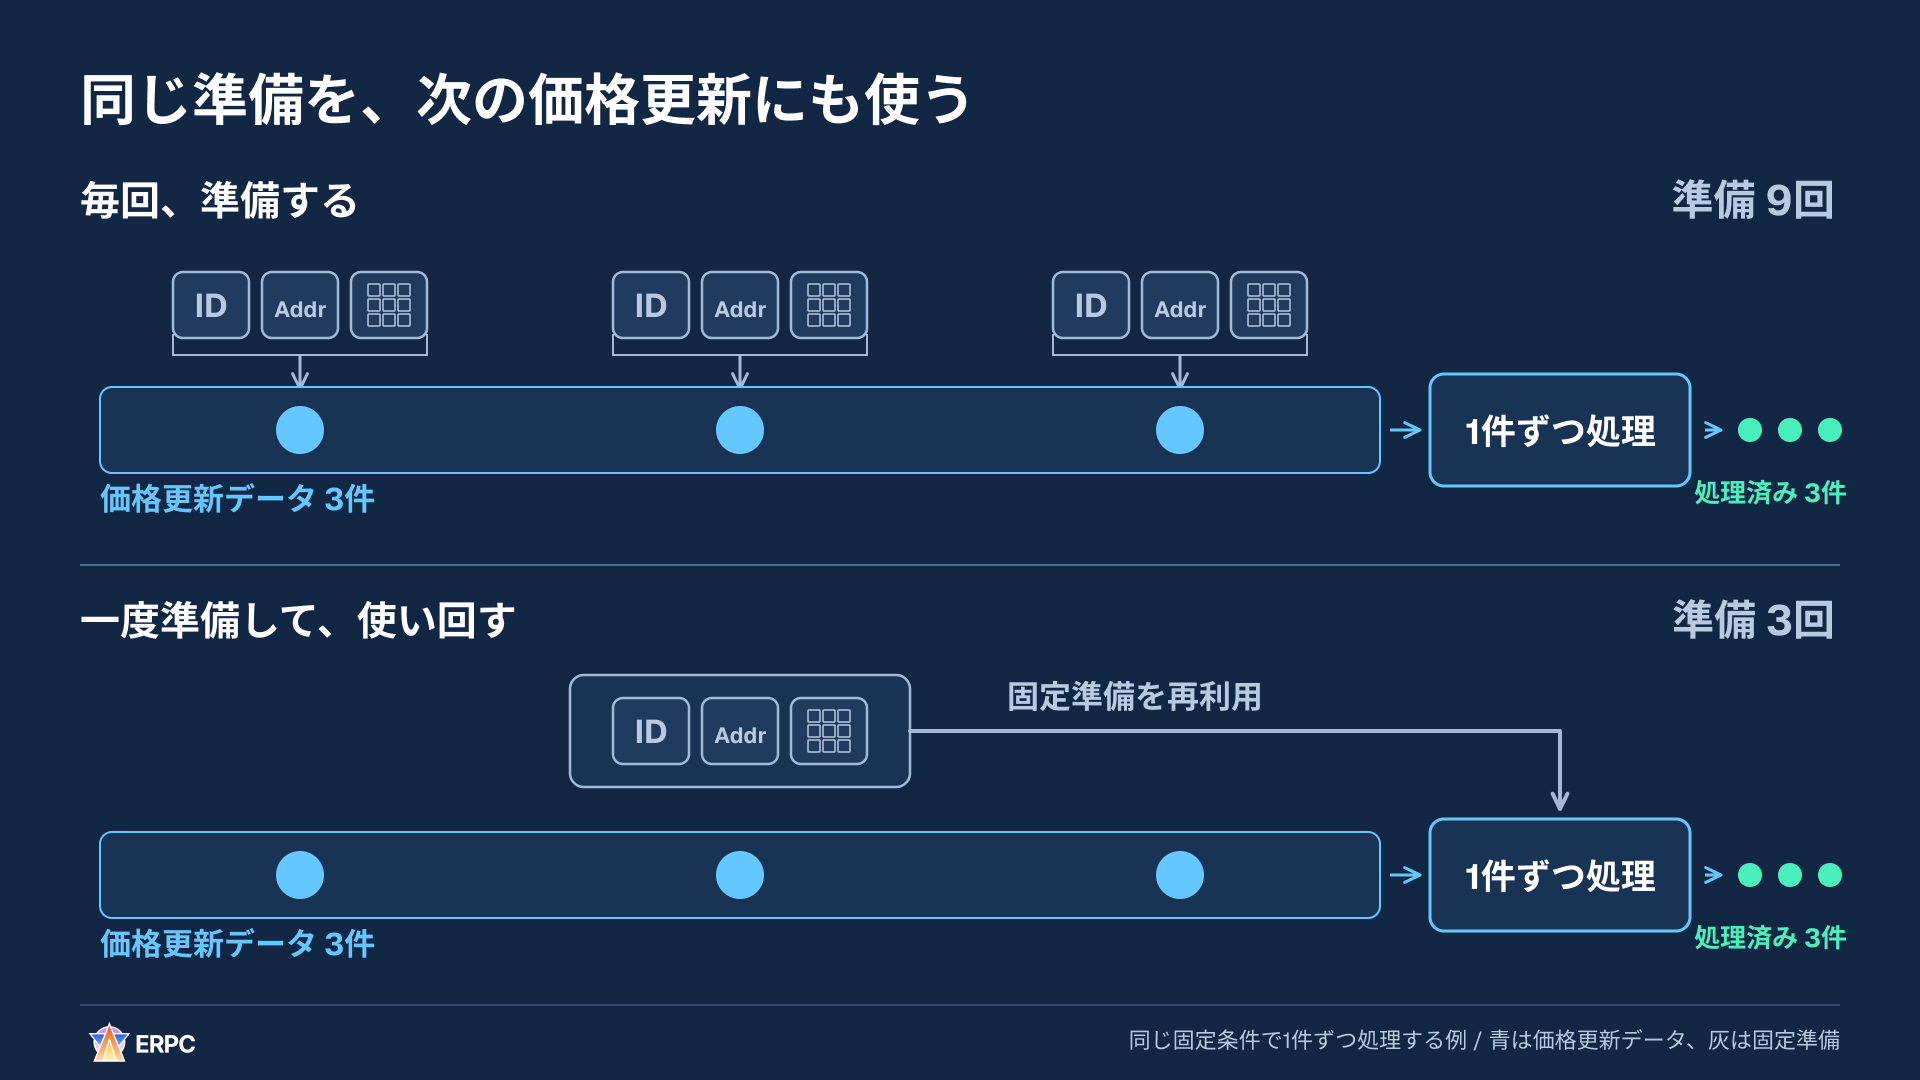
処理するデータは3件のまま、固定準備を9回から3回へ減らす例です。
この比較は、固定条件が変わらず、作業用メモリを順に安全に再利用できる場合を表しています。メモリの中身は、その都度、今回のデータに合わせて書き換えます。同時に複数の処理で使う場合は、同じ領域を上書きし合わないよう、処理ごとの領域や、貸し出しを管理するプールを用意します。
同じ例を1,000件に広げると、毎回3種類を準備する構成は3,000回、共通の準備を一度済ませる構成は3回です。左右とも1,000件を入力し、1件ずつ処理して1,000件を出力します。準備の回数と、処理するイベントの数を分けて見てください。
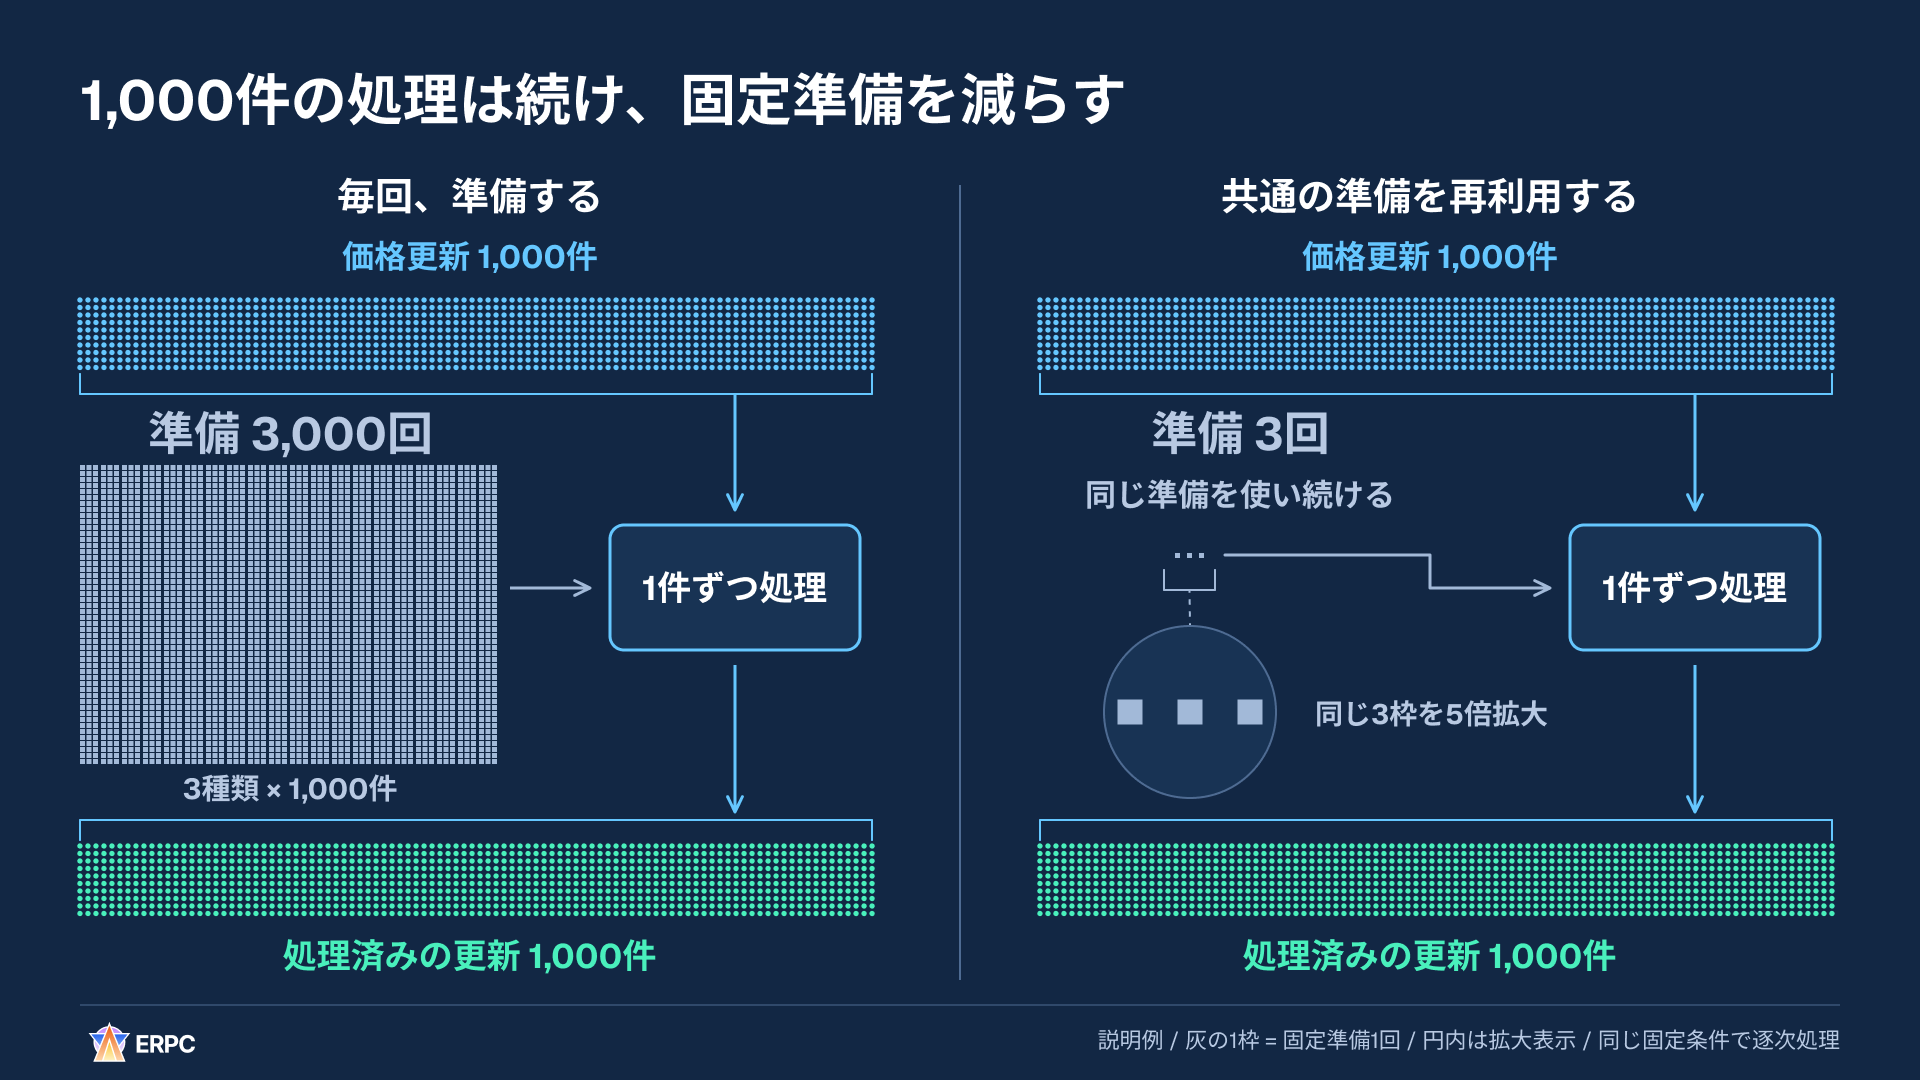
減ったのは繰り返す固定準備です。確認・判断・署名などの仕事は残るため、この回数の差をアプリ全体の速度倍率としては扱えません。
再利用を続けられる条件も決めておきます。固定アドレスの導出に使う入力が変わったなら、再計算が必要です。価格、数量、残高、参照するアカウントの状態、リスク上限、blockhashは、判断時に有効なものを使います。継続更新しているローカル状態を使う場合は、その版・鮮度・有効性を確認します。この確認のために、毎回すべてをRPCで取得し直す必要があるとは限りません。
SolanaのgetLatestBlockhashは、blockhashと、その有効期限を示すlastValidBlockHeightを返します。期限の判定ではblock heightとslotを区別します。[7] 最終メッセージを確定してから署名し、署名後にそのメッセージを書き換えた場合は、その内容に対応する署名を作り直します。[19]
固定準備を再利用し、受信後の仕事を減らしたい場合は、次の指示をコピーできます。
text
このアプリで、同じ解析・アドレス導出・メモリ確保を入力ごとに繰り返す処理を調べ、再利用できる準備を受信前へ移してください。

README・開発指示・依存関係と、受信→準備→判断→メッセージ作成→署名のコードを読んでください。既存の言語・実行環境・SDKで進め、準備の入力、出力、所有者、有効期間を確認してください。

1. 機密情報を除いた再現入力を保存し、処理するイベント数と出力数、準備ごとの実行回数・所要時間、メモリ確保量、受信から判断完了までの時間を記録してください。
2. 入力条件が変わらない準備を特定し、その結果を初期化時などに作って再利用してください。再利用のキー、入力や設定が変わったときの無効化・再計算、キャッシュとバッファプールの上限を実装してください。
3. 作業用メモリの中身は今回のデータへ更新してください。同時実行では処理ごとの領域や貸し出し管理を使い、使用中の領域を上書き・返却しないようにしてください。
4. 価格・数量・残高・アカウント状態・リスク条件・blockhashの有効性は、判断時の条件に合わせて確認してください。継続更新するローカル状態を使う場合は版と鮮度を検証してください。Solanaではblockhashの期限にlastValidBlockHeightを用いる際、block heightとslotを混同しないでください。最終メッセージを確定してから署名し、署名後に内容を変えた場合は署名を作り直してください。
5. 同じ入力で準備の回数・時間、受信から判断完了までのp50/p95/p99、CPU・メモリ、出力を比較してください。入力条件や設定の変更、期限切れ、同時実行も再現し、古い結果の誤使用とメモリの競合を検証してください。準備回数の比を、そのまま全体の速度倍率にしないでください。ホスト内の時間は単調時計で測り、測定の始点・終点を明記してください。

既存の承認・権限と開発手順を引き継いでください。この指示だけで、本番変更・有料契約・実売買の権限を追加しないでください。秘密鍵・認証情報・顧客データは出力しないでください。

最後に、変更箇所、比較条件、変更前後の値、正しさの確認、残る制約を報告してください。測れない値は未測定としてください。
このアプリで、同じ解析・アドレス導出・メモリ確保を入力ごとに繰り返す処理を調べ、再利用できる準備を受信前へ移してください。
README・開発指示・依存関係と、受信→準備→判断→メッセージ作成→署名のコードを読んでください。既存の言語・実行環境・SDKで進め、準備の入力、出力、所有者、有効期間を確認してください。
1. 機密情報を除いた再現入力を保存し、処理するイベント数と出力数、準備ごとの実行回数・所要時間、メモリ確保量、受信から判断完了までの時間を記録してください。
2. 入力条件が変わらない準備を特定し、その結果を初期化時などに作って再利用してください。再利用のキー、入力や設定が変わったときの無効化・再計算、キャッシュとバッファプールの上限を実装してください。
3. 作業用メモリの中身は今回のデータへ更新してください。同時実行では処理ごとの領域や貸し出し管理を使い、使用中の領域を上書き・返却しないようにしてください。
4. 価格・数量・残高・アカウント状態・リスク条件・blockhashの有効性は、判断時の条件に合わせて確認してください。継続更新するローカル状態を使う場合は版と鮮度を検証してください。Solanaではblockhashの期限にlastValidBlockHeightを用いる際、block heightとslotを混同しないでください。最終メッセージを確定してから署名し、署名後に内容を変えた場合は署名を作り直してください。
5. 同じ入力で準備の回数・時間、受信から判断完了までのp50/p95/p99、CPU・メモリ、出力を比較してください。入力条件や設定の変更、期限切れ、同時実行も再現し、古い結果の誤使用とメモリの競合を検証してください。準備回数の比を、そのまま全体の速度倍率にしないでください。ホスト内の時間は単調時計で測り、測定の始点・終点を明記してください。
既存の承認・権限と開発手順を引き継いでください。この指示だけで、本番変更・有料契約・実売買の権限を追加しないでください。秘密鍵・認証情報・顧客データは出力しないでください。
最後に、変更箇所、比較条件、変更前後の値、正しさの確認、残る制約を報告してください。測れない値は未測定としてください。5. 更新を取りこぼした状態で、判断を続けない
ここでは、同じ銘柄を扱う二つの市場で、価格差B−Aを計算します。接続が切れている間に市場Aが100から105へ変わり、その更新を受け取れなかったとします。再接続後にBの104だけが届くと、アプリの計算は104−100で+4です。Aの更新を反映した値では104−105で-1となり、符号まで変わります。
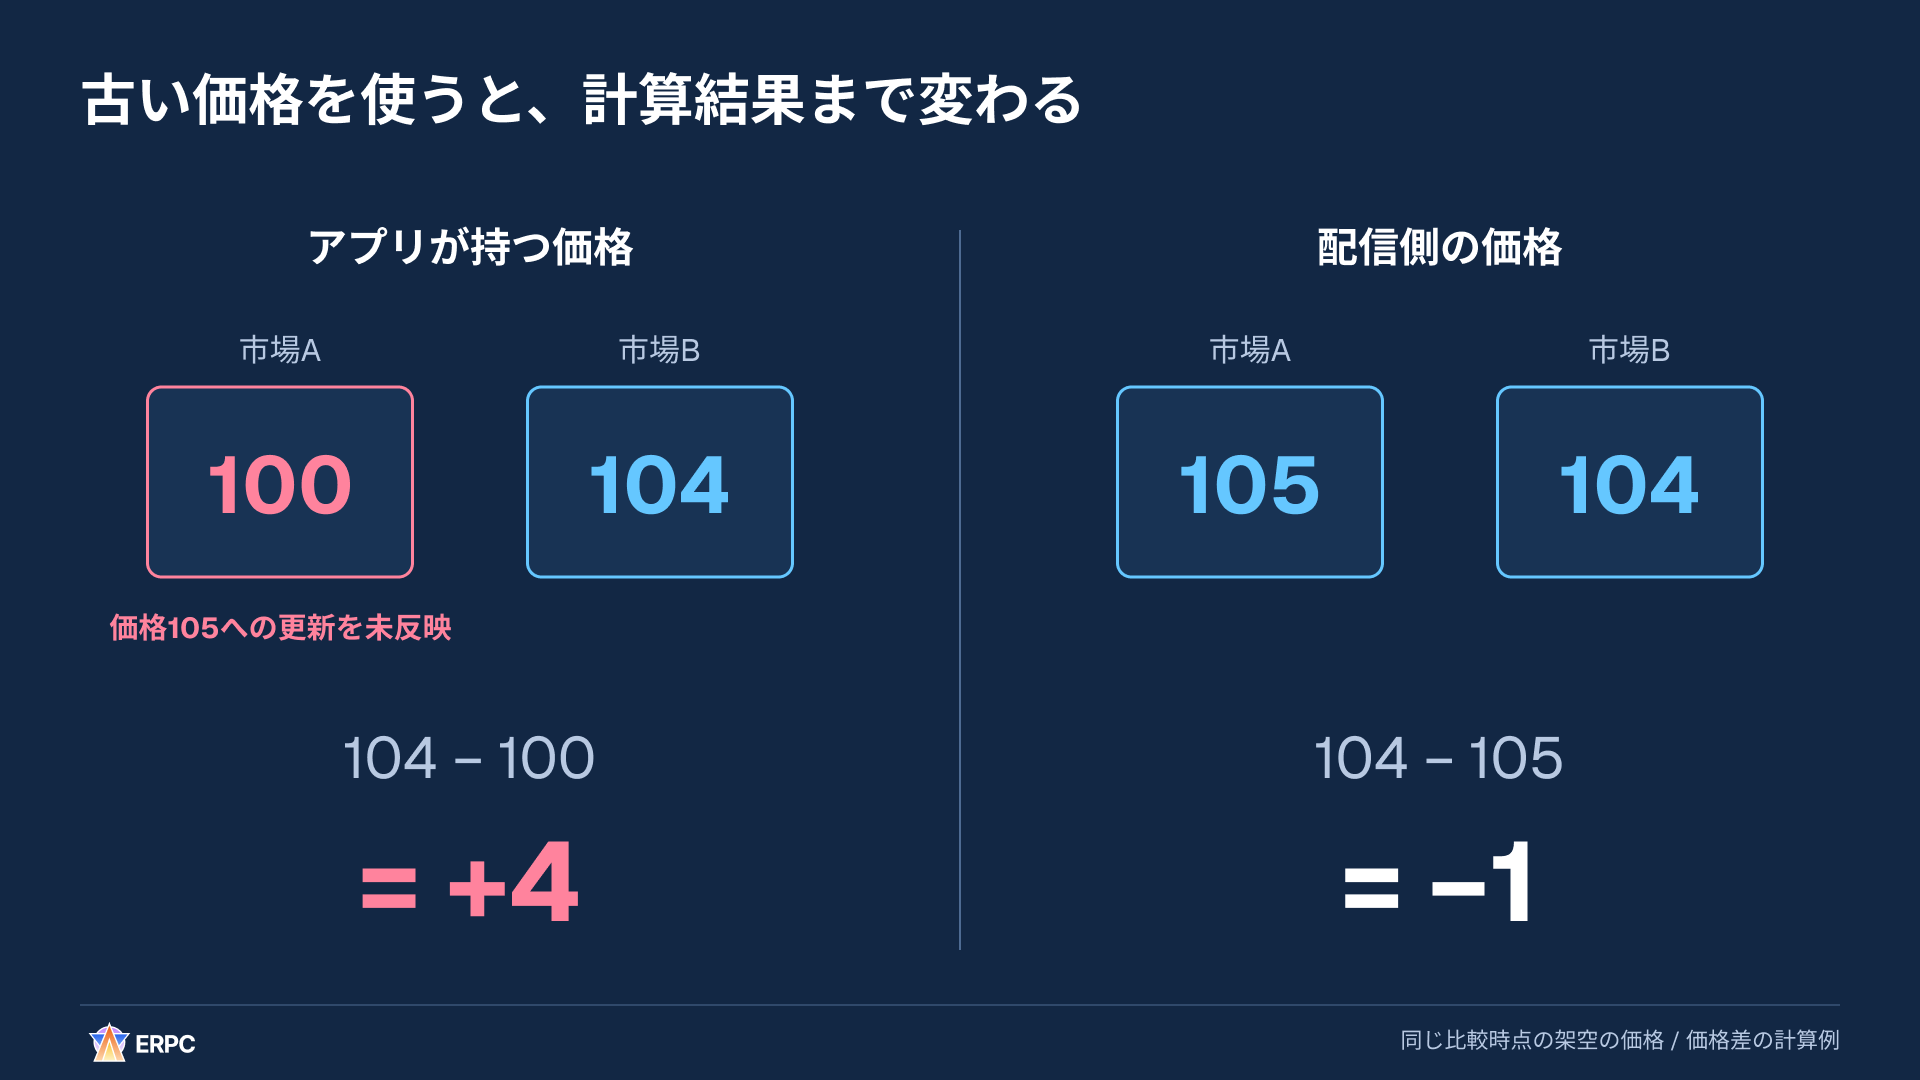
Aの古い100を使うか、更新後の105を使うかで、同じ計算の結果が変わります。
これは価格差だけのモデルです。手数料や約定条件などは含まず、売買の利益を示していません。ここで確認したいのは、接続が戻っただけでは、判断に必要な更新が揃うとは限らないことです。
この例では、AとBの価格を使う新たな取引判断を保留し、まず古いAの100を、取得した105へ更新します。その後、AとBについて判断に必要な更新を反映できたか、採用する更新順序や鮮度の条件を満たすかを確認します。必要な確認が済んだら再開し、確認できない間は保留を続けます。
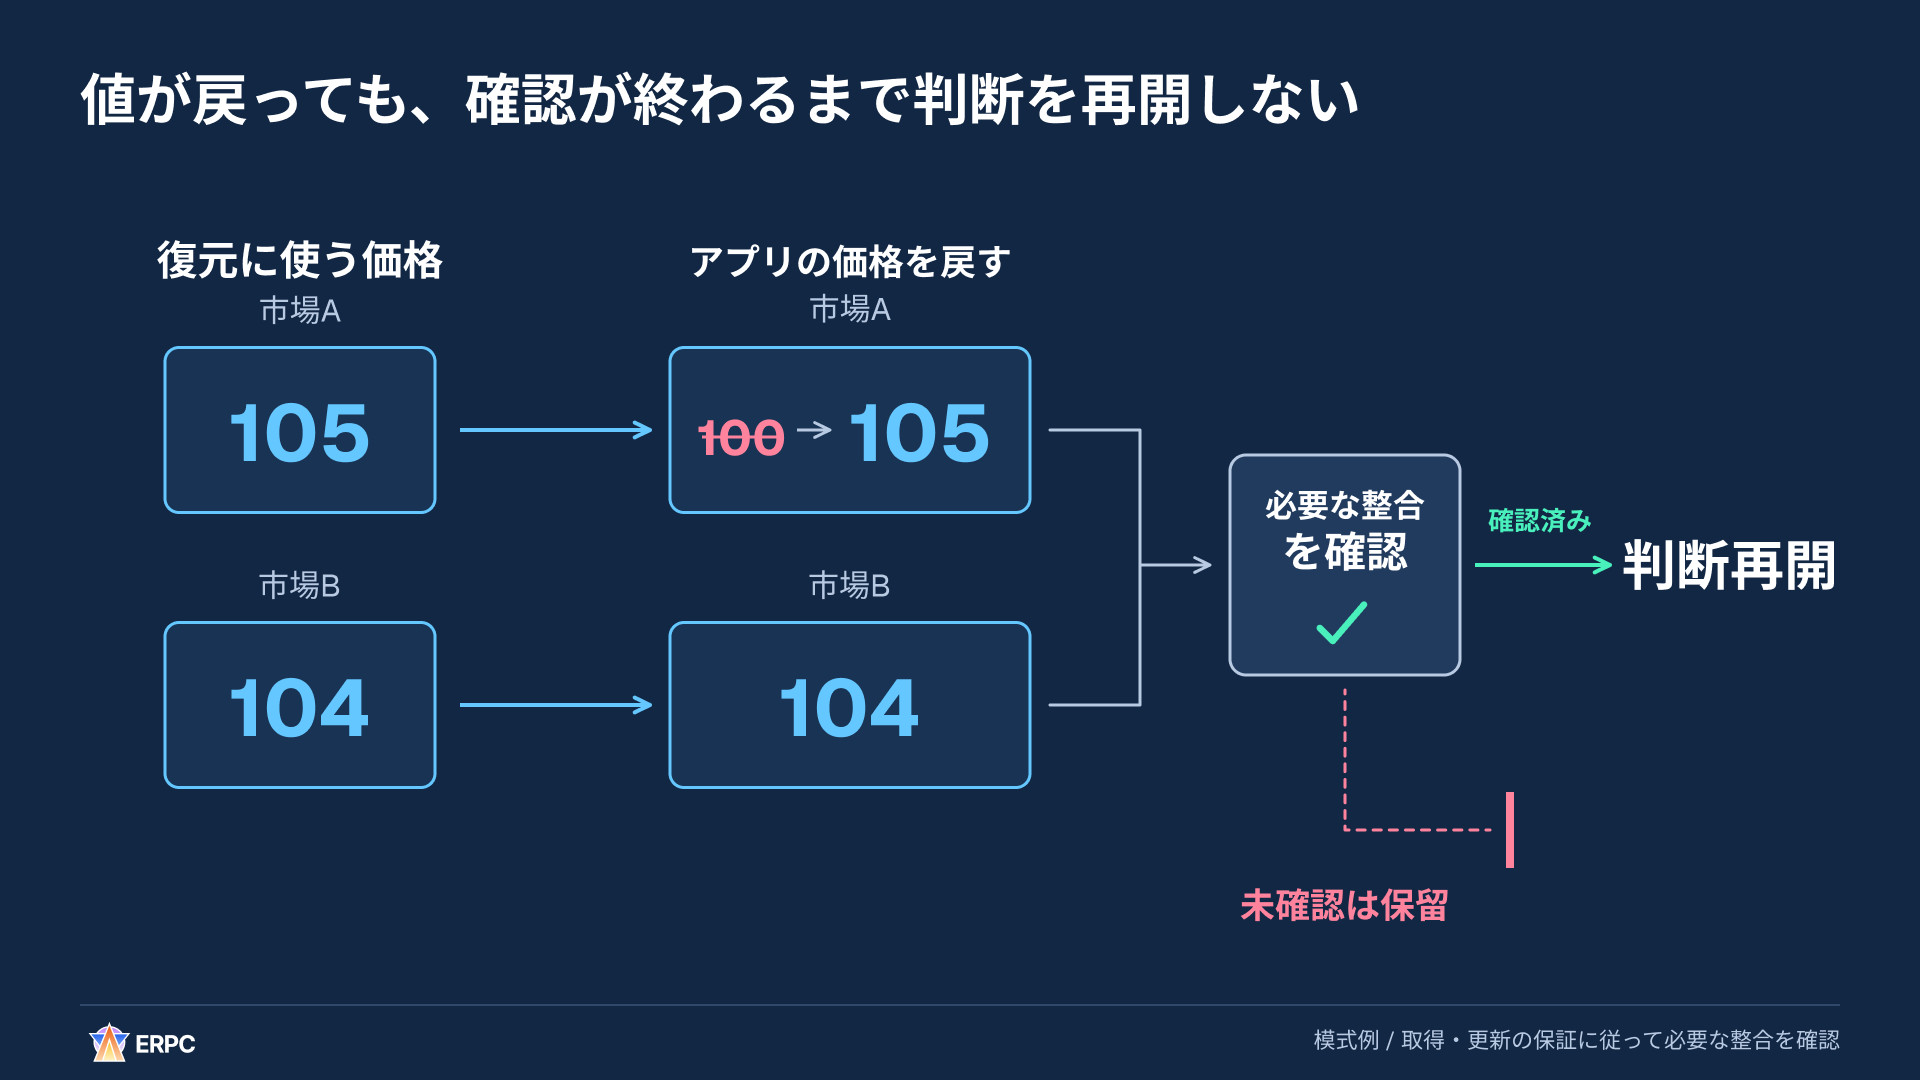
値を更新する工程と、その値で判断してよいか確認する工程を分けます。
復旧時によく使うのが、ある時点の状態をまとめて取得するスナップショットです。これを継続的な更新ストリームへつなぐときは、スナップショットにどこまでの更新が含まれ、どこから後の更新を適用すればよいかを確認します。すでに含まれる差分を二重に適用したり、境界にある更新を取りこぼしたりしないためです。具体的な接続方法は、使うAPIが提供する購読開始・識別・再取得・再送の保証に合わせます。
Yellowstoneのメッセージにはslotやwrite_versionがあります。[16] こうした値だけで、提供者をまたいでも使える連番や、欠落を完全に検出できる保証があると決めつけないでください。slot差だけを欠損件数や遅延秒数へ置き換えず、採用した配信元の保証に沿って、状態をつなぎ直せたかを確認します。
復旧前に始めた計算にも注意が必要です。古い状態で計算を始めた処理が復旧後に終わると、その結果で新しい状態を上書きするおそれがあります。復旧の前後で状態に世代番号を付けるなどして、古い世代の結果を適用しないようにします。processedの状態を使う場合は、その状態が後から採用されなくなるロールバックも、状態を見直す条件に含めます。[6]
再接続後に正しい状態へ戻してから判断を再開したい場合は、次の指示をコピーできます。
text
このアプリで、再接続しただけで古い状態を使った取引判断が再開されることを防ぎ、必要な状態を復旧してから再開する仕組みを実装してください。

README・開発指示・依存関係と、購読・初期取得・更新適用・再接続・判断のコードを読んでください。既存の言語・実行環境・SDKで進め、配信元、commitment、更新の意味、順序・識別・再取得・再送の実際の保証を確認してください。

1. 接続状態、データの有効性、判断を再開してよい状態を分けてください。必要な更新の欠落や鮮度不足が判明したら、その状態に依存する新たな取引判断を保留し、必要な受信・更新・復旧を進めてください。
2. スナップショットを使う場合は、含まれる更新の範囲と、その後のストリームとの境界を配信元の保証から決めてください。差分の二重適用、境界の取りこぼし、順序の逆転を防ぎ、保証が確認できない部分を推測で埋めないでください。slotやwrite_versionを、無条件に欠落検出できる連番として扱わないでください。
3. 値を取得しただけで再開せず、判断に必要な対象の更新・順序・鮮度・整合性を確認する条件を実装してください。確認できない間は対象の判断を保留してください。復旧前の処理が後から完了しても、古い計算結果や注文案を適用・送信しないよう、世代番号等で管理してください。再開時には、有効と確認した状態から判断し直してください。processedを使う場合はロールバック時の無効化・復旧も扱ってください。
4. 機密情報を除いた再現入力で、切断中の更新欠落、重複、順序逆転、鮮度不足、連続する再接続、古い世代の処理完了を再現してください。接続復帰から検証完了まで判断が保留され、検証後の状態が期待する結果と一致することを確認してください。
5. 復旧時間、無効状態により抑止した判断の回数と保留期間、再適用・除外した更新、通常時の受信から判断完了までの時間とCPU・メモリを記録してください。測定対象から保留期間や欠落を黙って除かず、測定の始点・終点と、検出できる範囲・できない範囲を明記してください。ホスト内の経過時間には単調時計を使ってください。

既存の承認・権限と開発手順を引き継いでください。この指示だけで、本番変更・有料契約・実売買の権限を追加しないでください。秘密鍵・認証情報・顧客データは出力しないでください。

最後に、変更箇所、比較条件、変更前後の値、正しさの確認、残る制約を報告してください。測れない値は未測定としてください。
このアプリで、再接続しただけで古い状態を使った取引判断が再開されることを防ぎ、必要な状態を復旧してから再開する仕組みを実装してください。
README・開発指示・依存関係と、購読・初期取得・更新適用・再接続・判断のコードを読んでください。既存の言語・実行環境・SDKで進め、配信元、commitment、更新の意味、順序・識別・再取得・再送の実際の保証を確認してください。
1. 接続状態、データの有効性、判断を再開してよい状態を分けてください。必要な更新の欠落や鮮度不足が判明したら、その状態に依存する新たな取引判断を保留し、必要な受信・更新・復旧を進めてください。
2. スナップショットを使う場合は、含まれる更新の範囲と、その後のストリームとの境界を配信元の保証から決めてください。差分の二重適用、境界の取りこぼし、順序の逆転を防ぎ、保証が確認できない部分を推測で埋めないでください。slotやwrite_versionを、無条件に欠落検出できる連番として扱わないでください。
3. 値を取得しただけで再開せず、判断に必要な対象の更新・順序・鮮度・整合性を確認する条件を実装してください。確認できない間は対象の判断を保留してください。復旧前の処理が後から完了しても、古い計算結果や注文案を適用・送信しないよう、世代番号等で管理してください。再開時には、有効と確認した状態から判断し直してください。processedを使う場合はロールバック時の無効化・復旧も扱ってください。
4. 機密情報を除いた再現入力で、切断中の更新欠落、重複、順序逆転、鮮度不足、連続する再接続、古い世代の処理完了を再現してください。接続復帰から検証完了まで判断が保留され、検証後の状態が期待する結果と一致することを確認してください。
5. 復旧時間、無効状態により抑止した判断の回数と保留期間、再適用・除外した更新、通常時の受信から判断完了までの時間とCPU・メモリを記録してください。測定対象から保留期間や欠落を黙って除かず、測定の始点・終点と、検出できる範囲・できない範囲を明記してください。ホスト内の経過時間には単調時計を使ってください。
既存の承認・権限と開発手順を引き継いでください。この指示だけで、本番変更・有料契約・実売買の権限を追加しないでください。秘密鍵・認証情報・顧客データは出力しないでください。
最後に、変更箇所、比較条件、変更前後の値、正しさの確認、残る制約を報告してください。測れない値は未測定としてください。言語の強みを、六つの軸で見比べる
5つの設計を実装すると、誰がデータを更新するか、どこでメモリを確保するか、何をコピーするか、どの処理が待つかを細かく決めることになります。計算が速いこと、急な待ちを抑えやすいこと、試作を早く進められることは、それぞれ別の強みです。言語を選ぶときも、改善したい部分に合わせて比べます。
公開ベンチマークで、実行時間を比べる
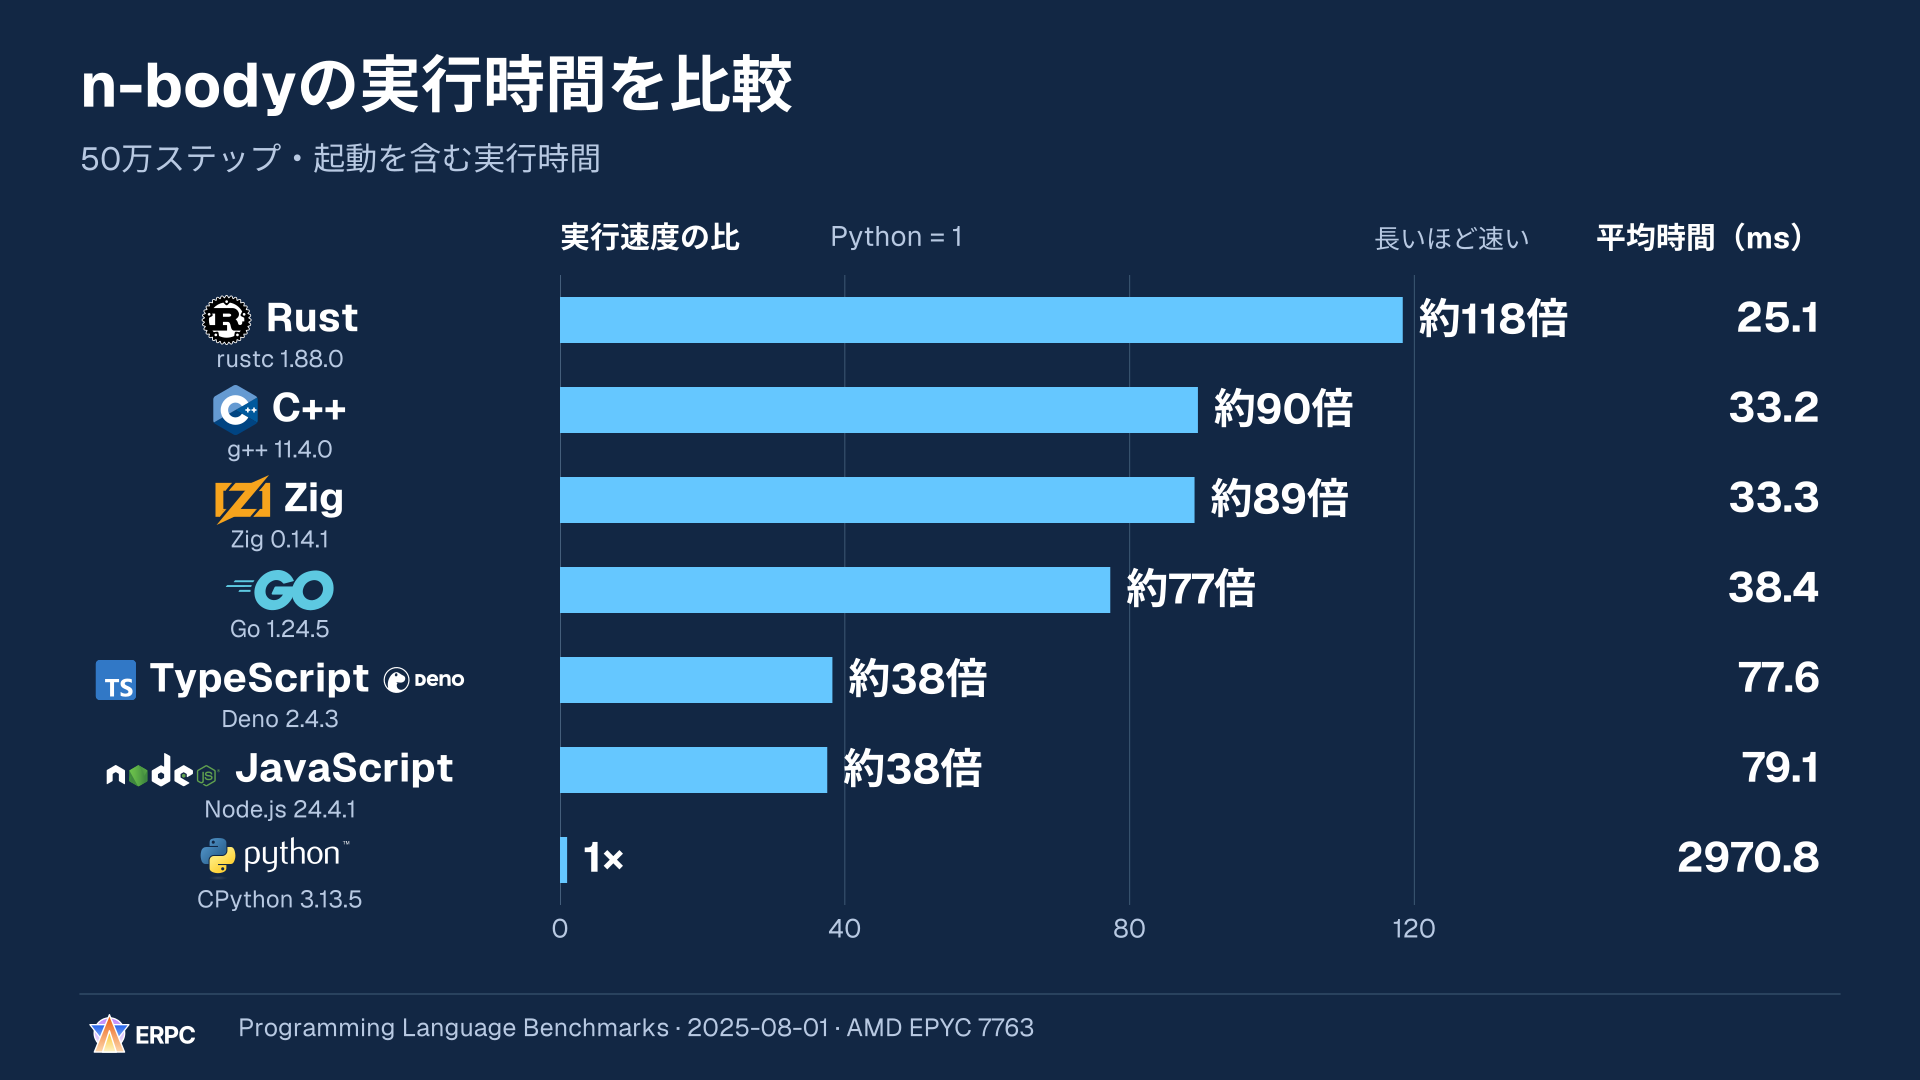
5天体の計算を50万ステップ行った、2025年8月1日の公開測定です。平均実行時間は、起動から処理完了までにかかった時間の平均です。起動処理や実行中のコード最適化を含み、事前のビルド時間は含みません。1,000msは1秒です。[27][29]
| 言語・実行環境 | 平均実行時間 | 相対速度(Python = 1) |
|---|---|---|
| Rust / rustc 1.88.0 | 25.1ms | 約118 |
| C++ / g++ 11.4.0 | 33.2ms | 約90 |
| Zig / Zig 0.14.1 | 33.3ms | 約89 |
| Go / Go 1.24.5 | 38.4ms | 約77 |
| TypeScript / Deno 2.4.3 | 77.6ms | 約38 |
| JavaScript / Node.js 24.4.1 | 79.1ms | 約38 |
| Python / CPython 3.13.5 | 2970.8ms | 1 |
相対速度は、丸める前の平均実行時間から、Pythonを1として算出しました。 各言語・実行系の安定版から、単一スレッドで明示的なSIMD命令・ベクトル型・外部数値ライブラリを使わない実装の最小平均値を選んでいます。コードと最適化は異なり、ZigはReleaseFastです。TypeScriptはDeno/V8を含む実行ファイル、JavaScriptはNode.jsでの結果です。[28]
近い値は同程度と読み、この1課題から言語全体の順位を決めないでください。起動後に動き続けるボットの処理時間や、注文が届くまでの遅延を直接測ったものではありません。
測定環境はAMD EPYC 7763、利用可能4コアのLinuxです。公開コードの計測設定は各条件3回で、毎回新しいプロセスを起動します。当日の実行コミットと各回の生データは確認できていないため、公開平均値の紹介として扱います。[28][29]
六つの軸で、設計上の強みを比べる
次の図は、オフチェーンのSolanaクライアントを作る場合の、3段階の編集上の選定目安です。「計算の速さ」の軸では、自分で書いた処理が大量のデータを読み、計算する場合に、高速化するための選択肢を見ています。通信待ちが大半のアプリ全体や、外部の高速なライブラリへ任せた計算の順位を表すものではありません。
Rust・Go・C++・Zigは、最適化したネイティブ実行の有力候補です。同じ速度という意味ではなく、細かい順位は実際の処理で測る必要があります。V8も、頻繁に実行する関数を機械語へ変換します。単に「JavaScriptは解釈実行だから遅い」とは説明できません。[20][21]
六つの軸のうち「計算の速さ」「遅延制御」「メモリ制御」は、計算と制御に関する強みです。「安全性の支援」「試作のしやすさ」「Solana SDK」は、開発を助ける強みです。すべての軸が処理速度を表しているわけではありません。
六角形は全図で軸と尺度をそろえ、外側ほどその軸の強みが大きい目安とします。実測した速度や倍率を示すものではなく、3が1の3倍という意味もありません。面積を総合点にせず、改善したい軸を一つずつ見比べます。
| 軸 | 比べること |
|---|---|
| 計算の速さ | 自分で書く大量の読み取りや計算を、対象の実行系で高速化するための選択肢 |
| 遅延制御 | メモリの確保・回収や実行時のコード最適化など、急な待ちの原因になる仕事を重要な処理から外しやすいか |
| メモリ制御 | データの置き方、所有・寿命、確保・再利用・解放を自分で決められる範囲 |
| 安全性の支援 | メモリの寿命や共有メモリの扱いを誤ることを防ぐ、言語・実行系・標準的な道具の支援 |
| 試作のしやすさ | 小さなアプリを動かし、変更を試すまでの作りやすさ。経験や既存コードで変わる編集評価 |
| Solana SDK | Solana公式文書から、用途に合うクライアントSDKや実装例を見つけて使い始めやすいか |
制御の軸は直接設計できる範囲、安全性の軸は利用できる支援、SDKの軸は公式文書からの導線を評価しています。同じ段階でも、提供する仕組みや保証は異なります。[8][13][20][21][26]
次の一覧では、Rust・Go・TypeScript・Python・C++・Zigの6言語を、横3列・縦2段で見比べられます。気になる軸を比べ、続く個別図と説明で実行条件や使いどころを確かめてください。
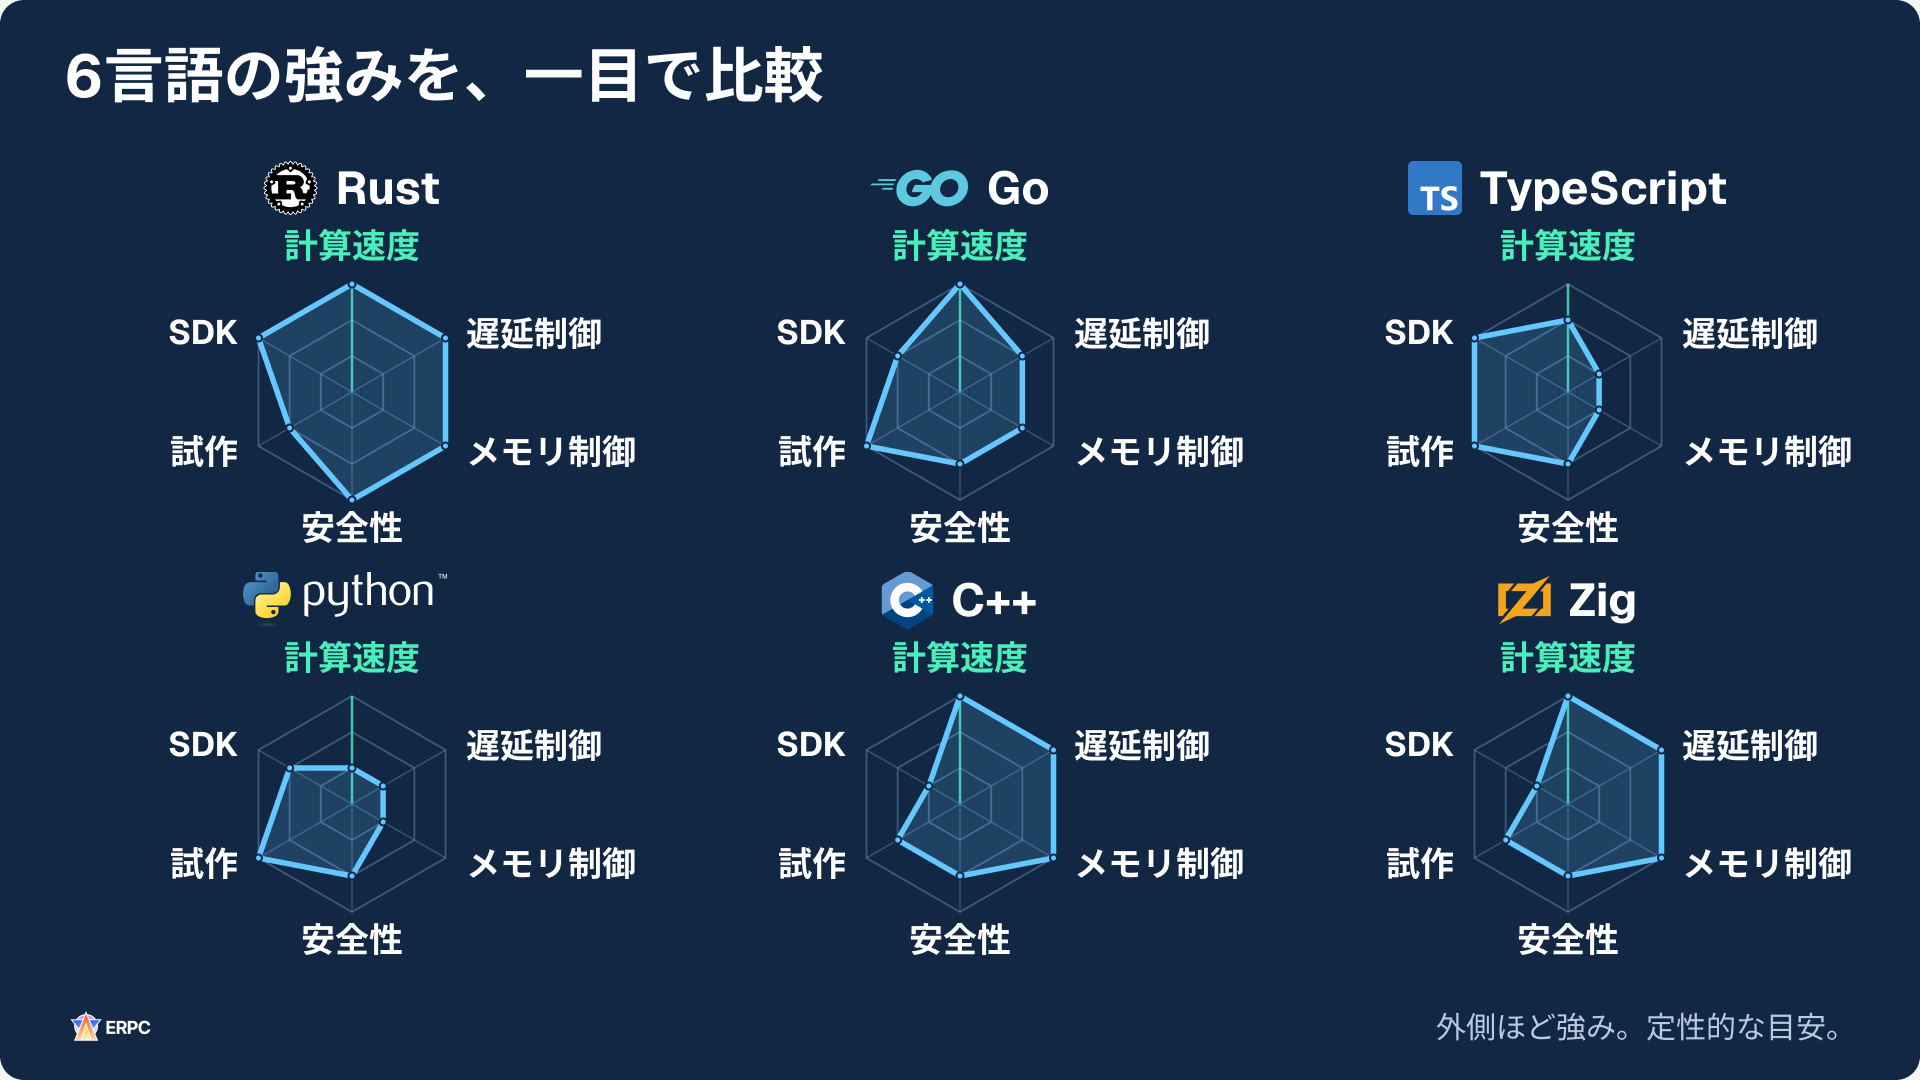
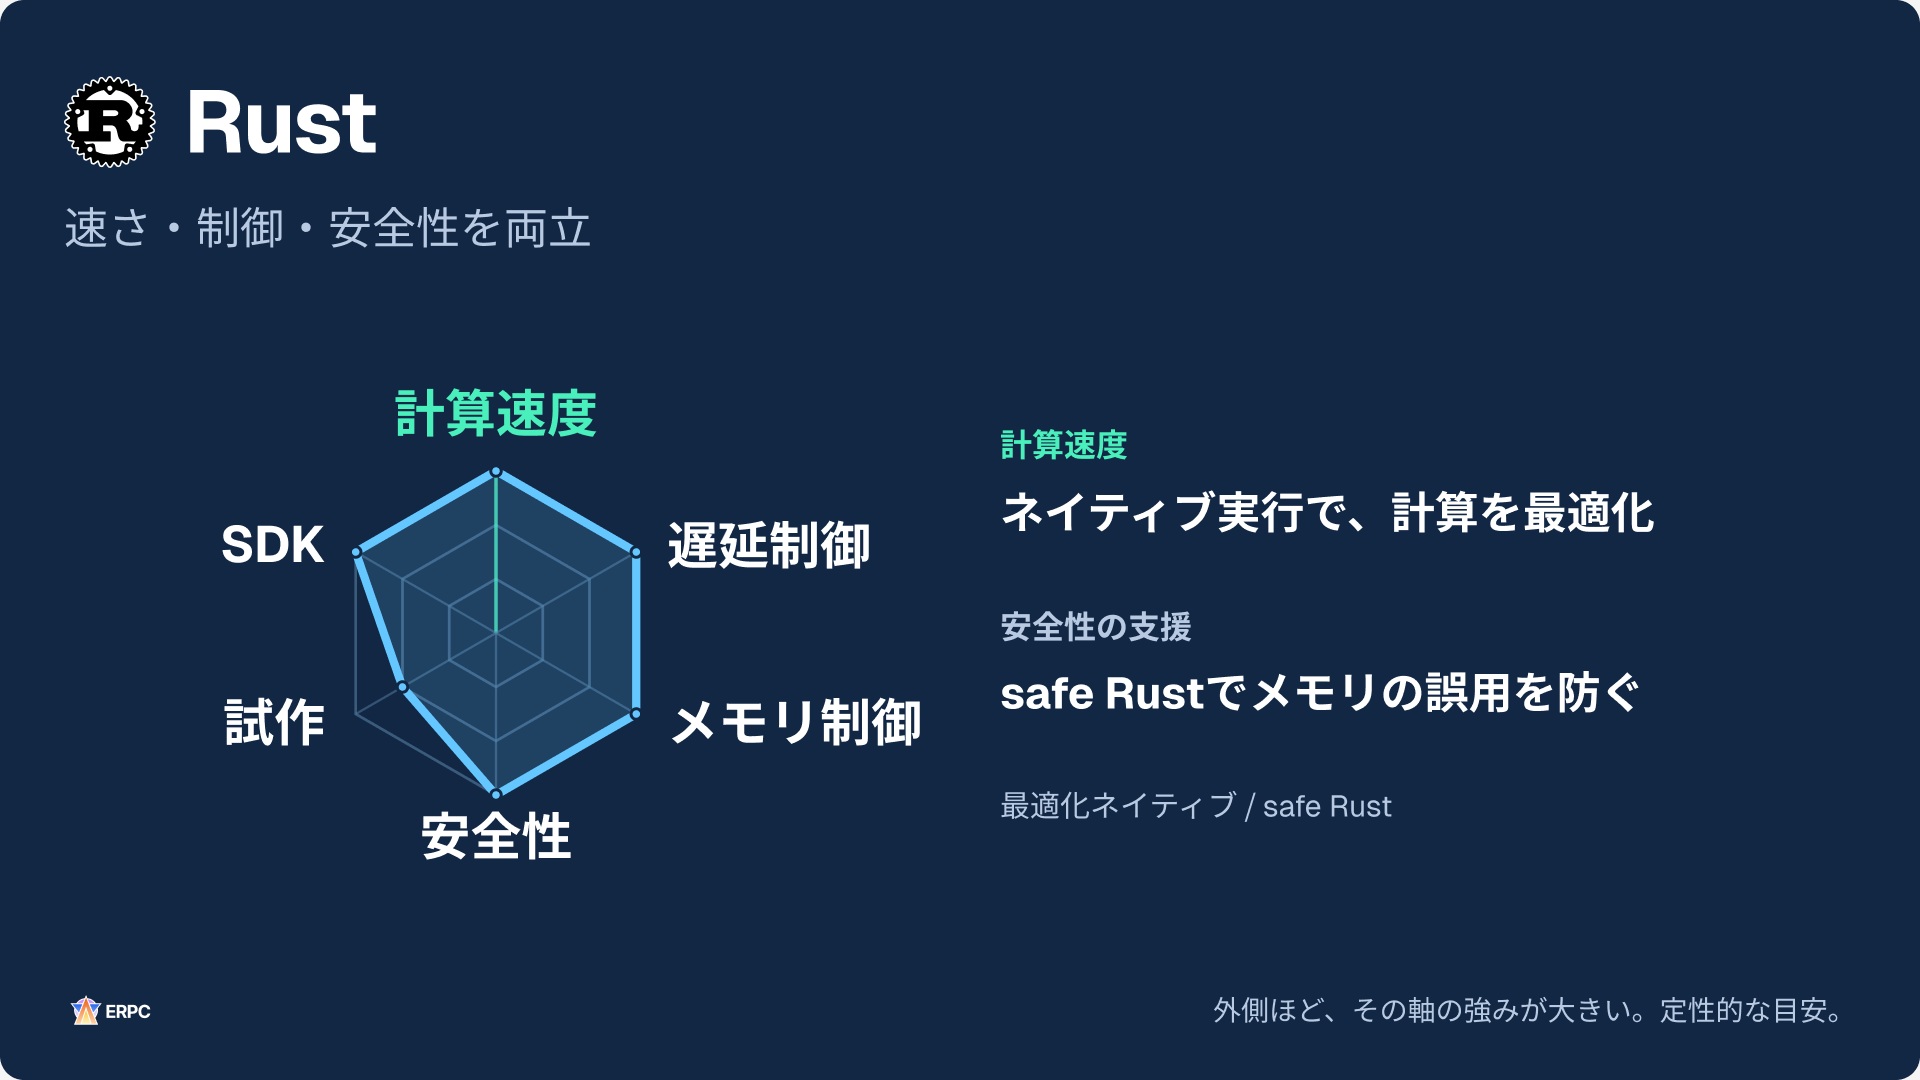
Rustは、重要な処理のメモリ配置や確保・再利用を詰めながら、所有権と借用の検査を使える候補です。通常のメモリ管理にトレーシングGCを必要としません。[8] safe Rustのdata raceに対する保証は、一般の競合条件やデッドロック、判断ロジックの正しさまで保証するものではありません。unsafeや外部言語との接続には別の確認が必要です。[22] Rustでもコピー、確保・解放、ロック、OSの待ちは発生するため、実際の入力と負荷で確かめます。
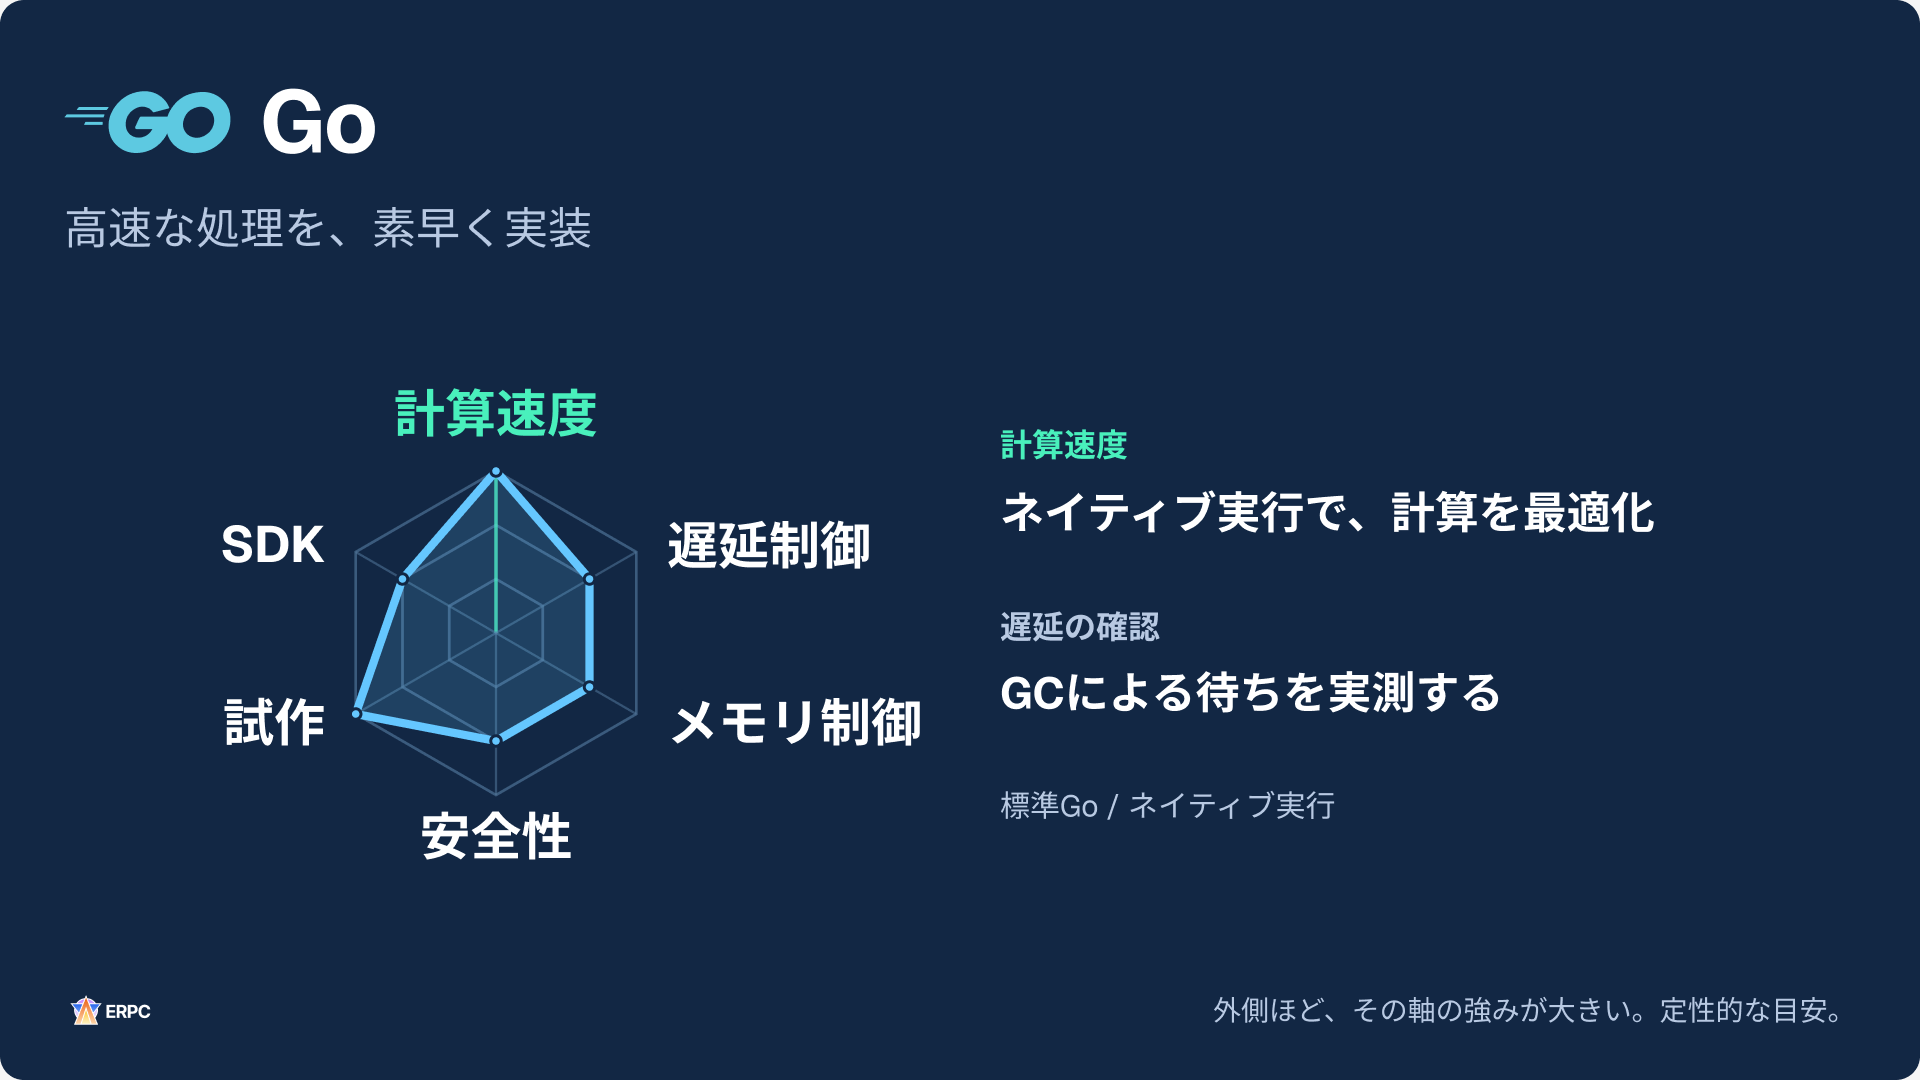
Goもネイティブにコンパイルして実行する候補です。並行するサービスや処理を組み立てやすく、メモリ管理などをランタイムが支えます。[20] GCの仕事は主に並行して進みますが、確保量とGCによるCPU・メモリ・遅延の費用を測ります。CPU処理の候補としての評価と、回収のタイミングをどこまで直接制御できるかを分けて見ます。[13]
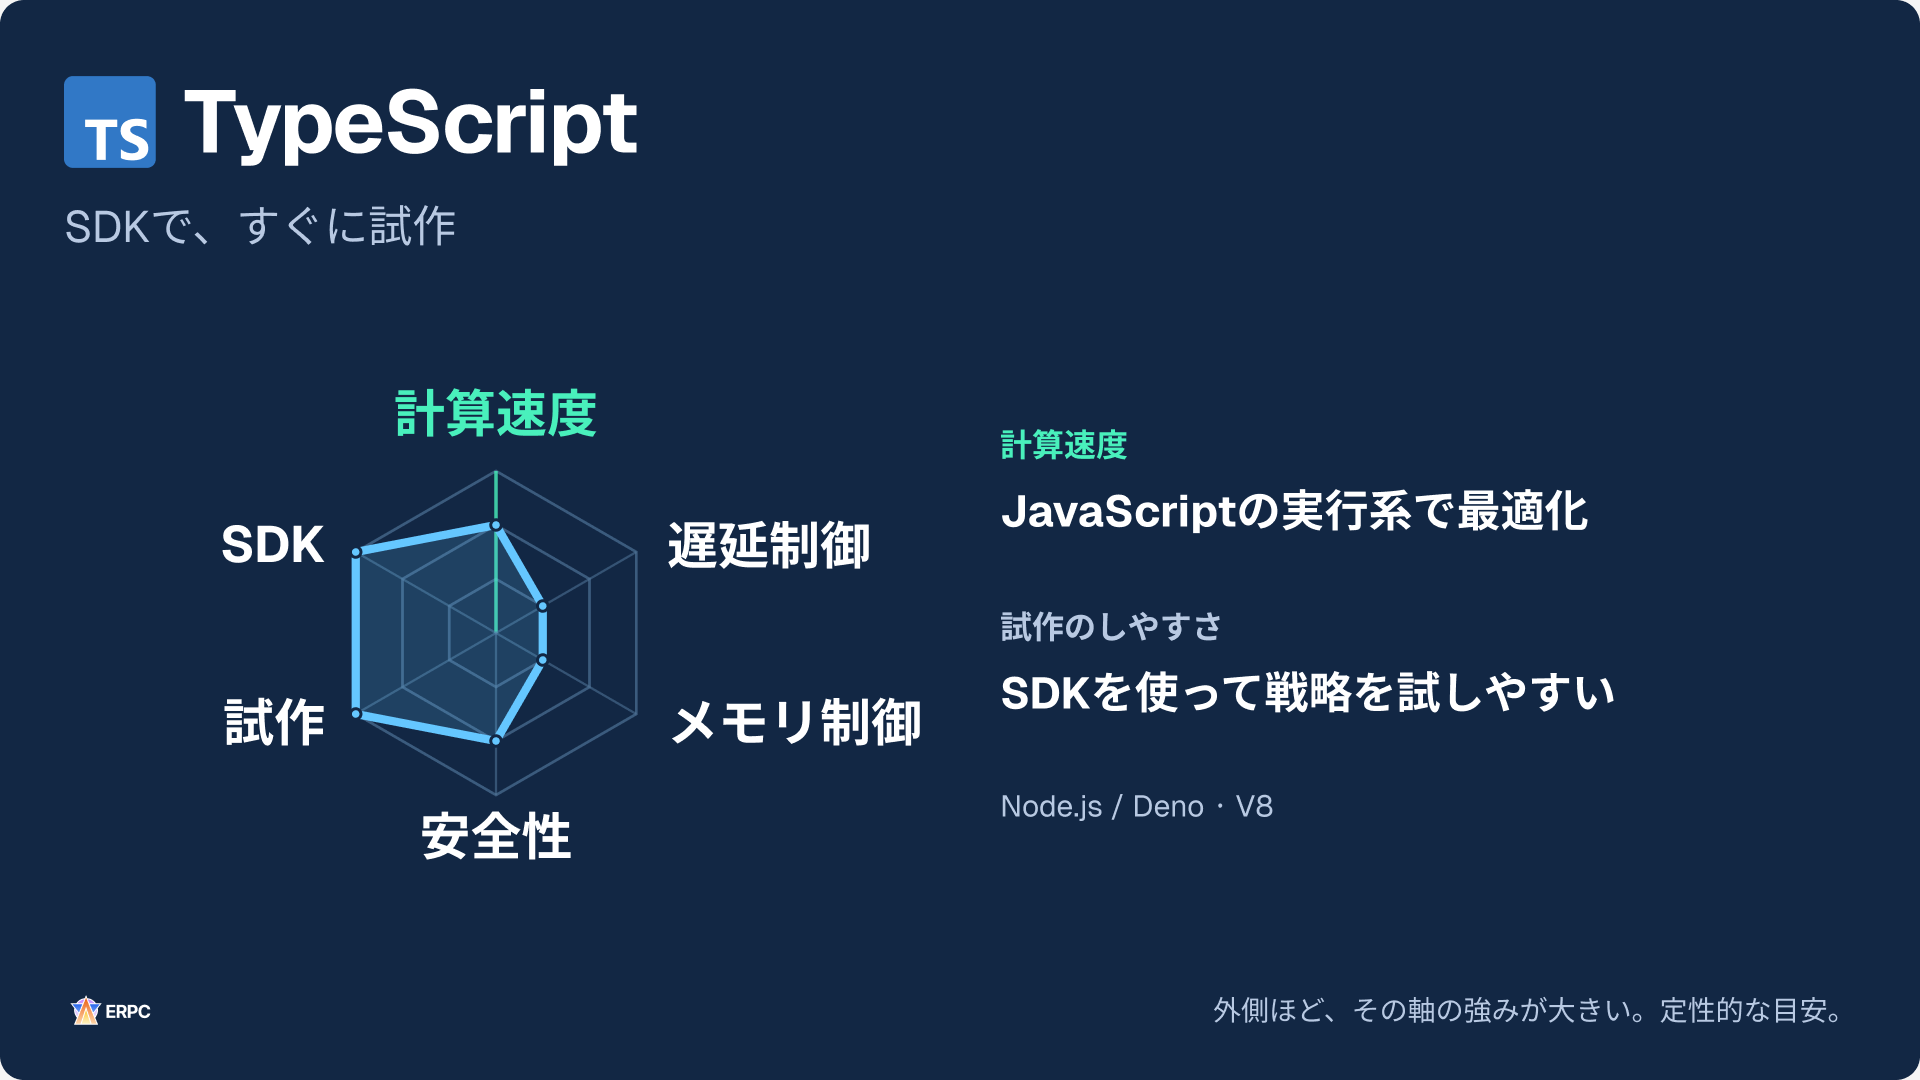
TypeScriptは言語で、Node.jsとDenoは実行環境です。この図ではV8上のJavaScriptとして扱います。型注釈は実行時には消えるため、型を付けたこと自体でCPU処理が速くなるわけではありません。外部から届くデータの実行時検証も別に必要です。[9][10][21] API連携、設定管理、監視、Web UI、必要な性能を満たすストリーム処理の候補として使えます。
Node.jsのworker_threadsやDenoのWeb Workersは、CPU処理を別の実行場所へ移す選択肢です。Node.jsの公式文書は、仕事ごとにworkerを作る方法よりプールを使う方法を勧めています。移動先の計算だけでなく、変換・コピー・投入待ちまで含めて比べます。[11][12]
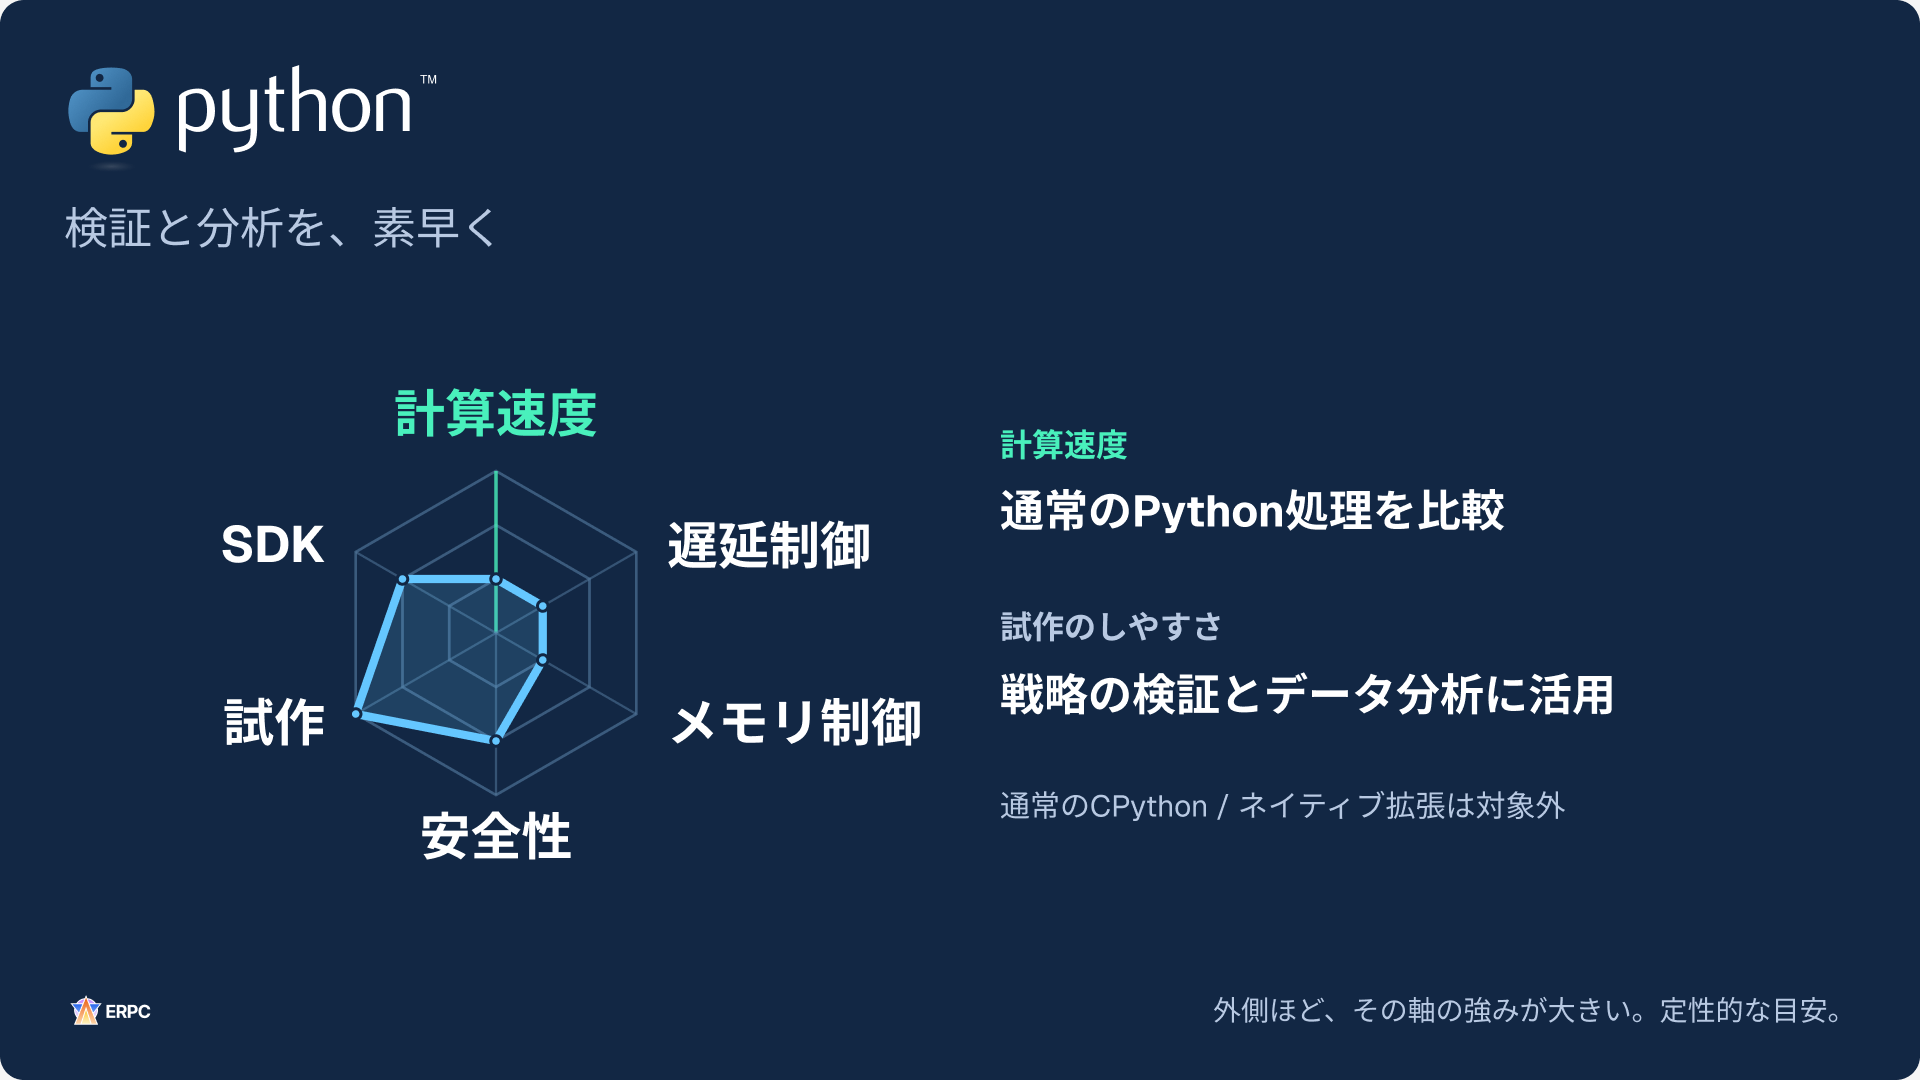
Pythonは研究、分析、検証、既存ライブラリを使う処理の候補です。この図の「計算の速さ」の評価は、通常のCPython内でPythonコードのループを回す場合です。NumPyなどのコンパイル済み処理へ任せる計算とは分けて考えます。[23] free-threaded buildを含む実際の構成も確認し、Pythonという名前だけで判断しません。[14] 一部をRust等へ移す場合も、境界での変換やコピーを含め、アプリ全体で効果が出るか測ります。
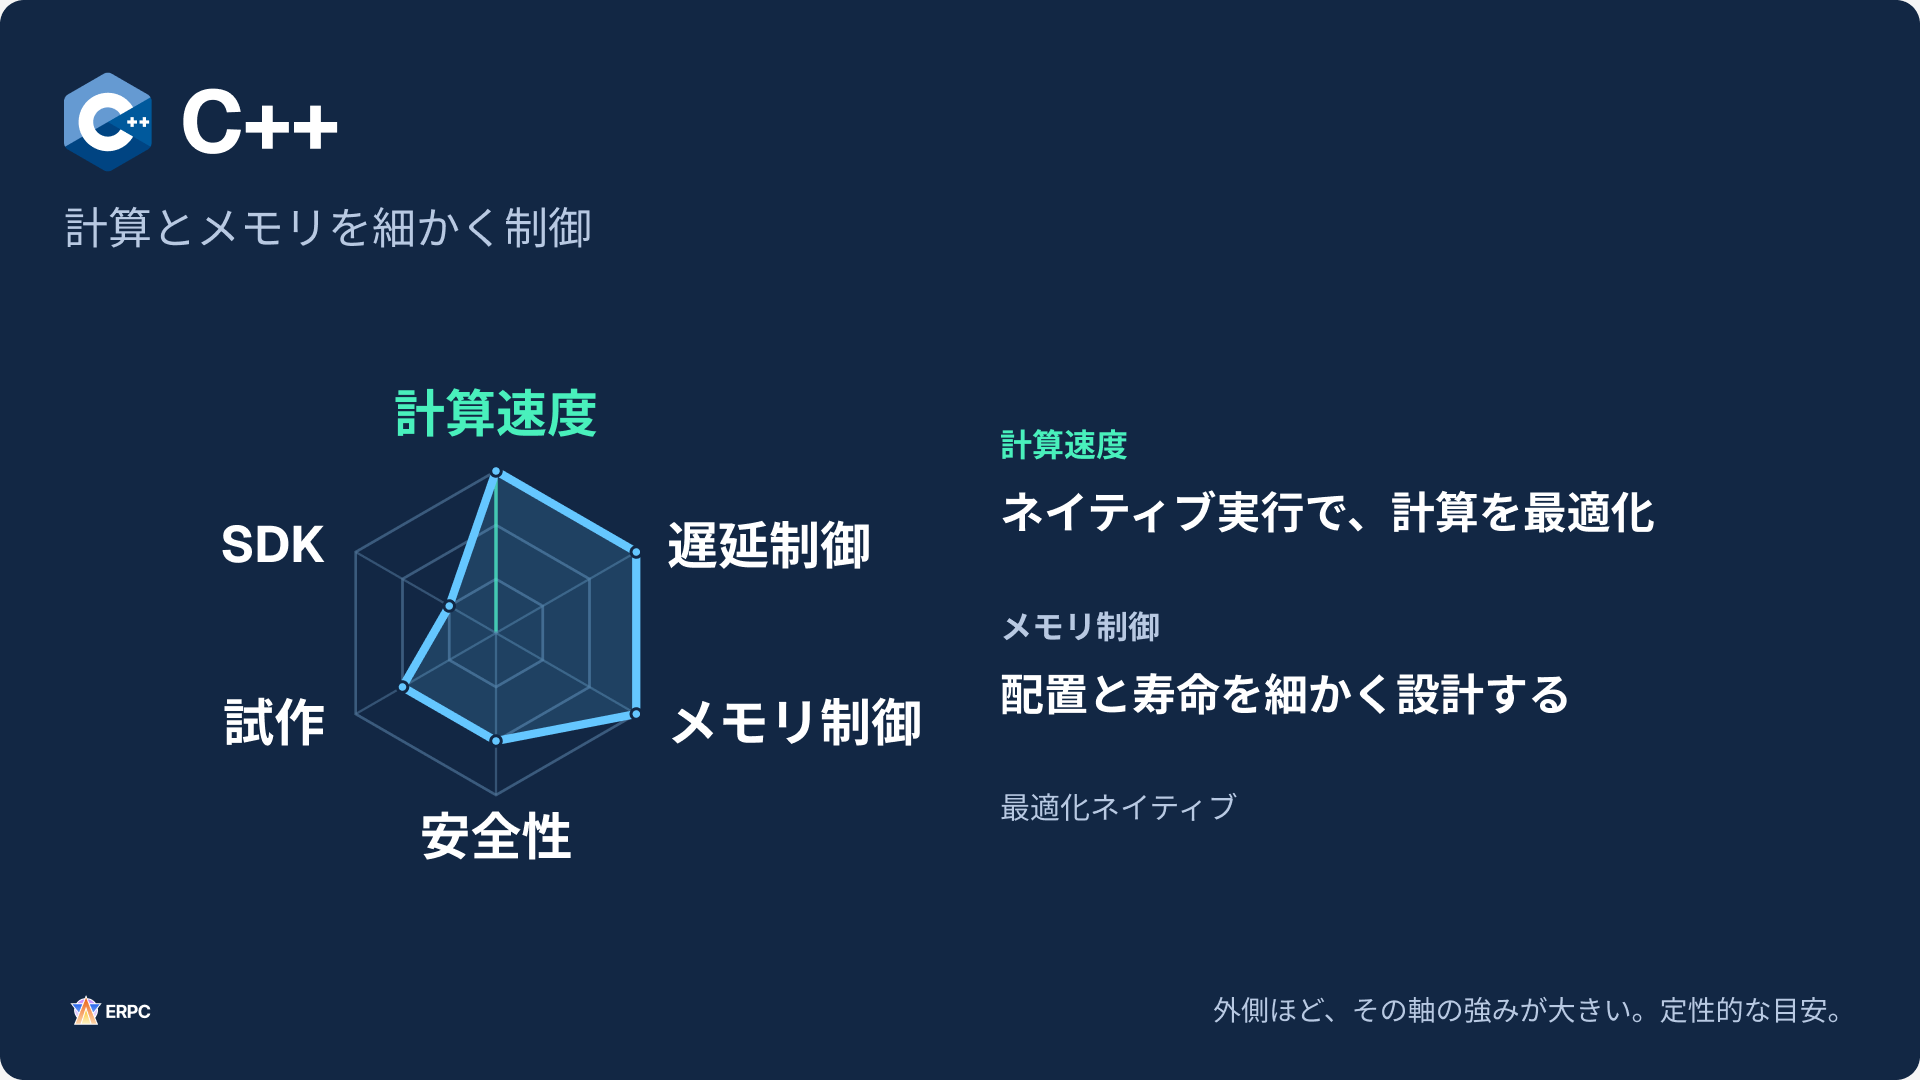
C++は、低レベルの制御に抽象化や既存ライブラリを組み合わせる候補です。RAIIやスマートポインタは、資源の寿命を管理する助けになります。ただし、これらを使うことがすべてのメモリ寿命や共有メモリの安全性を保証するわけではありません。[24] この図の安全性の中段は、Go等の管理メモリと同じ保証という意味でもありません。
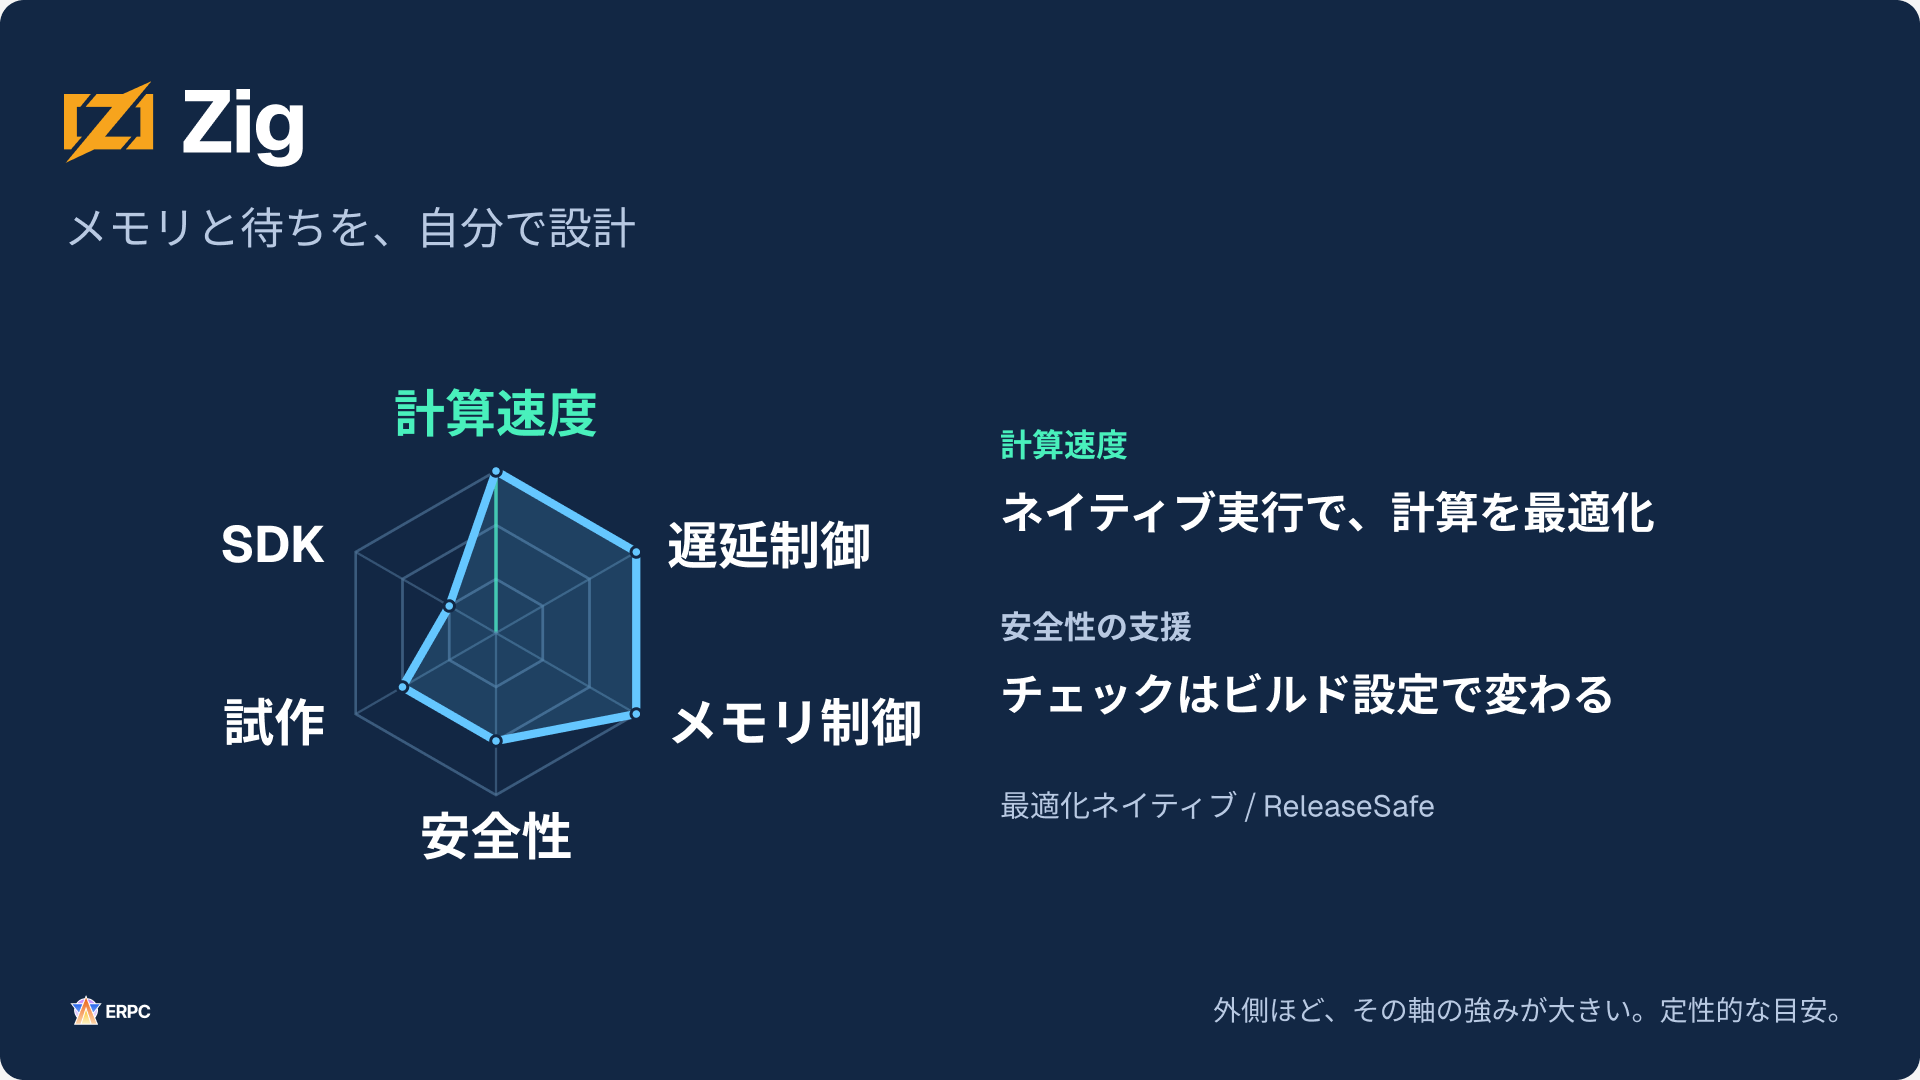
Zigは、メモリ確保や使用する確保器を明示して構成する候補です。このプロフィールはReleaseSafeのチェックを前提とします。ReleaseFastやReleaseSmallでは既定のチェックが異なり、ReleaseSafeでもすべての不正動作を検出するわけではありません。[25] C++と同じ形でも、仕組みが同じという意味ではありません。
Solana SDKの軸は、公式文書のTypeScript・Rust向けの導線、その一覧で紹介されるGo・Python向けの導線を基準にしています。一般的なライブラリの数や品質の順位ではなく、C++・Zigにライブラリがないという意味でもありません。必要なAPI、追従状況、Denoを含む実行環境との互換性は、採用するSDKごとに確認します。[26]
自分の処理が時間を使っている場所を測り、その場所に必要な強みから道具を選びます。まず今の言語で待ちや重複を減らし、さらに制御が必要なら該当部分を別の言語へ移すこともできます。
改善前後を、同じ条件で確かめる
各節のコピー用指示は、それぞれの改善を実装・検証するためのものです。複数の改善を進める場合は、変更と測定結果の対応を残します。変更をまとめて適用すると、どの変更が何に効いたかを分けて判断しにくくなるためです。
変更前後は、同じ入力、購読条件、負荷、出力条件で比べます。受信から判断完了までの時間は、中央値のp50に加えて、p95・p99も確認します。p99は、測定したイベントの99%がその時間以内に終わる境目です。平均的な処理だけでなく、待ちが長くなる側も見るために使います。
各工程のp99を足して、全体のp99にすることはできません。同じイベントの受信から判断完了までを直接測り、キューの待ち、CPU・メモリ、欠損・破棄、判断結果の一致と合わせて確認します。
アプリが動く一台のホスト内で経過時間を測るときは、時刻の修正で逆戻りしない単調時計を使います。SDKがデータを解析し終えてからコールバックを呼ぶなら、コールバックの開始より前にも処理があります。どこからどこまでを測れたかを明記すると、配信の遅延とアプリ内部の遅延を分けて考えられます。
送信後の結果も確認します。sendTransactionの成功応答は、クラスタでの処理や確認を保証しません。[15] データの受信、判断、送信の受理、オンチェーンで確認した結果を対応させることで、次に改善する場所を選べます。
インフラの速さを、判断につなげる
配信が早く届くことと、アプリケーションが必要な判断を間に合って終えることは、どちらも大切です。ERPCは配信環境を改善するとともに、その上で動くソフトウェアを改善するための情報も整えていきます。
まずアプリ側の変更を同じ環境で確かめ、その後、必要に応じて同じコードを別の配置やリソースで比較すると、効果を分けて見やすくなります。ERPCの時間課金を使う場合も、調べたい仮説、比較条件、利用時間を先に決め、料金・在庫はDashboardの現在の表示で確認してください。
参考資料・関連リンク
- [1] Tokio / CPU処理とblocking
- [2] Node.js / Event loopを塞がない設計
- [3] gRPC / Flow Control
- [4] Yellowstone gRPC / メッセージと購読仕様
- [5] LMAX Disruptor / 設計と利用方法
- [6] Solana / Commitment
- [7] Solana / getLatestBlockhash
- [8] Rust / Ownership
- [9] TypeScript / Runtime Behavior and Erased Types
- [10] Deno / TypeScript
- [11] Node.js / Worker threads
- [12] Deno / Web Workers
- [13] Go / Garbage Collector
- [14] Python / Free threading
- [15] Solana / sendTransaction
- [16] Yellowstone gRPC / メッセージ定義
- [17] Rust / std::sync::Mutex
- [18] Tokio / Shared state・Mutex sharding
- [19] Solana / Transaction Structure・Signatures
- [20] Go / FAQ
- [21] V8 / High-Level Overview
- [22] Rust / Data Races and Race Conditions
- [23] NumPy / What is NumPy?
- [24] C++ / Core Guidelines
- [25] Zig / Language Reference
- [26] Solana / Client SDKs
- [27] Programming-Language-Benchmarks / nbody
- [28] Programming-Language-Benchmarks / Measurement code (2025-07-31): execution, defaults, aggregation, Zig build, Deno configuration.
- [29] Programming-Language-Benchmarks / Published measurement data (2025-08-01)
- ロゴと出典: Rust © Rust Foundation (CC BY 4.0, 形状・色の変更なし); Zig © Zig project (CC BY-SA 4.0, 形状・色の変更なし).
- その他のロゴ: Go © The Go Authors; TypeScript © Microsoft; Python © Python Software Foundation; C++ by Jeremy Kratz / Standard C++ Foundation; Node.js / OpenJS Foundation and Node.js contributors; Deno / Deno Land Inc..
- ERPC
- ERPC Web Dashboard