








Mehr Tempo für Ihre Solana-App: gRPC-Datenmenge, Empfangsverarbeitung und Laufzeitressourcen prüfen
Die Solana-Anwendung, die Sie entwickeln, könnte schneller laufen. Die empfangene Datenmenge, die anschließende Verarbeitung und Ressourcen wie CPU und Netzwerk wirken zusammen. Wenn Sie dieses Zusammenspiel überprüfen, können Sie möglicherweise mehr Leistung aus Ihrer vorhandenen Software herausholen.
Sie haben begonnen, HFT auf Solana zu entwickeln, sich mit Geyser gRPC verbunden und sehen Daten in den Logs. Die Entscheidungen fallen jedoch nicht so schnell wie erwartet. Wartezeiten zwischen Empfang und Entscheidung können Hinweise auf Verbesserungsmöglichkeiten geben. Beginnen Sie damit, die Stellen zu finden, die sich in Ihrem aktuellen Code beobachten lassen.
Bei ERPC geben uns Gespräche und Rückmeldungen von Kunden Gelegenheit, die Datenbereitstellung, Empfangseinstellungen und Anwendungsverarbeitung zu überprüfen. Diese Erkenntnisse fließen in die Verbesserung unserer Bereitstellung und Dokumentation ein. Dieser Artikel erläutert Zusammenhänge und Untersuchungsschritte, damit Entwickler, die erstmals schnelle Datenströme mit hohem Volumen verarbeiten, Verbesserungsmöglichkeiten in ihrer eigenen Umgebung erkunden können.
Beginnen Sie mit einer kleinen Prüfung in Ihrem aktuellen Code
Fachbegriffe und Diagnosebefehle können Sie nachschlagen, sobald sie nützlich werden. Wenn Ihnen ein KI-Agent zur Verfügung steht, der den Code Ihres Projekts lesen kann, probieren Sie zunächst die folgende kurze Anfrage aus. Ergänzen Sie, wo die Anwendung läuft und wann sie langsam erscheint. Noch offene Anforderungen und nicht verfügbare Messwerte können zunächst offenbleiben.
text
Ich möchte herausfinden, ob meine Solana-Anwendung schneller reagieren könnte.
Lesen Sie zunächst den aktuellen Code und zeigen Sie, wo Daten empfangen werden und wo die Entscheidung abgeschlossen wird, die diese Daten verwendet. Behalten Sie das Abonnement unverändert bei und schlagen Sie die kleinste Änderung vor, mit der sich Ereigniszahlen und die verstrichene Zeit in diesem Abschnitt messen lassen.
Zeigen Sie für diesen ersten Schritt die Messpunkte, den Änderungsvorschlag, die daraus möglichen Erkenntnisse und die weiterhin ungemessenen Abschnitte. Falls kein Zugriff auf den Host möglich ist, beginnen Sie mit dem, was sich innerhalb der Anwendung beobachten lässt. Zeigen Sie keine vertraulichen Daten an, ändern Sie die Produktionsumgebung nicht und erstellen Sie keine kostenpflichtigen Ressourcen.
Ich möchte herausfinden, ob meine Solana-Anwendung schneller reagieren könnte.
Lesen Sie zunächst den aktuellen Code und zeigen Sie, wo Daten empfangen werden und wo die Entscheidung abgeschlossen wird, die diese Daten verwendet. Behalten Sie das Abonnement unverändert bei und schlagen Sie die kleinste Änderung vor, mit der sich Ereigniszahlen und die verstrichene Zeit in diesem Abschnitt messen lassen.
Zeigen Sie für diesen ersten Schritt die Messpunkte, den Änderungsvorschlag, die daraus möglichen Erkenntnisse und die weiterhin ungemessenen Abschnitte. Falls kein Zugriff auf den Host möglich ist, beginnen Sie mit dem, was sich innerhalb der Anwendung beobachten lässt. Zeigen Sie keine vertraulichen Daten an, ändern Sie die Produktionsumgebung nicht und erstellen Sie keine kostenpflichtigen Ressourcen.Das erste nützliche Ergebnis ist zu wissen, wo und was Sie in Ihrem eigenen Code messen können. Wenn Sie beobachtbare und ungemessene Abschnitte unterscheiden, fällt die Wahl des nächsten Untersuchungsschritts leichter. Weiter unten finden Sie einen ausführlicheren Prompt zur weiteren Diagnose.
Ein Agent könnte zum Beispiel antworten: „Der Empfang erfolgt in
stream.ts bei onData; die Entscheidung wird in strategy.ts bei onDecisionComplete abgeschlossen. Ich schlage eine Änderung vor, die die Zählwerte für empfangene Ereignisse und abgeschlossene Entscheidungen sowie die in diesem Abschnitt verstrichene Zeit zusammenfasst. Dieser Messvorschlag umfasst nicht den Abschnitt vor dem Callback.“ Dieses Beispiel verwendet fiktive Datei- und Funktionsnamen in TypeScript. Prüfen Sie unabhängig von der Programmiersprache, ob diese drei Aspekte zusammenpassen: die tatsächlichen Codepositionen, die hinzuzufügenden Aufzeichnungen und die Grenzen dieser Messung. Wenn Empfang und Entscheidungen nicht eins zu eins zusammenhängen, lassen Sie den Agenten auch ihre Zuordnung und die Zähleinheit vorschlagen.Ergänzen Sie Ihre Webentwicklungserfahrung um den Blick auf Datenströme
Managed Services ermöglichen es, viele Webfunktionen zu entwickeln, ohne sich mit einzelnen Serverkomponenten befassen zu müssen. Diese Erfahrung bleibt eine Grundlage für die Arbeit mit Solana-Datenströmen. Ergänzen Sie den Blick darauf, wie viele Daten kontinuierlich eintreffen und wie schnell die Anwendung sie verarbeitet.
Ein SDK mit Solana zu verbinden, kann ebenso unkompliziert wirken. Wer jedoch eine große Bandbreite an Transaktionen oder Account-Aktualisierungen abonniert, verändert die Arbeitslast. Der Bedarf an Bandbreite, CPU und Arbeitsspeicher hängt vom Abonnement, den Nachrichtengrößen, der Komprimierung, der Verarbeitung in der Anwendung und dem aktuellen Datenverkehr ab. Für „Solana“ gibt es keinen einzigen festen Wert in Megabyte pro Sekunde.
Der Ausgangspunkt ist, das Verhältnis zwischen eingehender Arbeit und Verarbeitungskapazität bewusst zu gestalten und zu messen.
Auch ein laufender Datenstrom kann eine Warteschlange aufbauen
Vergleichen Sie zunächst die Daten, die innerhalb derselben Sekunde eintreffen, anhand gleich großer Kacheln. Eine Kachel steht für 1.000 Nachrichten; bei angenommenen 1 kB pro Nachricht ergibt das 1 MB. Im kleineren Beispiel kommen 2 MB pro Sekunde an, im größeren 12 MB pro Sekunde. Die empfangende App hat in beiden Fällen dieselbe Verarbeitungskapazität. Dies ist ein Modell zur Veranschaulichung der Nutzdatenmenge der Nachrichten in Dezimaleinheiten, ohne Berücksichtigung von Komprimierung und Protokoll-Headern.
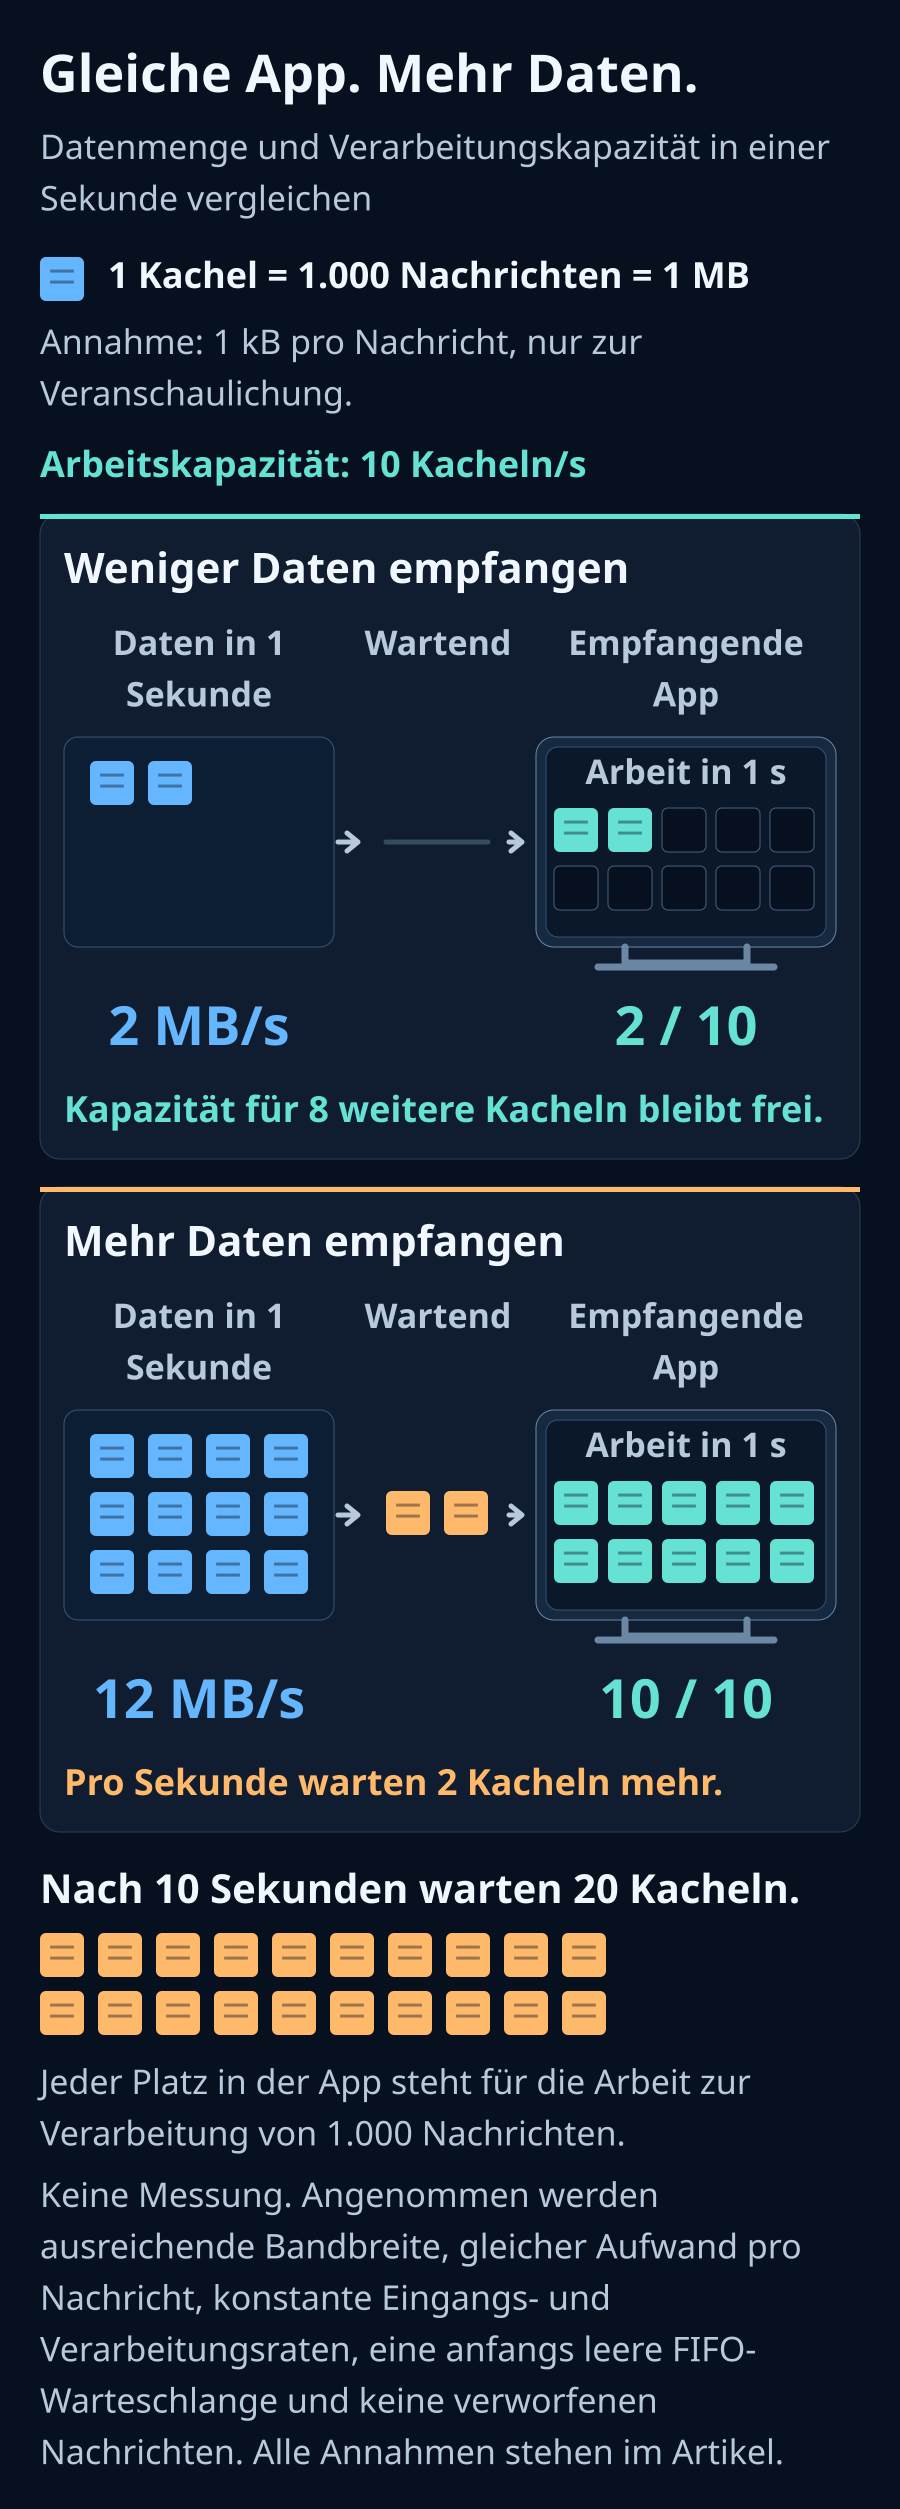
Betrachten wir ein vereinfachtes Modell: Pro Sekunde treffen 12.000 Ereignisse ein, und ein Computer kann 10.000 pro Sekunde verarbeiten. Jedes Ereignis verursacht denselben Arbeitsaufwand, die Warteschlange ist anfangs leer, die Verarbeitung folgt der Ankunftsreihenfolge, und es werden keine Ereignisse verworfen.
Jede Sekunde bleiben weitere 2.000 Ereignisse unverarbeitet. Nach zehn Sekunden warten 20.000 Ereignisse. Ein Ereignis, das sich in diesem Moment in die Warteschlange einreiht, wartet ungefähr zwei Sekunden, bevor seine Verarbeitung beginnt. Die Logs laufen weiter, während die Warteschlange wächst.
Diese Zahlen sind Annahmen zur Veranschaulichung, keine Messwerte von Solana oder ERPC. Das Modell setzt einen konstanten Zufluss und eine konstante Kapazität voraus. In der Praxis kommen Daten in Schüben an, und die Verarbeitungskosten variieren. Deshalb können auch bei ausreichender durchschnittlicher Kapazität Wartezeiten entstehen.
Die gRPC-Flusskontrolle passt die Übertragung daran an, wie viel der Empfänger aufnehmen kann. Wenn die Verarbeitung zurückfällt, können Wartezeiten über die Anwendungswarteschlange hinaus in Kommunikationsbibliotheken oder beim Sender entstehen. Eine bestehende Verbindung oder ein erfolgreicher Schreibvorgang an eine Sende-API sagt noch nichts darüber aus, wie aktuell die Daten bei ihrer Ankunft sind.[1]
Wählen Sie die benötigten Daten aus, bevor sie das Netzwerk durchlaufen
Wenn Ihre Entscheidungen nur bestimmte Programme oder Accounts betreffen, legen Sie zunächst fest, welche Daten benötigt werden, und verwenden Sie serverseitige Abonnementfilter. Yellowstone gRPC unterstützt Filter für Transaktionen und Accounts. Prüfen Sie die genauen Kombinationen und verfügbaren Möglichkeiten anhand der verwendeten API, des SDK und des Dienstes.[2]
Wenn Sie noch nicht wissen, was Sie filtern sollen, ermitteln Sie im Code, welche Werte Ihre Anwendung für Entscheidungen verwendet und welche Benachrichtigungsfelder diese Werte liefern. Leiten Sie daraus mögliche Filterbedingungen für das Abonnement ab und prüfen Sie anschließend, ob bekannte benötigte Ereignisse enthalten sind. Wenn Sie sowohl die Verringerung der Ereigniszahl als auch den Erhalt der benötigten Daten prüfen, haben Sie eine verlässliche Grundlage für den nächsten Vergleich.
Wenn Sie alles empfangen und unerwünschte Daten erst im Client verwerfen, ist der Aufwand für Übertragung, Entschlüsselung und Dekodierung bis zu diesem Punkt bereits entstanden. Filter am Sender können diesen Aufwand verringern. Wenn im obigen Beispiel nur die benötigten 2.000 Ereignisse pro Sekunde eintreffen, hat dieselbe Verarbeitungskapazität von 10.000 Ereignissen pro Sekunde ausreichend Spielraum.
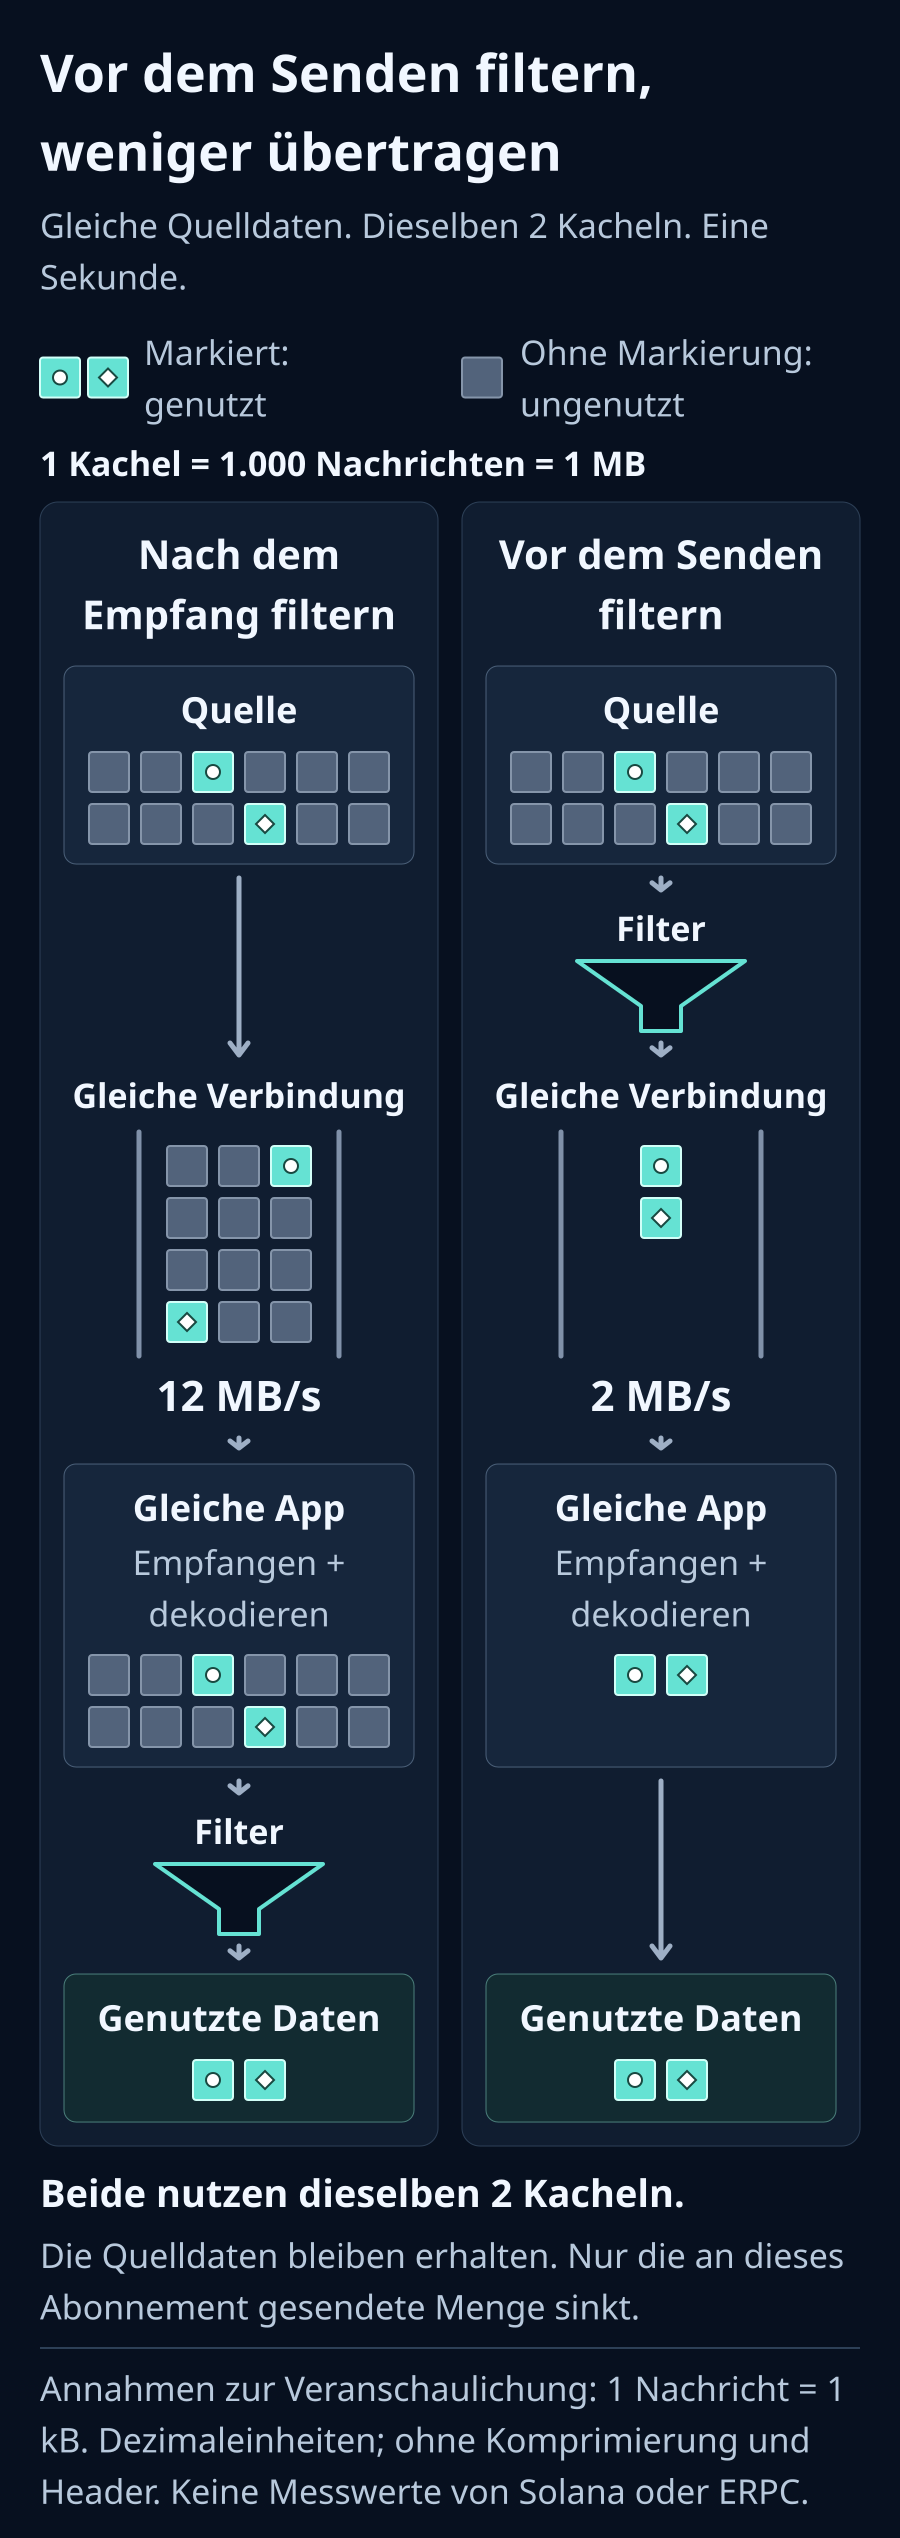
Denken Sie an Straßenverkehr: Die Straßenlänge steht für die Übertragungsstrecke, die Fahrspuren für die Bandbreite, die Mautstelle für die Verarbeitungskapazität beim Empfang und die Autoschlange für wartende Arbeit. Wenn nur die benötigten Autos dieselbe Mautstelle passieren sollen, entsteht eine andere Warteschlange, als wenn alle Autos aus der Umgebung dorthin geleitet werden. Die Strecke zu verkürzen und die Zahl der Autos zu verringern, sind zwei unterschiedliche Verbesserungen.
Kommunikation hat auch physikalische Grenzen. Die Übertragung von 100 MB über eine Verbindung mit 1 Gbps benötigt theoretisch mindestens 0,8 Sekunden; bei 10 Gbps sind es 0,08 Sekunden. Diese Untergrenzen verwenden dezimale Einheiten und berücksichtigen weder Entfernung noch Protokoll-Overhead, erneute Übertragungen oder wartende Arbeit. Sie bedeuten nicht, dass jedes einzelne Ereignis eines Datenstroms um 0,8 Sekunden verzögert wird.
Auch wenn eine einzelne Berechnung schneller ist als ein Netzwerkaustausch, verursacht das Senden unnötiger Daten weiterhin Kosten. Betrachten Sie die Laufzeit des Signals, die übertragbare Menge pro Zeiteinheit und die Arbeit, die nach der Ankunft erledigt werden kann, getrennt.
Manche Anwendungen benötigen sämtliche Daten, etwa vollständige Indizes, Prüfungen und Forschung. Dafür müssen Empfang, Verarbeitung und Speicherung auf diese Arbeitslast ausgelegt sein. Alle einzelnen Benachrichtigungen zu empfangen, ist außerdem etwas anderes, als auf einen vollständigen Block zu warten: Daten, die zu einem Block zusammengeführt und rekonstruiert wurden. Prüfen Sie, ob Ihre Entscheidung unnötigerweise von nicht benötigten Daten oder dem Abschluss einer Zusammenführung abhängt.[2]
Prüfen Sie die Empfangsverarbeitung und die Laufzeitressourcen
Rust kann helfen, Verarbeitungskosten zu senken. Damit diese Geschwindigkeit wirksam wird, betrachten Sie auch das Eingangsvolumen, die tatsächlich nutzbare Verbindungskapazität, Wartezeiten bei Datenbankschreibvorgängen, Sperren und serielle Abschnitte. In einer asynchronen Laufzeitumgebung kann es die Anwendung ebenfalls verbessern, CPU-intensive Arbeit und Arbeit, die einen Thread blockiert, geeigneten Teilen des Systems zuzuweisen.[3]
Halten Sie die Empfangsschleife kurz und lagern Sie aufwendige Arbeit aus. Definieren Sie eine Obergrenze für die Warteschlange und das Verhalten bei voller Auslastung. Eine unbegrenzte Warteschlange kann zunehmende Verzögerungen als wachsenden Speicherverbrauch verbergen. Eine begrenzte Warteschlange behebt einen dauerhaften Mangel an Verarbeitungskapazität ebenfalls nicht. Bewahren Sie die erforderliche Reihenfolge und Vollständigkeit, während Sie zwischen kleineren Abonnements, effizienterer Verarbeitung, Aufteilung, Parallelisierung und zusätzlichen Ressourcen wählen.
Messen Sie zunächst den Abschnitt vom Empfang bis zum Abschluss der Entscheidung und untersuchen Sie dann genauer, wo Wartezeiten auftreten. Die folgende Tabelle zeigt einen ersten Blick auf die einzelnen Bereiche. Ausführliche Metriknamen und Befehle stehen auch im Diagnose-Prompt weiter unten, sodass Sie die jeweils relevanten Punkte heranziehen können.
| Ressource | Was Sie zuerst prüfen können |
|---|---|
| CPU | Konzentriert sich die Arbeit auf einen Kern? Prüfen Sie die Gesamtauslastung und die Auslastung je Kern sowie CPU-Begrenzungen der Ausführungsumgebung |
| Arbeitsspeicher | Wachsen die Zahl wartender Ereignisse oder die Speichernutzung weiter an? Betrachten Sie die Menge der wartenden Daten zusammen mit der Wartezeit des ältesten Ereignisses |
| Datenträger und Datenbank | Wartet der Empfang auf den Abschluss der Speicherung? Prüfen Sie Datenbankschreibvorgänge und Wartezeiten beim Speichern. Wenn die Anwendung keine Daten dauerhaft speichert, können andere Bereiche den Einstieg bieten |
| Netzwerk | Passen die Verbindung und ihre Einstellungen zum Eingangsvolumen? Prüfen Sie tatsächliche Übertragungsraten, die Umlaufzeit und erneute Übertragungen |
Wenn Sie die Kommunikation genauer untersuchen, können Bibliothekseinstellungen weitere Hinweise liefern. HTTP/2 hat sowohl auf Stream- als auch auf Verbindungsebene Flow-Control-Fenster, die steuern, wie viele zusätzliche Daten die Gegenstelle senden darf. Ist dieser Spielraum klein im Verhältnis zum Bandbreiten-Verzögerungs-Produkt, also Bandbreite multipliziert mit Umlaufzeit, kann der Durchsatz eine Grenze erreichen, obwohl die Verbindung noch Reserven hat. Prüfen Sie in einem solchen Fall die Bibliothek und zwischengeschaltete Komponenten und beachten Sie beim Anpassen den Geltungsbereich der Einstellung sowie ihren Speicherbedarf.[4]
Messen Sie neben dem Empfang auch Aktualität und Wartezeit
Um zunächst Rückstaus innerhalb der Anwendung zu prüfen, behalten Sie das aktuelle Abonnement bei und erfassen Sie im selben Beobachtungszeitraum empfangene Ereignisse, abgeschlossene Ereignisse, die Anzahl in der Warteschlange und die Wartezeit des ältesten Ereignisses. Wenn Sie nicht wissen, wo Sie messen sollen, lassen Sie einen Agenten mit dem unten stehenden Prompt den Code untersuchen. Gibt es keine explizite Warteschlange, beginnen Sie mit der Zeit vom Empfang bis zum Abschluss der Entscheidung und vergleichen Sie diese mit einer Diagnoseversion ohne aufwendige Verarbeitung.
Der folgende sprach- und SDK-unabhängige Pseudocode zeigt, wo die Messungen hingehören. Behalten Sie die aktuelle Verarbeitungsreihenfolge und Parallelität bei, wenn Sie die Messung in den tatsächlichen Code einbauen.
text
Wenn Daten empfangen werden:
  Den Zähler empfangener Ereignisse um 1 erhöhen
  Einen monotonen Empfangszeitstempel diesem Ereignis zugeordnet speichern
  Das Ereignis an die bestehende Verarbeitung übergeben

Wenn die Entscheidung mit demselben Ereignis abgeschlossen ist:
  Den Zähler abgeschlossener Ereignisse um 1 erhöhen
  Die seit dem Empfang verstrichene Zeit berechnen und aggregieren
Wenn Daten empfangen werden:
Den Zähler empfangener Ereignisse um 1 erhöhen
Einen monotonen Empfangszeitstempel diesem Ereignis zugeordnet speichern
Das Ereignis an die bestehende Verarbeitung übergeben
Wenn die Entscheidung mit demselben Ereignis abgeschlossen ist:
Den Zähler abgeschlossener Ereignisse um 1 erhöhen
Die seit dem Empfang verstrichene Zeit berechnen und aggregierenWenn Empfang und Entscheidungen nicht eins zu eins zusammenhängen, legen Sie zuerst diese Zuordnung und die Zähleinheit fest. Wenn Sie Beobachtungen über feste Zeitabschnitte zusammenfassen, können Sie Ergebnisse vergleichen, ohne für jedes Ereignis einen zusätzlichen Logeintrag zu erzeugen.
Erfassen Sie für die weitere Diagnose zusätzlich empfangene Bytes, den Byteumfang der Warteschlange, p50/p95/p99 der Verarbeitungszeit sowie Fehler und erneute Verbindungen. p99 ist der Schwellenwert, den 99% der gemessenen Verarbeitungszeiten nicht überschreiten. Geben Sie für jede Messung an, wo sie erfolgt. Datenverkehr an der Netzwerkkarte, Protobuf-Größe und die Größe dekodierter Objekte sind unterschiedliche Größen.
Verwenden Sie eine monotone Uhr für Zeitspannen innerhalb eines Hosts und messen Sie Empfang, Einreihung, Entnahme und Abschluss getrennt. Wenn die Dekodierung beim Aufruf des SDK-Callbacks bereits abgeschlossen ist, bleibt der Zeitraum davor ungemessen. Prüfen Sie bei Vergleichen mit einem Senderzeitstempel die Uhrensynchronisation und den Punkt, an dem der Zeitstempel erzeugt wird. Bezeichnen Sie die Differenz nicht automatisch als reine Netzwerklatenz.
Verringert sich die Wartezeit, wenn Sie die Anwendungslogik entfernen, ohne das Abonnement zu ändern, ist das ein Hinweis darauf, die Auswirkungen dieser Verarbeitung zu untersuchen. Eine schnelle Verarbeitung nach dem Callback allein beweist nicht, dass die Daten aktuell eingetroffen sind.
Sie können Ereigniskennungen auch mit einem Referenzstream vergleichen, der dieselben Abonnementeinstellungen und dasselbe Commitment verwendet, also dieselbe Bestätigungsstufe der verwendeten Daten. Vergewissern Sie sich dabei, dass sich im Referenzstream selbst kein Rückstau aufbaut. Eine Lücke zwischen Slotnummern allein beweist weder fehlende Daten noch entspricht sie einer festen Anzahl von Sekunden: Manche Slots enthalten kein passendes Ereignis, und Slots können übersprungen werden.[5]
mtr hilft dabei, Latenzen und Antwortmuster entlang einer Route zu untersuchen. Paketverlust an nur einem Zwischenknoten kann darauf zurückzuführen sein, dass ein Router seine Antworten begrenzt. Gleichen Sie das Verhalten bis zum Ziel mit TCP-Neuübertragungen, effektiven Übertragungsraten und einer anderen Route ab. mtr allein kann weder eine erschöpfte Bandbreite noch einen Fehler im Rechenzentrum nachweisen.[6]
Ein Diagnose-Prompt für Ihren KI-Agenten
Geben Sie den folgenden Text an einen Agenten weiter, der den Code Ihres Projekts lesen kann. Beschreiben Sie zunächst, wo es läuft und wann und wie es Ihnen langsam vorkommt. Der Agent kann zuerst Verbindung, Abonnement und Verarbeitung nach dem Empfang anhand des Codes untersuchen. API-Schlüssel oder Zugangsdaten müssen Sie nicht in die Unterhaltung kopieren.
Wenn die benötigten Ereignisse oder die akzeptable Verzögerung noch nicht feststehen, geben Sie sie als unentschieden an. Beschreiben Sie in eigenen Worten, welche Informationen Sie beobachten und welche Entscheidungen Sie treffen möchten. Behandeln Sie nicht verfügbare Messwerte als ungemessen und beginnen Sie mit dem, was sich jetzt untersuchen lässt.
text
Untersuchen Sie, ob mein Solana-Geyser-gRPC-Client schneller reagieren könnte. Falls Verzögerungen, Rückstau oder Verbindungsabbrüche auftreten, grenzen Sie deren Ursachen ein und helfen Sie bei der Verbesserung. Schließen Sie nicht allein aus einer erfolgreichen Verbindung oder aus Ereignissen in den Logs, dass aktuelle Daten verarbeitet werden. Legen Sie sich nicht im Voraus darauf fest, ob die Ursache beim Client oder beim Anbieter liegt.

1. Kläre das Ziel: benötigte Ereignisse, akzeptable Aktualität, Anforderungen an Reihenfolge und Datenverlust, Abonnementfilter, Commitment, Region des Endpunkts, tatsächliche Versionen von Sprache, SDK und gRPC-Bibliothek sowie Laufzeitumgebung. Prüfe zuerst verfügbaren Code, Konfigurationen und Lockfiles; frage nur nach fehlenden Informationen. Lasse noch nicht entschiedene Anforderungen ausdrücklich offen und untersuche zunächst den aktuellen Zustand. Zeige keine Geheimnisse an und schwärze sensible Angaben in geteilten Logs.

2. Messe vom Empfang bis zum Abschluss. Priorisiere Empfang, Abschluss und Wartezeiten und beginne mit dem, was messbar ist. Erfasse Ereignisse/Sekunde, Bytes/Sekunde, abgeschlossene Ereignisse/Sekunde, Anzahl und Bytes der Warteschlange sowie Wartezeit des ältesten Ereignisses, p50/p95/p99, Fehler, Verbindungsabbrüche, erneute Verbindungen und verworfene Daten. Wenn keine explizite Warteschlange vorhanden ist, halte das fest und benenne die beobachtbaren Verarbeitungsabschnitte. Nenne Beobachtungspunkte und ungemessene Zeitabschnitte. Unterscheide Datenverkehr an der Netzwerkkarte, tatsächlich übertragene Bytes, Protobuf-Größe und dekodierte Objekte. Verwende für lokale Zeitspannen eine monotone Uhr; prüfe bei externen Zeitangaben Synchronisation und Ursprung des Zeitstempels. Setze eine Lücke zwischen Slotnummern nicht unmittelbar mit Datenverlust oder einer festen Dauer gleich.

3. Unterscheide Begrenzungen durch CPU, Arbeitsspeicher, Datenträger und Netzwerk. Prüfe CPU-Werte pro Kern und Thread, Steal-Zeit und CPU-Limits, RSS/GC/Swap/PSI, I/O-Wartezeiten, Bytes, verworfene Pakete und Fehler an der Netzwerkkarte, TCP-Neuübertragungen und RTT. Mögliche Linux-Werkzeuge sind mpstat, pidstat, vmstat, iostat, sar, ss -ti und /proc/pressure/. Wenn Werkzeuge oder Berechtigungen fehlen, sage das und nenne die minimal erforderlichen Befehle. Wenn kein Hostzugriff möglich ist, suche nach Informationen in der Verwaltungskonsole oder in der Instrumentierung der Anwendung und kennzeichne nicht verfügbare Größen als ungemessen. Erfinde niemals Ergebnisse.

4. Prüfe HTTP/2-Fenster auf Stream- und Verbindungsebene, TCP-Empfangspuffer, Proxys, VPNs und Sidecars. Nutze die offizielle Dokumentation der installierten SDK-Version und berücksichtige das Bandbreiten-Laufzeit-Produkt. Untersuche JSON-Konvertierung, Logging jedes einzelnen Ereignisses, synchrone Datenbankaufrufe oder Aufrufe externer APIs, blockierende Arbeit, Sperren, unbegrenzte Task-Erzeugung und unbegrenzte Warteschlangen in und um die Empfangsschleife. Betrachte Rust oder asynchronen Code allein nicht als Lösung.

5. Falls mtr oder ein gleichwertiges Werkzeug verfügbar ist, führe eine zeitlich begrenzte Messung zum tatsächlichen Endpunkthost durch. Auf unterstützten Systemen kommt folgender Befehl infrage: mtr --tcp --port <PORT> --report --report-cycles 30 <HOST>. Verwende den tatsächlichen Port, statt einen üblichen TLS-Port anzunehmen. Bewerte Paketverlust an einem Zwischenknoten allein nicht als Fehler; vergleiche das Verhalten am Ziel, erneute Übertragungen und andere Routen. Nutze mtr nicht als Ersatz für eine Bandbreitenmessung.

6. Erfasse einen Ausgangswert mit dem aktuellen Abonnement und ändere jeweils nur eine Variable. Behalte dasselbe Abonnement bei, wenn du einen minimalen Empfangspfad mit der Pipeline einschließlich Anwendungslogik vergleichst. Behandle Filteränderungen als separaten Vergleich. Ordne vor dem Eingrenzen des Abonnements die Eingabedaten der Entscheidungen den zugehörigen Benachrichtigungen zu und prüfe, ob die vorgeschlagenen Filter bekannte benötigte Ereignisse einschließen. Entwirf begrenzte Warteschlangen und Parallelisierung unter Wahrung der erforderlichen Reihenfolge und Vollständigkeit und lege das Verhalten bei Überlauf fest. Verwirf benötigte Daten nicht stillschweigend. Speichere vollständige Fehlerdetails und vorgegebene Zeitpunkte für erneute Versuche; verbinde dich während einer vorgegebenen Pause nicht erneut.

7. Berichte getrennt über beobachtete Fakten, mögliche Ursachen, ungeprüfte Hypothesen, überprüfbare Änderungen und Messwerte vor und nach den Änderungen. Schätze CPU, RAM, Bandbreite, Speicherleistung und Standort aus dem Abonnement und den Messungen ab und berücksichtige Reserven für Spitzenlasten. Erfinde keine feste, allgemeingültige Hardwareanforderung für Solana. Schlage bei Bedarf einen Vergleich von Maschinen oder Rechenzentren mit demselben Abonnement, SDK und Commitment vor.

Wenn ich ERPC nutze, lies die aktuelle gRPC-FAQ und befolge die Anweisungen für den konkreten Fehlercode:
https://erpc.global/en/faq/grpc/general/
Wenn ERPC User MCP oder eine CLI angebunden ist, überprüfe die tatsächlich verfügbaren Operationen und Berechtigungen. Zugriff auf Kontodaten bedeutet nicht, dass auch Hostdiagnosen möglich sind. Bevor du einen kostenpflichtigen VPS erstellst, einen Vertrag änderst, die Produktionsumgebung aktualisierst oder sie neu startest, lege Kosten, Zweck und Testdauer vor und hole meine Zustimmung ein. Schließe zuerst die Diagnose und überprüfbare Verbesserungen ab.
Untersuchen Sie, ob mein Solana-Geyser-gRPC-Client schneller reagieren könnte. Falls Verzögerungen, Rückstau oder Verbindungsabbrüche auftreten, grenzen Sie deren Ursachen ein und helfen Sie bei der Verbesserung. Schließen Sie nicht allein aus einer erfolgreichen Verbindung oder aus Ereignissen in den Logs, dass aktuelle Daten verarbeitet werden. Legen Sie sich nicht im Voraus darauf fest, ob die Ursache beim Client oder beim Anbieter liegt.
1. Kläre das Ziel: benötigte Ereignisse, akzeptable Aktualität, Anforderungen an Reihenfolge und Datenverlust, Abonnementfilter, Commitment, Region des Endpunkts, tatsächliche Versionen von Sprache, SDK und gRPC-Bibliothek sowie Laufzeitumgebung. Prüfe zuerst verfügbaren Code, Konfigurationen und Lockfiles; frage nur nach fehlenden Informationen. Lasse noch nicht entschiedene Anforderungen ausdrücklich offen und untersuche zunächst den aktuellen Zustand. Zeige keine Geheimnisse an und schwärze sensible Angaben in geteilten Logs.
2. Messe vom Empfang bis zum Abschluss. Priorisiere Empfang, Abschluss und Wartezeiten und beginne mit dem, was messbar ist. Erfasse Ereignisse/Sekunde, Bytes/Sekunde, abgeschlossene Ereignisse/Sekunde, Anzahl und Bytes der Warteschlange sowie Wartezeit des ältesten Ereignisses, p50/p95/p99, Fehler, Verbindungsabbrüche, erneute Verbindungen und verworfene Daten. Wenn keine explizite Warteschlange vorhanden ist, halte das fest und benenne die beobachtbaren Verarbeitungsabschnitte. Nenne Beobachtungspunkte und ungemessene Zeitabschnitte. Unterscheide Datenverkehr an der Netzwerkkarte, tatsächlich übertragene Bytes, Protobuf-Größe und dekodierte Objekte. Verwende für lokale Zeitspannen eine monotone Uhr; prüfe bei externen Zeitangaben Synchronisation und Ursprung des Zeitstempels. Setze eine Lücke zwischen Slotnummern nicht unmittelbar mit Datenverlust oder einer festen Dauer gleich.
3. Unterscheide Begrenzungen durch CPU, Arbeitsspeicher, Datenträger und Netzwerk. Prüfe CPU-Werte pro Kern und Thread, Steal-Zeit und CPU-Limits, RSS/GC/Swap/PSI, I/O-Wartezeiten, Bytes, verworfene Pakete und Fehler an der Netzwerkkarte, TCP-Neuübertragungen und RTT. Mögliche Linux-Werkzeuge sind mpstat, pidstat, vmstat, iostat, sar, ss -ti und /proc/pressure/. Wenn Werkzeuge oder Berechtigungen fehlen, sage das und nenne die minimal erforderlichen Befehle. Wenn kein Hostzugriff möglich ist, suche nach Informationen in der Verwaltungskonsole oder in der Instrumentierung der Anwendung und kennzeichne nicht verfügbare Größen als ungemessen. Erfinde niemals Ergebnisse.
4. Prüfe HTTP/2-Fenster auf Stream- und Verbindungsebene, TCP-Empfangspuffer, Proxys, VPNs und Sidecars. Nutze die offizielle Dokumentation der installierten SDK-Version und berücksichtige das Bandbreiten-Laufzeit-Produkt. Untersuche JSON-Konvertierung, Logging jedes einzelnen Ereignisses, synchrone Datenbankaufrufe oder Aufrufe externer APIs, blockierende Arbeit, Sperren, unbegrenzte Task-Erzeugung und unbegrenzte Warteschlangen in und um die Empfangsschleife. Betrachte Rust oder asynchronen Code allein nicht als Lösung.
5. Falls mtr oder ein gleichwertiges Werkzeug verfügbar ist, führe eine zeitlich begrenzte Messung zum tatsächlichen Endpunkthost durch. Auf unterstützten Systemen kommt folgender Befehl infrage: mtr --tcp --port <PORT> --report --report-cycles 30 <HOST>. Verwende den tatsächlichen Port, statt einen üblichen TLS-Port anzunehmen. Bewerte Paketverlust an einem Zwischenknoten allein nicht als Fehler; vergleiche das Verhalten am Ziel, erneute Übertragungen und andere Routen. Nutze mtr nicht als Ersatz für eine Bandbreitenmessung.
6. Erfasse einen Ausgangswert mit dem aktuellen Abonnement und ändere jeweils nur eine Variable. Behalte dasselbe Abonnement bei, wenn du einen minimalen Empfangspfad mit der Pipeline einschließlich Anwendungslogik vergleichst. Behandle Filteränderungen als separaten Vergleich. Ordne vor dem Eingrenzen des Abonnements die Eingabedaten der Entscheidungen den zugehörigen Benachrichtigungen zu und prüfe, ob die vorgeschlagenen Filter bekannte benötigte Ereignisse einschließen. Entwirf begrenzte Warteschlangen und Parallelisierung unter Wahrung der erforderlichen Reihenfolge und Vollständigkeit und lege das Verhalten bei Überlauf fest. Verwirf benötigte Daten nicht stillschweigend. Speichere vollständige Fehlerdetails und vorgegebene Zeitpunkte für erneute Versuche; verbinde dich während einer vorgegebenen Pause nicht erneut.
7. Berichte getrennt über beobachtete Fakten, mögliche Ursachen, ungeprüfte Hypothesen, überprüfbare Änderungen und Messwerte vor und nach den Änderungen. Schätze CPU, RAM, Bandbreite, Speicherleistung und Standort aus dem Abonnement und den Messungen ab und berücksichtige Reserven für Spitzenlasten. Erfinde keine feste, allgemeingültige Hardwareanforderung für Solana. Schlage bei Bedarf einen Vergleich von Maschinen oder Rechenzentren mit demselben Abonnement, SDK und Commitment vor.
Wenn ich ERPC nutze, lies die aktuelle gRPC-FAQ und befolge die Anweisungen für den konkreten Fehlercode:
https://erpc.global/en/faq/grpc/general/
Wenn ERPC User MCP oder eine CLI angebunden ist, überprüfe die tatsächlich verfügbaren Operationen und Berechtigungen. Zugriff auf Kontodaten bedeutet nicht, dass auch Hostdiagnosen möglich sind. Bevor du einen kostenpflichtigen VPS erstellst, einen Vertrag änderst, die Produktionsumgebung aktualisierst oder sie neu startest, lege Kosten, Zweck und Testdauer vor und hole meine Zustimmung ein. Schließe zuerst die Diagnose und überprüfbare Verbesserungen ab.Testen Sie denselben Code in einer vergleichbaren Umgebung
Messungen können Verbesserungsmöglichkeiten bei CPU- oder Arbeitsspeicherressourcen oder beim Netzwerkpfad aufzeigen. Eine leistungsfähigere CPU, mehr Speicher, aufgeteilte Arbeit oder ein Standort näher an der Quelle sind mögliche Optionen. Wenn Sie diese Entscheidungen mit der Datenmenge Ihrer Anwendung und Ihren Beobachtungen verbinden, werden sowohl der Grund für einen Versuch als auch die zu prüfende Wirkung klarer.
ERPC VPS ist eine Möglichkeit, Stream-Clients in der Nähe von Solana-Infrastruktur zu betreiben. Mit stündlicher Abrechnung können Sie denselben Code und dasselbe Abonnement mit Ihrer aktuellen Umgebung vergleichen. Prüfen Sie aktuelle Preise, Regionen und Verfügbarkeit im Dashboard. Auch bei ERPC hängt der Ressourcenbedarf vom Abonnement und der Verarbeitung in Ihrer Anwendung ab.[7]
Vergleichen Sie neben dem Empfangsdurchsatz auch das Wachstum der Warteschlange, die Aktualität beim Abschluss der Verarbeitung, p99 und Fehler. Halten Sie Messzeitraum und Auslastung der Blockchain fest. Gleichzeitige Vergleiche oder wiederholte Messungen helfen, zeitliche Veränderungen des Datenverkehrs nicht mit Unterschieden zwischen Umgebungen zu verwechseln.
Für Supportanfragen teilen Sie Abonnementeinstellungen mit geschwärzten sensiblen Angaben, SDK-Version, Region, Zeitstempel, vollständige Fehlermeldungen und bereits vorhandene Messwerte. Werte, die Sie noch nicht erfasst haben, dürfen Sie als ungemessen kennzeichnen.
Jede zusätzliche Beobachtung erleichtert die Wahl der nächsten Änderung. Erhalten Sie die benötigten Daten und prüfen Sie Verbesserungen Schritt für Schritt. Wir werden die Informationen und die Infrastruktur, die Ihre Entwicklung unterstützen, weiter verbessern.
Quellen und weiterführende Links
- [1] gRPC Flow Control: https://grpc.io/docs/guides/flow-control/
- [2] Yellowstone-gRPC-Abonnementspezifikation: https://github.com/rpcpool/yellowstone-grpc/blob/master/README.md
- [3] Tokio: CPU-bound tasks and blocking code: https://docs.rs/tokio/latest/tokio/index.html#cpu-bound-tasks-and-blocking-code
- [4] HTTP/2-Flusskontrolle: https://www.rfc-editor.org/rfc/rfc9113.html#section-5.2
- [5] Solana-Terminologie: https://solana.com/docs/references/terminology
- [6] Offizielle mtr-Dokumentation: https://github.com/traviscross/mtr
- [7] ERPC VPS: https://erpc.global/de/vps/
- Linux PSI: https://docs.kernel.org/accounting/psi.html
- Node.js-APIs zur Leistungsmessung: https://nodejs.org/api/perf_hooks.html
- ERPC gRPC FAQ: https://erpc.global/de/faq/grpc/general/
- ERPC Web Dashboard: https://dashboard.erpc.global/de/
- Offizieller Discord von Validators DAO: https://discord.gg/C7ZQSrCkYR


