„Solana-Daten sind langsam oder unvollständig?“ Was Sie an Ihrer Empfangsinfrastruktur prüfen sollten
Sie haben einen schnellen Solana Shreds-Stream gebucht, doch es kommen nur wenige Pakete an. Die empfangenen Shreds lassen sich korrekt auslesen, aber es fehlen zu viele Fragmente, um Transaktionen zu extrahieren. Auf demselben Server funktioniert gRPC. Wo sollten Sie nun nach der Ursache suchen?
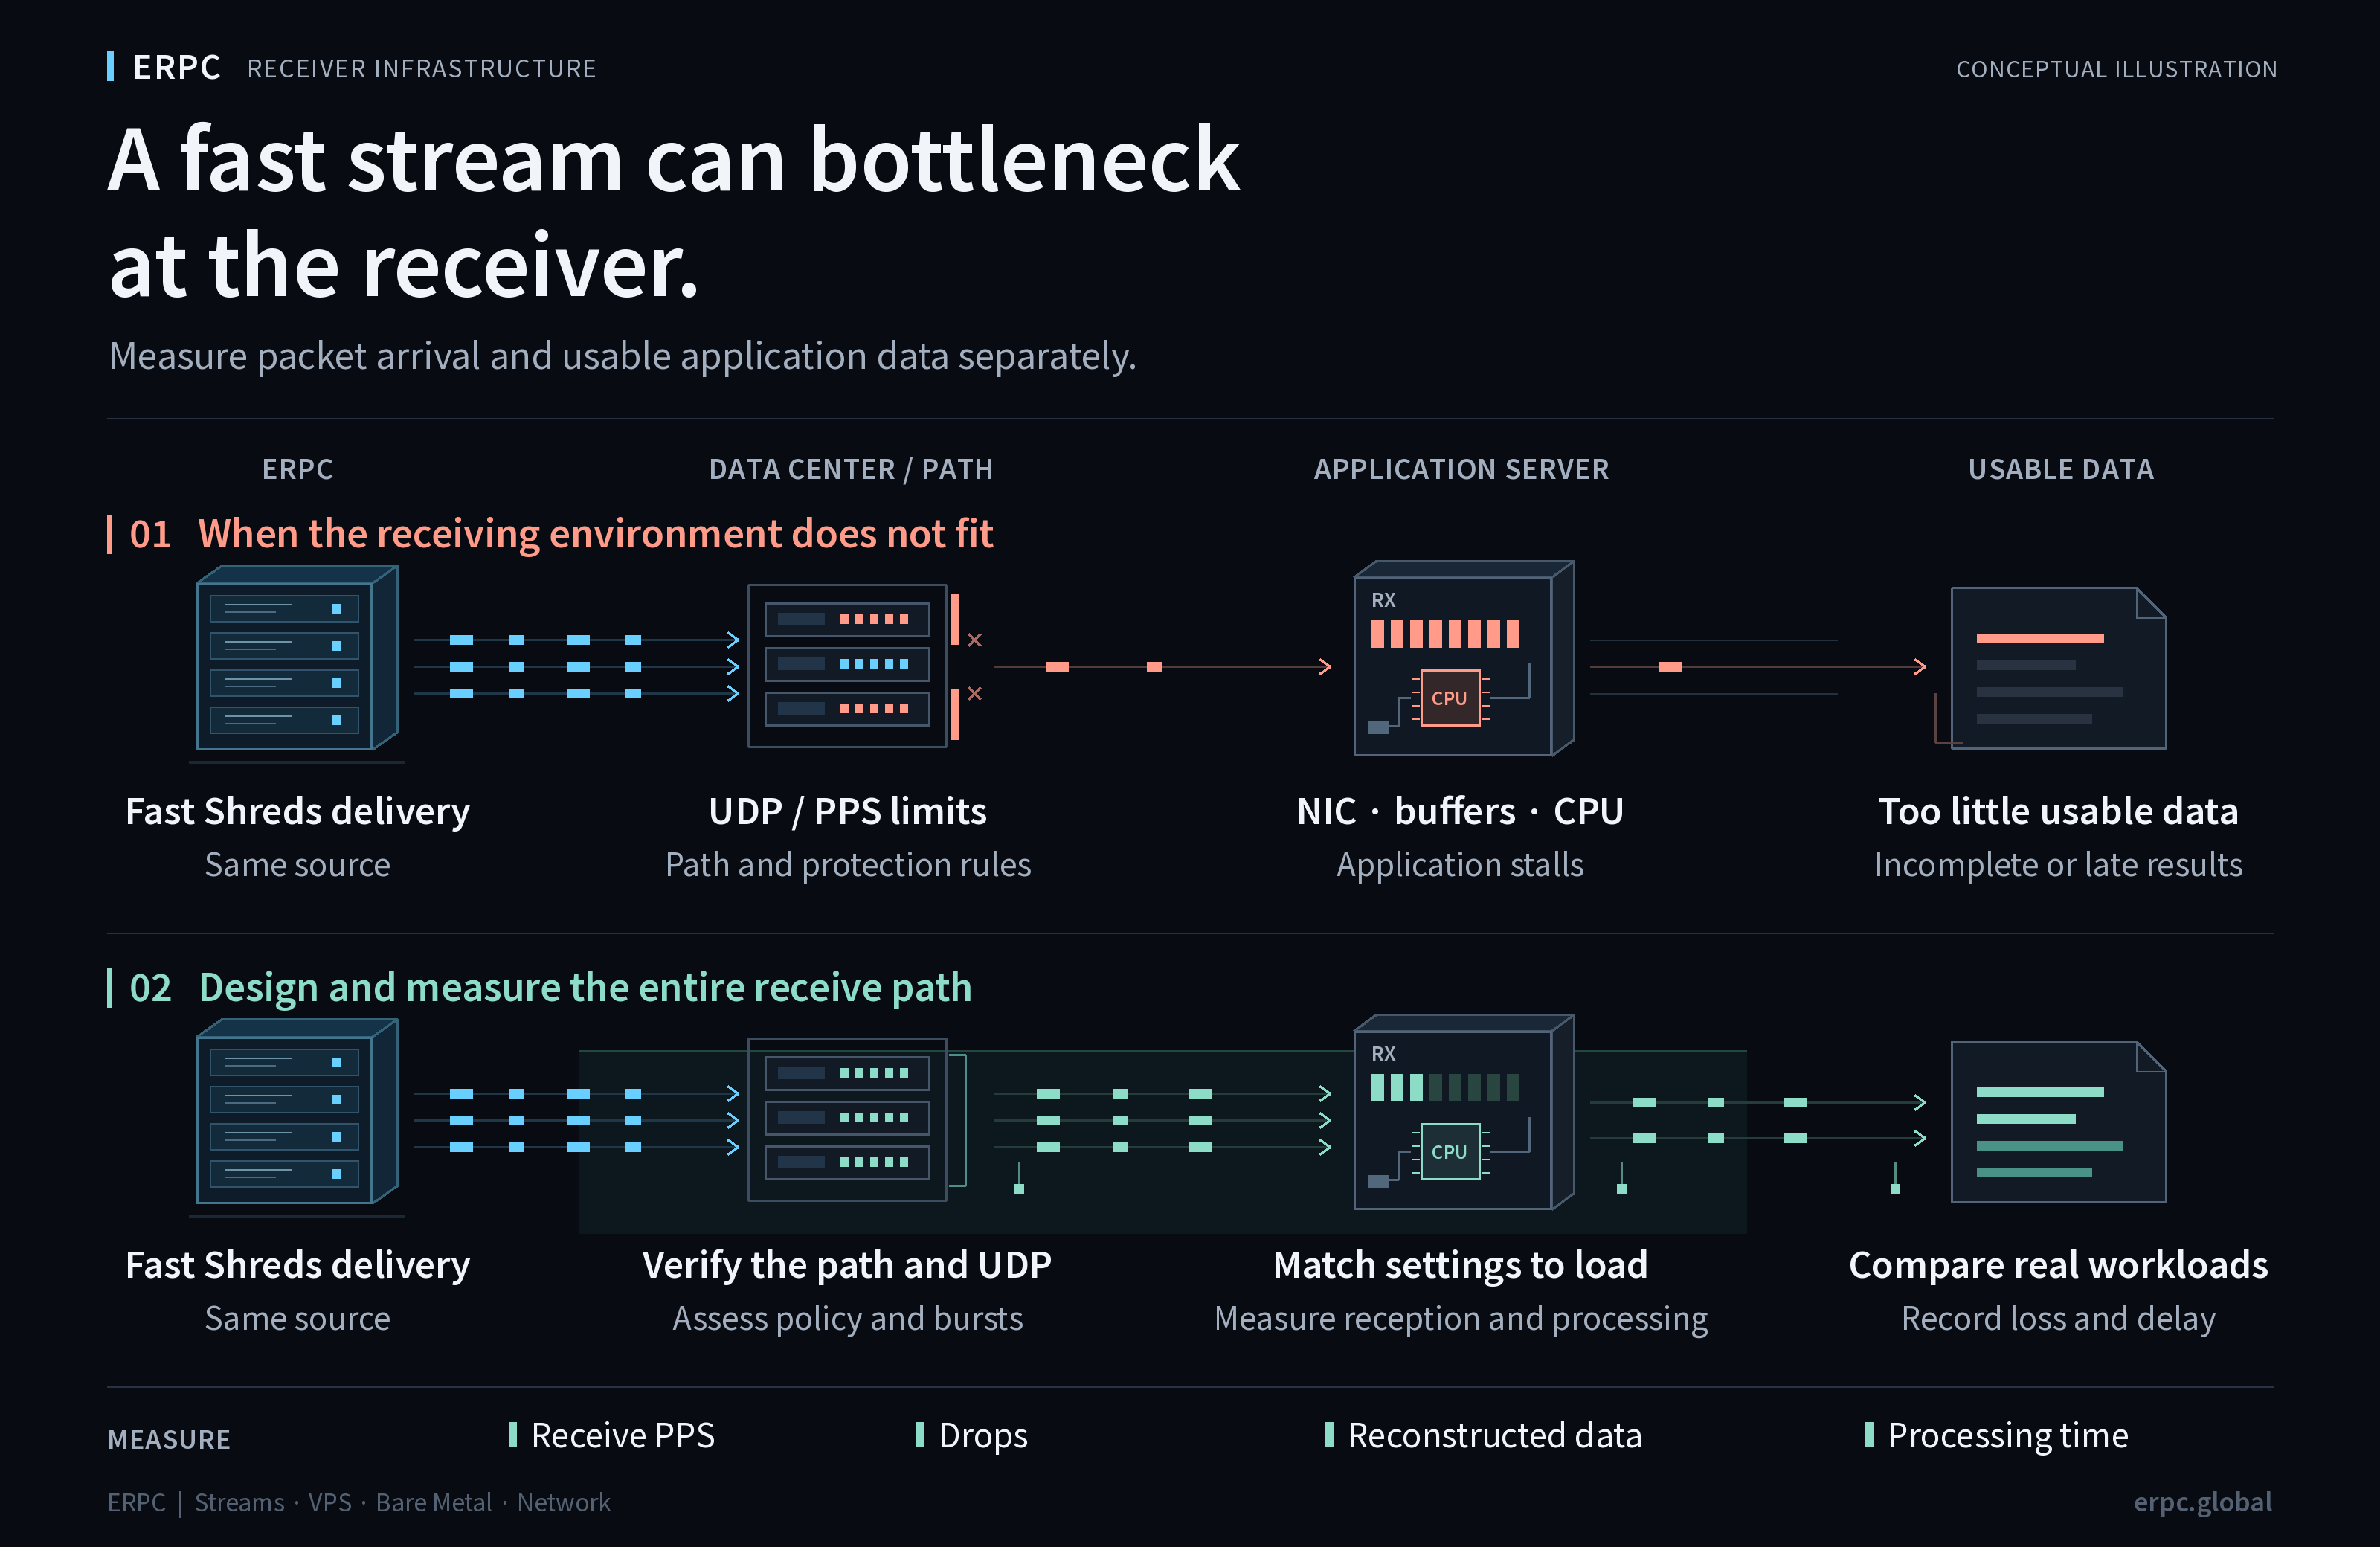
Prüfen Sie neben dem Absender auch Ihren Anwendungsserver und das Rechenzentrum, in dem er steht. Selbst wenn ERPC Shreds schnell weiterleitet, können UDP-Beschränkungen auf dem Übertragungsweg oder Engpässe bei der Verarbeitung auf dem Empfangsserver verhindern, dass Ihre Anwendung diese Geschwindigkeit nutzt.
Bei der Auswahl eines Shreds-Streams zählt der gesamte Weg: wie die Pakete ankommen und wie daraus nutzbare Daten werden. Netzwerkqualität, Entfernung und die Betriebsrichtlinien des Rechenzentrums beeinflussen auch die Leistung von Geyser Yellowstone gRPC, gewöhnlichem RPC- und API-Verkehr sowie der Übermittlung von Transaktionen.
Sendeprotokolle und nutzbare empfangene Daten sind unterschiedliche Nachweise
Bei einer kürzlichen Supportanfrage an ERPC ergaben kurze Messungen auf der Senderseite etwa 3.400–3.900 Pakete/s. Auf der Empfängerseite wurden etwa 13 Pakete/s gemeldet, und die Rekonstruktion eines Slots wurde nicht abgeschlossen.
Diese Werte stammen aus unterschiedlichen Messzeiträumen. Ob die Messmethoden vergleichbar sind, ist ebenfalls nicht bestätigt. Deshalb lässt sich daraus weder eine erfolgreiche Zustellquote noch eine Verlustrate ableiten. Aufzeichnungen auf der Senderseite allein belegen nicht, dass die Pakete am Ziel ankommen. Zum Zeitpunkt der Veröffentlichung ist die endgültige Ursache weiterhin ungeklärt.
Einige Tausend PPS allein belegen auch keine ungewöhnlich hohe Last für einen gewöhnlichen Server. Entscheidend ist, was auf dem tatsächlichen Übertragungsweg geschieht, welche Grenzen gelten, wie stark sich der Verkehr kurzfristig konzentriert, wie der Empfang verarbeitet wird und was die jeweiligen Zähler erfassen.
Beide in Frankfurt, aber unterschiedliche Netzwerkwege
Die Quelle Ihres Streams und Ihr Anwendungsserver können beide in Frankfurt stehen und sich trotzdem in verschiedenen Rechenzentren befinden. In einer solchen Konfiguration kann der Verkehr das eine Gebäude verlassen, ein externes Netzwerk durchlaufen und in das andere Gebäude eintreten. Dieselbe Regionsbezeichnung bedeutet nicht automatisch dieselbe Einrichtung, denselben Netzbetreiber oder dieselben zwischengeschalteten Geräte.
Wenn ERPC-Streams oder RPC-Dienste mit einem ERPC VPS oder Bare Metal am selben Standort kombiniert werden, befinden sich die Dienstserver und der Anwendungsserver in benachbarten Racks. Die Kommunikation zwischen ihnen bleibt im internen Netzwerk. Das ist die Idee hinter ERPCs Zero-Distance Communication: die physische Platzierung und den Weg zur empfangenden Anwendung gemeinsam zu planen, statt lediglich dieselbe Stadt auszuwählen.
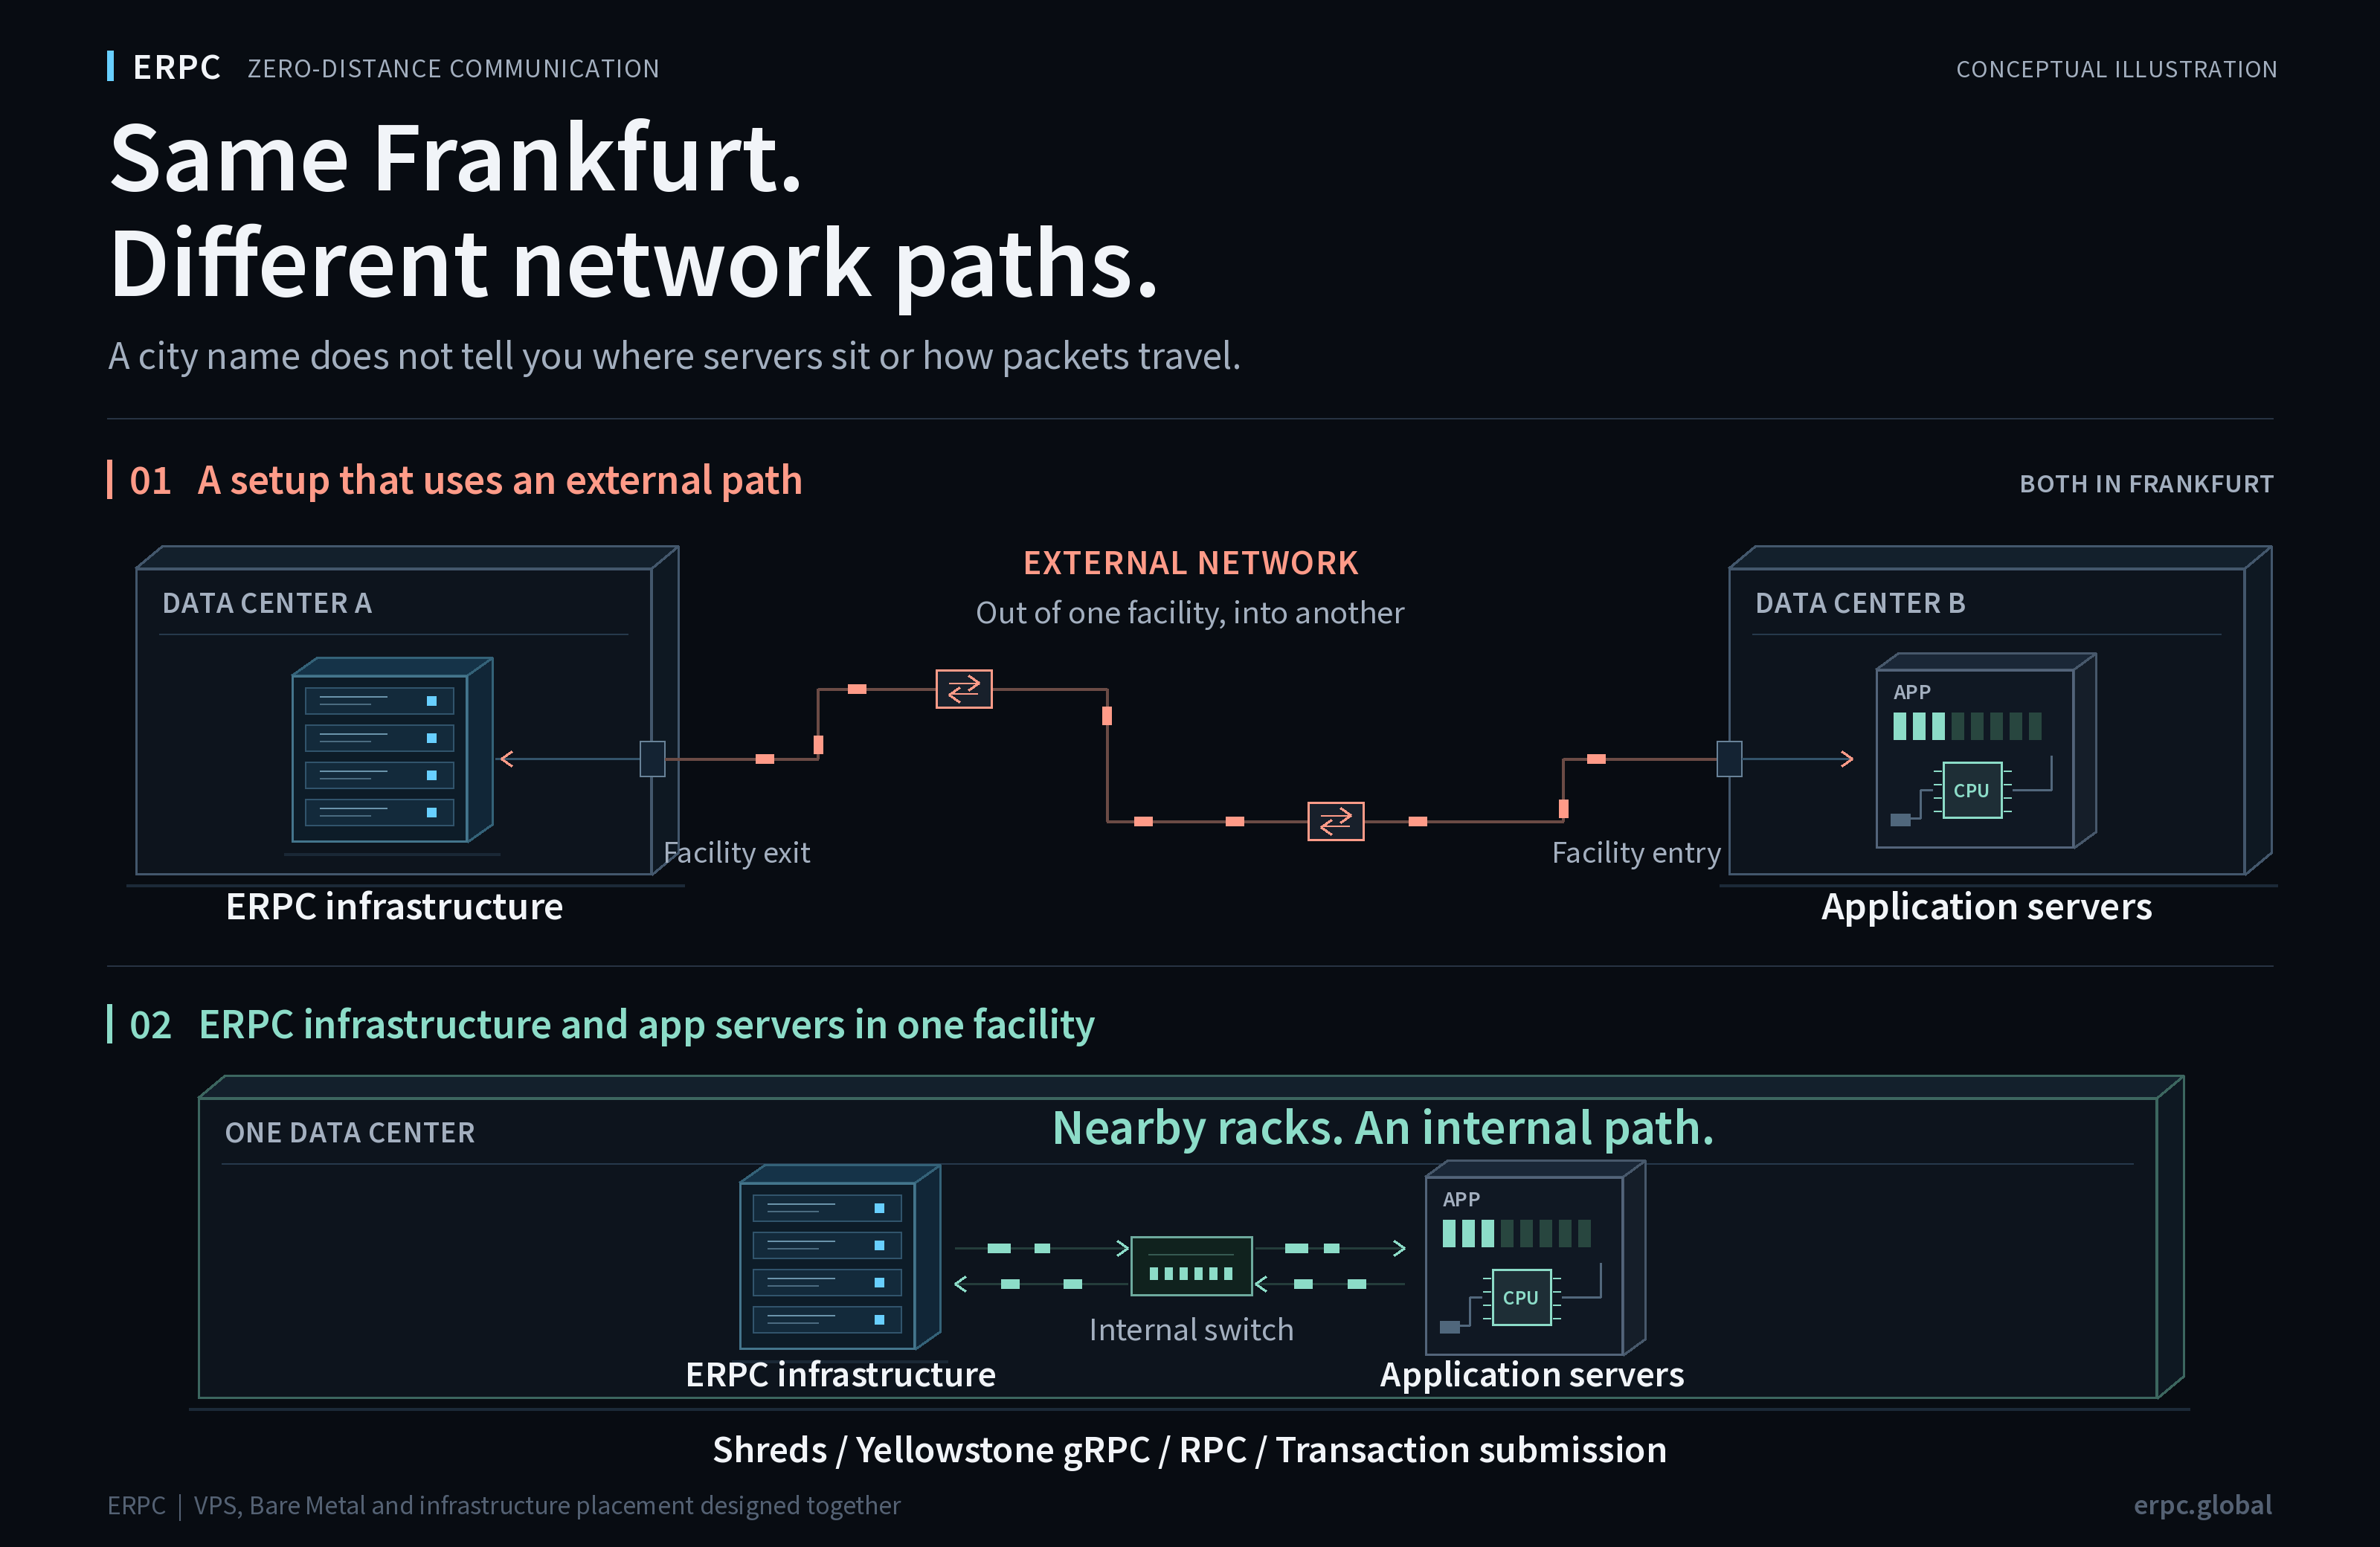
Werden externe Umwege zwischen ERPC-Diensten und dem Anwendungsserver vermieden, wird der Weg kürzer. Auf diesem Abschnitt sinkt zugleich der Einfluss von Überlastung und Routenänderungen in externen Netzwerken. Ein kurzer Weg zusammen mit den nötigen Ressourcen für Empfang und Verarbeitung schafft die Grundlage, um einen schnellen Stream zu nutzen. Prüfen Sie das Ergebnis sowohl bei der Paketankunft als auch bei der Verarbeitung in der Anwendung.
Netzwerkbedingungen wirken sich auf jede Art von Kommunikation aus
Bei Shreds machen fehlende Fragmente das Problem sichtbar. Die Qualität derselben Infrastruktur beeinflusst aber auch allgemein den Datenempfang, API-Anfragen und die Übermittlung von Transaktionen. Je nach Protokoll unterscheiden sich die Symptome in der Anwendung und die sinnvollen Messpunkte.
| Kommunikation | Wo sich Netzwerkeinflüsse zeigen | Was die Anwendung prüfen sollte |
|---|---|---|
| Shreds / UDP | Paketverlust und Verzögerung sowie die Ankunft der zur Rekonstruktion benötigten Fragmente | Gültige Shreds und die Zeit bis zur Rekonstruktion der Daten |
| Geyser Yellowstone gRPC | Warten auf TCP-Neuübertragungen, Rückstau und Verzögerungen im Stream | Zeit, bis dieselbe Aktualisierung empfangen und verarbeitet wurde |
| RPC, APIs und Kommunikation zwischen Diensten | Hin- und Rückweg von Anfrage und Antwort sowie Wartezeiten bei Überlastung | Antwortzeit und deren Schwankungen |
| Übermittlung von Transaktionen | Anfrageweg zum empfangenden Node | Zeit von der Sendeanfrage bis zur Antwort des Nodes |
Eine nahe Platzierung und passende Betriebsrichtlinien unterstützen diesen gesamten Verkehr. Messen Sie die Antwortzeit des empfangenden Nodes getrennt von der Zeit bis zur Aufnahme und Finalisierung einer Transaktion auf der Blockchain.
Gbps allein erklären PPS und Lastspitzen nicht
Bandbreite beschreibt die Datenmenge, die in einer bestimmten Zeit übertragen werden kann. PPS bezeichnet die Anzahl der pro Sekunde verarbeiteten Pakete. Eine Verbindung kann noch freie Bandbreite haben und trotzdem an eine Grenze für die Paketrate oder eine UDP-Beschränkung stoßen. Auch die offiziellen Dokumentationen von Cloud-Anbietern behandeln Bandbreiten- und PPS-Grenzen als getrennte Beschränkungen.[1]
Shreds treffen zudem nicht unbedingt gleichmäßig ein. Eine kurze Lastspitze kann Warteschlangen belasten, ohne dass dies im Durchschnitt erkennbar ist. Sammeln sich Pakete schneller an, als ein Netzwerkgerät oder der Empfänger sie verarbeiten kann, können Pakete jenseits der Kapazität der Warteschlange verworfen werden.[2]
Fragen Sie Ihren Hosting-Anbieter nach dauerhaftem UDP-Empfang, kurzen Lastspitzen, PPS-Grenzen und den Regeln des DDoS-Schutzes. Ziel ist es, Bedingungen zu klären, unter denen der benötigte Verkehr sicher zugelassen wird. Schutzfunktionen sollten nicht pauschal abgeschaltet werden.
Funktionierendes gRPC belegt keinen funktionierenden UDP-Empfang
TCP-basiertes gRPC und die Übertragung unverarbeiteter Shreds über UDP nutzen unterschiedliche Transportmechanismen. TCP bietet Neuübertragung und Reihenfolgesicherung. Streaming über gRPC verfügt über eine Flusskontrolle, die die Kapazität des Empfängers berücksichtigt. UDP selbst überträgt fehlende Pakete nicht erneut und lässt den Sender nicht warten, bis die empfangende Anwendung aufgeholt hat.[3]
Funktionierendes gRPC auf einem Server belegt daher nicht, dass auch der UDP-Weg oder der UDP-Empfang korrekt funktioniert. Protokollspezifische Filter, Ports, Übertragungswege und Empfangsimplementierungen müssen getrennt geprüft werden. Verzögerungen bei der gRPC-Verarbeitung können sich ebenfalls durch Wartezeiten oder Verbindungsabbrüche zeigen.
Transaktionen/s bei gRPC und Pakete/s bei UDP sind unterschiedliche Einheiten auf unterschiedlichen Verarbeitungsstufen. Sie lassen sich nicht direkt vergleichen, um die ausgelieferte Datenmenge oder eine Verlustrate zu berechnen.
Von ankommenden Paketen zu nutzbaren Daten
Bei einem gewöhnlichen UDP-Socket-Empfänger durchlaufen ankommende Pakete NIC, Kernel und den Empfangspuffer des Sockets, bevor sie die Anwendung erreichen. Kommt die Verarbeitung nicht hinterher, können Pakete auch nach ihrer Ankunft auf dem Host verworfen werden. Empfangszähler von Linux-Netzwerkschnittstellen enthalten Pakete, die später verworfen werden. Ein steigender Empfangszähler allein belegt daher keine Zustellung an die Anwendung.[4]
Eine einzelne Empfangswarteschlange oder ein einzelner CPU-Kern kann ausgelastet sein, obwohl die gesamte CPU-Auslastung niedrig ist. Prüfen Sie NIC-Warteschlangen, die Zuordnung von Interrupts und die Leistung einzelner CPU-Kerne. Trennen Sie in der Anwendung den Empfang bei Bedarf von der nachfolgenden Verarbeitung. Aufwendige Analyse und übermäßige Protokollausgabe sollten die Empfangsschleife nicht blockieren. Ein größerer Empfangspuffer kann vorübergehende Lastspitzen auffangen, aber einen dauerhaften Mangel an Verarbeitungskapazität nicht beheben.[5]
Shreds sind Fragmente von Blockdaten. Die Vorwärtsfehlerkorrektur (FEC) kann fehlende Daten mithilfe von Data Shreds und Coding Shreds aus derselben Gruppe wiederherstellen. Dafür müssen aber weiterhin genügend Fragmente vorliegen. Zusätzliche doppelte Pakete ersetzen keine fehlenden Fragmente.[6]
Je nach Implementierung kann ein Empfänger aus bereits verfügbaren Fragmenten Entries rekonstruieren, bevor der gesamte Slot vollständig ist.[9] Messen Sie neben der Gesamtzahl der Pakete auch gültige eindeutige Shreds, rekonstruierte Daten und die Zeit, bis die Anwendung das benötigte Ereignis erkennt.
Jede Stufe im selben Zeitfenster messen
Stimmen Sie Zieladresse, Port und Messzeitfenster auf beiden Seiten aufeinander ab. Werden die folgenden Stufen getrennt erfasst, lässt sich der nächste Untersuchungsschritt gezielter auswählen.
| Messpunkt | Was zu erfassen ist | Was sich daraus ableiten lässt |
|---|---|---|
| Sender | Aufzeichnungen für das Ziel und die Definition des Zählers | Welche Stufe des Sendevorgangs beobachtet wurde |
| Eingang des Empfangshosts | Mitschnitt des betreffenden UDP-Verkehrs, NIC-Statistiken und Verluste beim Mitschnitt | Wie viel Verkehr an diesem Beobachtungspunkt sichtbar war |
| Betriebssystem und Socket | UDP-Fehler, verworfene Pakete am Empfangspuffer und Veränderungen der Warteschlangen | Ob sich die Empfangsverarbeitung im Host staut |
| Shreds-Rekonstruktion | Gültige eindeutige Shreds, erfolgreiche Rekonstruktionen, fehlende Daten und Fehler | Ob aus den Paketen die benötigten Daten entstehen |
| Anwendung | Verarbeitungsrückstand und Erkennungszeitpunkte desselben Ereignisses | Ob die schnelle Ankunft in der Anwendung nutzbar wird |
Zeigt ein Mitschnitt nur wenige Pakete, prüfen Sie zuerst dessen Filter, die beobachtete Schnittstelle, Verluste beim Mitschnitt und verworfene Pakete an der NIC. Manche Betriebssystemzähler beziehen sich auf den gesamten Host oder Netzwerk-Namespace. Prüfen Sie ihren Geltungsbereich und setzen Sie sie mit den Messungen der betreffenden Anwendung in Beziehung.[4][5]
Ändern Sie Einstellungen erst, nachdem Sie die begrenzende Stufe identifiziert haben. Ein größerer Puffer oder Ring allein kann den Engpass verschieben oder die Wartezeit erhöhen. Die aktuelle ERPC-Empfangskonfiguration und die zugehörigen Prüfschritte sind hier dokumentiert:
Betriebsrichtlinien ebenso sorgfältig wählen wie den Server
Die Solana Foundation erläutert, warum die Kontrolle über NICs, physische Kerne, Treiber und Netzwerke für leistungsfähige Validatoren wichtig ist. Diese Anforderungen an einen vollständigen Validator sollten jedoch nicht pauschal auf jeden Shreds-Empfänger übertragen werden. Eine empfangende Anwendung benötigt eine Konfiguration, die zu ihrem eigenen Stream und ihrer Verarbeitungslast passt.[7]
Kosten oder Stromverbrauch zu senken, ist ein nachvollziehbares Betriebsziel. HFT- und Echtzeitanwendungen benötigen zugleich eine schnell reagierende CPU, dauerhaft verfügbare Verarbeitungskapazität und kurze Wartezeiten im Netzwerk. Das Aufwachen aus einem Energiesparzustand kann mit zusätzlicher Latenz verbunden sein.[8]
Prüfen Sie neben CPU-Modell und Kernzahl auch die gemeinsame Nutzung von Ressourcen, den Umgang mit dauerhafter Last, die Bedingungen für UDP-Verkehr und den tatsächlichen Netzwerkweg.
ERPC betrachtet Stream und Empfangsumgebung gemeinsam
ERPC arbeitet an der Auswahl von Rechenzentren nahe der Solana-Infrastruktur, an Netzwerkwegen, Hardware und Betriebseinstellungen. Neben Shreds und gRPC bieten wir VPS und Bare Metal an. Sie können einen VPS passend zu Ihrer Verarbeitungslast wählen und Bare Metal vergleichen, wenn Sie physische Ressourcen exklusiv nutzen möchten.
Die Konfiguration und den Betrieb der bereitgestellten Umgebungen zu verstehen, hilft auch bei der technischen Fehleranalyse. Wir können Aufzeichnungen auf der Senderseite mit Messungen beim Empfänger abgleichen und konkrete Prüfschritte für Netzwerk, Betriebssystem oder Anwendung bestimmen. In der hier beschriebenen Anfrage haben wir die Messungen auf der Senderseite geprüft und zusätzliche Messungen beim Empfänger angefordert.
Wenn Stream, Platzierung des Empfängers und Implementierung der Anwendung gemeinsam bewertet werden, lässt sich leichter erkennen, was zwischen dem gewählten Dienst und den benötigten Daten noch fehlt.
Mit stündlicher Abrechnung die aktuelle Umgebung vergleichen
Wenn Sie Zweifel an Ihrer Empfangsumgebung haben, testen Sie einen ERPC VPS oder Bare Metal mit stündlicher Abrechnung und vergleichen Sie denselben Stream und dieselbe Anwendung. Aktuelle Preise, Verfügbarkeit und Bestellbedingungen für Ihre gewünschte Region finden Sie im Dashboard.
Beginnen Sie mit einer verfügbaren Konfiguration und erfassen Sie Empfangszahlen, rekonstruierte Daten, Verarbeitungsrückstände sowie die Erkennungszeitpunkte derselben Ereignisse. Prüfen Sie beim Vergleich von Zeitstempeln verschiedener Hosts auch die Genauigkeit der Uhrensynchronisation. Wiederholen Sie den Test zu unterschiedlichen Zeiten und vergleichen Sie, an welcher Stelle des Weges sich die Ergebnisse unterscheiden. Nutzen Sie diese Messungen, um einen Server und ein Rechenzentrum zu wählen, die zu Ihrer Anwendung passen.
- VPS: https://erpc.global/de/vps/
- Bare Metal: https://erpc.global/de/baremetal/
- Dashboard: https://dashboard.erpc.global/de/
Weiterführende Artikel
- Solana Stream SDK v4.0.0: https://erpc.global/de/news/2026/11/07/erpc-solana-stream-sdk-v4-20261107/
- [9] Shreds UDP Forwarding Premium: https://erpc.global/de/news/2026/11/03/erpc-shreds-udp-forwarding-premium-20261103/
- Offizieller Discord von Validators DAO: https://discord.gg/C7ZQSrCkYR
Technische Quellen
- [1] AWS EC2: Bandbreiten- und PPS-Grenzen: https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/monitoring-network-performance-ena.html
- [2] IETF UDP Usage Guidelines, Lastspitzen: https://www.rfc-editor.org/rfc/rfc8085.html#section-3.1.6
- [3] Linux UDP: https://man7.org/linux/man-pages/man7/udp.7.html
- [3] Linux TCP: https://man7.org/linux/man-pages/man7/tcp.7.html
- [3] gRPC-Flusskontrolle: https://grpc.io/docs/guides/flow-control/
- [4] Linux-Schnittstellenstatistiken: https://docs.kernel.org/networking/statistics.html
- [4] libpcap: Verhalten und Verluste beim Mitschnitt: https://github.com/the-tcpdump-group/libpcap/blob/master/doc/README.linux
- [5] Skalierung der Netzwerkverarbeitung unter Linux: https://docs.kernel.org/networking/scaling.html
- [5] Linux-Socket-Empfangspuffer: https://man7.org/linux/man-pages/man7/socket.7.html
- [5] Red Hat: Untersuchung von UDP-Paketverlusten: https://docs.redhat.com/en/documentation/red_hat_enterprise_linux/10/html/network_troubleshooting_and_performance_tuning/tuning-udp-connections
- [6] Anza Turbine Block Propagation: https://docs.anza.xyz/consensus/turbine-block-propagation/
- [7] Solana Foundation: Hardware für leistungsfähige Validatoren: https://solana.com/news/high-performance-solana-validators-run-on-bare-metal-hardware
- [8] Verwaltung von CPU-Leerlaufzuständen unter Linux: https://docs.kernel.org/admin-guide/pm/cpuidle.html