Dez mitos que tornam aplicações Solana mais lentas: por que um ambiente rápido ainda pode ser lento
Sua conexão é rápida. Sua CPU é moderna. Seu servidor fica na mesma cidade que o provedor de dados. Mesmo assim, a aplicação demora a reagir às informações de que precisa. A conexão permanece aberta, mas os dados processados ficam cada vez mais atrasados.
Ao desenvolver aplicações de baixa latência na Solana, essa situação nem sempre tem uma única causa. Rotas de rede, configurações de recebimento, os dados escolhidos na assinatura e esperas dentro da aplicação podem se combinar e impedir o uso completo da infraestrutura rápida que você escolheu.
Na ERPC, operada pela ELSOUL LABO B.V., nossa equipe de suporte encontra repetidamente dúvidas sobre loops de recebimento bloqueados, configurações de clientes, assinaturas de dados desnecessariamente amplas e tentativas de reconexão que não resolvem o erro original. Escolhas que causavam poucos problemas em uma aplicação web convencional podem se tornar limitações no trading de alta frequência e no processamento em tempo real.
Este artigo examina dez mitos por trás desses problemas. O objetivo é ajudar a avaliar tanto a escolha da infraestrutura quanto o projeto que leva seu desempenho até a decisão e o envio de transações.
Este guia é para desenvolvedores com experiência em aplicações web que estão começando a criar aplicações de trading de alta frequência (HFT) ou outras aplicações em tempo real na Solana. Ele aborda a escolha do ambiente e as primeiras verificações. Aqui, uma assinatura de dados significa escolher quais atualizações a aplicação receberá continuamente.
Primeiro, defina o que precisa terminar mais cedo
O tempo de ida e volta da rede, a chegada dos dados, o tempo de decisão e o prazo até a confirmação de uma transação são métricas diferentes. Um ping rápido não evita decisões lentas se o processamento travar após o recebimento. Uma resposta RPC rápida não significa necessariamente que a transação foi executada.
Considere, por exemplo, uma aplicação que recebe uma atualização do estado de um mercado, recalcula suas condições e envia uma transação quando essas condições são atendidas. Separe o tempo até a atualização chegar, o tempo para terminar o cálculo e o tempo para verificar o resultado da transação enviada. Definir qual intervalo precisa ser menor deixa claro onde investigar.
Meça esses intervalos separadamente. Melhorar começa por definir velocidade com mais precisão do que um nome de produto ou um único número.
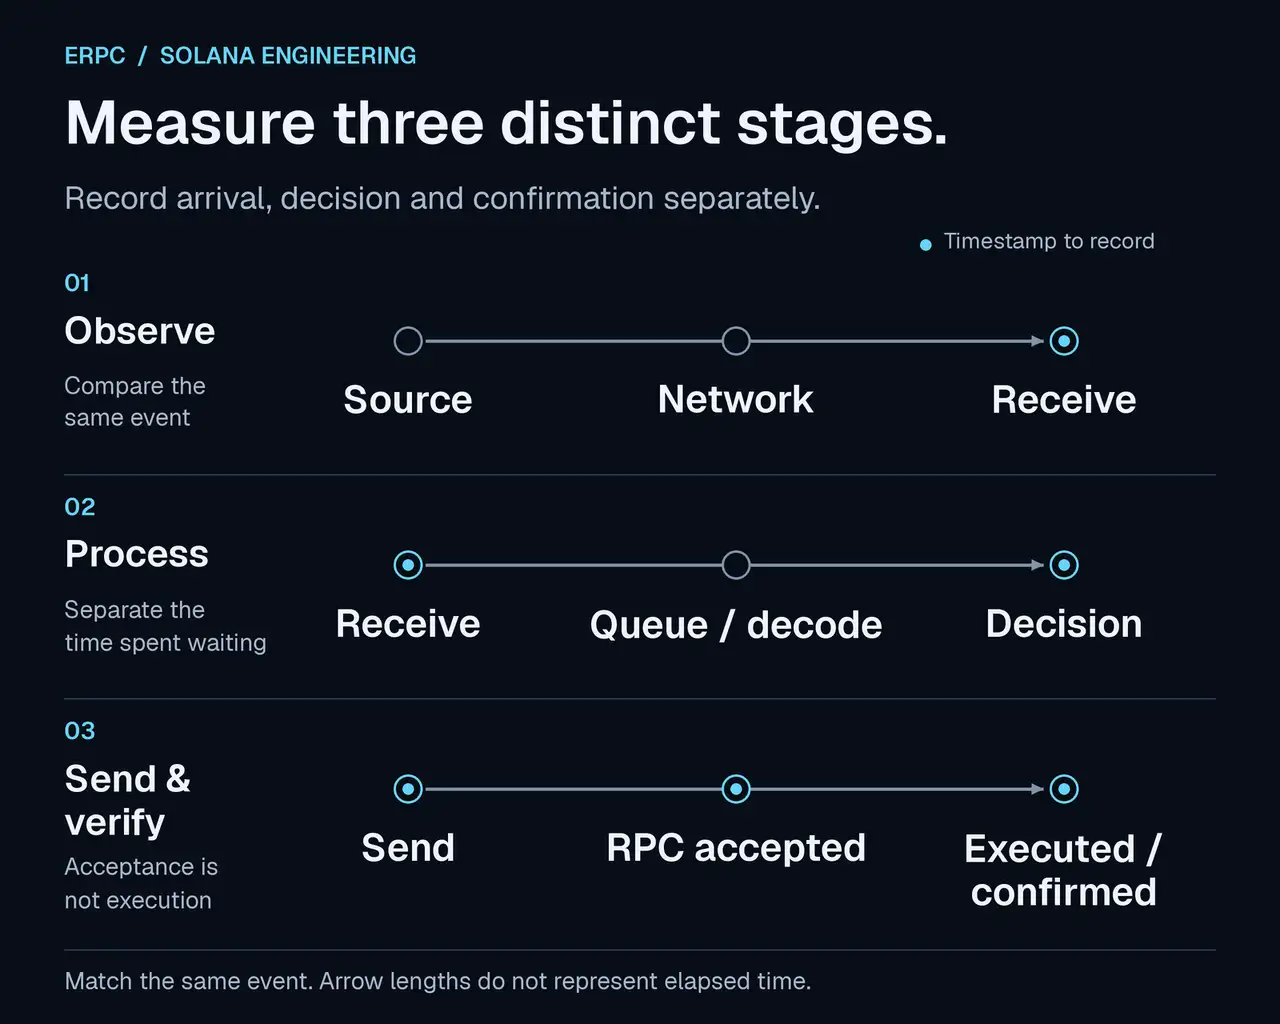
Meça separadamente a observação, o processamento dentro da aplicação e o envio e a confirmação. Este diagrama ilustra etapas de medição, não durações medidas ou diferenças de desempenho.
Mito 1: Uma VM pequena está funcionando, então sua capacidade deve ser suficiente
Uma pequena VM na nuvem funcionou bem para uma aplicação web anterior ou uma carga de trabalho na Ethereum. Essa experiência pode levar à suposição de que a mesma configuração dará conta de um fluxo da Solana. Mas uma aplicação que faz consultas RPC ocasionais precisa de recursos diferentes de outra que recebe e processa continuamente um amplo conjunto de atualizações.
Dimensione o ambiente pelo volume de dados, pela taxa de chegada, pelo trabalho por evento e pela latência aceitável. Quantos eventos chegam por segundo? Quantos bytes são transferidos? Quanto tempo de CPU e memória a decodificação e as decisões consomem? Reserve margem para acompanhar tanto os picos quanto o tráfego habitual. Mesmo na mesma cadeia, o escopo da assinatura de dados e a implementação alteram os requisitos.
A dificuldade é que uma aplicação com recursos insuficientes pode parecer estar funcionando. Os dados continuam aparecendo na tela enquanto ficam cada vez mais antigos, ou lacunas durante a reconexão passam despercebidas. Apenas contar eventos recebidos não revela isso. Confira também a quantidade de eventos processados, a idade dos dados pendentes e a continuidade dos eventos que a assinatura deveria cobrir.
Se a experiência anterior for a única referência, os desenvolvedores podem nunca questionar a capacidade de recebimento e continuar atribuindo o problema ao endpoint de dados. Testar um ambiente com mais folga pode revelar acúmulos ou dados ausentes que antes não eram perceptíveis.
Para investigar, compare o mesmo endpoint, a mesma assinatura de dados, o mesmo nível de commitment (a etapa de confirmação solicitada, explicada no mito 9), o mesmo SDK e configurações e o mesmo processamento em um ambiente de recebimento e processamento com mais folga. Mantenha a região, registre diferenças de CPU, memória e rede e compare a taxa de recebimento, o trabalho concluído, o acúmulo, os eventos ausentes e o tempo até decidir. A carga varia ao longo do tempo. Compare no mesmo período quando possível, respeitando os limites de conexão e a carga imposta ao serviço.
Uma melhora após mudar o ambiente mostra que as condições de recebimento ou processamento contribuíram para o resultado. Se CPU, memória e rede mudaram juntas, são necessárias verificações adicionais para identificar qual recurso foi relevante. Escolher recursos de acordo com o volume e a velocidade dos dados realmente tratados é um pré-requisito para o processamento de baixa latência.
Mito 2: Estar na mesma cidade significa estar perto na rede
“Os dois servidores estão em Frankfurt, então devem estar próximos.” “Implantar em Tokyo deve ser o mais rápido para o Japão.” O nome de uma cidade ajuda a escolher locais, mas não garante o caminho real percorrido pelo tráfego.
Esse caminho depende das conexões entre data centers, das interconexões entre operadores e das decisões de roteamento. Mesmo servidores na mesma cidade podem fazer um desvio por redes externas. O RIPE IPmap cita, por exemplo, a visualização de rotas ineficientes, como tráfego que sai de um país e depois retorna, entre seus usos. [1]
Meça o RTT entre a fonte real de dados e o host que executa a aplicação, a variação ao longo do tempo, as retransmissões ou perdas e o momento de chegada do mesmo evento. Traceroute e MTR ajudam a investigar o caminho, mas o número de saltos sozinho não determina qual é melhor. Também é importante não confundir um roteador intermediário que limita respostas de diagnóstico com perda de pacotes que afeta a aplicação.
Depois de escolher uma região, faça mais uma pergunta: como esta fonte específica e este servidor específico estão realmente conectados? Essa verificação revela diferenças que o nome da cidade não permite enxergar.
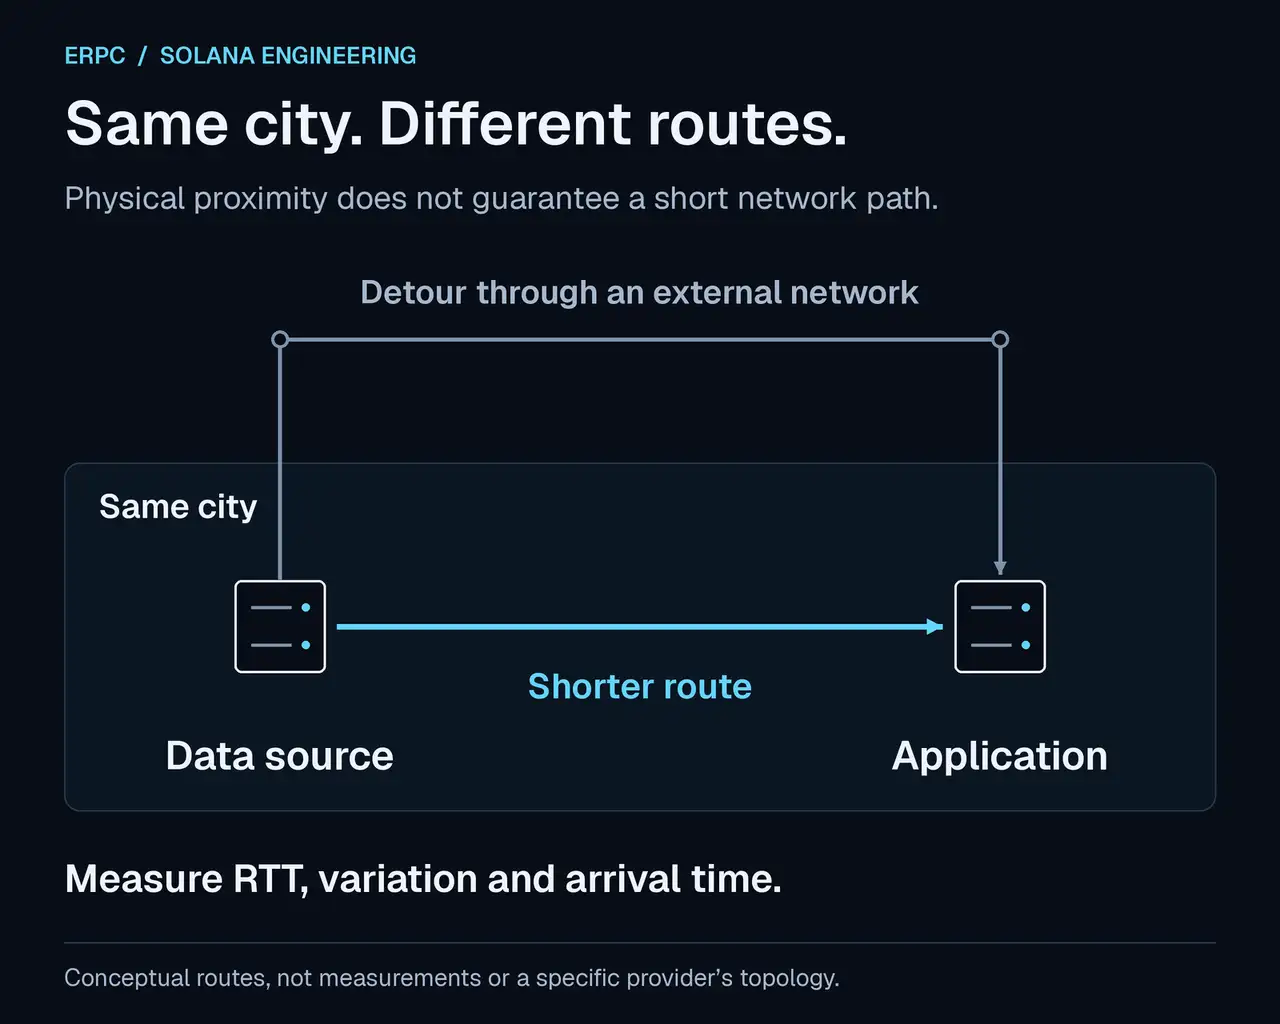
Dois servidores na mesma cidade podem ter rotas e tempos de ida e volta diferentes. Este diagrama é conceitual e não representa a rota real de um provedor específico.
Mito 3: Uma especificação de rede alta significa banda utilizável suficiente
A largura de banda na especificação de um servidor pode significar várias coisas: velocidade da porta física, banda atribuída à máquina virtual, capacidade sustentada ou um limite temporário de burst. Ter uma NIC rápida não significa que a aplicação possa usar toda a sua capacidade continuamente.
A documentação da AWS, por exemplo, distingue banda de base e banda de burst e descreve restrições relacionadas a destinos, fluxos e taxas de pacotes. Isso mostra como interpretar uma especificação; não significa que todo VPS tenha os mesmos limites da AWS. [2]
Ao escolher um plano, verifique se a banda é dedicada ou compartilhada, as condições de uso sustentado, as franquias de transferência e se destinos diferentes recebem tratamento distinto. Durante os testes, mantenha tráfego para o mesmo endpoint e sob as mesmas condições de assinatura previstas para produção, observando juntos a taxa de recebimento, os descartes, as retransmissões e a carga de CPU.
Um resultado alto em um teste curto de velocidade não prova que o servidor consegue processar continuamente um fluxo de produção. Ao mesmo tempo, uma baixa taxa de recebimento não significa necessariamente falta de banda. Separe problemas de configuração de recebimento e limitações de processamento antes de ampliar a conexão.
Mito 4: Um modelo melhor de CPU, mais núcleos ou mais GHz máximos tornam a aplicação rápida
A frequência máxima de boost de uma CPU não é uma frequência mantida em qualquer carga. O funcionamento real depende de potência, temperatura, firmware, controles de frequência e outras cargas. A documentação do Linux explica que habilitar o boost permite seu uso; isso não demonstra que a CPU esteja efetivamente operando em boost. [3]
Se o trabalho importante estiver concentrado em uma thread, adicionar núcleos não o fará terminar mais cedo por si só. O uso total de CPU pode parecer baixo enquanto um único núcleo ou o loop de eventos está saturado. O guia oficial do Node.js também explica como um callback pesado faz outras tarefas esperarem. [4]
Verifique a frequência, a temperatura, o uso por núcleo e os tempos de processamento sob sua carga real. Em um ambiente virtual, o tempo de espera por alocação de CPU também pode ser esclarecedor. Faça o profiling da aplicação para identificar quanto tempo é gasto em decodificação, cálculos, alocação de memória e logs.
Escolha uma combinação de desempenho de frequência da CPU, alocação de recursos, configurações que sustentem o desempenho e implementação da aplicação. Comparar apenas os modelos não determina a velocidade da aplicação inteira.
Mito 5: Com gRPC, as configurações padrão do cliente são suficientes
Estabelecer uma conexão gRPC não prova que ela pode receber o volume necessário na velocidade exigida. O HTTP/2 possui controle de fluxo pelo qual o receptor informa ao emissor quantos dados pode aceitar. Esse controle se aplica tanto ao fluxo quanto à conexão. Portanto, as janelas de recebimento e suas atualizações podem limitar a vazão mesmo quando a rede ainda tem capacidade livre. [5][6]
Uma janela de recebimento informa ao emissor quantos dados ele pode enviar sem outra atualização do receptor. Valores iniciais, ajuste automático e precedência das configurações variam entre SDKs e bibliotecas. Escrever um número grande em um arquivo de configuração não prova que o cliente se comporta como esperado. Verifique as configurações de fluxo e conexão, sua interação com os ajustes adaptativos e a versão utilizada.
Faça mudanças enquanto mede a taxa real de recebimento e o acúmulo de trabalho sob as mesmas condições de assinatura de dados. O tamanho máximo de mensagem recebida, o buffer TCP de recebimento e a janela HTTP/2 são configurações diferentes. Keepalive verifica se a conexão continua ativa; não acrescenta capacidade de processamento nem banda.
A FAQ de gRPC da ERPC inclui etapas de diagnóstico e exemplos de configuração para um fluxo cuja vazão permanece constante enquanto o atraso aumenta. Antes de usar um exemplo, anote o SDK e sua versão. Localize onde esse SDK configura as janelas de recebimento do fluxo e da conexão, além do ajuste automático, e compare essas configurações com o exemplo da FAQ. Se usar outro SDK, consulte a documentação dele para identificar as configurações correspondentes, em vez de copiar nomes de parâmetros e valores sem alterações. Depois, verifique o resultado com o volume da sua assinatura de dados e sua capacidade de processamento. [7]
Mito 6: Receber todos os blocos completos permite decidir mais cedo
“Receber tudo primeiro e depois procurar o que importa.” É uma maneira compreensível de começar a desenvolver, mas acrescenta trabalho que talvez não seja necessário antes da decisão. Transferir, decodificar, alocar memória e pesquisar dados desnecessários consome recursos finitos de CPU e banda.
Se você quer reagir a mudanças em um mercado, programa ou conta específicos, defina primeiro os eventos e campos necessários para a decisão. O Yellowstone gRPC oferece filtros para escolher quais atualizações de transações e contas a aplicação recebe e uma forma de obter apenas parte dos dados de uma conta. Notificações de blocos completos também são diferentes das notificações de atualizações individuais. [8]
Para um requisito como “recalcular as condições sempre que o mercado A mudar”, liste as informações que identificam o mercado A, o estado usado no cálculo e os eventos que atualizam esse estado. Os dados necessários dependem da especificação do programa, portanto compare essa especificação com as atualizações recebidas. Use a lista para restringir as assinaturas de dados e verifique se o estado necessário à decisão continua completo.
Com os mesmos recursos e condições, se uma aplicação espera para decodificar e pesquisar todos os registros enquanto outra processa imediatamente a atualização necessária, a segunda evita essa espera. Um concorrente mais focado pode reagir antes repetidamente por razões que vão além da conexão de rede. Decidir o que pode ser ignorado faz parte do projeto de baixa latência.
Indexação, auditoria, pesquisa e armazenamento histórico podem legitimamente exigir todos os dados. Crie um caminho separado para essa carga. Separá-lo das decisões imediatas permite projetar a capacidade e a completude necessárias a cada caminho. Verifique, porém, se a filtragem não remove atualizações necessárias a decisões corretas. O processamento em lotes também pode aumentar a vazão total em alguns casos, então deve ser escolhido conforme a espera tolerável para a aplicação.
No serviço Shared gRPC atual da ERPC, uma assinatura
blocks não vazia exige o serviço Dedicated. Assinaturas transactions ou blocksMeta podem atender a determinadas necessidades, mas nenhuma fornece os mesmos dados dos blocos completos. Escolher Dedicated ainda exige capacidade adequada de processamento no receptor e um projeto apropriado das assinaturas de dados. [9]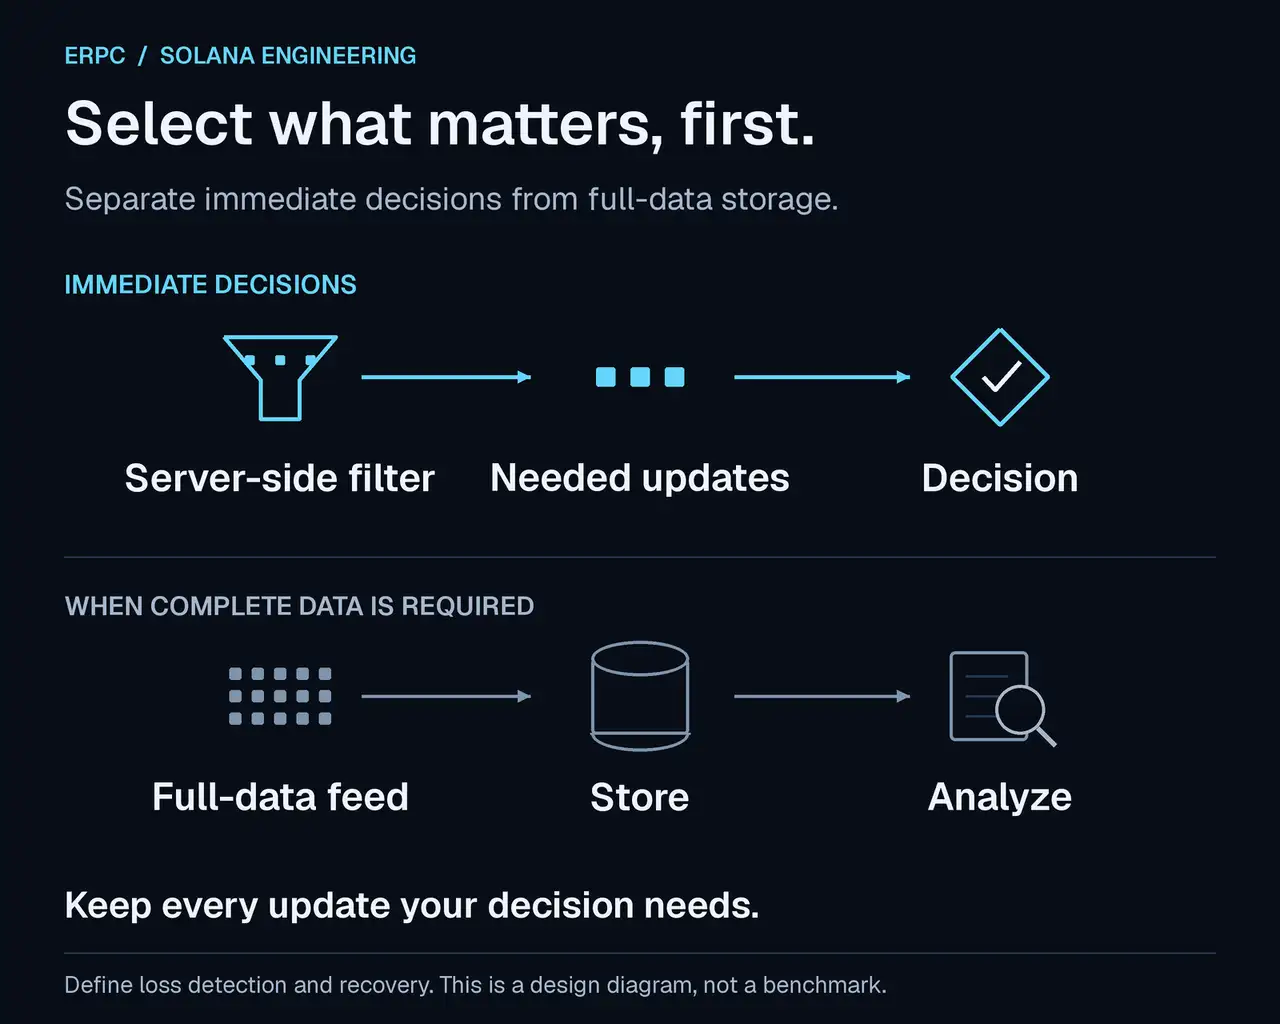
Use um caminho para as atualizações necessárias às decisões imediatas e outro para armazenamento completo e análise. Este diagrama ilustra uma abordagem arquitetural. Verifique se a filtragem preserva o estado necessário às decisões corretas e defina como recuperar dados ausentes.
Mito 7: Se os dados chegam, o processamento está acompanhando
Uma fila pode se formar entre os dados recebidos e os dados processados até ficarem prontos para fundamentar uma decisão. Se o trabalho que entra superar continuamente a capacidade de processamento, o atraso se acumula mesmo com a conexão aberta. Um buffer maior pode absorver picos temporários, mas, diante de um déficit sustentado de processamento, apenas armazena mais dados antigos.
Considere um exemplo hipotético que começa sem trabalho pendente. A aplicação recebe 12.000 eventos do mesmo tipo por segundo e conclui o processamento de 10.000 por segundo. Se puder manter todos os eventos na fila, sem descartá-los nem agrupá-los, o trabalho pendente crescerá em 2.000 eventos por segundo e chegará a 20.000 após 10 segundos. A conexão continua ativa e os dados continuam aparecendo, enquanto o trabalho necessário às decisões fica para trás. Esses números ilustram o mecanismo; não são medições de desempenho da ERPC.
Não meça somente a quantidade de eventos recebidos. Meça também o processamento concluído, o tamanho da fila, a idade do item pendente mais antigo e o tempo entre recebimento e fim da decisão. Monitore separadamente a saúde da conexão e a atualidade dos dados.
Mantenha no loop de recebimento apenas o trabalho necessário para continuar recebendo. Considere separar gravações em banco de dados, logs de payloads completos, chamadas a APIs externas e cálculos pesados em outros caminhos de processamento. Defina um limite de capacidade para as filas e uma política para quando ficarem cheias. Uma fila com capacidade limitada pode fazer as etapas anteriores de processamento esperarem quando fica cheia; ela não resolve sozinha a falta de capacidade de processamento. [10]
Em atualizações nas quais apenas o estado mais recente importa, pode ser possível agrupar estados antigos. Eventos de transação que exigem processamento completo ou em ordem não devem ser descartados indiscriminadamente. Projete detecção de lacunas, recuperação de dados e restauração de estado após reconexão conforme os requisitos da aplicação.
O
STREAM_GUARD_SLOW_READER da ERPC é uma proteção acionada por progresso insuficiente de escrita ou atraso de entrega observado. Essa observação, sozinha, não identifica a causa. Investigue a conexão, o host, o volume da assinatura de dados e a velocidade de consumo da aplicação. Antes de reconectar, preserve o primeiro status, message, metadata e trailers disponíveis e leia o motivo e as condições de nova tentativa fornecidos pelo servidor. Reenviar a mesma solicitação rejeitada sem corrigi-la mantém a causa intacta. [7]Mito 8: Um ping ou uma média rápidos significam rapidez quando importa
O ping indica o tempo de ida e volta da rede. Ele mede um intervalo diferente da latência da aplicação, que inclui processamento na origem, conteúdo da assinatura, espera de recebimento, decodificação e decisão. Uma média também pode esconder um pequeno número de atrasos expressivos.
p50 é a mediana. p95 e p99 indicam os valores em que, ou abaixo dos quais, ficam respectivamente 95% e 99% das medições. p99 não é o máximo. Informe a quantidade de amostras e o período de medição e verifique os valores durante picos de eventos, os máximos, os timeouts, as desconexões e os dados ausentes. [11]
Ao comparar provedores, relacione o mesmo evento, tipo de dado, commitment e condições de assinatura. Quando possível, receba no mesmo host de medição e use um relógio monotônico para medir o tempo decorrido dentro da aplicação. Ao subtrair timestamps de hosts diferentes, considere as diferenças entre relógios que podem contaminar a medição.
Manter apenas eventos bem-sucedidos pode fazer uma configuração que perde dados com frequência parecer rápida. Escolher o resultado isolado mais rápido e escolher uma configuração menos propensa a ficar para trás quando a produção precisa são decisões diferentes.
Mito 9: Os primeiros dados recebidos são igualmente definitivos e significam a mesma coisa
Shreds, notificações de transações, atualizações de contas e notificações de blocos não representam as mesmas informações na mesma etapa. Usar dados de uma fase anterior pode deixar mais reconstrução ou interpretação a cargo da aplicação. A comparação precisa alinhar não só o horário de recebimento, mas também o que é possível saber naquele momento. [8][12]
Diferencie também os níveis de commitment
processed, confirmed e finalized da Solana. Se observações antecipadas orientarem decisões, a aplicação precisa verificar seu estado de confirmação depois e corrigir o próprio estado quando necessário. Separe o recebimento de uma atualização antecipada das condições para uma ação definitiva em um sistema externo. [13]Por exemplo, simplesmente comparar notificações recebidas com commitments diferentes e afirmar que uma é alguns milissegundos mais rápida não compara o mesmo trabalho. Determine as informações e o grau de finalização exigidos pela aplicação e meça quanto tempo leva para poder decidir nessas condições.
Mito 10: Um envio bem-sucedido significa que a transação será executada primeiro
Uma resposta bem-sucedida de
sendTransaction significa que o RPC aceitou a transação. Não garante processamento nem confirmação pelo cluster. A especificação da Solana exige verificar separadamente o status da assinatura da transação. [14]Mesmo que as informações recebidas permitam decidir cedo, continuam relevantes o caminho de envio, a validade do blockhash, a disputa pelas contas que a transação precisa modificar, os recursos computacionais, as taxas de prioridade e as condições de sucesso da própria transação. O SWQoS trata da admissão e da prioridade de conexão em direção ao líder, enquanto as taxas de prioridade afetam a prioridade no agendamento das transações. Suas funções são diferentes e nenhuma garante incondicionalmente a ordem de execução ou o sucesso. [15][16]
Registre separadamente o fim da decisão, o início do envio, a aceitação pelo RPC, os resultados da execução e o estado de confirmação exigido. Ao tentar novamente, diferencie também o reenvio de uma transação com a mesma assinatura da criação de uma nova transação, para evitar ações duplicadas não intencionais.
Somente ao observar o caminho completo, do recebimento à confirmação, é possível identificar qual melhoria aproxima a aplicação do objetivo.
Medições que devem ser estabelecidas primeiro
Comece com estas três verificações.
- Escolha uma decisão e anote quais atualizações ela exige e qual estado precisa estar disponível antes que a aplicação possa decidir.
- No mesmo período de medição, registre a quantidade de eventos recebidos, de eventos com processamento concluído e de eventos pendentes, todos do mesmo tipo. Se houver trabalho em fila, meça também o tempo desde que a aplicação recebeu o evento pendente mais antigo.
- Se o trabalho pendente ou o tempo de espera continuar crescendo, descubra onde o trabalho se acumula. Escolha uma mudança pertinente nas assinaturas de dados, no processamento, nas configurações ou no ambiente de execução e compare os resultados antes e depois.
O tempo medido a partir do recebimento pela aplicação revela a espera dentro dela. Meça separadamente o atraso entre o evento original e seu recebimento pela aplicação. Depois de obter esses registros iniciais, use a tabela a seguir para ampliar as verificações.
| Etapa | O que registrar | O que ajuda a identificar |
|---|---|---|
| Rede e recebimento | Taxa real de recebimento, retransmissões e perdas, diferenças de chegada do mesmo evento | Limitações de rota, banda e configuração de recebimento |
| Aplicação | Número de eventos recebidos e de eventos com processamento concluído, tamanho da fila, idade do item mais antigo | Déficit sustentado de processamento e dados antigos acumulados |
| Tempo até decidir | p50, p95, p99 e máximo entre recebimento e fim da decisão | Trabalho pesado e atrasos durante picos |
| Envio e confirmação | Início do envio, aceitação RPC, status da assinatura da transação, erros de execução | Atrasos e falhas após o recebimento |
| Condições de comparação | Região, host, SDK e versão, assinatura de dados, commitment, período e quantidade de amostras | Diferenças aparentes causadas por condições distintas |
Preserve uma medição de referência e depois verifique uma mudança por vez, conforme os sintomas: escopo da assinatura, separação de processamento, configurações do cliente e posicionamento ou recursos. Se ampliar uma janela, confira também se aumentam o uso de memória e o acúmulo de trabalho. Se restringir uma assinatura, verifique se informações necessárias não foram perdidas.
O p99 do tempo total não é calculado simplesmente somando os p99 de cada etapa. Calcule-o a partir do tempo total de cada evento correspondente e use as medições por etapa para localizar as causas. Teste tanto durante picos reais de eventos quanto sob carga média.
A ERPC prepara a infraestrutura para que desenvolvedores aperfeiçoem sua lógica
Quando redes, servidores, entrega de dados e clientes são escolhidos separadamente, podem permanecer esperas entre eles mesmo que cada um tenha boas especificações. A ERPC reúne a entrega de dados da Solana e os ambientes de processamento em uma plataforma, reduzindo o trabalho que os desenvolvedores repetiriam ao escolher posicionamento e recursos desde o início.
As ofertas SUPER VPS e Premium VPS especificam configurações de alta frequência e alocação de recursos sem sobrealocação, enquanto Bare Metal oferece uma máquina física dedicada. A ERPC aproxima redes e servidores de seu ambiente de entrega e prepara CPU, memória, armazenamento e conectividade para processamento sustentado. As especificações concretas estão disponíveis por plano e região. [17][18]
| Obstáculo comum de desenvolvimento | Infraestrutura e informações disponíveis na ERPC | O que aperfeiçoar na aplicação |
|---|---|---|
| Distância que os nomes das cidades não revelam | Configurações regionais e de rede para escolher entrega e processamento juntos | Medir chegadas e variação sob suas condições de assinatura |
| Disputa por recursos e desempenho sustentado | SUPER VPS e Premium VPS de alta frequência sem sobrealocação e Bare Metal dedicado | Identificar trabalho pesado e processamento sequencial |
| Volume de dados e método de conexão | gRPC, Shreds, RPC e opções compartilhadas ou dedicadas adequadas à carga | Definir os eventos e campos necessários |
| Ajustes de recebimento e diagnóstico | Solana Stream SDK, exemplos de configuração, documentação de filtros e FAQ por erro | Verificar ajustes efetivos, filas, reconexão e recuperação |
A ERPC ajuda os desenvolvedores a avançar na seleção e no ajuste da infraestrutura, deixando mais tempo para desenvolver o que observar, quais informações usar para decidir e quando enviar. Com o serviço e o posicionamento adequados, alinhar o volume da assinatura de dados à capacidade de processamento transforma desempenho de infraestrutura em velocidade da aplicação.
Comece decidindo quais informações suas decisões realmente exigem. Receba-as cedo, processe-as sem espera desnecessária e verifique o resultado. A ERPC continuará oferecendo o ambiente e as informações que sustentam essa melhoria.
Recursos para implementação
- FAQ de gRPC da ERPC: https://erpc.global/pt/faq/grpc/general/
- Filtros de assinatura de dados e limites atuais de Shared: https://erpc.global/pt/doc/geyser-grpc/filter/
- Boas práticas de implementação de gRPC: https://erpc.global/pt/doc/geyser-grpc/best-practices/
- Solana Stream SDK: https://github.com/ValidatorsDAO/solana-stream
- ERPC VPS: https://erpc.global/pt/vps/
- ERPC Bare Metal: https://erpc.global/pt/baremetal/
- ERPC Dashboard: https://dashboard.erpc.global/
- Discord oficial de Validators DAO: https://discord.gg/C7ZQSrCkYR
Referências técnicas
- RIPE IPmap, visualização de rotas ineficientes: https://ipmap.ripe.net/
- AWS, largura de banda de rede das instâncias: https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/ec2-instance-network-bandwidth.html
- Linux Kernel, CPU Performance Scaling: https://docs.kernel.org/admin-guide/pm/cpufreq.html
- Node.js, evitar bloqueios no loop de eventos: https://nodejs.org/en/learn/asynchronous-work/dont-block-the-event-loop
- IETF RFC 9113, controle de fluxo HTTP/2: https://httpwg.org/specs/rfc9113.html#FlowControl
- gRPC, Flow Control: https://grpc.io/docs/guides/flow-control/
- ERPC, recebimento, slow readers e novas tentativas na FAQ de gRPC: https://erpc.global/pt/faq/grpc/general/
- Yellowstone gRPC, especificações de assinaturas e filtros: https://github.com/rpcpool/yellowstone-grpc
- ERPC, regras atuais dos filtros Shared: https://erpc.global/pt/doc/geyser-grpc/filter/
- Tokio, filas e backpressure: https://tokio.rs/tokio/tutorial/channels
- AWS CloudWatch, definições de percentis: https://docs.aws.amazon.com/AmazonCloudWatch/latest/monitoring/Statistics-definitions.html
- ERPC, Shreds UDP Forwarding: https://erpc.global/pt/doc/shredstream/udp-forwarding/
- Solana, Transaction Confirmation & Expiration: https://solana.com/developers/cookbook/transactions/confirmation
- Solana, sendTransaction: https://solana.com/docs/rpc/http/sendtransaction
- Solana, Stake-weighted Quality of Service: https://solana.com/docs/defi/stake-weighted-qos
- Solana, taxas de transação: https://solana.com/docs/core/fees
- ERPC, configurações e especificações de VPS: https://erpc.global/pt/vps/
- ERPC, configurações e especificações de Bare Metal: https://erpc.global/pt/baremetal/