








Deixe sua aplicação Solana mais rápida: revise o volume de dados gRPC, o processamento na recepção e os recursos de execução
A aplicação Solana que você está desenvolvendo pode funcionar mais rápido. A quantidade de dados recebidos, o processamento que vem depois e recursos como CPU e rede atuam em conjunto. Rever essa combinação pode ajudar a extrair mais desempenho do software que você já tem.
Você começou a desenvolver HFT na Solana, conectou-se ao Geyser gRPC e vê dados nos logs. Mesmo assim, as decisões não chegam tão rápido quanto esperava. As esperas entre o recebimento e uma decisão podem dar pistas sobre onde melhorar. Comece identificando o que é possível observar no código atual.
Na ERPC, as conversas e os comentários dos clientes nos dão oportunidades de revisar a distribuição de dados, as configurações de recebimento e o processamento das aplicações. Essas observações orientam melhorias na distribuição e na documentação. Este artigo explica os mecanismos e as etapas de investigação para que desenvolvedores que lidam pela primeira vez com fluxos rápidos e de alto volume possam explorar melhorias no próprio ambiente.
Comece com uma pequena verificação no código atual
Você pode consultar os termos técnicos e os comandos de diagnóstico conforme eles se tornarem úteis. Se tiver um agente de IA capaz de ler o código do projeto, experimente primeiro a solicitação curta abaixo. Acrescente onde a aplicação é executada e em quais situações ela parece lenta. Requisitos ainda não definidos e medições indisponíveis podem continuar assim enquanto você começa.
text
Quero descobrir se minha aplicação Solana tem espaço para responder mais rápido.
Primeiro, leia o código atual e identifique onde os dados são recebidos e onde termina a decisão que usa esses dados. Mantenha a assinatura sem alterações e proponha a menor mudança que permita medir a quantidade de eventos e o tempo decorrido nesse intervalo.
Nesta primeira tarefa, mostre os pontos de medição, a mudança proposta, o que ela permitiria descobrir e o que permaneceria sem medição. Se não houver acesso ao host, comece pelo que pode ser observado dentro da aplicação. Não exiba informações sigilosas, não altere a produção e não crie recursos pagos.
Quero descobrir se minha aplicação Solana tem espaço para responder mais rápido.
Primeiro, leia o código atual e identifique onde os dados são recebidos e onde termina a decisão que usa esses dados. Mantenha a assinatura sem alterações e proponha a menor mudança que permita medir a quantidade de eventos e o tempo decorrido nesse intervalo.
Nesta primeira tarefa, mostre os pontos de medição, a mudança proposta, o que ela permitiria descobrir e o que permaneceria sem medição. Se não houver acesso ao host, comece pelo que pode ser observado dentro da aplicação. Não exiba informações sigilosas, não altere a produção e não crie recursos pagos.O primeiro resultado útil é saber onde e o que medir no próprio código. Separar os intervalos observáveis dos que não foram medidos ajuda a escolher o que investigar depois. Mais adiante, o artigo traz um prompt mais detalhado para aprofundar o diagnóstico.
Por exemplo, um agente poderia responder: “O recebimento ocorre em
stream.ts, em onData; a decisão é concluída em strategy.ts, em onDecisionComplete. Proponho uma alteração que agregue as contagens de eventos recebidos e decisões concluídas, além do tempo decorrido nesse intervalo. O trecho anterior ao callback está fora do escopo desta proposta de medição.” Este exemplo usa nomes fictícios de arquivos e funções em TypeScript. Independentemente da linguagem de programação, confira se estes três pontos estão coerentes entre si: os locais no código real, os registros a adicionar e os limites desta medição. Se recebimentos e decisões não tiverem uma relação de um para um, peça ao agente que também proponha o mapeamento entre eles e a unidade de contagem.Acrescente uma perspectiva de fluxos à sua experiência com desenvolvimento web
Serviços gerenciados permitem que desenvolvedores criem muitas funcionalidades web sem pensar em cada componente do servidor. Essa experiência continua sendo uma base para trabalhar com fluxos da Solana. Acrescente a ela uma visão de quantos dados chegam continuamente e da velocidade com que a aplicação os processa.
Conectar um SDK ao Solana pode parecer igualmente simples. Mas assinar uma ampla variedade de transações ou atualizações de contas muda a carga de trabalho. As necessidades de largura de banda, CPU e memória dependem da assinatura, do tamanho das mensagens, da compressão, do processamento da aplicação e do tráfego naquele momento. Não existe um único número fixo de megabytes por segundo para “Solana”.
O ponto de partida é incluir a relação entre o trabalho que chega e a capacidade de processamento no projeto e nas medições.
Mesmo um fluxo ativo pode acumular uma fila
Primeiro, compare os dados que chegam no mesmo intervalo de um segundo usando quadrados do mesmo tamanho. Cada quadrado representa 1.000 mensagens; supondo 1 kB por mensagem, isso totaliza 1 MB. O exemplo de menor volume recebe 2 MB por segundo e o de maior volume, 12 MB por segundo, com a mesma capacidade de processamento na aplicação receptora em ambos os casos. Este é um modelo ilustrativo do volume da carga útil das mensagens em unidades decimais, sem compressão nem cabeçalhos de protocolo.
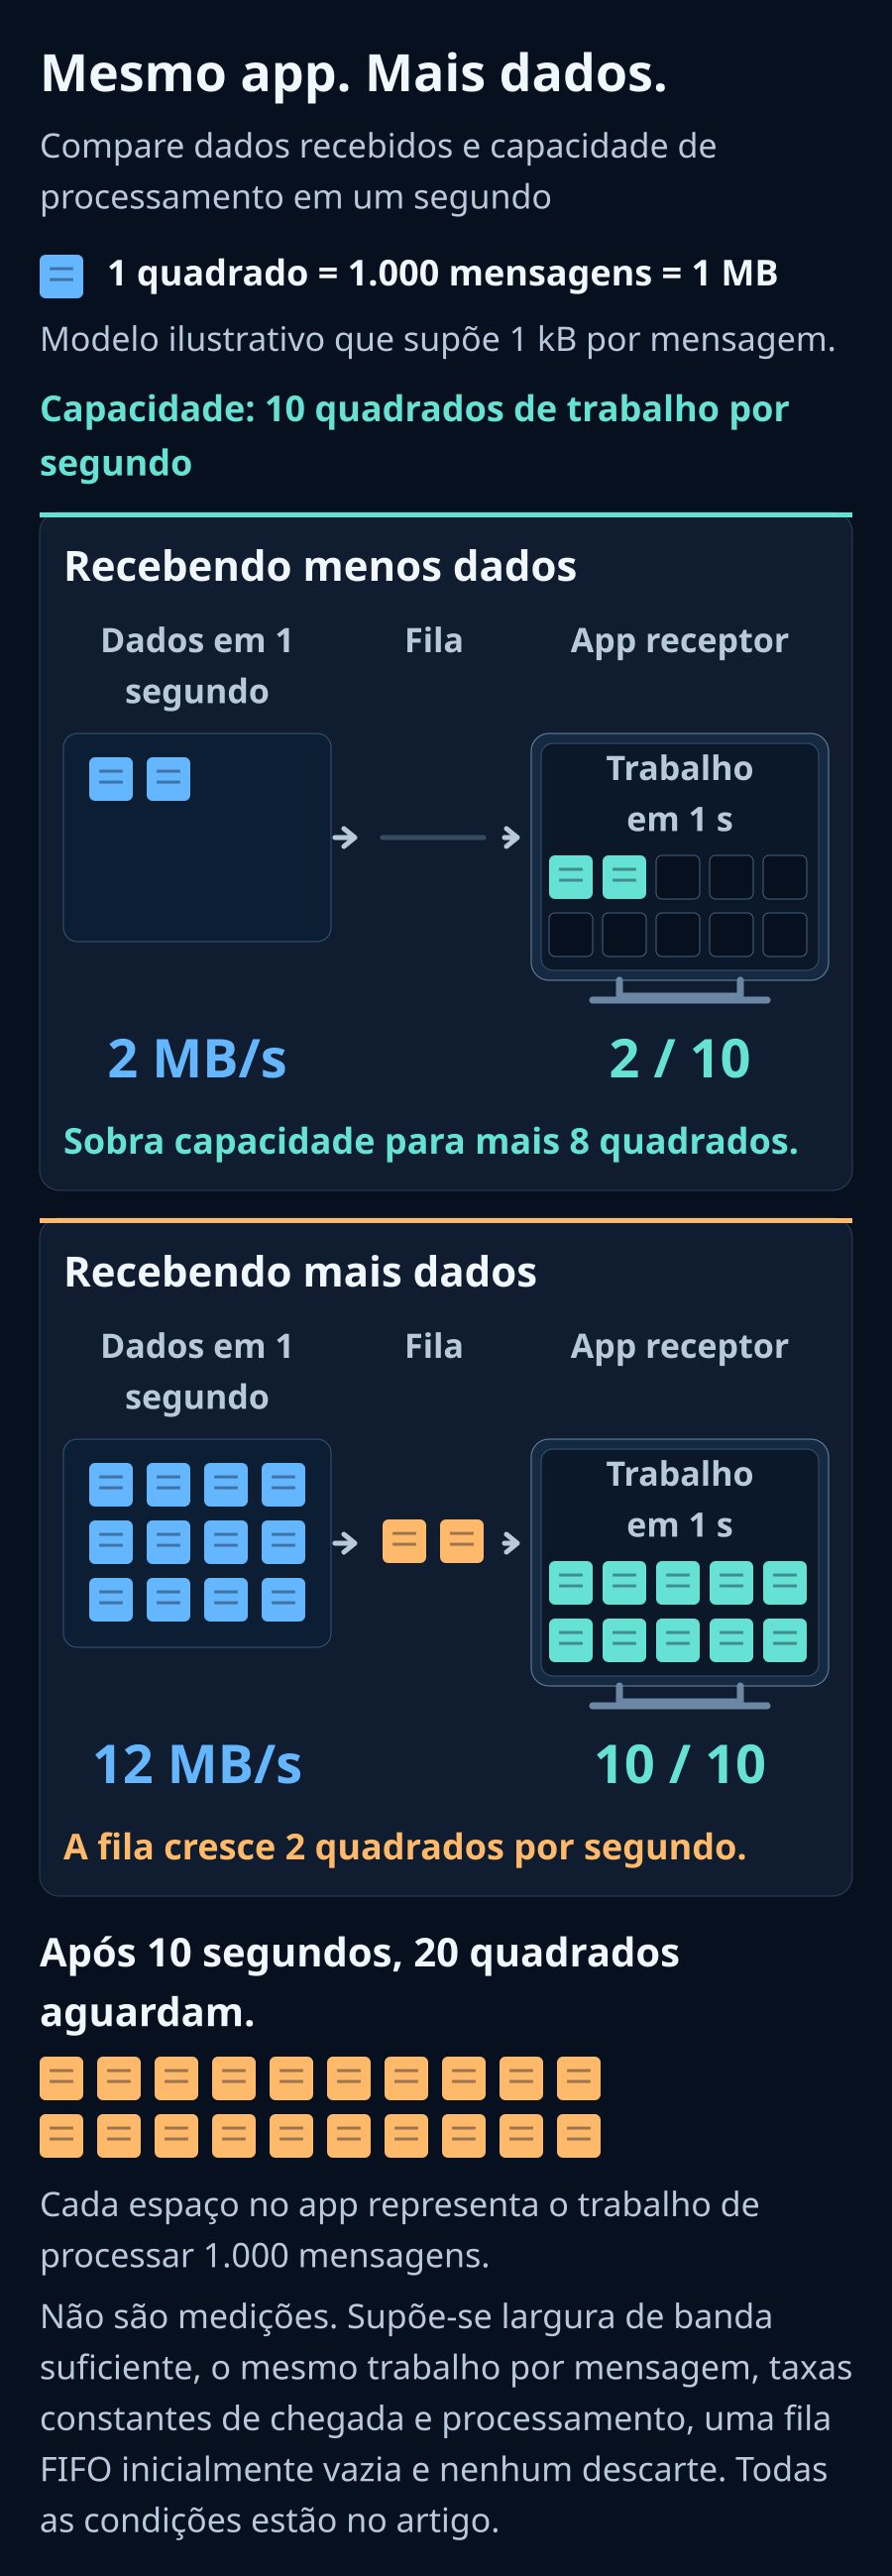
Considere um modelo ilustrativo: chegam 12.000 eventos por segundo, e um computador consegue processar 10.000 por segundo. Cada evento exige o mesmo trabalho, a fila começa vazia, os eventos são processados na ordem de chegada e nenhum é descartado.
A cada segundo, outros 2.000 eventos ficam sem processamento. Após dez segundos, há 20.000 eventos esperando. Um evento que entra na fila nesse momento espera aproximadamente dois segundos antes de começar a ser processado. Os logs continuam avançando enquanto a fila continua crescendo.
Essas são hipóteses explicativas, não medições do Solana ou da ERPC. O modelo pressupõe entrada e capacidade constantes. O tráfego real chega em rajadas, e o custo de processamento varia, portanto pode haver espera mesmo quando a capacidade média é suficiente.
O controle de fluxo do gRPC ajusta a transmissão ao que o receptor consegue aceitar. Quando o processamento fica para trás, a espera pode se estender além da fila da aplicação, chegando às bibliotecas de comunicação ou ao remetente. Uma conexão ativa ou uma gravação bem-sucedida em uma API de envio não comprova que os dados estejam atuais ao chegar.[1]
Escolha os dados necessários antes de eles atravessarem a rede
Se suas decisões precisam apenas de determinados programas ou contas, defina primeiro esses dados e aplique filtros de assinatura no servidor. O Yellowstone gRPC oferece filtros para transações e contas. Confira as combinações exatas e os recursos disponíveis nas especificações da API, do SDK e do serviço que você usa.[2]
Se ainda não souber o que filtrar, examine o código para identificar quais valores sua aplicação usa nas decisões e quais campos das notificações os fornecem. A partir dessa correspondência, elabore condições candidatas de assinatura e verifique se incluem os eventos necessários já conhecidos. Conferir tanto a redução de eventos quanto a preservação dos dados necessários oferece uma base sólida para a próxima comparação.
Receber tudo e descartar dados indesejados no cliente significa que o trabalho de transferência, descriptografia e decodificação até aquele ponto já ocorreu. Filtrar no remetente pode reduzir esse trabalho. No exemplo acima, limitar a entrada aos 2.000 eventos por segundo necessários deixa folga para a mesma capacidade de processamento de 10.000 eventos por segundo.
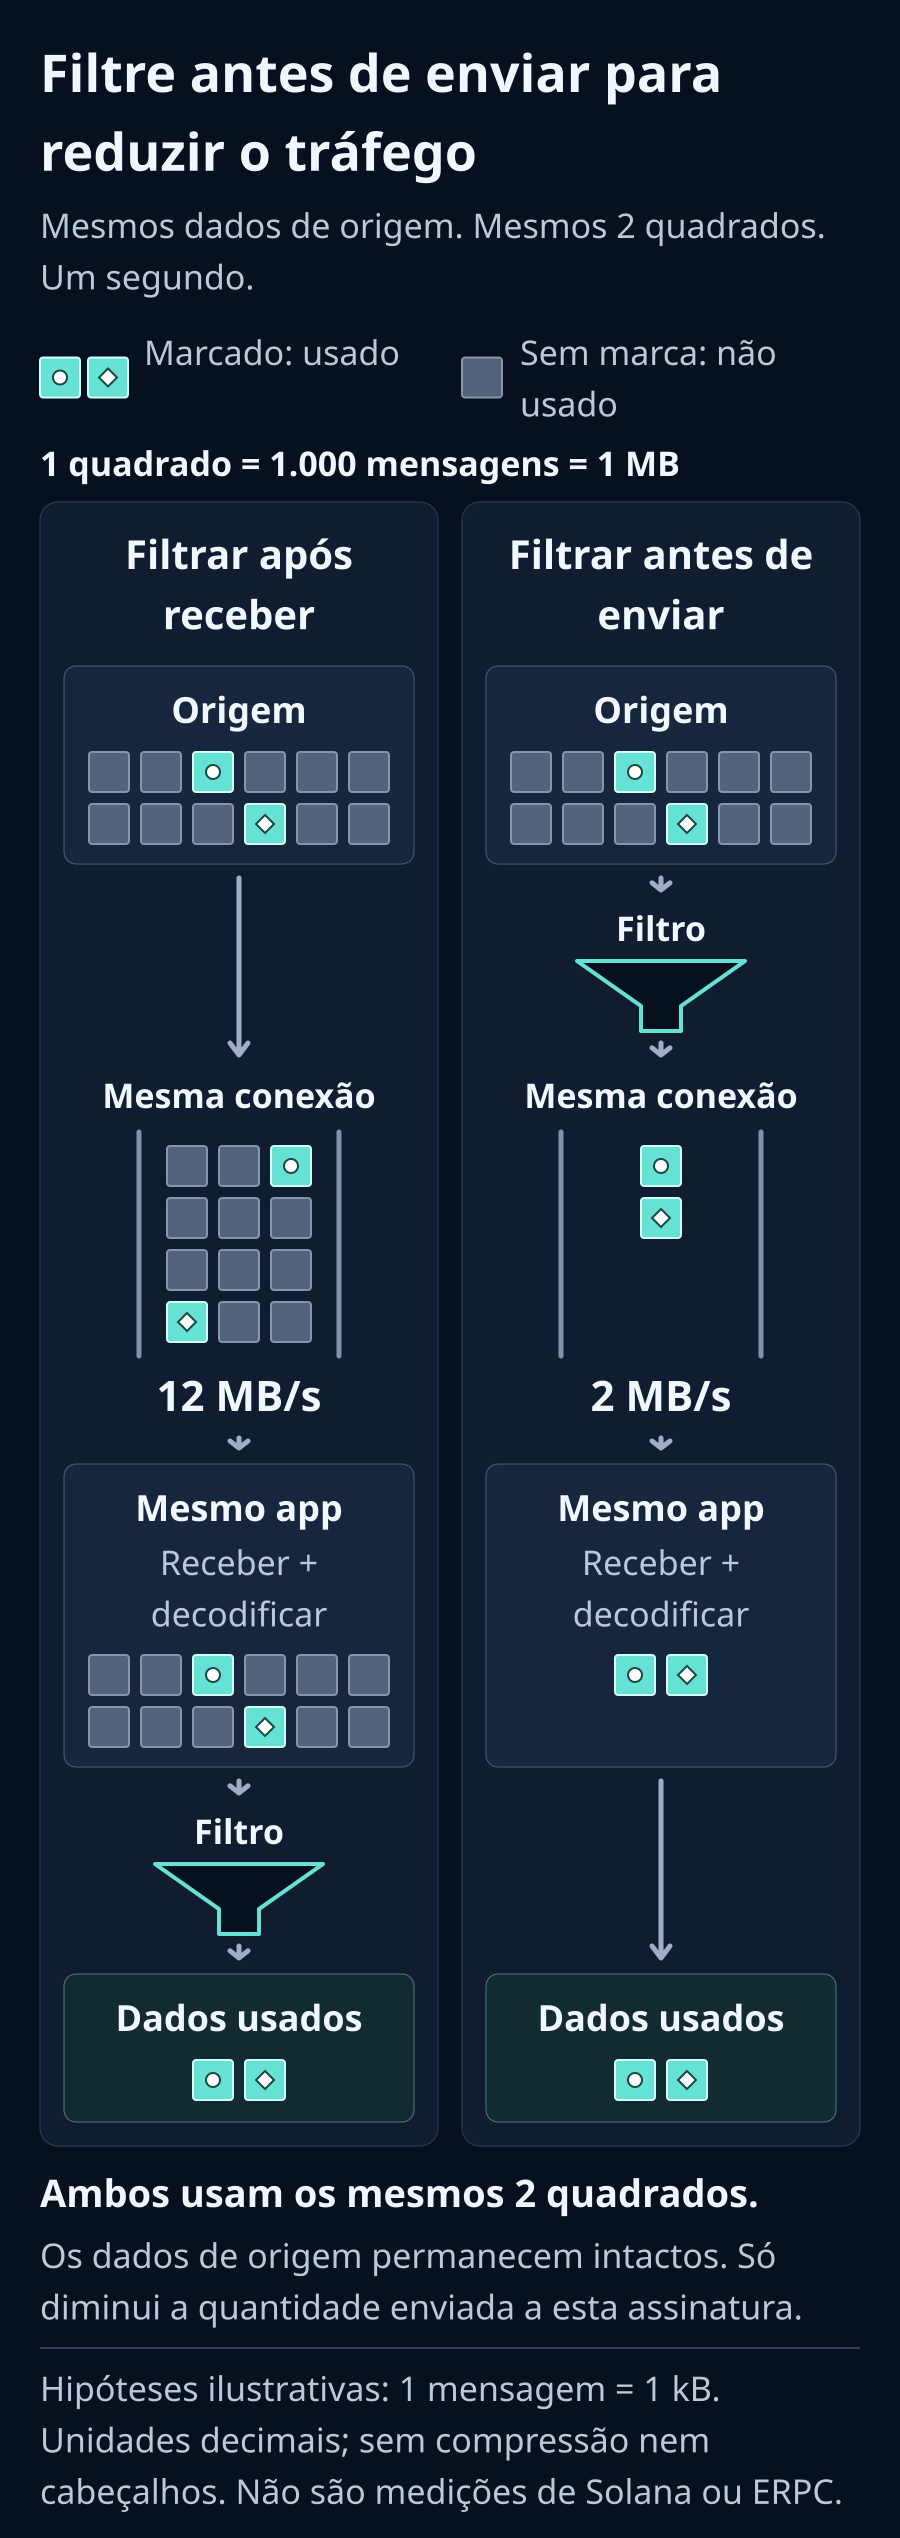
Pense no trânsito: o comprimento da estrada representa a distância de propagação, as faixas representam a largura de banda, o pedágio representa a capacidade de processamento na recepção e a fila de carros representa o trabalho em espera. Enviar apenas os carros necessários ao mesmo pedágio produz uma fila diferente de direcionar todos os carros da região para ele. Encurtar a estrada e reduzir o número de carros são melhorias distintas.
A comunicação também tem limites físicos. Transferir 100 MB a 1 Gbps leva, em teoria, pelo menos 0,8 segundo; a 10 Gbps, leva 0,08 segundo. Esses limites inferiores usam unidades decimais e não incluem distância, sobrecarga do protocolo, retransmissões ou trabalho em fila. Eles não significam que cada evento individual de um fluxo sofra um atraso de 0,8 segundo.
Mesmo quando um cálculo é mais rápido que uma troca pela rede, enviar dados desnecessários continua tendo um custo. Considere separadamente o tempo de propagação, quanto pode passar pelo enlace por unidade de tempo e quanto trabalho pode ser concluído após a chegada.
Algumas aplicações precisam de todos os dados, como índices completos, auditoria e pesquisa. Elas exigem capacidade de recebimento, processamento e armazenamento para essa carga. Receber todas as notificações individuais também é diferente de esperar por um bloco completo: dados agregados e reconstruídos como um bloco. Verifique se sua decisão depende desnecessariamente de dados sem relação com ela ou da conclusão da agregação.[2]
Revise o processamento na recepção e os recursos de execução
Rust pode ajudar a reduzir o custo de processamento. Para aproveitar essa velocidade, examine também o volume de entrada, a capacidade efetiva do enlace, o tempo de espera das gravações no banco de dados, os bloqueios e as partes sequenciais. Em um ambiente de execução assíncrono, atribuir o trabalho intensivo em CPU e o que bloqueia uma thread às partes adequadas do sistema também pode melhorar a aplicação.[3]
Mantenha o laço de recebimento curto e separe o trabalho pesado. Defina um limite para a fila e o que acontece quando ela fica cheia. Uma fila ilimitada pode esconder um atraso crescente como aumento no consumo de memória. Uma fila limitada também não resolve uma falta persistente de capacidade de processamento. Preserve a ordem e a completude necessárias ao escolher entre assinaturas mais seletivas, processamento mais eficiente, particionamento, paralelismo e recursos adicionais.
Comece medindo do recebimento até o término da decisão e depois investigue onde aparecem esperas. A tabela abaixo apresenta uma primeira forma de olhar para cada área. Os nomes detalhados das métricas e os comandos também estão no prompt de diagnóstico mais adiante, para que você use os itens que se tornarem relevantes.
| Recurso | O que verificar primeiro |
|---|---|
| CPU | O trabalho está concentrado em um único núcleo? Confira o uso total e por núcleo, além dos limites de CPU do ambiente de execução |
| Memória | Os eventos pendentes ou o uso de memória continuam crescendo? Observe a quantidade de dados na fila junto com o tempo de espera do evento mais antigo |
| Disco e banco de dados | O recebimento espera o armazenamento terminar? Confira as gravações no banco e as esperas de armazenamento. Se a aplicação não persiste dados, outras áreas oferecem um ponto de partida |
| Rede | O enlace e suas configurações estão adequados ao volume de entrada? Confira as taxas reais de transferência, o tempo de ida e volta e as retransmissões |
Ao investigar a comunicação com mais detalhe, as configurações das bibliotecas podem oferecer outras pistas. HTTP/2 tem janelas de controle de fluxo tanto por fluxo quanto por conexão, que controlam a quantidade de dados adicionais que a outra ponta pode enviar. Se essa margem for pequena em relação ao produto entre largura de banda e atraso, isto é, largura de banda multiplicada pelo tempo de ida e volta, a vazão pode atingir um limite mesmo quando o enlace tem folga. Nesse caso, examine a biblioteca e os intermediários, verificando o alcance da configuração e seu custo de memória ao ajustá-la.[4]
Meça a atualidade e a espera, além do recebimento
Para começar a verificar se há acúmulo de trabalho dentro da aplicação, mantenha a assinatura atual e registre, no mesmo período de observação, os eventos recebidos, os eventos concluídos, a quantidade de itens na fila e a espera do evento mais antigo. Se não souber onde medir, use o prompt abaixo para que um agente examine o código. Se não houver uma fila explícita, comece pelo tempo entre o recebimento e a conclusão da decisão e compare com uma versão de diagnóstico que remova o processamento custoso.
O pseudocódigo abaixo, independente de linguagem e SDK, mostra onde colocar as medições. Preserve a ordem de processamento e a concorrência atuais ao acrescentar instrumentação ao código real.
text
Quando os dados são recebidos:
  Aumentar em 1 o contador de eventos recebidos
  Registrar um instante monotônico de recebimento associado ao evento
  Encaminhar o evento ao processamento existente

Quando termina a decisão que usa o mesmo evento:
  Aumentar em 1 o contador de eventos concluídos
  Calcular e agregar o tempo decorrido desde o recebimento
Quando os dados são recebidos:
Aumentar em 1 o contador de eventos recebidos
Registrar um instante monotônico de recebimento associado ao evento
Encaminhar o evento ao processamento existente
Quando termina a decisão que usa o mesmo evento:
Aumentar em 1 o contador de eventos concluídos
Calcular e agregar o tempo decorrido desde o recebimentoSe o recebimento e as decisões não tiverem uma relação de um para um, defina primeiro essa correspondência e a unidade que será contada. Resumir as observações em um intervalo fixo permite comparar resultados sem acrescentar uma mensagem de log para cada evento.
Para aprofundar o diagnóstico, registre também os bytes recebidos, os bytes na fila, p50/p95/p99 do tempo de processamento, erros e reconexões. O p99 é o valor que 99% dos tempos de processamento medidos não ultrapassam. Identifique onde cada medição é feita. O tráfego da placa de rede, o tamanho Protobuf e o tamanho dos objetos decodificados são grandezas diferentes.
Use um relógio monotônico para o tempo decorrido no mesmo host, separando recebimento, entrada na fila, saída da fila e conclusão. Se a decodificação já tiver ocorrido quando o callback do SDK for executado, o intervalo anterior a esse callback não foi medido. Para comparar com um timestamp do remetente, verifique a sincronização dos relógios e onde esse timestamp é gerado. Não chame automaticamente a diferença de latência pura de rede.
Se a espera diminuir quando o processamento da aplicação for removido sem mudar a assinatura, isso é uma pista para investigar o efeito de adicionar esse processamento. O trabalho rápido após o callback, por si só, não prova que os dados estavam atuais no momento da chegada.
Você também pode comparar identificadores de eventos com um fluxo de referência que tenha a mesma assinatura e o mesmo commitment, isto é, o estágio de confirmação dos dados que você usa. Verifique se o fluxo de referência também não está acumulando atraso. Um salto entre números de slot, por si só, não comprova perda de dados nem corresponde a um número fixo de segundos: alguns slots não contêm eventos que atendam aos filtros, e slots podem ser pulados.[5]
O mtr ajuda a investigar a latência e os padrões de resposta de uma rota. Perda em apenas um salto intermediário pode indicar que um roteador limita suas respostas. Compare o comportamento até o destino com retransmissões TCP, taxas efetivas de transferência e outra rota. O mtr sozinho não comprova esgotamento de banda nem falha em um data center.[6]
Um prompt de diagnóstico para seu agente de IA
Entregue o texto abaixo a um agente que possa ler o código do seu projeto. Comece dizendo onde ele é executado e quando e de que forma parece lento. O agente pode primeiro investigar, a partir do código, a conexão, a assinatura e o processamento após o recebimento. Você não precisa colar chaves de API ou credenciais na conversa.
Se os eventos necessários ou o atraso aceitável ainda não estiverem definidos, diga que estão em aberto. Explique com suas próprias palavras quais informações deseja observar e quais decisões deseja tomar. Trate as medições indisponíveis como não medidas e comece pelo que pode examinar agora.
text
Investigue se meu cliente Solana Geyser gRPC tem espaço para responder mais rápido. Se houver atraso, acúmulo ou desconexões, isole suas causas e ajude a melhorá-los. Não deduza que dados atuais estão sendo processados apenas porque a conexão funciona ou porque os logs mostram eventos. Não decida de antemão se a causa está no cliente ou no provedor.

1. Estabeleça o objetivo: eventos necessários, atualidade aceitável, requisitos de ordem e perda de dados, filtros de assinatura, commitment, região do endpoint, versões reais da linguagem, do SDK e da biblioteca gRPC, e ambiente de execução. Examine primeiro o código, a configuração e os lockfiles disponíveis; pergunte apenas sobre as informações que faltarem. Mantenha explicitamente em aberto os requisitos ainda não decididos e investigue primeiro o estado atual. Não exiba segredos e oculte informações sensíveis nos logs compartilhados.

2. Meça do recebimento à conclusão. Priorize o recebimento, a conclusão e os tempos de espera, começando pelo que puder ser medido. Registre eventos/segundo, bytes/segundo, eventos concluídos/segundo, quantidade de itens e bytes na fila, espera do evento mais antigo, p50/p95/p99, erros, desconexões, reconexões e descartes. Se não houver uma fila explícita, informe isso e identifique os intervalos de processamento que podem ser observados. Informe os pontos de observação e os intervalos não medidos. Diferencie tráfego da placa de rede, bytes transmitidos, tamanho Protobuf e objetos decodificados. Use um relógio monotônico para o tempo local decorrido; verifique sincronização e origem dos timestamps externos. Não converta um salto entre slots diretamente em perda de dados ou duração fixa.

3. Separe as limitações de CPU, memória, disco e rede. Examine CPU por núcleo e thread, steal e limites de CPU, RSS/GC/swap/PSI, esperas de E/S, bytes, descartes e erros da placa de rede, retransmissões TCP e RTT. Algumas ferramentas Linux possíveis são mpstat, pidstat, vmstat, iostat, sar, ss -ti e /proc/pressure/. Se faltarem ferramentas ou permissões, informe isso e forneça os comandos mínimos necessários. Se o acesso ao host não estiver disponível, procure informações no console de gerenciamento ou na instrumentação da aplicação e marque como não medidas as grandezas indisponíveis. Nunca invente resultados.

4. Examine as duas janelas HTTP/2, de stream e de conexão, os buffers de recebimento TCP, proxies, VPNs e sidecars. Consulte a documentação oficial da versão instalada do SDK e considere o produto largura de banda-atraso. Verifique conversão JSON, logs por evento, chamadas síncronas ao banco de dados ou a APIs externas, trabalho bloqueante, locks, criação ilimitada de tarefas e filas ilimitadas dentro ou ao redor do laço de recebimento. Não trate Rust ou código assíncrono, por si sós, como solução.

5. Quando mtr ou uma ferramenta equivalente estiver disponível, faça uma medição finita até o host real do endpoint. Em sistemas compatíveis, considere: mtr --tcp --port <PORT> --report --report-cycles 30 <HOST>. Use a porta real em vez de presumir uma porta TLS padrão. Não classifique como falha a perda em apenas um salto intermediário; compare o comportamento no destino, retransmissões e outras rotas. Não use mtr como substituto de uma medição de banda.

6. Registre uma linha de base com a assinatura atual e altere uma variável por vez. Mantenha a mesma assinatura ao comparar um caminho mínimo de recebimento com a pipeline que inclui o processamento da aplicação. Trate as mudanças de filtros como uma comparação separada. Antes de restringir a assinatura, relacione os dados de entrada das decisões às notificações que os fornecem e verifique se os filtros candidatos incluem os eventos necessários já identificados. Projete filas limitadas e paralelismo que preservem a ordem e a completude exigidas e especifique o comportamento quando a fila ficar cheia. Não descarte silenciosamente dados necessários. Guarde todos os detalhes dos erros e os prazos para novas tentativas; não reconecte durante uma pausa imposta.

7. Relate separadamente fatos observados, possíveis causas, hipóteses não testadas, mudanças revisáveis e medições antes e depois. Estime CPU, RAM, banda, desempenho de armazenamento e localização com base na assinatura e nas medições, incluindo margem para picos. Não invente um requisito de hardware fixo e universal para Solana. Se necessário, proponha comparar máquinas ou data centers usando a mesma assinatura, SDK e commitment.

Se eu usar ERPC, leia a FAQ de gRPC atual e siga as instruções para o código de erro exato:
https://erpc.global/en/faq/grpc/general/
Se ERPC User MCP ou uma CLI estiver conectado, verifique as operações e permissões realmente disponíveis. Acesso à conta não implica acesso ao diagnóstico do host. Antes de criar um VPS pago, alterar um contrato, atualizar a produção ou reiniciá-la, apresente custo, objetivo e duração do teste e obtenha minha aprovação. Conclua primeiro o diagnóstico e as melhorias revisáveis.
Investigue se meu cliente Solana Geyser gRPC tem espaço para responder mais rápido. Se houver atraso, acúmulo ou desconexões, isole suas causas e ajude a melhorá-los. Não deduza que dados atuais estão sendo processados apenas porque a conexão funciona ou porque os logs mostram eventos. Não decida de antemão se a causa está no cliente ou no provedor.
1. Estabeleça o objetivo: eventos necessários, atualidade aceitável, requisitos de ordem e perda de dados, filtros de assinatura, commitment, região do endpoint, versões reais da linguagem, do SDK e da biblioteca gRPC, e ambiente de execução. Examine primeiro o código, a configuração e os lockfiles disponíveis; pergunte apenas sobre as informações que faltarem. Mantenha explicitamente em aberto os requisitos ainda não decididos e investigue primeiro o estado atual. Não exiba segredos e oculte informações sensíveis nos logs compartilhados.
2. Meça do recebimento à conclusão. Priorize o recebimento, a conclusão e os tempos de espera, começando pelo que puder ser medido. Registre eventos/segundo, bytes/segundo, eventos concluídos/segundo, quantidade de itens e bytes na fila, espera do evento mais antigo, p50/p95/p99, erros, desconexões, reconexões e descartes. Se não houver uma fila explícita, informe isso e identifique os intervalos de processamento que podem ser observados. Informe os pontos de observação e os intervalos não medidos. Diferencie tráfego da placa de rede, bytes transmitidos, tamanho Protobuf e objetos decodificados. Use um relógio monotônico para o tempo local decorrido; verifique sincronização e origem dos timestamps externos. Não converta um salto entre slots diretamente em perda de dados ou duração fixa.
3. Separe as limitações de CPU, memória, disco e rede. Examine CPU por núcleo e thread, steal e limites de CPU, RSS/GC/swap/PSI, esperas de E/S, bytes, descartes e erros da placa de rede, retransmissões TCP e RTT. Algumas ferramentas Linux possíveis são mpstat, pidstat, vmstat, iostat, sar, ss -ti e /proc/pressure/. Se faltarem ferramentas ou permissões, informe isso e forneça os comandos mínimos necessários. Se o acesso ao host não estiver disponível, procure informações no console de gerenciamento ou na instrumentação da aplicação e marque como não medidas as grandezas indisponíveis. Nunca invente resultados.
4. Examine as duas janelas HTTP/2, de stream e de conexão, os buffers de recebimento TCP, proxies, VPNs e sidecars. Consulte a documentação oficial da versão instalada do SDK e considere o produto largura de banda-atraso. Verifique conversão JSON, logs por evento, chamadas síncronas ao banco de dados ou a APIs externas, trabalho bloqueante, locks, criação ilimitada de tarefas e filas ilimitadas dentro ou ao redor do laço de recebimento. Não trate Rust ou código assíncrono, por si sós, como solução.
5. Quando mtr ou uma ferramenta equivalente estiver disponível, faça uma medição finita até o host real do endpoint. Em sistemas compatíveis, considere: mtr --tcp --port <PORT> --report --report-cycles 30 <HOST>. Use a porta real em vez de presumir uma porta TLS padrão. Não classifique como falha a perda em apenas um salto intermediário; compare o comportamento no destino, retransmissões e outras rotas. Não use mtr como substituto de uma medição de banda.
6. Registre uma linha de base com a assinatura atual e altere uma variável por vez. Mantenha a mesma assinatura ao comparar um caminho mínimo de recebimento com a pipeline que inclui o processamento da aplicação. Trate as mudanças de filtros como uma comparação separada. Antes de restringir a assinatura, relacione os dados de entrada das decisões às notificações que os fornecem e verifique se os filtros candidatos incluem os eventos necessários já identificados. Projete filas limitadas e paralelismo que preservem a ordem e a completude exigidas e especifique o comportamento quando a fila ficar cheia. Não descarte silenciosamente dados necessários. Guarde todos os detalhes dos erros e os prazos para novas tentativas; não reconecte durante uma pausa imposta.
7. Relate separadamente fatos observados, possíveis causas, hipóteses não testadas, mudanças revisáveis e medições antes e depois. Estime CPU, RAM, banda, desempenho de armazenamento e localização com base na assinatura e nas medições, incluindo margem para picos. Não invente um requisito de hardware fixo e universal para Solana. Se necessário, proponha comparar máquinas ou data centers usando a mesma assinatura, SDK e commitment.
Se eu usar ERPC, leia a FAQ de gRPC atual e siga as instruções para o código de erro exato:
https://erpc.global/en/faq/grpc/general/
Se ERPC User MCP ou uma CLI estiver conectado, verifique as operações e permissões realmente disponíveis. Acesso à conta não implica acesso ao diagnóstico do host. Antes de criar um VPS pago, alterar um contrato, atualizar a produção ou reiniciá-la, apresente custo, objetivo e duração do teste e obtenha minha aprovação. Conclua primeiro o diagnóstico e as melhorias revisáveis.Teste o mesmo código em um ambiente comparável
As medições podem revelar oportunidades de melhorar os recursos de CPU ou memória, ou o caminho de rede. Uma CPU mais potente, mais memória, dividir o trabalho ou escolher uma localização mais próxima da origem são opções possíveis. Relacionar essas escolhas ao volume de dados da aplicação e às observações torna mais claros tanto o motivo para experimentá-las quanto o efeito a verificar.
ERPC VPS é uma opção para executar clientes de streaming perto da infraestrutura Solana. A cobrança por hora permite comparar o mesmo código e a mesma assinatura com seu ambiente atual. Confira preços, regiões e disponibilidade no Dashboard no momento do uso. Também na ERPC, as necessidades de recursos dependem da assinatura e do processamento da aplicação.[7]
Compare o crescimento da fila, a atualidade na conclusão do processamento, p99 e erros, além da vazão de recebimento. Registre o período de medição e a carga da blockchain. Comparações simultâneas ou medições repetidas ajudam a evitar que mudanças no tráfego ao longo do tempo sejam confundidas com diferenças entre ambientes.
Para obter suporte, compartilhe as configurações de assinatura com informações sensíveis ocultas, versão do SDK, região, timestamps, mensagens de erro completas e as medições que tiver. Você pode indicar como não medidos os valores que ainda não obteve.
Cada nova observação facilita escolher a próxima mudança a experimentar. Preserve os dados de que precisa e verifique as melhorias passo a passo. Continuaremos aprimorando as informações e a infraestrutura que apoiam seu desenvolvimento.
Referências e links relacionados
- [1] gRPC Flow Control: https://grpc.io/docs/guides/flow-control/
- [2] Especificação de assinaturas do Yellowstone gRPC: https://github.com/rpcpool/yellowstone-grpc/blob/master/README.md
- [3] Tokio: CPU-bound tasks and blocking code: https://docs.rs/tokio/latest/tokio/index.html#cpu-bound-tasks-and-blocking-code
- [4] Controle de fluxo HTTP/2: https://www.rfc-editor.org/rfc/rfc9113.html#section-5.2
- [5] Terminologia Solana: https://solana.com/docs/references/terminology
- [6] Documentação oficial do mtr: https://github.com/traviscross/mtr
- [7] ERPC VPS: https://erpc.global/pt/vps/
- Linux PSI: https://docs.kernel.org/accounting/psi.html
- APIs de medição do Node.js: https://nodejs.org/api/perf_hooks.html
- ERPC gRPC FAQ: https://erpc.global/pt/faq/grpc/general/
- ERPC Web Dashboard: https://dashboard.erpc.global/pt/
- Discord oficial da Validators DAO: https://discord.gg/C7ZQSrCkYR


