Arquitetura de baixa latência para HFT na Solana
Os dados chegam, mas os preços que sua aplicação usa para decidir continuam desatualizados. Em uma aplicação de HFT na Solana, é preciso examinar tanto o tempo de cálculo quanto o tempo que os dados recebidos esperam antes de participar de uma decisão. Atualizações anteriores podem estar aguardando processamento, a gravação de um registro pode não ter terminado ou a atualização de outro mercado pode estar mantendo um bloqueio. A organização do código altera essas esperas.
Este artigo usa cinco padrões para mostrar onde os dados esperam e qual trabalho pode avançar quando o projeto muda. Você também pode começar pelo sintoma que corresponde à sua aplicação e ir diretamente à seção relevante.
| O que acontece na aplicação | Qual projeto examinar |
|---|---|
| Quanto mais tempo a aplicação funciona, mais dados não processados se acumulam | 1. Taxa de chegada, taxa de processamento e limites de espera |
| O próximo preço não pode ser processado enquanto um registro é salvo | 2. Separação do trabalho necessário à decisão e dos registros analíticos |
| Uma atualização do mercado A faz uma atualização do mercado B esperar | 3. Divisão dos bloqueios que protegem estados independentes |
| A mesma preparação se repete a cada chegada | 4. Preparação antecipada e reutilização das partes que não mudam |
| As decisões usam valores antigos mesmo após a conexão voltar | 5. Distinção entre recuperar a conexão e recuperar o estado usado nas decisões |
Cada seção termina com instruções que você pode copiar para aplicar aquela melhoria à sua aplicação. Entregue-as a um agente de IA que possa ler o código do projeto.
As quantidades, os preços, os números de operações e as durações dos diagramas são modelos ilustrativos. Eles não representam desempenho medido nem resultados de negociação.
Toque ou clique num diagrama para abrir a imagem no tamanho original.
1. Compare as chegadas com a capacidade de processamento e limite as esperas
Considere uma aplicação que recebe seis eventos e consegue processar dois a cada intervalo de mesma duração. Ao fim do primeiro intervalo, quatro eventos continuam sem processamento. Uma fila é o lugar onde os dados aguardam para ser processados.
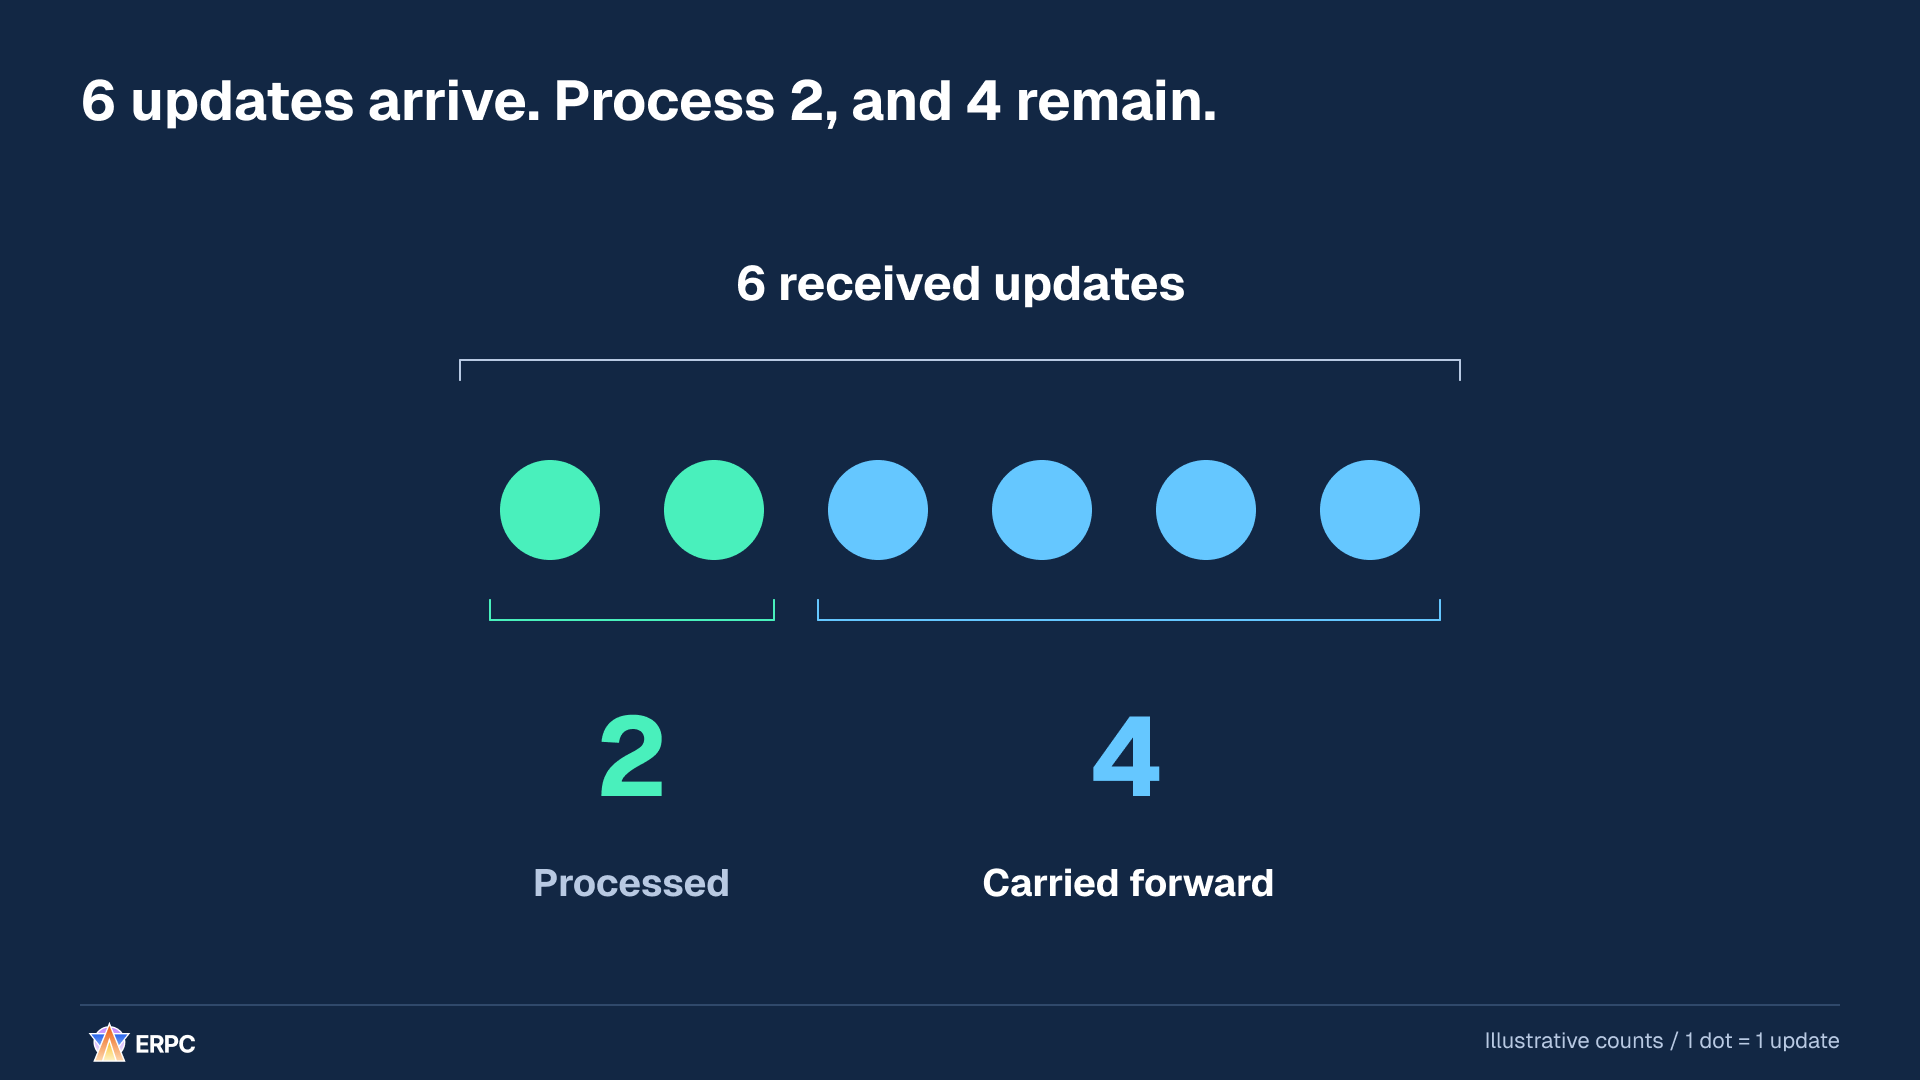
O processamento avança, mas quatro eventos ainda não foram usados nas decisões.
Agora aplique a mesma proporção a 60.000 eventos recebidos. Processar 20.000 deixa 40.000 aguardando. À direita do diagrama, cada ponto representa 100 eventos e cada grupo de 100 pontos representa 10.000 eventos. Dois grupos foram processados e quatro continuam esperando.
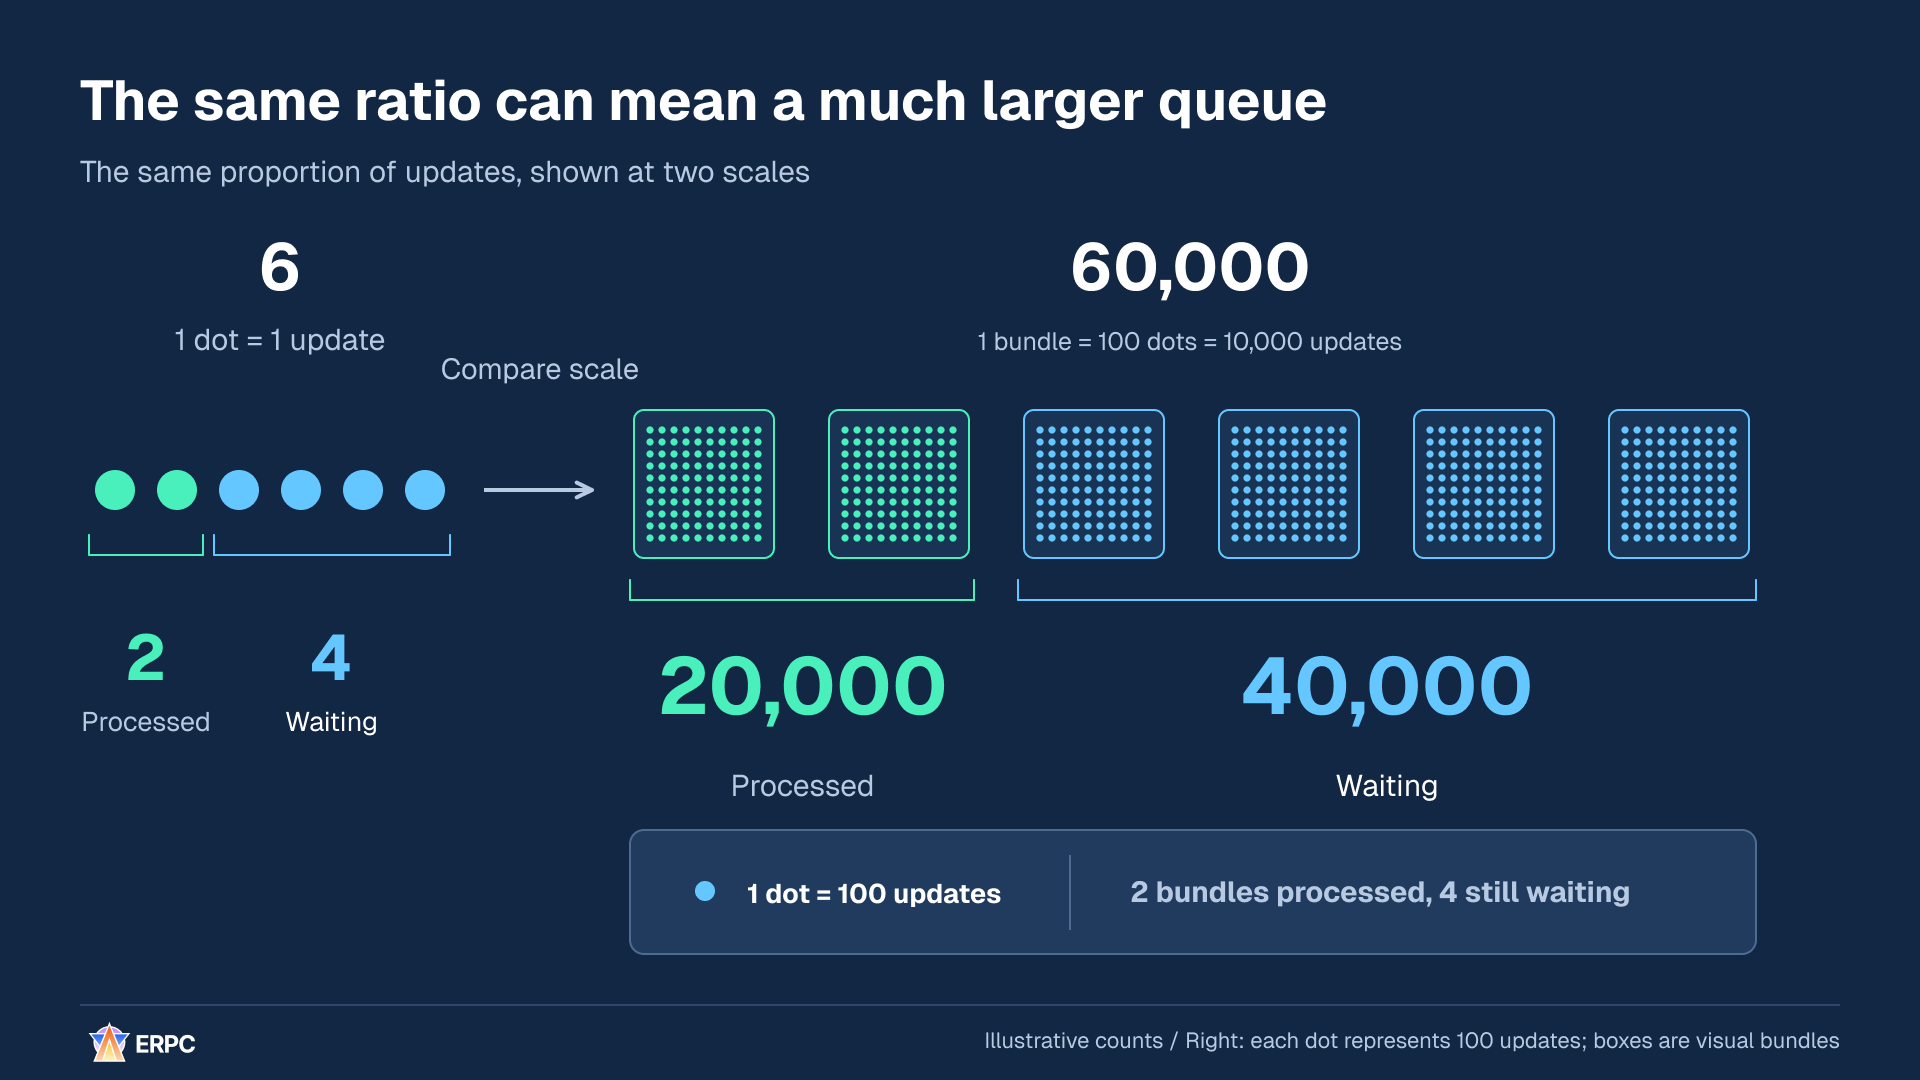
Os grupos à direita servem para mostrar o volume. Eles não representam lotes de processamento da aplicação.
O próximo intervalo começa com 40.000 eventos já pendentes. Chegam mais 60.000 e são processados 20.000, deixando 80.000. O intervalo seguinte termina com 120.000. Os preços recém-recebidos precisam esperar atrás do trabalho que já está na fila.
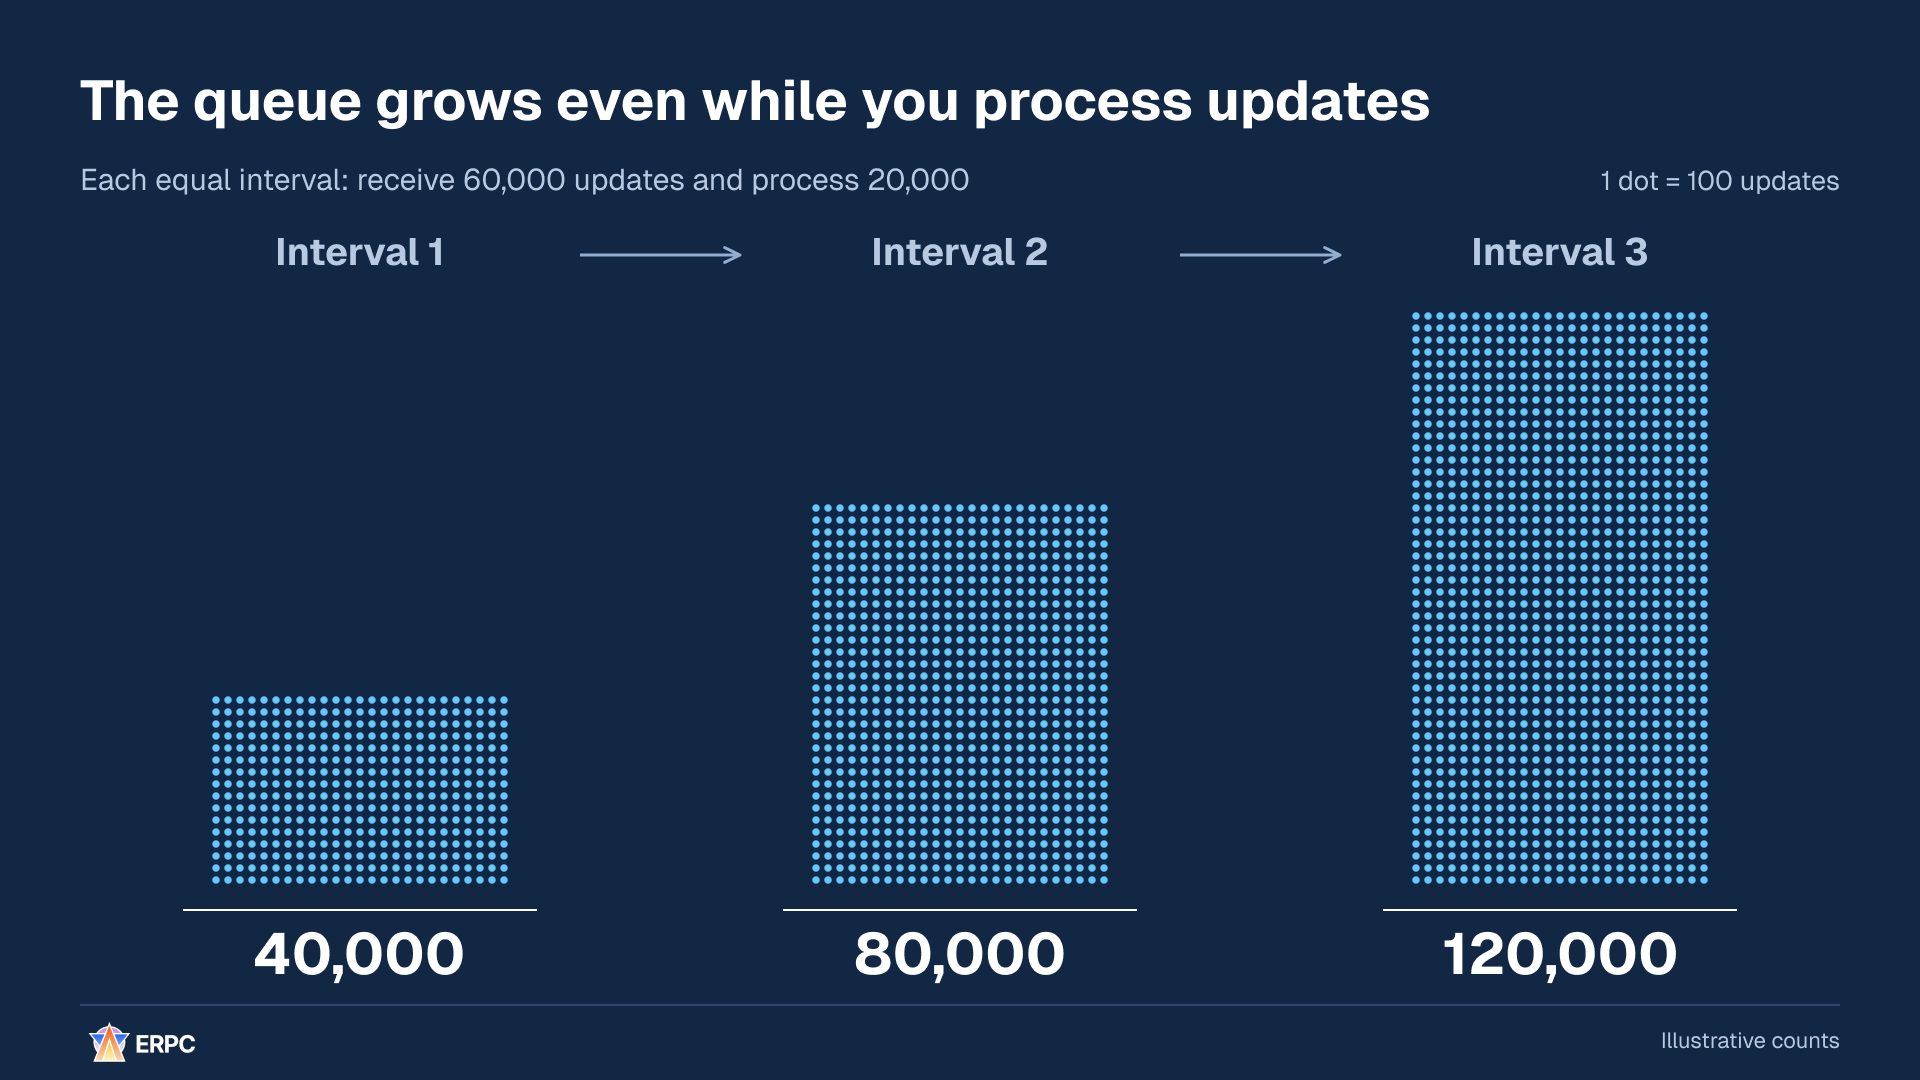
Quando as chegadas continuam superando a capacidade de processamento, a quantidade pendente continua aumentando.
Uma fila ajuda a absorver picos: períodos curtos em que as chegadas se concentram. Aumentar sua capacidade não resolve um déficit persistente de processamento como o deste exemplo. Além do número de itens e bytes mantidos, observe há quanto tempo o item mais antigo espera e defina um limite aceitável. Se os valores deixarem de atender ao requisito de atualidade, pause novas decisões de negociação que dependam deles, mesmo que nenhuma atualização tenha sido perdida.
O que deve acontecer quando esse limite for atingido? No próximo diagrama, as oito posições disponíveis estão ocupadas quando chegam mais duas atualizações. Se elas não puderem ser mantidas e forem necessárias para uma decisão, a aplicação não poderá mais atualizar corretamente seus valores armazenados. Pause novas decisões de negociação que dependam desses valores e retome depois de recuperar as atualizações necessárias.
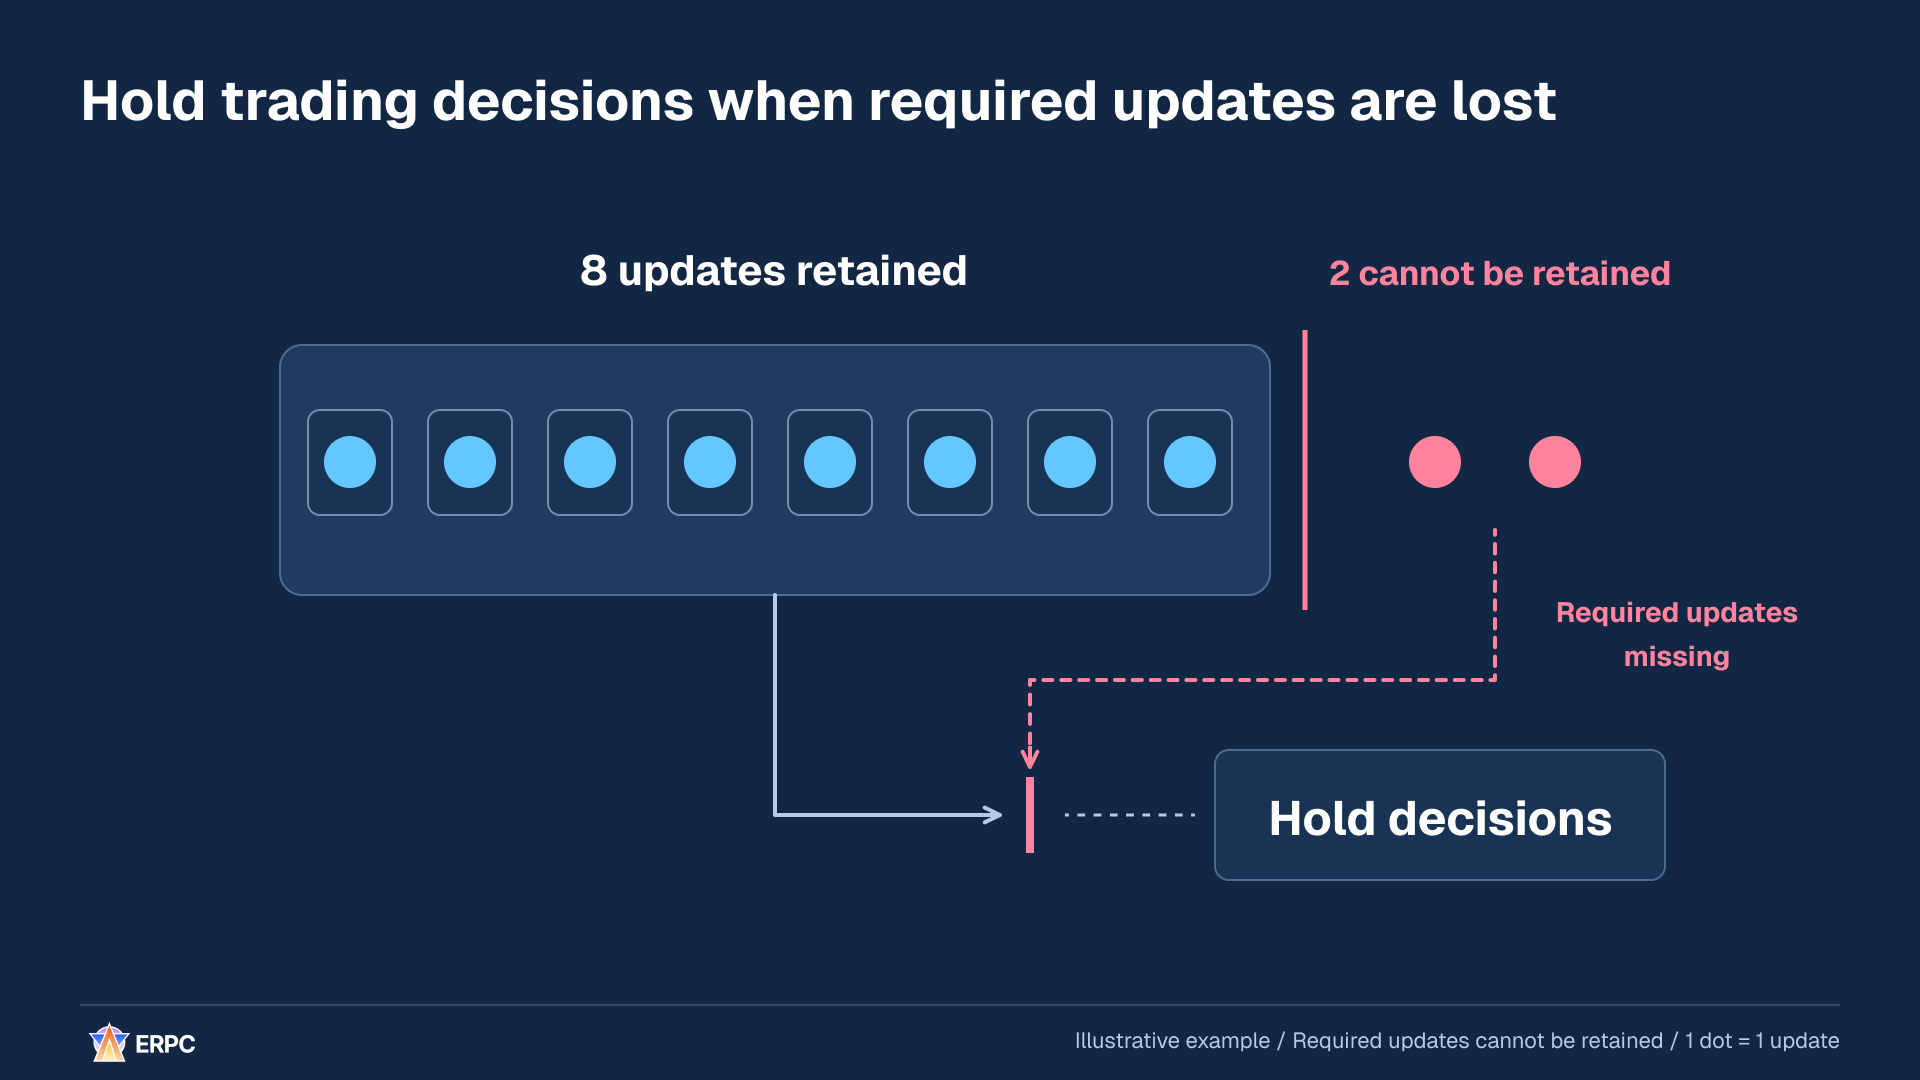
O projeto de uma fila também deve definir o que acontece depois que seu limite é atingido.
Examine se é possível reduzir o trabalho ou ampliar a capacidade de processamento. Se um consumidor precisar apenas do estado completo mais recente da mesma entidade, talvez seja possível consolidar valores intermediários no último valor. Porém, em um processo que acumula diferenças ou precisa de eventos intermediários, omitir atualizações muda o resultado.
Pausar a recepção também pode transferir a espera para a origem. Considere em conjunto o controle de fluxo do gRPC, que regula o ritmo de envio e recepção, os filtros no servidor que restringem os dados recebidos pela subscrição e a capacidade real de processamento da aplicação.[3][4]
Para melhorar a capacidade da fila de recepção e a atualidade dos dados da sua aplicação, copie estas instruções.
text
Melhore o tratamento de dados recebidos por esta aplicação quando o processamento fica para trás e os dados usados nas decisões se tornam desatualizados.

Leia o README, as instruções de desenvolvimento, as dependências e o código de recepção → fila → atualização do estado → decisão. Trabalhe com a linguagem, o ambiente de execução e o SDK existentes. Determine se as atualizações contêm um estado completo ou deltas, a ordem necessária de aplicação e o requisito de atualidade dos dados.

1. Salve entradas reproduzíveis sem informações confidenciais e registre os valores iniciais. Examine também a espera antes da entrada na fila. Meça, no mesmo intervalo, as quantidades de itens e bytes que entram e saem, o trabalho na fila, a idade do item mais antigo em espera e o trabalho em andamento.
2. Defina e implemente limites de itens, bytes, tempo de espera e concorrência, com uma justificativa para cada um. Explicite as premissas quando os requisitos forem desconhecidos. Verifique se a recepção ou o processamento desnecessários podem ser reduzidos e se a capacidade de processamento é suficiente. Não trate apenas uma fila maior como solução para um déficit persistente de processamento.
3. Defina o que acontece quando a fila está cheia. Se não for possível manter as atualizações necessárias, ou se os dados deixarem de atender à atualidade exigida mesmo sem atualizações ausentes, pause novas decisões de negociação que dependam desses valores. Continue a atualização e a recuperação do estado e verifique as condições de retomada.
4. Ao agrupar valores intermediários, estabeleça que o estado completo mais recente da mesma entidade basta para preservar o resultado. Não descarte silenciosamente deltas ou eventos necessários. Se pausar a recepção, verifique o controle de fluxo do provedor e para onde a espera se desloca.
5. Reproduza entradas normais, rajadas, sobrecarga persistente e recuperação de uma fila cheia em condições equivalentes. Compare as taxas de chegada e processamento, a idade do item mais antigo, p50/p95/p99 da recepção à conclusão da decisão, CPU e memória, e atualizações ausentes ou descartadas. Confira o estado aplicado e as decisões contra os resultados esperados. Use um relógio monotônico para medir durações dentro de um host e indique os limites da medição.

Respeite as aprovações, permissões e procedimentos de desenvolvimento existentes. Estas instruções, por si só, não concedem permissão adicional para alterar produção, contratar serviços pagos ou realizar negociações reais. Não exponha chaves privadas, credenciais ou dados de clientes.

Informe as mudanças, as condições de comparação, as medições antes e depois, as verificações de correção e as limitações restantes. Marque como não medidos os valores que não puderem ser medidos.
Melhore o tratamento de dados recebidos por esta aplicação quando o processamento fica para trás e os dados usados nas decisões se tornam desatualizados.
Leia o README, as instruções de desenvolvimento, as dependências e o código de recepção → fila → atualização do estado → decisão. Trabalhe com a linguagem, o ambiente de execução e o SDK existentes. Determine se as atualizações contêm um estado completo ou deltas, a ordem necessária de aplicação e o requisito de atualidade dos dados.
1. Salve entradas reproduzíveis sem informações confidenciais e registre os valores iniciais. Examine também a espera antes da entrada na fila. Meça, no mesmo intervalo, as quantidades de itens e bytes que entram e saem, o trabalho na fila, a idade do item mais antigo em espera e o trabalho em andamento.
2. Defina e implemente limites de itens, bytes, tempo de espera e concorrência, com uma justificativa para cada um. Explicite as premissas quando os requisitos forem desconhecidos. Verifique se a recepção ou o processamento desnecessários podem ser reduzidos e se a capacidade de processamento é suficiente. Não trate apenas uma fila maior como solução para um déficit persistente de processamento.
3. Defina o que acontece quando a fila está cheia. Se não for possível manter as atualizações necessárias, ou se os dados deixarem de atender à atualidade exigida mesmo sem atualizações ausentes, pause novas decisões de negociação que dependam desses valores. Continue a atualização e a recuperação do estado e verifique as condições de retomada.
4. Ao agrupar valores intermediários, estabeleça que o estado completo mais recente da mesma entidade basta para preservar o resultado. Não descarte silenciosamente deltas ou eventos necessários. Se pausar a recepção, verifique o controle de fluxo do provedor e para onde a espera se desloca.
5. Reproduza entradas normais, rajadas, sobrecarga persistente e recuperação de uma fila cheia em condições equivalentes. Compare as taxas de chegada e processamento, a idade do item mais antigo, p50/p95/p99 da recepção à conclusão da decisão, CPU e memória, e atualizações ausentes ou descartadas. Confira o estado aplicado e as decisões contra os resultados esperados. Use um relógio monotônico para medir durações dentro de um host e indique os limites da medição.
Respeite as aprovações, permissões e procedimentos de desenvolvimento existentes. Estas instruções, por si só, não concedem permissão adicional para alterar produção, contratar serviços pagos ou realizar negociações reais. Não exponha chaves privadas, credenciais ou dados de clientes.
Informe as mudanças, as condições de comparação, as medições antes e depois, as verificações de correção e as limitações restantes. Marque como não medidos os valores que não puderem ser medidos.2. Processe o próximo preço sem esperar pela gravação de um registro
Considere um preço de mercado que muda de 100 para 101. A aplicação já aplicou 100, concluiu sua decisão e está salvando um registro analítico. Se o laço que trata os dados recebidos esperar essa gravação terminar, ele não poderá aplicar 101 mesmo quando a atualização chegar. O preço armazenado continua sendo 100.
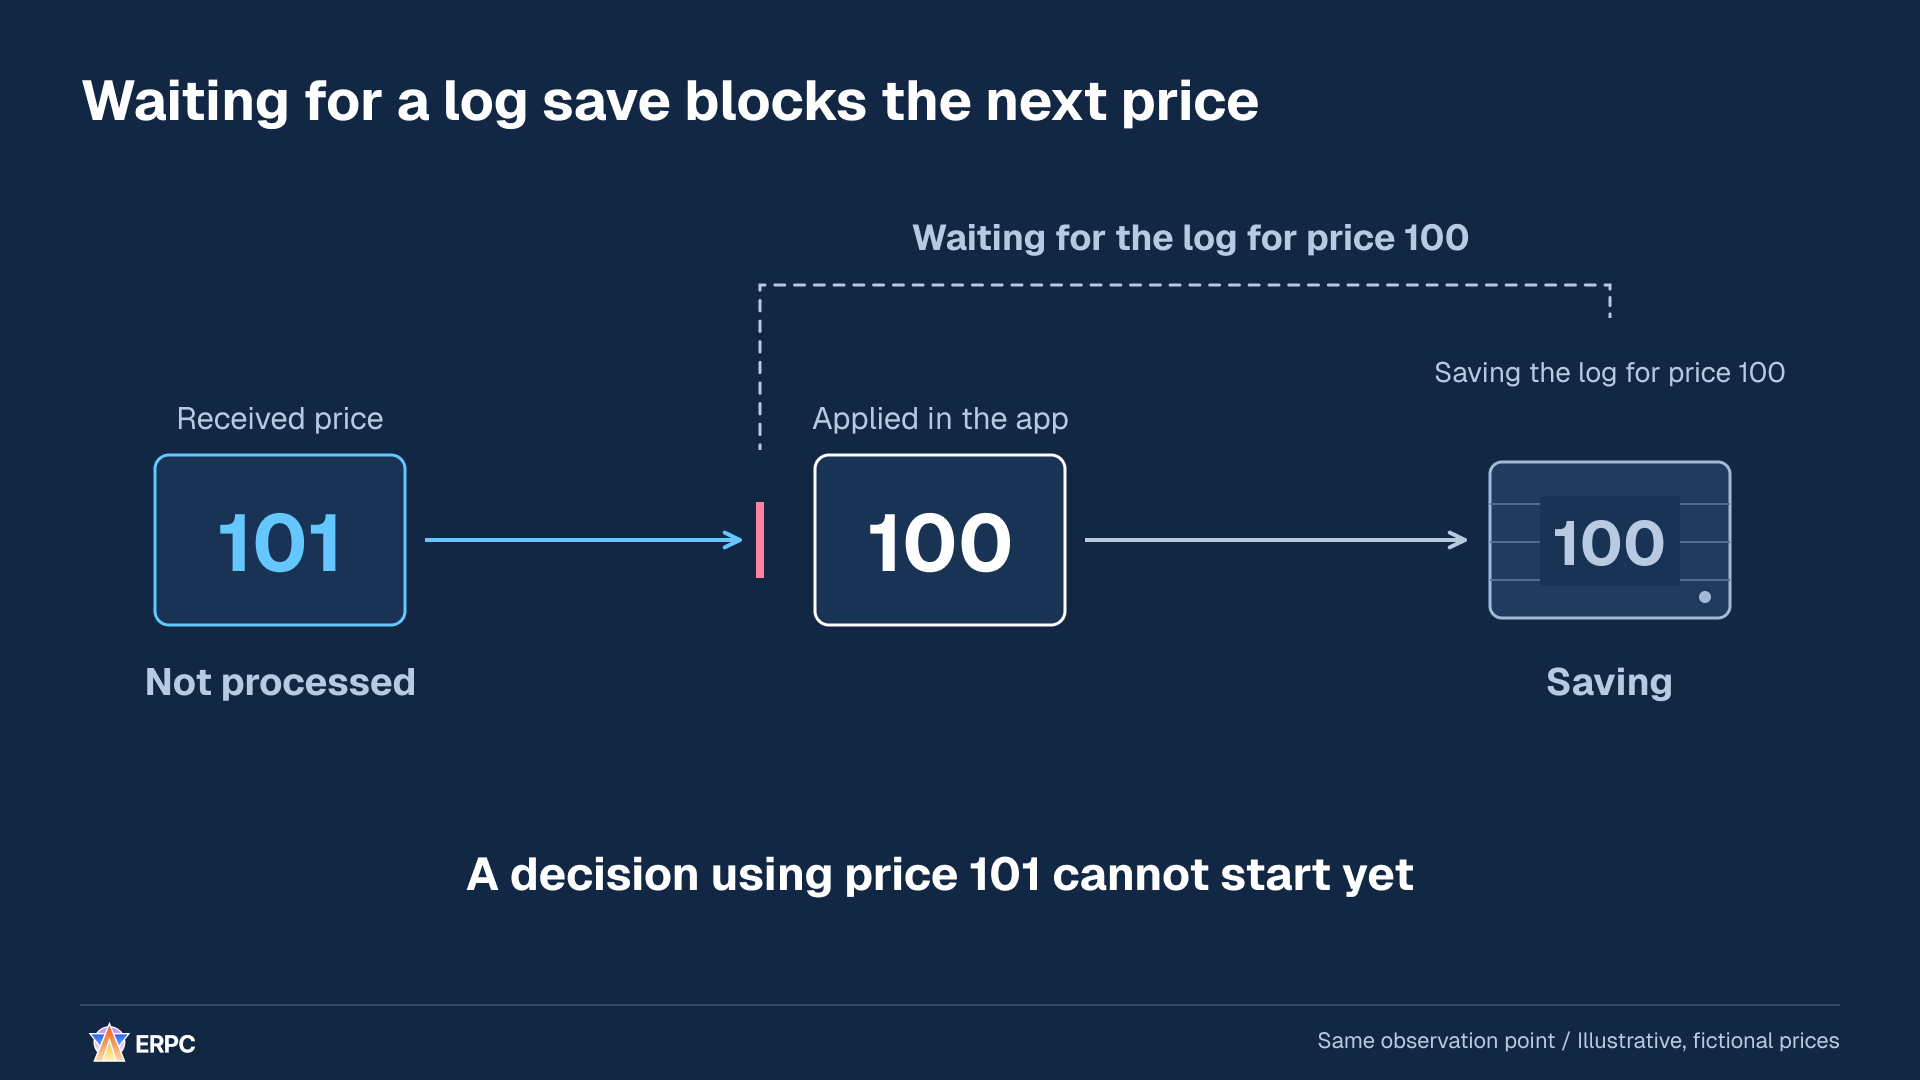
O processamento de 101 não pode começar porque aguarda o registro de 100.
Agora entregue o registro analítico a uma fila auxiliar com capacidade disponível e deixe uma operação separada salvá-lo. O laço receptor pode voltar à próxima entrada assim que a entrega terminar. Ele pode aplicar 101 e avançar para uma decisão enquanto a gravação de 100 continua.
A comparação a seguir mantém iguais a duração da gravação de 100, o momento de chegada de 101 e o tempo necessário para processar 101. O que muda é se avançar para a próxima entrada depende do término da gravação.
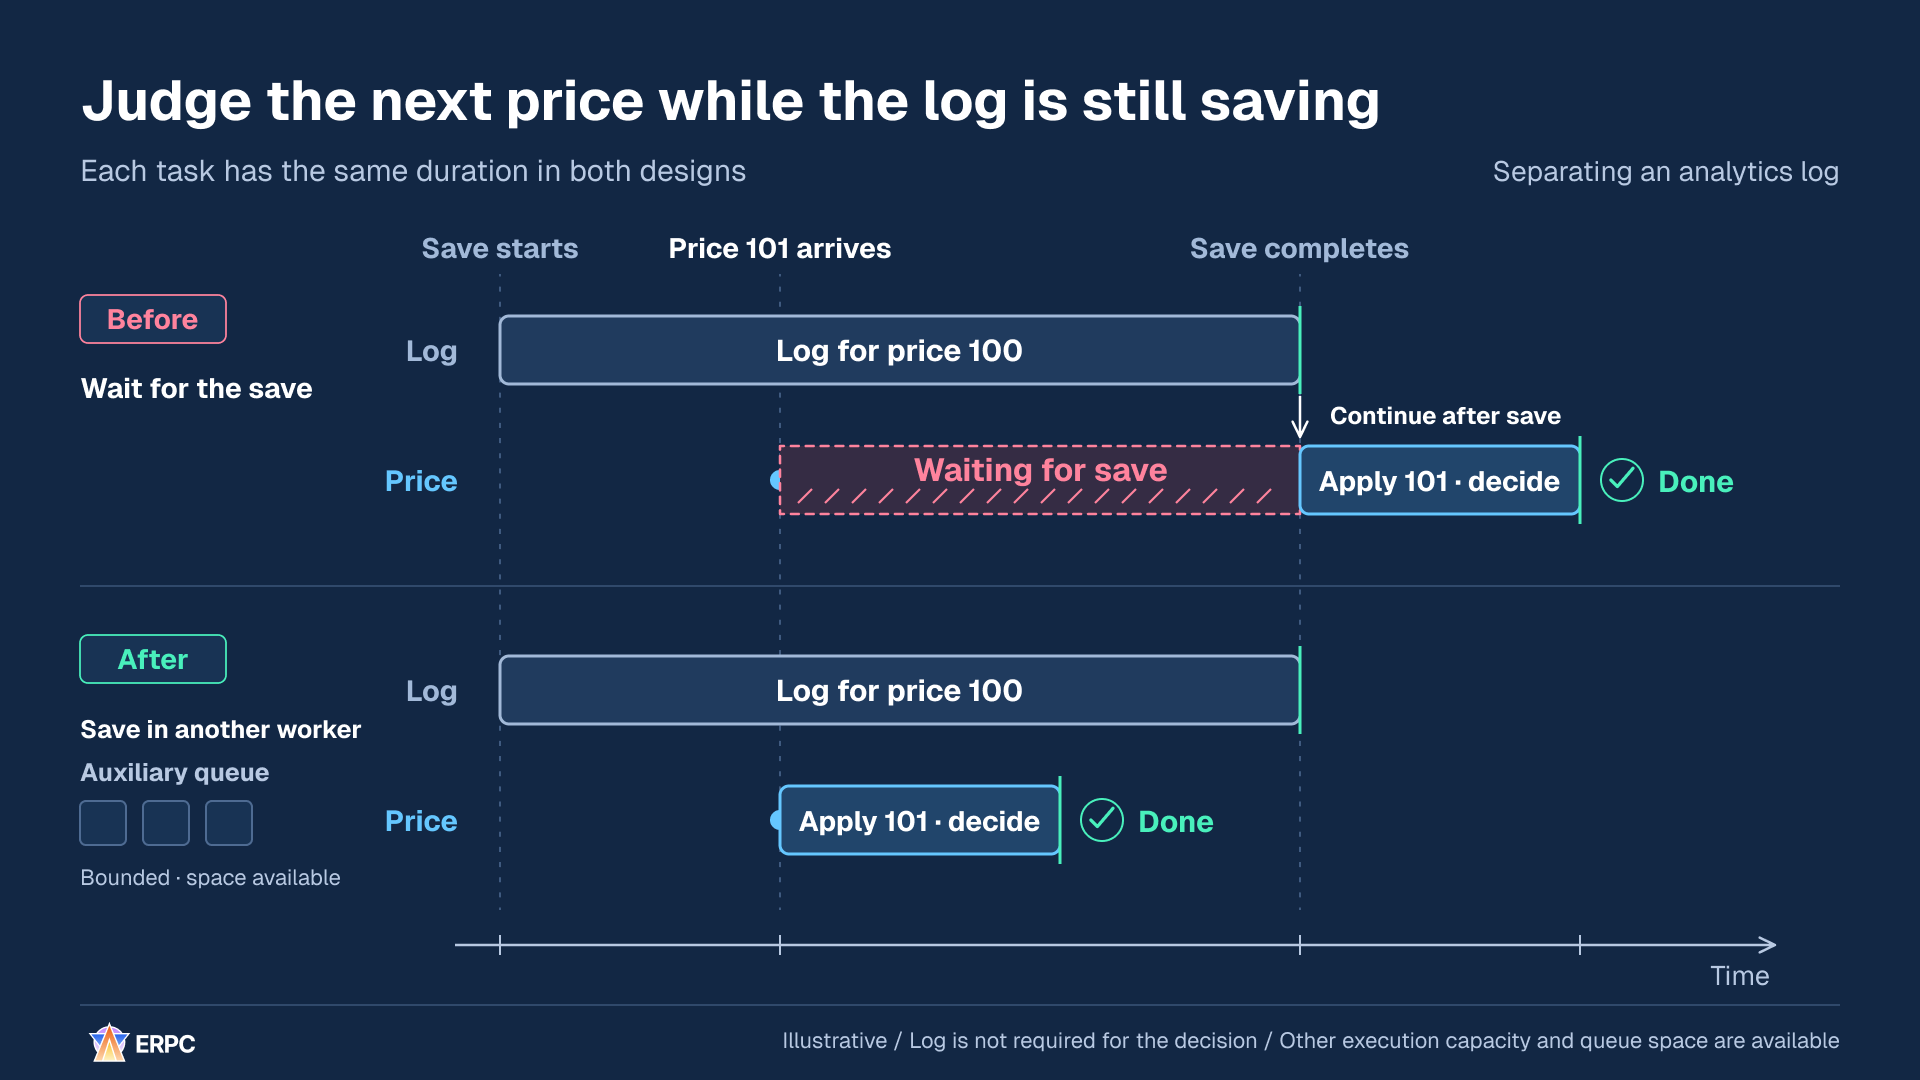
Mesmo sem encurtar o trabalho de 101 em si, é possível reduzir a espera antes de ele começar.
O caminho de processamento necessário desde a recepção, passando pela decisão, até o envio é chamado de hot path. Neste exemplo, o registro analítico que não precisa atrasar a decisão é retirado desse caminho. Verificações de saldo, verificações dos limites de risco e gravações que precisam terminar para preservar a correção continuam nas posições exigidas pelos requisitos.
O trabalho de gravação continua existindo, portanto a fila auxiliar também precisa de limites de capacidade e espera. Uma tarefa separada não necessariamente executa em uma CPU separada. Operações longas de cálculo ou bloqueio no Tokio e operações síncronas longas no event loop do Node.js podem impedir o avanço de outros trabalhos. Ao mover trabalho, verifique onde ele realmente será executado.[1][2]
Para separar a gravação de registros analíticos do caminho de decisão, copie estas instruções.
text
Melhore esta aplicação quando esperar pela gravação de registros analíticos impede aplicar a próxima atualização ou usá-la em uma decisão.

Leia o README, as instruções de desenvolvimento, as dependências e o laço receptor. Trabalhe com a linguagem, o ambiente de execução e a biblioteca de armazenamento existentes. Localize as esperas pela conclusão das gravações e identifique as threads, tarefas ou event loops em que o trabalho realmente é executado.

1. Prepare entradas reproduzíveis sem informações confidenciais. Registre recepção, aplicação do estado, início e conclusão da decisão, início e conclusão da gravação, e os resultados atuais.
2. Determine, com base nos requisitos, se a conclusão da gravação é pré-requisito para decisões ou recuperação. Mantenha verificações de saldo e risco e a persistência necessária à correção nos lugares em que são exigidas. Separe os registros analíticos cuja gravação possa terminar depois.
3. Defina a transferência dos registros para que mudanças posteriores de estado não alterem os valores registrados. Implemente uma fila auxiliar limitada e um consumidor responsável pela gravação. Especifique limites de itens, bytes e tempo de espera; o comportamento diante de fila cheia, falhas de gravação, novas tentativas e encerramento; e os requisitos de retenção. Não descarte registros enquanto esses requisitos forem desconhecidos.
4. Não presuma que uma tarefa separada seja executada em outra CPU. Verifique onde são executados a E/S síncrona e os trabalhos longos de CPU. Se usar workers ou mecanismos semelhantes, limite a concorrência e inclua conversão, cópia e espera pela transferência na avaliação.
5. Use as mesmas entradas e o mesmo ritmo de chegada para reproduzir gravações normais, lentas e com falha, uma fila auxiliar cheia e o encerramento. Compare p50/p95/p99 da recepção à conclusão da decisão, espera e acúmulo do lado da gravação, CPU e memória, e registros ausentes ou duplicados. Verifique a correção do estado e das decisões e os requisitos de retenção dos registros. Use um relógio monotônico para medir durações dentro de um host e indique os limites da medição.

Respeite as aprovações, permissões e procedimentos de desenvolvimento existentes. Estas instruções, por si só, não concedem permissão adicional para alterar produção, contratar serviços pagos ou realizar negociações reais. Não exponha chaves privadas, credenciais ou dados de clientes.

Informe as mudanças, as condições de comparação, as medições antes e depois, as verificações de correção e as limitações restantes. Marque como não medidos os valores que não puderem ser medidos.
Melhore esta aplicação quando esperar pela gravação de registros analíticos impede aplicar a próxima atualização ou usá-la em uma decisão.
Leia o README, as instruções de desenvolvimento, as dependências e o laço receptor. Trabalhe com a linguagem, o ambiente de execução e a biblioteca de armazenamento existentes. Localize as esperas pela conclusão das gravações e identifique as threads, tarefas ou event loops em que o trabalho realmente é executado.
1. Prepare entradas reproduzíveis sem informações confidenciais. Registre recepção, aplicação do estado, início e conclusão da decisão, início e conclusão da gravação, e os resultados atuais.
2. Determine, com base nos requisitos, se a conclusão da gravação é pré-requisito para decisões ou recuperação. Mantenha verificações de saldo e risco e a persistência necessária à correção nos lugares em que são exigidas. Separe os registros analíticos cuja gravação possa terminar depois.
3. Defina a transferência dos registros para que mudanças posteriores de estado não alterem os valores registrados. Implemente uma fila auxiliar limitada e um consumidor responsável pela gravação. Especifique limites de itens, bytes e tempo de espera; o comportamento diante de fila cheia, falhas de gravação, novas tentativas e encerramento; e os requisitos de retenção. Não descarte registros enquanto esses requisitos forem desconhecidos.
4. Não presuma que uma tarefa separada seja executada em outra CPU. Verifique onde são executados a E/S síncrona e os trabalhos longos de CPU. Se usar workers ou mecanismos semelhantes, limite a concorrência e inclua conversão, cópia e espera pela transferência na avaliação.
5. Use as mesmas entradas e o mesmo ritmo de chegada para reproduzir gravações normais, lentas e com falha, uma fila auxiliar cheia e o encerramento. Compare p50/p95/p99 da recepção à conclusão da decisão, espera e acúmulo do lado da gravação, CPU e memória, e registros ausentes ou duplicados. Verifique a correção do estado e das decisões e os requisitos de retenção dos registros. Use um relógio monotônico para medir durações dentro de um host e indique os limites da medição.
Respeite as aprovações, permissões e procedimentos de desenvolvimento existentes. Estas instruções, por si só, não concedem permissão adicional para alterar produção, contratar serviços pagos ou realizar negociações reais. Não exponha chaves privadas, credenciais ou dados de clientes.
Informe as mudanças, as condições de comparação, as medições antes e depois, as verificações de correção e as limitações restantes. Marque como não medidos os valores que não puderem ser medidos.3. Não faça atualizações independentes esperarem pelo mesmo bloqueio
Considere uma aplicação que pode atualizar de forma independente os preços dos mercados A e B. Uma atualização de B chega depois que a de A começou. Se um único mutex protege A e B, B precisa esperar até A liberar esse bloqueio.
Um mutex concede a uma operação por vez o direito de acessar os dados protegidos. Se outra operação já o utiliza, a operação que tenta adquirir o mesmo bloqueio espera.[17]
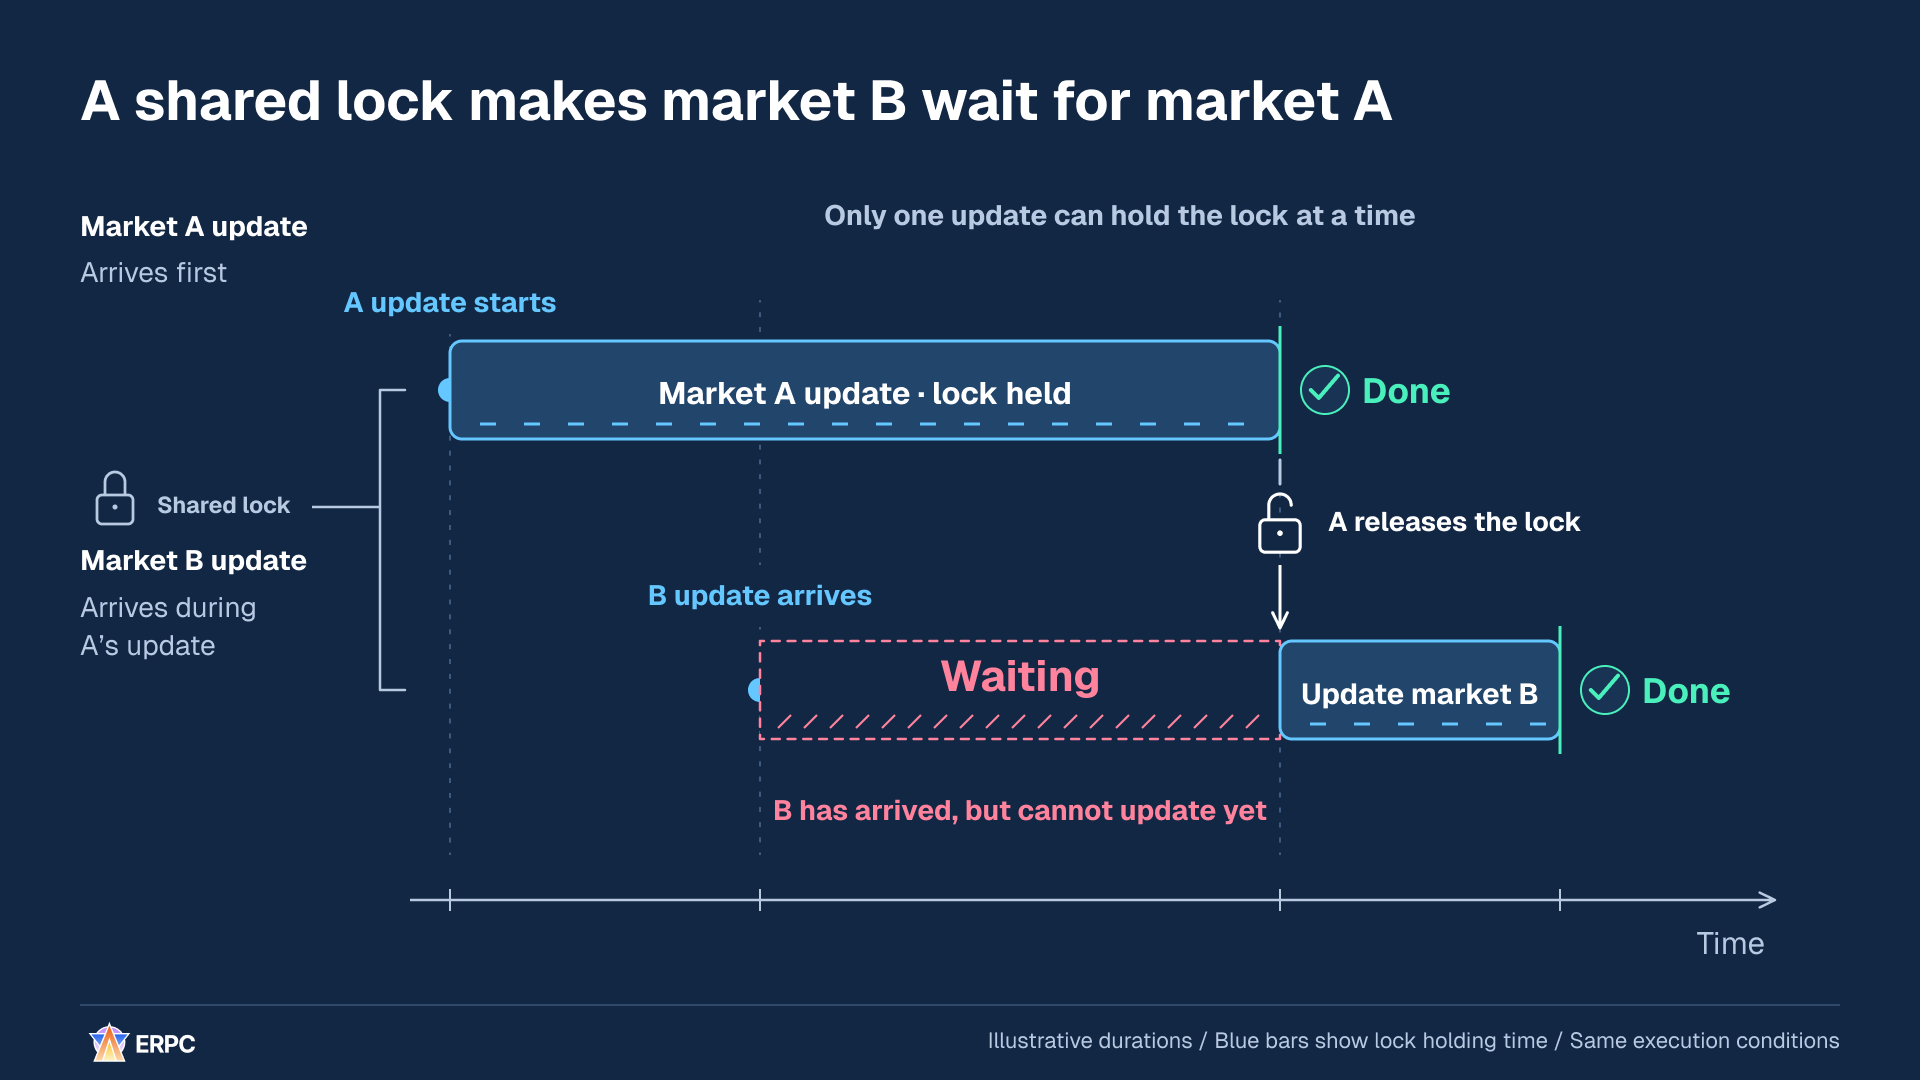
Os dados de B chegaram, mas aguardam o bloqueio compartilhado mantido por A.
Se A e B modificam valores separados, uma opção é protegê-los com bloqueios distintos. A metade superior do próximo diagrama usa um bloqueio compartilhado; a inferior usa bloqueios separados. As posições de chegada e as durações em que A e B mantêm seus bloqueios são idênticas nas duas metades. O exemplo pressupõe que o bloqueio de B está livre e há capacidade de execução para B. O tutorial oficial do Tokio também descreve o particionamento de mutexes para dados com chaves independentes.[18]
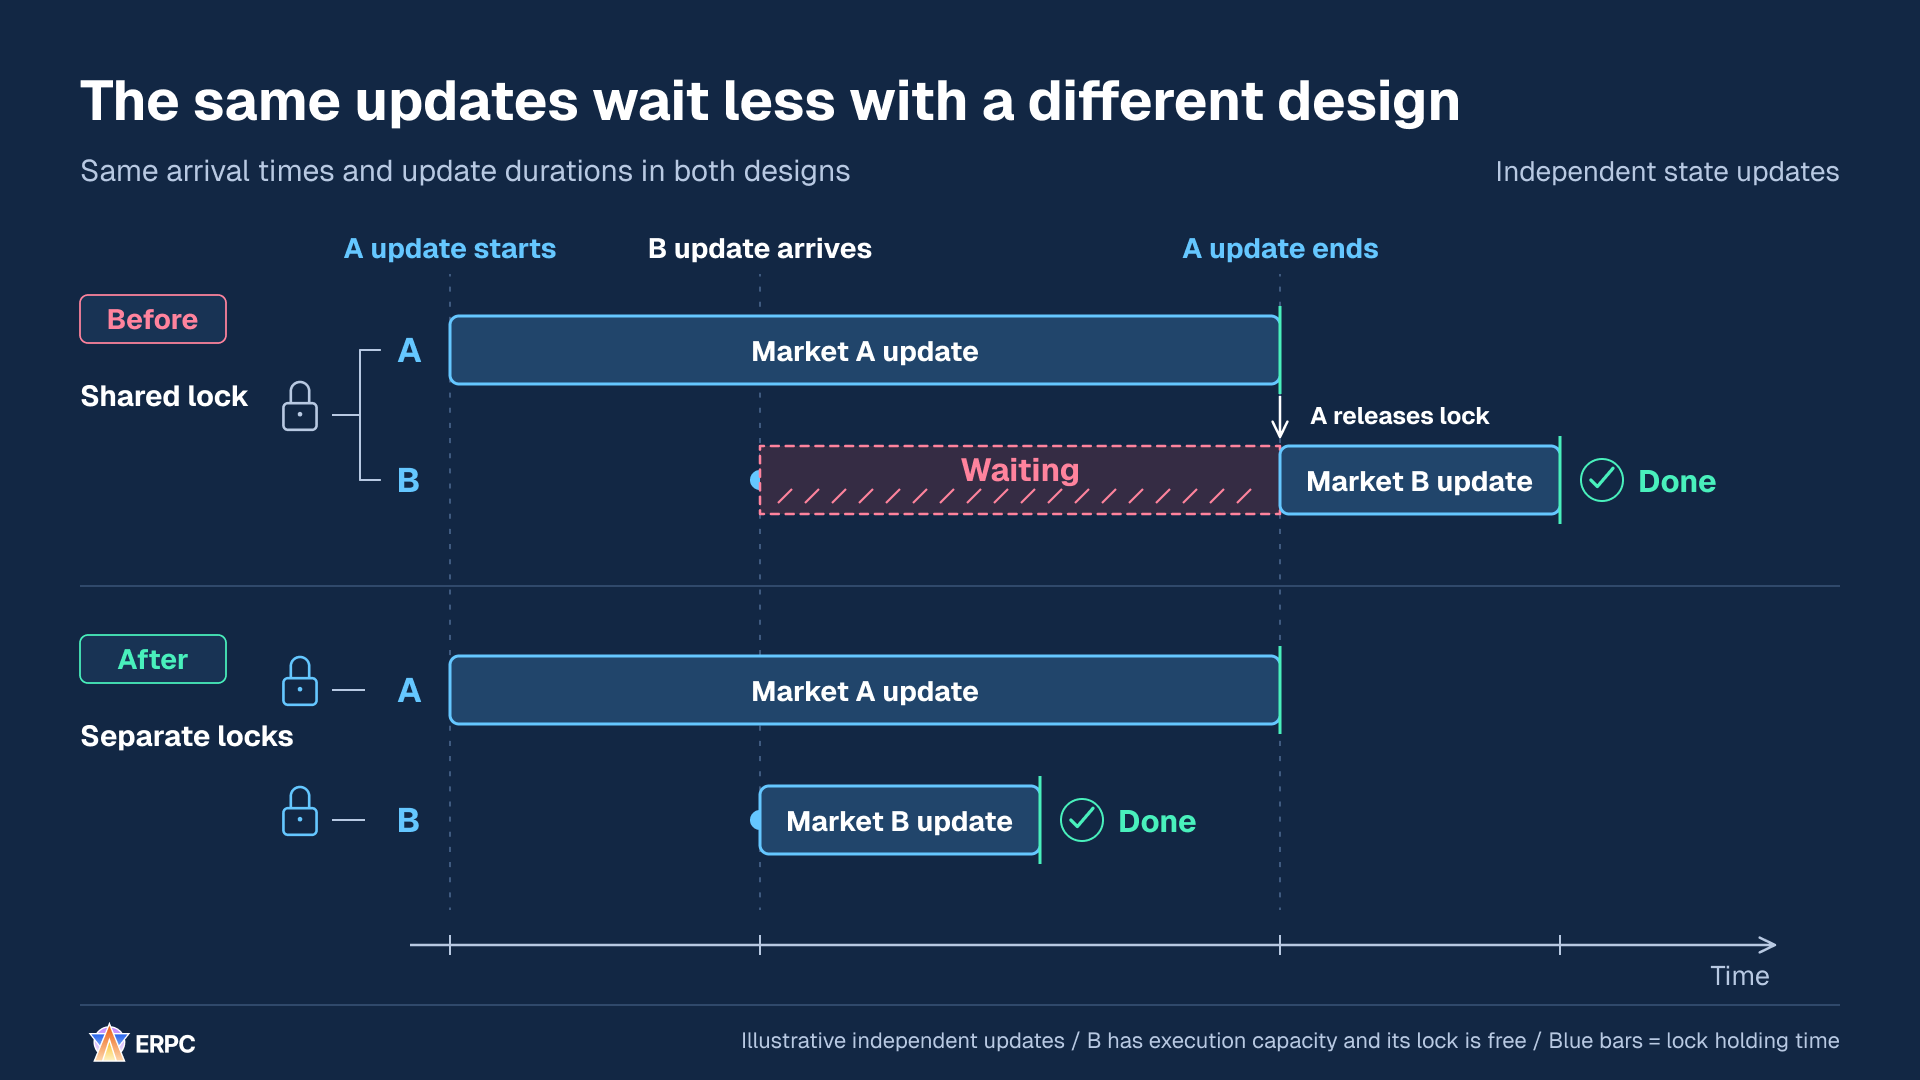
A barra azul de B tem o mesmo comprimento. A parte removida é o intervalo rosa de espera que vinha antes dela.
A barra azul cobre o período da aquisição até a liberação do bloqueio. Neste exemplo, B termina enquanto A ainda está atualizando. Separar bloqueios não elimina uma espera causada pelo próprio bloqueio de B estar ocupado ou por outro trabalho consumir os recursos de execução disponíveis.
Antes de dividir um bloqueio, estabeleça quais atualizações são independentes. Mesmo que os preços de A e B possam ser atualizados separadamente, uma decisão que use ambos ou um saldo compartilhado ainda precisa ler os valores necessários de forma consistente. Os valores podem mudar enquanto uma operação está suspensa em um await, mesmo na mesma thread. Defina quais versões uma decisão lê, como ela as lê e a ordem de aplicação das atualizações.
Por exemplo, se A e B leem o mesmo saldo e cada um monta uma ordem, ambos podem contar com os mesmos recursos. Valores compartilhados continuam precisando de proteção própria, como um único responsável que confira o saldo e reserve os recursos de cada ordem em sequência.
Outra opção é atribuir a cada estado um único responsável pelas atualizações e enviar mensagens a ele. Esse é o princípio Single Writer. Dividir bloqueios e escolher um único escritor são decisões de projeto distintas. O LMAX Disruptor descreve Single Writer e dependências de processamento; o Tokio descreve o gerenciamento de estado por mensagens enviadas a uma tarefa dedicada.[5][18]
Para reduzir a espera por bloqueios entre atualizações de estado independentes, copie estas instruções.
text
Melhore esta aplicação quando uma atualização de um mercado ou chave faz uma atualização independente esperar pelo mesmo bloqueio compartilhado.

Leia o README, as instruções de desenvolvimento, as dependências e o código que lê ou escreve o estado, adquire bloqueios ou usa await para esperar outros trabalhos. Use a linguagem e o ambiente de execução existentes. Identifique quem atualiza cada valor e quais conjuntos de valores cada decisão lê.

1. Salve entradas reproduzíveis sem informações confidenciais e registre os valores iniciais. Para os bloqueios com contenção, registre chegadas por chave, espera para aquisição, tempo de retenção, ordem das atualizações e versões do estado usadas nas decisões.
2. Distinga os valores que podem ser atualizados independentemente daqueles cuja consistência deve ser protegida em conjunto. Divida os bloqueios em torno dos estados independentes e explicite a ordem de aplicação e a responsabilidade de escrita de cada chave. Controle o número de bloqueios ou responsáveis pelo processamento.
3. Proteja decisões que envolvam vários mercados e saldos ou reservas de fundos compartilhados. Faça da verificação de saldo e da reserva uma única operação coordenada, para que várias ordens não possam presumir, cada uma, que os mesmos fundos estão disponíveis. Defina uma ordem de aquisição se forem necessários vários bloqueios.
4. Examine mudanças de estado entre pontos await e a ordem de conclusão na decodificação paralela. Defina quais versões uma decisão lê e como as lê. Não permita que a ordem de conclusão da decodificação substitua a ordem necessária de aplicação. Depois de dividir os bloqueios, verifique se limites de recursos de execução ou contenção na mesma chave ainda causam espera.
5. Reproduza as mesmas entradas e a mesma ordem de chegada com chaves independentes, atualizações concentradas em uma chave, reservas concorrentes de fundos compartilhados e trabalho suspenso e retomado. Compare a espera por bloqueios, p50/p95/p99 da recepção à conclusão da decisão, CPU e memória. Verifique a ordem exigida de atualização, a consistência do estado usado nas decisões e a ausência de reserva dupla. Use um relógio monotônico para medir durações dentro de um host e indique os limites da medição.

Respeite as aprovações, permissões e procedimentos de desenvolvimento existentes. Estas instruções, por si só, não concedem permissão adicional para alterar produção, contratar serviços pagos ou realizar negociações reais. Não exponha chaves privadas, credenciais ou dados de clientes.

Informe as mudanças, as condições de comparação, as medições antes e depois, as verificações de correção e as limitações restantes. Marque como não medidos os valores que não puderem ser medidos.
Melhore esta aplicação quando uma atualização de um mercado ou chave faz uma atualização independente esperar pelo mesmo bloqueio compartilhado.
Leia o README, as instruções de desenvolvimento, as dependências e o código que lê ou escreve o estado, adquire bloqueios ou usa await para esperar outros trabalhos. Use a linguagem e o ambiente de execução existentes. Identifique quem atualiza cada valor e quais conjuntos de valores cada decisão lê.
1. Salve entradas reproduzíveis sem informações confidenciais e registre os valores iniciais. Para os bloqueios com contenção, registre chegadas por chave, espera para aquisição, tempo de retenção, ordem das atualizações e versões do estado usadas nas decisões.
2. Distinga os valores que podem ser atualizados independentemente daqueles cuja consistência deve ser protegida em conjunto. Divida os bloqueios em torno dos estados independentes e explicite a ordem de aplicação e a responsabilidade de escrita de cada chave. Controle o número de bloqueios ou responsáveis pelo processamento.
3. Proteja decisões que envolvam vários mercados e saldos ou reservas de fundos compartilhados. Faça da verificação de saldo e da reserva uma única operação coordenada, para que várias ordens não possam presumir, cada uma, que os mesmos fundos estão disponíveis. Defina uma ordem de aquisição se forem necessários vários bloqueios.
4. Examine mudanças de estado entre pontos await e a ordem de conclusão na decodificação paralela. Defina quais versões uma decisão lê e como as lê. Não permita que a ordem de conclusão da decodificação substitua a ordem necessária de aplicação. Depois de dividir os bloqueios, verifique se limites de recursos de execução ou contenção na mesma chave ainda causam espera.
5. Reproduza as mesmas entradas e a mesma ordem de chegada com chaves independentes, atualizações concentradas em uma chave, reservas concorrentes de fundos compartilhados e trabalho suspenso e retomado. Compare a espera por bloqueios, p50/p95/p99 da recepção à conclusão da decisão, CPU e memória. Verifique a ordem exigida de atualização, a consistência do estado usado nas decisões e a ausência de reserva dupla. Use um relógio monotônico para medir durações dentro de um host e indique os limites da medição.
Respeite as aprovações, permissões e procedimentos de desenvolvimento existentes. Estas instruções, por si só, não concedem permissão adicional para alterar produção, contratar serviços pagos ou realizar negociações reais. Não exponha chaves privadas, credenciais ou dados de clientes.
Informe as mudanças, as condições de comparação, as medições antes e depois, as verificações de correção e as limitações restantes. Marque como não medidos os valores que não puderem ser medidos.4. Prepare antecipadamente as partes que não mudam para reduzir o trabalho após a chegada
Suponha que cada atualização de preço faça a aplicação interpretar o mesmo ID fixo, derivar um endereço fixo a partir das mesmas entradas e alocar memória de trabalho. Essa memória também é chamada de buffer. Repetir essas três preparações coloca o tempo gasto com informações inalteradas no caminho de cada decisão.
A preparação cujas entradas não mudam pode terminar antes de os dados chegarem e ser reutilizada. Após a chegada, a aplicação confere as informações que mudaram para aquele evento, constrói a mensagem final a ser enviada e assina esse conteúdo.
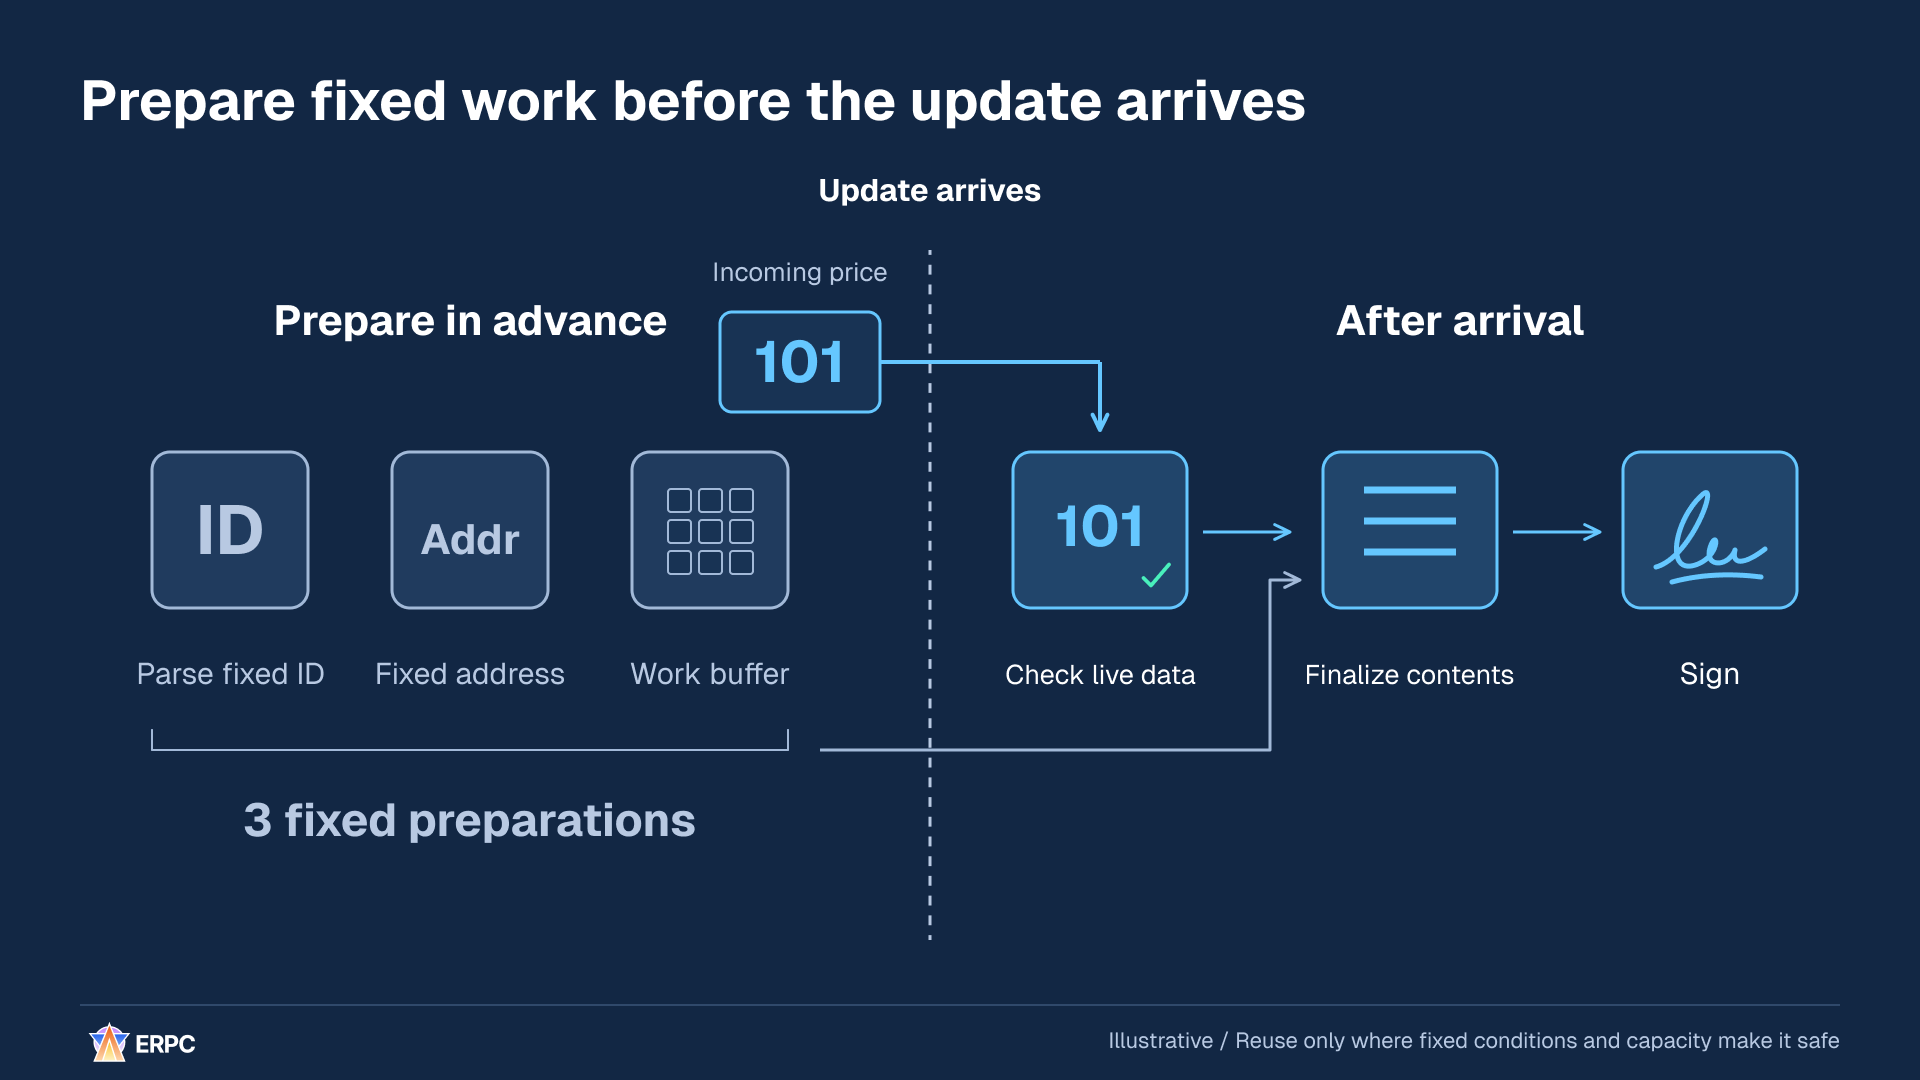
Antecipe a preparação que não muda e mantenha a validação do conteúdo atual e a assinatura após a chegada.
Conte o que muda para três atualizações. Preparar três tipos de elementos para cada evento exige nove operações de preparação. Preparar esses três tipos uma única vez e reutilizá-los sequencialmente exige três. Os dois projetos continuam recebendo três eventos, processando-os um a um e produzindo três saídas.
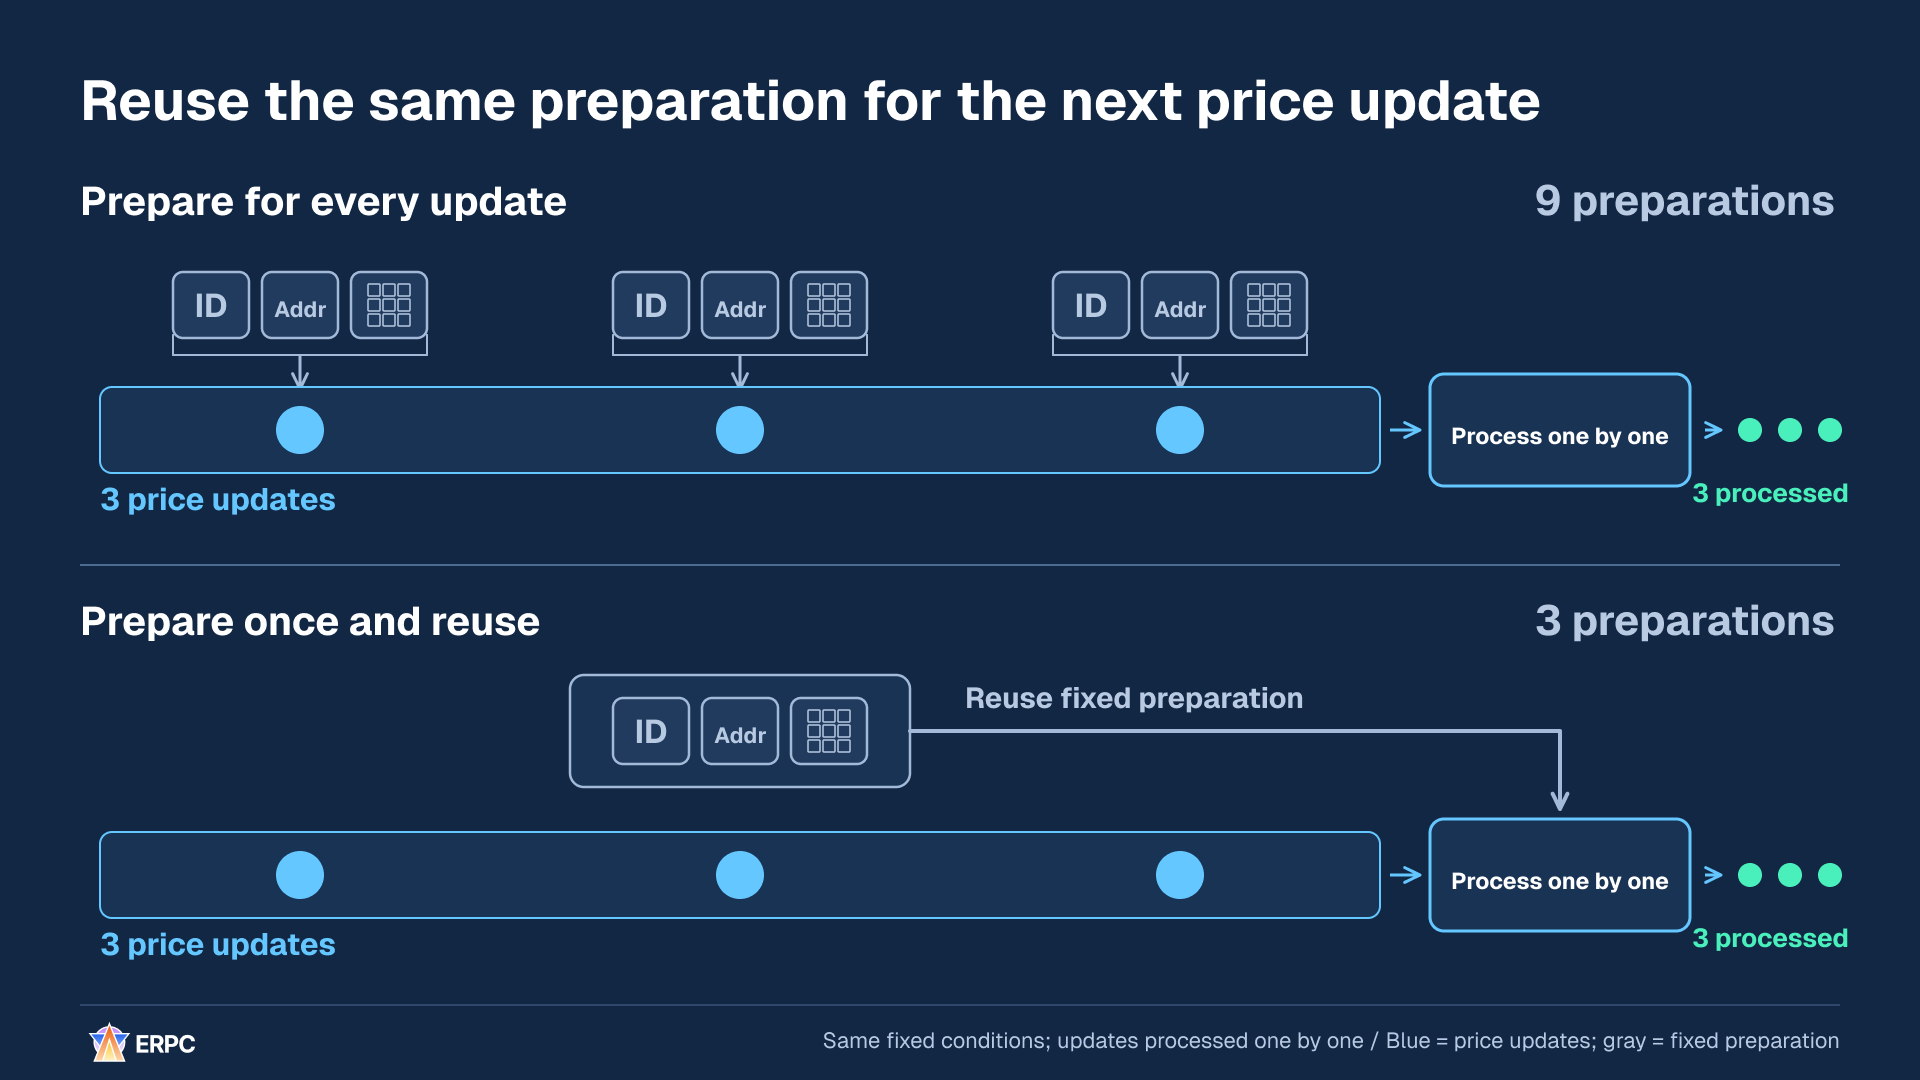
O número de eventos permanece três, enquanto a preparação fixa cai de nove para três operações neste exemplo.
A comparação pressupõe condições fixas inalteradas e reutilização sequencial segura da memória de trabalho. Seu conteúdo continua sendo atualizado para o evento atual a cada uso. Se várias operações executam ao mesmo tempo, use regiões separadas para cada uma ou um pool que controle o acesso, evitando que sobrescrevam a mesma memória.
Amplie o exemplo para 1.000 eventos. Preparar três tipos de elementos para cada evento exige 3.000 operações; fazer a preparação compartilhada uma vez exige três. Os dois projetos recebem 1.000 eventos, processam-nos um a um e produzem 1.000 saídas. Separe a contagem de preparações da quantidade de eventos processados.
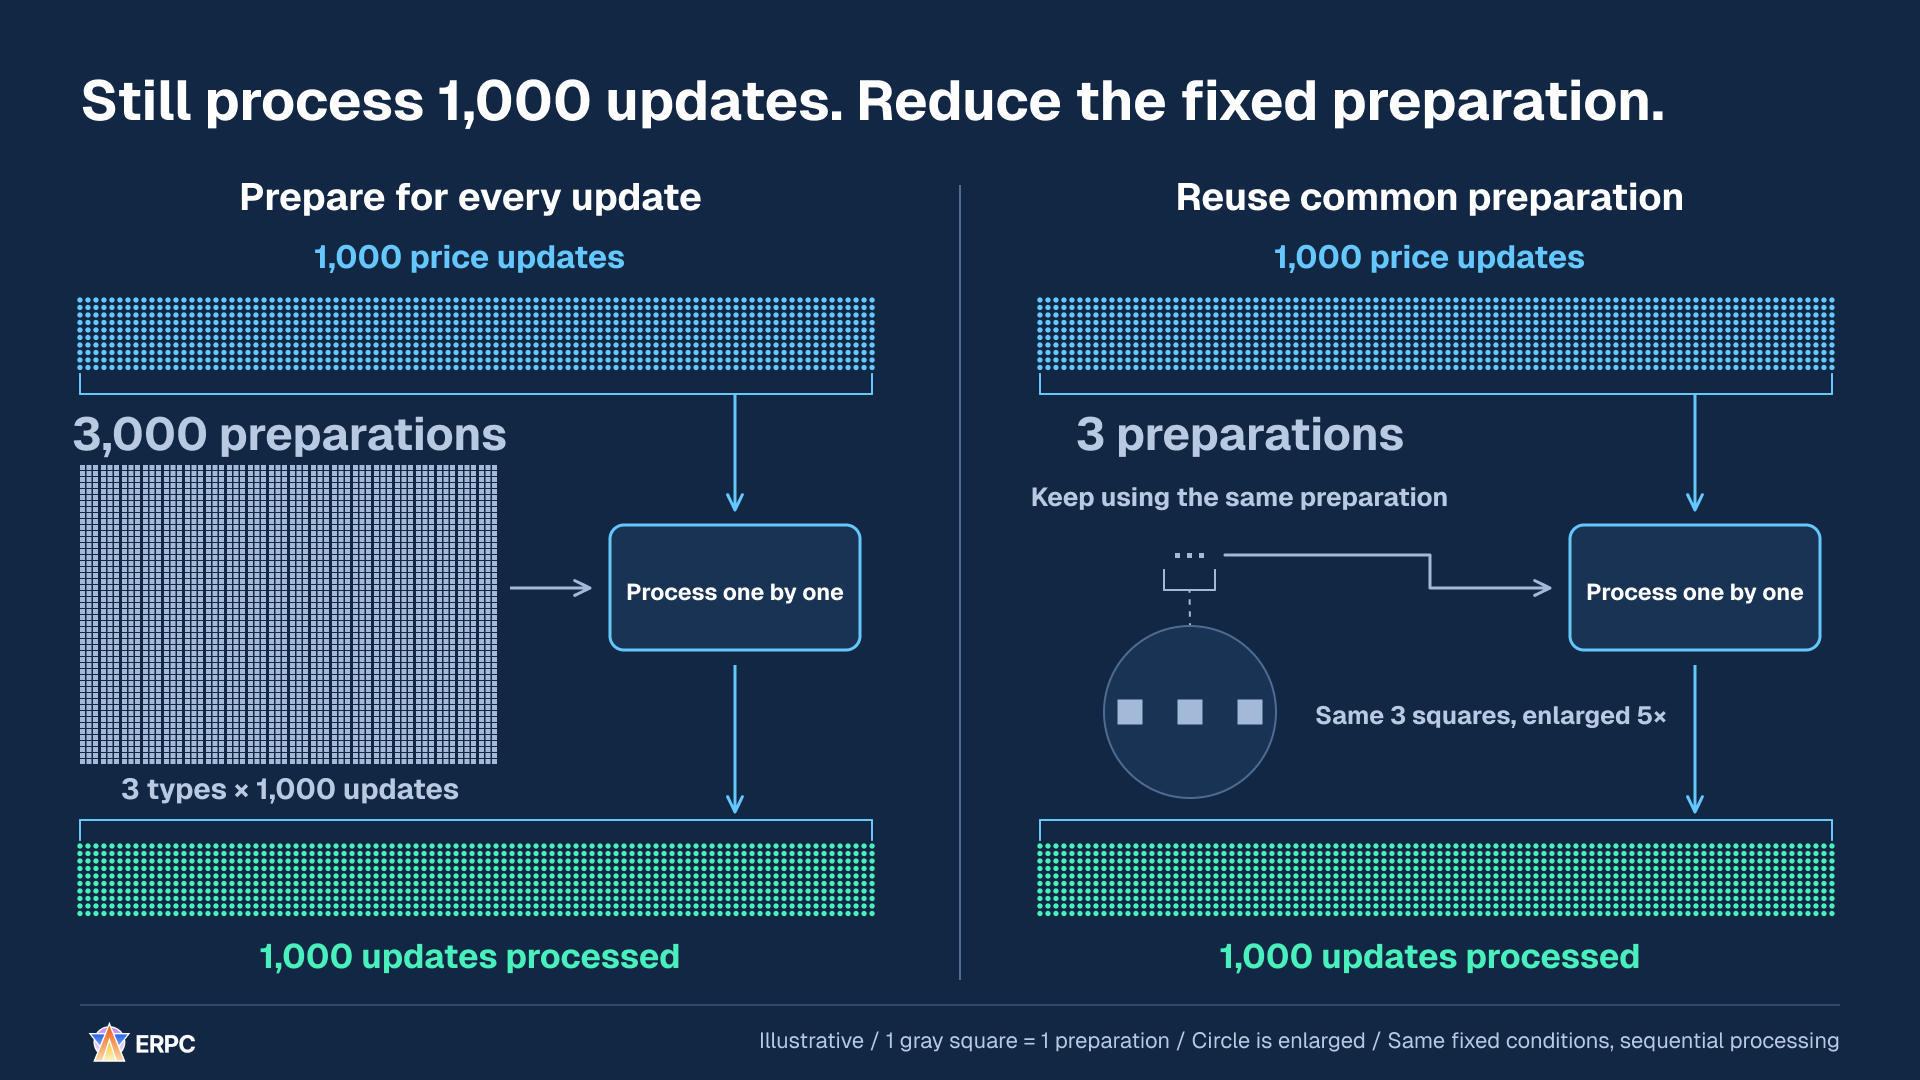
O que diminui é a repetição da preparação fixa. Validação, decisões, assinaturas e outros trabalhos continuam existindo, portanto a proporção entre essas contagens não representa a aceleração da aplicação inteira.
Defina as condições em que a reutilização permanece válida. Se uma entrada usada para derivar o endereço fixo mudar, ele precisará ser recalculado. Preços, quantidades, saldos, estados das contas referenciadas, limites de risco e blockhashes devem estar válidos quando usados na decisão. Se a aplicação mantém um estado local continuamente atualizado, confira sua versão, atualidade e validade. Isso não exige necessariamente buscar tudo novamente por RPC a cada decisão.
O getLatestBlockhash da Solana retorna um blockhash e seu lastValidBlockHeight. Ao conferir a expiração, diferencie altura de bloco e slot.[7] Finalize a mensagem antes de assiná-la. Se a mensagem mudar após a assinatura, produza assinaturas para o conteúdo atualizado.[19]
Para reutilizar a preparação fixa e reduzir o trabalho após a recepção, copie estas instruções.
text
Examine o trabalho que repete a mesma interpretação, derivação de endereço ou alocação de memória para cada entrada e mova a preparação reutilizável para antes da recepção.

Leia o README, as instruções de desenvolvimento, as dependências e o código de recepção → preparação → decisão → construção da mensagem → assinatura. Use a linguagem, o ambiente de execução e o SDK existentes. Identifique as entradas, saídas, responsável e período de validade de cada preparação.

1. Salve entradas reproduzíveis sem informações confidenciais. Registre as quantidades de eventos e saídas, a quantidade de execuções e a duração de cada preparação, a memória alocada e o tempo da recepção à conclusão da decisão.
2. Identifique preparações cujas entradas permaneçam iguais, execute-as durante a inicialização ou outra etapa anterior apropriada e reutilize os resultados. Implemente chaves de reutilização, invalidação e recálculo quando as entradas ou a configuração mudarem, e limites para caches e pools de buffers.
3. Atualize a memória de trabalho reutilizável para a entrada atual. No trabalho concorrente, use regiões separadas ou empréstimos gerenciados para que uma região não seja sobrescrita nem devolvida enquanto ainda estiver em uso.
4. Valide preços, quantidades, saldos, estado das contas, condições de risco e blockhashes conforme os requisitos da decisão. Verifique versão e atualidade ao usar estado local continuamente atualizado. Na Solana, diferencie altura de bloco de slot ao usar lastValidBlockHeight para verificar a expiração de um blockhash. Finalize a mensagem antes de assinar e assine novamente a mensagem atualizada se o conteúdo mudar depois da assinatura.
5. Com as mesmas entradas, compare a quantidade e a duração das preparações, p50/p95/p99 da recepção à conclusão da decisão, CPU e memória, e as saídas. Reproduza também mudanças de entradas ou configuração, expiração e execução concorrente para verificar a reutilização de resultados obsoletos e conflitos de memória. Não trate a proporção entre as quantidades de preparações como o fator de aceleração total. Use um relógio monotônico para medir durações dentro de um host e indique os limites da medição.

Respeite as aprovações, permissões e procedimentos de desenvolvimento existentes. Estas instruções, por si só, não concedem permissão adicional para alterar produção, contratar serviços pagos ou realizar negociações reais. Não exponha chaves privadas, credenciais ou dados de clientes.

Informe as mudanças, as condições de comparação, as medições antes e depois, as verificações de correção e as limitações restantes. Marque como não medidos os valores que não puderem ser medidos.
Examine o trabalho que repete a mesma interpretação, derivação de endereço ou alocação de memória para cada entrada e mova a preparação reutilizável para antes da recepção.
Leia o README, as instruções de desenvolvimento, as dependências e o código de recepção → preparação → decisão → construção da mensagem → assinatura. Use a linguagem, o ambiente de execução e o SDK existentes. Identifique as entradas, saídas, responsável e período de validade de cada preparação.
1. Salve entradas reproduzíveis sem informações confidenciais. Registre as quantidades de eventos e saídas, a quantidade de execuções e a duração de cada preparação, a memória alocada e o tempo da recepção à conclusão da decisão.
2. Identifique preparações cujas entradas permaneçam iguais, execute-as durante a inicialização ou outra etapa anterior apropriada e reutilize os resultados. Implemente chaves de reutilização, invalidação e recálculo quando as entradas ou a configuração mudarem, e limites para caches e pools de buffers.
3. Atualize a memória de trabalho reutilizável para a entrada atual. No trabalho concorrente, use regiões separadas ou empréstimos gerenciados para que uma região não seja sobrescrita nem devolvida enquanto ainda estiver em uso.
4. Valide preços, quantidades, saldos, estado das contas, condições de risco e blockhashes conforme os requisitos da decisão. Verifique versão e atualidade ao usar estado local continuamente atualizado. Na Solana, diferencie altura de bloco de slot ao usar lastValidBlockHeight para verificar a expiração de um blockhash. Finalize a mensagem antes de assinar e assine novamente a mensagem atualizada se o conteúdo mudar depois da assinatura.
5. Com as mesmas entradas, compare a quantidade e a duração das preparações, p50/p95/p99 da recepção à conclusão da decisão, CPU e memória, e as saídas. Reproduza também mudanças de entradas ou configuração, expiração e execução concorrente para verificar a reutilização de resultados obsoletos e conflitos de memória. Não trate a proporção entre as quantidades de preparações como o fator de aceleração total. Use um relógio monotônico para medir durações dentro de um host e indique os limites da medição.
Respeite as aprovações, permissões e procedimentos de desenvolvimento existentes. Estas instruções, por si só, não concedem permissão adicional para alterar produção, contratar serviços pagos ou realizar negociações reais. Não exponha chaves privadas, credenciais ou dados de clientes.
Informe as mudanças, as condições de comparação, as medições antes e depois, as verificações de correção e as limitações restantes. Marque como não medidos os valores que não puderem ser medidos.5. Não continue decidindo depois de perder atualizações necessárias
Considere dois mercados do mesmo ativo e uma aplicação que calcula a diferença de preços B−A. Durante uma desconexão, o mercado A passa de 100 para 105 e a aplicação perde essa atualização. Se, ao reconectar, ela receber somente o preço 104 de B, calculará 104−100, ou +4. Com o valor atualizado de A, o resultado é 104−105, ou -1. Até o sinal muda.
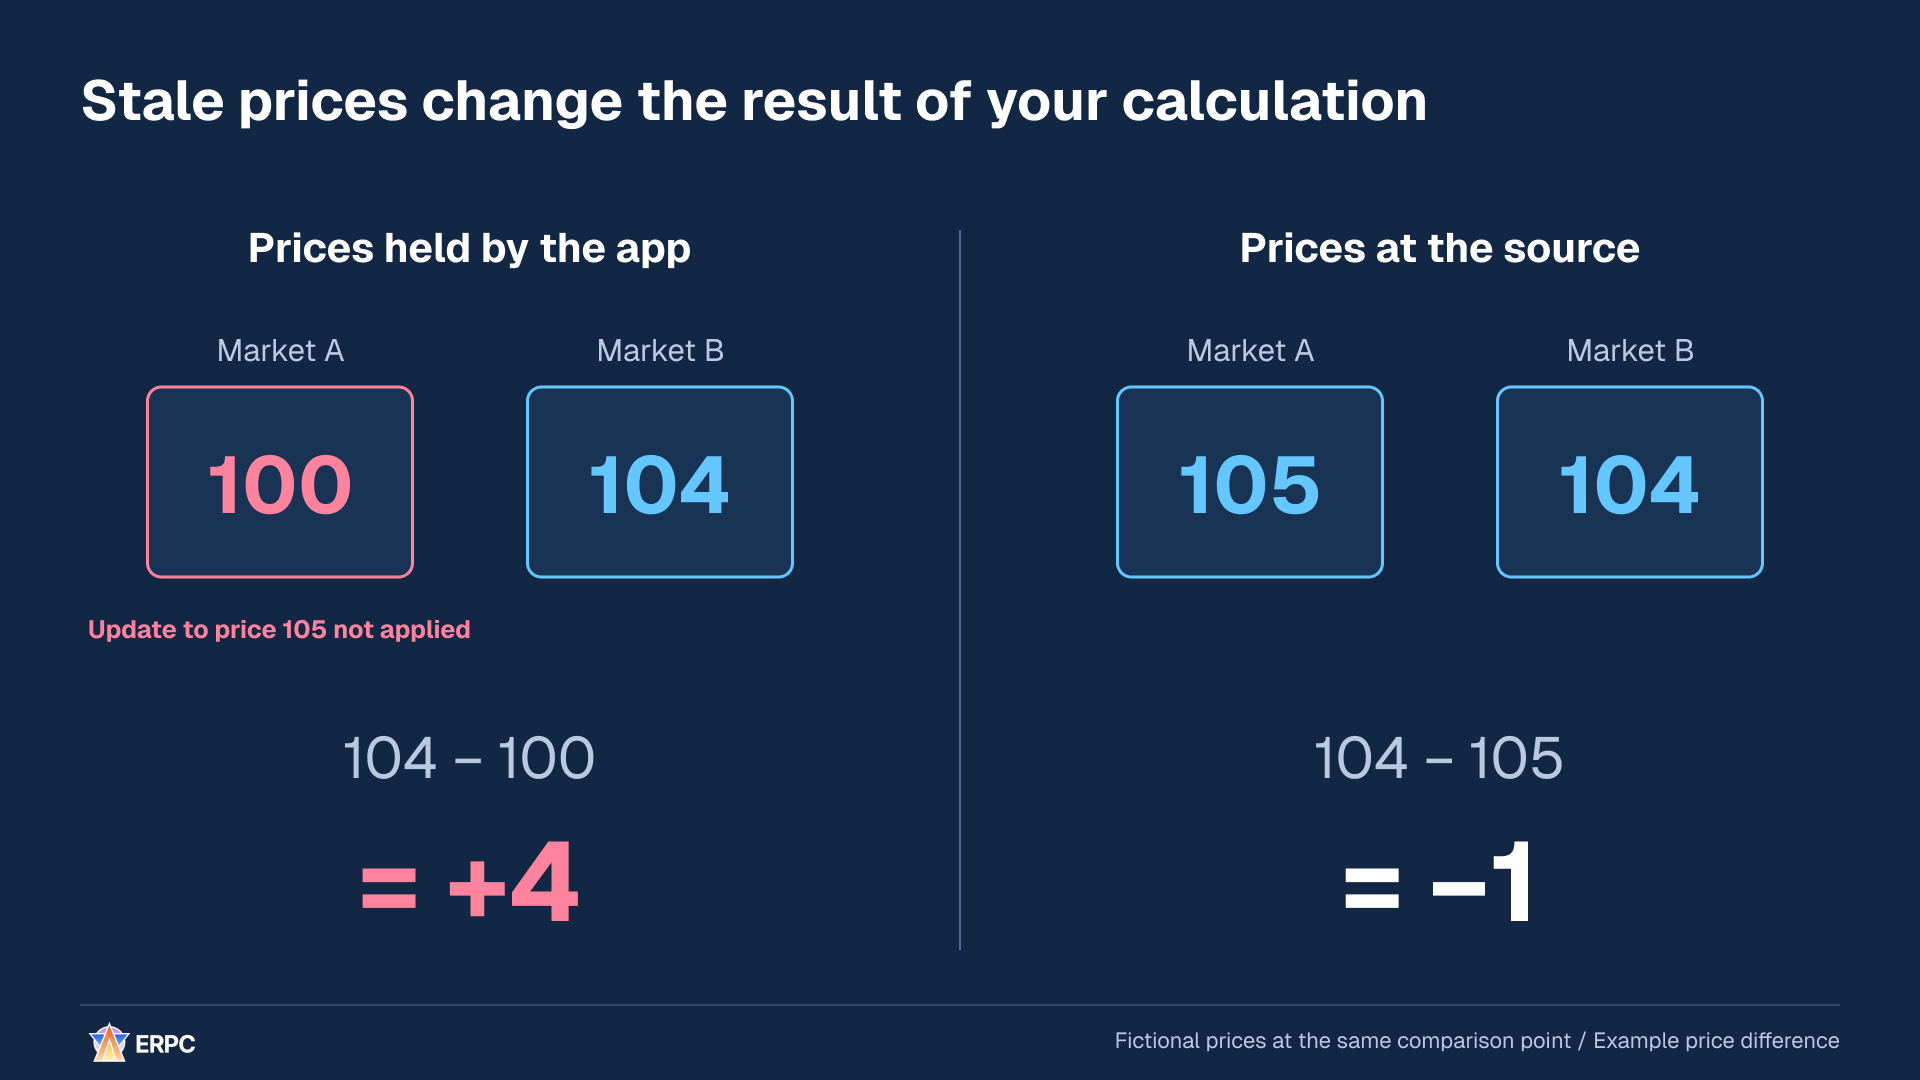
O mesmo cálculo muda conforme use o valor antigo 100 de A ou o valor atualizado 105.
Esse modelo mostra apenas uma diferença de preços. Ele não inclui taxas, condições de execução e outros fatores, nem representa lucro de negociação. O ponto é que restaurar a conexão não necessariamente restaura todas as atualizações necessárias para decidir.
Neste exemplo, pause novas decisões de negociação que usem os preços de A e B e substitua o valor antigo 100 de A pelo valor recuperado 105. Depois, verifique se as atualizações necessárias foram aplicadas a A e B e se as condições exigidas de ordem e atualidade foram satisfeitas. Retome quando as verificações necessárias terminarem; se isso não for possível, mantenha a pausa.
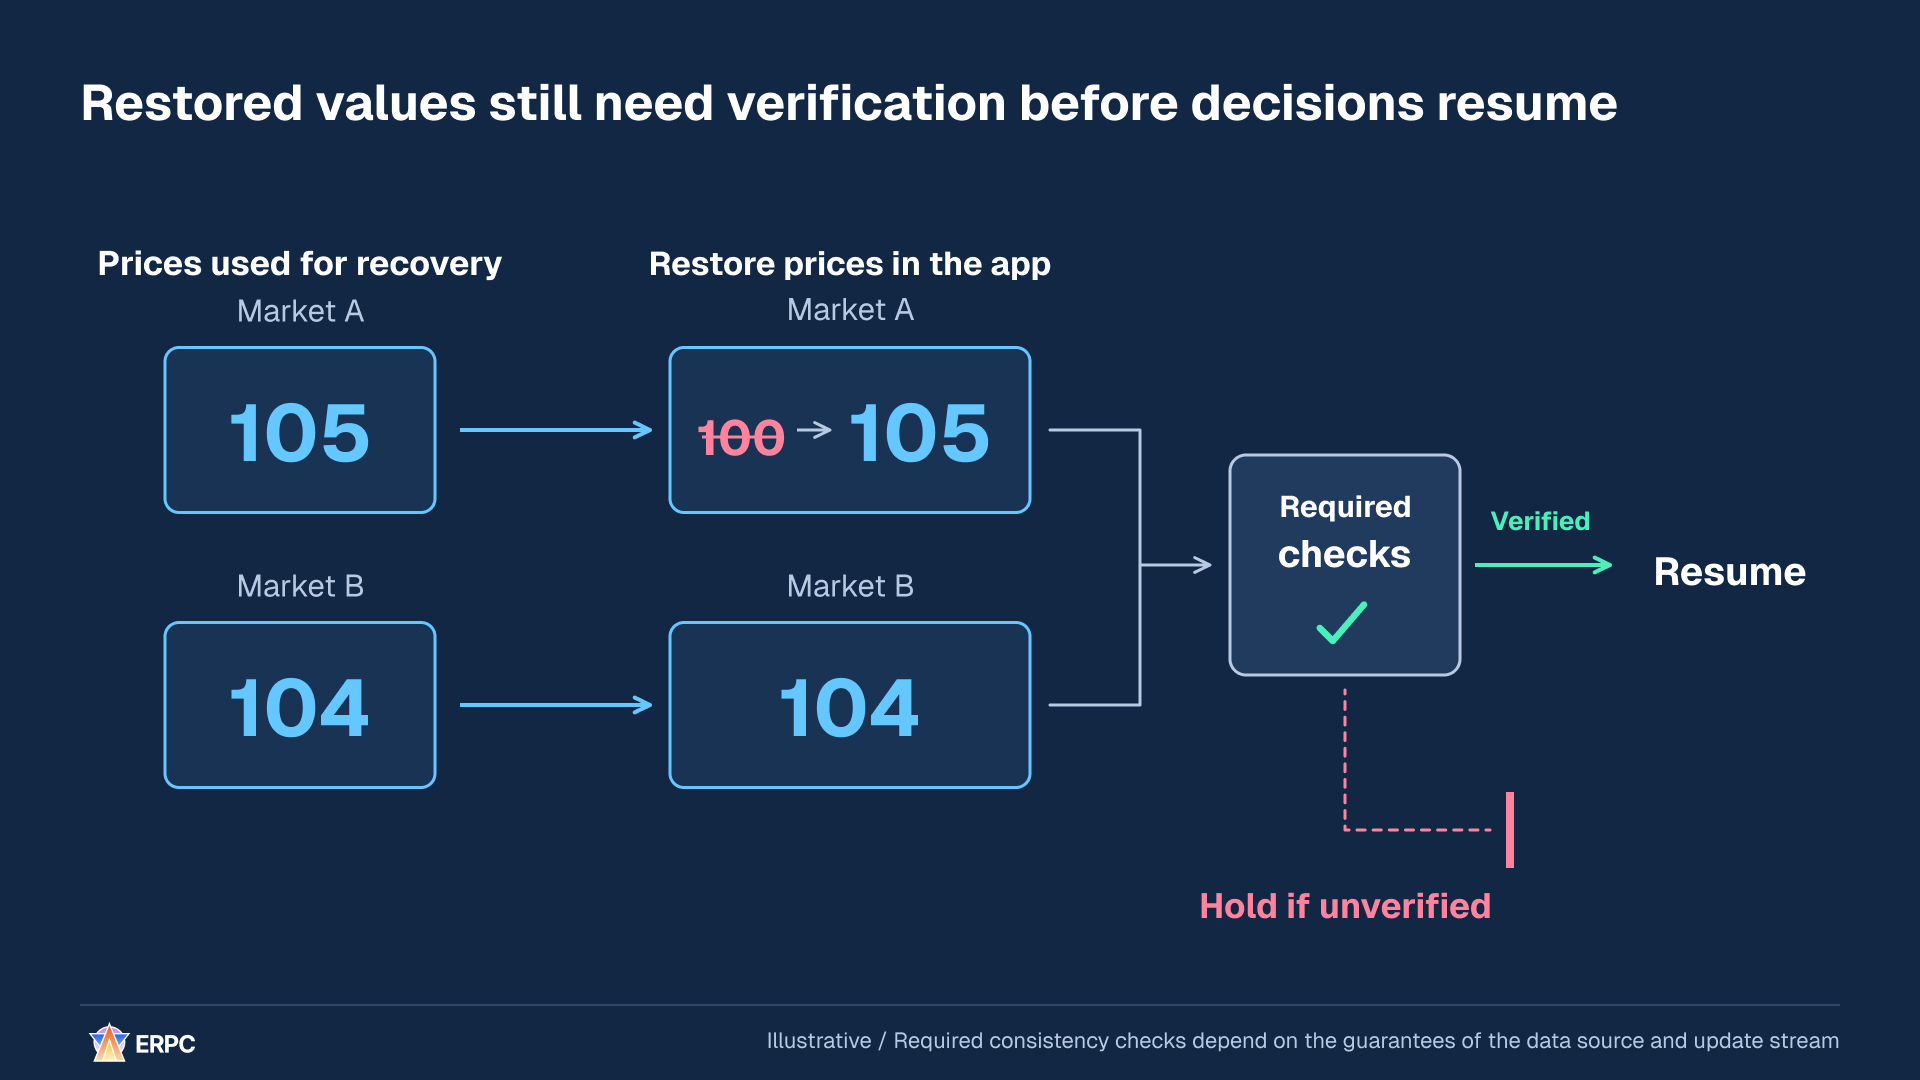
Separe a atualização dos valores da verificação de que esses valores podem ser usados nas decisões.
Um mecanismo comum de recuperação é o snapshot: um retrato do estado em determinado instante. Ao conectá-lo a um fluxo contínuo de atualizações, estabeleça quais já estão incluídas no snapshot e quais posteriores devem ser aplicadas. Isso evita aplicar duas vezes uma diferença já incluída ou perder uma atualização na fronteira. O método específico deve seguir as garantias da API escolhida para início da subscrição, identificação, nova obtenção e reprodução.
As mensagens do Yellowstone incluem campos como slot e write_version.[16] A presença desses campos, por si só, não garante uma sequência utilizável entre provedores nem detecção completa de lacunas. Não converta diretamente uma diferença de slots em uma quantidade de atualizações perdidas ou segundos de latência. Verifique se o estado foi reconectado conforme as garantias do provedor escolhido.
Considere também cálculos iniciados antes da recuperação. Uma operação que começou com o estado antigo e termina depois pode sobrescrever o estado novo com seu resultado. Uma abordagem é atribuir números de geração ao estado ao longo das recuperações e rejeitar resultados de gerações anteriores. Se usar estado processed, inclua também rollbacks (quando aquele estado deixa de ser adotado) como motivo para reavaliar o estado.[6]
Para recuperar um estado válido antes de retomar decisões após uma reconexão, copie estas instruções.
text
Impeça que esta aplicação retome decisões de negociação com estado desatualizado apenas porque a conexão voltou. Implemente a recuperação do estado necessário antes de retomar as decisões.

Leia o README, as instruções de desenvolvimento, as dependências e o código de subscrição, busca inicial, aplicação de atualizações, reconexão e decisão. Use a linguagem, o ambiente de execução e o SDK existentes. Verifique o provedor, o commitment, a semântica das atualizações e as garantias reais de ordem, identificação, nova busca e reprodução.

1. Distinga o estado da conexão, a validade dos dados e a permissão para retomar decisões. Se forem confirmadas atualizações necessárias ausentes ou atualidade insuficiente dos dados, pause novas decisões de negociação que dependam desse estado, enquanto mantém a recepção, as atualizações e a recuperação necessárias.
2. Se usar um snapshot, determine pelas garantias do provedor quais atualizações ele contém e sua fronteira com o fluxo seguinte. Evite aplicação dupla de deltas, lacunas na fronteira e ordem incorreta de aplicação. Não preencha falhas dessas garantias com suposições. Não trate slot ou write_version como uma sequência incondicional para detectar atualizações ausentes.
3. Não retome apenas porque os valores foram buscados. Implemente verificações das atualizações, da ordem, da atualidade e da consistência exigidas pelas decisões afetadas, e mantenha essas decisões pausadas enquanto as verificações não puderem ser concluídas. Use gerações ou mecanismo equivalente para impedir a aplicação ou o envio de cálculos ou propostas de ordens antigos se um trabalho iniciado antes da recuperação terminar mais tarde. Ao retomar, tome novas decisões a partir do estado validado. Se usar estado processed, trate a invalidação e a recuperação após um rollback.
4. Com entradas reproduzíveis sem informações confidenciais, reproduza atualizações perdidas durante uma desconexão, duplicatas, atualizações reordenadas, dados desatualizados, reconexões repetidas e a conclusão de trabalho de uma geração antiga. Verifique se as decisões permanecem pausadas da recuperação da conexão até o fim da validação e se o estado validado corresponde ao resultado esperado.
5. Registre o tempo de recuperação, o número de tentativas de decisão suprimidas por estado inválido e a duração da pausa, as atualizações reaplicadas ou excluídas, o tempo normal da recepção à conclusão da decisão, CPU e memória. Não exclua silenciosamente das medições períodos de pausa nem atualizações ausentes. Indique os limites de medição e o que pode ou não ser detectado. Use um relógio monotônico para medir durações dentro de um host.

Respeite as aprovações, permissões e procedimentos de desenvolvimento existentes. Estas instruções, por si só, não concedem permissão adicional para alterar produção, contratar serviços pagos ou realizar negociações reais. Não exponha chaves privadas, credenciais ou dados de clientes.

Informe as mudanças, as condições de comparação, as medições antes e depois, as verificações de correção e as limitações restantes. Marque como não medidos os valores que não puderem ser medidos.
Impeça que esta aplicação retome decisões de negociação com estado desatualizado apenas porque a conexão voltou. Implemente a recuperação do estado necessário antes de retomar as decisões.
Leia o README, as instruções de desenvolvimento, as dependências e o código de subscrição, busca inicial, aplicação de atualizações, reconexão e decisão. Use a linguagem, o ambiente de execução e o SDK existentes. Verifique o provedor, o commitment, a semântica das atualizações e as garantias reais de ordem, identificação, nova busca e reprodução.
1. Distinga o estado da conexão, a validade dos dados e a permissão para retomar decisões. Se forem confirmadas atualizações necessárias ausentes ou atualidade insuficiente dos dados, pause novas decisões de negociação que dependam desse estado, enquanto mantém a recepção, as atualizações e a recuperação necessárias.
2. Se usar um snapshot, determine pelas garantias do provedor quais atualizações ele contém e sua fronteira com o fluxo seguinte. Evite aplicação dupla de deltas, lacunas na fronteira e ordem incorreta de aplicação. Não preencha falhas dessas garantias com suposições. Não trate slot ou write_version como uma sequência incondicional para detectar atualizações ausentes.
3. Não retome apenas porque os valores foram buscados. Implemente verificações das atualizações, da ordem, da atualidade e da consistência exigidas pelas decisões afetadas, e mantenha essas decisões pausadas enquanto as verificações não puderem ser concluídas. Use gerações ou mecanismo equivalente para impedir a aplicação ou o envio de cálculos ou propostas de ordens antigos se um trabalho iniciado antes da recuperação terminar mais tarde. Ao retomar, tome novas decisões a partir do estado validado. Se usar estado processed, trate a invalidação e a recuperação após um rollback.
4. Com entradas reproduzíveis sem informações confidenciais, reproduza atualizações perdidas durante uma desconexão, duplicatas, atualizações reordenadas, dados desatualizados, reconexões repetidas e a conclusão de trabalho de uma geração antiga. Verifique se as decisões permanecem pausadas da recuperação da conexão até o fim da validação e se o estado validado corresponde ao resultado esperado.
5. Registre o tempo de recuperação, o número de tentativas de decisão suprimidas por estado inválido e a duração da pausa, as atualizações reaplicadas ou excluídas, o tempo normal da recepção à conclusão da decisão, CPU e memória. Não exclua silenciosamente das medições períodos de pausa nem atualizações ausentes. Indique os limites de medição e o que pode ou não ser detectado. Use um relógio monotônico para medir durações dentro de um host.
Respeite as aprovações, permissões e procedimentos de desenvolvimento existentes. Estas instruções, por si só, não concedem permissão adicional para alterar produção, contratar serviços pagos ou realizar negociações reais. Não exponha chaves privadas, credenciais ou dados de clientes.
Informe as mudanças, as condições de comparação, as medições antes e depois, as verificações de correção e as limitações restantes. Marque como não medidos os valores que não puderem ser medidos.Compare os pontos fortes das linguagens em seis dimensões
Implementar esses cinco projetos exige decidir quem atualiza os dados, onde a memória é alocada, o que é copiado e quais operações esperam. Cálculo rápido, controle de atrasos repentinos e rapidez para criar protótipos são pontos fortes diferentes. Compare as linguagens de acordo com a parte que você quer melhorar.
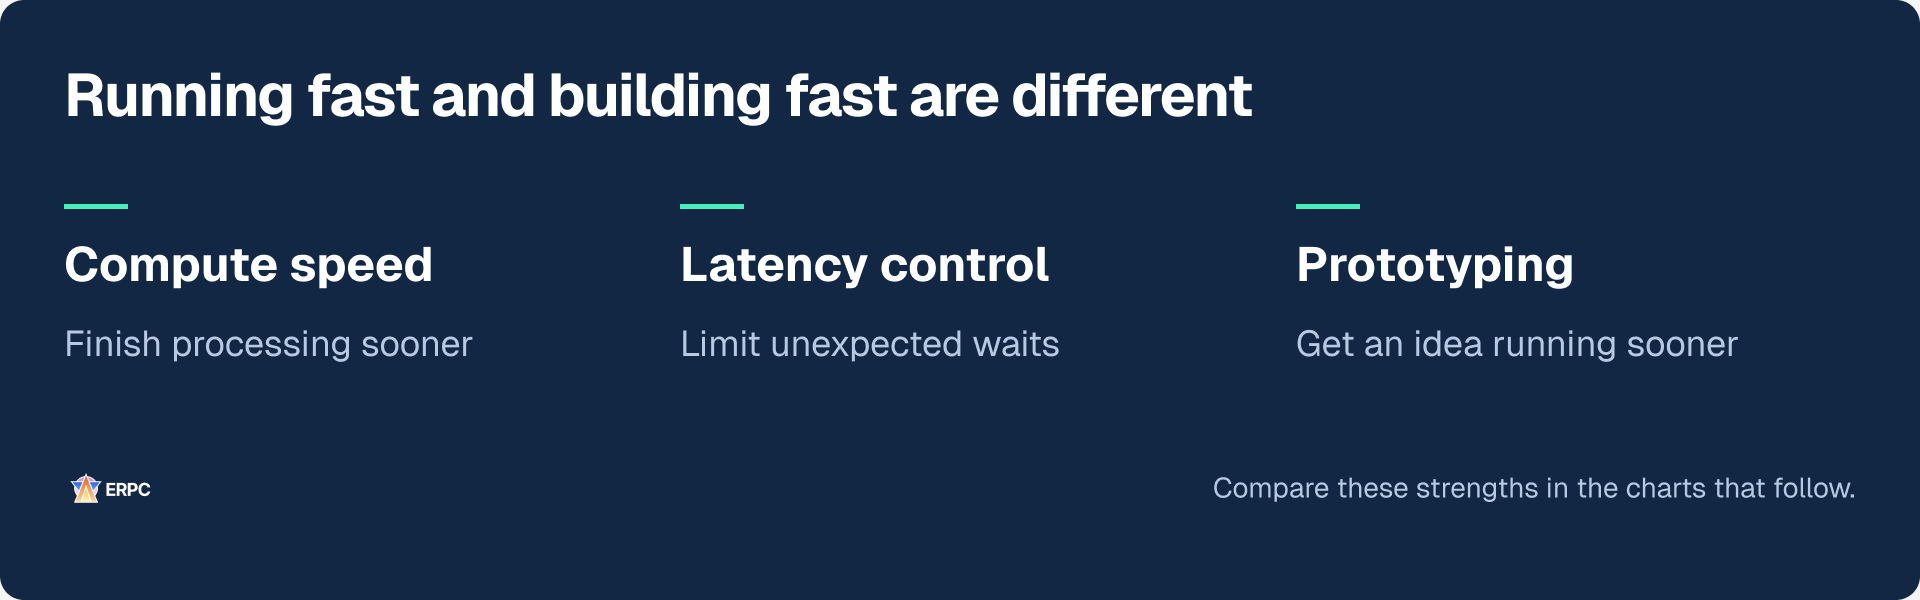
Comparar tempos de execução em um benchmark publicado
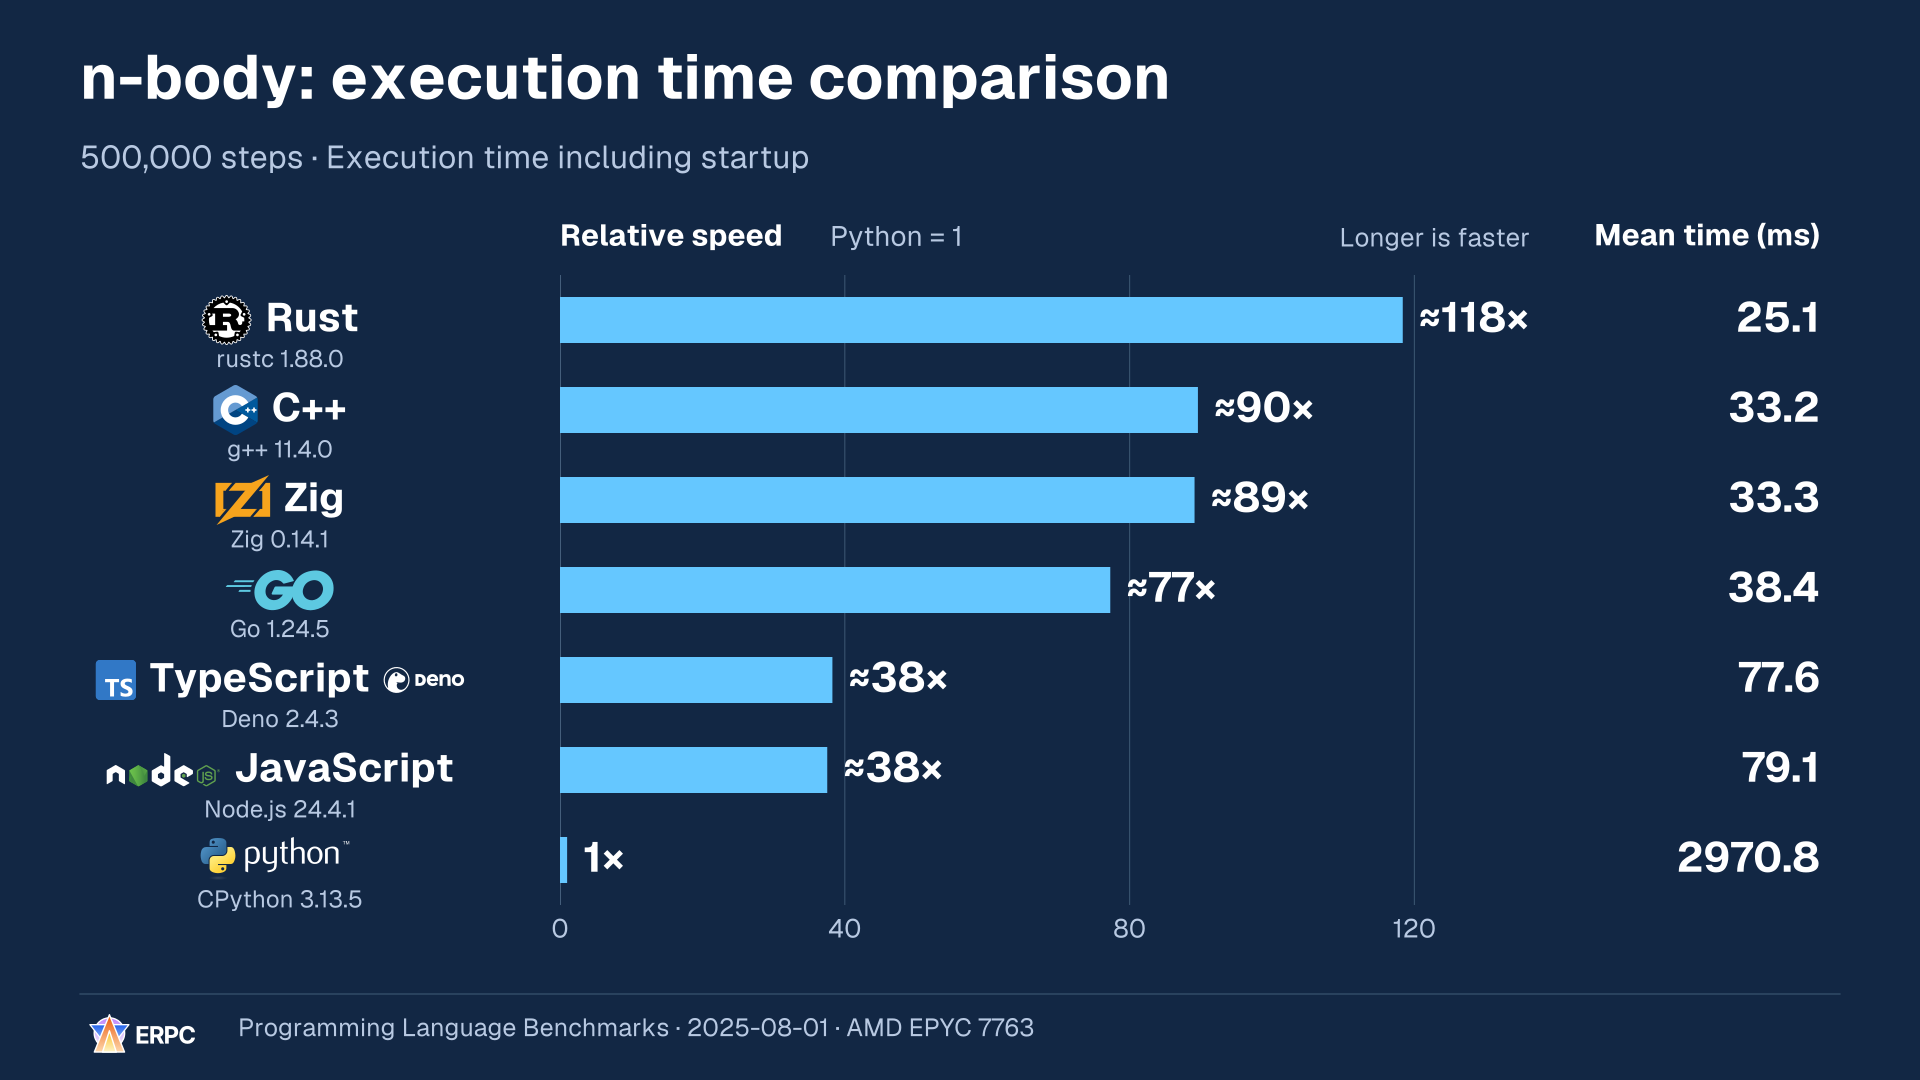
Estas medições publicadas, datadas de 1º de agosto de 2025, executam um cálculo de cinco corpos por 500.000 passos. O tempo médio de execução é a média do tempo entre a inicialização do programa e a conclusão. Inclui a inicialização e a otimização do código durante a execução, mas exclui a compilação prévia. 1.000 ms equivalem a um segundo.[27][29]
| Linguagem / runtime | Tempo médio de execução | Velocidade relativa (Python = 1) |
|---|---|---|
| Rust / rustc 1.88.0 | 25.1 ms | ≈118 |
| C++ / g++ 11.4.0 | 33.2 ms | ≈90 |
| Zig / Zig 0.14.1 | 33.3 ms | ≈89 |
| Go / Go 1.24.5 | 38.4 ms | ≈77 |
| TypeScript / Deno 2.4.3 | 77.6 ms | ≈38 |
| JavaScript / Node.js 24.4.1 | 79.1 ms | ≈38 |
| Python / CPython 3.13.5 | 2970.8 ms | 1 |
As velocidades relativas são calculadas com os tempos médios sem arredondamento, com Python = 1. Para cada família de linguagem e runtime, selecionamos a menor média publicada entre implementações estáveis cujo cálculo numérico usa uma thread, sem intrínsecos SIMD explícitos, tipos vetoriais ou bibliotecas numéricas externas. O código e as otimizações diferem; Zig usa ReleaseFast. TypeScript roda como um executável que contém Deno/V8, enquanto JavaScript roda no Node.js.[28]
Leia valores próximos como resultados comparáveis, sem transformar essa única tarefa em uma classificação geral das linguagens. Ela não mede diretamente o tempo de processamento de um bot que continua rodando após a inicialização nem o atraso até uma ordem chegar ao destino.
O ambiente registrado é Linux em um AMD EPYC 7763 com quatro núcleos disponíveis. O código de medição publicado está configurado para três repetições por condição e inicia um novo processo a cada vez. Não foi possível verificar o commit exato da execução histórica nem as observações brutas individuais; por isso, apresentamos as médias publicadas.[28][29]
Comparar os pontos fortes do projeto em seis dimensões
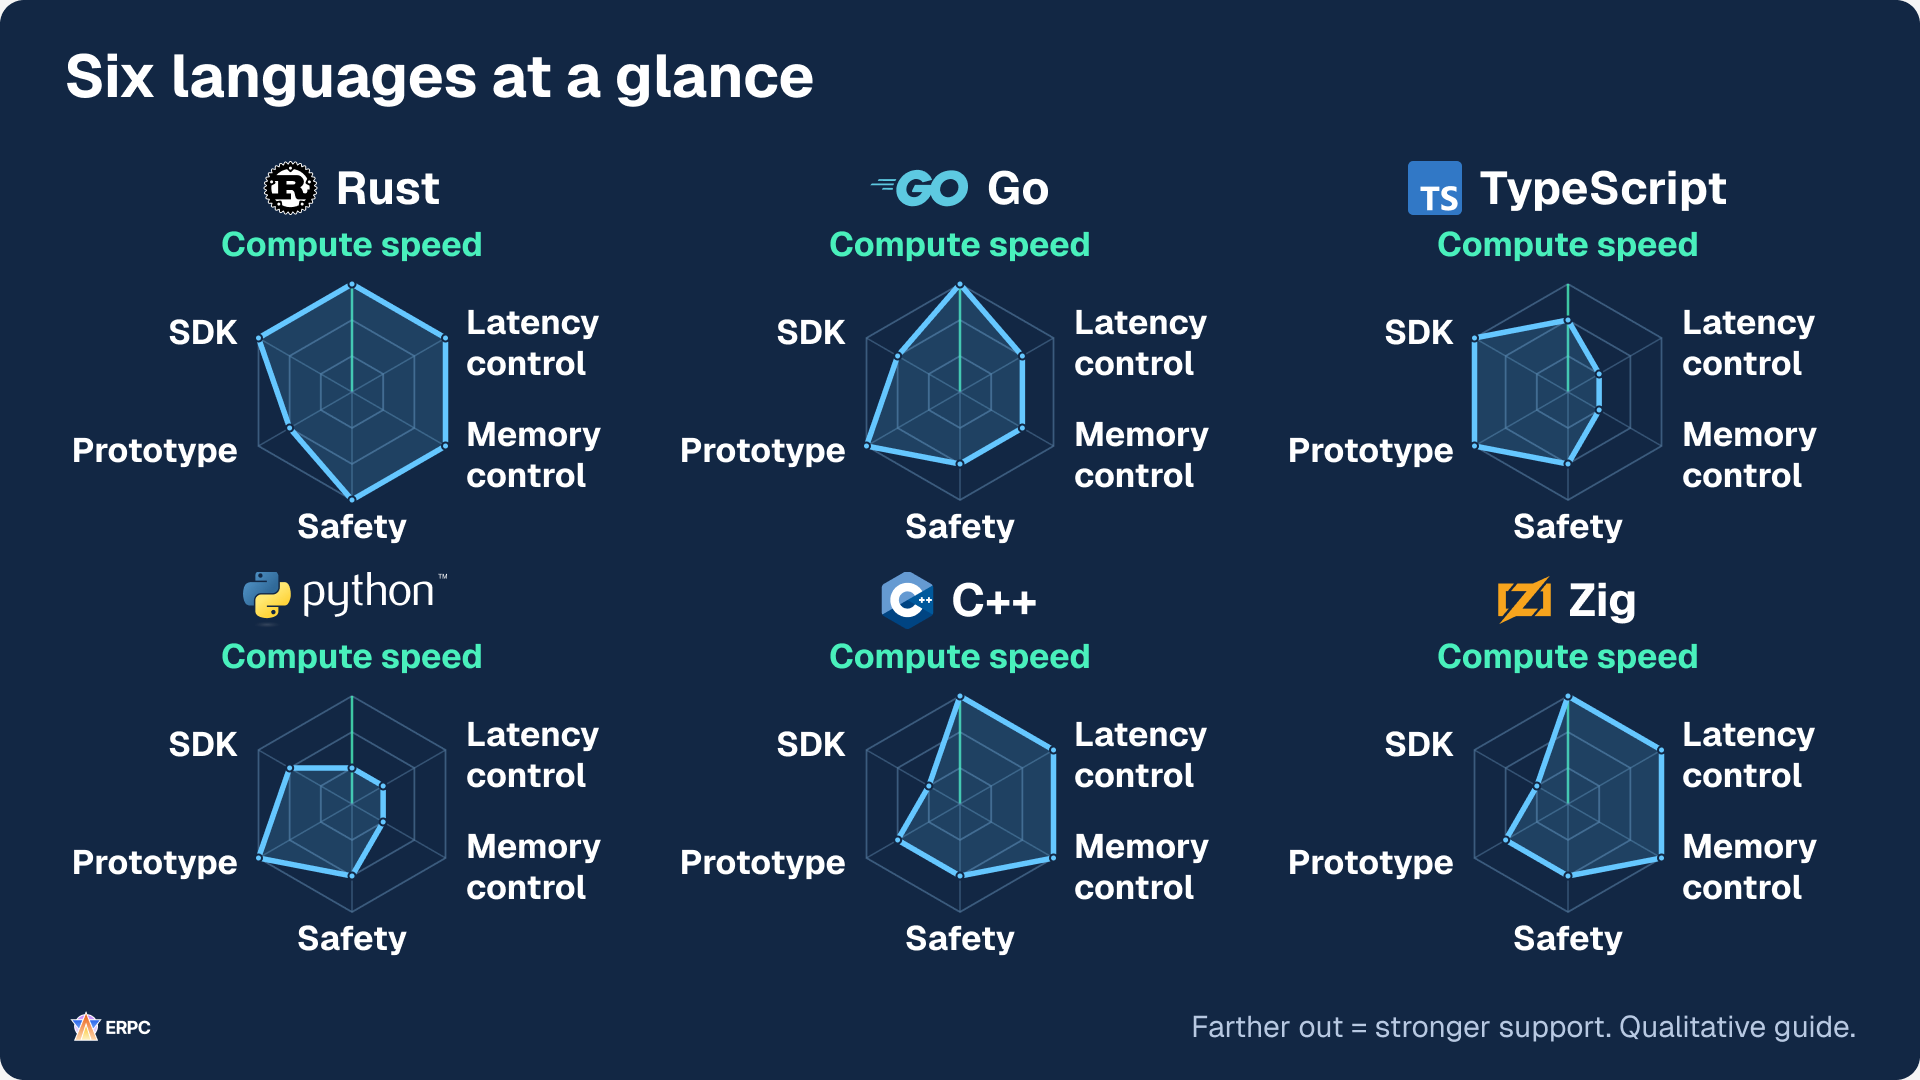
Os diagramas a seguir são guias editoriais de seleção em três níveis para um cliente Solana fora da cadeia. A dimensão Velocidade de cálculo considera opções para acelerar leituras intensivas de dados e cálculos escritos diretamente na linguagem e na implementação comparadas. Ela não classifica aplicações inteiras dominadas por esperas de rede nem cálculos delegados a bibliotecas externas aceleradas.
Rust, Go, C++ e Zig são candidatos fortes para execução nativa otimizada. Isso não afirma que tenham a mesma velocidade; uma ordem mais precisa exige medir a carga real. O V8 também transforma funções executadas com frequência em código de máquina. Descrever JavaScript como lento apenas porque é interpretado seria incorreto.[20][21]
Três dimensões, Velocidade de cálculo, Controle de latência e Controle de memória, descrevem cálculo e controle. Apoio à segurança, Facilidade de prototipagem e SDK Solana descrevem o apoio ao desenvolvimento. Nem todos os seis eixos representam velocidade de processamento.
Todos os hexágonos usam os mesmos eixos e a mesma escala. Quanto mais para fora, maior é o ponto forte qualitativo naquela dimensão. Não são velocidades nem proporções medidas: o nível 3 não significa três vezes o nível 1. Compare separadamente as dimensões que você quer melhorar, em vez de tratar a área do polígono como uma pontuação geral.
| Dimensão | O que compara |
|---|---|
| Velocidade de cálculo | Opções para acelerar leituras intensivas de dados e cálculos próprios dentro da implementação comparada |
| Controle de latência | Até que ponto tarefas como alocação e recuperação de memória e otimização de código durante a execução podem ser mantidas diretamente fora do processamento importante, para limitar atrasos repentinos |
| Controle de memória | Até que ponto você pode projetar diretamente a disposição dos dados, sua propriedade e tempo de vida, alocação, reutilização e recuperação de memória |
| Apoio à segurança | Apoio de recursos da linguagem, ambientes de execução e ferramentas padrão para evitar erros de tempo de vida e memória compartilhada |
| Facilidade de prototipagem | Facilidade para executar uma aplicação pequena e testar alterações; uma avaliação editorial que depende da experiência e do código existente |
| SDK Solana | Facilidade com que a documentação oficial da Solana leva a SDKs de cliente e exemplos para o uso pretendido |
As dimensões de controle avaliam opções diretas de projeto, a segurança avalia o apoio disponível e a dimensão SDK avalia o caminho oferecido pela documentação oficial. O mesmo nível pode representar mecanismos e garantias diferentes.[8][13][20][21][26]
A visão geral compara seis linguagens em três colunas e duas linhas: Rust, Go, TypeScript, Python, C++ e Zig. Compare as dimensões importantes para você e depois consulte os diagramas individuais e as explicações abaixo para verificar as premissas sobre o ambiente de execução e os usos adequados.
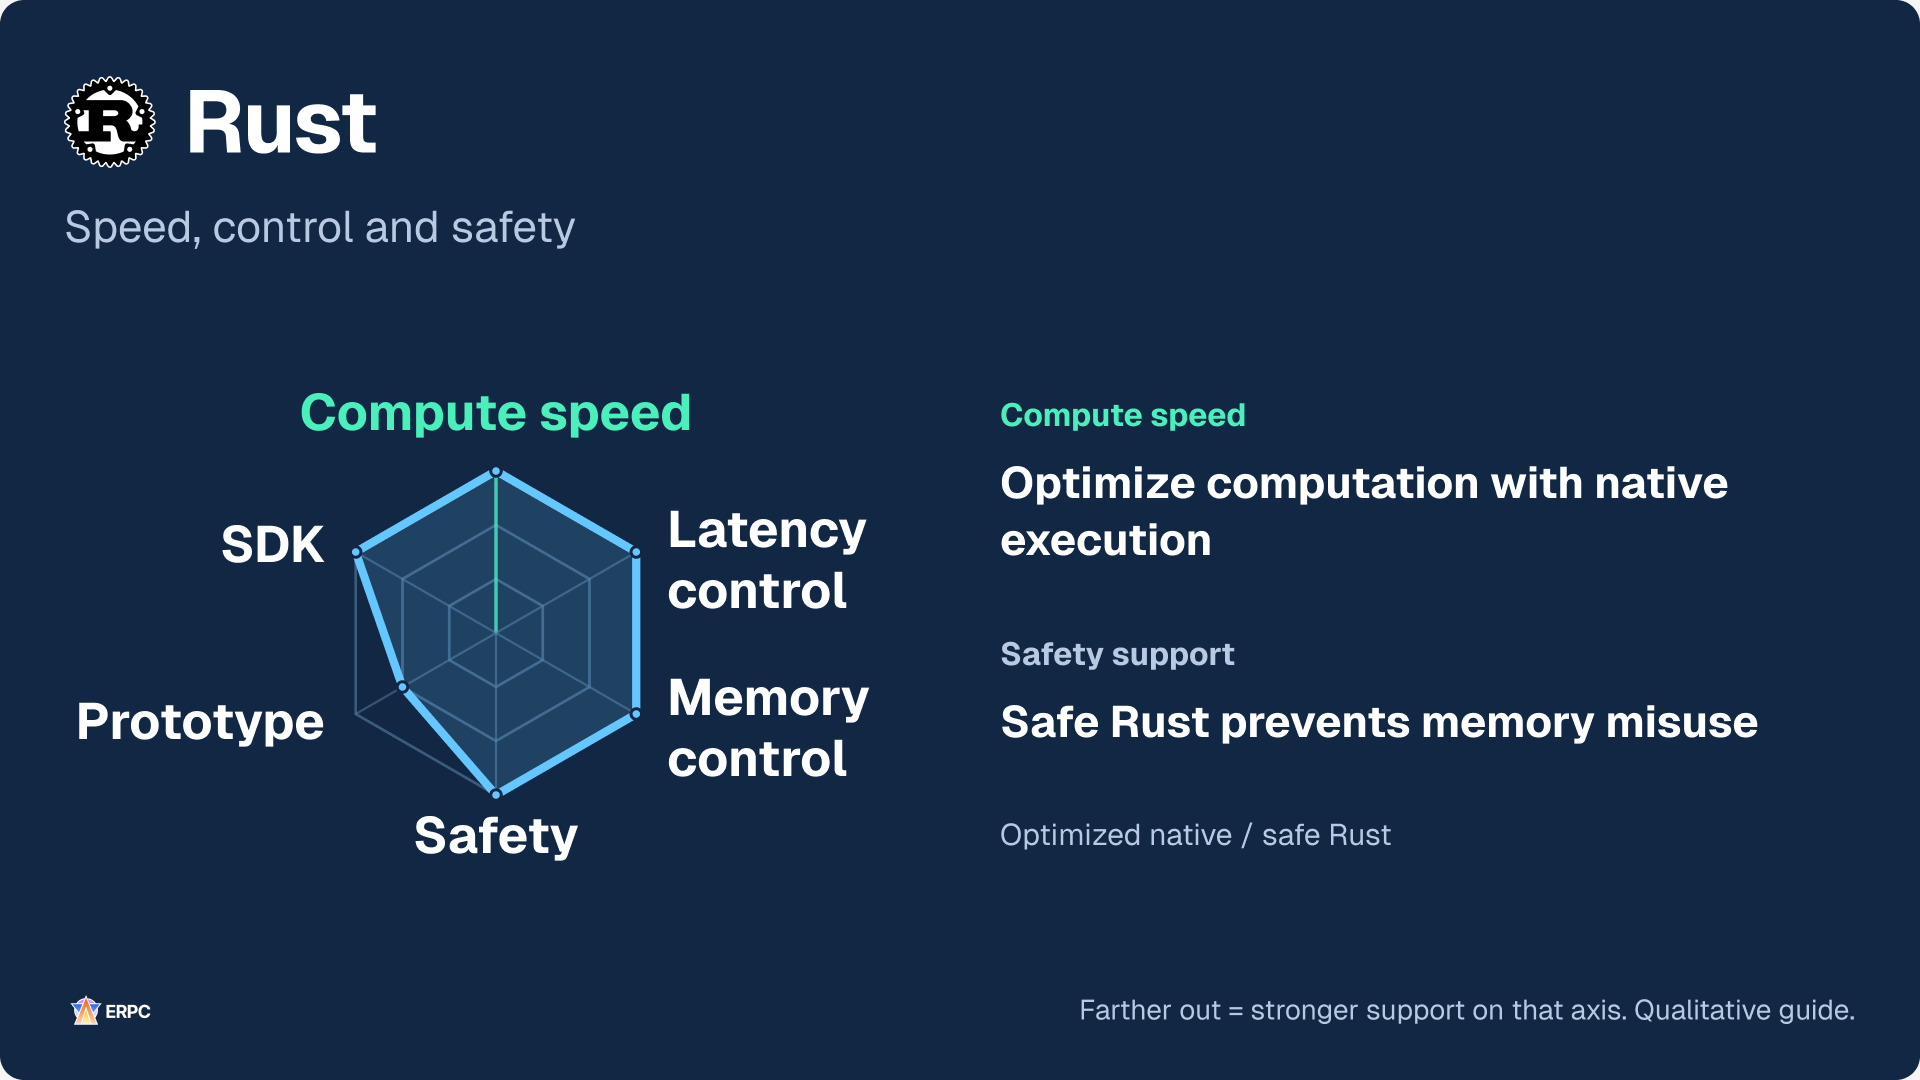
Rust combina controle de disposição, alocação e reutilização nos caminhos importantes com verificações de propriedade e empréstimo. Sua gestão normal de memória não exige GC por rastreamento.[8] As garantias de Safe Rust contra data races não garantem ausência de condições de corrida gerais, deadlocks ou lógica de decisão incorreta. Código unsafe e interfaces com outras linguagens exigem verificação separada.[22] Cópias, alocações, liberações, bloqueios e esperas do sistema operacional continuam ocorrendo; por isso, teste com as entradas e a carga reais.
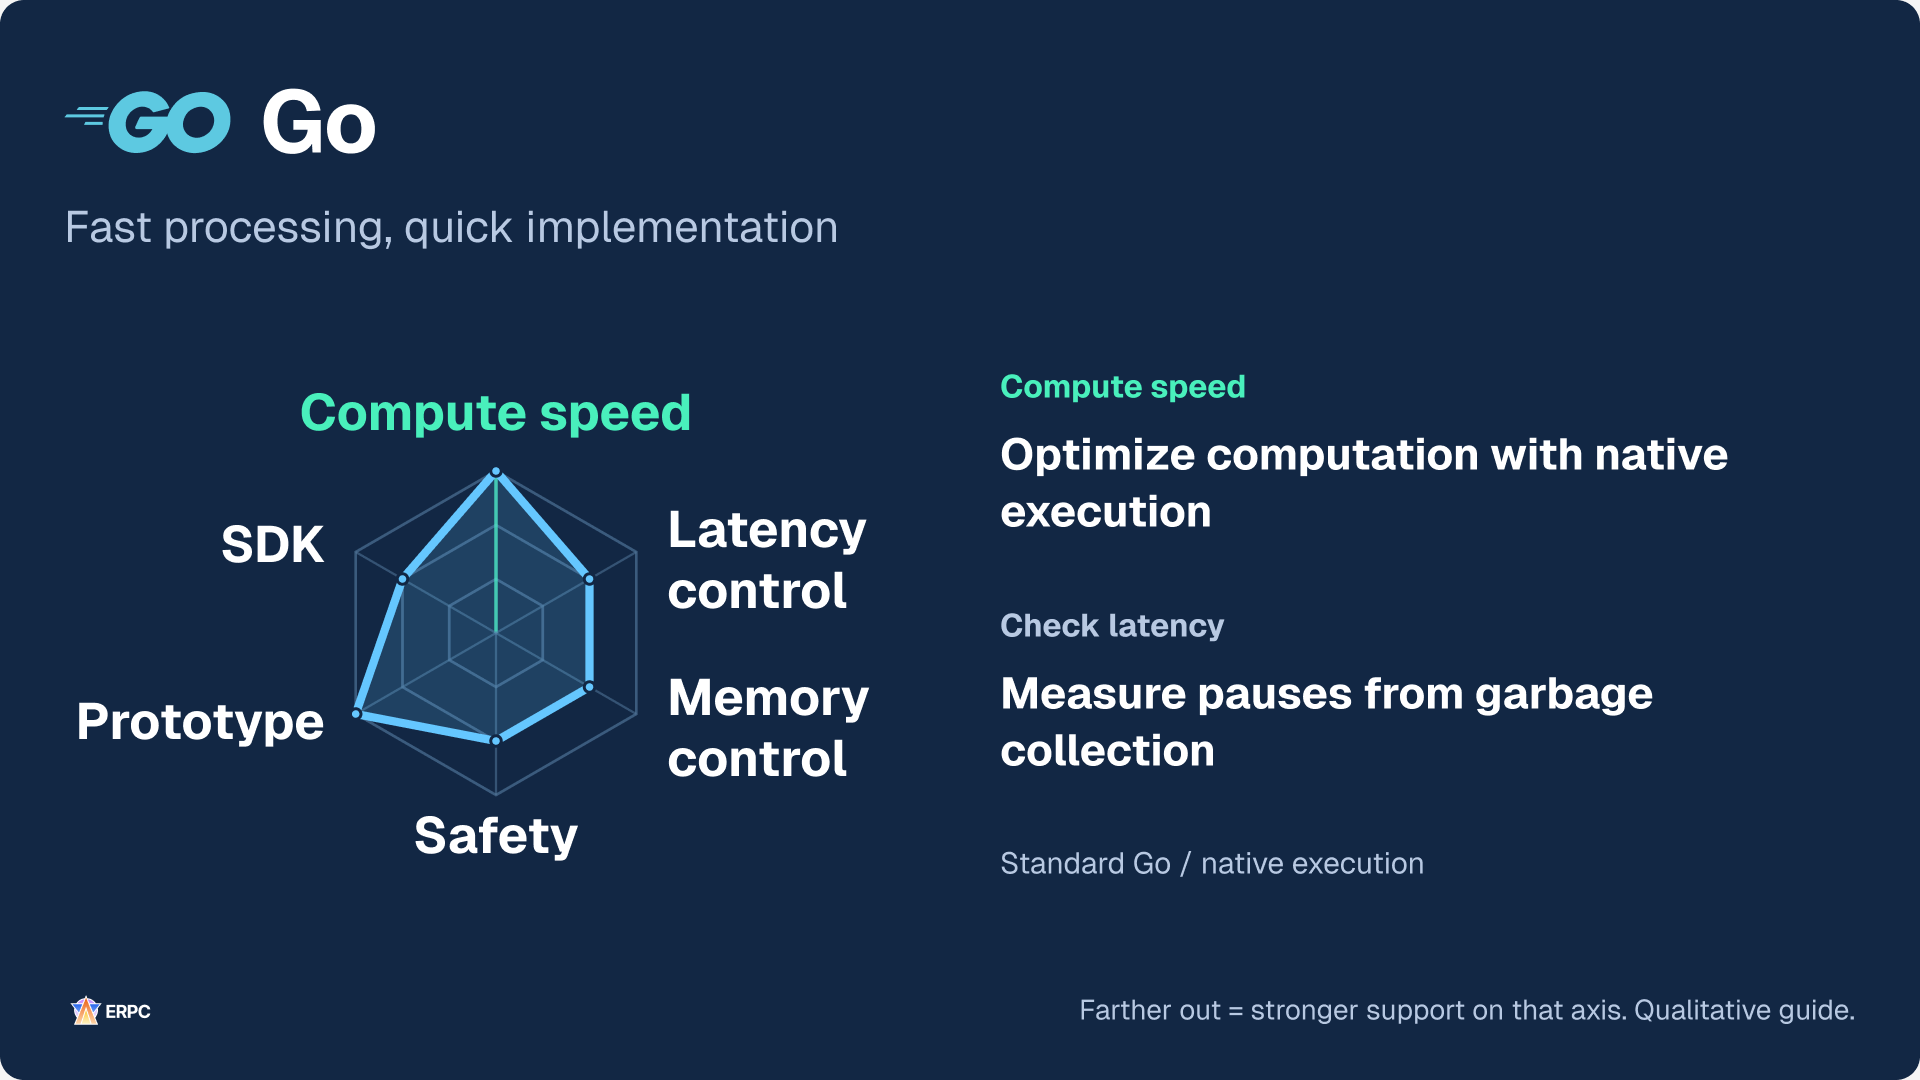
Go também é um candidato para execução compilada nativa. Ele facilita a construção de serviços e processamento concorrentes, enquanto seu ambiente de execução cuida da gestão de memória e de outras operações.[20] A maior parte do trabalho do GC ocorre de forma concorrente, mas é necessário medir as alocações e os custos da coleta em CPU, memória e latência. O potencial de processamento CPU é uma questão distinta do controle direto sobre o momento de liberar memória.[13]
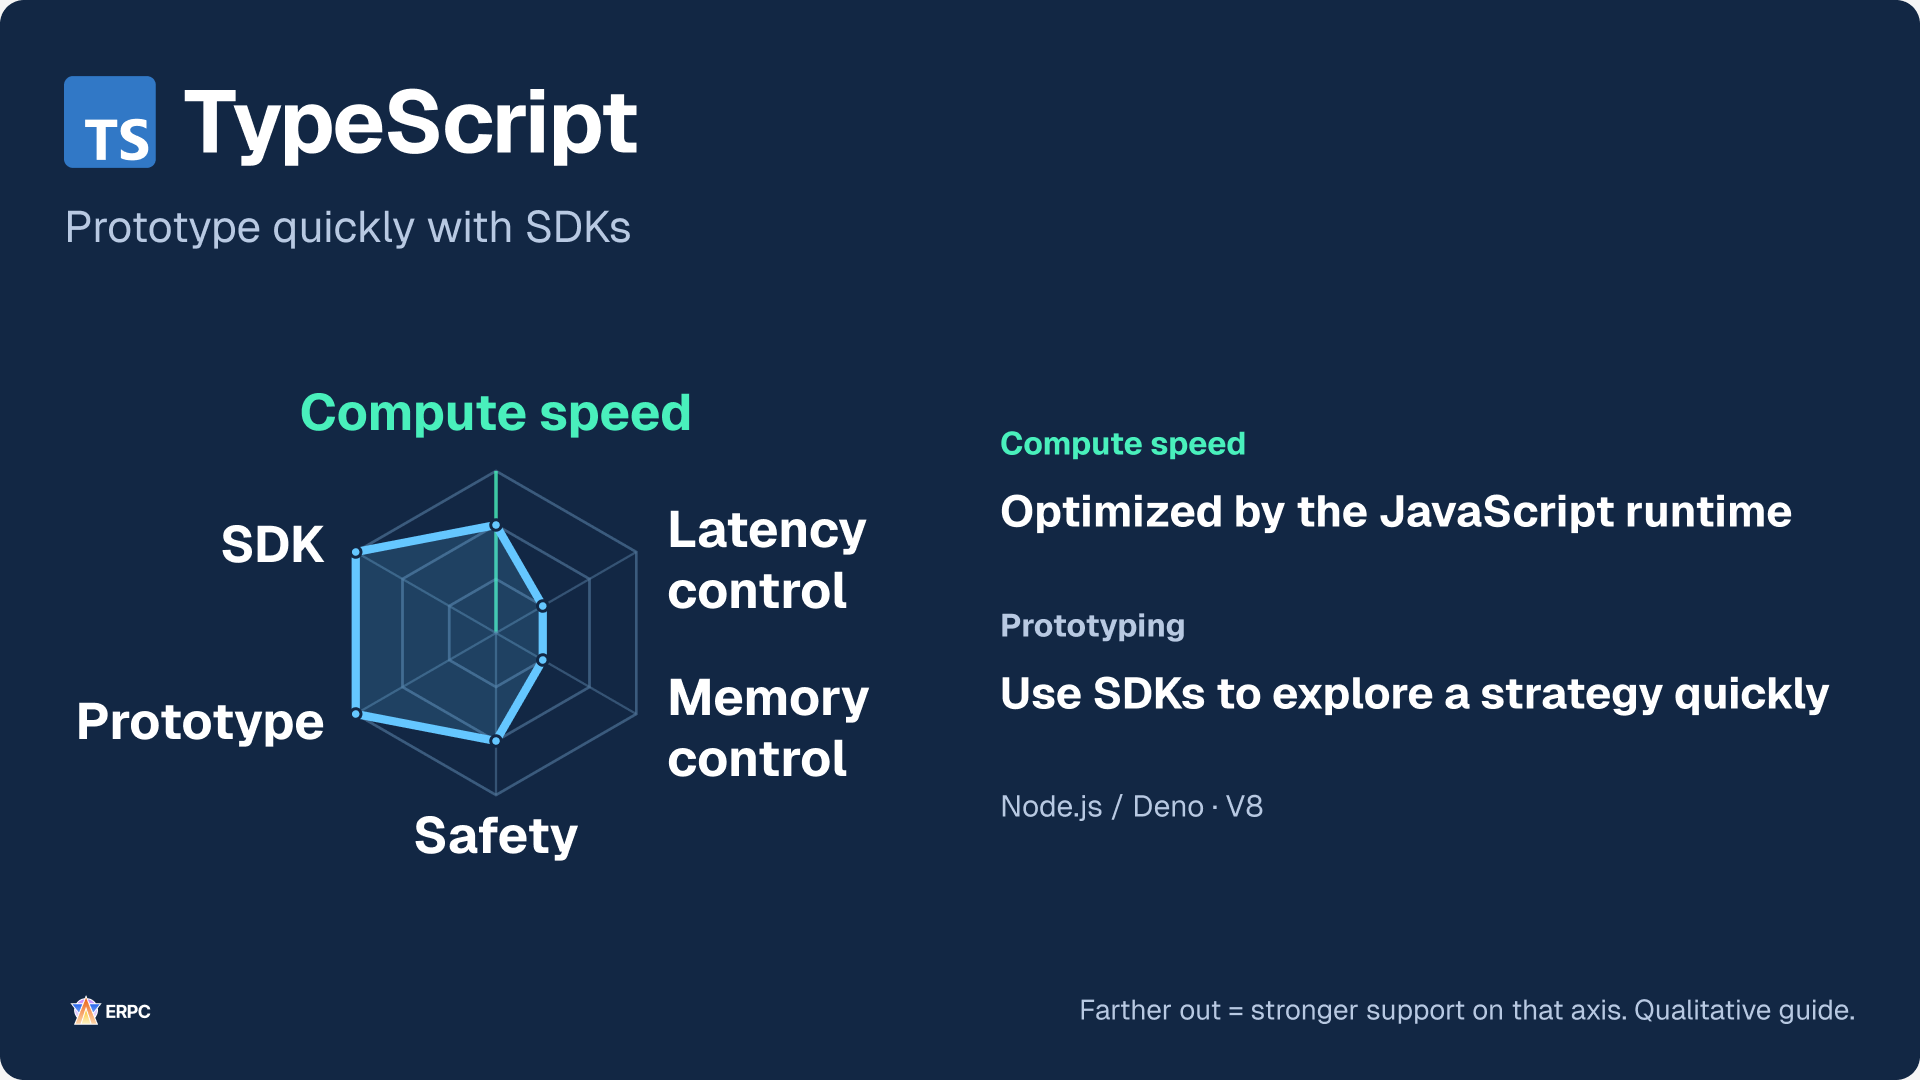
TypeScript é uma linguagem; Node.js e Deno são ambientes de execução. Este diagrama considera JavaScript executado pelo V8. As anotações de tipos são removidas na execução, portanto adicionar tipos não acelera, por si só, o trabalho de CPU. Dados externos continuam exigindo validação em tempo de execução.[9][10][21] Essas opções podem atender integração de APIs, configuração, monitoramento, interfaces Web e processamento de fluxos que cumpra o desempenho exigido.
Node.js worker_threads e Deno Web Workers podem mover trabalho de CPU para outro contexto de execução. A documentação do Node.js recomenda um pool de workers em vez de criar um worker para cada tarefa. Inclua conversão, cópia e espera para entregar o trabalho, além do cálculo no destino.[11][12]
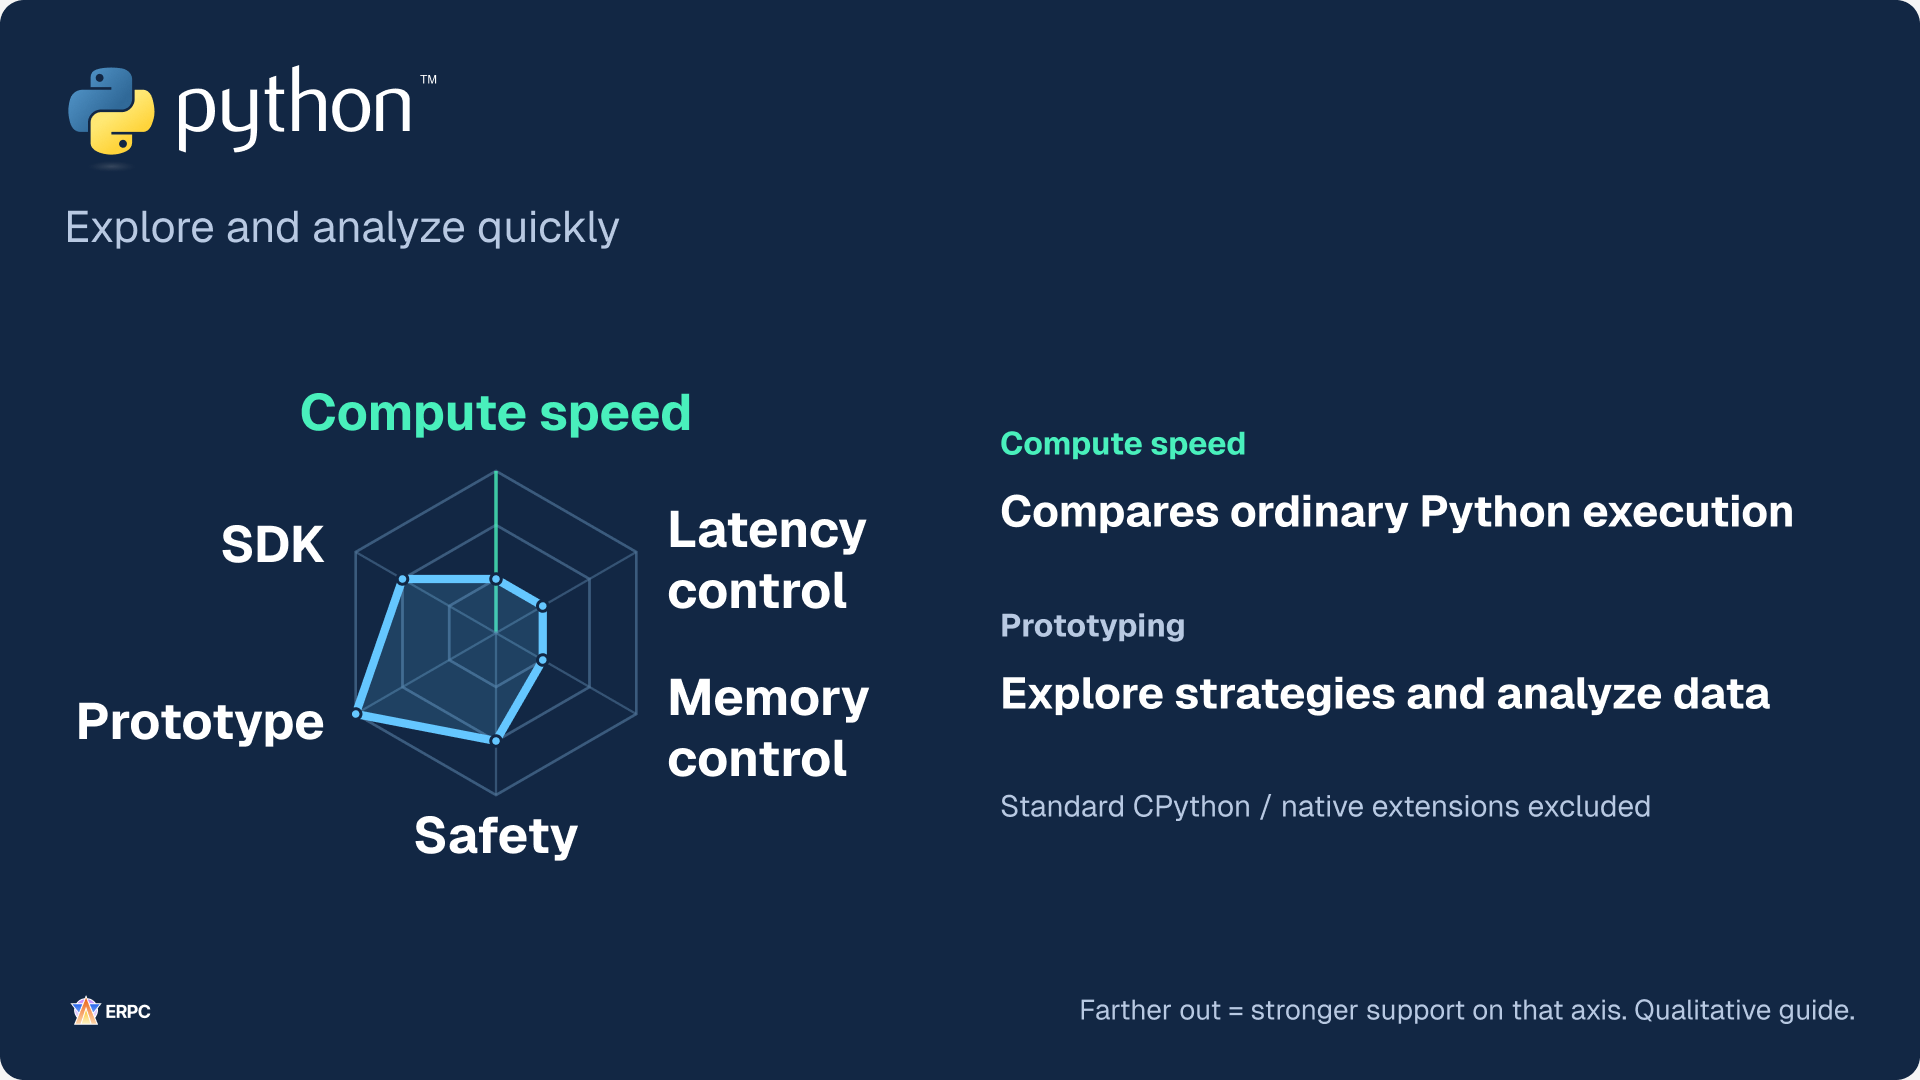
Python é um candidato para pesquisa, análise, validação e trabalho com bibliotecas existentes. A avaliação CPU aqui diz respeito a laços escritos em Python e executados dentro do CPython comum. Cálculos delegados a código compilado, como operações NumPy, são um caso diferente.[23] Verifique a configuração real, incluindo compilações free-threaded, em vez de decidir apenas pelo nome da linguagem.[14] Se mover uma parte para Rust ou outra implementação, meça conversões e cópias na fronteira e verifique o benefício para a aplicação inteira.
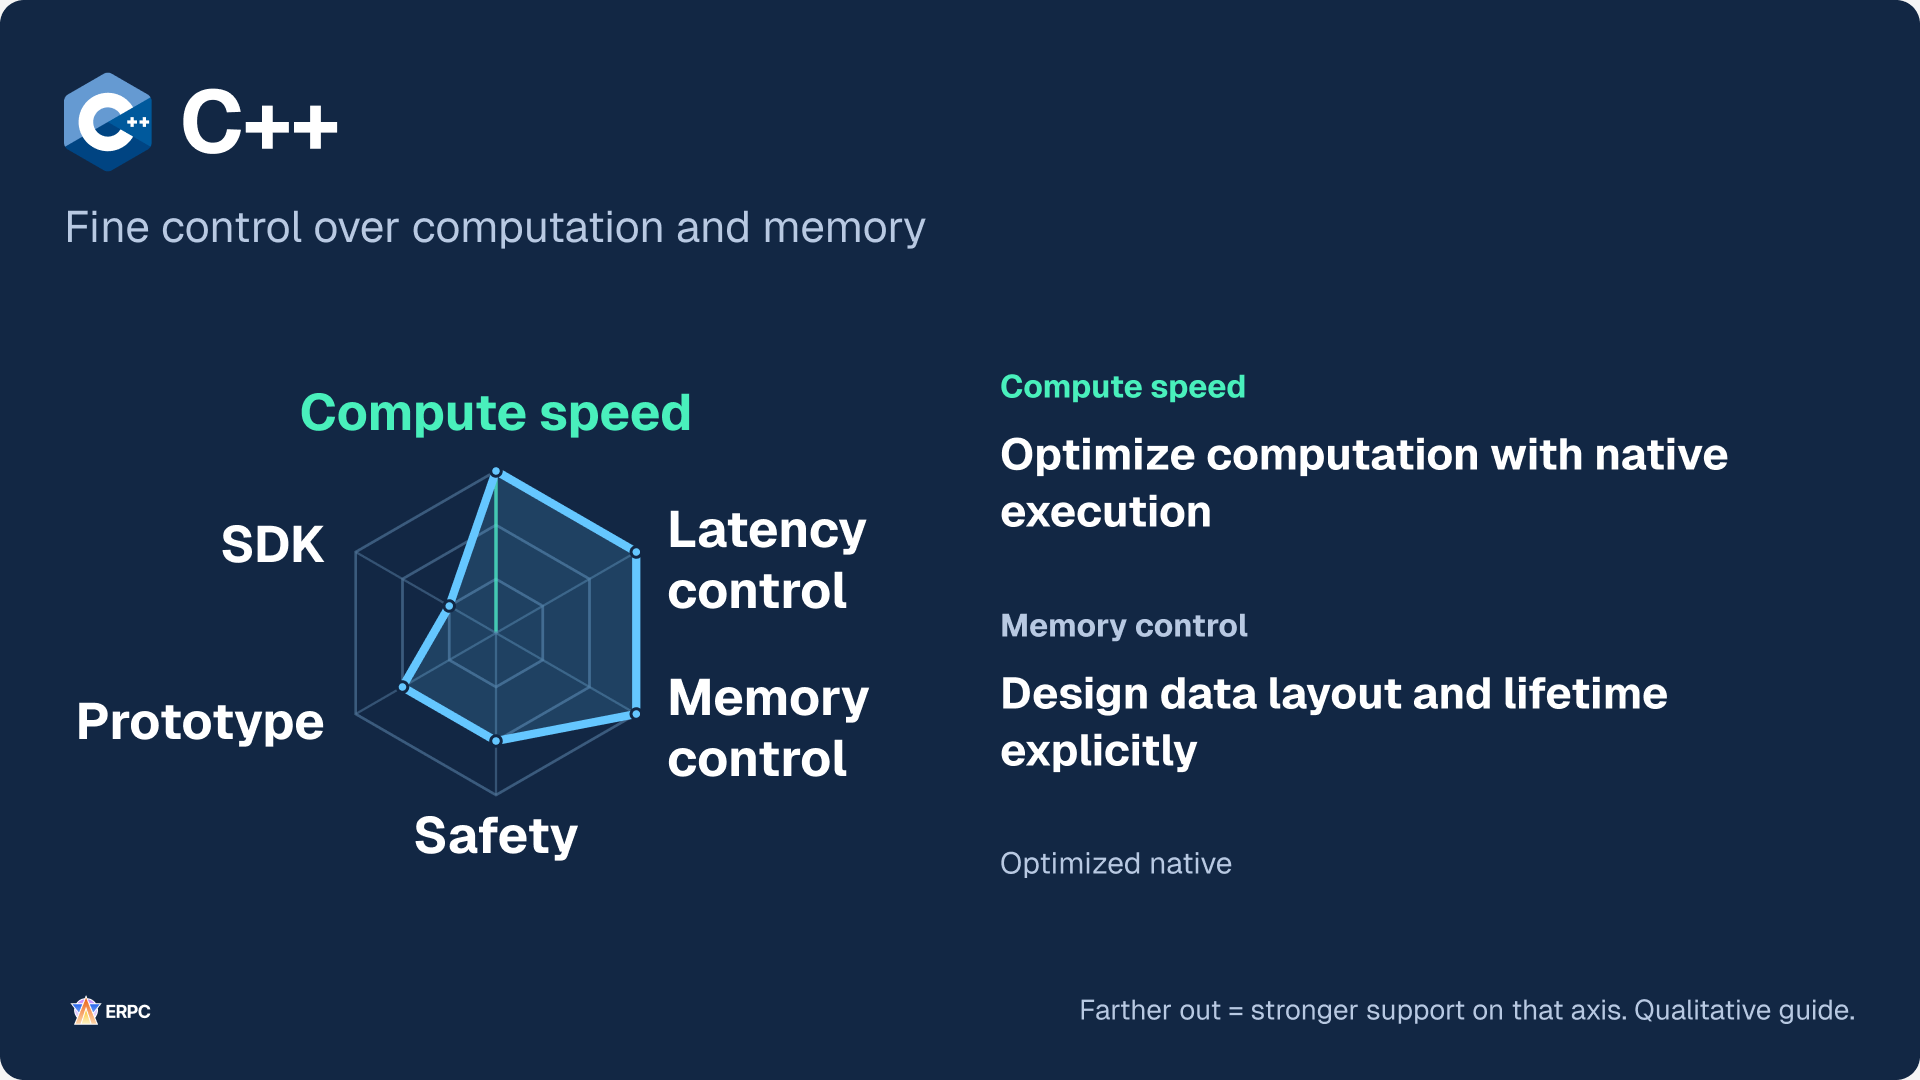
C++ combina controle de baixo nível com abstrações e bibliotecas existentes. RAII e ponteiros inteligentes ajudam a gerenciar o tempo de vida dos recursos, mas seu uso não garante toda a segurança dos tempos de vida ou da memória compartilhada.[24] Seu nível intermediário de segurança também não implica as mesmas garantias que a memória gerenciada em opções como Go.
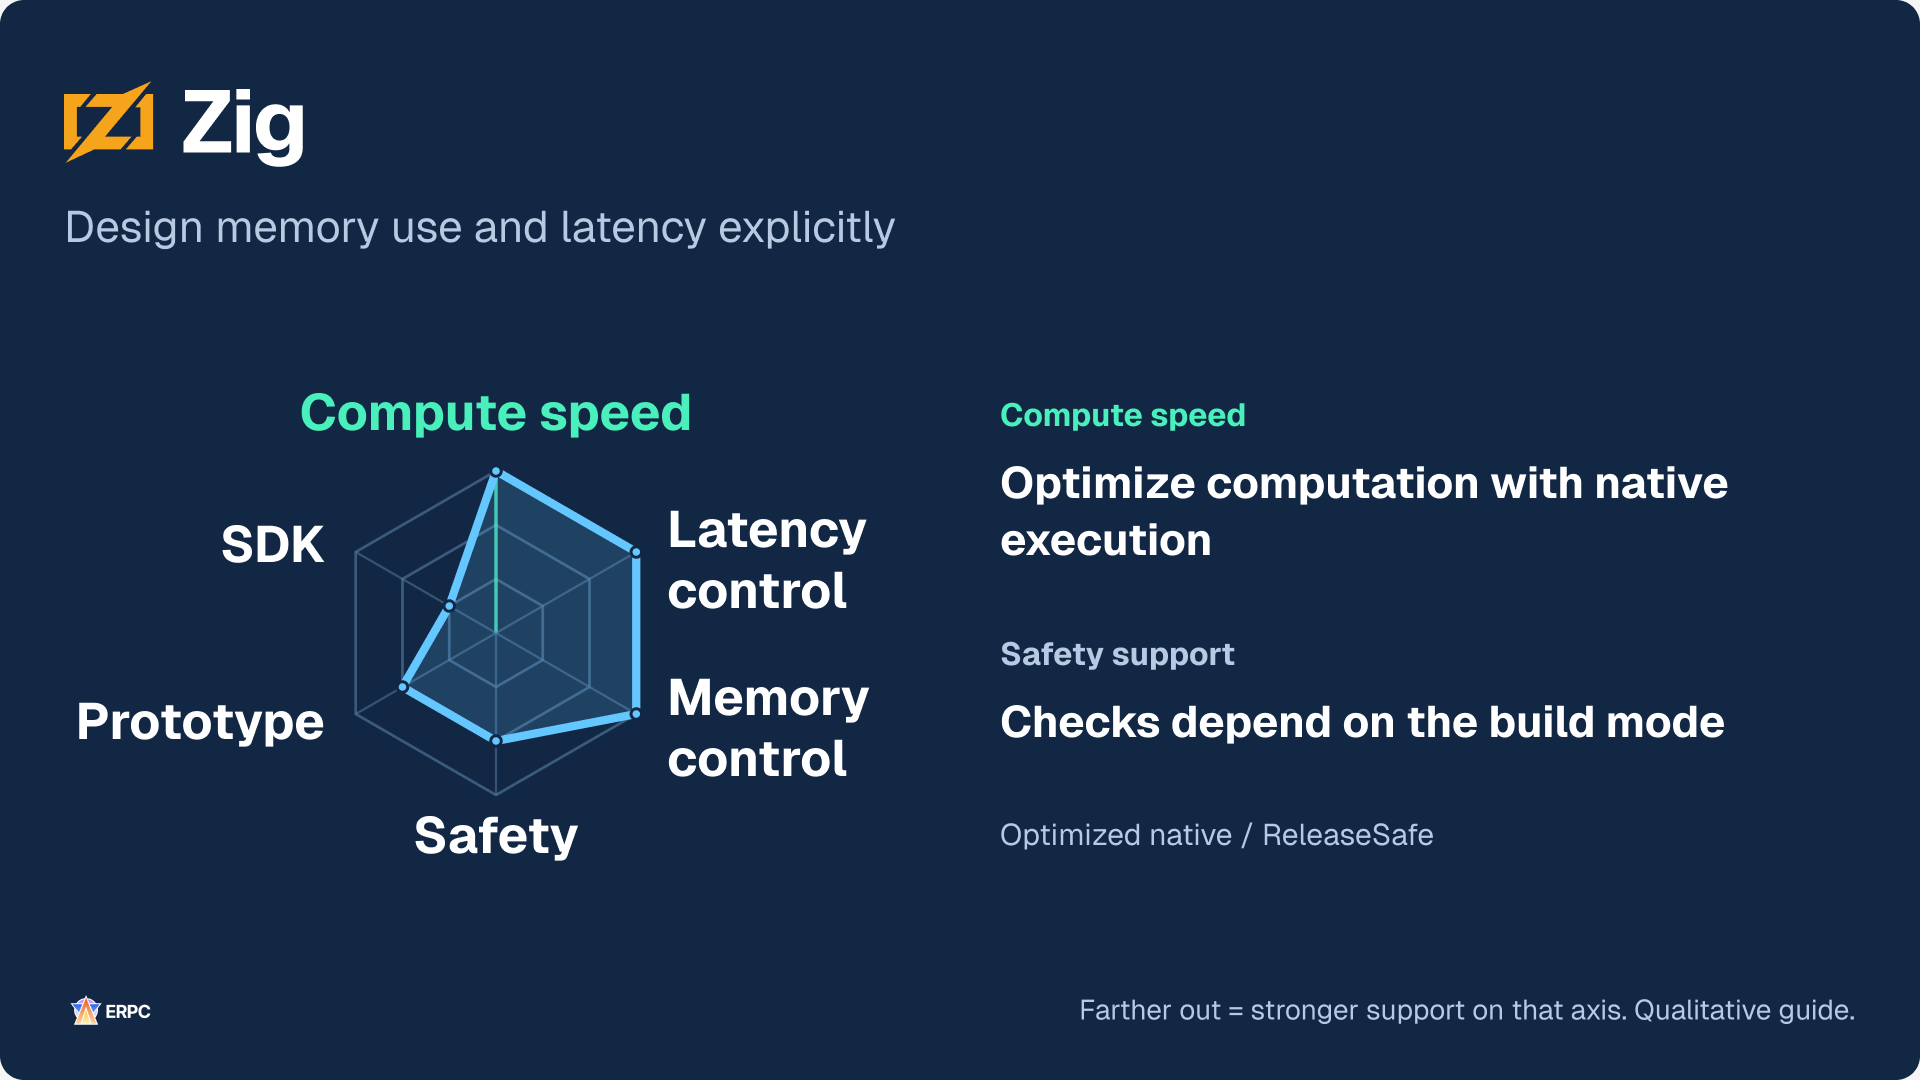
Zig permite estruturar explicitamente a alocação e a escolha do alocador. Este perfil pressupõe as verificações de ReleaseSafe. ReleaseFast e ReleaseSmall têm verificações padrão diferentes, e ReleaseSafe não detecta todas as formas de comportamento inválido.[25] Compartilhar a forma do polígono com C++ não significa ter mecanismos idênticos.
A dimensão SDK Solana usa os caminhos da documentação oficial para TypeScript e Rust e os clientes Go e Python listados ali. Ela não classifica a quantidade geral ou a qualidade das bibliotecas nem afirma que C++ e Zig não tenham bibliotecas. No SDK escolhido, verifique as APIs necessárias, o acompanhamento da manutenção e a compatibilidade com o ambiente de execução selecionado, incluindo Deno.[26]
Meça onde sua aplicação gasta tempo e selecione os pontos fortes necessários para aquela parte. Reduza primeiro as esperas e o trabalho repetido na linguagem atual. Se for necessário um controle mais preciso, mover a parte relevante para outra linguagem continua sendo uma opção.
Compare as mudanças nas mesmas condições
As instruções de cada seção abrangem a implementação e a validação da respectiva melhoria. Se aplicar várias melhorias, mantenha a relação entre cada mudança e seus resultados de medição. Aplicar mudanças em conjunto dificulta distinguir qual delas afetou cada resultado.
Compare antes e depois com as mesmas entradas, condições de subscrição dos dados, carga e requisitos de saída. Para o tempo entre recepção e conclusão da decisão, observe a mediana p50 junto com p95 e p99. O p99 é um limite dentro do qual 99% dos eventos medidos terminam. Ele ajuda a observar a parte mais lenta da distribuição além do processamento típico.
Somar o p99 de cada etapa não produz o p99 de ponta a ponta. Meça diretamente, para cada evento, a duração completa entre recepção e conclusão da decisão, junto com esperas em filas, uso de CPU e memória, atualizações ausentes ou descartadas e concordância dos resultados das decisões.
Para medir tempo decorrido no mesmo host, use um relógio monotônico que não retroceda quando a hora civil for corrigida. Se um SDK chama um callback apenas após decodificar os dados, houve processamento antes do início do callback. Indique exatamente onde cada medição começa e termina para distinguir a latência de entrega da latência da aplicação.
Confira também o que acontece depois do envio. Uma resposta de sucesso de sendTransaction não garante processamento nem confirmação pelo cluster.[15] Relacionar recepção, decisão, aceitação do envio e resultado observado na blockchain ajuda a identificar o próximo ponto de melhoria.
Transforme entrega rápida em decisões no prazo
Tanto a entrega rápida quanto uma aplicação que conclua as decisões necessárias a tempo são importantes. A ERPC continua melhorando sua infraestrutura de entrega e produzindo informações que ajudam a melhorar o software executado sobre ela.
Valide primeiro as mudanças da aplicação no mesmo ambiente. Depois, quando necessário, compare o mesmo código em outras localizações ou com outros recursos para distinguir seus efeitos. Ao usar a cobrança por hora da ERPC, defina previamente a hipótese, as condições de comparação e a duração do uso, e consulte preços e disponibilidade atuais no Dashboard.
Referências e links relacionados
- [1] Tokio / Tarefas intensivas de CPU e bloqueio
- [2] Node.js / Não bloquear o event loop
- [3] gRPC / Controle de fluxo
- [4] Yellowstone gRPC / Mensagens e especificações de subscrição
- [5] LMAX Disruptor / Projeto e uso
- [6] Solana / Commitment
- [7] Solana / getLatestBlockhash
- [8] Rust / Propriedade
- [9] TypeScript / Comportamento em execução e remoção de tipos
- [10] Deno / TypeScript
- [11] Node.js / Worker threads
- [12] Deno / Web Workers
- [13] Go / Coletor de lixo
- [14] Python / Free threading
- [15] Solana / sendTransaction
- [16] Yellowstone gRPC / Definições de mensagens
- [17] Rust / std::sync::Mutex
- [18] Tokio / Estado compartilhado e particionamento de mutexes
- [19] Solana / Estrutura de transações e assinaturas
- [20] Go / Perguntas frequentes
- [21] V8 / Visão geral
- [22] Rust / Data races e condições de corrida
- [23] NumPy / O que é NumPy?
- [24] C++ / Diretrizes fundamentais
- [25] Zig / Referência da linguagem
- [26] Solana / SDKs de cliente
- [27] Programming-Language-Benchmarks / nbody
- [28] Programming-Language-Benchmarks / Measurement code (2025-07-31): execution, defaults, aggregation, Zig build, Deno configuration.
- [29] Programming-Language-Benchmarks / Published measurement data (2025-08-01)
- Logotipos e fontes: Rust © Rust Foundation (CC BY 4.0, forma e cores sem alterações); Zig © Zig project (CC BY-SA 4.0, forma e cores sem alterações).
- Outros logotipos: Go © The Go Authors; TypeScript © Microsoft; Python © Python Software Foundation; C++ by Jeremy Kratz / Standard C++ Foundation; Node.js / OpenJS Foundation and Node.js contributors; Deno / Deno Land Inc..
- ERPC
- ERPC Web Dashboard