








常見問題 - Geyser gRPC 串流
問:你們的節點位於哪些區域?
我們目前在以下區域營運節點:
- 法蘭克福(FRA)
- 阿姆斯特丹(AMS)
- 倫敦(LON)
- 紐約(NY)
- 東京(TY)
- 新加坡(SGP)
- 雪梨(SYD)
ERPC 基於實際路由路徑測量網路延遲,自動選擇延遲最低的區域,而不是依賴直線距離。這種方法不僅能改善單個使用者的延遲,還能提高整體網路效率,並增強 ERPC 對潛在攻擊的全球抵禦能力。
如果您的環境未能自動選擇最佳區域,請透過 ERPC Web Dashboard 聯絡我們。
ERPC Web Dashboard: https://dashboard.erpc.global/zh-tw
問:延遲顯示 9999ms 且選擇了非最佳區域。該怎麼辦?
選擇 gRPC 區域時,ERPC 會從下列代理主機向您已註冊的 IP 傳送 ICMP 延遲探測。請允許來自所有列出來源 IP 的傳入 ICMP Echo Request。如果防火牆(ufw、雲端防火牆、安全性群組等)阻擋這些要求,測量結果可能變為
9999ms,並可能選到非最佳區域。同一區域中的多個 IP 分別屬於不同的探測主機,必須全部允許。問:我已經將 IP 加入白名單,但仍然無法連線。應該檢查什麼?
使用 Dashboard 中選取的加密 HTTPS 端點;HTTPS 使用 443 連接埠。HTTP 使用 80 連接埠,仍是未加密的低延遲選項。
兩種傳輸方式使用相同的已註冊 IP 白名單。使用 Dashboard 中選取的端點:HTTPS 使用 443,HTTP 使用 80。
- HTTPS 端點:使用 Dashboard 中選取的端點和 443 連接埠。
- HTTP 端點:使用 Dashboard 中選取的端點和 80 連接埠。
- 使用 Dashboard 中顯示的 URL,並採用
https://或http://格式。
認證基於您已註冊的 IP 位址。除非特定產品頁面明確要求,否則不要加入
x-token、token 或 Authorization 標頭。問:我以前只用過 WebSocket。我可以使用 gRPC 嗎?有示例嗎?
可以。您可以使用 SLV 快速測試並開始 gRPC 開發。
如果是無需 token 即可測試的共享端點,可以執行:
bash
請檢視我們的 gRPC 快速入門指南瞭解詳情。
問:我可以註冊兩個 IP 位址嗎?
每個訂閱可以使用一個端點。如果您希望使用兩個 IP 位址,則需要兩份獨立的訂閱。
問:過濾器有限制嗎?
Shared Geyser gRPC 具有公平使用保護,避免單一串流耗用其他 ERPC 客戶所需的資源。依目前的 Shared 規則,任何非空的
blocks map 都會被拒絕,即使是範圍已縮小的區塊請求也一樣。每個賬戶過濾器都必須包含 account、owner 或受支援的 cuckoo filter;僅有 memcmp 或 dataSize 並不足夠。請移除被拒絕的訂閱形式,只訂閱應用程式真正需要的資料。交易訂閱或區塊 metadata 也許不必傳送完整區塊就能滿足需求。當正當的工作負載超出 Shared 的訂閱形式或資源額度時,適合使用 Dedicated Geyser gRPC;但它不會讓無效的參數變得有效,也無法修復過慢的用戶端。
問:重新連線之前,應如何收集 gRPC 錯誤?
請在重連迴圈覆蓋第一個錯誤之前將它保留下來。記錄初始 metadata 與 trailer 中的 gRPC 狀態和訊息,以及
x-erpc-error-code、x-erpc-error-reason 和 x-erpc-doc-url。ERPC 指定暫停時,也請一併記錄 x-erpc-retry-after-seconds 與 x-erpc-retry-at(Unix 秒)。錯誤可能顯示為
ERPC [STREAM_GUARD_SLOW_READER]: ...。請將顯示的錯誤或其錯誤碼貼到 FAQ 搜尋中。標準說明請參閱 ERPC gRPC FAQ。連線提早結束時,不要假定 trailer 一定會送達。也可以用症狀搜尋:接收端過慢、中斷連線、頻寬、傳遞延遲、積壓、暫停、重試、無效參數、資源耗盡、權限遭拒、IP 註冊、串流過多、完整區塊或全部賬戶。
問:哪些 gRPC 錯誤會使我的連線進入暫停,我的用戶端應何時停止重新連線?
暫停是 ERPC 在發生某些錯誤後設定的一段有時限的期間。暫停期間,用戶端不得重新連線。
哪些會被計入。 下列錯誤會被計入,並共用同一組階段:
- ERPC 以
ERPC_GRPC_INVALID_ARGUMENT、STREAM_GUARD_SHAPE_BLOCKS或STREAM_GUARD_SHAPE_ACCOUNTS_ALL拒絕的每一個 Subscribe 請求,包括第一個在內。第一個計入的錯誤是警告,不會開始暫停。 STREAM_GUARD_SLOW_READER。不過,如果傳遞延遲發生在 ERPC 這一側,ERPC 會關閉串流但不計入,錯誤中也不帶重試時間。
下列項目不計入:重新連線本身、四個
STREAM_ADMISSION_* 錯誤碼(STREAM_ADMISSION_LIMIT_REACHED、STREAM_ADMISSION_IP_NOT_ADMITTED、STREAM_ADMISSION_SOURCE_UNAVAILABLE 與 STREAM_ADMISSION_SNAPSHOT_UNAVAILABLE),以及在暫停期間發生的任何本應計入的錯誤。暫停期間發生的這類錯誤不會延長該暫停,也不會推進到下一個階段。階段。 每一個計入的錯誤都會依下列順序前進一個階段,從警告開始:
- 警告:不暫停。
- 暫停 60 秒。
- 暫停 300 秒。
- 暫停 1800 秒。
- 暫停 86400 秒(24 小時)。這是最後一個階段:到了此階段,每一個計入的錯誤都會再開始一次 86400 秒的暫停。
處於警告階段時,下一個計入的錯誤只有在警告後 1 小時內發生,才會進入 60 秒的暫停。若計入的錯誤發生在警告後超過 1 小時,它就是另一個不暫停的警告,1 小時的計算區間改從這個新的警告起算。
若計入的錯誤發生在上一個被計入的錯誤之後不到 60 秒,它會被視為那個錯誤的一部分,不推進任何階段。
階段何時回到警告。 一旦階段已開始暫停,必須從上一次暫停結束起,經過 24 小時既沒有計入的錯誤也沒有暫停,階段才會回到警告;此後的下一個計入的錯誤是不暫停的警告。在此之前,下一個計入的錯誤會立即開始下一個階段,不會先有警告。
Egress 暫停。
STREAM_GUARD_EGRESS_BUDGET 會開始一段獨立、固定為 600 秒的暫停。它不會推進階段。結束時間在哪裡。
- 開始暫停的錯誤會帶有
Retry after N seconds.以及標頭x-erpc-retry-after-seconds與x-erpc-retry-at(Unix 秒)。警告不帶重試時間。 - 當開始暫停的正是那個計入的被拒絕請求時,它會以
STREAM_GUARD_SHAPE_REJECT_PENALTY與ResourceExhausted (8)傳回,而不是它自己的錯誤碼。 - 在 slow-reader 或 egress 暫停期間,重新連線會收到
STREAM_GUARD_PENALTY_ACTIVE與剩餘時間。 - 在由被拒絕請求開始的暫停期間,新的連線會被立即關閉,不帶 gRPC 狀態,也不帶 ERPC 錯誤碼。在仍開啟的連線上,請求可能在該連線關閉前再次收到
STREAM_GUARD_SHAPE_REJECT_PENALTY與剩餘時間。用戶端可能再也看不到結束時間,因此必須從第一個帶有x-erpc-retry-at的錯誤中儲存它。
用戶端必須做什麼。 遇到計入的錯誤時,停止重連迴圈,不要重新傳送同一個請求,並修正它。暫停期間,不要在
x-erpc-retry-at 的時間之前重新連線。被拒絕的 Subscribe 請求會依上述規則計入,重新連線則不會。問:接收端過慢而被中斷連線時,STREAM_GUARD_SLOW_READER 與 ResourceExhausted (8) 代表什麼?
ERPC 觀察到此串流的寫入進度不足,或出現傳遞延遲。僅憑傳遞延遲無法判定原因。請檢查網路封包遺失、實際可用頻寬、主機硬體,以及應用程式的消費端是否跟得上。請縮小訂閱的資料,並將處理工作移出接收迴圈,交給有界佇列。有界佇列能限制記憶體用量,但無法解決持續性的消費端過慢問題。若 ERPC 提供了重試截止時間,請等到該時間再重新連線。下方的問題「為什麼我的 gRPC 串流速度一直停在同一水準,而且越來越落後?」說明了接收視窗,以及如何在用戶端的函式庫中調大它。
問:為什麼我的 gRPC 串流速度一直停在同一水準,而且越來越落後?
用戶端或用戶端與 ERPC 之間某個環節的接收視窗較小,可能導致
STREAM_GUARD_SLOW_READER 中斷連線以及之後的暫停。本回答說明什麼是接收視窗、如何判斷它是否限制了您的串流,以及如何在各函式庫中調大它。上方的問題「哪些 gRPC 錯誤會使我的連線進入暫停,我的用戶端應何時停止重新連線?」列出了各階段及其時長。什麼是接收視窗。 在 HTTP/2 中,接收方會告訴傳送方:在接收方確認之前,最多可以傳送多少資料;這個量就是接收視窗(HTTP/2 flow control window)。一次往返最多只能傳輸一個視窗的資料,因此速度的上限大約是視窗除以往返時間(到端點再返回所需的時間)。
其他限制。 視窗有兩個:每個串流一個,每個連線一個(同一連線上的所有串流共用),較小的那個決定上限。依照 HTTP/2 規格,兩個視窗的初始值都是 65,535 位元組。TCP 接收緩衝區(存放傳入資料的記憶體)也以同樣的方式限制速度。中間的代理、負載平衡器、閘道、VPN 或 sidecar 都有自己的視窗與緩衝區。那裡的視窗或緩衝區較小時,即使您自己用戶端的視窗很大,串流也會被限速。
表現。 無論鏈上多繁忙,單一串流的速度都會穩定在幾乎相同的水準,而它的傳遞延遲會持續增加。ERPC 在一個到法蘭克福共享端點往返時間約 6 ms 的位置進行了測量,每次只改變視窗:
- 16 KiB 的串流視窗:穩定在約 2.7 MB/s(16 KiB 除以 6 ms);傳遞延遲每秒增加約 0.6 秒,45 秒時達到 26 秒。
- 兩個視窗皆為 16 MiB:傳遞延遲最大為 14 ms。
如果傳遞延遲發生在 ERPC 這一側,ERPC 會關閉串流但不計入,錯誤中也不帶重試時間。
自行檢查。
- 將串流的速度與傳遞延遲和上述模式比較。
- 測量往返時間。將串流的速度乘以往返時間來估算視窗(2.7 MB/s 乘以 6 ms 約為 16 KB)。
- 檢查用戶端的兩個視窗是否設定了較小的值,或是否關閉了自動增長(函式庫自動調大視窗)。
- 檢查 TCP 接收緩衝區。在 Linux 上執行
sysctl net.ipv4.tcp_rmem net.core.rmem_max,並查看您的應用程式是否設定了SO_RCVBUF;設定它會關閉自動調整大小。 - 檢查中間所有環節的視窗與緩衝區。
- 如果速度沒有上限、只有傳遞延遲在增加,代表接收之後的處理較慢。上方的問題「接收端過慢而被中斷連線時,
STREAM_GUARD_SLOW_READER與ResourceExhausted (8)代表什麼?」說明了如何讓接收迴圈只負責讀取,並將繁重的工作移到有界佇列。
各函式庫的設定。 範例將兩個視窗都設為 16 MiB,與 ERPC 的測量相同。對於未列出的函式庫,請尋找 HTTP/2 初始視窗的設定。
Rust,
yellowstone-grpc-client。 未設定視窗時,GeyserGrpcClient::build_from_shared 使用每個串流 2 MiB、每個連線 5 MiB。在 6 ms 的往返時間下,這些預設值可支援超過 300 MB/s,因此不會限制串流。如需自行設定視窗,請使用 builder 的兩個方法,並保持 http2_adaptive_window 關閉。若開啟它,視窗會從 65,535 位元組開始自動增長到最多 16 MiB,並忽略您設定的值。rust
TypeScript,
@triton-one/yellowstone-grpc 5.0.1 或更新版本。 預設值:每個串流 4 MiB,每個連線 8 MiB,自動增長開啟。視窗從 64 KiB 開始,最多增長到 16 MiB,因此預設值很少會限制串流。如需固定大小,請在第三個參數中傳入 grpcHttp2AdaptiveWindow: false。typescript
TypeScript,
@triton-one/yellowstone-grpc 5.0.0 或更舊版本。 這些版本使用 @grpc/grpc-js,其預設視窗為 65,535 位元組:6 ms 時約 11 MB/s,100 ms 時約 0.66 MB/s。從 1.14 版起,@grpc/grpc-js 將 'grpc-node.flow_control_window' 同時套用到兩個視窗;1.13 版只將其套用到串流視窗,因此連線視窗仍為 65,535 位元組(6 ms 時約 11 MB/s)。如果 @grpc/grpc-js 低於 1.14 版,升級到 @triton-one/yellowstone-grpc 5.0.1 或更新版本會更快。typescript
Go,
google.golang.org/grpc。 預設情況下,此函式庫會自行調大視窗,最多到 16 MiB。grpc.WithInitialWindowSize 與 grpc.WithInitialConnWindowSize 會固定視窗並關閉自動增長;低於 64 KiB 的值會被忽略。請兩個都設定:只設定一個時,另一個會維持在 64 KiB。go
Python,
grpcio。 grpc.http2.bdp_probe 預設為開啟,因此視窗會自動增長;如果您的程式碼傳入了 ("grpc.http2.bdp_probe", 0),請將其移除。grpc.http2.lookahead_bytes 設定每個串流的預讀量(預設 64 KB);往返時間較長時,較大的值可能有幫助。python
謹慎拆分。 每個已註冊的來源 IP,Standard 允許 10 個串流,Premium 允許 50 個。每個串流有自己的串流視窗,但同一連線上的串流共用一個連線視窗,因此連線視窗較小時仍會限制速度。替換串流時,請先關閉舊的:已開啟的串流會計入上限,超出上限會傳回
STREAM_ADMISSION_LIMIT_REACHED(下方有獨立的問題)。拆分並不能讓緩慢的處理變快。問:STREAM_GUARD_EGRESS_BUDGET 與 ResourceExhausted (8) 代表什麼?
來自此 IP 的總流量超過了 Shared 額度,因此相關的串流可能會一起關閉。請減少資料量與不必要的平行串流,然後等到傳回的截止時間。此 egress 暫停固定為 600 秒,不會推進暫停階段;不過,既有的更長暫停仍可能持續有效。
問:STREAM_GUARD_PENALTY_ACTIVE 與 ResourceExhausted (8) 代表什麼?
先前的 slow-reader 或 egress 暫停仍在進行中,此回應帶有剩餘時間。請保留第一個 ERPC 錯誤並修正其原因,不要在
x-erpc-retry-at 之前重新連線;也不要為了測試而提早重新連線。重新連線的嘗試不會被計入。上方的問題「哪些 gRPC 錯誤會使我的連線進入暫停,我的用戶端應何時停止重新連線?」列出了各階段及其時長。問:STREAM_GUARD_SHAPE_BLOCKS 與 PermissionDenied (7) 代表什麼?
目前的 Shared 規則會拒絕每個非空的
blocks map,即使請求範圍很窄也一樣。請移除 blocks map。如果交易和/或區塊 metadata 能滿足需求,可以改用它們,但兩者都不等同於完整區塊。需要完整區塊時,請使用 Dedicated Geyser gRPC;這並不表示有可選擇區塊的 Shared 方案。問:STREAM_GUARD_SHAPE_ACCOUNTS_ALL 與 PermissionDenied (7) 代表什麼?
賬戶過濾器項目必須以
account、owner 或受支援的 cuckoo filter 選擇資料。只有 memcmp 和 dataSize 並不足夠。請將賬戶請求縮小為上述其中一種受支援的形式;需要完整的賬戶串流時,請使用 Dedicated Geyser gRPC。問:STREAM_GUARD_SHAPE_REJECT_PENALTY 與 ResourceExhausted (8) 代表什麼?
當開始暫停的正是那個計入的被拒絕請求時,傳回的會是此錯誤碼,而不是
ERPC_GRPC_INVALID_ARGUMENT、STREAM_GUARD_SHAPE_BLOCKS 或 STREAM_GUARD_SHAPE_ACCOUNTS_ALL;上方的問題「哪些 gRPC 錯誤會使我的連線進入暫停,我的用戶端應何時停止重新連線?」說明了這種情況何時發生。它帶有 Retry after N seconds.、x-erpc-retry-after-seconds 與 x-erpc-retry-at。在此暫停期間,新的連線會被立即關閉,不帶 gRPC 狀態,也不帶 ERPC 錯誤碼,因此用戶端可能再也看不到結束時間。請從第一個帶有 x-erpc-retry-at 的錯誤中儲存它。被拒絕的 Subscribe 請求會依上述規則計入,重新連線則不會。請修正該請求,不要原封不動地重新傳送。連線提早中斷時,看起來可能像傳輸錯誤,因此請在重連迴圈把它蓋掉之前,保留第一個 ERPC 錯誤。問:STREAM_ADMISSION_LIMIT_REACHED 與 ResourceExhausted (8) 代表什麼?
准入額度目前已滿。請關閉未使用或重複的串流,檢查此連線的額度,並在有可用容量後再重試。此回應本身並不表示已有限時懲罰生效。
問:STREAM_ADMISSION_IP_NOT_ADMITTED 與 PermissionDenied (7) 代表什麼?
ERPC 無法准入此連線,包括 IP 註冊寬限期到期之後的情況。請將實際的對外 IP 與已註冊的 IP 比較,並確認目前的存取狀態。註冊變更需要時間生效,請勿假定固定的生效時間;若情況持續,請聯絡支援團隊。
問:STREAM_ADMISSION_SOURCE_UNAVAILABLE 與 Unavailable (14) 代表什麼?
ERPC 當時無法判定此連線的來源。請退避,稍後再試。若持續發生,請附上第一個錯誤及其 metadata 聯絡支援團隊;此回應並不代表客戶的網路或伺服器有故障。
問:STREAM_ADMISSION_SNAPSHOT_UNAVAILABLE 與 Unavailable (14) 代表什麼?
ERPC 當時無法驗證存取權限。請退避,稍後再試;若持續發生,請聯絡支援團隊。反覆重新註冊、擴大過濾器範圍或購買 Dedicated Geyser gRPC,都無法修復這個可用性回應。
問:ERPC_GRPC_INVALID_ARGUMENT 與 InvalidArgument (3) 代表什麼?
請求含有無效的參數、選項、欄位類型、鍵或過濾器組合。請在重試前修正請求,並且不要重新傳送同一個請求。以此錯誤碼被拒絕的每一個 Subscribe 請求,都是上方問題「哪些 gRPC 錯誤會使我的連線進入暫停,我的用戶端應何時停止重新連線?」所述暫停規則下計入的錯誤,這些規則與
STREAM_GUARD_SHAPE_BLOCKS、STREAM_GUARD_SHAPE_ACCOUNTS_ALL 和 STREAM_GUARD_SLOW_READER 共用。當以此錯誤碼被拒絕的請求開始暫停時,它會以 STREAM_GUARD_SHAPE_REJECT_PENALTY 與 ResourceExhausted (8) 傳回。Dedicated Geyser gRPC 不會讓無效的參數變成有效。錯誤訊息會在錯誤碼後面加上
(reason: <token>),同一個 token 也會透過回應標頭 x-erpc-error-reason 傳回。請在下表中尋找該 token,了解需要修改什麼。有限制時,錯誤訊息會寫明具體數值。問:當 gRPC 傳回其他非零狀態時,ERPC_GRPC_REQUEST_FAILED 代表什麼?
請求以有效的 gRPC 狀態失敗,由該狀態決定下一步。歷史範圍無效時,對於
OutOfRange (11) 這類狀態應修正請求;對於 Unavailable (14) 這類可用性狀態則應退避。不要把每個非零狀態都視為暫時性錯誤,也不要原封不動地重試每個回應。問:推薦哪個區域?
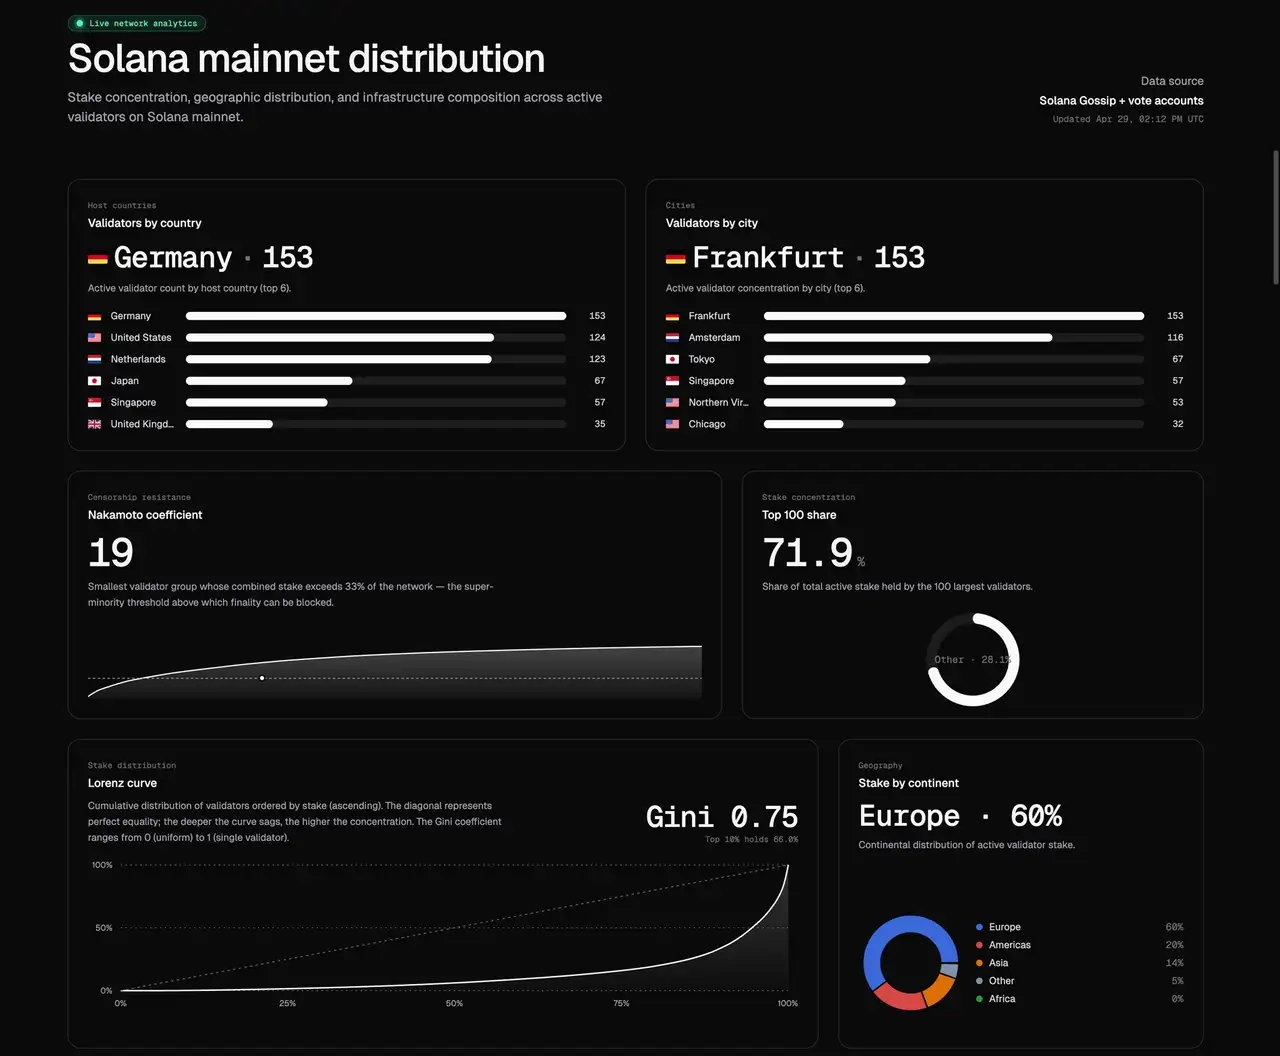
沒有一個永遠最好的區域。Solana 是全球網路,leader 角色依照 Leader 排程在驗證者之間轉移。驗證者數量和質押量較多的區域中,leader slot 出現的頻率更高,這有助於交易更快上鏈。但相應地,競爭流量也會同步集中,因此根據您的策略,競爭相對較少的區域有時反而能取得更好的效果。
一個實用的起點是:當穩定的 leader slot 供給最為重要時,選擇驗證者集中的區域,例如法蘭克福或美國東海岸;當最短路徑執行是首要目標時,則將基礎設施部署在特定目標驗證者附近。請使用 Validators Solutions 瞭解 Solana 網路的公開分佈,然後結合 ERPC Leader Slot API 和實際測量判斷單區域、雙區域或全球部署是否合適。
問:我需要約 400ms 或更低的延遲。
要實現約 400ms 以內的延遲,請考慮以下要點:
-
對 Ping 值的現實理解:Ping 值表示理想條件,不反映串流通訊中的實際延遲,後者通常約為 ping 延遲的 5 倍。例如,跨洲 100ms 的 ping 實際上會導致約 500ms 的延遲。因此,必須在同一區域內建立基礎設施才能實現約 400ms 的延遲。
- 典型 Ping 值參考:
- 同一網路:~0.1ms
- 私有網路互連(PNI):~0.2ms
- 同一資料中心:~0.3ms
- 同一城市:~1ms
- 鄰國:~5–10ms
- 跨洲:~100–300ms
- 典型 Ping 值參考:
-
避免平均延遲的陷阱:Solana 驗證者分佈在全球各地,且 Leader 排程在每個 epoch 隨機變化。依賴平均延遲來實現約 400ms 是不切實際的。相反,您應該精確追蹤特定區域的驗證者排程,以識別延遲最低的 slot。要持續實現最小延遲,需要在所有相關區域部署基礎設施。在同一區域內,資料取得可以在幾十毫秒內完成,傳輸可以在幾毫秒內完成。
-
追蹤 Leader 排程:透過 ERPC Leader Slot API(
getLeaderSlots),監控您所在區域的 Leader 驗證者排程。 它會回傳即將到來的 Leader 排程、目前 epoch 的質押權重、推估的驗證者地理位置以及參考 ping 值,讓您能趕在延遲最低的 slot 到來之前識別出它們,並將其設為目標。 公共地圖型資料來源和原生 RPC API 適合瞭解網路整體分佈,但精確度不足以用於判斷執行時機。Leader Slot API 補足了路由和交易判斷所需的粒度。
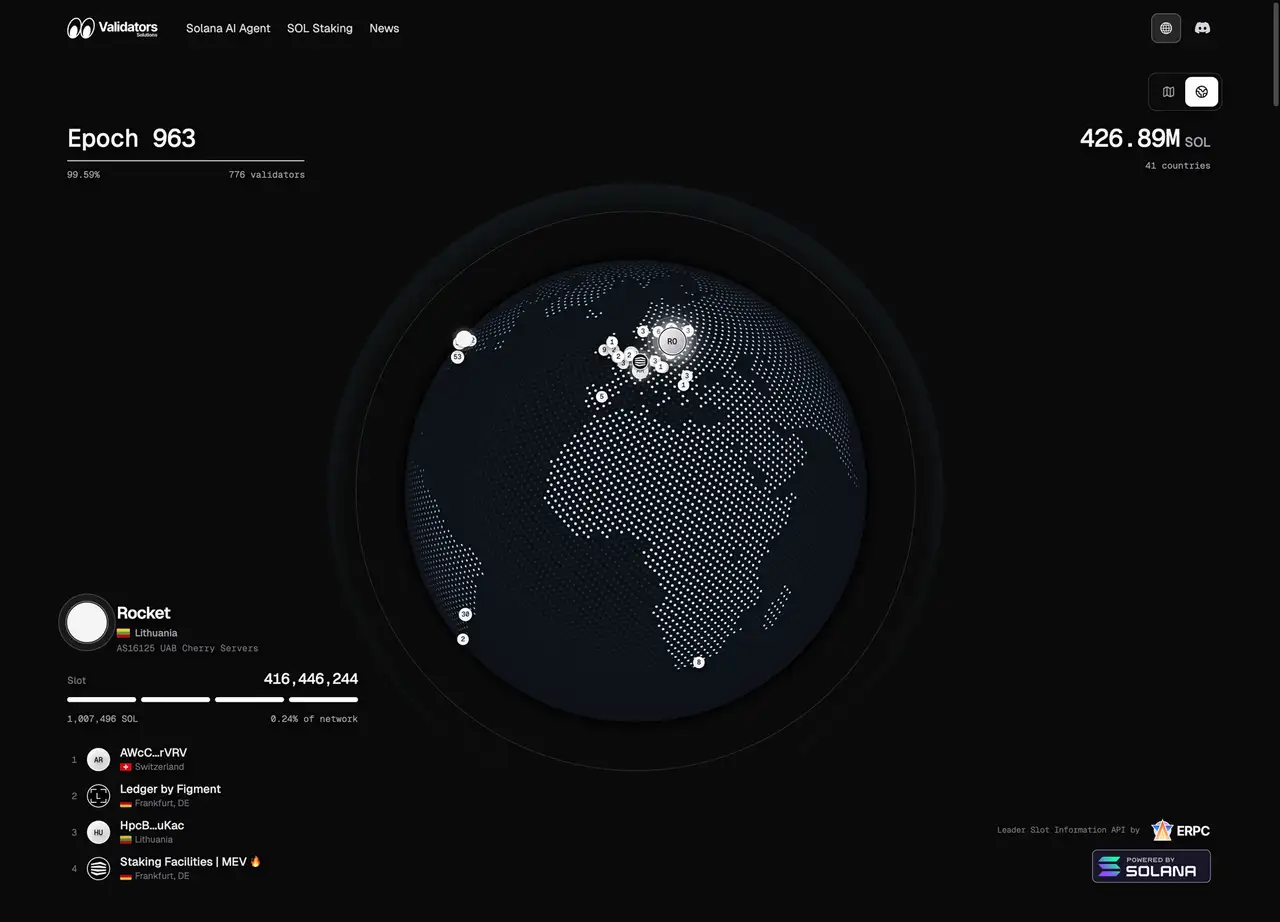
Solana 網路資料:Validators Solutions
問:如何實現零區塊(零 slot)交易?
成功實現零區塊(零 slot)交易需要更複雜的策略,如下:
-
識別機會區域:Solana 驗證者分佈在全球各地,物理上不可能對每個 slot 都實現最佳延遲。因此,監控您基礎設施所在區域的驗證者 Leader 排程,並識別最有利的機會區域。在多個區域部署基礎設施也可能有利。例如,法蘭克福是關鍵區域,因為其驗證者密度高,Leader 選擇更頻繁,交易機會更多。透過 ERPC Leader Slot API(
getLeaderSlots),查詢即將到來的 Leader 排程、目前 epoch 的質押權重、推估的驗證者地理位置資料以及參考 ping 值,精確度遠高於公共地圖型資料來源或原生 RPC API。如此一來,您就能在相應 slot 到來之前預先標出機會區域,並執行接近零延遲的交易。 -
部署專用節點:如果您難以競爭,請考慮部署專用節點。共享節點由於其他使用者的流量會產生延遲,因此不建議使用。此外,將您的專用節點放置在與應用程式相同的網路中可以顯著降低網路延遲並最佳化效能。
問:我可以使用特定端點嗎?
為了維持低延遲環境,我們的系統會自動選擇最近的可用節點。如果您希望使用特定端點,我們建議租用距離該端點最近的伺服器。
問:我收到了 401 錯誤。為什麼?
為了維護低延遲環境,我們實施了 IP 限制。如果您沒有訂閱或您的 IP 未註冊,您將收到 401 錯誤。
請仔細檢查您註冊的 IP 是否與目前存取 IP 相符。
問:我收到了 429 錯誤。為什麼?
您已達到方案的連線上限。
如果遇到此錯誤,請考慮升級您的方案。如果您需要的連線數超過高階方案提供的數量,專用 gRPC 節點會更合適。
問:為什麼專用端點更快?
共享端點由多個客戶共同使用相同的資源。隨著流量增加,延遲往往會出現。伺服器資源有物理限制,它們能處理的工作量是有限的。當太多請求同時到達時,必須按順序處理,這會導致回應時間變慢。
儘管我們採取了各種措施來最佳化共享端點的效能,但使用專用端點時您是資源的唯一使用者。這意味著您完全不受其他使用者的影響,確保始終穩定且快速的回應。
此外,專用端點提供無 TLS 的通訊選項,如 HTTP。透過跳過 TLS 握手(約 20ms),通訊比 HTTPS 更快。
問:簽約後價格會被上調嗎?
在訂閱有效期內,您簽約時鎖定的價格將保持不變。能夠承擔 Solana 即時工作負載的執行環境在全球範圍內都很稀缺,我們計劃隨著硬體和網路需求的持續成長,分階段上調價格。高規格配置和需求集中的區域庫存會更快售罄,因此以目前的價格鎖定訂閱是長期控制成本最有利的選擇。
問:我想用加密貨幣支付
當註冊帳單地址的國家/地區屬於歐盟成員國時,即可在 ERPC Web Dashboard 中使用加密貨幣付款。如果帳戶中註冊的支付卡片全部由歐盟以外發行,則無法使用加密貨幣付款。您可以使用 SOL、USDC 或 EURC 購買 ERPC Credits。
這些 ERPC Credits 可用於啟用或續用 ERPC 方案。開啟儀表板,選擇「Crypto 付款」,從您的錢包發起轉帳,儀表板會驗證這筆交易,並將 Credits 記入您的帳戶。
支援國家/地區:奧地利、比利時、保加利亞、克羅埃西亞、賽普勒斯、捷克、丹麥、愛沙尼亞、芬蘭、法國、德國、希臘、匈牙利、愛爾蘭、義大利、拉脫維亞、立陶宛、盧森堡、馬爾他、荷蘭、波蘭、葡萄牙、羅馬尼亞、斯洛伐克、斯洛維尼亞、西班牙、瑞典。
如果您的國家/地區不在清單中,請使用信用卡付款。
問:如何實現盡可能低的延遲?
我們強烈推薦將專用 gRPC 節點與我們的裸金屬伺服器結合使用。
兩者共享同一網路,允許私有的零距離通訊,無需穿越網際網路。這種設定可實現極低的延遲,通常約 0.1ms ping。
如需瞭解更多詳情,請透過 ERPC Web Dashboard 聯絡我們。
問:延遲是怎樣的?
延遲因測量方法和您的具體使用環境而異。與其關注精確的數值,更重要的是確保延遲滿足您的實際營運需求。
我們提供易於使用的 TypeScript 和 Rust 延遲測量工具。
問:這個 RPC(gRPC、Shreds)比其他的快嗎?
我們在每個價格檔位都以速度為設計目標,歡迎您把我們與任何其他供應商放在同等條件下比較。結果會隨區域、使用共享端點或專用端點、所用協定(WebSocket、gRPC 或 Shreds)以及用戶端的程式語言而變化。
如果您發現我們的服務更慢,請透過 ERPC Web Dashboard 告訴我們您比較的具體條件和競爭對手。我們將找出原因並進一步提高速度。
問:哪個方案提供最快的效能?
通常,我們最高等級的方案由於更優秀的 CPU、更大的記憶體容量和強大的硬體配置而提供最快的效能。
如果您需要更強大的伺服器,我們還提供客製化解決方案,但我們的標準方案旨在提供最佳的價效比。
我們有信心在每個價位都提供世界級的效能。如果您在相同價格範圍內找到更快的供應商,請告訴我們,以便我們調查和改進。
問:我遇到了高延遲。我該怎麼辦?
問:WebSocket、gRPC 和 Shreds 哪個最快?
客戶回饋一致認為速度排名如下:
Shreds > gRPC > WebSocket
如果您觀察到不同的結果,請告訴我們。
問:延遲不如預期。
效能因使用的程式語言而異。通常,語言速度排名如下:
Rust > Go > TypeScript (JavaScript) > Python
詳細比較請參閱:
為了獲得最佳效能,我們強烈推薦使用 Rust。